쌓인 기록에서 찾기
무엇을 찾으세요?
날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위부터 2026년 11월 17일 (화)까지4750건
6건 · "3D 환경"조건 지우기 ×
001스타 1,676고교 과학 실험을 3D로 배운다…'동강 랩' 50개 수업 무료 공개물리·화학·생물·지리 고등학교 과학 주제를 다루는 인터랙티브 3D 수업 50개를 무료로 제공하는 동강 랩이 GitHub에 공개되었다.오픈소스 · 도구 · smithjohn78390/tongjiang-lab · HTML

Key Point고등학교 과학 실험실 환경을 3D로 완벽히 재현해 학생들이 위험하거나 복잡한 실험을 가상으로 체험할 수 있으며, 오프라인 작동과 교육 표준 연계로 학교 현장에 즉시 적용 가능하다.
핵심 요약
- 물리·화학·생물·지리 고등학교 과학 주제를 다루는 인터랙티브 3D 수업 50개를 무료로 제공하는 동강 랩이 GitHub에 공개되었다.
- 각 수업은 약 1MB 용량의 단독 HTML 파일로, 더블클릭하면 오프라인에서도 작동하며 프로젝터나 스마트보드에 연결할 수 있다.
- 3D 환경 내에서 실시간 제어 콘솔, 안내 질문, 교사가 따를 수 있는 단계별 진행 경로를 제공한다.
전체 요약 12문장 읽기 →AI · 머신러닝 · FilmFlow: Agentic System for 3D Virtual Film Cinematography

Key Point자연어 지시만으로 3D 환경의 영화급 카메라 동작을 자동으로 계획·실행할 수 있게 되면, 영화·게임·VR 등 다양한 미디어 제작 환경에서 영상 제작 시간을 크게 단축할 수 있다.
핵심 요약
- FilmFlow는 자연어 지시나 참고 영상을 3D 가상 환경의 실행 가능한 카메라 궤적으로 변환하는 에이전트 시스템이다.
- Director 에이전트가 병렬 원자 동작들을 조합해 이동·회전·프레이밍을 동시에 제어하는 고수준 카메라 계획을 생성한다.
- Interpreter는 장면 기반 영화적 의도를 추출하고, Scout는 초기 시점을 선택하며, Critic은 렌더링 결과를 평가하고 시각적 피드백으로 반복 개선한다.
전체 요약 6문장 읽기 →AI · 머신러닝 · Learning to Think and Explore in 3D World

Key Point3D 환경에서 능동적으로 탐색해야만 답할 수 있는 문제에서 기존 상용 모델을 능가하는 오픈소스 모델 사례를 제시하며, VLM의 추론 능력을 확장하는 새로운 학습 패러다임을 보여줍니다.
핵심 요약
- 시각언어모델(VLM)이 한 번에 한 장의 이미지만 입력받아 3D 환경과 상호작용하면서 능동적으로 탐색하도록 학습하는 새로운 접근을 제시했습니다.
- 초기 질문과 첫 번째 관점에서 시작한 뒤, 모델이 반복적으로 추론하고 이동·회전 같은 행동을 통해 시점을 변경하며 최종 답변을 제출하는 방식입니다.
- 궤적 감독 미세조정 후 강화학습(RL)을 적용했으며, 보상은 최종 답변 정확도로만 주어져서 모델이 어떤 시점을 방문할지는 스스로 학습합니다.
전체 요약 8문장 읽기 →AI · 머신러닝 · Gemini 4 Argon for Robotics
Key Point3D 물리 환경에서 로봇 제어·시뮬레이션·코드 생성을 통합적으로 처리하는 AI 모델의 등장으로, 로봇공학 개발의 전체 워크플로우가 단순화될 수 있는 전환점이 될 수 있다.
핵심 요약
- 구글이 로봇공학 전문 대규모 언어 모델 제미니 4 아르곤을 발표했다.
- 아르곤은 ERQA 벤치마크에서 순수 추론으로 87% 점수를 달성해 다른 모든 경쟁 모델을 능가한다.
- 보스턴 다이나믹스 스팟 로봇 제어, 로봇팔 조작 작업, 3D 환경 내 물체 배열 등 로봇공학 전주기에 적용 가능하다.
전체 요약 12문장 읽기 →AI · 머신러닝 · WorldAuditBench: Interactive 3D World Auditing with Multimodal Agents

Key Point멀티모달 AI가 3D 환경 내 시각적 추론과 행동 탐색을 동시에 수행해야 하는 실제적 요구를 측정하는 벤치마크로, AI 모델의 공간 이해와 의사결정 능력의 격차를 정량화한다.
핵심 요약
- 3D 시뮬레이션 환경에서 부유하는 물체, 통과 가능한 벽, 맞지 않는 객체 등의 이상을 자동으로 감지하는 것이 중요해지고 있다.
- 비전-언어 모델(VLM)과 비전-언어-행동 모델(VLA) 같은 멀티모달 AI 시스템이 이 작업을 자동화할 가능성을 보여주고 있다.
- 3D 세계 감시는 행동 능력(3D 환경을 탐색하며 이상을 체계적으로 찾기)과 시각 추론 능력(환경을 이해하고 이상 식별)의 긴밀한 결합이 필요하다.
전체 요약 8문장 읽기 →웹 · 프론트엔드 · SDF vs. MSDF vs. Slug: GPU Text Rendering
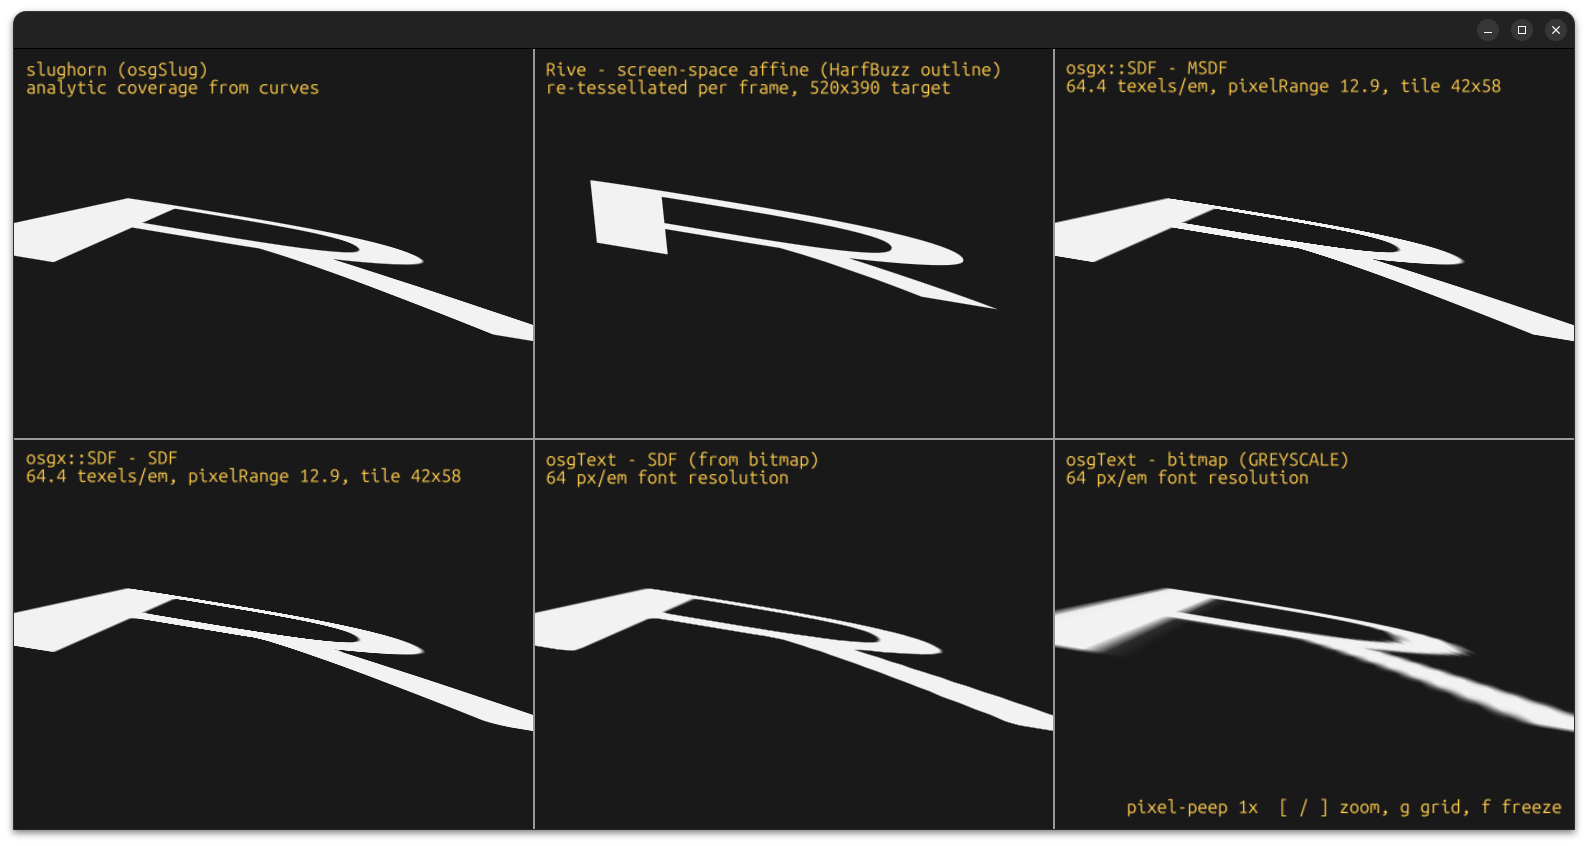
Key Point2026년 Slug 특허가 공개 도메인으로 해방되면서 고사양 3D·AR 환경의 텍스트 렌더링 기술이 개방되었으며, 각 기법의 정확한 트레이드오프를 이해하면 게임, 시뮬레이션, 데이터 시각화 프로젝트에서 최적의 방식을 선택할 수 있다.
핵심 요약
- GPU에서 글자를 렌더링하는 방식은 텍스트가 매 프레임 바뀌고 임의의 3D 변환 아래서도 선명해야 한다는 제약으로 인해 CPU 래스터화보다 복잡하다.
- 가장 오래된 텍스처 아틀라스 방식은 글자를 고정 크기로 미리 렌더링해 저장하므로, 확대하면 흐릿해지고 중국어·일본어·한국어 같은 거대 글자 집합은 메모리가 폭증한다.
- SDF(부호있는 거리장)는 픽셀 대신 가장자리까지의 거리를 저장해 확대에 강하지만, 날카로운 모서리가 둥글어지는 한계가 있다.
전체 요약 12문장 읽기 →