쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 3일 (화)까지 3800건
6건 · "AI 검증"조건 지우기 ×
001 12:10 ▲ 100 · 댓글 76 PostgreSQL 19 출시 지연, LLM이 찾은 버그 폭증이 원인 PostgreSQL 19는 전통적인 9월~10월 중순 일정을 깨고 11월 이후 출시될 것으로 예상되며, UPDATE/DELETE FOR PORTION OF, SQL Property Graph Queries 등 여러 대형 기능이 8월 27일~9월 15일 사이 베타 후반에 회수됐다. AI · 머신러닝 · Postgres 19 is late because so many more bugs are being found now
Key Point 기존 30년 이상의 코드베이스에서 인간이 놓친 버그를 LLM이 대량으로 발견하면서 소프트웨어 개발과 유지보수의 패러다임이 변하고 있으며, PostgreSQL의 사례는 앞으로 모든 개발자가 직면할 AI 검증 시대의 현실을 보여준다.
핵심 요약
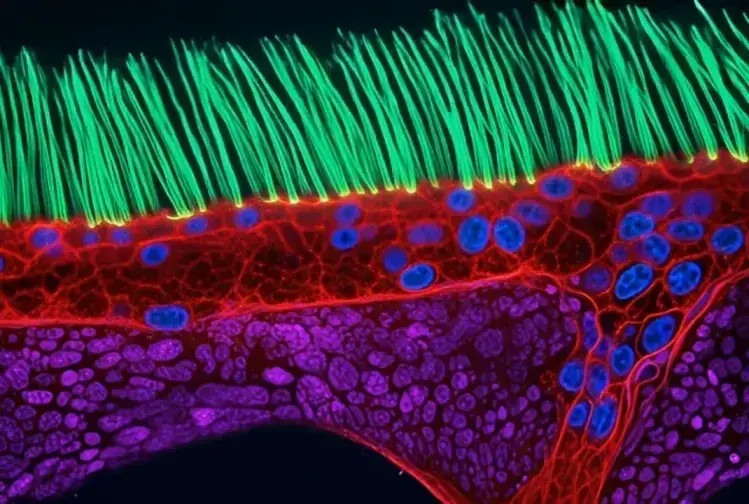
PostgreSQL 19는 전통적인 9월~10월 중순 일정을 깨고 11월 이후 출시될 것으로 예상되며, UPDATE/DELETE FOR PORTION OF, SQL Property Graph Queries 등 여러 대형 기능이 8월 27일~9월 15일 사이 베타 후반에 회수됐다. 2026년 4월 8일~9월 25일 사이 마스터 브랜치 커밋은 1,443개(2025년 1,037개)로 소폭 증가했으나, 백포트 커밋은 724개에서 1,169개로 60% 이상 급증했다. REL_17_STABLE과 REL_18_STABLE 커밋도 248개에서 433개로 74% 증가했으며, 이는 LLM을 이용해 발견된 버그 보고가 크게 늘어났기 때문이다. 전체 요약 7문장 읽기 → 002 03:11 ▲ 107 · 댓글 39 니콘 사진 대회 우승자, AI 조작 적발 후 타이틀 박탈 니콘의 16회 'Small World in Motion' 미시 촬영 대회에서 우승한 중국 칭화대 닝쉬 박사의 영상이 AI로 생성되었다는 의혹을 받았다. AI · 머신러닝 · Nikon photography contest winner loses title after scientists spot signs of AI
Key Point 과학 논문의 신뢰성과 증거 기반을 중시하는 학계와 대회 운영진들이 AI 생성 이미지 검증 방법을 고민하게 되는 계기이며, 미디어·사진·과학 분야 전반에서 AI 검증 기준 마련의 필요성을 드러내는 사건입니다.
핵심 요약
니콘의 16회 'Small World in Motion' 미시 촬영 대회에서 우승한 중국 칭화대 닝쉬 박사의 영상이 AI로 생성되었다는 의혹을 받았다. 영상은 원발성 섬모운동이상증을 가진 어린이의 기도에서 움직이는 미세한 섬모를 촬영한 것으로 제시되었으나, 세포 구조와 크기에 비정상이 있고 섬모가 갑자기 나타났다 사라지는 등 생물학적으로 불가능한 특징이 지적되었다. UT 사우스웨스턴 의료센터 박사과정생 이안 도노번은 원본 이미지에 AI 생성을 나타내는 특정 워터마크가 있다고 밝혔다. 전체 요약 9문장 읽기 → 003 21:11 ▲ 116 · 댓글 61 LLM의 신뢰도 점수는 신뢰할 수 없다 LLM에 신뢰도 점수를 요청하면 번호는 주지만, 그 숫자를 신뢰할 이유가 없다. AI · 머신러닝 · Using LLM for confidence scoring is a bad idea
Key Point LLM이 생성한 신뢰도 점수는 단순 텍스트 생성일 뿐 실제 확률을 반영하지 않으므로, AI 에이전트의 신뢰성을 검증해야 하는 개발자들이 알아야 할 근본적인 한계다.
핵심 요약
LLM에 신뢰도 점수를 요청하면 번호는 주지만, 그 숫자를 신뢰할 이유가 없다. 신뢰도란 예측이 얼마나 정확한지를 나타내는데, 이는 과거 정보와 현재 증거를 바탕으로 한 계산이어야 한다. 신뢰도 점수의 정확성은 같은 조건의 많은 사례에서 예측 확률과 실제 발생률이 일치하는지(보정도)로만 측정할 수 있다. 전체 요약 9문장 읽기 → 004 18:30 ▲ 304 · 댓글 186 AI 수학 증명 검증의 함정, 자동형식화는 신뢰할 수 없다 AI가 자연언어 수학 증명을 Lean 같은 형식 언어로 자동 번역하는 '자동형식화'가 수학 검증에 널리 쓰이고 있으며, OpenAI의 나비에-스토크스 방정식 해의 폭발성 증명도 이 방식으로 검증되었다. AI · 머신러닝 · Navier–Stokes Lost in Translation
Key Point AI가 수학 논문을 자동으로 검증하려는 시도가 이론적으로 불가능하다는 것을 보여주는 논문으로, OpenAI의 발표된 증명이 실제로는 원본과 다를 수 있음을 시사한다.
핵심 요약
AI가 자연언어 수학 증명을 Lean 같은 형식 언어로 자동 번역하는 '자동형식화'가 수학 검증에 널리 쓰이고 있으며, OpenAI의 나비에-스토크스 방정식 해의 폭발성 증명도 이 방식으로 검증되었다. 그러나 이 논문은 형식 언어로 검증된 증명이 원래 자연언어 증명의 정확성을 보장하지 않음을 보인다. 문제는 자연언어 수학 텍스트의 모호성을 해결하려면 의미론적으로 충실한 번역이 필수인데, 이 모호성 해결 문제가 계산 복잡도 계층(Solvability Complexity Index)에서 무한 수준(SCI = ∞)에 위치한다는 것이다. 전체 요약 6문장 읽기 → 005 09:11 ▲ 12 · 댓글 2 의료 AI 검증 시스템의 숨은 한계, 자동 분류로 드러내다 의료 데이터에서 검색한 근거로 LLM 생성 답변의 사실성을 확인하는 검색 기반 평가가 임상 환경에서 주류 방식이 되었으나, F1 같은 집계 지표는 실패의 원인과 위치를 불명확하게 남긴다. AI · 머신러닝 · Where Does Retrieval-Based Open-Ended Evaluation Fail? Automatic Taxonomy Induction from Long-Form Medical Answer Factuality Verification
Key Point 의료 AI 시스템의 검증 성능이 개선되지 않는 근본 원인이 무엇인지 밝혀, 현재 방식의 한계를 이해하고 새로운 접근이 필요한 이유를 제시한다.
핵심 요약
의료 데이터에서 검색한 근거로 LLM 생성 답변의 사실성을 확인하는 검색 기반 평가가 임상 환경에서 주류 방식이 되었으나, F1 같은 집계 지표는 실패의 원인과 위치를 불명확하게 남긴다. MedExpert 데이터셋과 3개의 폐쇄형 데이터셋 사례 연구에서 검색 단계 오류 5가지와 검증 추론 오류 6단계를 분류하는 두 개의 체계적 분류법을 개발했다. LLM을 판사로 삼아 증거 품질을 라벨링하고 검증 오류를 자동으로 분류하는 패턴 귀납 파이프라인을 적용하여 4가지 검색 방식과 6개 최신 검증 모델에서 대규모로 검증했다. 전체 요약 5문장 읽기 → 006 09:10 ▲ 227 · 댓글 123 AI 실수 원천 차단하는 프로그래밍 언어 'Bend' 공개 형식 증명(proof)으로 AI가 작성한 코드의 정확성을 검증하는 프로그래밍 언어 Bend를 발표했다. AI · 머신러닝 · Bend – A language that blocks AI mistakes via proof, on CPU and GPU
Key Point AI 에이전트가 코드를 자동 생성하는 시대에 형식 증명으로 보안 결함을 원천 차단할 수 있는 새로운 접근 방식을 제시하기 때문입니다.
핵심 요약
형식 증명(proof)으로 AI가 작성한 코드의 정확성을 검증하는 프로그래밍 언어 Bend를 발표했다. C 수준의 단일 코어 성능으로 컴파일되며, 동일 바이너리가 GPU에서 100배까지 빠르게 실행된다. 타입 체커가 증명 체커로 작동해 중간 규모 코드베이스에서 최대 1초 내에 검증을 완료한다. 전체 요약 5문장 읽기 →