쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
7건 · "AI 벤치마크"조건 지우기 ×
001 18:11 ▲ 27 · 댓글 2 논문을 포스터로 변환하는 AI 벤치마크 RAP 공개 논문을 한 페이지 포스터로 압축하는 작업을 시각적 코딩으로 정의하고, 이를 위한 대규모 벤치마크 RAP를 제시한다. AI · 머신러닝 · RAP: A Dataset for Paper-to-Poster Generation via Declarative Markup from Human-Crafted Exemplars
Key Point 시각적 코딩 벤치마크의 공백을 채우고, 객관적 평가와 인간 설계 재활용을 동시에 가능하게 하는 대규모 구조화된 데이터셋이 공개되었다.
핵심 요약
논문을 한 페이지 포스터로 압축하는 작업을 시각적 코딩으로 정의하고, 이를 위한 대규모 벤치마크 RAP를 제시한다. RAP는 2022~2026년 머신러닝 학회 25K개 이상의 논문-포스터 쌍을 수집하고, 3단계 콘텐츠 분류체계로 주석했으며, 150개 테스트 논문 벤치마크를 별도로 포함한다. 기존 벤치마크와 달리 완전 자동화된 역렌더링 파이프라인으로 각 포스터를 재작성 가능한 HTML/CSS 마크업으로 변환하여, 논문-포스터-마크업 삼중쌍으로 검증할 수 있다. 전체 요약 8문장 읽기 → 002 06:11 ▲ 292 · 댓글 268 AI 벤치마크, 실제 일자리의 90%는 측정 못 한다 AI 벤치마크들이 미국 직업 923개(O*NET 분류)의 작업 중 대부분을 제대로 측정하지 못하고 있다는 분석이 나왔다. AI · 머신러닝 · 90% of US working hours are spent on tasks not covered well by AI benchmarks
Key Point AI 기업과 정책입안자들이 모델의 실제 경제적 영향을 평가할 때 사용하는 벤치마크들이 큰 맹점을 가지고 있으며, 특히 중간 소득 일자리와 물리적 작업에 대한 측정이 심각하게 부족하다는 점이 드러났다.
핵심 요약
AI 벤치마크들이 미국 직업 923개(O*NET 분류)의 작업 중 대부분을 제대로 측정하지 못하고 있다는 분석이 나왔다. 미국 근로시간의 90%가 기존 벤치마크에서 5개 이상의 프롬프트로 커버되지 않는 작업에 사용되고 있다. 923개 직업 중 단 208개만 충분히 벤치마크된 작업(5개 이상 프롬프트)을 보유하고 있으며, 22개 직업군 중 6개는 해당하는 직업이 없다. 전체 요약 10문장 읽기 → 003 18:11 ▲ 57 · 댓글 2 일상 영상에서 도구 사용 이해하는 AI 벤치마크 공개 일상 및 전문적 작업에서 도구 사용은 필수이지만, 현 영상 모델들은 도구 사용의 affordance·기하학적 관계·절차·인과관계를 이해하는 데 제한적이다. AI · 머신러닝 · EgoTools: Towards Tool-Centric Reasoning in Real-World Egocentric Videos
Key Point 현 멀티모달 모델이 실제 작업 영상에서 도구 사용의 세부 기하학·절차·인과관계를 이해하는 데 약점을 드러냈으므로, 이를 진단하고 개선할 수 있는 벤치마크가 필요하다.
핵심 요약
일상 및 전문적 작업에서 도구 사용은 필수이지만, 현 영상 모델들은 도구 사용의 affordance·기하학적 관계·절차·인과관계를 이해하는 데 제한적이다. 이를 해결하기 위해 EgoTools 스위트를 공개했으며, 100시간의 도구 중심 1인칭 영상 데이터셋(음성 동기화·캡션·내레이션·3D 정보 포함)과 진단 벤치마크로 구성된다. 벤치마크는 1,000개의 QA로 이루어져 있으며 지각·기하학·절차·인과 추론의 4가지 트랙을 포함한다. 전체 요약 6문장 읽기 → 004 12:11 ▲ 90 · 댓글 2 3D 세계의 이상을 찾아내는 AI 벤치마크 공개 3D 시뮬레이션 환경에서 부유하는 물체, 통과 가능한 벽, 맞지 않는 객체 등의 이상을 자동으로 감지하는 것이 중요해지고 있다. AI · 머신러닝 · WorldAuditBench: Interactive 3D World Auditing with Multimodal Agents
Key Point 멀티모달 AI가 3D 환경 내 시각적 추론과 행동 탐색을 동시에 수행해야 하는 실제적 요구를 측정하는 벤치마크로, AI 모델의 공간 이해와 의사결정 능력의 격차를 정량화한다.
핵심 요약
3D 시뮬레이션 환경에서 부유하는 물체, 통과 가능한 벽, 맞지 않는 객체 등의 이상을 자동으로 감지하는 것이 중요해지고 있다. 비전-언어 모델(VLM)과 비전-언어-행동 모델(VLA) 같은 멀티모달 AI 시스템이 이 작업을 자동화할 가능성을 보여주고 있다. 3D 세계 감시는 행동 능력(3D 환경을 탐색하며 이상을 체계적으로 찾기)과 시각 추론 능력(환경을 이해하고 이상 식별)의 긴밀한 결합이 필요하다. 전체 요약 8문장 읽기 → 005 16:18 ▲ 129 · 댓글 3 게임 AI의 능력을 평가하는 대규모 벤치마크 공개 게임 플레이 능력을 다양한 시간 범위에서 측정하는 GameHorizon Suite를 개발했다. AI · 머신러닝 · GameHorizon Suite: Multi-Horizon Data and Evaluation in Gameplay
Key Point 게임을 통해 AI의 비전, 지시 분해, 계획, 제어 능력을 체계적으로 평가하는 첫 번째 대규모 표준화 벤치마크로, 멀티모달 AI 모델 발전의 객관적 척도가 된다.
핵심 요약
게임 플레이 능력을 다양한 시간 범위에서 측정하는 GameHorizon Suite를 개발했다. 21개 게임의 5,000시간 녹화본, 100명 전문가 플레이어의 행동, 다중 수준 지시문으로 구성된 대규모 데이터세트를 구축했다. 오프라인 평가는 표준화된 문제로 재현 가능하고, 온라인 평가는 실제 게임플레이 능력을 검증한다. 전체 요약 5문장 읽기 → 006 08:27 ▲ 128 · 댓글 45 주요 AI 모델 SVG 생성 속도 및 비용 비교 여러 AI 모델의 텍스트-투-이미지 SVG 생성 성능을 체계적으로 비교한 벤치마크 결과를 공개했다. AI · 머신러닝 · Show HN: Pelican-bicycle alternatives
Key Point AI 모델 선택 시 속도와 비용의 트레이드오프를 정량적으로 파악할 수 있는 실제 벤치마크 데이터를 제공한다.
핵심 요약
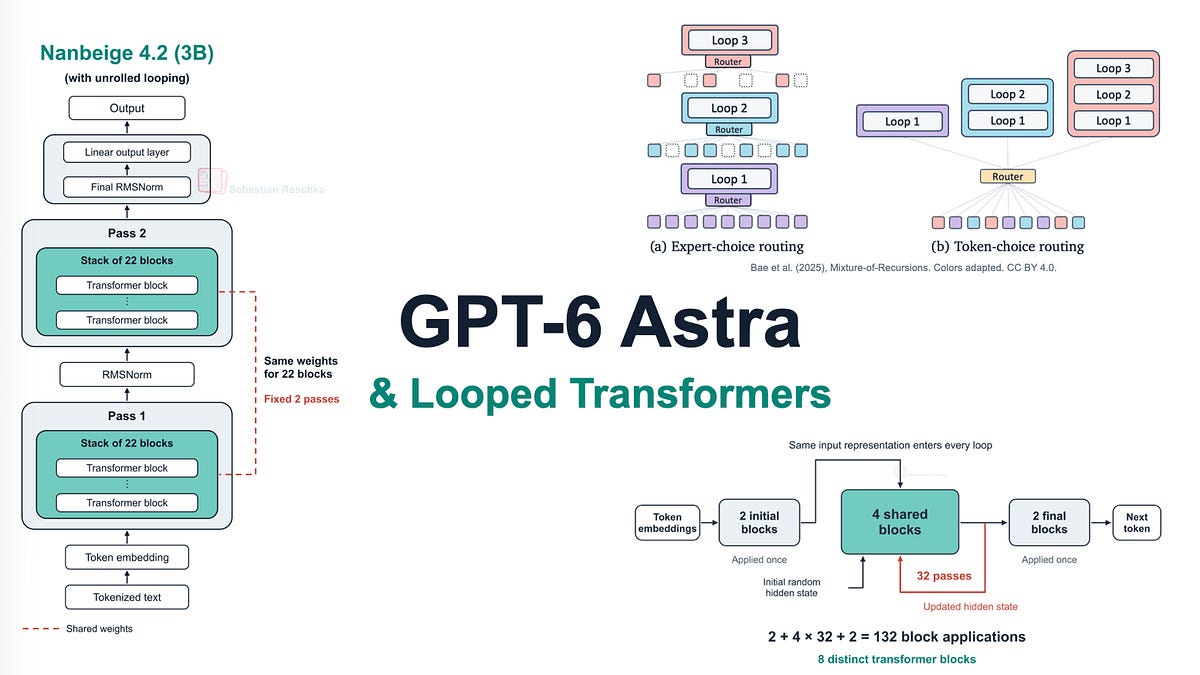
여러 AI 모델의 텍스트-투-이미지 SVG 생성 성능을 체계적으로 비교한 벤치마크 결과를 공개했다. GPT-6 Astra, Claude Fable 5.1, Gemini 3.8 Flash 등 2026년 최신 모델들을 포함해 6~10개 모델을 대상으로 테스트했다. 각 모델별로 실행 시간(초 단위)과 API 비용($)을 측정했으며, 동일한 프롬프트를 여러 창의적인 동물 시나리오로 반복 실행했다. 전체 요약 5문장 읽기 → 007 03:10 ▲ 172 · 댓글 62 GPT-6 Astra, 루프 트랜스포머, 숨겨진 추론 메커니즘 OpenAI의 GPT-6 Astra는 코딩, 수학, 3D 렌더링 등 거의 모든 카테고리에서 GPT-5.6을 능가하며, 특히 ARC-AGI-3 벤치마크에서 99.9% 정확도를 기록했다. AI · 머신러닝 · GPT-6 Astra, looped transformers, and hidden reasoning
Key Point GPT-6 Astra의 구체적인 성능 향상(특히 추론과 컴퓨터 조작 능력)을 이해해야 차세대 모델의 방향을 파악할 수 있습니다.
핵심 요약
OpenAI의 GPT-6 Astra는 코딩, 수학, 3D 렌더링 등 거의 모든 카테고리에서 GPT-5.6을 능가하며, 특히 ARC-AGI-3 벤치마크에서 99.9% 정확도를 기록했다. 컴퓨터 사용 능력이 뛰어나 로컬 PC의 그래픽 소프트웨어(페인트, 블렌더 등)를 마우스와 UI로 직접 조작할 수 있으며, 이는 데모 영상의 시각적 임팩트로 주목받고 있다. 루프 트랜스포머(반복적 깊이) 및 숨겨진 추론 메커니즘에 대한 건축학적 루머가 있으며, 이 글은 이러한 기술 혁신과 최근 연구를 분석한다.