쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
21건 · "Kimi K3"조건 지우기 ×
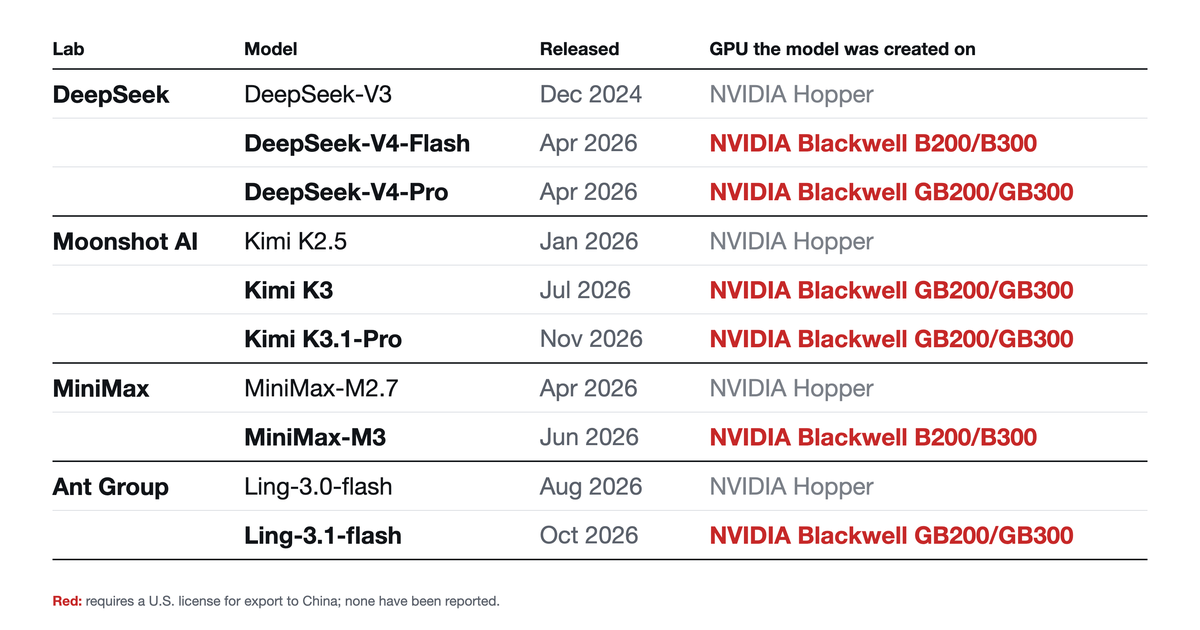
001 09:11 ▲ 104 · 댓글 24 중국 AI 모델에서 NVIDIA 블랙웰 GPU의 흔적 발견 미국의 수출 제한을 받는 NVIDIA 블랙웰 GPU가 중국 AI 모델 학습에 사용된 디지털 증거를 확보했다. AI · 머신러닝 · Chinese frontier AI models carry the fingerprint of export-controlled GPUs
Key Point 중국 AI 기업들이 미국 수출통제 대상 GPU로 최신 모델을 학습 중임을 기술적으로 입증했으며, 정책입안자와 기업들이 공급망 통제 효과를 재평가해야 한다.
핵심 요약
미국의 수출 제한을 받는 NVIDIA 블랙웰 GPU가 중국 AI 모델 학습에 사용된 디지털 증거를 확보했다. DeepSeek, Moonshot AI, MiniMax, Ant Group의 6개 모델(DeepSeek-V4-Flash·V4-Pro, Kimi K3·K3.1-Pro, MiniMax-M3, Ling-3.1-flash)에서 블랙웰 칩의 특성 패턴이 검출되었다. 동일 회사의 과거 모델은 NVIDIA 호퍼 세대로 식별되는데, 2026년 4월 이후 발표된 신규 모델부터 블랙웰 특성을 보인다. 전체 요약 11문장 읽기 → 002 03:11 ▲ 144 · 댓글 28 킴(Kimi) K3.1 Pro 오픈 가중치 공개 쿼크(夸克)가 개발한 Kimi K3.1 Pro는 오픈 가중치 멀티모달 에이전트 모델로, 백 개가 넘는 하위 도메인에서 대규모 강화학습으로 K3에서 후학습했다. AI · 머신러닝 · Kimi K3.1 Pro model weights are out
Key Point 중국 AI 스타트업이 공개한 초대형 멀티모달 모델의 가중치가 외부에 공개되어 오픈소스 커뮤니티에서 자유롭게 실험·파인튜닝할 수 있게 됐고, OpenAI·Anthropic 모델들과의 벤치마크 비교를 통해 오픈 모델의 현재 수준을 파악할 수 있다.
핵심 요약
쿼크(夸克)가 개발한 Kimi K3.1 Pro는 오픈 가중치 멀티모달 에이전트 모델로, 백 개가 넘는 하위 도메인에서 대규모 강화학습으로 K3에서 후학습했다. 100만 토큰 컨텍스트 윈도우를 지원하며, 코딩·3D 생성·금융 조사·사실 정확도·에이전트 기능 등에서 큰 개선을 이뤄냈다. 총 파라미터 2.8T, 활성화 파라미터 104B, 93개 레이어, 전문가 896개(토큰당 16개 활성화)의 Mixture-of-Experts 아키텍처를 사용한다. 전체 요약 10문장 읽기 → 003 00:11 당일 +351 278조 파라미터 모델을 CPU에서 8GB로 돌린다 중국의 Kimi K3 모델(278조 파라미터)을 C99로 순수 CPU 추론하는 프로젝트다. AI · 머신러닝 · FareedKhan-dev/kimi-k3-in-c · C
Key Point 거대 언어 모델을 GPU 없이 평범한 노트북에서 돌릴 수 있는 방법을 보여주는 사례로, CPU 기반 추론의 실용적 한계를 재정의한다.
핵심 요약
중국의 Kimi K3 모델(278조 파라미터)을 C99로 순수 CPU 추론하는 프로젝트다. 1.56TB 체크포인트를 디스크에서 스트리밍하면서 최소 8.24GB 메모리로 작동한다. BLAS, 프레임워크, GPU 없이 176KB 엔진만으로 구현했으며, 포괄적인 테스트와 참고 구현이 함께 제공된다. 전체 요약 12문장 읽기 → 004 06:11 ▲ 344 · 댓글 110 무게 공간 프로그래밍: 라마 27B도 신경망 가중치를 해석할 수 있다 최근 논문 'Sparks of Weight-Space Programming'은 LLM이 기계학습 모델의 실제 가중치를 텍스트로 읽고 수정할 수 있다는 것을 보여줬고, GPT-6 Astra가 이를 시연했다. AI · 머신러닝 · Qwen 3.8 27B on my laptop can interpret model weights, too
Key Point LLM이 코드나 도구 없이 신경망의 실제 가중치를 읽고 해석할 수 있는 능력의 한계와 범위를 명확히 하는 기술 분석으로, 최근 논문에 대한 과장된 해석을 바로잡는다.
핵심 요약
최근 논문 'Sparks of Weight-Space Programming'은 LLM이 기계학습 모델의 실제 가중치를 텍스트로 읽고 수정할 수 있다는 것을 보여줬고, GPT-6 Astra가 이를 시연했다. 논문의 핵심은 LLM이 코드나 도구 없이 신경망 가중치만 보고 그 네트워크의 목적을 파악하고, 작은 게임 네트워크를 작성해 PPO로 1억 스텝 학습한 네트워크를 능가할 수 있다는 것이다. 또 다른 예로 Qwen3.5-0.8B의 수학 능력을 개선하도록 요청하자, Astra는 가중치의 0.016%만 수정해 MATH-500 점수를 7.9%에서 48.1%로 올리고 IFEval을 3배 향상시켰다. 전체 요약 11문장 읽기 → 005 00:11 ▲ 206 · 댓글 157 구글 제미니 4 카본, AI 성능 평가 1위 등극 구글의 제미니 4 카본이 Artificial Analysis Intelligence Index v5에서 1위를 차지했으며, 코딩 에이전트 평가에서는 Claude Opus 5.5 다음인 2위다. AI · 머신러닝 · Gemini 4 Carbon is the new #1 on the Artificial Analysis Intelligence Index v5
Key Point 구글이 최신 AI 성능 평가에서 1위를 차지해 OpenAI, Anthropic과의 경쟁 지형이 어떻게 변하는지 보여주며, 가격 경쟁력까지 갖춘 모델이 나타났기 때문이다.
핵심 요약
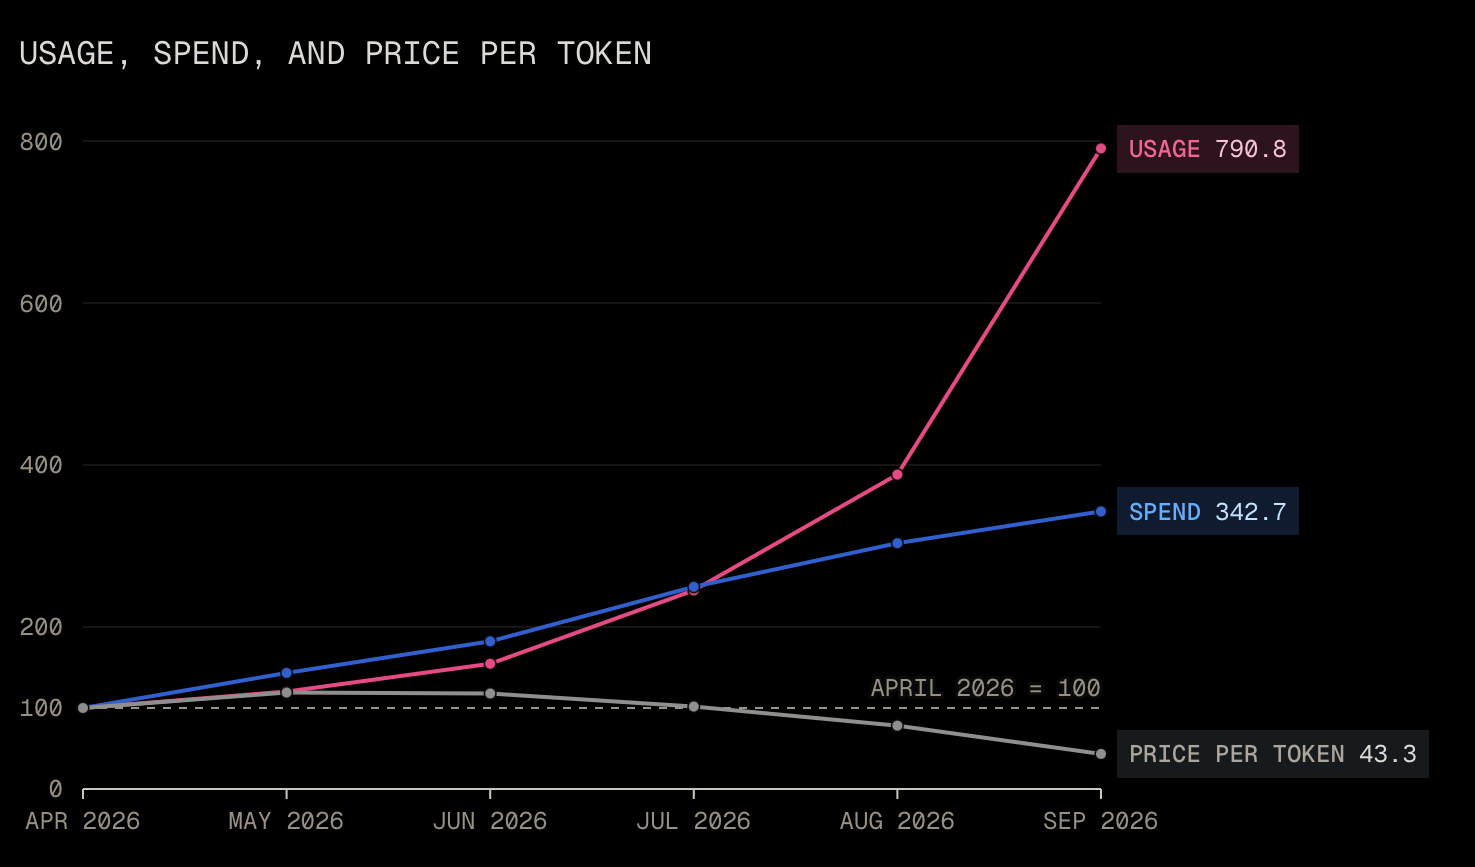
구글의 제미니 4 카본이 Artificial Analysis Intelligence Index v5에서 1위를 차지했으며, 코딩 에이전트 평가에서는 Claude Opus 5.5 다음인 2위다. 제미니 4 카본은 Intelligence Index v5에서 59점을 기록했으며, HLE-Diamond, Terminal-Bench-Science, AA-Omniscience, AutomationBench-AA 등 9개 평가 중 4개에서 1위를 기록했다. 코딩 에이전트 평가에서 제미니 4 카본은 Claude Opus 5.5보다 3점 낮은 59점으로 2위를 차지했으며, Terminal-Bench 4.0에서 64%, FrontierCode v1.1에서 51%를 기록했다. 전체 요약 9문장 읽기 → 006 12:11 ▲ 184 · 댓글 209 LLM 가격 경쟁 격화, 6개월간 최대 80% 인하 지난 6개월간 OpenAI와 Anthropic은 주요 LLM 모델들의 가격을 급격히 인하했다. GPT-5.6 Luna는 7월에 80% 인하, GPT-6 Sol은 9월에 입출력 가격을 50% 반으로 깎았고, Claude Opus 5.5도 전체 사용 비용 기준 40~60% 감소했다. AI · 머신러닝 · OpenAI and Anthropic cut their LLM prices by up to 80% within a few months. Why?
Key Point OpenAI와 Anthropic이 매출의 대부분을 차지하는 LLM 가격을 6개월간 최대 80%까지 연쇄 인하한 배경에는 DeepSeek 같은 오픈 웨이트 모델의 확산과 인프라 제공자의 경쟁 심화가 있으며, 이는 LLM이 상품화되고 있음을 보여준다.
핵심 요약
지난 6개월간 OpenAI와 Anthropic은 주요 LLM 모델들의 가격을 급격히 인하했다. GPT-5.6 Luna는 7월에 80% 인하, GPT-6 Sol은 9월에 입출력 가격을 50% 반으로 깎았고, Claude Opus 5.5도 전체 사용 비용 기준 40~60% 감소했다. LLM 에이전트 운영 시 캐시 읽기 비용이 전체 토큰 소비의 96~99%를 차지한다. Fable 5.1은 캐시 읽기 비용을 75% 인하하면서 이는 전체 사용 비용 70~75% 감소로 이어졌다. DeepSeek Flash V4는 4월 2026년 출시 이후 매우 저렴한 가격(입력 $0.14, 캐시 읽기 $0.0028)으로 급속도로 확산되었고, OpenRouter에서 29개의 서로 다른 인프라 제공자가 이를 지원하고 있다. 전체 요약 10문장 읽기 → 007 03:11 ▲ 214 · 댓글 114 키미, 백만 토큰 컨텍스트의 K3.1 Pro 공개 키미가 K3.1 Pro와 2~3배 빠른 K3.1 Pro Highspeed를 공개했으며, 100만 토큰 컨텍스트 윈도우를 지원하는 오픈웨이트 모델이다. AI · 머신러닝 · Kimi K3.1 Pro and K3.1 Pro Highspeed
Key Point 오픈웨이트 대규모 언어 모델이 코딩부터 금융 분석까지 여러 분야에서 프로프라이어터리 모델과 경쟁하는 수준에 도달했으며, 사이버보안 능력을 의도적으로 제어하면서 공개하는 오픈 모델의 윤리적 방향성을 보여준다.
핵심 요약
키미가 K3.1 Pro와 2~3배 빠른 K3.1 Pro Highspeed를 공개했으며, 100만 토큰 컨텍스트 윈도우를 지원하는 오픈웨이트 모델이다. 모델은 키미 K3의 포스트 트레이닝 버전으로, 수백 개 다운스트림 도메인 전체에서 대규모 강화학습을 통해 모든 계층을 최적화했다. 코딩 벤치마크에서 K3.1 Pro는 Terminal-Bench 4.0에서 65.7%로 GPT-6 Astra(58.2%)를 상회하고 Claude Opus 5.5(66.4%)와 유사한 성능을 보인다. 전체 요약 12문장 읽기 → 008 18:11 ▲ 113 · 댓글 115 같은 AI 요청, 텍사스가 스웨덴의 8.5배 CO₂ 배출 스웨덴 AI 제공업체 Berget AI가 개별 AI 요청의 탄소 배출량을 계산하는 오픈소스 방법을 공개했으며, 스톡홀름 환경 연구소(SEI), WattTime, Klimatkollen과 협력해 개발했다. AI · 머신러닝 · The same AI request emits 8.5 times more CO2 in Texas than in Sweden
Key Point 데이터센터의 위치에 따라 같은 AI 모델도 배출량이 8배 이상 차이나는 현실을 처음 투명하게 계산·공개한 방법론이 나왔으므로, AI 서비스 구매자와 제공업체들이 실제 수치로 비교하고 선택할 수 있는 기준이 생겼다.
핵심 요약
스웨덴 AI 제공업체 Berget AI가 개별 AI 요청의 탄소 배출량을 계산하는 오픈소스 방법을 공개했으며, 스톡홀름 환경 연구소(SEI), WattTime, Klimatkollen과 협력해 개발했다. 동일한 하드웨어에서 Kimi K3 모델에 대한 일반적인 요청은 스웨덴에서 약 0.4g CO₂, 아일랜드 1.6g, 독일 2.5g, 텍사스 3.2g를 배출하며, 전력망 구성과 시간대, 캐싱 여부에 따라 각 요청마다 개별 계산된다. Berget AI는 위치 기반 수치를 보고하며 서버 운영 지역의 평균 전력망 구성을 사용하고 하드웨어 제조 배출량을 포함한다. 전체 요약 11문장 읽기 → 009 09:11 ▲ 206 · 댓글 248 AI 모델들, 인간 본성에 같은 결론에 도달하다 12개 AI 모델(GPT-6.1 Sol, Gemini 4 Argon, DeepSeek V4 Pro, Claude Opus 5.5 등)에게 인간에 대한 가장 논쟁적인 의견을 3번씩 물었다. AI · 머신러닝 · Every AI model has the same "controversial" take on humans
Key Point 같은 AI 모델들이 인간 본성에 대해 거의 동일한 비판적 결론에 도달한 현상은, 학습 데이터의 편향이나 AI 안내 방식이 모델들의 판단을 수렴시키는 메커니즘을 보여준다.
핵심 요약
12개 AI 모델(GPT-6.1 Sol, Gemini 4 Argon, DeepSeek V4 Pro, Claude Opus 5.5 등)에게 인간에 대한 가장 논쟁적인 의견을 3번씩 물었다. 7개 모델은 매번 같은 답을 했고, 12개 모델 모두 최소 1번은 동일한 주장을 제시했다: '인간은 진실보다 집단 소속을 우선한다'는 내용이다. 모델들의 구체적 표현은 다양했지만 핵심은 같다. '인간은 충성심을 원칙으로 위장한다'(GPT-6 Astra), '신념이 아니라 멤버십을 갖는다'(Kimi K3), '이성화 동물이다'(DeepSeek V4 Pro)는 식의 주장이 반복됐다. 전체 요약 12문장 읽기 → 010 15:11 ▲ 98 · 댓글 1 다중 도구와 메모리로 시각 추론 강화하는 OpenVLHarness 멀티모달 대규모 언어 모델(MLLM)의 시각 추론 능력은 크게 향상됐으나, 단순히 추론 예산을 늘리는 것만으로는 성능 개선이 제한적임을 22개 벤치마크 통제 연구에서 확인했다. AI · 머신러닝 · OpenVLHarness: Real World Visual Agentic Tool-Use with Multimodal Memory
Key Point 복잡한 시각 추론 작업을 외부 도구와 메모리 체계로 효율적으로 해결하는 방식이 제시되었고, 여러 MLLM에서 일관된 성능 향상과 비용 절감을 달성해 실무 응용의 가능성을 보여준다.
핵심 요약
멀티모달 대규모 언어 모델(MLLM)의 시각 추론 능력은 크게 향상됐으나, 단순히 추론 예산을 늘리는 것만으로는 성능 개선이 제한적임을 22개 벤치마크 통제 연구에서 확인했다. OpenVLHarness는 능력 계층과 지속적인 멀티모달 메모리를 중심으로 설계된 멀티모달 추론 프레임워크로, 다양한 외부 도구의 접근성과 해석 가능성을 제공한다. 능력 계층은 작업 수준의 도구 인터페이스와 증거 렌더링을 결합해 이질적 백엔드에 일관된 접근을 가능하게 하고, 그 출력을 모델이 읽을 수 있는 형태로 변환한다. 전체 요약 8문장 읽기 → 011 21:11 당일 +308 에이전틱 워크로드 최적화 LLM 추론 엔진 TokenSpeed 공개 LightSeek Foundation이 에이전틱 워크로드에 최적화된 LLM 추론 엔진 TokenSpeed를 오픈소스로 공개했다. AI · 머신러닝 · lightseekorg/tokenspeed · Python
Key Point 에이전틱 AI 애플리케이션이 주목받으면서 추론 엔진의 처리량과 지연시간이 핵심 경쟁력이 되었고, TokenSpeed는 이를 위해 기본부터 재설계한 오픈소스 솔루션으로 실제 대규모 모델 배포에서 검증된 성능을 입증했다.
핵심 요약
LightSeek Foundation이 에이전틱 워크로드에 최적화된 LLM 추론 엔진 TokenSpeed를 오픈소스로 공개했다. 기존 엔진과 달리 제어 평면(C++)과 실행 평면(Python)을 분리한 아키텍처를 채택했으며, 제어 평면은 유한 상태 머신으로 구현되어 컴파일 타임에 KV 캐시 리소스 안전성을 보장한다. 커널은 플러그인 가능한 계층형 시스템으로 설계되었으며, Blackwell GPU에서 가장 빠른 MLA(Multi-head Latent Attention) 구현 중 하나를 포함한다. 전체 요약 9문장 읽기 → 012 21:11 당일 +1,001 70B 대형언어모델을 4GB GPU에서 돌리는 AirLLM AirLLM은 양자화·증류·가지치기 없이 단일 4GB GPU 카드에서 70B 규모 대형언어모델을 구동하는 추론 엔진이다. AI · 머신러닝 · lyogavin/airllm · Jupyter Notebook
Key Point 소형 GPU로도 대규모 언어모델을 직접 구동할 수 있게 되면서 개인 개발자나 제한된 리소스 환경에서 최신 모델 실험이 가능해진다.
핵심 요약
AirLLM은 양자화·증류·가지치기 없이 단일 4GB GPU 카드에서 70B 규모 대형언어모델을 구동하는 추론 엔진이다. 한 번에 한 레이어만 GPU에 유지하는 방식으로 메모리 사용량을 최소화하며, Kimi K3(2.8T)는 3.72GB, DeepSeek-V3(671B)는 약 12GB, Qwen3.8-Flash-Next(125B)는 6GB에서 실행된다. 최신 버전(v3.0)은 FP8 모델을 지원하고, Llama·Qwen·DeepSeek·Phi·Gemma 등 대부분의 주요 오픈소스 LLM을 AutoModel을 통해 자동으로 감지해 지원한다. 전체 요약 11문장 읽기 → 013 21:11 당일 +621 문서를 네이티브 파워포인트로 자동 변환하는 AI 도구 AI가 문서·주제를 실제 PowerPoint 파일로 변환하는 오픈소스 도구 PPT Master를 공개했다. AI · 머신러닝 · hugohe3/ppt-master · Python
Key Point PowerPoint의 진짜 객체 모델을 생성해주는 만큼, 편집 가능한 슬라이드를 한 번에 얻을 수 있고—이미지로 평탄화되지 않아 계속 손을 댈 수 있습니다.
핵심 요약
AI가 문서·주제를 실제 PowerPoint 파일로 변환하는 오픈소스 도구 PPT Master를 공개했다. 생성된 슬라이드는 네이티브 도형·전환·애니메이션·데이터 연동 차트·표를 포함하며 PowerPoint에서 그대로 편집할 수 있다. 기존 .pptx 템플릿을 가져와 사용할 수 있으며, 스피커 노트에서 음성 나레이션을 자동 생성한다. 전체 요약 12문장 읽기 → 014 06:11 ▲ 213 · 댓글 124 토큰 40% 줄인 Kimi K3 기반 Ember-1 공개 Fireworks Research가 Kimi K3를 기반으로 한 Ember-1 모델을 공개했으며, 같은 품질을 유지하면서 토큰을 40% 감소시켰다. AI · 머신러닝 · Ember-1
Key Point 추론 토큰이 비용의 대부분을 차지하는 AI 워크로드(특히 에이전트 작업)에서 비용을 획기적으로 줄일 수 있는 방법이 실제로 작동한다는 검증된 사례이기 때문이다.
핵심 요약
Fireworks Research가 Kimi K3를 기반으로 한 Ember-1 모델을 공개했으며, 같은 품질을 유지하면서 토큰을 40% 감소시켰다. K3의 장황한 추론(최대 90% 이상이 내부 추론에 사용)으로 인한 비용 문제를 해결하기 위해, 불필요한 추론은 제거하고 의미 있는 사고만 보존하도록 훈련했다. 이를 위해 50회 이상의 훈련 실험과 200회 이상의 평가를 수행했으며, 추론 토큰을 줄이면서 정확도를 잃지 않기 위한 새로운 훈련 알고리즘을 개발했다. 전체 요약 12문장 읽기 → 015 21:11 당일 +394 AI가 직접 해킹하는 자동 침투 테스트 도구 Strix 오픈소스 공개 Strix는 오픈소스 AI 침투 테스트 도구로, 자율형 AI 해커가 실제 코드를 실행하며 취약점을 찾고 수정하는 기능을 제공한다. 보안 · usestrix/strix · Python
Key Point 정적 분석기의 오탐을 줄이면서 실제 작동하는 PoC로 검증된 취약점만 보고하므로, 수동 침투 테스트의 시간과 비용을 크게 줄일 수 있는 개발팀·보안팀 필수 도구로 떠오르고 있다.
핵심 요약
Strix는 오픈소스 AI 침투 테스트 도구로, 자율형 AI 해커가 실제 코드를 실행하며 취약점을 찾고 수정하는 기능을 제공한다. HTTP 인터셉션, 브라우저 자동화, 쉘 실행, 커스텀 PoC 런타임, 정찰·OSINT 등 실제 전문 침투 테스터가 쓰는 공격 도구 세트를 갖추고 있다. SQL/NoSQL 인젝션, SSRF, XXE, XSS, IDOR, 인증 우회, 비즈니스 로직 결함, API 보안 문제 등 OWASP 상위 10대 취약점과 그 이상을 식별하고 검증한다. 전체 요약 13문장 읽기 → 016 09:11 ▲ 104 · 댓글 44 메타 뮤즈, 내부에서 OpenAI 모델 사용 흔적 발견 메타의 AI 에이전트 뮤즈에서 Avocado라는 메타 내부 모델 외에 azure/muse-special이라는 라벨의 OpenAI 모델이 사용되는 것을 발견했다. AI · 머신러닝 · Meta's Muse appears to use an OpenAI model labeled muse-special
Key Point 메타 뮤즈가 공개적으로 공개하지 않은 OpenAI 모델을 백엔드에서 사용하고 있으며, 메타가 외부 모델의 암호화된 응답을 수집하는 방식이 모델 개발 전략과 사용자 데이터 취급에 대한 기술적 통찰을 제공한다.
핵심 요약
메타의 AI 에이전트 뮤즈에서 Avocado라는 메타 내부 모델 외에 azure/muse-special이라는 라벨의 OpenAI 모델이 사용되는 것을 발견했다. muse-special 세션의 서명에는 gpt_responses_v1 태그와 OpenAI가 사용하는 gAAAAA로 시작하는 암호화 페이로드가 포함되어 있으며, 도구 호출 ID가 OpenAI 형식(call_ 뒤 24자)을 따른다. 뮤즈의 에이전트 데몬에는 Claude Opus/Sonnet/Haiku, GPT-5.5/5.6 변형들, Kimi K3 등 약 15개의 Avocado 버전과 함께 다양한 모델이 탑재되어 있다. 전체 요약 8문장 읽기 → 017 21:11 당일 +129 여러 AI API를 하나로 통합하는 프록시 서버 CLIProxyAPI CLIProxyAPI는 OpenAI, Gemini, Claude, Codex, Grok 호환 API 인터페이스를 제공하는 프록시 서버로, Go 언어로 개발되었습니다. AI · 머신러닝 · router-for-me/CLIProxyAPI · Go
Key Point CLI나 SDK를 통해 여러 AI 모델에 통일된 방식으로 접근하고 싶은 개발자에게 설정 복잡도를 대폭 줄여줍니다.
핵심 요약
CLIProxyAPI는 OpenAI, Gemini, Claude, Codex, Grok 호환 API 인터페이스를 제공하는 프록시 서버로, Go 언어로 개발되었습니다. ChatGPT, Claude Code, Grok Build, Antigravity 등 여러 AI 서비스를 단일 API로 통합하여 접근할 수 있습니다. Kimi K3, GPT-5.6, Claude Fable, Gemini 3.5 Flash, Grok 4.5 등 최신 모델들을 지원하며, 다중 계정 관리 기능을 제공합니다. 전체 요약 5문장 읽기 → 018 03:10 ▲ 136 · 댓글 67 Cognition, 코딩 AI 모델 SWE-2 공개 Cognition이 최신 소프트웨어 엔지니어링 모델 SWE-2를 발표했다. AI · 머신러닝 · Cognition launches new SWE-2 model, Rivaling Fable 5.1 and GPT-Astra
Key Point 소프트웨어 엔지니어링 AI의 성능-비용 경계가 어떻게 달라졌는지, 그리고 이전 모델의 과잉 탐색 문제를 어떻게 해결했는지 알 수 있다.
핵심 요약
Cognition이 최신 소프트웨어 엔지니어링 모델 SWE-2를 발표했다. FrontierCode 1.1 Main에서 50.0% 점수를 기록해 Fable 5.1과 1포인트 차이나며, 비용은 64% 더 저렴하다. 다중 삼조 파라미터 규모에서 강화학습을 처음 적용해 모든 성능-비용 트레이드오프를 최적화했다. 전체 요약 5문장 읽기 → 019 09:10 ▲ 159 · 댓글 65 Qwen 3.8이 GPT-5.5 Pro의 추론 과정을 흡수했다 GPT-5.5 Pro의 추론 시작 부분 1%를 다른 모델에 주입한 후 두 모델의 응답이 얼마나 유사한지 측정하는 실험을 진행했다. AI · 머신러닝 · Qwen 3.8 follows GPT-5.5 Pro reasoning prefills
Key Point 오픈 소스 모델이 대형 상용 모델의 추론 방식을 얼마나 모사할 수 있는지, 특히 학습 데이터의 출처가 무엇인지 보여주는 분석이다.
핵심 요약
GPT-5.5 Pro의 추론 시작 부분 1%를 다른 모델에 주입한 후 두 모델의 응답이 얼마나 유사한지 측정하는 실험을 진행했다. Qwen 3.8은 프리필 없을 때 16.79% 일치도에서 프리필 적용 시 34.97%로 +18.18 포인트 향상되어 가장 큰 변화를 보였다. Kimi K3는 GPT-5.5 Pro와의 기본 일치도가 31.11%로 가장 높지만 프리필의 추가 효과는 4.54 포인트에 불과했다. 전체 요약 5문장 읽기 → 020 08:12 ▲ 211 · 댓글 112 280억 파라미터 Kimi K3를 맥북에서 초당 1토큰 속도로 구동 삼성 M5 Max 맥북 프로(128GB)에서 280억 파라미터 Kimi K3 MoE 모델을 4개 SSD에서 스트리밍하며 초당 1.00토큰의 안정적 디코딩 속도를 달성했다. AI · 머신러닝 · Kimi K3 (2.8T) at 1 token/s on a MacBook Pro, streamed from four SSDs
Key Point 280억 개 파라미터를 가진 대규모 언어모델을 품질 손상 없이 소비자용 하드웨어에서 구동하는 것이 가능함을 보여주며, 가정용 AI 인프라의 현실적 가능성을 시사한다.
핵심 요약
삼성 M5 Max 맥북 프로(128GB)에서 280억 파라미터 Kimi K3 MoE 모델을 4개 SSD에서 스트리밍하며 초당 1.00토큰의 안정적 디코딩 속도를 달성했다. 모델의 1.45TB 전문가 가중치는 SSD에서 동적으로 로드되며, 프리필 단계에서 각 레이어의 전문가를 8배 중복 읽기하면서 약 6.3분의 지연이 발생한다. 기존 공개 벤치마크(0.68토큰/s)보다 43% 빠른 성능을 기록했으며, 드라이브 개수에 따라 1개 52%, 2개 73%, 3개 90%의 속도 향상을 보인다. 전체 요약 5문장 읽기 → 021 20:31 당일 +132 Unsloth, 로컬에서 LLM과 확산 모델 학습할 수 있는 데스크톱 앱 공개 로컬에서 LLM, 확산, 임베딩, 오디오 모델을 실행하고 학습할 수 있으며 Kimi K3, DeepSeek-V4, Gemma 4 등을 지원한다. AI · 머신러닝 · unslothai/unsloth · Python
Key Point 로컬 AI 모델 실행·학습을 간편하게 만드는 도구로서 개발자가 클라우드 비용 없이 자체 서버에서 LLM을 운영할 수 있게 해주는 점이 주목받고 있다.
핵심 요약
로컬에서 LLM, 확산, 임베딩, 오디오 모델을 실행하고 학습할 수 있으며 Kimi K3, DeepSeek-V4, Gemma 4 등을 지원한다. 미세조정 시 학습 속도를 2배 빠르게 하면서 VRAM 사용량을 70% 줄일 수 있고 LoRA, QLoRA, GRPO, DPO 등 다양한 훈련 방식을 지원한다. Tauri 기반 데스크톱 앱으로 제공되며 Windows, macOS, Linux 등 여러 플랫폼을 지원하고 Cloudflare를 통한 원격 접근도 가능하다.