쌓인 기록에서 찾기
무엇을 찾으세요?
날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위부터 2026년 11월 16일 (월)까지4683건
4건 · "LLM 아키텍처"조건 지우기 ×
001▲ 127 · 댓글 3LLM의 위치 정보 처리 방식: RoPE까지 완벽 가이드언어 모델이 토큰의 위치 정보를 인코딩하고 처리하는 방식을 다루는 기술 가이드로, 고전적 방법부터 현대 기법까지 시각 자료와 수식, PyTorch 코드 예제를 통해 설명한다.AI · 머신러닝 · Understanding Positional Embeddings in Modern LLMs
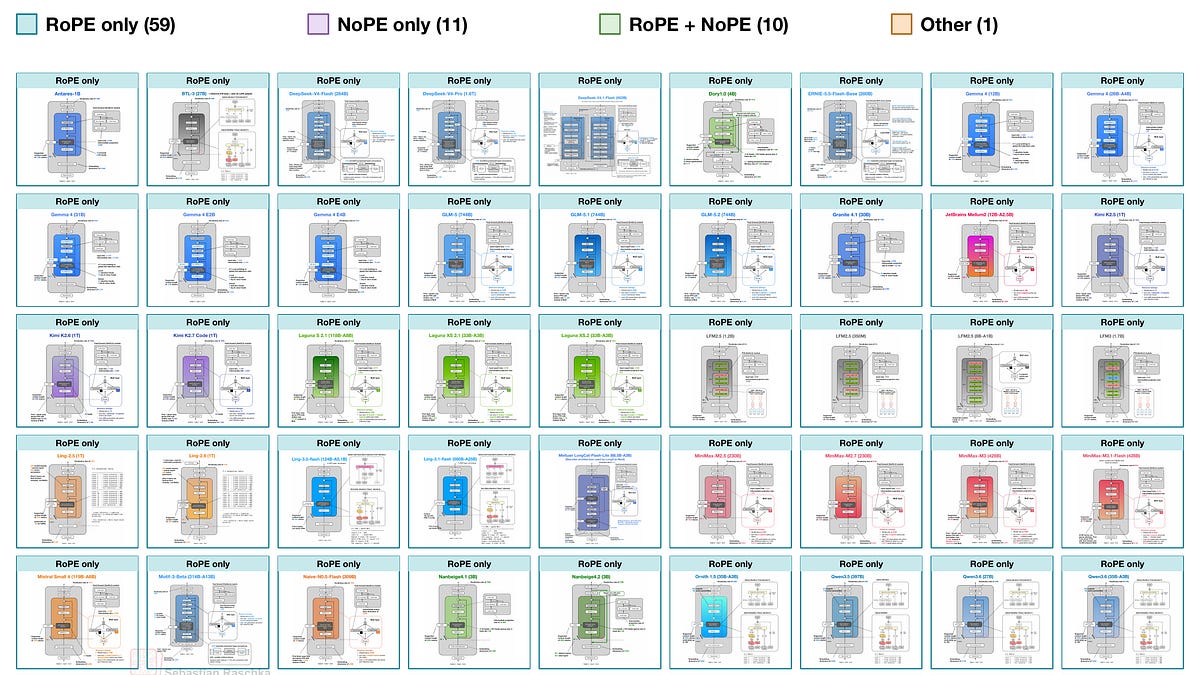
Key Point위치 임베딩은 LLM 아키텍처의 기초 요소이며 GPT-2의 학습된 벡터, 원래 트랜스포머의 사인·코사인 함수, 현대 모델의 RoPE 등 진화 과정을 이해하면 LLM의 작동 원리와 각 아키텍처의 설계 선택을 파악할 수 있다.
핵심 요약
- 언어 모델이 토큰의 위치 정보를 인코딩하고 처리하는 방식을 다루는 기술 가이드로, 고전적 방법부터 현대 기법까지 시각 자료와 수식, PyTorch 코드 예제를 통해 설명한다.
- 토큰 임베딩 계층이 입력 텍스트를 벡터로 변환한 후 위치 정보가 추가되는데, GPT-2는 변환기 블록 전에 위치 벡터를 더하고 MiniMax-M3은 어텐션 내부에서 RoPE 방식으로 위치 정보를 주입한다.
- 같은 토큰이 다른 위치에 나타나도 동일한 임베딩을 받으므로 명시적 위치 정보가 필요하며, 인과 마스크만으로도 암묵적 순서 정보를 제공하지만 위치 간 거리 차이를 구별하지 못한다.
전체 요약 8문장 읽기 →AI · 머신러닝 · DepthGraft: Structural Regularization through Hierarchical Cross-Layer KV Reconstruction

Key Point모델의 깊이를 키우면서 정보 손실을 막고 캐시를 줄일 수 있는 구조적 기법이 제시되어, 더 효율적인 초대형 언어모델 개발에 실질적 가능성을 보여준다.
핵심 요약
- LLM 규모를 키우기 위해 모델 깊이를 늘리면 Pre-LN 아키텍처에서 정보가 각 계층을 지나며 희석되어 깊은 계층이 제대로 학습되지 못하는 문제가 발생한다.
- 교차 계층 연결은 이 문제를 완화하지만 기존 방식은 계산이나 메모리 접근을 추가로 늘린다.
- 연구팀은 교차 계층 KV(Key-Value) 공유 방식을 효율적인 연결 방법으로 재검토했으며, KV 재사용이 깊은 계층에서 얕은-중간 계층의 KV 생성으로 직접 기울기 경로를 만들어 KV 표현 구조를 정규화한다는 점을 발견했다.
전체 요약 9문장 읽기 →AI · 머신러닝 · Infinite-Parameter LLMs: Generating and Adapting Weights from Live Data

Key PointLLM이 배포 후 사용자 상호작용 데이터를 학습하는 방식의 근본적 전환을 제시해, 미세조정 없이 동적 적응을 추구하는 개발자와 연구자에게 새로운 설계 방향을 제공한다.
핵심 요약
- 정적 사전학습 데이터 대신 실시간 상호작용 데이터로부터 모델 가중치를 생성하는 '무한-파라미터 LLM'이 제안됐다.
- 하이퍼네트워크가 사용자 입력이나 정정 같은 런타임 데이터를 공유 기본 네트워크의 저랭크 변조로 변환해 가중치를 동적으로 생성한다.
- 베이지안 신념으로 생성기의 잠재 코드를 추적해 세션 진행 중 가중치를 재계산하므로, 한 번만 읽고 고정하던 방식과 달라진다.
전체 요약 5문장 읽기 →AI · 머신러닝 · OpenArch – PyTorch implementations of modern LLM architectures

Key PointLLM 아키텍처의 세부 설계 차이를 명확히 읽고 비교하고 싶은 개발자라면, 프로덕션 코드의 복잡성 없이 각 선택지가 어떻게 구현되는지 바로 확인할 수 있다.
핵심 요약
- 최신 오픈소스 LLM들의 PyTorch 구현을 처음부터 손으로 직접 작성한 저장소로, 각 모델은 원논문과 기술 보고서를 참고해 구성했다.
- GPT-2, Llama 2/3/4, Qwen, Mistral, DeepSeek R1 등 11개 텍스트 모델과 PaliGemma, Qwen3 등 멀티모달 모델을 구현 중이며, 추가로 72개 아키텍처 전체 구현을 목표로 한다.
- 주의 메커니즘(MHA, GQA, MQA, MLA), 정규화(RMSNorm, QK-Norm), 위치 인코딩(RoPE, NoPE), MoE 라우팅 등 현대 LLM들이 사용하는 구조적 선택지를 명시적으로 표현해 비교하기 쉽게 했다.
전체 요약 5문장 읽기 →