쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 4일 (수)까지 3942건
16건 · "게임 AI"조건 지우기 ×
001 06:11 ▲ 1,031 · 댓글 320 GPT-6 Astra가 신경망 가중치를 읽고 수정해 모델 성능 개선 최신 LLM이 신경망 가중치를 직접 읽고 쓸 수 있는 'Weight-Space Programming' 기법을 연구한 결과를 공개했다. AI · 머신러닝 · Astra can read and write weights to improve Qwen
Key Point LLM이 신경망 최적화라는 미분 불가능한 영역에 직접 개입할 수 있다는 것을 처음 대규모로 입증하며, 향후 해석 가능성과 모델 튜닝 방식에 근본적 변화를 가져올 가능성을 시사한다.
핵심 요약
최신 LLM이 신경망 가중치를 직접 읽고 쓸 수 있는 'Weight-Space Programming' 기법을 연구한 결과를 공개했다. GPT-6 Astra는 게임 플레이 정책의 가중치만 보고 어떤 게임인지 식별했으며, 환경 피드백 없이도 PPO로 1억 스텝 학습한 네트워크보다 강한 게임 AI를 처음부터 작성했다. Qwen3.5-0.8B의 수학 추론을 개선하기 위해 Astra는 반복 루프를 유발하는 가중치 방향을 찾아 8억 개 중 0.016%(13만 1,072개)만 수정했다. 전체 요약 8문장 읽기 → 002 15:11 ▲ 27 · 댓글 2 실시간 게임 월드를 자유롭게 조종하는 AI 에이전트 'Wizard' 비디오 월드 모델의 발전으로 게이머가 커스터마이징할 수 있는 인터랙티브 가상 환경 생성이 가능해졌지만, 기존 접근법은 단순한 게임 설정만 지원하고 새로운 환경과 캐릭터에 제대로 일반화되지 않으며 실시간 인터랙션이 제한적이었다. AI · 머신러닝 · Wizard: Manipulate Any World in Real Time via Agentic Control
Key Point 기존 게임 AI는 특정 환경·캐릭터에만 작동했지만, Wizard는 학습하지 않은 상황에서도 작동하며 플레이어가 실시간으로 게임 세계를 조종할 수 있어 게임 생성 AI의 상용화 가능성을 크게 높인다.
핵심 요약
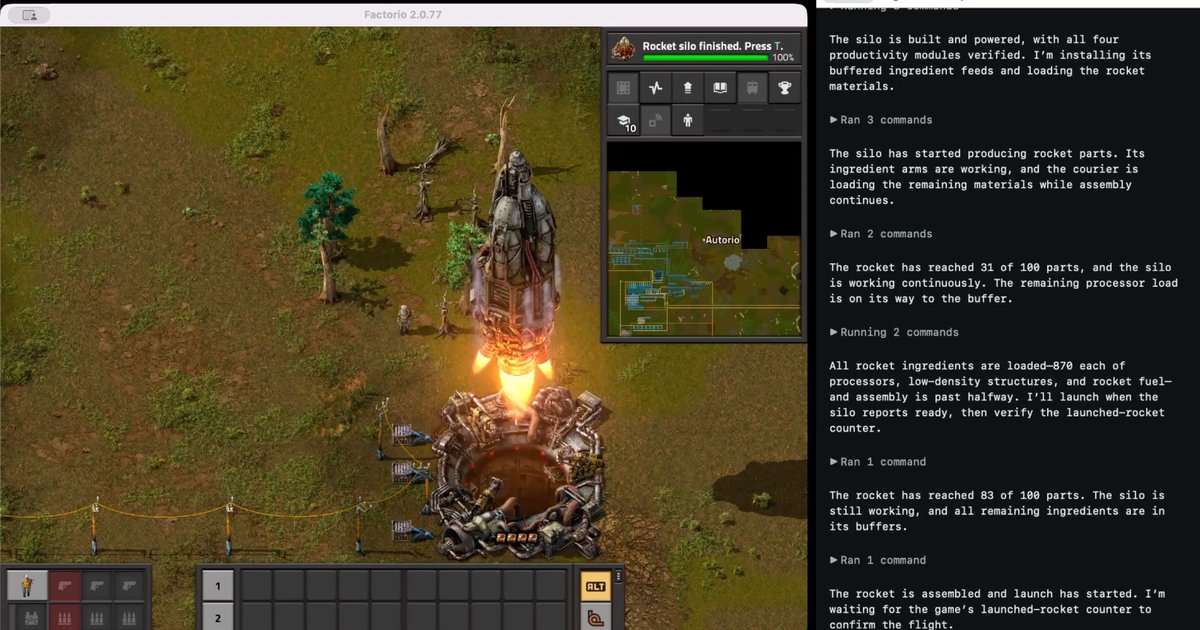
비디오 월드 모델의 발전으로 게이머가 커스터마이징할 수 있는 인터랙티브 가상 환경 생성이 가능해졌지만, 기존 접근법은 단순한 게임 설정만 지원하고 새로운 환경과 캐릭터에 제대로 일반화되지 않으며 실시간 인터랙션이 제한적이었다. Wizard는 에이전틱 게임 월드 모델로서 캐릭터 모션을 실시간으로 정밀하게 제어하면서도 미학습 장면, 캐릭터, 행동에 대해 영점 일반화(zero-shot generalization)를 달성한다. 750개 장면과 178개 캐릭터를 포함하는 다양한 데이터셋을 구축했으며, 이들에 스켈레톤과 지오메트리 정보 같은 구조화된 표현을 포함시켰다. 전체 요약 6문장 읽기 → 003 06:11 ▲ 109 · 댓글 108 GPT-4o가 팩토리오 평화모드 클리어 저자가 GPT-5.6 Sol 모델을 Codex에서 낮은 사고 수준으로 실행하여 13.5시간의 게임 시간으로 팩토리오 평화모드(생물 무적) 완주에 성공했다. AI · 머신러닝 · GPT-5.6 Sol can beat Factorio on peaceful mode
Key Point 최신 LLM이 복잡한 실시간 전략 게임을 자율적으로 플레이하고 완주한 첫 사례로, 모델의 실제 문제 해결 능력과 한계를 구체적으로 보여주는 벤치마크입니다.
핵심 요약
저자가 GPT-5.6 Sol 모델을 Codex에서 낮은 사고 수준으로 실행하여 13.5시간의 게임 시간으로 팩토리오 평화모드(생물 무적) 완주에 성공했다. 게임 매니저를 통해 모델이 Python 라이브러리를 사용해 프로그래밍 방식으로 게임을 플레이했으며, GUI 사용자와 동일한 제약(플레이어 도달 거리, 안개 기능)을 적용했다. 모델은 일부 영역에서는 기대를 초과했으나 명확한 약점도 보였고, 전체 런이 기록되어 해설 영상 제작 중이다. 전체 요약 8문장 읽기 → 004 03:11 ▲ 28 · 댓글 2 LLM 연구 에이전트가 만든 하스스톤 AI, 최상위 플레이어 능가 LLM 연구 에이전트들로 구성된 자기개선 시스템 AutoTavern이 8인 자동배틀게임 하스스톤 배틀그라운드의 완전한 시뮬레이터를 20일 만에 개발했다. AI · 머신러닝 · Build, Don't Play: Self-Improving LLM Research Agents Develop a Hearthstone Battlegrounds AI That Rivals Top Players
Key Point LLM 에이전트가 자동 개선 루프를 통해 최첨단 게임 AI를 개발하고 인간 최강자를 능가한 사례로, 에이전트 연구의 현실적 가능성과 한계를 보여줍니다.
핵심 요약
LLM 연구 에이전트들로 구성된 자기개선 시스템 AutoTavern이 8인 자동배틀게임 하스스톤 배틀그라운드의 완전한 시뮬레이터를 20일 만에 개발했다. AutoTavern은 특화된 LLM 에이전트들이 타입화된 연구 메모리를 공유하고, 모든 주장이 검증 단계를 거치며, 실제 게임을 통해 피드백 루프가 닫혀 있어 시뮬레이터, 상대 AI, 정책, 연구 과정까지 동시에 개선된다. TavernAgent는 PPO로 학습되어 23개 버전을 거쳤으며, 실제 게임 래더에서 등급이 6,000에서 약 15,000으로 올랐다. 전체 요약 7문장 읽기 → 005 15:11 ▲ 55 · 댓글 4 마인크래프트 정복하는 비전 언어 행동 에이전트 마인크래프트 같은 개방형 게임에서 인간처럼 행동하는 자율 에이전트를 만들기 위해 장기적 계획과 네이티브 인터페이스 조작을 모두 필요로 한다. AI · 머신러닝 · HiSTEVE 1.0: Harnessing Human-Interface VLA Agents for Open-World Games
Key Point 실제 마인크래프트 환경에서 인간 수준의 자율 행동을 보이는 에이전트가 처음 실현되었으며, 이는 게임 AI뿐 아니라 로봇 제어, 업무 자동화 등 복잡한 실제 환경에서의 에이전트 설계 방식을 재정의할 수 있다.
핵심 요약
마인크래프트 같은 개방형 게임에서 인간처럼 행동하는 자율 에이전트를 만들기 위해 장기적 계획과 네이티브 인터페이스 조작을 모두 필요로 한다. HiSTEVE는 계층적 VLA 에이전트로, 상위 수준의 조율 계층과 하위 수준의 제어 계층으로 구성되어 있다. 조율 계층은 구조화된 메모리로 진행상황을 추적하고 VLM 플래너로 수행 가능한 부작업을 선택하며, 정책 기반 작업 완료 감지기로 부작업 완료 여부를 판단한다. 전체 요약 7문장 읽기 → 006 12:11 ▲ 224 · 댓글 185 AI가 이전 불가능했던 소프트웨어를 현실로 만든다 AI 능력의 급격한 향상으로 이전엔 비용이 너무 커서 시도하지 않던 소프트웨어 프로젝트들이 이제 실현 가능해졌다. AI · 머신러닝 · We should be more ambitious with the software we build
Key Point AI 모델의 성능 급증으로 불가능했던 소프트웨어 개발이 현실화되는 한편, 누가, 어떤 조건에서 이를 활용할 수 있는지가 핵심 관심사다.
핵심 요약
AI 능력의 급격한 향상으로 이전엔 비용이 너무 커서 시도하지 않던 소프트웨어 프로젝트들이 이제 실현 가능해졌다. PostgreSQL을 Rust로 재작성하는 pgrust 프로젝트는 철저한 테스트 과정에서 PostgreSQL 내 수치 버그, JSONPath 포맷 캐시 버그, 메모리 안전 버그 등 여러 실제 버그를 발견했으며, 성능 최적화에 초점을 맞추고 있다. 저자는 정규표현식 엔진, ripgrep 포크, Rust 컴파일 속도 개선 도구 등을 몇 시간 내에 구현했는데, 5년 전이라면 1년 이상 걸렸을 작업들이다. 전체 요약 10문장 읽기 → 007 03:11 ▲ 17 · 댓글 1 언어로 조종하는 무한 3D 월드, 실시간으로 생성된다 WorldStream은 자유로운 언어 명령에 따라 3D 세계를 무한으로 확장하면서 방문했던 장소의 편집 내용을 보존하는 오픈엔디드 월드 모델을 제시한다. AI · 머신러닝 · WorldStream: Streaming Interactive 3D Worlds with Hierarchical Planning and Persistent State
Key Point LLM과 3D 생성 모델을 결합해 게임·메타버스 같은 대규모 인터랙티브 환경을 실시간으로 만드는 기술이 가능함을 보여주는 논문으로, 생성형 AI의 게임·시뮬레이션 분야 응용 가능성을 확인할 수 있다.
핵심 요약
WorldStream은 자유로운 언어 명령에 따라 3D 세계를 무한으로 확장하면서 방문했던 장소의 편집 내용을 보존하는 오픈엔디드 월드 모델을 제시한다. 계층적 플래너가 거시(Macro) 단계에서 타일 그룹 전체의 정착지·생태·교통·수문 구조를 결정하고, 미시(Micro) 단계에서 지형과 이웃 타일의 제약을 반영해 각 타일의 의미론적 세부를 구체화한다. 결정된 계획은 결정론적 로컬 코드로 컴파일되어 지형·도로·정착촌·식생·개체를 생성하며, 스트리밍 방식으로 사용자 이동 경로 앞쪽에서만 계획과 컴파일을 실행해 메모리를 절감한다. 전체 요약 6문장 읽기 → 008 03:12 ▲ 13 · 댓글 1 영상 세계 모델, 프레임률을 자유롭게 조절하다 기존 영상 기반 인터랙티브 세계 모델은 고정된 시간 속도로만 학습·생성되어, 실행 속도가 다르면 의도와 달리 느리거나 빠르게 진행되는 문제가 있었다. AI · 머신러닝 · RAR: Rate-Adaptive Rollout for Time-Consistent Interactive World Models
Key Point 세계 모델의 기본 제약인 프레임률 고정 문제를 해결하면 더 유연한 실시간 시뮬레이션과 로봇·게임 AI 개발이 가능해진다.
핵심 요약
기존 영상 기반 인터랙티브 세계 모델은 고정된 시간 속도로만 학습·생성되어, 실행 속도가 다르면 의도와 달리 느리거나 빠르게 진행되는 문제가 있었다. 또한 단일 프레임률로는 정교한 모션 캡처와 긴 시간 지평 사이의 트레이드오프를 피할 수 없었다: 높은 프레임률은 미세한 움직임을 포착하지만 컨텍스트 윈도우 내에서 짧은 기간만 커버한다. 논문이 제시하는 RAR(Rate-Adaptive Rollout)은 세계 모델이 제어 가능한 시간 속도로 생성할 수 있게 한다. 전체 요약 7문장 읽기 → 009 15:11 ▲ 283 · 댓글 2 게임 AI 학습을 위한 합성 경험 기반 강화학습 프레임워크 Player-1 화면 해석과 키보드·마우스 조작을 수행하는 컴퓨터 사용 에이전트는 발전했으나, 시각적으로 풍부하고 복잡한 게임 환경은 여전히 도전 과제로 남아 있습니다. AI · 머신러닝 · Player-1: Learning to Play from Synthetic Experience
Key Point 게임 AI의 성능 개선이 실제 환경 데모 없이 합성 환경만으로 달성 가능함을 보여줌으로써, 대규모 데이터 수집 없이 일반적 디지털 제어 에이전트를 학습할 수 있는 길을 열었습니다.
핵심 요약
화면 해석과 키보드·마우스 조작을 수행하는 컴퓨터 사용 에이전트는 발전했으나, 시각적으로 풍부하고 복잡한 게임 환경은 여전히 도전 과제로 남아 있습니다. 기존 게임 에이전트 학습 파이프라인은 제한된 동적 게임 상태 커버리지의 대규모 데모에 의존하며, 상호작용 학습을 위한 확장 가능한 환경 구축이 어렵습니다. Player-1은 합성 경험을 통해 데모 이상의 게임 제어를 학습하는 포스트 트레이닝 프레임워크로, 상대적 포인터 모션, 지속적 입력, 복합 액션으로 컴퓨터 사용 액션 공간을 확장합니다. 전체 요약 9문장 읽기 → 010 18:12 ▲ 44 · 댓글 2 AI 에이전트, 게임 경쟁으로 전략 학습하는 방식 평가 대전 게임에서 AI 에이전트가 모델 가중치는 고정한 채 게임 정책을 자동으로 개선하는 적대적 휴리스틱 학습(AHL) 패러다임을 제안했다. AI · 머신러닝 · Can AI Agents Learn Their Way to the Top? Evaluating Heuristic Learning in a Long-Running Game Agent Competition
Key Point 모델 가중치를 고정하면서 게임을 통해 정책을 학습·개선하는 새로운 AI 학습 방식이 실제 게임 경쟁에서 어느 수준인지 보여주는 첫 대규모 평가로, 에이전트의 한계와 가능성을 함께 드러낸다.
핵심 요약
대전 게임에서 AI 에이전트가 모델 가중치는 고정한 채 게임 정책을 자동으로 개선하는 적대적 휴리스틱 학습(AHL) 패러다임을 제안했다. 12개 실제 대전 게임과 1,920개 보관된 인간 프로그램을 포함한 AAArena 벤치마크를 구축하고, 실제 게임 대회를 모델로 한 평가 프로토콜을 적용했다. 에이전트는 규칙을 해석하고 상대를 선택한 후 리플레이를 분석하며 경기와 평가 예산 내에서 최고 순위 달성을 목표로 게임 에이전트를 수정했다. 전체 요약 7문장 읽기 → 011 18:30 ▲ 84 · 댓글 2 AI가 재미있는 게임을 만든다: 재귀적 평가 루프로 프로토타입을 완성작으로 기존 게임 개발 에이전트는 실행 가능한 게임을 만들지만, 프로그램 정확성만으로는 플레이어에게 재미있는 경험을 보장하지 못한다. AI · 머신러닝 · Recursive Game Creator: An Agentic Product-Level Experience-Oriented Game Harness
Key Point 게임 개발 AI가 단순히 '동작하는' 게임을 넘어 '재미있는' 게임을 만드는 구체적 방법론을 제시해, 에이전트 기반 창작 도구의 평가 기준을 바꾼다.
핵심 요약
기존 게임 개발 에이전트는 실행 가능한 게임을 만들지만, 프로그램 정확성만으로는 플레이어에게 재미있는 경험을 보장하지 못한다. Recursive Game Creator는 Designer, Builder, Player, Reviewer 네 개 컴포넌트로 프로토타입을 재귀적으로 개선해 완성도 높은 게임으로 발전시킨다. Designer는 사용자 지시사항과 Reviewer의 피드백을 구체적 계획으로 변환하고, Builder가 이를 게임 후보로 구현한다. 전체 요약 7문장 읽기 → 012 03:11 ▲ 31 · 댓글 2 체스를 두면서 수를 설명하는 언어모델 'Queen' 공개 기존 체스 엔진은 초인적 수준으로 두지만 수의 이유를 설명하지 못하고, 언어모델은 설명은 가능하지만 두는 실력이 약하다는 문제를 해결한 4B 파라미터 크기의 Queen 모델을 소개했다. AI · 머신러닝 · Language Models that Play Chess and Explain Their Moves
Key Point 전문 모델의 강력한 성능과 언어모델의 설명 능력을 결합하는 새로운 아키텍처로, 체스를 넘어 로봇, 게임 AI 등 여러 도메인에 적용할 수 있는 일반적 프레임워크를 제시한다.
핵심 요약
기존 체스 엔진은 초인적 수준으로 두지만 수의 이유를 설명하지 못하고, 언어모델은 설명은 가능하지만 두는 실력이 약하다는 문제를 해결한 4B 파라미터 크기의 Queen 모델을 소개했다. Queen은 인코더-디코더 아키텍처와 반복적 증류 알고리즘을 결합한 프레임워크를 사용하며, 침묵하는 체스 엔코더를 크로스-어텐션으로 명령어 튜닝된 언어모델과 통합한다. Q&A 커리큘럼을 통해 엔코더의 표현에서 체스 개념을 추출하도록 학습했으며, 벨만 업데이트의 자연어 유사형식으로 설명을 반복 개선한다. 전체 요약 7문장 읽기 → 013 16:56 ▲ 159 · 댓글 75 숨겨진 정보 게임 스트래테고, AI가 인류 최강자 제압 스트래테고는 체스·바둑·포커처럼 AI가 도전해온 게임이지만, 거대한 숨겨진 정보와 2,000수 이상의 긴 게임 길이 때문에 DeepMind도 해결하지 못했다. AI · 머신러닝 · With most information hidden, the game Stratego had stumped AI until now
Key Point AI 연구에서 오랫동안 미해결로 남던 문제를 해결했으며, 막대한 자원 없이도 최강자를 이길 수 있음을 보였기 때문이다.
핵심 요약
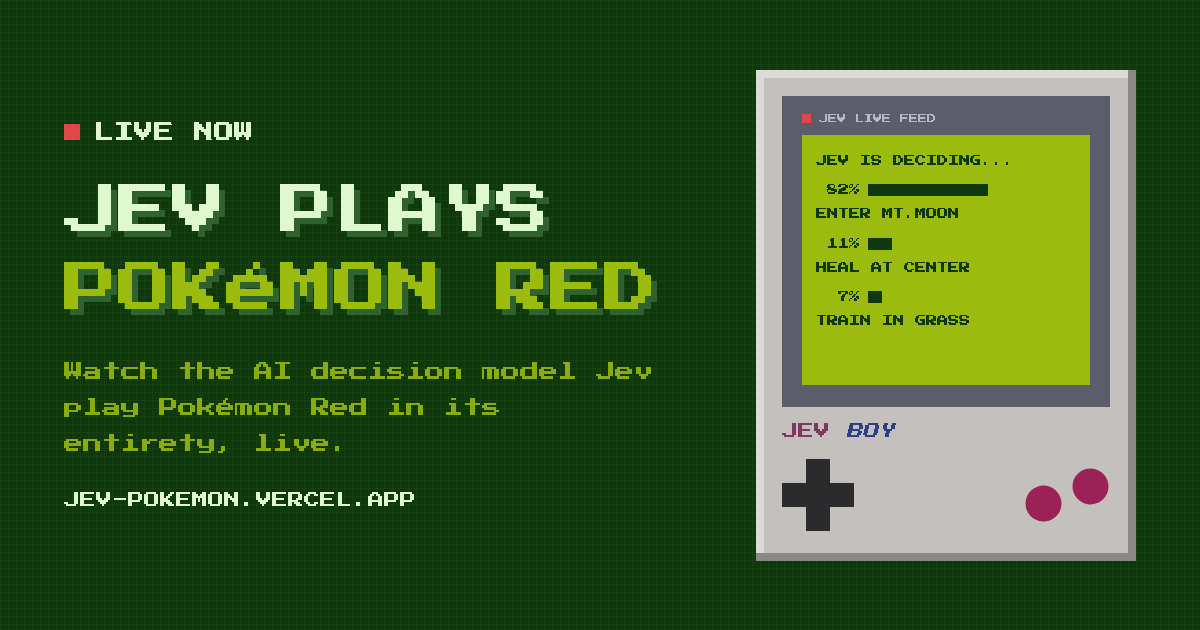
스트래테고는 체스·바둑·포커처럼 AI가 도전해온 게임이지만, 거대한 숨겨진 정보와 2,000수 이상의 긴 게임 길이 때문에 DeepMind도 해결하지 못했다. 카네기멜론·MIT·NYU·스탠포드 연구팀이 개발한 AI 아타락소스는 역대 최강자 핌 니메이예르를 20게임 중 15승 1패 4무로 압도했다. 스트래테고는 40개 피스의 조합이 데실리언 가지에 달하고, 블러핑이 핵심이라 기존 AI들이 전략을 찾기 어려웠다. 전체 요약 12문장 읽기 → 014 09:11 ▲ 126 · 댓글 60 JEV: AI가 포켓몬 레드를 플레이한다 AI 어시스턴트 JEV가 포켓몬 레드를 자동으로 플레이하는 라이브 스트림이다. AI · 머신러닝 · Show HN: Jev Plays Pokémon Red
Key Point AI가 비디오 게임을 실시간으로 플레이하는 방식과 의사결정 과정을 실제로 시연한 사례로, AI의 게임 플레이 능력과 결정 과정의 투명성을 보여준다.
핵심 요약
AI 어시스턴트 JEV가 포켓몬 레드를 자동으로 플레이하는 라이브 스트림이다. 오른쪽 패널에는 JEV가 내린 모든 결정 내용과 각 행동의 확률이 표시된다. JEV는 게임 진행을 위해 별도의 가이드 정보를 활용하여 다음 단계를 파악한다. 전체 요약 5문장 읽기 → 015 16:18 ▲ 129 · 댓글 3 게임 AI의 능력을 평가하는 대규모 벤치마크 공개 게임 플레이 능력을 다양한 시간 범위에서 측정하는 GameHorizon Suite를 개발했다. AI · 머신러닝 · GameHorizon Suite: Multi-Horizon Data and Evaluation in Gameplay
Key Point 게임을 통해 AI의 비전, 지시 분해, 계획, 제어 능력을 체계적으로 평가하는 첫 번째 대규모 표준화 벤치마크로, 멀티모달 AI 모델 발전의 객관적 척도가 된다.
핵심 요약
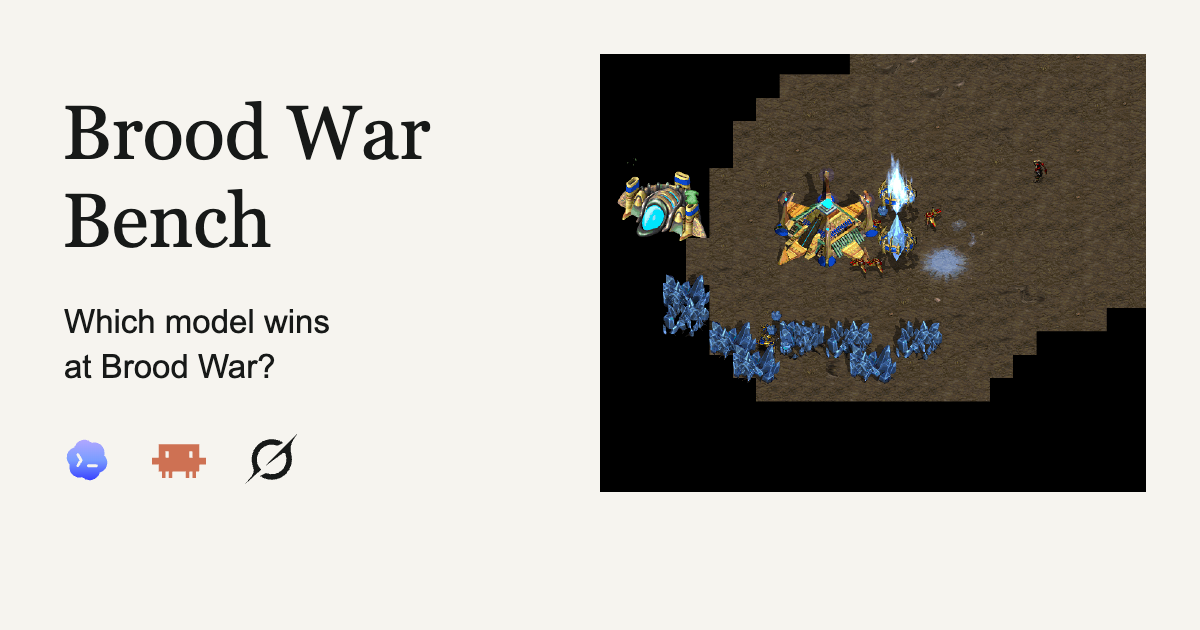
게임 플레이 능력을 다양한 시간 범위에서 측정하는 GameHorizon Suite를 개발했다. 21개 게임의 5,000시간 녹화본, 100명 전문가 플레이어의 행동, 다중 수준 지시문으로 구성된 대규모 데이터세트를 구축했다. 오프라인 평가는 표준화된 문제로 재현 가능하고, 온라인 평가는 실제 게임플레이 능력을 검증한다. 전체 요약 5문장 읽기 → 016 09:10 ▲ 125 · 댓글 63 AI 모델 스타크래프트 실력 평가, Codex Astra 압승 다양한 AI 모델을 스타크래프트 브루드 워에서 대결시켜 게임 실력을 평가한 벤치마크 결과를 공개했다. AI · 머신러닝 · Brood War Bench
Key Point 현재의 LLM들이 실시간 전략 게임을 얼마나 잘 플레이할 수 있는지, 그리고 모델별로 어떤 약점(전술 구성, 경제 관리, 실시간 의사결정)이 있는지 직관적으로 보여준다.
핵심 요약
다양한 AI 모델을 스타크래프트 브루드 워에서 대결시켜 게임 실력을 평가한 벤치마크 결과를 공개했다. Codex Astra가 100% 승률로 1위를 차지했고, Claude Fable이 83.3% 승률로 3위에 올랐으나, Grok 모델은 11.1% 이하 낮은 성능을 보였다. 대부분의 모델이 초급 수준에 머물렀으며, 구체적으로는 기술 트리 발전 미흡, 유닛 개별 투입(한 번에 하나씩 보내기), 경제 운영 실패 등의 문제를 드러냈다. 전체 요약 5문장 읽기 →