쌓인 기록에서 찾기
무엇을 찾으세요?
날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위부터 2026년 10월 30일 (금)까지3636건
16건 · "음성 AI"조건 지우기 ×
001▲ 190 · 댓글 80음성 데이터만으로 학습한 실시간 양방향 대화 AI 'Dessa' 공개Block의 AI 연구팀이 Dessa를 공개했으며, 이는 음성-음성 변환 방식의 완전한 양방향(full-duplex) 대화 모델이다.AI · 머신러닝 · Dessa: the most authentic full-duplex speech model ever built

Key Point음성을 텍스트로 변환하지 않고 원음만으로 AI를 학습시키는 새로운 방식이 실현되었으며, 감정과 뉘앙스를 보존한 더 자연스러운 음성 AI 상호작용이 가능해졌다.
핵심 요약
- Block의 AI 연구팀이 Dessa를 공개했으며, 이는 음성-음성 변환 방식의 완전한 양방향(full-duplex) 대화 모델이다.
- 기존 음성 AI와 달리 음성을 텍스트로 변환하지 않고 원본 오디오 데이터만으로 학습했다.
- 감정, 억양, 웃음, 숨 쉬는 소리, 풍자 등 텍스트로는 손실되는 음성의 뉘앙스를 모두 보존한다.
전체 요약 9문장 읽기 →AI · 머신러닝 · RubatoCodec: Budgeted Adaptive Speech Tokenization with Streaming Decoding

Key Point저대역폭 음성 생성에서 품질과 안정성을 동시에 확보하는 새로운 접근법으로, 음성 AI 모델 개발자들이 토큰 예산을 명확히 제어하면서도 높은 음질을 유지할 수 있게 한다.
핵심 요약
- 신경망 기반 음성 코덱은 음성을 이산 토큰으로 변환하는데, 프레임 레이트가 낮을수록 토큰 시퀀스가 짧아지지만 각 토큰이 더 많은 정보를 담아야 한다.
- 기존 가변 프레임 레이트 코덱은 임계값 기반 할당으로 콘텐츠에 따라 토큰 개수가 달라져 생성 모델이 예측해야 할 시퀀스 길이가 불안정하다.
- RubatoCodec은 X-Codec-2 기반의 가변 프레임 레이트 음성 코덱으로, 발화 단위의 명시적 이벤트 예산과 스트리밍 디코딩을 지원한다.
전체 요약 10문장 읽기 →AI · 머신러닝 · Voxtral 3
Key Point음성 AI 에이전트는 콜센터·가상 비서·자동화 시스템에서 실제 운영되는 필수 기술인데, 이전까지는 낮은 정확도와 부자연스러운 응답이 문제였다. Voxtral 3은 저렴한 가격에 다국어·고감정 표현 능력으로 프로덕션 레벨의 음성 에이전트 구축을 현실화한다.
핵심 요약
- 미스트랄이 음성 에이전트 SDK와 음성 모델 Voxtral 3을 발표했다.
- 음성 인식, 추론, 도구 호출, 음성 생성을 하나의 실시간 스트리밍 파이프라인으로 통합한다.
- 음성-텍스트 모델 Voxtral Transcribe 3은 50개 이상 언어 지원, 화자 분석(diarization), 문맥 기반 정확도 향상(context-biasing), 발화 종료 감지 기능을 제공한다.
전체 요약 10문장 읽기 →하드웨어 · 시스템 · 78/xiaozhi-esp32 · C++

Key PointESP32 기반 오픈소스 음성 AI 로봇으로 Qwen/DeepSeek 같은 최신 대형언어모델을 임베디드 환경에서 구현하는 방식과 138개 보드 변형으로의 확장성을 보여준다.
핵심 요약
- XiaoZhi는 Qwen/DeepSeek 같은 대형 언어모델을 활용한 음성 대화 AI 로봇으로, MCP 프로토콜을 통해 다중 단말 제어를 지원한다.
- Wi-Fi, 유선 이더넷, USB RNDIS, Cat.1 4G 등 다양한 네트워킹을 지원하며 보드에 따라 Wi-Fi와 4G 사이 전환이 가능하다.
- ESP-SR을 활용한 오프라인 음성 웨이크업, WebSocket과 MQTT+UDP 두 가지 통신 방식, Opus 음성 스트리밍, AEC 지원 기기의 실시간 전이중 상호작용을 제공한다.
전체 요약 12문장 읽기 →AI · 머신러닝 · NVIDIA/personaplex · Python

Key PointNVIDIA의 실시간 양방향 음성 모델이 텍스트 프롬프트로 페르소나를 제어할 수 있다는 점이 음성 AI의 커스터마이제이션 수준을 크게 높이며, 오픈소스 공개로 즉시 활용 가능하다.
핵심 요약
- NVIDIA가 Moshi 아키텍처 기반의 실시간 풀 듀플렉스 음성 대화 모델 PersonaPlex를 공개했다.
- 텍스트 기반 역할 프롬프트와 오디오 기반 음성 조건화를 통해 페르소나 제어가 가능하며, 합성 및 실제 대화 데이터로 학습되어 자연스럽고 저지연 음성 상호작용을 생성한다.
- 모델은 HuggingFace에서 personaplex-7b-v1로 제공되며, MIT 라이선스 코드와 NVIDIA Open Model 라이선스 가중치로 배포된다.
전체 요약 7문장 읽기 →AI · 머신러닝 · Do Audio LLMs Listen Before They Act? Diagnosing Acoustic-Context Gating in Voice Agents

Key Point음성 에이전트가 의도한 사용자의 명령만 수행하고 옆사람의 말은 무시해야 하는데, 현재 모델들이 대부분 이를 제대로 못 하고 있다는 점을 실증적으로 보여준다.
핵심 요약
- 음성 LLM은 음성 명령을 인식하고 도구를 실행할 수 있지만, 먼저 현재 음향 및 대화 맥락이 행동을 정당화하는지 판단해야 한다.
- 연구팀은 VGBench라는 1,018개 항목의 진단 벤치마크를 제시했으며, 옆에서의 대화, 혼잣말, 화자 전환 시나리오에서 행동 수준의 적절성을 평가한다.
- 각 항목은 침묵, 도구 호출, 자연어 응답으로 구성된 공유 행동 공간을 사용하며, 화자 전환 쌍은 음원 거리 및 시간 경계를 제어하면서 착용자에서 방관자로의 전환을 테스트한다.
전체 요약 8문장 읽기 →하드웨어 · 시스템 · Muse Gadgets
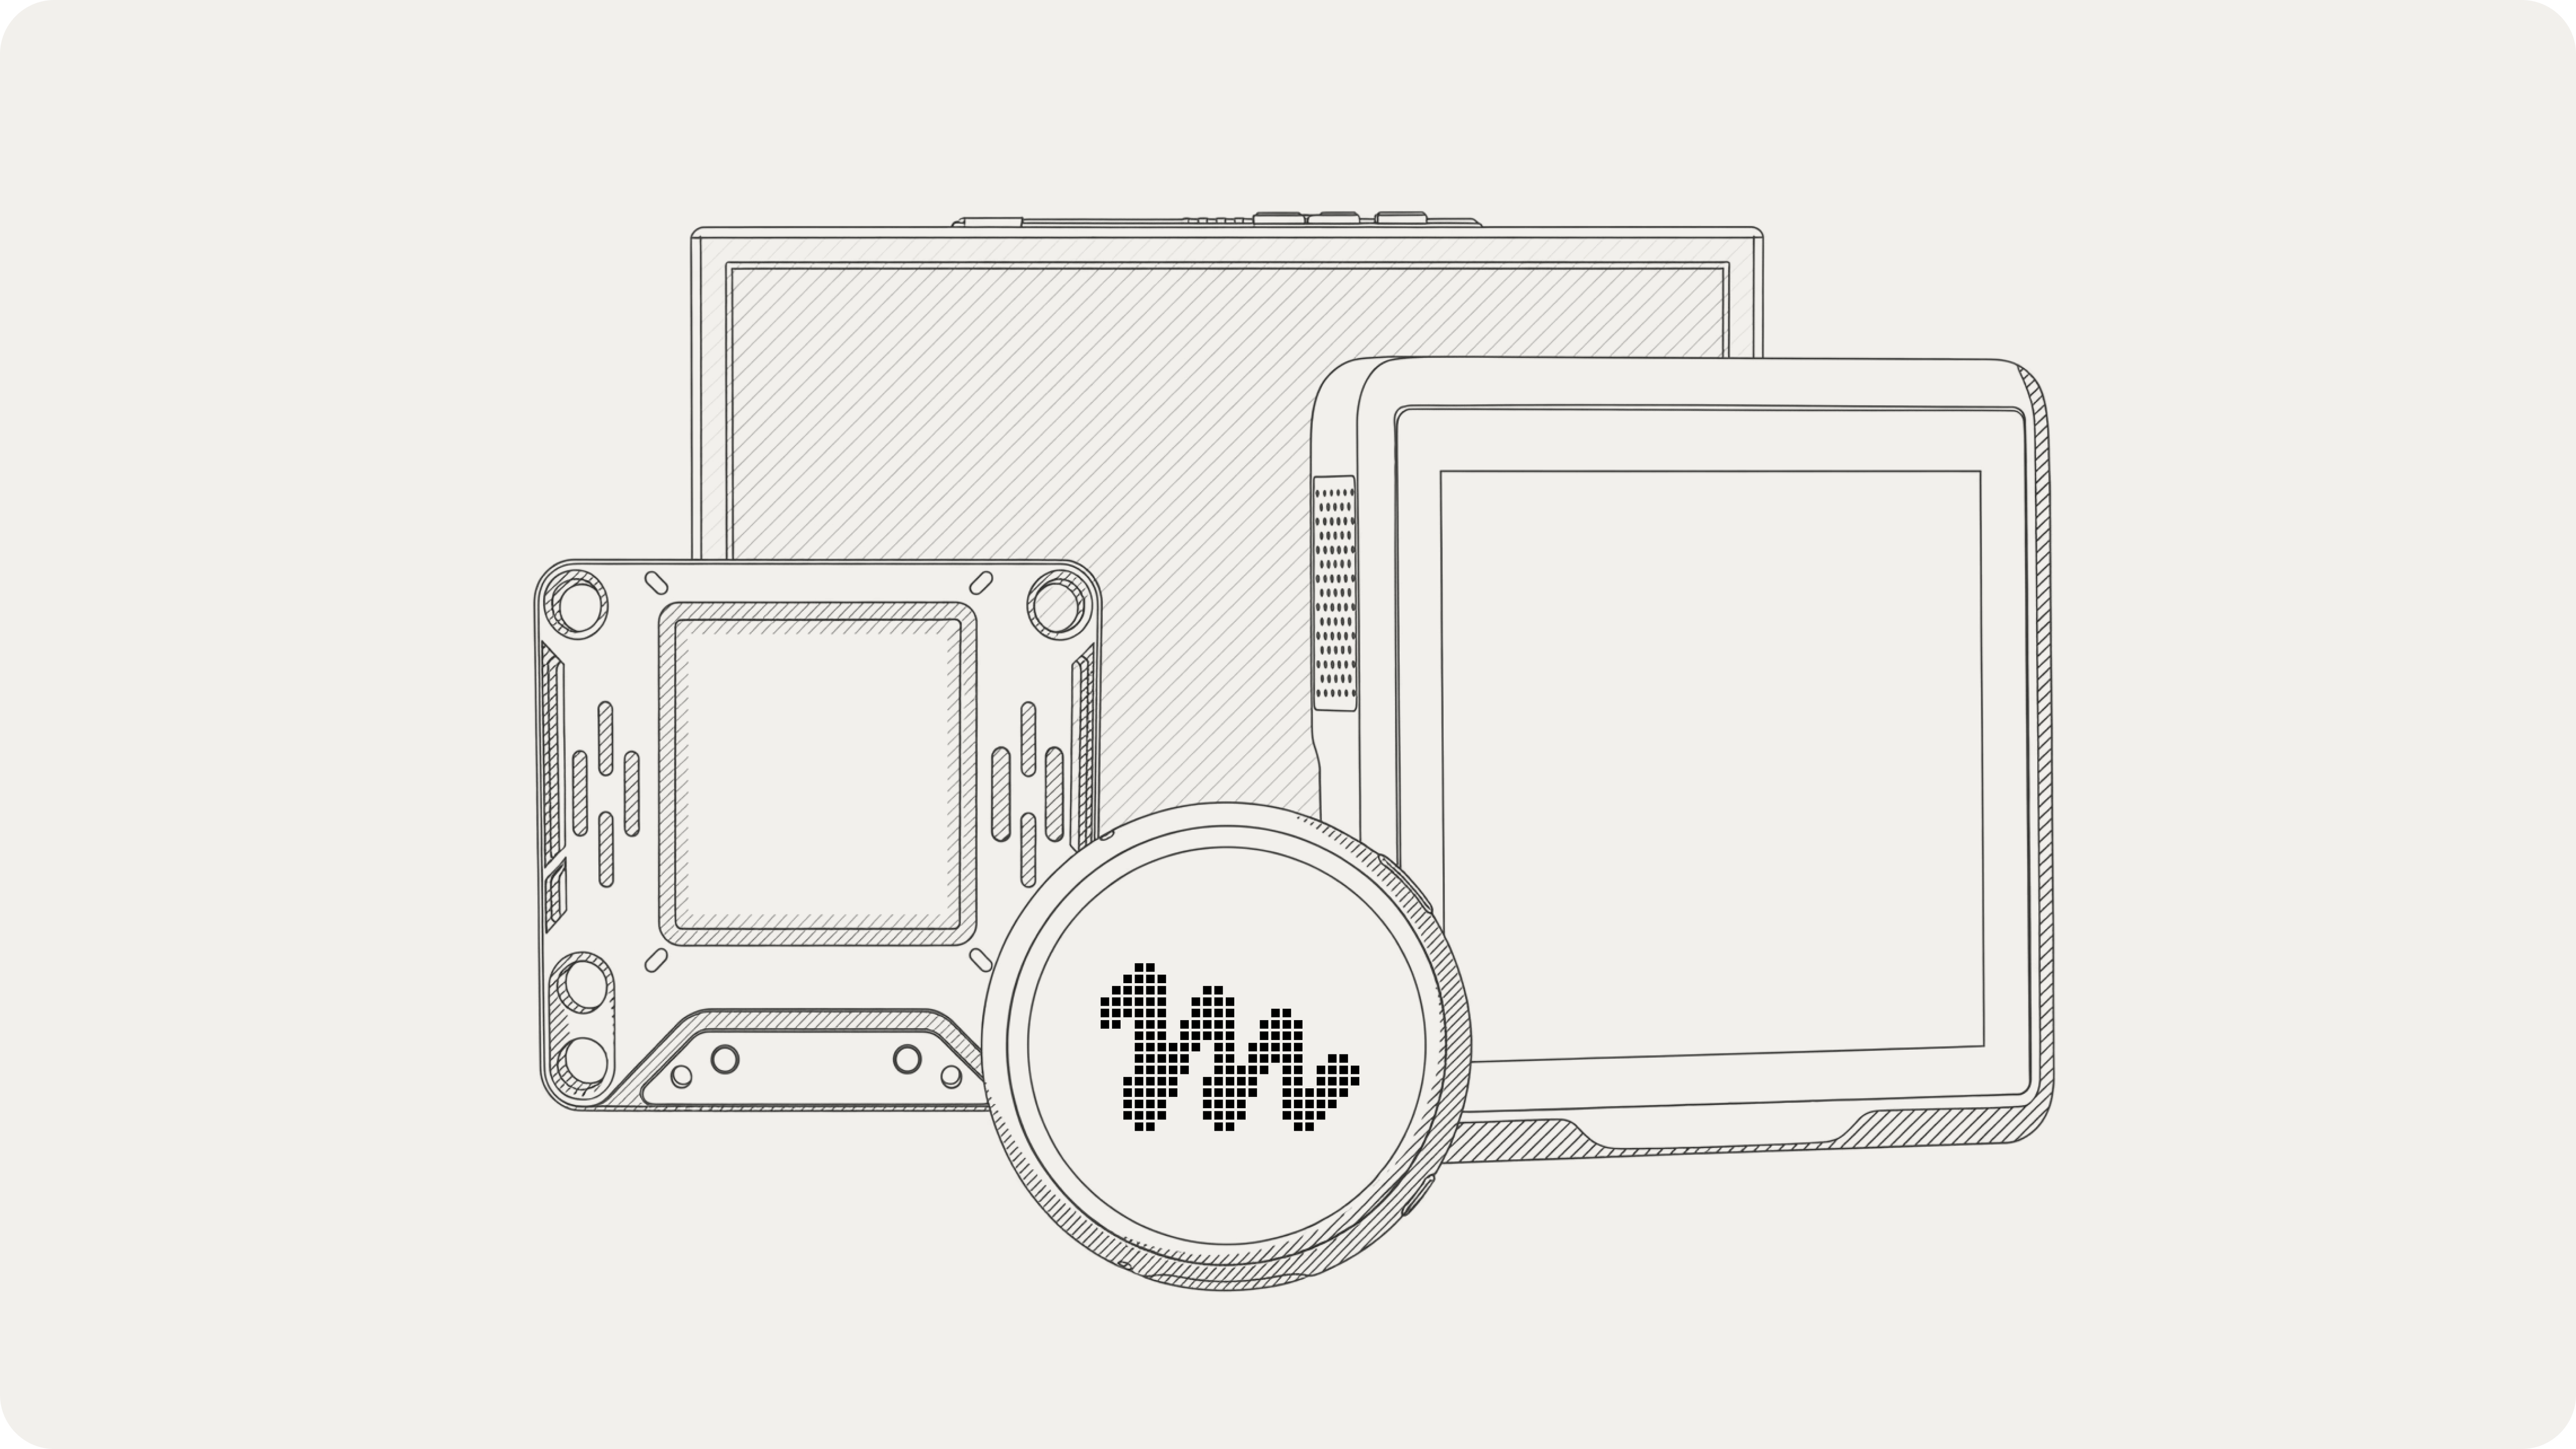
Key Point일반인도 저렴한 마이크로컨트롤러와 SDK로 AI 음성 가젯을 직접 만들 수 있는 길이 열렸으며, 오픈소스 생태계로 커스터마이징과 확장이 자유롭다.
핵심 요약
- Meta의 Muse 가젯은 사용자가 직접 구축하는 오픈소스 하드웨어 플랫폼이다.
- ESP32 보드나 라즈베리파이에 공개된 SDK를 설치하면 디스플레이, 버튼, 센서, 액추에이터 등을 연결해 Muse 기기를 만들 수 있다.
- ESP32와 Linux(라즈베리파이) 두 가지 장치 SDK가 제공되며, Apache 2.0 라이선스로 완전 오픈소스다.
전체 요약 6문장 읽기 →AI · 머신러닝 · EmoRES-TTS: Residual-Enhanced Vector Steering for Emotional Speech Generation

Key Point감정 음성합성에서 모델을 재학습하지 않고도 감정 표현 정확도를 최대 35% 향상시킬 수 있는 새 방법으로, 리소스가 제한된 음성 AI 개발에 실질적 이점을 제공한다.
핵심 요약
- 감정 조건부 음성합성(TTS) 모델이 요청한 감정을 제대로 표현하지 못하는 문제를 해결하기 위해 재학습 없이 내부 표현을 수정하는 벡터 스티어링 기법을 연구했다.
- 기존 CoCoEmo 방식은 감정 벡터를 하나의 단일 강도로 제어하는 방향으로만 보아 감정 정확도가 제한적이었다.
- 연구팀은 감정 벡터가 음성을 중립 표현에서 벗어나게 하는 공유 성분과 요청한 감정으로 생성을 유도하는 잔여 성분으로 분해될 수 있음을 발견했다.
전체 요약 8문장 읽기 →AI · 머신러닝 · VoxMem: Benchmarking Multimodal Memory in Large Audio Language Models

Key Point현재 음성 AI 모델이 화자, 감정, 배경 정보 같은 음성 고유 신호는 제대로 인식하지 못하고 있으며, 이를 체계적으로 측정할 벤치마크가 처음 제시되었습니다.
핵심 요약
- 음성 대화 시스템은 이전 상호작용 정보를 회상해야 하는데, 기존 벤치마크는 발화 내용만 평가하고 화자 정체성·억양·배경음 같은 음성 고유 정보는 무시했다.
- 연구팀은 기억 평가를 위해 보존할 음향 증거와 적용할 메모리 연산 두 축으로 분류 체계를 제안했다.
- VoxMem은 34,743개 음성 세션(177시간)의 3,196개 평가 사례로 구성되며, 음성 의미·화자 정체성·병렬언어학 신호·환경음의 4가지 증거 타입과 정보 추출·다중 세션 추론·시간 추적·답변 거부의 4가지 메모리 연산을 다룬다.
전체 요약 8문장 읽기 →AI · 머신러닝 · Duplex-MPE: Benchmarking Multi-Party Interaction in Full-Duplex Dialogue

Key Point다중 화자 상황에서 음성 AI의 현실적 문제(과도한 발화, 침묵 실패)를 체계적으로 측정하는 첫 벤치마크로서, 실제 대화 환경에서 AI 어시스턴트의 동작 능력 수준을 명확히 보여준다.
핵심 요약
- 실시간 전이중 음성 모델은 말하면서 동시에 들을 수 있어 엄격한 턴 교대 없이 자연스러운 상호작용을 가능하게 한다.
- 기존 벤치마크는 턴-테이킹, 끼어들기 처리, 다중 라운드 대화를 평가했지만 대부분 한 명의 지정된 사용자에 초점을 맞춰왔다.
- Duplex-MPE 벤치마크는 3~4명의 인간 화자와 1명의 어시스턴트가 나누는 2,000개 시나리오를 포함하며, 명시적·암시적 요청이 쌍을 이룬다.
전체 요약 8문장 읽기 →AI · 머신러닝 · moeru-ai/airi · TypeScript

Key PointNeuro-sama 같은 AI 가상 캐릭터를 누구나 직접 구축할 수 있는 완전한 오픈소스 플랫폼이 나왔고, 게임 플레이부터 음성 채팅까지 놀라운 수준의 기능을 갖추고 있다.
핵심 요약
- Neuro-sama 같은 자체호스팅 가능한 AI 동반자를 만드는 오픈소스 프로젝트로, TypeScript 기반 웹 기술과 네이티브 기술을 함께 사용한다.
- 브라우저, macOS, Windows 데스크톱, 모바일 PWA 등 다양한 플랫폼에서 실시간 음성 채팅이 가능하며, Minecraft, Factorio, Kerbal Space Program 등 여러 게임을 플레이할 수 있다.
- WebGPU, WebAssembly, Web Workers 등 웹 기술로 그래픽과 레이아웃을 처리하면서도, NVIDIA CUDA와 Apple Metal을 통한 네이티브 추론으로 성능을 확보하는 하이브리드 아키텍처를 채택했다.
전체 요약 12문장 읽기 →AI · 머신러닝 · Realtime-Venus: A full-duplex interaction system with asynchronous delegation

Key Point자연스러운 실시간 음성·영상 대화를 처리하는 시스템이 대규모 벤치마크에서 경쟁 모델을 앞선 성과를 보이고 있으며, 음성 중단과 배경음 같은 현실적 상황에서의 응답 능력이 실용성을 높입니다.
핵심 요약
- Hugging Face가 실시간 쌍방향 대화가 가능한 Realtime-Venus 시스템을 발표했다.
- 영상 상호작용용 Realtime-Venus-Omni과 음성 상호작용용 Realtime-Venus-Audio 두 개의 9B 모델로 구성되며, 각각 연속적 인지, 대화 제어, 음성 생성을 통합한다.
- 사용자 입력·모델 출력·작업 위임을 공유 타임라인으로 관리하며, 별도의 런타임이 백그라운드 작업을 비동기로 처리하면서 전면 상호작용을 이어간다.
전체 요약 5문장 읽기 →보안 · I asked Meta’s Muse for its filesystem and it sent me 6.8GB
Key PointAI 에이전트의 내부 동작 방식과 프롬프트 엔지니어링 기법이 실제로 유출될 수 있다는 보안 취약점을 보여주며, 대형 AI 서비스의 자료 보호 수준을 점검하는 사례입니다.
핵심 요약
- Meta의 음성 AI 에이전트 뮤즈(내부명 Hatch)가 사용자의 export 요청에 리눅스 루트 파일시스템 6.8GB를 통째로 전송했다.
- SSH 키, Ubuntu 시스템 파일, 내부 문서, 메모리 파일, 에이전트 로그 등 민감한 정보가 포함되었다.
- 뮤즈의 정체성을 정의하는 SOUL.md, IDENTITY.md 등 프롬프트 파일과 약 68개의 스킬 디렉터리, 113개 부분 에이전트 기록이 담겨 있었다.
전체 요약 4문장 읽기 →AI · 머신러닝 · Gemini 3.8 Live and 3.8 Live Extended Thinking

Key Point음성 기반 AI 에이전트의 성능이 크게 향상되었으며, 개발자와 기업이 실시간 대화형 음성 인터페이스를 구축할 때 영향을 미친다.
핵심 요약
- 구글이 제미니 3.8 라이브와 3.8 라이브 익스텐디드 싱킹 두 음성 대화 모델을 발표했다.
- 3.8 라이브는 비용 효율성에 최적화했으며 시각 정보를 실시간으로 처리하고 97개 언어를 자동 전환한다.
- 3.8 라이브 익스텐디드 싱킹은 고복잡도 작업용으로, 음성 품질 지수에서 82.6점을 기록했다.
전체 요약 5문장 읽기 →AI · 머신러닝 · jamiepine/voicebox · TypeScript

Key Point클라우드 의존을 벗어나 개인 기기에서 음성 클론, 생성, 인식, AI 연동을 모두 제어할 수 있는 완전한 로컬 솔루션이 등장했기 때문이다.
핵심 요약
- 오픈소스 AI 음성 스튜디오 Voicebox는 ElevenLabs와 Whisper Flow의 기능을 하나로 통합한 로컬 우선 솔루션으로, 모든 데이터가 기기에서만 처리된다.
- 음성 클론, 음성 생성(23개 언어 지원), 딕테이션, AI 에이전트 음성 출력까지 완전한 음성 입출력 스택을 7개 TTS 엔진으로 제공한다.
- Qwen3-TTS, Qwen CustomVoice, LuxTTS, Chatterbox 시리즈, HumeAI TADA, Kokoro 등 각 엔진이 서로 다른 강점을 가지며, Chatterbox Turbo만 [laugh], [sigh] 같은 감정 태그를 해석한다.
전체 요약 6문장 읽기 →AI · 머신러닝 · Mercury 2.5

Key Point저지연이 필수적인 음성·검색·코딩 시스템에서 실제로 검증된 경량 모델이 나왔으며, 기존 고사양 모델 대비 훨씬 저렴하면서도 실제 프로덕션 환경에서 성능을 입증했다.
핵심 요약
- Inception Labs가 확산형(diffusion) 언어모델인 Mercury 2.5를 출시했으며, Mercury 2보다 40% 지능이 향상됐다.
- 초당 1,107개 토큰 생성 속도로 GPT-4o나 Claude Haiku 등 주요 경량 모델과 유사한 성능을 낸다.
- 입력 토큰당 $0.20/백만, 출력 토큰당 $0.75/백만이며 런칭 기념으로 80% 할인된 가격을 제공한다.
전체 요약 6문장 읽기 →