쌓인 기록에서 찾기
무엇을 찾으세요?
날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위부터 2026년 10월 30일 (금)까지3636건
4건 · "음성-시각"조건 지우기 ×
001▲ 13 · 댓글 1멀티모달 LLM의 정보 검색 메커니즘 분석멀티모달 대형 언어 모델의 긴 입력에서 관련 증거를 찾는 능력은 '검색 헤드'라는 특정 어텐션 헤드 집합에서 비롯된다.AI · 머신러닝 · A Broader Look into MLLM's Retrieval Heads

Key Point멀티모달 LLM의 정보 검색 능력이 특정 어텐션 헤드에 집중되어 있다는 발견은 이들 모델의 작동 원리를 이해하는 핵심이며, 최적화를 통해 성능을 구체적으로 개선할 수 있는 방법을 제시한다.
핵심 요약
- 멀티모달 대형 언어 모델의 긴 입력에서 관련 증거를 찾는 능력은 '검색 헤드'라는 특정 어텐션 헤드 집합에서 비롯된다.
- 이 연구는 기존 연구의 한계를 확장해 음성-시각 입력 같은 새로운 모달리티를 포함한 18개 모델 체크포인트를 분석했다.
- 같은 답이 음성 또는 화면에 표시되는 쌍을 이루는 입력으로 테스트한 결과, 증거 내용이 같으면 검색 헤드는 새로운 모달리티에서도 희소성을 유지한다.
전체 요약 6문장 읽기 →기타 · Dogs seem to agree with humans that 'bouba' is round and 'kiki' is spiky
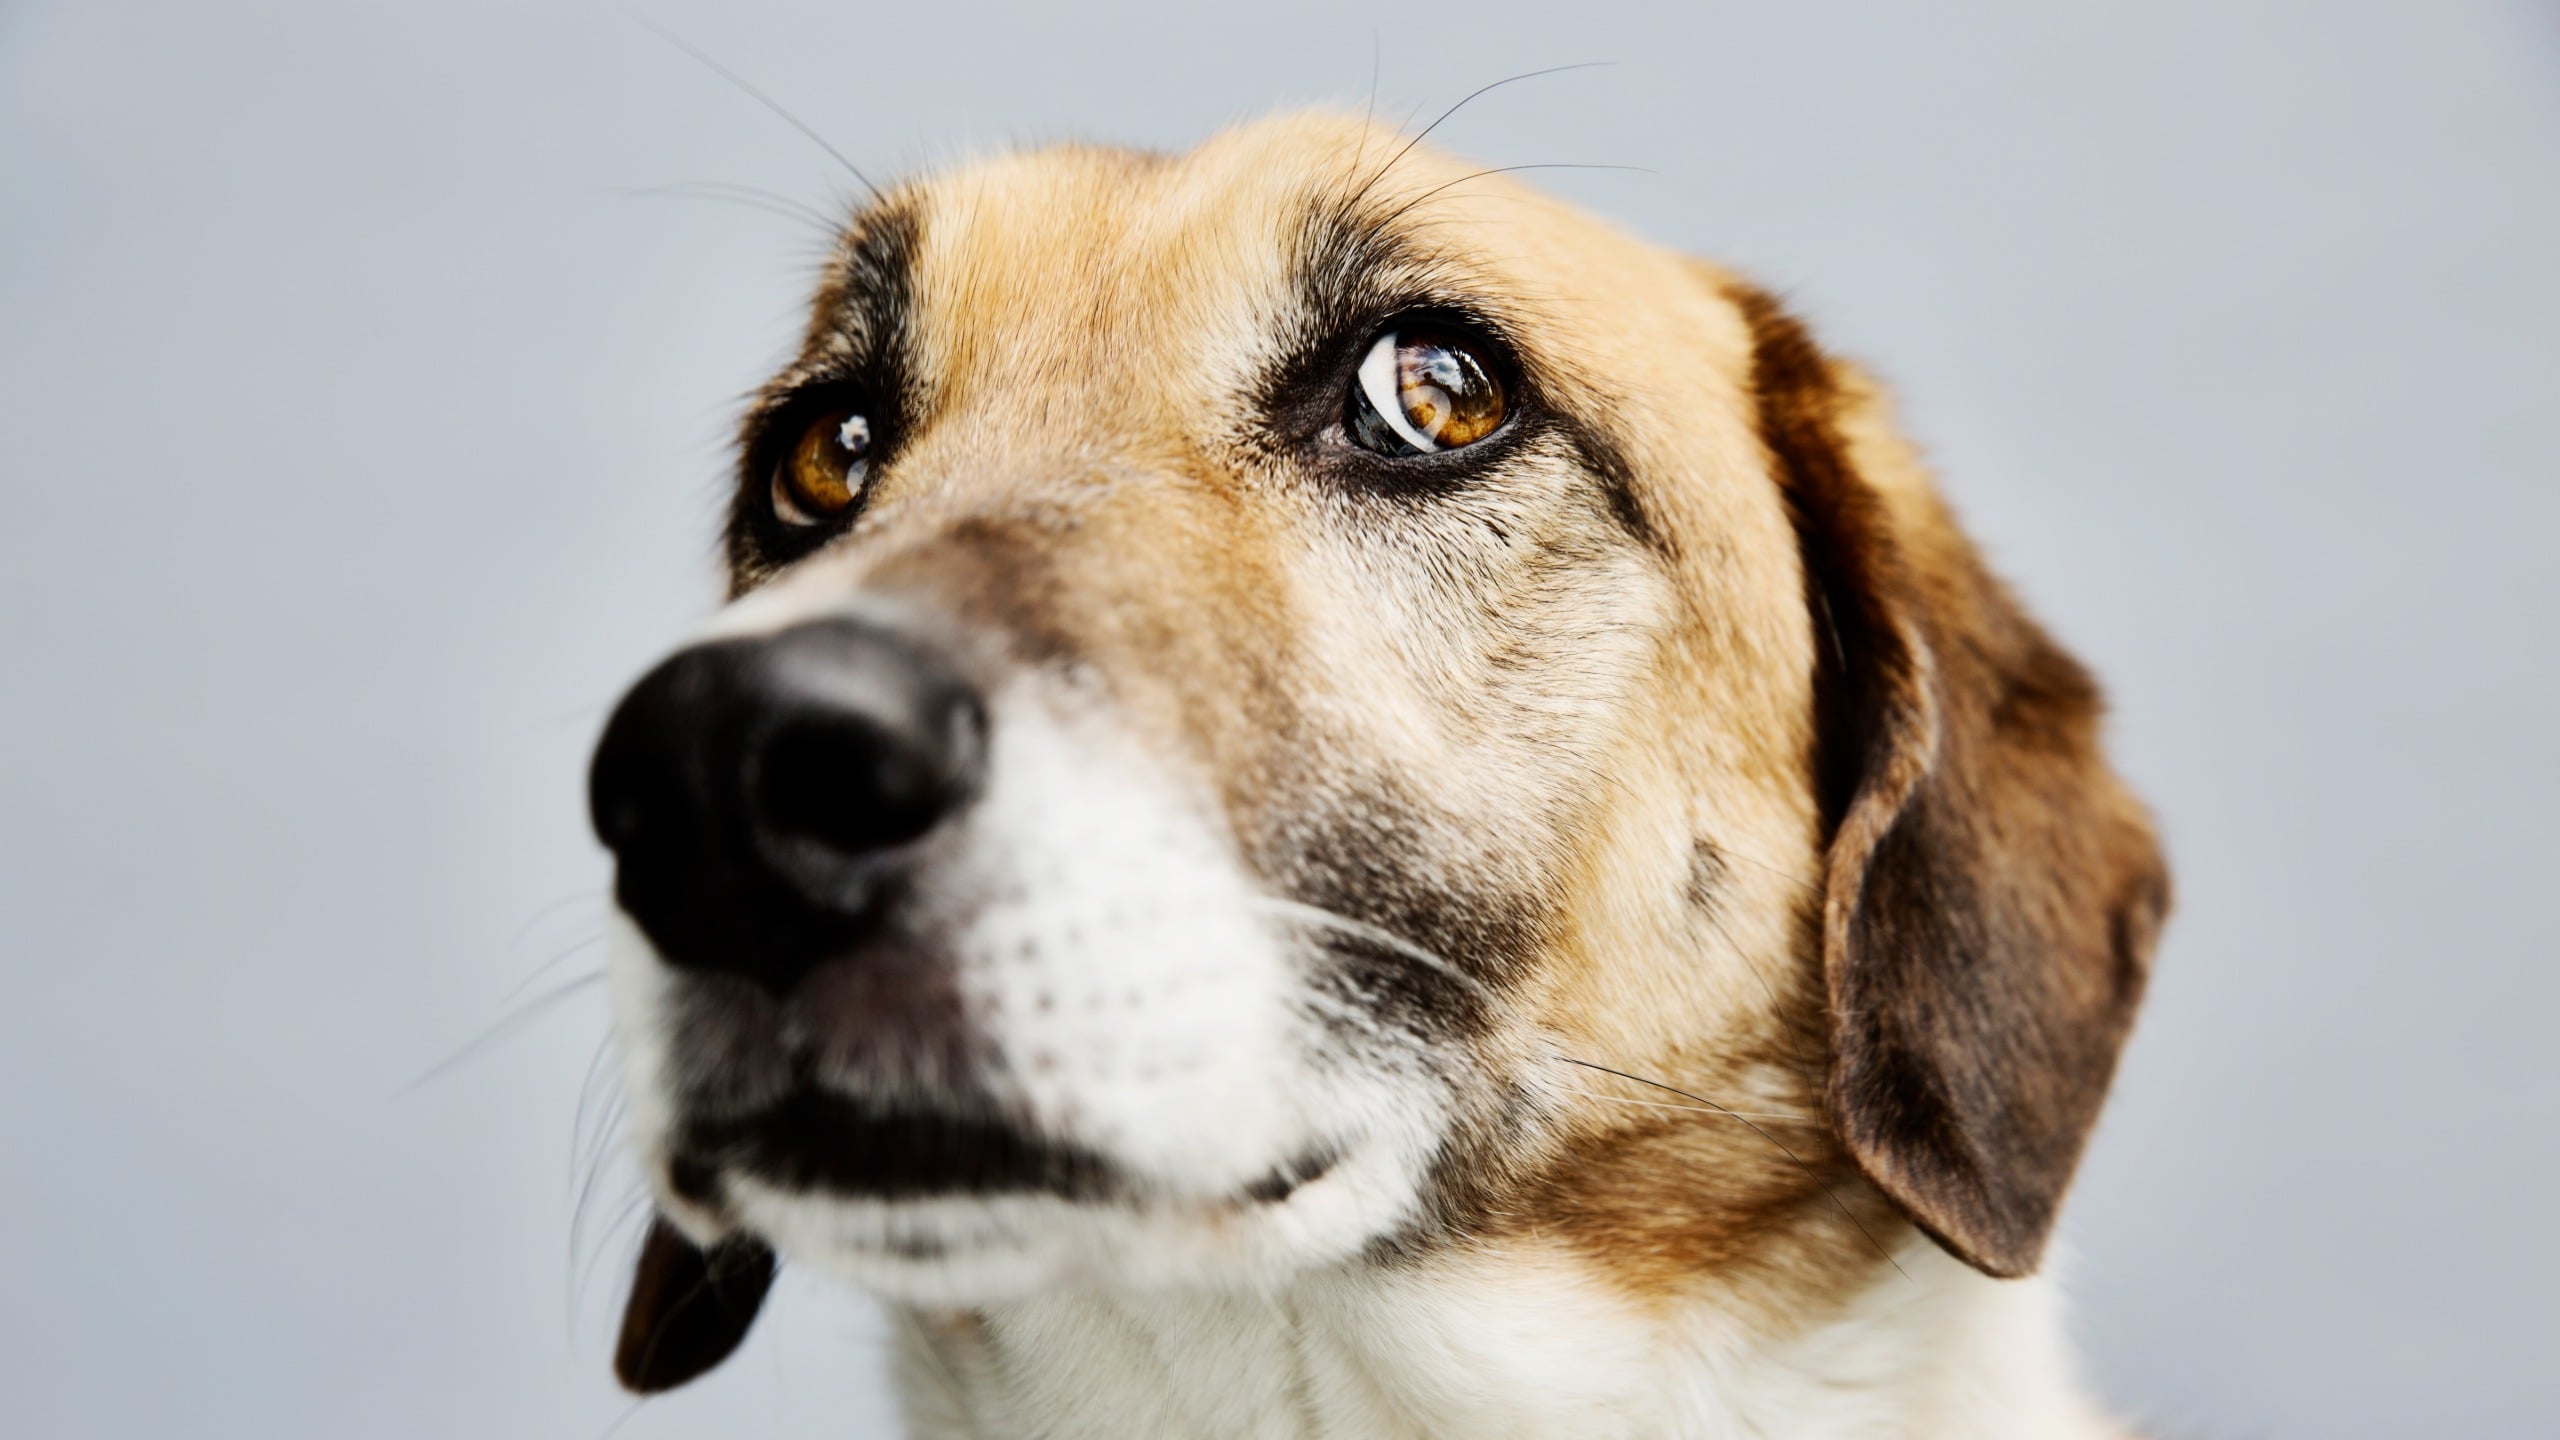
Key Point개도 인간과 같은 음형-형태 연관 능력을 보여줌으로써, 이것이 종(種)을 넘어선 보편적 특성일 수 있음을 시사한다.
핵심 요약
- 'Bouba'라는 단어는 둥근 모양으로, 'Kiki'는 뾰족한 모양으로 느껴진다는 심리학 실험이 1920년대부터 알려져 있으며, 언어와 알파벳에 관계없이 대부분의 인간이 이에 동의한다.
- 이탈리아 파르마 대학의 동물 행동학자 엘레오노라 비피가 이 현상이 개에게도 나타나는지 확인하기 위해 70마리 강아지를 대상으로 실험을 진행했다.
- 첫 번째 실험은 51마리 개와 주인이 참여했으며, 양쪽 화면과 스피커 사이에서 'Bouba'와 'Kiki' 음성을 재생하면서 둥근 모양과 뾰족한 모양을 번갈아 표시했다.
전체 요약 9문장 읽기 →AI · 머신러닝 · OmniCompass: A Holistic Benchmark for Omni-Modal Video Grounding and Understanding

Key Point오픈소스 MLLM과 상용 모델 간의 격차를 정량적으로 드러내고, 음성-시각 이해라는 미흡한 영역을 구체적으로 지목하는 실제 평가 결과를 제시한다.
핵심 요약
- 멀티모달 대형언어모델(MLLM)의 동영상 이해 능력을 체계적으로 평가하기 위해 OmniCompass 벤치마크를 새로 제안했다.
- VL 트랙(시각 정보 기반)과 AV 트랙(음성-시각 결합)의 두 평가 경로로 구성되며, 각각 시간 정위(TG), 공간 정위(SG), 질의응답(QA) 세 가지 과제를 포함한다.
- VL 트랙은 5가지 지각·3가지 추론 범주를 다루고, AV 트랙은 3가지 지각·2가지 추론 범주를 다룬다.
전체 요약 7문장 읽기 →AI · 머신러닝 · OmniEcho: Spatial Audio Understanding for Embodied Agents

Key Point음성 감지 능력이 로봇과 에이전트의 환경 이해 능력을 크게 확장할 수 있으며, 이를 평가하고 개선할 수 있는 첫 번째 대규모 벤치마크가 공개되었다.
핵심 요약
- 구체화된 에이전트(로봇 등)가 시각 정보와 함께 음성 신호를 이용해 추론하기는 여전히 어렵다.
- 음향-시각 인식과 음성-시각-언어 기반 네비게이션을 평가할 통일된 벤치마크가 필요했다.
- 연구팀이 OmniEchoBench를 제안했으며, 30개 실제 환경에서 수집한 197개 실제 공간음향-시각 장면, 2,972개 질문-답변 쌍, 900개 네비게이션 샘플(1차 앰비소닉스 오디오)을 포함한다.
전체 요약 7문장 읽기 →