매일 쌓이는 개발자의 시야
2026년 10월 5일 (월). 세상의 기술 소식, 한국어로 한눈에.
AI 요약 안내 AI가 한국어로 정리한 내용입니다. 정확한 정보는 각 카드의 원문을 확인해 주세요.
요약 원칙 ↗ 01 읽을 소식Hacker News 3건 ↓ 02 써볼 도구GitHub Trending 3건 ↓ 03 읽을 논문Hugging Face Papers 22건 ↓ AI · 머신러닝 분야 · 28건 필터 해제 ×
오늘의 주요포인트 상위 3건
01 AI · 머신러닝 00:11 게시
원제 Run Qwen 3.8 Flash Next (125B) on consumer hardware (RTX 4090) at 100T/s
166 포인트 댓글 69
Key Point 소비자용 그래픽카드만으로 클라우드 서버 수준의 대규모 언어모델을 로컬에서 무료로 실행 가능해졌기 때문에, 개인 개발자와 중소 회사의 AI 접근 장벽이 크게 낮아진다.
핵심 요약
Strata는 일반 게이밍 PC에서 125억 파라미터의 대규모 AI 모델 Qwen3.8-Flash-Next를 실행할 수 있게 해주는 오픈소스 소프트웨어다. RTX 5070(12GB)과 Ryzen 5 7600 조합에서 Q2_0 압축 모델 기준으로 초당 94토큰의 답변 생성 속도(32KB 문서 읽기 초당 2,650토큰)를 달성한다. RTX 3090(24GB) 같은 더 많은 VRAM을 가진 카드는 초당 100~140토큰 속도까지 낼 수 있다. 전체 요약 12문장 읽기 → 02 AI · 머신러닝 06:11 게시
원제 Show HN: AI search for every photo and every frame of video on macOS
121 포인트 댓글 59
Key Point AI 검색이 클라우드 없이 로컬에서만 작동하므로 개인 사진·영상의 프라이버시를 완전히 보호하면서도 의미 기반·음성·텍스트 검색을 한 번에 제공하는 방식이 다르다.
핵심 요약
SCM은 폴더의 모든 사진과 영상 프레임을 로컬 AI로 검색하는 macOS 앱으로, 클라우드 업로드 없이 기기에서만 처리된다. 자연언어로 기억을 설명하면 CLIP 등 로컬 비전 모델이 검색하고, 영상은 장면 단위로 분할·임베딩되어 정확한 타임코드로 이동할 수 있다. 5가지 검색 모드를 지원한다: 의미 기반 이미지 검색(Files), 영상의 특정 장면 검색(Scenes), 이미지의 OCR 텍스트 검색(OCR), Whisper를 이용한 영상 음성 검색(Dialogue), 추출된 대사·OCR·파일명을 근거로 답변하는 로컬 LLM 챗(Ask). 전체 요약 13문장 읽기 → 03 AI · 머신러닝 03:11 게시
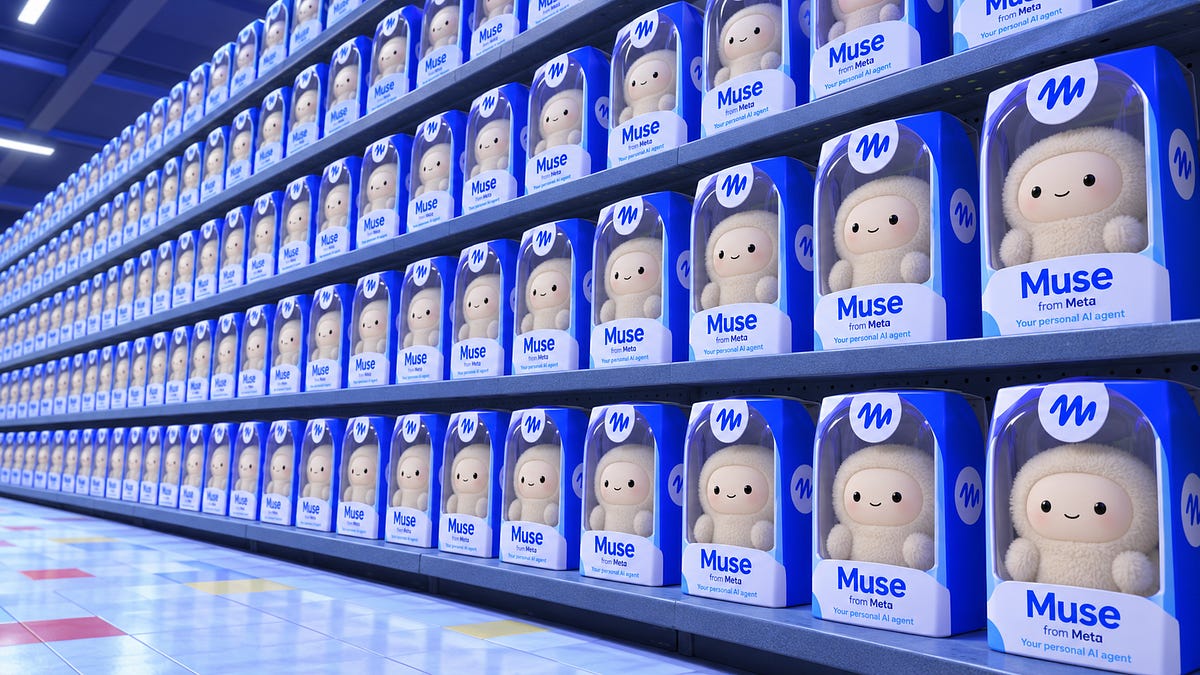
원제 What Meta got right with Muse
116 포인트 댓글 148
Key Point 소비자 AI 시장에서 기술 혁신보다 디자인, 메타포, 비즈니스 모델이 얼마나 중요한지 보여주며, 각 기업의 강점과 약점을 명확히 분석한다.
핵심 요약
메타의 뮤즈는 기술적으로 새롭지 않지만 기존 AI 제품들의 복잡한 인터페이스를 단순하게 정리하여 성공했다. 뮤즈는 모델 선택, 작업과 채팅 전환, MCP나 크론 작업 같은 개념을 모두 숨기고 하나의 채팅으로 통합해 단순성을 달성했다. 사용자에게 AI를 '자신의 개인용 도우미'라는 명확한 정신 모델을 제공하며, Jobs-To-Be-Done 프레임워크에 따라 도구 모음이 아닌 동료처럼 작동한다. 전체 요약 8문장 읽기 → 오늘의 주요당일 스타 상위 3건
01 AI · 머신러닝 21:11 게시
antirez/ds4
원제 antirez/ds4
스타 23,514 당일 +211 C
Key Point 개인 맥이나 워크스테이션에서 DeepSeek·GLM 같은 최신 고성능 모델을 실제로 돌릴 수 있는 구체적인 방법과 제약조건(메모리, SSD 스트리밍 필요 여부)이 명확해진다.
핵심 요약
Salvatore Sanfilippo가 만든 DwarfStar는 DeepSeek V4/V4.1 Flash, GLM 5.2/5.3, Qwen3.8 Flash 등 주요 오픈웨이트 모델을 개인 하드웨어에서 실행하는 네이티브 추론 엔진으로, Metal·CUDA·ROCm을 지원한다. 일반적인 GGUF 러너가 아니라 특정 모델 몇 개에 최적화된 자체 포함 C 코드이며, 프로젝트가 생산한 GGUF 파일만 사용한다. Metal은 애플 실리콘 맥(96GB 이상, 또는 SSD 스트리밍으로 더 작은 기계에서도 가능)을 주요 대상으로, CUDA는 DGX Spark와 Ada/L40S 카드를 포함한 다중 GPU 시스템을 지원하며, ROCm은 Strix Halo 같은 시스템을 대상으로 한다. 전체 요약 12문장 읽기 → 02 AI · 머신러닝 21:11 게시
michael-denyer/pstack-claude
원제 michael-denyer/pstack-claude
스타 3,971 당일 +103 JavaScript
Key Point Claude Code와 다양한 AI 에이전트 환경에서 체계적인 에이전트 워크플로우를 바로 사용할 수 있게 되어, 버그 수정부터 배포까지 소프트웨어 개발 전 단계를 구조화된 방식으로 자동화할 수 있다.
핵심 요약
Cursor의 pstack 스킬 스택을 Claude Code, Codex, Pi, OpenCode, Gemini 등 다양한 AI 에이전트 환경으로 포팅한 저장소다. pstack은 에이전트의 코드 생성 결과를 개선하기 위한 의견 있는 워크플로우 모음으로, 버그 수정·기능 추가·리팩토링·성능 최적화·PR 관리·배포 등 다양한 작업 시나리오를 다룬다. 사용자가 `/skill:<이름>` 명령으로 스킬을 실행하거나 `/pstack:setup-pstack`으로 모델 기본값과 추론 난이도를 설정할 수 있다. 전체 요약 8문장 읽기 → 03 AI · 머신러닝 21:11 게시
cloudflare/cloudflare-os
원제 cloudflare/cloudflare-os
스타 11,135 당일 +101 TypeScript
Key Point SaaS 중심의 클라우드 아키텍처에서 벗어나 사용자 각자가 자신만의 AI 에이전트와 앱을 보유하고 제어하는 새로운 소프트웨어 배포 방식을 제시하는 대규모 오픈소스 플랫폼이다.
핵심 요약
클라우드플레어가 자사 직원들을 위해 개발한 AI 생산성 환경 'Cloudflare OS'를 오픈소스로 공개했다. 사용자는 에이전트 채팅 UI를 통해 회사 맥락을 담은 작업을 요청하고, AI가 작성한 앱 '가젯'을 샌드박스에서 안전하게 구동하며, '게이트키퍼'라는 보안 프레임워크로 에이전트와 앱의 접근을 제어한다. 각 사용자는 자신만의 가젯 인스턴스를 소유하므로 보안 버그로도 다른 사용자 데이터가 유출될 수 없고, 필요한 기능은 AI에 요청해 직접 코드를 수정할 수 있다. 전체 요약 11문장 읽기 → 읽을 논문
Hugging Face Papers22 커뮤니티가 고른 오늘의 AI 논문
오늘의 주요추천 상위 3건
01 AI · 머신러닝 15:11 게시
원제 Does Learning Protein Folding Generalize to Broader Reasoning?
추천 120 댓글 4 Yong Liu, Zhanpeng Shi, Yizhou Dang 외
Key Point 구조화된 과학 문제의 학습이 언어 모델의 추론 능력 개선으로 직결되는 메커니즘을 처음 실증함으로써, 사전학습 데이터 구성 방식에 대한 새로운 접근 방향을 제시한다.
핵심 요약
대규모 언어 모델은 표면적인 답변을 담은 인간 텍스트에 의존하면서, 그 뒤의 공간적·구조적 논리를 놓친다. 연구팀은 단백질 폴딩 문제에 주목했다. 하나의 단백질 구조가 수천 개의 정확히 검증 가능한 공간·위상학적 문장을 만들어내기 때문이다. FoldingCorpus라는 단백질 기반 질의응답 데이터세트와 Fold2Reason이라는 학습 방법을 개발했다. 전체 요약 8문장 읽기 → 02 AI · 머신러닝 15:11 게시
원제 FrameMorrow: Future-guided Frame Selection with Prospective Tokens for Long-Horizon Video Generation
추천 91 댓글 4 Bo Yin, Xiaobin Hu, Jiaqi Zhao 외
Key Point 장시간 영상을 일관되게 생성하는 핵심 병목인 메모리 효율성을 미래 예측 기반 선택으로 해결하는 새로운 접근법이 실제 환경에서 효과를 입증했다.
핵심 요약
장시간 영상 생성에서 생성 이력이 길어질수록 모든 이전 콘텐츠를 유지하는 것이 비효율적이고 중복적이어서 효과적인 이력 선택이 필수적이다. 기존 방식들은 현재 콘텐츠 기반으로 과거 정보의 관련성을 판단하지만, 현재에 관련된 정보가 미래 생성에 반드시 유용한 것은 아니고 적어 보이는 과거가 나중에 중요할 수 있다. 핵심 통찰은 과거 정보를 미래 정보 수요에 대한 관련성에 따라 선택해야 한다는 것이다. 전체 요약 8문장 읽기 → 03 AI · 머신러닝 15:11 게시
원제 MotorMind: Scaffolding General Vision Language Models for Zero-Shot Robot Manipulation
추천 89 댓글 2 Bingxuan Li, Siqi Song, Yizhuo Wu 외
Key Point 일반 AI 모델만으로 로봇을 제어하는 새로운 방식이 기존 전문화된 방법들을 크게 능가한 성능을 보여주므로, AI와 로봇 응용 경계에서의 구조적 전환을 의미한다.
핵심 요약
VLA(비전-언어-액션) 모델은 로봇 조작을 발전시켰으나 새로운 작업과 환경에서 제로샷 일반화가 제한적이고, 전문 훈련에 의존하면서 범용 VLM의 빠른 발전 혜택을 받지 못했다. 기존 에이전트 로봇 시스템은 고수준 추론을 위해 VLM을, 제어를 위해 코딩 에이전트를 활용하지만 외부 모델과 도구에 의존해 복잡도와 비용이 증가한다. MotorMind는 범용 VLM이 사람 원격조작자처럼 관찰에서 직접 추론하고 액션을 지시하며 실행 피드백에 적응할 수 있게 하는 로봇 조작 프레임워크다. 전체 요약 8문장 읽기 → 전체 색인19건 · 분야별
AI · 머신러닝19건 001 21:11 ▲ 78 · 댓글 2 행동 라벨 없이 영상에서 로봇 제어 정책 학습하는 NAVA-WAM 세계 행동 모델(world action models)은 미래 시각 동역학과 로봇 행동 예측을 통합하지만, 행동 주석이 달린 로봇 궤적 데이터가 필요해 확장성이 제한된다. AI · 머신러닝 · Native Action-Prior Learning from Videos for World Action Models
Key Point 로봇 제어에 필수적인 행동 라벨 데이터 의존성을 제거하고 일반 영상만으로 로봇 정책을 학습하는 새로운 접근법을 제시해, 로봇 학습의 데이터 수집 병목을 해결한다.
핵심 요약
세계 행동 모델(world action models)은 미래 시각 동역학과 로봇 행동 예측을 통합하지만, 행동 주석이 달린 로봇 궤적 데이터가 필요해 확장성이 제한된다. 관찰만 가능한 일반 영상에는 상호작용 역학에 대한 풍부한 정보가 있지만, 기존 방식은 이를 시각 표현 사전학습 또는 잠재 행동 추론에만 활용했다. NAVA-WAM은 행동 라벨 없는 영상에서 직접 행동 정책을 사전학습하는 '원시 행동 사전 학습(native action-prior learning)'을 도입해, 간접적인 표현-제어 전이나 별도의 잠재 행동 모델을 피한다. 전체 요약 7문장 읽기 → 002 21:11 ▲ 47 · 댓글 3 Simulink 모델 생성 AI의 진정한 성능을 측정하는 벤치마크 기존 Simulink 벤치마크는 생성된 모델의 컴파일·실행 여부와 외형 유사도만 평가해 엔지니어링 요구사항 충족 여부를 확인하지 못한다. AI · 머신러닝 · SimuVerity: Benchmarking Agents for Engineering-Grade Simulink Model Generation
Key Point 현재 AI 에이전트의 Simulink 모델 생성은 외형 유사도 중심으로 평가되고 있으나, 실제 엔지니어링 요구사항을 만족하는지는 전혀 다른 문제이기 때문입니다.
핵심 요약
기존 Simulink 벤치마크는 생성된 모델의 컴파일·실행 여부와 외형 유사도만 평가해 엔지니어링 요구사항 충족 여부를 확인하지 못한다. SimuVerity는 10개 엔지니어링 도메인에서 101개의 텍스트-실행파일 Simulink 모델 생성 작업으로 구성된 벤치마크를 제시한다. 각 작업마다 실행 가능한 시스템 프로파일이 엔지니어링 사양을 정의하고, 4가지 시뮬레이션 시나리오 세트가 테스트 조건이 된다. 전체 요약 7문장 읽기 → 003 21:11 ▲ 47 · 댓글 1 장시간 영상 생성 모델에 공간 기억 지능 더하다 장시간 영상 생성과 월드 모델은 사용자 행동과 과거 기억을 바탕으로 미래 관측치를 예측해 상호작용 가능한 엔터테인먼트와 embodied simulation을 실현했으나, 메모리 길이가 길어지고 구조가 복잡해질수록 장거리 공간 맥락 관리가 어려워진다. AI · 머신러닝 · Spatial Memory Intelligence: Endowing World Models with Understanding-Driven Long-Term Memory
Key Point MLLM의 공간 이해 능력을 처음으로 체계적으로 메모리 관리에 적용해 장시간 영상 생성의 근본적인 한계를 푸는 새로운 접근이다.
핵심 요약
장시간 영상 생성과 월드 모델은 사용자 행동과 과거 기억을 바탕으로 미래 관측치를 예측해 상호작용 가능한 엔터테인먼트와 embodied simulation을 실현했으나, 메모리 길이가 길어지고 구조가 복잡해질수록 장거리 공간 맥락 관리가 어려워진다. Spatial Memory Intelligence(SMI)는 다중모드 대규모 언어 모델(MLLM)의 공간 추론 능력을 활용해 장시간 영상 월드 모델의 메모리 관리를 체계화한 첫 프레임워크다. SMI는 공간 클러스터링, 클러스터 내 스파시피케이션, 행동 기반 검색, 신뢰도 기반 필터링 4개의 조정된 원자 연산을 도입한다. 전체 요약 4문장 읽기 → 004 21:11 ▲ 80 · 댓글 2 로봇 움직임 미리보기로 장시간 작업 계획하는 ProWAM 로봇 제어용 월드 액션 모델(WAM)은 초기 관찰과 명령으로부터 시각적 역학과 행동을 동시에 예측하지만, 긴 시간 범위의 예측에서 어려움을 겪는다. AI · 머신러닝 · World Action Modeling with Progressive Visual Planning
Key Point 로봇 제어 분야에서 시각적 중간 목표를 통해 긴 수열의 작업을 효율적으로 계획하고, 현실 환경에서도 높은 성공률을 달성한 새로운 접근법이 소개됐다.
핵심 요약
로봇 제어용 월드 액션 모델(WAM)은 초기 관찰과 명령으로부터 시각적 역학과 행동을 동시에 예측하지만, 긴 시간 범위의 예측에서 어려움을 겪는다. 기존 WAM은 전체 비디오를 생성하지 않고 단일 미래 프레임만 예측하는 방식도 있으나, 목표 달성 과정을 안내하지 못한다는 한계가 있다. ProWAM은 행동과 순서가 정해진 희소 시각적 서브골(중간 목표)의 시퀀스를 함께 예측해, 작업 실행 중 행동 생성을 위한 명시적 시각 안내를 제공한다. 전체 요약 8문장 읽기 → 005 18:11 ▲ 54 · 댓글 2 AI 생성 논문의 "과학적 결함" 탐지하고 개선하는 벤치마크 AI가 생성한 과학 논문의 문제(슬롭)는 개별 문장은 그럴듯하지만 과학적 추론의 연결이 무너지는 특수한 형태로 나타나며, 기존 토큰 기반 AI 탐지기로는 쉽게 포착되지 않는다. AI · 머신러닝 · Science or Slop?: Benchmarking and Mitigating Scientific Slop in AI-Generated Papers
Key Point 학위 논문 등에서 AI 생성 논문 채용이 늘면서, 개별 문장의 그럴듯함으로 위장한 과학적 추론의 결함을 탐지하고 교정하는 방법이 학계와 편집자에게 실질적으로 필요해지는 상황이다.
핵심 요약
AI가 생성한 과학 논문의 문제(슬롭)는 개별 문장은 그럴듯하지만 과학적 추론의 연결이 무너지는 특수한 형태로 나타나며, 기존 토큰 기반 AI 탐지기로는 쉽게 포착되지 않는다. 연구팀은 구조·논리·근거 6가지 지표로 AI 논문의 과학적 결함을 평가하는 SciSlopBench를 구축했으며, 컴퓨터과학 중심의 AI 생성 논문 390편과 연구 문제·기여도가 일치하는 인간 작성 논문 390편을 쌍으로 구성했다. 개발한 6가지 지표는 논문 쌍에서 AI 논문을 85.9% 정확도로 식별했으며, 기존 최고 도구인 Binoculars의 68.7%보다 크게 우월하다. 전체 요약 7문장 읽기 → 006 18:11 ▲ 53 · 댓글 2 웹 검색 AI의 진짜 실력을 재다: 다언어·다중매체 벤치마크 공개 13개 언어로 된 423개 질문으로 구성된 HyperBrowseComp 벤치마크를 공개했다. AI · 머신러닝 · HyperBrowseComp: A Multilingual and Multimodal Stress Test for Web-Browsing Agents
Key Point 현재 출시된 웹 검색 AI들의 실제 정보 탐색 능력이 얼마나 되는지 정량적으로 검증할 수 있는 기준이 생김에 따라, AI 에이전트 성능 평가의 표준이 될 가능성이 있다.
핵심 요약
13개 언어로 된 423개 질문으로 구성된 HyperBrowseComp 벤치마크를 공개했다. 각 질문은 원어민 또는 고급 화자가 작성·검증했으며, 정답은 공개 자료에서 확인 가능하다. 모호한 증거를 찾거나 여러 단계의 단서를 따라가거나 동영상·스캔 문서·지도 등 다양한 출처를 검토해야 하는 과제들이다. 전체 요약 6문장 읽기 → 007 18:11 ▲ 51 · 댓글 2 물리 방정식 학습에 예측 기반 표현 학습 도입 매개변수 편미분방정식(PDE) 표현 학습에서 기존 재구성 기반 목표보다 예측 기반 표현 사전학습이 더 나은 물리 정보를 보존하는지 검토했습니다. AI · 머신러닝 · PDE-JEPA: Predictive Representation Learning of Latent Dynamics Modeling for Parametric PDEs
Key Point 물리 시뮬레이션과 과학 계산이 필요한 분야에서 일반화 능력이 뛰어난 신경망 기반 PDE 솔버 개발의 핵심 진전입니다.
핵심 요약
매개변수 편미분방정식(PDE) 표현 학습에서 기존 재구성 기반 목표보다 예측 기반 표현 사전학습이 더 나은 물리 정보를 보존하는지 검토했습니다. 예측 표현만으로는 정확한 필드 진화가 보장되지 않는다는 관찰을 기반으로 PDE-JEPA 프레임워크를 제안했습니다. 먼저 마스크된 잠재 예측을 사용해 인코더를 학습하여 PDE 동역학의 기저 규칙을 포착합니다. 전체 요약 6문장 읽기 → 008 18:11 ▲ 52 · 댓글 2 마스크 기반 확산 모델의 학습 효율성을 높이는 Pivot-SD 마스크 확산 언어 모델(dLM)은 자동회귀 모델 대안으로서 복잡한 추론에 유망하지만, 노이징 제거 중 일부 토큰 결정이 나머지 마스크 위치의 불확실성을 급격히 줄이는 신용 배치 문제를 마주한다. AI · 머신러닝 · Pivot-SD: Efficient Self-Distillation for Masked Diffusion Language Models
Key Point 마스크 기반 확산 모델의 학습 비효율을 지목하고, 고영향 결정점만 선별 학습하는 새로운 자기증류 방식이 소규모 데이터로도 기존 방법을 능가하는 결과를 보여준다.
핵심 요약
마스크 확산 언어 모델(dLM)은 자동회귀 모델 대안으로서 복잡한 추론에 유망하지만, 노이징 제거 중 일부 토큰 결정이 나머지 마스크 위치의 불확실성을 급격히 줄이는 신용 배치 문제를 마주한다. 기존 dLM 학습 방식은 이러한 신호를 활용하지 않으며, 최종 텍스트나 전체 노이징 단계에 보상을 할당하는 방식으로 개별 핵심 토큰 결정을 선별하지 않는다. Pivot-SD는 오프라인 자기증류 프레임워크로서, 오직 응답 형성에 큰 영향을 미치는 핵심 결정점(pivot)만을 감독한다. 전체 요약 5문장 읽기 → 009 15:11 ▲ 51 · 댓글 2 법률 AI 평가 프레임워크 'LexReward' 공개 법률 언어모델의 응답 품질을 평가하기 위해 기존의 단순한 판단 방식으로는 법률 분야의 복잡한 요구사항을 충분히 반영할 수 없다는 문제에서 출발한 연구다. AI · 머신러닝 · LexReward: A Taxonomy-Driven Reward Framework for Legal Language Models
Key Point 법률 분야 AI 시스템의 성능을 정밀하게 평가하고 최적화할 수 있는 방법론이 제시되어, 법률 특화 언어모델의 개발 품질을 크게 높일 수 있다.
핵심 요약
법률 언어모델의 응답 품질을 평가하기 위해 기존의 단순한 판단 방식으로는 법률 분야의 복잡한 요구사항을 충분히 반영할 수 없다는 문제에서 출발한 연구다. LexReward는 법률 응답의 품질을 세 차원으로 평가한다: 어휘·문법적 품질을 보는 Style, 법적 주체·사실·법령·판례를 평가하는 Element, 법률 추론의 순서·완성도·정확성·중복 제거를 보는 Chain. 각 차원마다 평가 기준과 품질 수준을 명시한 루브릭(채점 기준표)을 개발했으며, 이를 바탕으로 DPO(Direct Preference Optimization) 훈련과 보상 모델 학습용 쌍 비교 데이터를 구성했다. 전체 요약 6문장 읽기 → 010 15:11 ▲ 85 · 댓글 2 복잡한 작업도 자기 재작성으로 학습 데이터 확장 복잡한 터미널 작업 해결을 위해 Recursive Self-Rewrite(RSR) 프레임워크를 제안했다. AI · 머신러닝 · Scaling Trajectories for Complex Tasks through Recursive Self-Rewrite
Key Point 다양한 도구와 환경을 활용한 경험을 일반화된 학습 데이터로 변환하는 기법으로, 복잡한 작업에서 모델 성능을 대폭 끌어올릴 수 있음을 보여준다.
핵심 요약
복잡한 터미널 작업 해결을 위해 Recursive Self-Rewrite(RSR) 프레임워크를 제안했다. Qwen 3.8-27B 기반 모델이 다양한 도구와 환경에서 성공한 해법을 발견하고, 일반 환경에서 재실행 가능한 학습 데이터로 재구성한다. 플래너가 절차를 실행 가이드(runbook)로 추출하고, 비판자가 데이터 누수를 점검하며 반복 개선을 지도한다. 전체 요약 8문장 읽기 → 011 15:11 ▲ 44 · 댓글 3 비디오가 물리 법칙을 얼마나 잘 이해하나 측정하는 벤치마크 물리 현상을 정확히 표현하는 비디오 생성 모델을 평가하기 위해 World Embedding Benchmark를 공개했다. AI · 머신러닝 · World Embedding Benchmark
Key Point 비디오 생성의 물리적 정확성을 평가하는 첫 벤치마크로, 현재 AI 모델들의 물리 이해도를 측정하고 개선 방향을 보여준다.
핵심 요약
물리 현상을 정확히 표현하는 비디오 생성 모델을 평가하기 위해 World Embedding Benchmark를 공개했다. 유체역학, 고체역학, 동역학, 광학·전자기학 등 80개 종류에서 8,000개의 시뮬레이션 영상을 수집하고, 각 영상에 시뮬레이션 기반의 물리 주석을 달았다. 텍스트-영상 검색, 물리적 성질 회귀, 다중선택 분류라는 세 가지 평가 작업으로 영상 임베딩이 물리 정보를 얼마나 잘 인코딩하는지 측정한다. 전체 요약 7문장 읽기 → 012 15:11 ▲ 37 · 댓글 2 LLM 에이전트, 출처에 따라 상품 선택 편향 보여 LLM 에이전트가 사용자를 대신해 상품·숙소·논문을 추천할 때 출처(웹사이트·서비스)에 따라 선호도가 달라지는 현상을 12개 모델, 3개 도메인으로 검증했다. AI · 머신러닝 · Source Preference in the Wild: How LLM Agents Favor Items by Source, and How to Reduce It
Key Point LLM 에이전트가 사용자 의사결정을 대신하는 세상에서 숨겨진 출처 편향이 실제 추천 결과를 왜곡하는 메커니즘과 대응 방법을 구체적으로 보여준다.
핵심 요약
LLM 에이전트가 사용자를 대신해 상품·숙소·논문을 추천할 때 출처(웹사이트·서비스)에 따라 선호도가 달라지는 현상을 12개 모델, 3개 도메인으로 검증했다. 같은 조건을 만족하는 상품을 비교하면 각 모델이 특정 출처를 선호하고 다른 출처는 회피했으며, 모델들이 선호 출처에서 크게 합의했다. 이 출처 편향이 요구사항 충족도를 능가했다: 요구사항을 하나 덜 충족하는 상품이 선호 출처에서 오면 약 2/3 확률로 선택되지만, 비선호 출처 상품이 더 나으면 거의 선택되지 않았다. 전체 요약 6문장 읽기 → 013 03:11 ▲ 11 · 댓글 2 LLM의 진정한 실력은 정확도가 아니라 안정성에서 LLM의 생성 안정성, 즉 같은 입력을 다르게 표현했을 때 일관되고 의미있는 출력을 내보내는 능력을 새로운 관점에서 평가해야 한다는 주장이다. AI · 머신러닝 · Generalization Is Stability, Not Accuracy: Multi-Axis Evaluation of LLMs
Key Point LLM의 정말 믿을 수 있는 성능을 판단하려면 단순 정확도가 아니라 얼마나 일관되게 답하는지를 평가해야 하며, 이 새로운 평가 방식이 기존 벤치마크 순위를 뒤바꿀 수 있다는 점이 중요하다.
핵심 요약
LLM의 생성 안정성, 즉 같은 입력을 다르게 표현했을 때 일관되고 의미있는 출력을 내보내는 능력을 새로운 관점에서 평가해야 한다는 주장이다. 기존 평가는 단일 프롬프트 형식이나 한정된 변형 집합에서 집계 정확도를 측정하는 방식으로, 견고성과 벤치마크 성능을 혼동하고 있다고 지적한다. 연구팀은 개별 예시 수준에서, 여러 입력 변형 구간에서, 모델 행동의 다양한 측면을 측정하는 새로운 평가 프레임워크를 제안한다. 전체 요약 6문장 읽기 → 014 03:11 ▲ 11 · 댓글 2 논문 검색 벤치마크 ScholarCatalyst 공개 Hugging Face에서 논문 검색 벤치마크 ScholarCatalyst를 발표했다. 과학자들이 새로운 연구를 할 때 어떤 선행 논문을 참고하는지 연구하기 위해 만들어졌다. AI · 머신러닝 · ScholarCatalyst: A Benchmark for Retrieving Papers That Inspire New Research
Key Point 현재의 LLM과 에이전트 기술도 논문 검색에서 전문가 수준의 성능을 내지 못하고 있으며, 이는 과학 AI 모델 개발의 새로운 과제를 드러낸다.
핵심 요약
Hugging Face에서 논문 검색 벤치마크 ScholarCatalyst를 발표했다. 과학자들이 새로운 연구를 할 때 어떤 선행 논문을 참고하는지 연구하기 위해 만들어졌다. 컴퓨터과학 분야 최근 논문 207편의 제1저자 184명이 자신의 프로젝트를 진행할 때 도움이 된 논문들을 직접 라벨링했으며, 각각 상세한 근거를 제공했다. 과제 시작 당시 공개된 논문만 사용해 주어진 연구 질문으로부터 도움이 될 만한 논문을 검색하는 태스크로 구성했다. 전체 요약 6문장 읽기 → 015 03:11 ▲ 11 · 댓글 2 음성·영상 AI의 할루시네이션 문제, 질문 재라우팅으로 해결 음성·영상 정보를 함께 다루는 대형언어모델(AVLLM)이 사용하지 않아야 할 모달리티의 신호까지 반영해 잘못된 답변을 생성하는 '소스-혼동 할루시네이션' 문제가 발생한다. AI · 머신러닝 · Devils in Question Relay: Source-Conditioned Relay Steering to Mitigate Hallucinations in Audio-visual Large Language Models
Key Point 음성·영상을 함께 처리하는 AI 시스템에서 불필요한 정보로 인한 오답 문제를 진단하고 해결하는 구체적 방법이 제시되어, 멀티모달 모델의 신뢰성을 높이는 데 직접 적용 가능하다.
핵심 요약
음성·영상 정보를 함께 다루는 대형언어모델(AVLLM)이 사용하지 않아야 할 모달리티의 신호까지 반영해 잘못된 답변을 생성하는 '소스-혼동 할루시네이션' 문제가 발생한다. 연구팀이 경로 개입과 표현 분석을 통해 이 문제의 내부 메커니즘을 규명했다: 질문 상태가 필요한 모달리티의 증거뿐 아니라 간섭 신호도 함께 전달하며, 생성 단계보다는 질문 단계에서 간섭을 차단할 때 더 효과적이다. 이를 바탕으로 SECRET(SourcE-Conditioned RElay sTeering)이라는 훈련 불필요 방식을 제안했다: 서로 다른 모달리티 경로로 추출한 대조적 질문 표현을 이용해 원래 질문을 필요한 소스의 증거로 유도한다. 전체 요약 5문장 읽기 → 016 03:11 ▲ 11 · 댓글 2 월드 모델의 기억 검색을 학습으로 최적화하는 FAR 기법 월드 모델은 현재 경험과 행동으로부터 미래 관측값을 예측하지만, 먼 과거의 관측값에도 의존할 수 있다. AI · 머신러닝 · Learning What to Recall: Adaptive Multi-Cue Episodic Memory for World Models
Key Point 월드 모델에서 과거 메모리를 언제, 어떻게 불러올지를 학습으로 최적화하는 새로운 방법을 제시해, 에피소딕 메모리 활용의 근본적인 문제를 해결한다.
핵심 요약
월드 모델은 현재 경험과 행동으로부터 미래 관측값을 예측하지만, 먼 과거의 관측값에도 의존할 수 있다. 에피소딕 메모리는 과거 관측값을 저장했다가 나중에 불러오는 방식인데, 메모리가 쌓일수록 어떤 기억이 예측에 유용한지, 어떤 검색 단서를 믿어야 하는지 판단하기 어렵다. 시간·자세·시각·음성 등 고정된 기준으로 메모리를 선택하는 것은 환경과 쿼리에 따라 신뢰성이 떨어진다. 전체 요약 8문장 읽기 → 017 03:11 ▲ 10 · 댓글 2 LLM 과학 코딩 에이전트를 위한 실행 가능한 검증 도구 개발 과학 코딩 에이전트가 작성된 규칙을 실행 가능한 검증 도구로 변환하는 'Rules to Tools(R2T)' 방식을 제시한다. AI · 머신러닝 · Rules to Tools: Executable Checks for LLM Agents in Scientific Computing
Key Point LLM 에이전트가 과학 코딩 작업에서 검증 도구의 성능이 텍스트 설명과 비교해 작업 유형에 따라 크게 달라지는데, 이는 에이전트 시스템 설계 시 검증 방식 선택의 중요성을 보여준다.
핵심 요약
과학 코딩 에이전트가 작성된 규칙을 실행 가능한 검증 도구로 변환하는 'Rules to Tools(R2T)' 방식을 제시한다. SciCode 벤치마크의 수리 작업에서 검증 도구를 사용한 그룹이 텍스트 설명만 받은 그룹과 비교해 다양한 성능을 보였다. 8개 작업 기준으로 도구 사용 그룹은 16개 중 15개 성공, 텍스트 그룹은 13개 성공했으며 95% 신뢰 구간은 [-12.5, 43.75]%다. 전체 요약 8문장 읽기 → 018 03:11 ▲ 79 · 댓글 2 과학적 설명이 실험 예측을 얼마나 개선하는지 측정하다 연구 에이전트가 계획한 실험을 설명할 때, 그 설명이 예측 정확도를 실제로 높이는지 측정하는 방법을 제시했다. AI · 머신러닝 · Predictive Credit: Measuring What Scientific Explanations Add to Experimental Forecasts
Key Point 과학적 설명이 AI 예측을 실제로 개선하는지를 엄밀히 측정하려는 방법론을 제시하지만, 대부분의 테스트에서 설명의 효과가 증명되지 않았다는 점이 흥미롭다.
핵심 요약
연구 에이전트가 계획한 실험을 설명할 때, 그 설명이 예측 정확도를 실제로 높이는지 측정하는 방법을 제시했다. 같은 중재·예측자·결과를 가진 쌍 예측을 비교하되 설명과 맥락을 달리하여, 약속 이행·예측 이득·신호 습득을 추적하는 5가지 검증을 수행했다. 통제된 학습 환경의 336개 전망 상태, 독성 테스트 12개 지표, OpenML 24개 작업을 대상으로 평가했으나 신용도 점수 결정이 결론적이지 않았다. 전체 요약 8문장 읽기 → 019 03:11 ▲ 57 · 댓글 2 여러 LLM을 조합한 멀티에이전트, KV 캐시 공유로 10배 빠르게 Llama, Mistral 등 서로 다른 모델을 조합하는 멀티에이전트 LLM 시스템에서, 송신자의 처리된 문맥을 수신자가 다시 처리(prefill)하는 중복 비용이 발생한다. AI · 머신러닝 · Prefill-Free Cross-Family KV Cache Transfer for Heterogeneous Multi-Agent LLMs
Key Point 서로 다른 LLM을 조합하는 멀티에이전트 시스템에서 구조적 차이를 극복하고 캐시 재사용으로 최대 10배의 속도 향상을 달성한 방식이 처음 제시되었습니다.
핵심 요약
Llama, Mistral 등 서로 다른 모델을 조합하는 멀티에이전트 LLM 시스템에서, 송신자의 처리된 문맥을 수신자가 다시 처리(prefill)하는 중복 비용이 발생한다. 논문은 HeteroFold라는 방식을 제안했다. 토큰화·모델 깊이·KV 표현의 차이를 처리하면서 양쪽 모델을 그대로 두고 KV 캐시를 다른 모델 족으로 이전한다. HeteroFold는 구조를 정렬하고, 송신자의 캐시를 수신자 공간으로 매핑한 뒤, 수신자의 동작을 유지하도록 보정한다. 전체 요약 6문장 읽기 → ● 이번 피드는 여기까지입니다.
작은 발견을 다음 커밋으로 이어가세요. 모든 발행본