쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 22일 (일)까지 5067건
33건 · "모델 선택"조건 지우기 ×
001 21:11 ▲ 13 · 댓글 2 바이오메드 의료 데이터 94개로 모델 벤치마킹 프레임워크 공개 생의학 예측에서 구조화된 데이터 평가가 단편적이라는 문제를 해결하기 위해 TabBioMed 벤치마크를 개발했다. AI · 머신러닝 · TabBioMed: A Large-Scale Benchmark for Biomedical Tabular Learning
Key Point 생의학 머신러닝에서 테이블형 데이터를 다룰 때 모델 선택 기준이 뚜렷해져, 의료 AI 개발 시 성능과 효율의 트레이드오프를 고려한 의사결정이 가능해진다.
핵심 요약
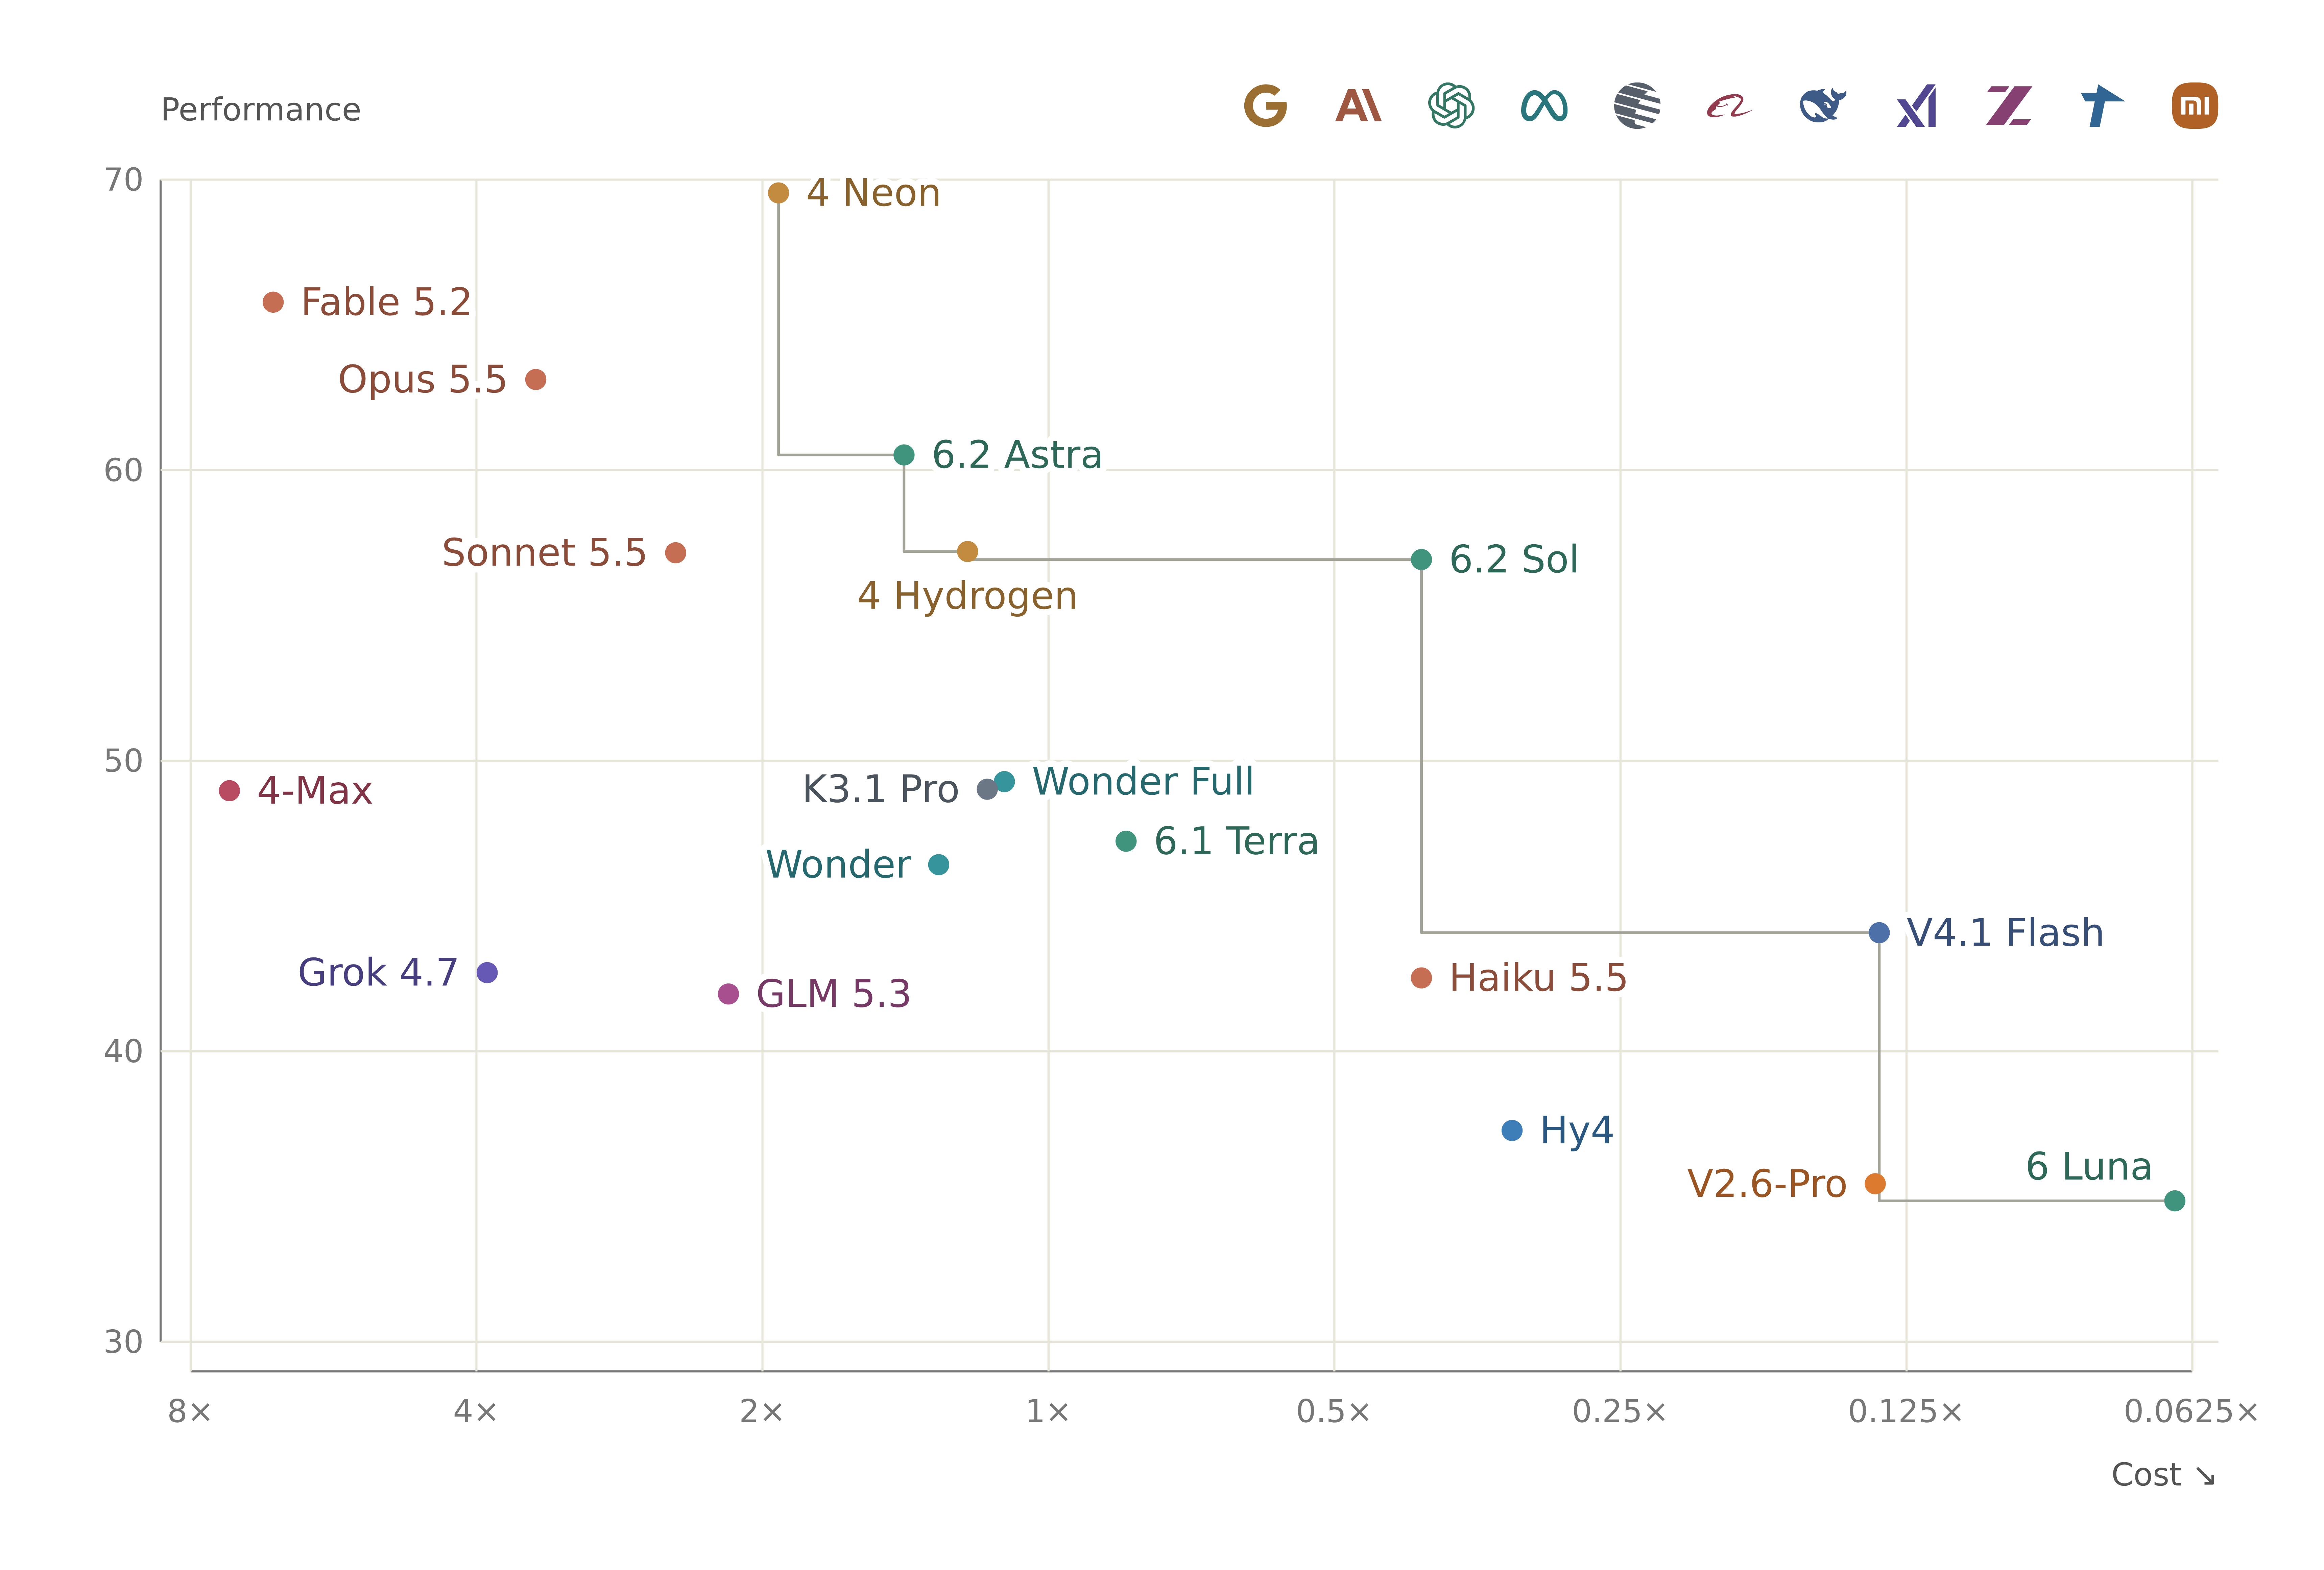
생의학 예측에서 구조화된 데이터 평가가 단편적이라는 문제를 해결하기 위해 TabBioMed 벤치마크를 개발했다. 전자의료기록, 신약개발, 유전체학, 전사체학, 단백질체학, 대사체학, 단일세포 오믹스, 시스템생물학 등 94개의 생의학 테이블형 데이터셋을 수집했다. 고차원성, 대규모 샘플, 결측값, 클래스 불균형 등 현실적 문제를 반영한 데이터셋들이다. 전체 요약 9문장 읽기 → 002 12:10 ▲ 185 · 댓글 108 구글 Gemini 4 Neon, 성능 대비 비용 효율 모델 순위 1위 구글의 Gemini 4 Neon이 Models Engineering Index의 성능 대비 비용 효율 순위에서 1위를 차지했으며, 인덱스 점수는 68.0이다. AI · 머신러닝 · Gemini 4 Neon is the new #1 on the Models Engineering Index
Key Point 생성형 AI 모델 선택 시 성능뿐 아니라 운영 비용의 효율성이 점점 중요해지고 있으며, 최신 순위는 각 모델 간 비용-성능 트레이드오프를 비교하는 데 필요하다.
핵심 요약
구글의 Gemini 4 Neon이 Models Engineering Index의 성능 대비 비용 효율 순위에서 1위를 차지했으며, 인덱스 점수는 68.0이다. 상위 모델들은 Anthropic의 Claude Fable 5.2(점수 65.3), OpenAI의 GPT-4 Astra(점수 61.5), 구글 Gemini 4 Carbon(점수 61.4) 등이 뒤를 이었다. Models Engineering Index는 LLM 모델들을 성능 점수와 비용, 토큰 수를 기준으로 순위를 매기는 평가 지표이다. 003 06:11 새 버전 OpenAI Python SDK v3.56.0 릴리스, gpt-live-1.1 모델 추가 OpenAI Python SDK v3.56.0이 릴리스됐다. AI · 머신러닝 · openai/openai-python@v3.56.0
Key Point OpenAI의 공식 Python 라이브러리에 새로운 실시간 모델이 추가되어, Live API를 사용하는 개발자가 최신 모델을 곧바로 활용할 수 있게 되었다.
핵심 요약
OpenAI Python SDK v3.56.0이 릴리스됐다. gpt-live-1.1 모델이 Live API 모델 선택 옵션에 추가됐다. 004 03:11 ▲ 192 · 댓글 78 모델마다 최적 하네스가 다르다 Baseten과 협력해 83B 토큰, 27,280회 에이전트 실행을 통한 대규모 하네스 리더보드를 구축했으며, 모델 전환 시 하네스도 함께 바꿀지 고민해야 한다는 질문에 답하려 했다. AI · 머신러닝 · What is the best harness for each model?
Key Point 모델 선택 시 하네스도 함께 고려하면 작업당 비용을 최대 5배까지 절감할 수 있다는 실제 데이터를 제시한다.
핵심 요약
Baseten과 협력해 83B 토큰, 27,280회 에이전트 실행을 통한 대규모 하네스 리더보드를 구축했으며, 모델 전환 시 하네스도 함께 바꿀지 고민해야 한다는 질문에 답하려 했다. v1.1은 22개 하네스 × 5개 모델 × 62개 태스크 × 4회 시도로 v1.0 대비 76배 규모로 확대됐다. 모델별 최적 하네스는 GLM-5.3용 Codex CLI, GLM-5.3 Flash용 Pi, DeepSeek V4.1 Flash 1017용 ZCode, Muse용 Oh My Pi, Kimi-K3용 Alma이다. 전체 요약 12문장 읽기 → 005 18:11 ▲ 100 · 댓글 2 의료 AI의 포용성을 측정하는 'InclusionMed' 벤치마크 공개 다양한 의료 역할과 AI 능력에 걸쳐 의료 AI를 평가하기 위한 오픈 평가 이니셔티브 'InclusionMed'를 소개한다. AI · 머신러닝 · InclusionMed: Benchmarking AI for Inclusive Healthcare
Key Point 의료 AI 모델마다 역할별·능력별 성능이 크게 차이 나므로, 단순 순위만으로는 실제 임상 환경에 맞는 모델을 선택할 수 없다는 점을 보여준다.
핵심 요약
다양한 의료 역할과 AI 능력에 걸쳐 의료 AI를 평가하기 위한 오픈 평가 이니셔티브 'InclusionMed'를 소개한다. InclusionMed Atlas는 3가지 의료 역할과 3가지 AI 능력 조합으로 벤치마크를 체계적으로 구성하며, 388개 후보 중 구조화된 감시를 거쳐 4개의 공개 벤치마크와 자체 진단 추론 벤치마크 'InclusionMed-DxFiles'를 선정했다. 최신 대규모 언어 모델들을 Atlas에서 평가한 결과 InclusionMed Index 점수는 100점 만점에 17.5~49.1점 범위로 분포했으며, 모델의 순위는 평가 대상 의료 역할이나 AI 능력에 따라 달라졌다. 전체 요약 5문장 읽기 → 006 03:11 ▲ 12 · 댓글 3 웹 에이전트의 현실성 높인 평가 기준 등장 LLM과 비전-언어 모델 기반 웹 에이전트의 성능을 평가하는 새로운 벤치마크인 WebArena-Pro가 공개되었다. AI · 머신러닝 · WebArena-Pro: A Heterogeneous, Multimodal, Reproducible Benchmark for Web Agents
Key Point 웹 에이전트의 실제 적용 가능성을 판단할 기준이 부족했는데, 멀티모달 콘텐츠와 다양한 웹 애플리케이션을 아우르는 재현 가능한 벤치마크 등장으로 개발자가 모델 선택과 개선 방향을 더 정확히 판단할 수 있게 되었다.
핵심 요약
LLM과 비전-언어 모델 기반 웹 에이전트의 성능을 평가하는 새로운 벤치마크인 WebArena-Pro가 공개되었다. 6개 도메인 20개 자체 호스팅 웹 애플리케이션 300개 과제로 구성되며, 텍스트·이미지뿐 아니라 오디오·비디오도 포함한 멀티모달 콘텐츠를 평가한다. 기존 재현 가능한 벤치마크는 적은 수의 웹 애플리케이션만 다루거나 모달리티를 제한했으나, WebArena-Pro는 이 두 한계를 동시에 해결했다. 전체 요약 6문장 읽기 → 007 21:11 당일 +322 PS5·캡처 카드를 120fps로 고주파 재생하는 Veyra 2.1.5 공개 Windows용 GPU 기반 실시간 영상 개선 도구 Veyra 2.1.5를 공개했다. 초해상화·노이즈 제거·HDR·프레임 생성 기술을 조합해 PS5·Xbox·PC·캡처 카드 영상을 실시간으로 고화질화할 수 있다. AI · 머신러닝 · Likely7/Veyra-NRVideo · C++
Key Point DLSS 5와 AI 초해상화로 기존 영상을 고주파 고화질로 업스케일링하는 기술이 실시간 게임·방송 녹화에 어떻게 적용되는지 보여주는 실제 구현체다.
핵심 요약
Windows용 GPU 기반 실시간 영상 개선 도구 Veyra 2.1.5를 공개했다. 초해상화·노이즈 제거·HDR·프레임 생성 기술을 조합해 PS5·Xbox·PC·캡처 카드 영상을 실시간으로 고화질화할 수 있다. 2.1.2 버전 주요 업데이트는 RTX Video SR 듀얼 초해상화, SR 후 다운샘플링, NVIDIA Low Latency 지원, RX 7000 노이즈 제거 실험 기능을 추가했다. 2.1.1은 처리된 영상 녹화·오디오 포함, 90도 회전 재생, 레이어별 노이즈 제거 강도 조절, 내보내기 크기 조절 기능을 지원한다. 전체 요약 10문장 읽기 → 008 18:11 ▲ 137 · 댓글 3 빠른 AI 모델의 신뢰성을 측정하는 벤치마크 'SO-Arena' 공개 System One 모델은 빠른 결정을 내리는 대신 생성 토큰을 줄이지만, 기존 벤치마크로는 능력과 신뢰성을 제대로 평가하기 어렵다는 한계가 있었다. AI · 머신러닝 · SO-Arena: Benchmarking the Capability Spectrum and Reliability of System One Models
Key Point 정확도 높은 AI 모델이 실제 환경에서 신뢰할 수 있는 판단을 하는지 확인하는 새로운 평가 방식이 제시되어, 프로덕션 배포 시 모델 선택의 기준이 달라질 수 있다.
핵심 요약
System One 모델은 빠른 결정을 내리는 대신 생성 토큰을 줄이지만, 기존 벤치마크로는 능력과 신뢰성을 제대로 평가하기 어렵다는 한계가 있었다. 연구팀이 SO-Arena을 제안했으며, 11개 도메인과 5개 능력 계열에 걸쳐 System One 모델의 능력 스펙트럼과 의사결정 신뢰성을 평가한다. 신뢰할 수 있는 출처 기반 평가, 수동 검증, 샌드박스 환경에서의 반복적 실행 등으로 현실적인 대화형 평가를 제공한다. 전체 요약 8문장 읽기 → 009 03:11 ▲ 106 · 댓글 27 결정 모델 추론 최대 9.5배 빠르게 하는 Flide 공개 OmniJev가 개발한 Flide는 Jev 스타일 결정 모델용 고속 추론 인프라로, 정확한 상태 포킹(exact state forking) 기술을 통해 vLLM과 SGLang 대비 최대 9.5배 빠른 속도를 제공한다. AI · 머신러닝 · Show HN: Flide: Make Jev-like decision models up to 9.5x faster
Key Point 결정 모델을 다루는 개발자와 AI 애플리케이션 구축자에게 기존 추론 엔진 대비 크게 향상된 성능과 다양한 모델 선택지를 제공하는 오픈소스 도구다.
핵심 요약
OmniJev가 개발한 Flide는 Jev 스타일 결정 모델용 고속 추론 인프라로, 정확한 상태 포킹(exact state forking) 기술을 통해 vLLM과 SGLang 대비 최대 9.5배 빠른 속도를 제공한다. Flide는 /v1/systemone API를 서빙하며, 모든 응답이 모델 단독으로 처리한 결과이다. 모델은 Python 3.12와 PyPI를 통해 설치할 수 있고, 명령 한 줄로 각 모델을 시작할 수 있다. 전체 요약 9문장 읽기 → 010 12:54 새 버전 올라마 0.40.15, 새 AI 모델과 동시 요청 지원 Ollama v0.40.15가 공개되었으며, MiMo V2.6(샤오미의 9B 코드·에이전트 모델)와 AutoTrust 의사결정 모델(9b, 35b, 27b-vl 크기로 35b와 27b-vl은 이미지 인식 가능)이 새로 지원된다. AI · 머신러닝 · ollama/ollama@v0.40.15
Key Point 로컬 AI 모델 실행 프레임워크의 주요 버전 업데이트로, 새 모델 지원과 동시 요청 처리 개선으로 개발 워크플로우가 확대된다.
핵심 요약
Ollama v0.40.15가 공개되었으며, MiMo V2.6(샤오미의 9B 코드·에이전트 모델)와 AutoTrust 의사결정 모델(9b, 35b, 27b-vl 크기로 35b와 27b-vl은 이미지 인식 가능)이 새로 지원된다. ollama launch 명령이 Kimi Code CLI를 지원하고 기존 kimi-cli 설정 마이그레이션을 제공하며, Pi 모델 목록이 자동으로 채워지고 Claude Desktop의 모델 선택창에 Ollama 모델명이 표시된다. Recurrent과 Vision GGUF 모델이 이제 한 번에 여러 요청을 처리할 수 있게 되었다. 전체 요약 6문장 읽기 → 011 21:11 당일 +667 AI 에이전트를 위한 콘텐츠 생성 스킬 모음 공개 Scenario가 AI 코딩 에이전트(Claude Code, Cursor, Copilot 등 70개 이상)를 위한 에이전트 스킬을 공개했다. AI · 머신러닝 · scenario-labs/skills · Python
Key Point 생성형 AI를 활용한 콘텐츠 제작의 대규모 자동화를 원하는 개발자나 크리에이티브 팀이 직접 검토해볼 수 있는 체계적인 도구 모음이다.
핵심 요약
Scenario가 AI 코딩 에이전트(Claude Code, Cursor, Copilot 등 70개 이상)를 위한 에이전트 스킬을 공개했다. Scenario MCP 서버를 통해 이미지, 비디오, 오디오, 텍스처, 스카이박스, 3D 에셋 등 프로덕션급 콘텐츠를 생성할 수 있다. 게임 아트용 스프라이트, 타일셋, 아이콘부터 영상 광고, 음악, 음성, 자막 생성까지 100개 이상의 세분화된 스킬을 제공한다. 전체 요약 9문장 읽기 → 012 00:11 ▲ 260 · 댓글 61 미스트랄, 1조 파라미터 대형 모델 가중치 공개 미스트랄이 1조 파라미터 멀티모달 모델 '르 총크(Le Chonk)'의 가중치를 공개했으며, 3주간의 강화학습으로 코딩과 사이버보안 성능을 크게 향상시켰다. AI · 머신러닝 · Mistral Large 4 (Le Chonk) is now Open Weight
Key Point 오픈가중치 대형 언어 모델의 최강자로 자리잡아 개발사들의 모델 선택지가 크게 늘어날 뿐 아니라, 주권 AI 전략을 추진하는 유럽 기관들과 규제가 엄격한 금융·방위 부문에서 실질적인 대안을 제공하기 시작했다.
핵심 요약
미스트랄이 1조 파라미터 멀티모달 모델 '르 총크(Le Chonk)'의 가중치를 공개했으며, 3주간의 강화학습으로 코딩과 사이버보안 성능을 크게 향상시켰다. FrontierCode 2.0 벤치마크에서 19.7%, Terminal-Bench 4.0에서 41%의 성능을 달성하며 오픈가중치 코딩 모델 중 최고 수준을 기록했다. Artificial Analysis 코딩 에이전트 인덱스에서 48%를 달성하며 GLM-5.3과 동등하지만 평균 47% 적은 토큰을 사용해 효율성이 우수하다. 전체 요약 13문장 읽기 → 013 21:11 당일 +206 자체 인프라에서 운영하는 오픈소스 AI 에이전트 플랫폼 OpenBot CopilotKit가 오픈소스 AI 에이전트 플랫폼 OpenBot을 공개했으며, 기업이 자신의 인프라에서 ChatGPT나 Claude 같은 AI 어시스턴트를 직접 운영할 수 있도록 설계했다. AI · 머신러닝 · CopilotKit/OpenBot · TypeScript
Key Point 기업이 기존 SaaS 에이전트 서비스에 의존하지 않고 자신의 인프라에서 완전히 제어 가능한 AI 에이전트 시스템을 직접 구축·운영할 수 있는 오픈소스 솔루션이 나왔다.
핵심 요약
CopilotKit가 오픈소스 AI 에이전트 플랫폼 OpenBot을 공개했으며, 기업이 자신의 인프라에서 ChatGPT나 Claude 같은 AI 어시스턴트를 직접 운영할 수 있도록 설계했다. 각 에이전트(코워커)는 독립적인 브라우저, 파일 시스템, 로그인 정보를 가진 자체 컴퓨터를 보유하며 실행 전 모든 작업이 결정되고 실행 후 기록된다. AG-UI 프로토콜 기반으로 LangGraph, Mastra, CrewAI, Pydantic AI 등 다양한 에이전트 프레임워크와 호환되며, 프레임워크에 종속되지 않는다. 전체 요약 13문장 읽기 → 014 21:11 당일 +100 IDE에 연결된 Hermes 에이전트 오퍼레이션 레이어 공개 Oh-My-Hermes는 Hermes Agent의 운영 계층으로, 작업 카테고리(초고성능·심화·시각공학·신속 등)에 맞춰 각 레인에 최적의 모델과 추론 난이도를 자동 선택한다. AI · 머신러닝 · rlaope/oh-my-hermes · Python
Key Point Hermes 에이전트를 IDE에서 효율적으로 운영하려는 개발자들에게, 자동 모델 선택·병렬 실행·통합 검증 체계를 한 번에 제공하는 실무 도구가 공개되었다.
핵심 요약
Oh-My-Hermes는 Hermes Agent의 운영 계층으로, 작업 카테고리(초고성능·심화·시각공학·신속 등)에 맞춰 각 레인에 최적의 모델과 추론 난이도를 자동 선택한다. dag-ulw 명령어로 목표를 작은 노드의 그래프로 변환하면 준비된 노드들이 병렬로 실행되며, 같은 파일을 수정하는 노드는 동시 실행되지 않는다. 프론트엔드·백엔드·Rust·보안 리뷰 등 100개 이상의 omh-* 전문 스킬을 라우터가 자동으로 적재하며, 사용자가 명시적으로 호출할 필요는 없다. 전체 요약 14문장 읽기 → 015 06:11 ▲ 28 · 댓글 2 멀티모달 임베딩의 새로운 기준, EmbeddingGemma 2 공개 Google이 오픈 멀티모달 임베딩 모델 EmbeddingGemma 2를 발표했다. AI · 머신러닝 · EmbeddingGemma 2: Unified and Efficient Multimodal Representations
Key Point 멀티모달 검색과 임베딩 생성이 필요한 개발자와 머신러닝 엔지니어에게 오픈 모델 선택지가 생겼으며, 작은 모델로 대형 모델 수준의 성능을 달성할 수 있다는 것이 중요하다.
핵심 요약
Google이 오픈 멀티모달 임베딩 모델 EmbeddingGemma 2를 발표했다. 텍스트, 이미지, 오디오, 비디오를 단일 벡터 공간에 통합으로 표현한다. 단순화된 계층별 임베딩과 모달리티·목표 기반 다단계 커리큘럼을 도입했다. 전체 요약 7문장 읽기 → 016 12:11 ▲ 283 · 댓글 6 AI 에이전트 신뢰성 평가 벤치마크 'TraceTrial-Bench' 공개 LLM 기반 AI 에이전트의 신뢰성을 평가하는 새로운 벤치마크 TraceTrial-Bench를 제시했다. AI · 머신러닝 · Trial by Trace: Benchmarking AI Agent Harnesses for Reliability and Failure Attribution
Key Point LLM 에이전트 개발 시 모델 선택만으로는 부족하며, 실제 운영 환경의 하네스 설계가 신뢰성에 얼마나 큰 영향을 미치는지 처음으로 정량적으로 드러냈다.
핵심 요약
LLM 기반 AI 에이전트의 신뢰성을 평가하는 새로운 벤치마크 TraceTrial-Bench를 제시했다. 기존 벤치마크는 모델 성능 중심이었으나, 이 연구는 에이전트를 지탱하는 하네스(harness) 신뢰성에 초점을 맞췄다. 하네스 신뢰성을 컨텍스트, 실행, 거버넌스, 라이프사이클, 관찰성, 도구, 검증 7가지 요소로 분류했다. 전체 요약 10문장 읽기 → 017 21:11 당일 +658 Google, 터미널용 Gemini AI 에이전트 공개 Google이 오픈소스 AI 에이전트 Gemini CLI를 공개했으며, TypeScript로 작성되어 GitHub에서 관리되고 있다. AI · 머신러닝 · google-gemini/gemini-cli · TypeScript
Key Point 터미널 기반 AI 에이전트 표준이 형성되고 있는 가운데, Google이 공식 오픈소스 도구로 대응하며 MCP 서버 지원으로 확장성을 열어두고 있다.
핵심 요약
Google이 오픈소스 AI 에이전트 Gemini CLI를 공개했으며, TypeScript로 작성되어 GitHub에서 관리되고 있다. 터미널에서 직접 Gemini 모델에 접근할 수 있으며, 코드 이해·생성, 대형 코드베이스 편집, PDF나 이미지에서 앱 생성 등이 가능하다. 자동화 작업, PR 쿼리, 복잡한 리베이스 처리, MCP 서버 연결로 Imagen·Veo·Lyria 같은 미디어 생성 기능 통합이 지원된다. 전체 요약 9문장 읽기 → 018 18:11 ▲ 134 · 댓글 114 최강 AI 모델 보유한 OpenAI, 왜 토큰 팔기만 할까 OpenAI와 Anthropic이 보유한 최첨단 모델이 정말 우수하다면, 모델을 팔기보다 이를 직접 활용해 자체 상품을 만드는 회사들을 여러 개 설립하는 것이 더 큰 수익을 가져올 수 있지 않을까라는 질문이 제기된다. AI · 머신러닝 · Ask HN: If the models are so good, why doesn't OpenAI just start 100 companies?
Key Point 대형 AI 기업의 사업 모델 선택에 대한 근본적인 질문으로, 현재 토큰 판매 중심 전략이 정말 최선인지, 또는 자체 서비스 개발로 더 큰 이윤을 확보할 여지가 있는지 검토하게 한다.
핵심 요약
OpenAI와 Anthropic이 보유한 최첨단 모델이 정말 우수하다면, 모델을 팔기보다 이를 직접 활용해 자체 상품을 만드는 회사들을 여러 개 설립하는 것이 더 큰 수익을 가져올 수 있지 않을까라는 질문이 제기된다. 토큰을 판매하는 것이 최적의 전략인지에 의문을 제시하며, AI 모델 가격이 하락하고 있는 현실을 지적한다. 기술 자체(utility side)의 가치보다 그 기술을 활용한 애플리케이션·서비스(application-side)에서 더 많은 수익을 만들 수 있을 가능성을 시사한다. 019 18:11 ▲ 28 · 댓글 2 LLM 에이전트의 메모리 효율화, 강화학습으로 최적화 LLM 에이전트 시스템에서 메모리는 상호작용 간 정보 보유와 재사용을 지원하지만, 기존 방식은 쿼리를 고려하지 않고 메모리를 구축해 불필요한 전처리 비용과 정보 손실을 초래한다. AI · 머신러닝 · MemPilot: Orchestrating On-Demand Multimodal Memory Curation for LLM Agents
Key Point LLM 에이전트가 상황에 맞게 메모리 처리 비용을 조절할 수 있게 함으로써, 가격과 속도 제약이 있는 실제 배포 환경에서 실용적인 선택지를 제공한다.
핵심 요약
LLM 에이전트 시스템에서 메모리는 상호작용 간 정보 보유와 재사용을 지원하지만, 기존 방식은 쿼리를 고려하지 않고 메모리를 구축해 불필요한 전처리 비용과 정보 손실을 초래한다. MemPilot은 성능·비용·지연 시간 우선순위에 따라 요청 시 메모리를 정리하는 유연한 프레임워크를 제시한다. 강화학습으로 최적화한 다단계 정책을 통해 사전 구축 메모리 검색과 쿼리 특화 정리 중 선택하며, 증거량·정리 지시·모델 선택·이미지 접근을 통합 제어한다. 전체 요약 7문장 읽기 → 020 21:11 당일 +188 자신의 모델로 운영하는 오픈소스 AI 에이전트 Rakazo Rakazo는 TypeScript 기반의 오픈소스 AI 에이전트 플랫폼으로, 사용자가 자신의 AI 모델과 컴퓨팅 환경을 선택해 운영할 수 있는 자체 호스팅 방식의 Grok Bot 대체제다. AI · 머신러닝 · elie222/rakazo · TypeScript
Key Point 자신의 AI 모델 선택권과 완전한 자체 호스팅이 가능한 오픈소스 에이전트 플랫폼으로, Grok Bot·Meta Muse 같은 호스팅형 AI 에이전트에 종속되지 않으려는 개발팀과 조직에게 실질적인 선택지를 제공한다.
핵심 요약
Rakazo는 TypeScript 기반의 오픈소스 AI 에이전트 플랫폼으로, 사용자가 자신의 AI 모델과 컴퓨팅 환경을 선택해 운영할 수 있는 자체 호스팅 방식의 Grok Bot 대체제다. 웹, Electron 데스크톱 앱, iPhone, Android에서 사용 가능하며, 로컬 머신 전체 스택 운영이나 클라우드 모델·프로바이더 조합을 지원한다. 지속적인 봇 관리, 음성 모드(ElevenLabs·OpenAI·Cartesia·Fish Audio 지원), 팀 공유 및 격리된 개인 컴퓨터, 브라우저·터미널·파일 접근 기능을 제공한다. 전체 요약 10문장 읽기 → 021 09:11 당일 +118 7개 AI 코딩 도구 지원하는 에이전트 마켓플레이스 Claude Code, Cursor, GitHub Copilot, OpenAI Codex CLI, OpenCode, Antigravity CLI, Pi 등 7개 AI 코딩 도구를 지원하는 통합 플러그인 마켓플레이스를 제공한다. AI · 머신러닝 · wshobson/agents · Python
Key Point AI 코딩 도구가 다양해지면서 각각 다른 플러그인 형식을 사용하는데, 이 저장소는 마크다운 소스 하나로 여러 도구를 동시에 지원하는 방식을 보여줌으로써 멀티 플랫폼 에이전트 생태계 운영의 새로운 패턴을 제시한다.
핵심 요약
Claude Code, Cursor, GitHub Copilot, OpenAI Codex CLI, OpenCode, Antigravity CLI, Pi 등 7개 AI 코딩 도구를 지원하는 통합 플러그인 마켓플레이스를 제공한다. 94개 플러그인(로컬 92개, 외부 2개)과 202개 에이전트, 184개 스킬, 105개 커맨드를 포함하고 있으며, Python과 JavaScript 개발, 코드 리뷰, 테스트, 인프라, 보안 등을 다룬다. 각 도구의 특성과 기능에 맞춰 설치 방식이 다르며, 플러그인 마켓플레이스, 네이티브 마켓플레이스, 저장소 클론 후 설치 등의 옵션을 제공한다. 전체 요약 10문장 읽기 → 022 18:12 ▲ 14 · 댓글 2 그래프 이해 능력 진단하는 벤치마크 'GraphDecideBench' 공개 대언어모델(LLM)의 그래프 이해 및 의사결정 능력이 증가하고 있으나, Jev 같은 System One 모델의 그래프 관련 작업 성능은 명확하지 않았다. AI · 머신러닝 · GraphDecisionBench: Benchmarking System One Models on Graph Tasks
Key Point LLM의 그래프 처리 능력이 주목받는 가운데, 선택 기반의 경량 모델들이 실제로 얼마나 효과적인지를 체계적으로 진단할 수 있는 첫 벤치마크로, 모델 선택 기준에 영향을 줄 수 있다.
핵심 요약
대언어모델(LLM)의 그래프 이해 및 의사결정 능력이 증가하고 있으나, Jev 같은 System One 모델의 그래프 관련 작업 성능은 명확하지 않았다. 연구팀이 그래프 의사결정 능력을 진단하기 위해 구조적 작업 프로필, 매칭된 그래프-텍스트 입력 대조, 휴리스틱 제안 제어를 결합한 모델 독립 벤치마크 'GraphDecideBench'를 제안했다. Jev와 관련 선택 기반 모델들을 언어 모델 기준선과 함께 14개 모델-인터페이스 구성으로 평가했다. 전체 요약 7문장 읽기 → 023 03:11 ▲ 116 · 댓글 148 메타 뮤즈, 우수한 디자인으로 소비자 AI 시장 주도권 잡다 메타의 뮤즈는 기술적으로 새롭지 않지만 기존 AI 제품들의 복잡한 인터페이스를 단순하게 정리하여 성공했다. AI · 머신러닝 · What Meta got right with Muse
Key Point 소비자 AI 시장에서 기술 혁신보다 디자인, 메타포, 비즈니스 모델이 얼마나 중요한지 보여주며, 각 기업의 강점과 약점을 명확히 분석한다.
핵심 요약
메타의 뮤즈는 기술적으로 새롭지 않지만 기존 AI 제품들의 복잡한 인터페이스를 단순하게 정리하여 성공했다. 뮤즈는 모델 선택, 작업과 채팅 전환, MCP나 크론 작업 같은 개념을 모두 숨기고 하나의 채팅으로 통합해 단순성을 달성했다. 사용자에게 AI를 '자신의 개인용 도우미'라는 명확한 정신 모델을 제공하며, Jobs-To-Be-Done 프레임워크에 따라 도구 모음이 아닌 동료처럼 작동한다. 전체 요약 8문장 읽기 → 024 00:11 ▲ 16 · 댓글 2 LLM 라우팅을 위한 기초 모델 'RouteFM' 등장 대규모언어모델(LLM) 라우팅은 여러 후보 모델 중 각 쿼리에 가장 적합한 모델을 선택해 추론의 품질-효율 트레이드오프를 개선하는 기술이다. AI · 머신러닝 · Pretrain Once, Route Anywhere: Towards a Foundation Model for LLM Routing
Key Point LLM 라우팅이 환경 변화마다 재훈련이 필요한 한계를 극복하고 범용 기초 모델로 통합되면, 실제 배포에서 모델 선택의 유연성과 효율성이 크게 높아질 수 있다.
핵심 요약
대규모언어모델(LLM) 라우팅은 여러 후보 모델 중 각 쿼리에 가장 적합한 모델을 선택해 추론의 품질-효율 트레이드오프를 개선하는 기술이다. 기존 라우터는 특정 쿼리 워크로드와 후보 모델풀에 최적화되며, 라우팅 환경이 바뀌면 추가 감독이나 재훈련이 필요했다. 연구팀은 LLM 라우팅을 기초 모델 관점에서 접근하는 RouteFM을 제시했으며, 모델의 고정된 정체성에 묶이지 않고 익명의 후보 모델을 행동 맥락으로 특성화한다. 전체 요약 7문장 읽기 → 025 12:11 ▲ 125 · 댓글 97 GLM 5.3 Flash 한 달 집중 사용, 배운 점은? Wagtail 팀이 9월 한 달간 GLM 5.3 Flash 모델만 사용하는 도전을 진행했으나, 총 2B 토큰 중 절반만 해당 모델로 처리했다. AI · 머신러닝 · One month coding with GLM 5.3 Flash
Key Point 개발 조직이 효율적인 LLM 모델을 선택할 때 직면하는 실제 비용 구조와 예상 외 변수들을 구체적 사례로 보여주며, 에너지·비용 절감을 위한 실질적 전략을 제시한다.
핵심 요약
Wagtail 팀이 9월 한 달간 GLM 5.3 Flash 모델만 사용하는 도전을 진행했으나, 총 2B 토큰 중 절반만 해당 모델로 처리했다. 첫 2주는 계획대로 GLM 5.3 Flash만 사용해 $68, 365g 탄소 배출, 4kWh 에너지 소비로 예산 내에서 운영했다. 실험용 MCP 서버 프로토타입에서 잘못된 모델을 선택해 450M 토큰, $150, 5kWh 에너지를 하루 밤사이에 소비하는 예상 외 비용이 발생했다. 전체 요약 8문장 읽기 → 026 06:11 ▲ 10 · 댓글 2 쿼리의 의미를 먼저 파악해 최적 LLM 선택 기존 LLM 라우팅 방식은 쿼리 임베딩이나 모델 표현에서 직접 결정을 내려 왔으나, 쿼리가 실제로 무엇을 필요로 하는지 명확히 나타내지 못했다. AI · 머신러닝 · SeLMRoute: Probabilistic Semantic Evidence for Large Language Model Routing
Key Point LLM 라우팅 결정에 의미론적 근거를 명확히 도입해 해석 가능성을 높이면서 성능을 기존 방식 대비 3% 이상 향상시킨 새로운 접근법이기 때문이다.
핵심 요약
기존 LLM 라우팅 방식은 쿼리 임베딩이나 모델 표현에서 직접 결정을 내려 왔으나, 쿼리가 실제로 무엇을 필요로 하는지 명확히 나타내지 못했다. SeLMRoute는 의미론적 증거 추출, 모델 성능 학습, 배포 목표 적용을 분리하는 라우팅 프레임워크를 제시한다. 의사결정 모델이 쿼리의 추론 요구도, 외부 지식 사용 여부 등 해석 가능한 질문들을 먼저 확률 분포로 평가한다. 전체 요약 9문장 읽기 → 027 21:11 ▲ 102 · 댓글 42 LLM으로 Jev 수준의 고속 의사결정 모델 구축하기 GLM-5.3-Flash를 프롬프트 엔지니어링으로 한 번의 forward pass에서 타입화된 의사결정을 내도록 개선했으며, 전문 의사결정 모델 Jev와 동등한 정확도를 달성했다. AI · 머신러닝 · Turning GLM-5.3-Flash into a Jev-like decision model
Key Point 일반 LLM을 구조화된 의사결정 모델로 탈바꿈시키는 프롬프트 기법이 전문 의사결정 모델과 실무 성능에서 동등하다는 것을 보여주므로, 고도량 의사결정 시스템 구축 시 모델 선택지와 비용-성능 트레이드오프 판단에 실질적 참고가 될 수 있다.
핵심 요약
GLM-5.3-Flash를 프롬프트 엔지니어링으로 한 번의 forward pass에서 타입화된 의사결정을 내도록 개선했으며, 전문 의사결정 모델 Jev와 동등한 정확도를 달성했다. 기본 아이디어는 LLM의 확률 분포에서 옵션별 확률을 직접 읽는 것이다. 숫자로 인덱싱된 옵션 목록을 JSON으로 제시하고 프롬프트를 'choice_index:'로 끝내면, 모델이 첫 토큰에서 내놓는 확률 분포가 각 옵션의 신뢰도가 된다. 29개 공개 데이터셋(2~151개 옵션, 의도 라우팅·감정 분석·법률 문서 등 포함)을 벤치마킹한 결과, GLM-5.3-Flash와 Jev의 정확도 차이는 중앙값 0.7 포인트로 통계적으로 유의미하지 않았다. 전체 요약 12문장 읽기 → 028 03:11 ▲ 167 · 댓글 120 OpenAI, 신흥 AI 모델 Jev를 빠르게 따라잡을 수 있을까 TypeSafe의 Jev는 LLM의 토큰 확률 분포를 이용해 boolean, choice, score 같은 분류 작업을 수행하는 새로운 방식의 모델로 급속도로 채택되고 있다. AI · 머신러닝 · OpenAI is well positioned to fast-follow Jev
Key Point OpenAI의 기술 역량과 기존 인프라가 Jev의 추격을 어렵게 만드는 요소가 무엇인지, 그리고 TypeSafe가 경쟁 우위를 지키려면 어디에 집중해야 하는지를 이해하는 데 필요하다.
핵심 요약
TypeSafe의 Jev는 LLM의 토큰 확률 분포를 이용해 boolean, choice, score 같은 분류 작업을 수행하는 새로운 방식의 모델로 급속도로 채택되고 있다. OpenAI는 도구 호출과 응답 생성 같은 기능에서 이미 수년간 토큰 단위 마이크로 분류기를 암묵적으로 사용해왔으며, 이 기술을 Jev의 방식으로 명시적으로 학습하고 패키징할 수 있다. OpenAI가 같은 기술을 습득하면 Jev를 빠르게 복제할 수 있을 뿐 아니라, 기존 모델과 에이전트에 통합해 더 빠르고 저렴한 응답, 보안 강화, 모델 선택 최적화 같은 추가 가치를 제공할 수 있다. 전체 요약 4문장 읽기 → 029 16:56 당일 +689 AI가 영상의 핵심만 자동으로 잘라주는 오픈소스 도구 비디오 링크 하나를 입력하고 플랫폼을 선택하면 자동으로 쇼츠 형식의 영상을 생성하는 오픈소스 도구 AutoClip을 공개했다. AI · 머신러닝 · zhouxiaoka/autoclip · Python
Key Point 긴 영상에서 플랫폼별 숏폼 콘텐츠를 자동으로 만드는 도구로, 팟캐스트·인터뷰 크리에이터나 마케팅팀이 수작업 편집 시간을 대폭 줄일 수 있다.
핵심 요약
비디오 링크 하나를 입력하고 플랫폼을 선택하면 자동으로 쇼츠 형식의 영상을 생성하는 오픈소스 도구 AutoClip을 공개했다. 긴 영상에서 AI가 하이라이트 장면을 감지해 자동으로 자르고, 자막과 발행 문안까지 함께 만든다. 틱톡, 유튜브 쇼츠, 인스타그램 릴스, 더우인, 샤오훙수, B스탠, 유튜브 등 8개 플랫폼의 화면 비율과 길이 요구사항에 맞춰 최대 10개 영상을 자동 생성한다. 전체 요약 10문장 읽기 → 030 08:25 당일 +195 컴퓨터 비전 개발을 빠르게, Supervision 라이브러리 Roboflow가 제공하는 Python 기반 오픈소스 라이브러리로, 모델 불가지론적 설계로 모든 분류·탐지·분할 모델을 연결할 수 있다. 오픈소스 · 도구 · roboflow/supervision · Python
Key Point 컴퓨터 비전 프로젝트의 반복적인 작업을 표준화된 도구로 통일할 수 있어, 모델 선택에 관계없이 동일한 코드로 여러 프레임워크를 활용할 수 있다.
핵심 요약
Roboflow가 제공하는 Python 기반 오픈소스 라이브러리로, 모델 불가지론적 설계로 모든 분류·탐지·분할 모델을 연결할 수 있다. Ultralytics, Transformers, MMDetection 등 인기 라이브러리와 기본 통합되며, 커스텀 모델도 손쉽게 연결할 수 있다. 데이터 로딩부터 실시간 구역 카운팅까지 컴퓨터 비전 작업의 전체 파이프라인을 지원한다. 전체 요약 5문장 읽기 → 031 08:27 ▲ 128 · 댓글 45 주요 AI 모델 SVG 생성 속도 및 비용 비교 여러 AI 모델의 텍스트-투-이미지 SVG 생성 성능을 체계적으로 비교한 벤치마크 결과를 공개했다. AI · 머신러닝 · Show HN: Pelican-bicycle alternatives
Key Point AI 모델 선택 시 속도와 비용의 트레이드오프를 정량적으로 파악할 수 있는 실제 벤치마크 데이터를 제공한다.
핵심 요약
여러 AI 모델의 텍스트-투-이미지 SVG 생성 성능을 체계적으로 비교한 벤치마크 결과를 공개했다. GPT-6 Astra, Claude Fable 5.1, Gemini 3.8 Flash 등 2026년 최신 모델들을 포함해 6~10개 모델을 대상으로 테스트했다. 각 모델별로 실행 시간(초 단위)과 API 비용($)을 측정했으며, 동일한 프롬프트를 여러 창의적인 동물 시나리오로 반복 실행했다. 전체 요약 5문장 읽기 → 032 21:11 당일 +346 로컬 AI 코딩 에이전트를 위한 독립형 데스크톱 워크스페이스 PI-Desktop은 Electron 기반 데스크톱 애플리케이션으로 AI 코딩 에이전트가 터미널이나 에디터 확장 없이 독립적으로 작업할 수 있는 워크스페이스를 제공한다. AI · 머신러닝 · vastsa/PI-Desktop · TypeScript
Key Point 로컬 우선 접근 방식으로 모델 선택의 자유도가 높고, 에이전트에 대한 인간의 제어와 감시가 기본값인 오픈소스 코딩 에이전트 플랫폼으로, 기업과 개인 개발자의 보안 및 프라이버시 요구사항을 충족시킨다.
핵심 요약
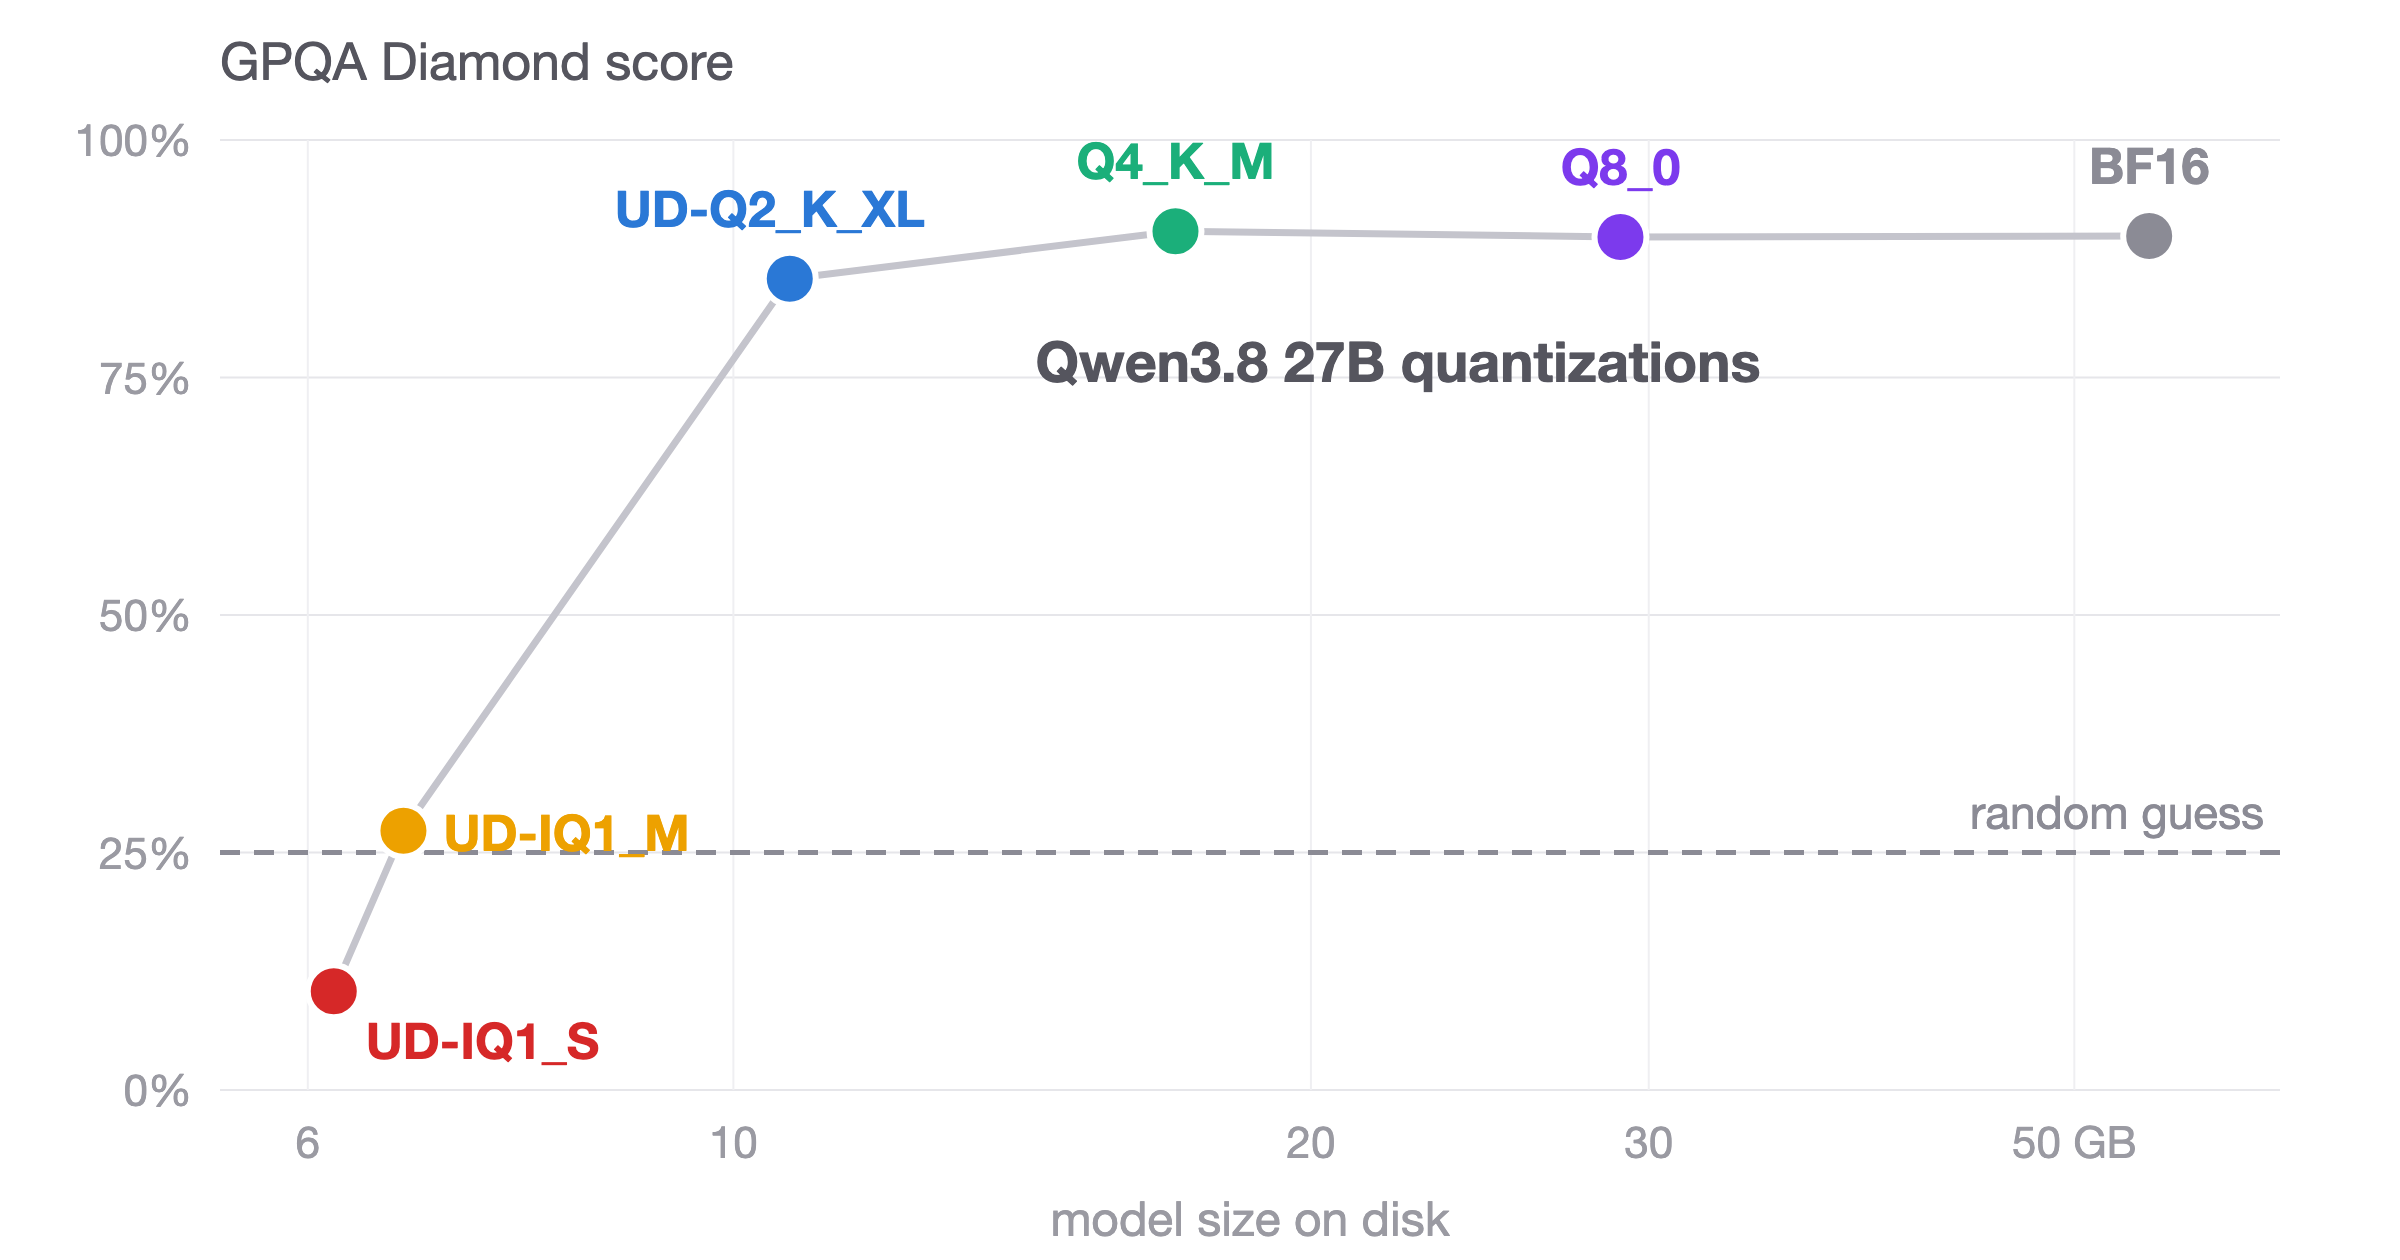
PI-Desktop은 Electron 기반 데스크톱 애플리케이션으로 AI 코딩 에이전트가 터미널이나 에디터 확장 없이 독립적으로 작업할 수 있는 워크스페이스를 제공한다. OpenAI, Anthropic, 로컬 모델, Ollama, LM Studio 등 어떤 OpenAI 호환 API도 연결할 수 있으며, 세션마다 모델을 전환하거나 여러 제공자를 동시에 설정 가능하다. Agent(자동 실행), Plan(계획 승인 후 실행), Goal(결과 승인) 세 가지 모드를 제공하며, 모든 모드에서 권한이 필요한 작업은 권한 계층을 거쳐 사용자가 검토할 수 있다. 전체 요약 5문장 읽기 → 033 08:12 ▲ 218 · 댓글 107 Qwen 3.8 27B, 4비트 양자화까지는 성능 유지 원본 모델 55GB에 비해 4비트 Q4_K_M(17GB)은 Terminal-Bench 2.1 등 주요 벤치마크에서 동일한 성능을 유지한다. AI · 머신러닝 · Benchmarking Qwen3.8 27B quantizations: 4-bit holds up, 1-bit collapses
Key Point 로컬에서 대형 언어 모델을 실행할 때 양자화 정도별로 실제 성능이 어떻게 달라지는지 벤치마크로 확인한 첫 실측 데이터라, 제한된 GPU 메모리 환경에서 모델 선택을 할 때 직접적인 참고 기준이 된다.
핵심 요약
원본 모델 55GB에 비해 4비트 Q4_K_M(17GB)은 Terminal-Bench 2.1 등 주요 벤치마크에서 동일한 성능을 유지한다. RTX 4090(24GB) 같은 소비자 GPU에서도 약 64k 토큰 컨텍스트를 남기며 실행 가능하다. 2비트 양자화는 조금 낮은 성능을 보이지만 10.7GB로 감소하고 실용적 수준을 유지한다. 전체 요약 6문장 읽기 →