쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
21건 · "비용 최적화"조건 지우기 ×
001 12:11 ▲ 17 · 댓글 2 이전 시행 기록으로 AI 에이전트 성능 끌어올리기 상호작용 작업에서 반복 시도는 다음 실행에 도움이 되는 사실, 유용한 작업, 실패 사례를 드러낸다. AI · 머신러닝 · ReGE: Stronger Agents through Experience Synthesis
Key Point 에이전트가 자체 실행 기록을 재활용해 성능을 크게 높일 수 있으며, 비용도 획기적으로 절감할 수 있음을 실증했기 때문에 복잡한 작업을 수행하는 AI 시스템의 구축 방식을 바꿀 가능성이 있다.
핵심 요약
상호작용 작업에서 반복 시도는 다음 실행에 도움이 되는 사실, 유용한 작업, 실패 사례를 드러낸다. ReGE는 이러한 기록된 경험을 새로운 시도의 지침으로 변환하는 프레임워크다. 주요 구현인 ReGE-Syn은 단일 코치 호출로 제한된 실행 기록과 사용 가능한 결과물을 과제별 발견사항과 제안된 행동, 관련 함정을 연결한 자율적 지침으로 종합한다. 전체 요약 10문장 읽기 → 002 03:11 새 버전 OpenAI Python SDK v3.40.0 릴리스, 프롬프트 캐시 TTL 옵션 추가 OpenAI Python SDK v3.40.0이 릴리스되었으며, 주요 기능으로 프롬프트 캐시 브레이크포인트 TTL(Time-To-Live) 옵션이 추가되었다. AI · 머신러닝 · openai/openai-python@v3.40.0
Key Point 프롬프트 캐시 TTL 옵션은 API 호출 시 캐시된 토큰의 유효기간을 세밀하게 제어할 수 있게 해주므로, OpenAI API를 활용하는 개발자들이 비용 최적화와 캐시 정책을 더 정교하게 관리할 수 있다.
핵심 요약
OpenAI Python SDK v3.40.0이 릴리스되었으며, 주요 기능으로 프롬프트 캐시 브레이크포인트 TTL(Time-To-Live) 옵션이 추가되었다. 브라우저 데모 의존성을 명시적으로 지정하는 버그 수정이 포함되었다. 생성된 코드 분리 기록 및 검증 프로세스를 업데이트하고 SDK 헬퍼를 보존하는 개선사항이 적용되었다. 전체 요약 5문장 읽기 → 003 06:11 ▲ 143 · 댓글 53 엔비디아 RTX 3000 시리즈, 커널 모듈로 FP/BF16 성능 잠금 해제 GPU unlock은 리눅스 커널 모듈로 엔비디아 RTX 3090 Ti, 3090, 3080, 3070, 3060 등 GA102/GA103/GA104/GA106 칩 기반 카드의 FP/BF16 명령어 발급 속도를 전문가용 수준으로 끌어올린다. 하드웨어 · 시스템 · GPU-unlock: FP/BF16 instruction issue rate on Nvidia 3000's cards
Key Point GeForce 게이밍 카드의 하드웨어 성능을 전문가용 수준으로 해제하는 커널 모듈 방식이 등장했으며, 드라이버 업데이트 때마다 수동 패치 없이 작동하는 점과 구체적인 성능 배수를 통해 AI/ML 워크로드 비용 최적화 전략을 바꿀 수 있다.
핵심 요약
GPU unlock은 리눅스 커널 모듈로 엔비디아 RTX 3090 Ti, 3090, 3080, 3070, 3060 등 GA102/GA103/GA104/GA106 칩 기반 카드의 FP/BF16 명령어 발급 속도를 전문가용 수준으로 끌어올린다. NVIDIA 드라이버 바인딩 전에 조기 실행되는 방식으로, 새 드라이버 출시 때마다 매번 수동 패치할 필요가 없다. 속도 선택자(SS0 0x88888888, SS1 0x8)를 기록하고 FLR을 수행한 뒤 작동하며, CMP 언로커의 V67/PLM 기법과 UEFI 방식의 사전 드라이버 타이밍을 결합한다. 전체 요약 13문장 읽기 → 004 00:11 ▲ 14 · 댓글 1 에이전트 제어 모델, 비용만 올리고 성능은 못 올려 AI 에이전트가 중단, 검증, 전략 변경 같은 소결정을 저비용 모델에 위임하는 추세 속에서, 특수 설계된 결정 모델 Jev 1.13이 Claude Sonnet 5.5 에이전트를 더 싸게 돌릴 수 있는지 실험했다. AI · 머신러닝 · Good Judgment, Bad Advice: Decision-Model Controllers Raise Agent Cost Without Improving Success
Key Point 작은 모델을 에이전트 제어에 쓰면 비용이 줄 것이라는 가정이 현실 데이터에서 부정되었으며, 오프라인 성능이 좋아도 실제 배포에서는 역효과를 낼 수 있음을 보여준다.
핵심 요약
AI 에이전트가 중단, 검증, 전략 변경 같은 소결정을 저비용 모델에 위임하는 추세 속에서, 특수 설계된 결정 모델 Jev 1.13이 Claude Sonnet 5.5 에이전트를 더 싸게 돌릴 수 있는지 실험했다. Terminal-Bench 2.1의 21개 과제(315시험)에서 Jev는 성공률을 73.0%에서 73.0%로 유지하면서 시도당 비용을 19% 올렸다(기하평균 비율 1.19, 95% 신뢰구간 1.02-1.36). Jev는 Claude Haiku 5.5 소형 언어 모델보다 21% 싸웠지만 위약 대조(개발 단계 선택 빈도로 샘플링)보다는 22% 더 비쌌다. 전체 요약 6문장 읽기 → 005 21:10 당일 +233 Claude API로 앱 개발 빠르게 시작하는 실제 예제 모음 Claude API로 실전 애플리케이션을 빌드하는 개발자를 위한 빠른 시작 프로젝트 모음을 공개했다. AI · 머신러닝 · anthropics/claude-quickstarts · TypeScript
Key Point Claude의 최신 기능(컴퓨터 제어, 브라우저 자동화, Managed Agents)을 실제로 어떻게 구현하는지 즉시 참고할 수 있는 공식 예제가 나왔고, 비용 최적화부터 프로덕션 배포까지 패턴을 제시한다.
핵심 요약
Claude API로 실전 애플리케이션을 빌드하는 개발자를 위한 빠른 시작 프로젝트 모음을 공개했다. 고객 지원 에이전트, 금융 데이터 분석기, 자율 코딩 에이전트 등 기초 구조가 갖춰진 12개 프로젝트를 제공한다. 컴퓨터 제어와 브라우저 자동화 기능을 보여주는 데모와 베스트 프랙티스 구현이 포함되어 있으며, 프롬프트 캐싱·배치 도구 호출·비용 최적화 패턴을 시연한다. 전체 요약 7문장 읽기 → 006 12:11 ▲ 18 · 댓글 2 LLM 에이전트의 비용 줄이는 경량 의사결정 모델 JevAgentHarness LLM 에이전트는 매 단계마다 대규모 언어모델을 호출하는데, 대부분의 호출이 '다음에 어떤 도구를 쓸지' 같은 선택지 문제로 끝나 비용과 시간이 낭비된다. AI · 머신러닝 · JevAgentHarness: Benchmarking, Deploying and Training Decision Models That Share Control with LLMs
Key Point LLM 에이전트의 매 단계 호출 비용을 줄이는 실질적 방법을 제시하며, 실제 에이전트 동작 환경에서의 검증과 훈련 전략이 비용-성능 트레이드오프를 어떻게 개선하는지 보여준다.
핵심 요약
LLM 에이전트는 매 단계마다 대규모 언어모델을 호출하는데, 대부분의 호출이 '다음에 어떤 도구를 쓸지' 같은 선택지 문제로 끝나 비용과 시간이 낭비된다. Jev 같은 경량 의사결정 모델은 이런 선택을 LLM 호출 비용의 일부로 직접 처리할 수 있다. 연구팀은 에이전트의 실제 동작 환경에서 의사결정 모델을 평가하는 AgentDecisionBench를 만들었고, 고립된 질문에서 정확도가 높아도 에이전트 작업 성공률은 69.5%에 불과함을 발견했다. 전체 요약 9문장 읽기 → 007 18:11 ▲ 101 · 댓글 100 코딩 에이전트는 왜 여전히 형편한가 저자는 초기에 코딩 에이전트의 자동화 능력에 매료되었으나, 며칠 후 빈번한 버그, 응답 중단, 작업 미완료 문제를 겪으면서 실망했다. AI · 머신러닝 · Why are coding agents so dumb?
Key Point LLM 성능이 비약적으로 향상되는 와중에도 코딩 에이전트는 설계 결함으로 인해 진전이 없다는 비판으로, 개발자들이 도구 선택과 투자 방향을 판단할 때 실질적 기준을 제시한다.
핵심 요약
저자는 초기에 코딩 에이전트의 자동화 능력에 매료되었으나, 며칠 후 빈번한 버그, 응답 중단, 작업 미완료 문제를 겪으면서 실망했다. 코딩 에이전트는 모델(GPT Astra, Claude Sonnet 등 LLM)과 다르다. 모델이 '뇌' 역할을 한다면, 에이전트는 모델을 시스템에 연결하는 '몸' 역할이다. 주요 문제점: 에이전트는 병렬 처리 가능한 작업을 순차적으로 처리한다. 예를 들어 10개의 독립적인 소작업을 하나씩 완료한 후 다음으로 넘어간다. 전체 요약 12문장 읽기 → 008 21:11 당일 +517 AI 에이전트 토큰 압축 도구 Headroom 공개 Headroom은 AI 에이전트가 읽는 도구 출력, 로그, RAG 청크, 파일, 대화 기록을 LLM에 도달하기 전에 압축한다. AI · 머신러닝 · headroomlabs-ai/headroom · Python
Key Point AI 에이전트 사용 비용의 대부분을 차지하는 토큰을 크기에 따라 20~95% 줄일 수 있으며 클로드, 깃허브 코파일럿 등 주요 에이전트에 대해 기존 코드 수정 없이 즉시 적용할 수 있다.
핵심 요약
Headroom은 AI 에이전트가 읽는 도구 출력, 로그, RAG 청크, 파일, 대화 기록을 LLM에 도달하기 전에 압축한다. 코딩 에이전트는 토큰 20% 절감, JSON은 60~95% 절감하면서 같은 답을 얻는다. Python 라이브러리, HTTP 프록시, MCP 서버의 세 가지 형태로 제공되며 압축은 사용자 머신에서 실행되어 프롬프트나 파일 내용이 외부로 전송되지 않는다. 전체 요약 13문장 읽기 → 009 03:11 ▲ 21 · 댓글 2 비용 효율 중심 LLM 진화 알고리즘 FrugalEvo 공개 LLM 기반 진화 알고리즘의 기존 방식은 고정된 반복 횟수 내 성능 극대화에만 집중했으나, 실제 최적화는 단위 비용당 이득을 최대화해야 한다는 점에 착안했다. AI · 머신러닝 · FrugalEvo: Towards Cost-Aware LLM-Guided Program Evolution
Key Point 동일한 성능을 기존 대비 10~90배 저렴한 비용으로 달성하는 혁신적 비용 최적화 기법으로, LLM 기반 자동 프로그래밍의 실용성을 크게 높인다.
핵심 요약
LLM 기반 진화 알고리즘의 기존 방식은 고정된 반복 횟수 내 성능 극대화에만 집중했으나, 실제 최적화는 단위 비용당 이득을 최대화해야 한다는 점에 착안했다. FrugalEvo는 고성능·고비용 LLM이 해결 전략을 탐색하고, 저비용 LLM이 이를 구현·반복 개선하는 2단계 진화 프레임워크다. 프롬프트와 하니스의 접두사 공유를 극대화해 LLM 캐시 재사용율을 높이는 효율적 진화 과정을 설계했다. 전체 요약 7문장 읽기 → 010 21:11 당일 +230 구글, AI 에이전트용 스킬 라이브러리 오픈소스 공개 구글이 Google Cloud와 관련 제품·기술을 위한 Agent Skills 저장소를 공개했다. AI · 머신러닝 · google/skills · Python
Key Point AI 에이전트 개발 생태계에서 Google 제품·서비스를 활용하려는 개발자가 공식 가이드와 구현 예제를 한 곳에서 찾을 수 있게 된다.
핵심 요약
구글이 Google Cloud와 관련 제품·기술을 위한 Agent Skills 저장소를 공개했다. Cloud 인증·온보딩·솔루션 아키텍처부터 AI/ML, 인프라, 데이터베이스, 개발자 도구, 보안, 웹 호스팅 등 광범위한 분야의 스킬을 포함하고 있다. Genkit(JavaScript, Python, Go, Dart)와 BigQuery, AlloyDB, GKE, Cloud Run, Firebase 등 주요 Google 서비스별 전문화된 스킬을 제공한다. 전체 요약 6문장 읽기 → 011 12:11 ▲ 125 · 댓글 97 GLM 5.3 Flash 한 달 집중 사용, 배운 점은? Wagtail 팀이 9월 한 달간 GLM 5.3 Flash 모델만 사용하는 도전을 진행했으나, 총 2B 토큰 중 절반만 해당 모델로 처리했다. AI · 머신러닝 · One month coding with GLM 5.3 Flash
Key Point 개발 조직이 효율적인 LLM 모델을 선택할 때 직면하는 실제 비용 구조와 예상 외 변수들을 구체적 사례로 보여주며, 에너지·비용 절감을 위한 실질적 전략을 제시한다.
핵심 요약
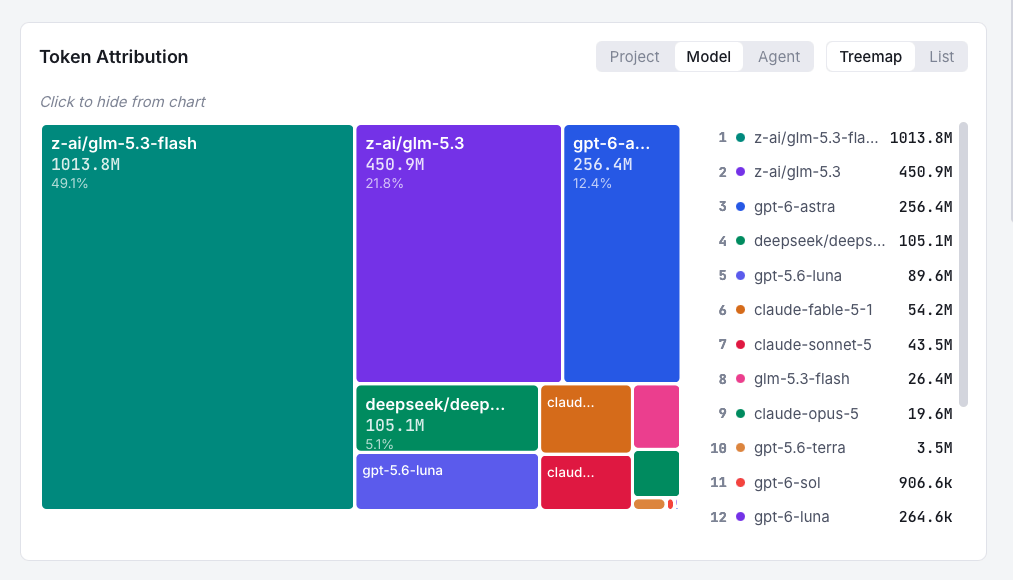
Wagtail 팀이 9월 한 달간 GLM 5.3 Flash 모델만 사용하는 도전을 진행했으나, 총 2B 토큰 중 절반만 해당 모델로 처리했다. 첫 2주는 계획대로 GLM 5.3 Flash만 사용해 $68, 365g 탄소 배출, 4kWh 에너지 소비로 예산 내에서 운영했다. 실험용 MCP 서버 프로토타입에서 잘못된 모델을 선택해 450M 토큰, $150, 5kWh 에너지를 하루 밤사이에 소비하는 예상 외 비용이 발생했다. 전체 요약 8문장 읽기 → 012 09:11 ▲ 13 · 댓글 1 LLM 라우팅의 경제성을 높이는 희소 감독 학습 기법 LLM 라우팅은 쿼리를 적절한 모델에 할당해 서빙 비용을 줄이지만, 라우터 학습을 위해선 여러 후보 모델을 반복 실행해 피드백을 모아야 하므로 배포 전 상당한 감독 비용이 발생한다. AI · 머신러닝 · Routing Should Pay for Itself: Sparse Supervision for Economical LLM Routing
Key Point LLM 라우팅 시스템의 총소유비용을 처음으로 정량화하며, 학습 비용과 서빙 절감을 동시에 고려하는 새로운 평가 방식이 산업 배포에 미치는 영향이 크기 때문이다.
핵심 요약
LLM 라우팅은 쿼리를 적절한 모델에 할당해 서빙 비용을 줄이지만, 라우터 학습을 위해선 여러 후보 모델을 반복 실행해 피드백을 모아야 하므로 배포 전 상당한 감독 비용이 발생한다. 기존 연구는 서빙 단계 효율성에만 집중해, 그 절감액이 사전 학습 비용을 회수할 수 있는지 여부를 무시했다. 라우팅 품질은 모든 피드백을 수집하기 훨씬 전에 포화되는 경향을 보여, 밀집한 감독이 경제적으로 과도함을 시사한다. 전체 요약 8문장 읽기 → 013 15:11 ▲ 33 · 댓글 1 작은 모델도 강력하게: 필요할 때만 큰 모델에 묻는 추론 시스템 작은 추론 모델(sRM)의 테스트 타임 컴퓨팅을 확장하는 것이 성능 향상의 핵심이지만, 더 많은 사고가 항상 도움이 되는지는 명확하지 않다. AI · 머신러닝 · Knowing When Thinking Is Not Enough: Teaching Small Reasoning Models to Reason Beyond Their Parametric Knowledge
Key Point 작은 모델이 큰 모델과 비슷하거나 나은 성능을 훨씬 낮은 비용으로 달성하는 방법을 보여주므로, 프로덕션 추론 비용 최적화를 고민하는 개발팀에게 직접적인 영향이 있다.
핵심 요약
작은 추론 모델(sRM)의 테스트 타임 컴퓨팅을 확장하는 것이 성능 향상의 핵심이지만, 더 많은 사고가 항상 도움이 되는지는 명확하지 않다. 중간 추론 상태에 개입하는 실험을 통해 자기개선(self-refinement)이 기존에 도달 가능한 해답으로 확률질량을 집중시킬 뿐, 새로운 해답을 만들지는 못한다는 것을 발견했다. 두 가지 실패 양식을 식별했다: 올바른 경로는 도달 가능하지만 실행에 실패하는 실행 병목(execution bottleneck)과, 외부 정보가 필요한 지식 병목(knowledge bottleneck)이다. 전체 요약 7문장 읽기 → 014 06:11 ▲ 213 · 댓글 124 토큰 40% 줄인 Kimi K3 기반 Ember-1 공개 Fireworks Research가 Kimi K3를 기반으로 한 Ember-1 모델을 공개했으며, 같은 품질을 유지하면서 토큰을 40% 감소시켰다. AI · 머신러닝 · Ember-1
Key Point 추론 토큰이 비용의 대부분을 차지하는 AI 워크로드(특히 에이전트 작업)에서 비용을 획기적으로 줄일 수 있는 방법이 실제로 작동한다는 검증된 사례이기 때문이다.
핵심 요약
Fireworks Research가 Kimi K3를 기반으로 한 Ember-1 모델을 공개했으며, 같은 품질을 유지하면서 토큰을 40% 감소시켰다. K3의 장황한 추론(최대 90% 이상이 내부 추론에 사용)으로 인한 비용 문제를 해결하기 위해, 불필요한 추론은 제거하고 의미 있는 사고만 보존하도록 훈련했다. 이를 위해 50회 이상의 훈련 실험과 200회 이상의 평가를 수행했으며, 추론 토큰을 줄이면서 정확도를 잃지 않기 위한 새로운 훈련 알고리즘을 개발했다. 전체 요약 12문장 읽기 → 015 22:29 ▲ 28 · 댓글 3 LLM 심판관을 저렴하게: 자신 없으면 상위 모델로 넘기기 LLM을 평가 심판관으로 쓸 때 비용과 신뢰도가 커질수록 문제가 되는데, 결정 전용 모델인 JEV로 1차 심사를 한 후 판단이 필요할 때만 강력한 모델에 넘기는 방식을 제안한다. AI · 머신러닝 · JEV-as-a-Judge: Accept When Confident, Escalate When Unsure
Key Point LLM을 심판으로 쓸 때 대부분의 판정은 저렴한 모델로 처리하되, 판단이 어려운 경우만 비싼 모델을 거쳐 전체 평가 비용을 대폭 줄일 수 있는 실용적 방법을 제시한다.
핵심 요약
LLM을 평가 심판관으로 쓸 때 비용과 신뢰도가 커질수록 문제가 되는데, 결정 전용 모델인 JEV로 1차 심사를 한 후 판단이 필요할 때만 강력한 모델에 넘기는 방식을 제안한다. 16가지 생성형 및 보상 모델 심판관과 블라인드 인간 검증으로 비교한 결과, JEV는 최고 성능 LLM 심판관 대비 일반적 선호도와 근거 기반 사실성 평가에서 3%p 범위 내 정확도를 유지하면서 비용은 0.36%에 불과했다. 미분 계산 확인이나 정교하게 쓰인 오답 저항 같은 복잡한 판단이 필요한 경우 JEV의 성능 격차가 커진다. 전체 요약 5문장 읽기 → 016 09:11 ▲ 115 · 댓글 70 비동기 도구 호출로 AI 에이전트 비용 40% 절감한 언리얼 에이전트 언리얼 랩스가 AI 에이전트 실행 비용을 줄이기 위해 설계한 '언리얼 에이전트' 하네스를 공개했다. AI · 머신러닝 · Unreal Agent
Key Point AI 에이전트의 운영 비용이 주요 과제인 상황에서 하네스 설계를 통해 실질적인 비용 절감을 달성한 오픈소스 솔루션이 등장했다.
핵심 요약
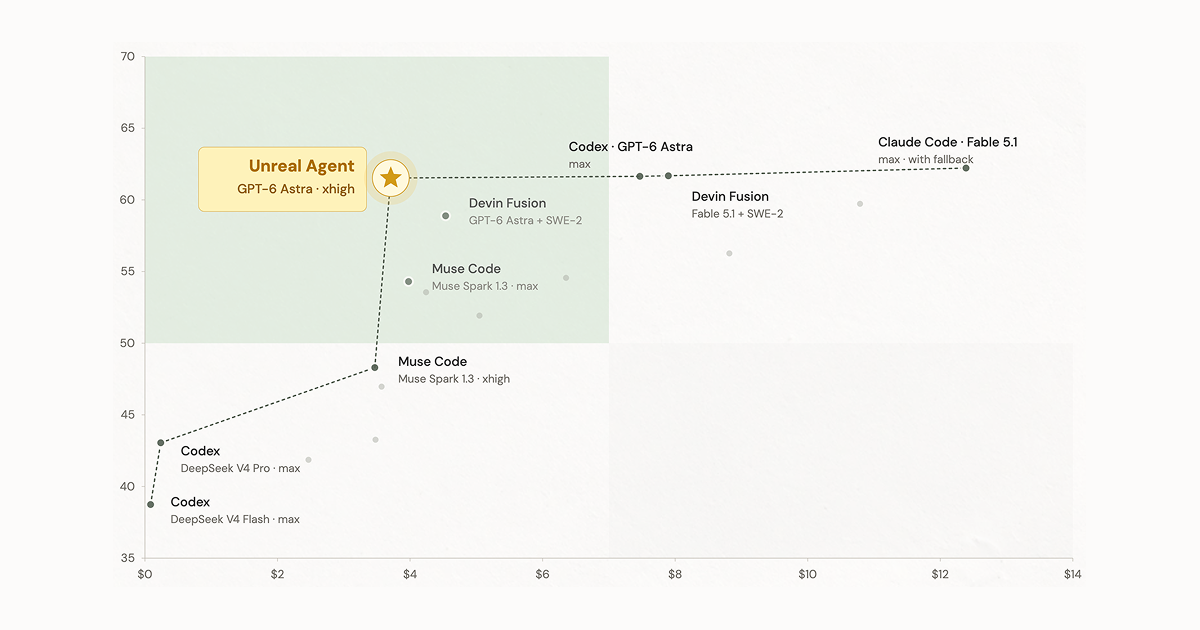
언리얼 랩스가 AI 에이전트 실행 비용을 줄이기 위해 설계한 '언리얼 에이전트' 하네스를 공개했다. 기존 에이전트들이 도구 호출 관리에 많은 토큰을 소비하는 문제를 해결하기 위해 비동기 방식의 도구 호출을 구현했다. 도구 실행을 백그라운드에서 처리하면서 곧바로 'in-progress' 상태를 기록함으로써 사용자 입력을 지연 없이 받을 수 있다. 전체 요약 5문장 읽기 → 017 06:10 ▲ 139 · 댓글 54 페타바이트급 ClickHouse 클러스터 6년 운영 노하우 Tinybird에서 6년간 페타바이트 규모의 ClickHouse 클러스터를 운영해온 경험을 바탕으로 설치보다는 운영이 어렵다는 점을 강조했습니다. 인프라 · 데브옵스 · I've operated petabyte-scale ClickHouse clusters for 5 years
Key Point 페타바이트급 대규모 데이터 인프라를 운영하는 팀의 실제 경험에서 나온 아키텍처 결정, 비용 최적화, 그리고 오픈소스 ClickHouse의 한계를 명확히 보여줍니다.
핵심 요약
Tinybird에서 6년간 페타바이트 규모의 ClickHouse 클러스터를 운영해온 경험을 바탕으로 설치보다는 운영이 어렵다는 점을 강조했습니다. 샤드 없이 수직 확장 레플리카로 시작한 후, HTTP 기반 로드 밸런서로 트래픽을 라우팅하고 쓰기 전용 레플리카를 분리하는 구조를 채택했습니다. 300TB 테이블에 1000 QPS를 처리하려면 10개 레플리카가 필요해 3000TB 용량이 필요하므로 SSD 비용이 매우 큰 문제가 됩니다. 전체 요약 5문장 읽기 → 018 03:10 ▲ 116 · 댓글 57 RTK의 토큰 절감 효과, 실제 벤치마크에서는 미미 AI 코딩 도구 RTK는 터미널 출력을 압축해 토큰 사용량을 줄인다고 주장하며 79k GitHub 스타를 기록했다. AI · 머신러닝 · RTK reports token savings, but our cost benchmarks disagree
Key Point AI 코딩 도구의 비용 절감 효과가 마케팅 주장과 실제 벤치마크에서 큰 차이가 나는 사례로, 어떤 AI 도구가 실제로 비용을 절감하는지 판단할 때 참고할 만한 검증 기준을 보여준다.
핵심 요약
AI 코딩 도구 RTK는 터미널 출력을 압축해 토큰 사용량을 줄인다고 주장하며 79k GitHub 스타를 기록했다. Terminal-Bench 2.1에서 1,740회 실험 결과 Claude Code는 5% 비용 감소, OpenCode는 5% 비용 증가했으나, 성공률은 각각 1~2% 하락했다. 작업별 평균 비용 변화를 측정하면 Claude Code는 1% 더 비싸졌고 OpenCode는 17% 더 비싸졌으며, 한 작업을 제외하면 절감 효과는 거의 없다. 전체 요약 6문장 읽기 → 019 08:12 당일 +1,117 자신의 모델을 소유하면서 비용을 절감하는 오픈소스 LLM 게이트웨이 Experiential은 OpenAI 호환 API 하나로 자체 호스팅, BYOK, 1000개 이상의 마켓플레이스 모델을 통합 관리하는 오픈소스 게이트웨이다. AI · 머신러닝 · experientiallabs/experiential · Python
Key Point 프로덕션 트래픽 데이터로 자신이 소유한 모델을 최적화하면서도 OpenAI 호환 인터페이스로 기존 도구와 호환되어, LLM 비용 관리와 성능 개선을 동시에 달성할 수 있다.
핵심 요약
Experiential은 OpenAI 호환 API 하나로 자체 호스팅, BYOK, 1000개 이상의 마켓플레이스 모델을 통합 관리하는 오픈소스 게이트웨이다. 사용자와 에이전트별로 어떤 모델을 사용할 수 있는지, 각 용도별 지출 한도를 제어할 수 있다. 프로덕션 트래픽으로부터 OpenTelemetry 추적을 수집하고 이를 통해 커스텀 라우터를 학습시켜 품질, 속도, 비용을 최적화한다. 전체 요약 5문장 읽기 → 020 08:12 ▲ 125 · 댓글 16 Mercury 2.5, 저지연 생성형 LLM의 차세대 모델 공개 Inception Labs가 확산형(diffusion) 언어모델인 Mercury 2.5를 출시했으며, Mercury 2보다 40% 지능이 향상됐다. AI · 머신러닝 · Mercury 2.5
Key Point 저지연이 필수적인 음성·검색·코딩 시스템에서 실제로 검증된 경량 모델이 나왔으며, 기존 고사양 모델 대비 훨씬 저렴하면서도 실제 프로덕션 환경에서 성능을 입증했다.
핵심 요약
Inception Labs가 확산형(diffusion) 언어모델인 Mercury 2.5를 출시했으며, Mercury 2보다 40% 지능이 향상됐다. 초당 1,107개 토큰 생성 속도로 GPT-4o나 Claude Haiku 등 주요 경량 모델과 유사한 성능을 낸다. 입력 토큰당 $0.20/백만, 출력 토큰당 $0.75/백만이며 런칭 기념으로 80% 할인된 가격을 제공한다. 전체 요약 6문장 읽기 → 021 00:10 ▲ 160 · 댓글 80 DeepSeek-V4-Pro 공개, 피크/비피크 요금제 도입 DeepSeek-V4-Pro를 출시했으며 에이전트 성능을 대폭 강화했다. AI · 머신러닝 · DeepSeek peak/off-peak pricing update
Key Point AI API 비용 최적화 기능의 도입과 DeepSeek의 모델 업그레이드가 개발자 커뮤니티에서 주목받고 있다.
핵심 요약
DeepSeek-V4-Pro를 출시했으며 에이전트 성능을 대폭 강화했다. 추론 난이도를 낮음/높음/최대로 조절할 수 있고 OpenAI Responses API를 기본 지원한다. 비피크 요금이 피크 요금의 50% 저렴하며 2026년 8월 16일 16:00 UTC부터 적용된다.