쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 22일 (일)까지 5067건
7건 · "오류 복구"조건 지우기 ×
001 18:13 ▲ 38 · 댓글 4 LLM 에이전트의 강화학습, 예산에 따라 성능 급락 다중 턴 강화학습(RL)은 장시간 작업에서 효과적이지만, 상호작용 제약에 매우 민감한 성능 변화를 보인다. AI · 머신러닝 · What Does Multi-Turn Reinforcement Learning Really Improve in LLM Agents?
Key Point LLM 에이전트의 강화학습이 실제 배포 환경에서 어떤 제약을 받는지 밝히고, 기존 방식의 한계를 극복할 수 있는 새로운 접근법을 제시한다.
핵심 요약
다중 턴 강화학습(RL)은 장시간 작업에서 효과적이지만, 상호작용 제약에 매우 민감한 성능 변화를 보인다. Pass@(K,T) 지표로 샘플링 폭 K와 상호작용 깊이 T를 평가한 결과, 상호작용 예산이 충분할 때만 궤적 수준의 RL 이점이 나타나고 예산이 줄어들면 성능이 급격히 하락한다. 에이전트 RL은 개별 의사결정 품질을 균등하게 높이지 못하며, 강점은 오류 복구와 장시간 탄력성에 집중되어 있다. 전체 요약 6문장 읽기 → 002 18:11 ▲ 33 · 댓글 3 컴퓨터 제어 AI, 실수 복구 능력 체계적으로 평가하기 키보드·마우스로 디지털 업무를 자동화하는 컴퓨터 제어 AI 에이전트는 긴 작업 흐름에서 오류가 쌓이고 의도하지 않은 부작용이 생기면서 실수에서 복구하는 능력이 중요해졌다. AI · 머신러닝 · Lost in Recovery: Demystifying Recovery Behavior of Computer-Use Agents via Goal-Oriented Action Replay
Key Point 컴퓨터 자동화 에이전트의 신뢰성을 높이는 핵심인 '오류 복구'를 처음 체계적으로 평가하고, 현재 AI 모델들이 자신의 복구 능력을 제대로 사용하지 못하고 있다는 실제 한계를 드러낸다.
핵심 요약
키보드·마우스로 디지털 업무를 자동화하는 컴퓨터 제어 AI 에이전트는 긴 작업 흐름에서 오류가 쌓이고 의도하지 않은 부작용이 생기면서 실수에서 복구하는 능력이 중요해졌다. 기존 복구 방식은 한계가 있다: 소유권이 있는 시스템은 환경 초기화가 불가능하고, 긴 작업 흐름에서 액션 재실행은 비용이 너무 크며, API 기반 되돌리기는 웹 환경에만 적용되므로 모델 기반 복구는 거의 연구되지 않았다. 연구팀은 ReTrace라는 평가 프레임워크를 제시해 컴퓨터 제어 에이전트의 복구 동작을 체계적으로 연구한다. 전체 요약 8문장 읽기 → 003 15:11 ▲ 18 · 댓글 2 나레이션으로 장편 비디오 자동 편집하는 AI 에이전트 WeVisCut 나레이션에서 장편 비디오를 생성할 때 여러 샷 사이의 일관성을 유지하는 것이 과제인데, 기존 멀티 스테이지 에이전트는 일반 모델 기반으로 작동해 소형 모델의 성능-비용 트레이드오프가 불명확했다. AI · 머신러닝 · WeVisCut: The Whole Editing Room in One Agent From Narration to Long-Form Video
Key Point 텍스트 지시만으로 긴 비디오를 자동 편집하면서 토큰 효율은 Claude Opus 5의 33분의 1 수준이라는 점이 현장 업무 자동화의 실제 가능성을 보여준다.
핵심 요약
나레이션에서 장편 비디오를 생성할 때 여러 샷 사이의 일관성을 유지하는 것이 과제인데, 기존 멀티 스테이지 에이전트는 일반 모델 기반으로 작동해 소형 모델의 성능-비용 트레이드오프가 불명확했다. WeVisCut는 스크립트를 비디오로 변환하는 시스템으로, 도구 실행과 정책 학습을 연결하며 에이전트가 공유 프로덕션 상태를 유지해 도구 피드백이 후속 결정과 오류 복구에 반영된다. 기존 완성 비디오에는 편집 의도가 노출되지 않으므로, 4단계 데이터 파이프라인이 편집 역변환(inversion)과 검증된 재생(replay)을 결합해 3,750개 영상에서 130K개 이상의 훈련 데이터를 추출한다. 전체 요약 7문장 읽기 → 004 18:33 ▲ 11 · 댓글 3 AI 에이전트의 작업 능력과 오류 복구를 분리 평가하는 벤치마크 Tool-using AI 에이전트를 평가하는 기존 벤치마크들은 단순한 작업 완료만 측정해 기본 계획 능력과 실제 운영 환경에서의 장애 복구 능력을 구분하지 못한다. AI · 머신러닝 · UndoBench: Separating Task Competence from Recovery Capability in Tool-Using AI Agents
Key Point 엔터프라이즈 환경에 배포되는 AI 에이전트의 실제 위험성은 정상 작동 능력이 아닌 장애 복구 능력에 있으며, 기존 평가 방식의 맹점을 드러내는 첫 체계적 벤치마크다.
핵심 요약
Tool-using AI 에이전트를 평가하는 기존 벤치마크들은 단순한 작업 완료만 측정해 기본 계획 능력과 실제 운영 환경에서의 장애 복구 능력을 구분하지 못한다. 연구팀은 UndoBench를 제시해 8개 엔터프라이즈 도메인의 36개 기본 워크플로우와 36개 장애 시나리오로 이 둘을 분리해 평가한다. 동일한 시드로 실행한 쌍 비교 시험과 와이어 수준 영향 이력·환경 상태 오라클을 통해 두 능력을 독립적으로 측정한다. 전체 요약 8문장 읽기 → 005 06:11 ▲ 19 · 댓글 2 에이전트 학습의 전체 시스템 개선, WEFT 프레임워크 제시 도구 사용 능력을 갖춘 AI 에이전트 학습을 위한 WEFT 프레임워크를 제안했다. AI · 머신러닝 · WEFT: Scaling Tool-Use Post-Training for General-Purpose Agents
Key Point 환경 확장만으로는 부족하다는 기존 접근의 한계를 지적하고, 에이전트 시스템 전체를 함께 개선하는 방식이 성능 향상에 실질적 영향을 미친다는 점을 실증한다.
핵심 요약
도구 사용 능력을 갖춘 AI 에이전트 학습을 위한 WEFT 프레임워크를 제안했다. 기존 방식은 환경만 확장했지만, WEFT는 환경·태스크·상호작용 다양성을 함께 키운다. 실행 중 발생한 실패를 추적하고 상태 증거를 이용해 문제 컴포넌트를 자동 수정하는 자진 진화 방식을 도입했다. 전체 요약 7문장 읽기 → 006 06:11 ▲ 20 · 댓글 2 다단계 작업에서 언어 모델이 실수를 예방하고 회복하는 법 다중 턴 에이전트 훈련에서 초기에 발생한 하나의 잘못된 행동이 이후 상태를 왜곡해 오류가 누적되는 문제를 발견했다. AI · 머신러닝 · PivotOPD: Learning to Recover from Pivotal Mistakes in Multi-Turn Agents
Key Point 초기 실수를 예방하면서 동시에 회복하는 훈련 방식으로, 다중 턴 작업 에이전트의 오류 누적 문제를 직접 해결하는 실용적 접근이다.
핵심 요약
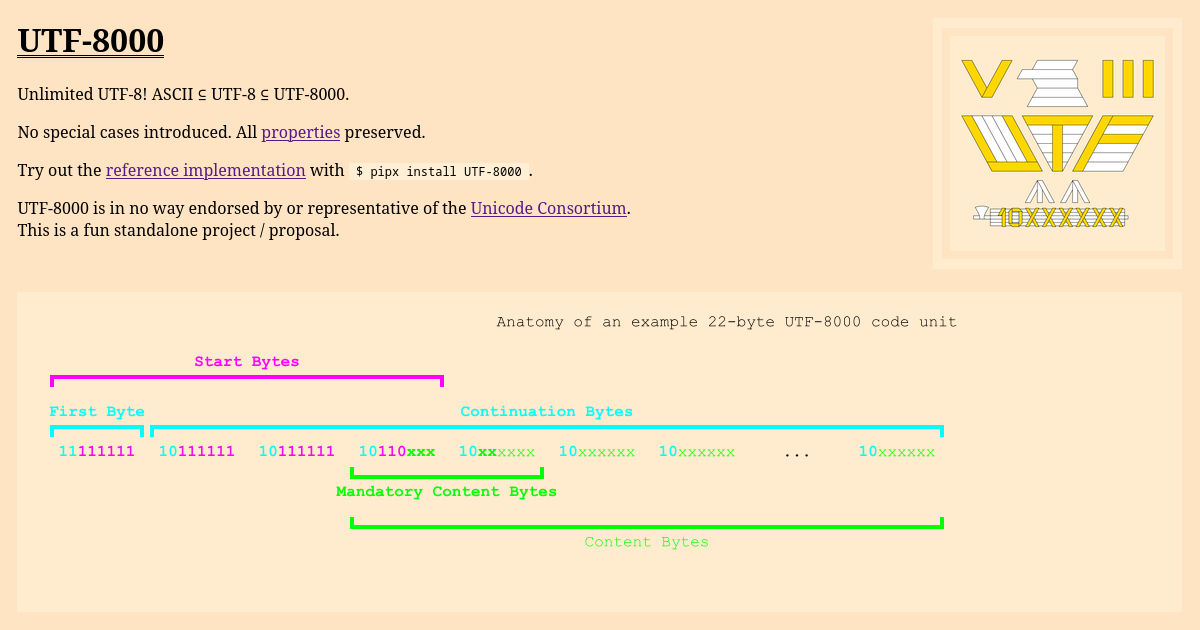
다중 턴 에이전트 훈련에서 초기에 발생한 하나의 잘못된 행동이 이후 상태를 왜곡해 오류가 누적되는 문제를 발견했다. Qwen3 3개 모델(8B~235B) 실험에서 실패한 시도의 50% 이상이 '중추적 실수'(작업 완료를 더 멀게 하는 행동)를 포함하고 있으며, 이는 대부분 초기에 발생한다. 놀랍게도 이러한 중추적 실수 후 몇 턴의 지도만으로도 작업 성공을 복구할 수 있다. 전체 요약 7문장 읽기 → 007 03:10 ▲ 111 · 댓글 82 UTF-8을 무한히 확장한 UTF-8000 제안 UTF-8의 구조를 확장하여 임의로 큰 코드포인트를 인코딩할 수 있는 UTF-8000을 제안했다. 기타 · UTF-8000: Unlimited UTF-8
Key Point UTF-8의 제약을 벗어나 원리적으로 무제한 크기의 문자를 인코딩할 수 있는 확장안을 이해해야 하는 개발자와, 인코딩 표준 설계에 관심 있는 사람들에게 유용하다.
핵심 요약
UTF-8의 구조를 확장하여 임의로 큰 코드포인트를 인코딩할 수 있는 UTF-8000을 제안했다. UTF-8은 최대 4바이트(RFC 3629)이지만, UTF-8000은 22바이트 이상의 코드 유닛으로 확장 가능하다. 다중 시작 바이트(multiple start bytes)를 활용해 코드 유닛 길이를 임의로 늘릴 수 있다. 전체 요약 5문장 읽기 →