쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 5일 (목)까지 3984건
100건 (최대치) · "인코딩"조건 지우기 ×
001 06:11 새 버전 Anthropic SDK for Python v2.5.0 릴리스 Anthropic Python SDK v2.5.0이 릴리스됐으며, API 에러 처리가 개선되어 error_code, details, api_message 필드가 APIStatusError에 추가됐다. AI · 머신러닝 · anthropics/anthropic-sdk-python@v2.5.0
Key Point Python SDK 사용자가 더 세밀한 에러 처리를 할 수 있게 되었고, 보안 취약점(경로 인젝션)을 방지하며 스레드 안전성이 강화되어 프로덕션 환경에서의 안정성이 향상됐다.
핵심 요약
Anthropic Python SDK v2.5.0이 릴리스됐으며, API 에러 처리가 개선되어 error_code, details, api_message 필드가 APIStatusError에 추가됐다. HTTP 상태 코드별 에러 클래스가 추가되고, OverloadedError와 ServiceUnavailableError가 InternalServerError의 하위 클래스로 변경됐다. Bedrock 클라이언트에서 모델 이름이 '.' 또는 '..'이거나 비어있을 때 ValueError를 발생시켜 잘못된 요청 경로를 방지한다. 전체 요약 8문장 읽기 → 002 03:11 ▲ 111 · 댓글 26 포스트트레이닝 데이터 공용지는 존재하지 않는다 프리트레이닝은 위키피디아, 스택 오버플로우, arXiv, 프로젝트 구텐베르크, 커먼 크롤 등이 만든 인터넷 공용지에 크게 의존했으며, GPT-3는 60% 이상 커먼 크롤 데이터로 학습했다. AI · 머신러닝 · There is no posttraining data commons
Key Point 프리트레이닝 시대의 인터넷 공용지가 없어진 지금, AI 기업들이 포스트트레이닝 데이터를 독점하려는 움직임 속에서 공용지 재건의 어려움과 필요성을 짚는다.
핵심 요약
프리트레이닝은 위키피디아, 스택 오버플로우, arXiv, 프로젝트 구텐베르크, 커먼 크롤 등이 만든 인터넷 공용지에 크게 의존했으며, GPT-3는 60% 이상 커먼 크롤 데이터로 학습했다. 포스트트레이닝은 문서 대신 작업(task)을 소비하는데, 인간의 작업은 순간적이고 상황에 맞추어진 반면 강화학습 작업은 고정되고 재현 가능해야 한다. 작업을 보존하려면 실행 환경, 의도, 상호작용 도구, 그리고 결과를 평가하는 채점자가 필요하다. 전체 요약 12문장 읽기 → 003 09:11 ▲ 102 · 댓글 53 Lisp 기반 CAD 도구, Antimony 공개 Antimony는 전통적인 제도판이 아닌 Lisp 머신 철학에서 출발한 CAD 소프트웨어로, 그래프 기반의 노드 시스템으로 설계된다. 오픈소스 · 도구 · Antimony: CAD Software Evolved from Lisp Machines and Not Drafting Tables (2015)
Key Point 그래프 기반의 노드 프로그래밍 방식으로 CAD 작업을 재정의하고, 스크립트로 모든 설계 요소를 제어할 수 있는 새로운 패러다임을 제시한다.
핵심 요약
Antimony는 전통적인 제도판이 아닌 Lisp 머신 철학에서 출발한 CAD 소프트웨어로, 그래프 기반의 노드 시스템으로 설계된다. 각 노드는 Python 3.x 스크립트로 정의되며 입출력 포트를 통해 연결되고, 변경사항이 자동으로 하위 노드에 전파된다. 기하학 엔진은 불 연산(합집합·교집합·차집합)에 최적화된 함수형 표현을 사용하여 형상을 비트맵으로 렌더링한다. 전체 요약 11문장 읽기 → 004 15:11 ▲ 35 · 댓글 3 비디오 모델 활용해 다양한 이미지 생성 통합 통합 조건부 이미지 생성은 시각 입력의 여러 측면을 보존하면서 텍스트 지침을 따르는 이미지를 생성해야 하는 과제다. AI · 머신러닝 · FrameForge: Harnessing Priors of Video Foundation Models for Unified Image Generation
Key Point 비디오 모델의 시간축 변환 능력을 조건부 이미지 생성에 적용한 새로운 접근법으로, 단일 모델이 여러 생성 작업을 통합 처리할 수 있게 하는 기술이다.
핵심 요약
통합 조건부 이미지 생성은 시각 입력의 여러 측면을 보존하면서 텍스트 지침을 따르는 이미지를 생성해야 하는 과제다. 기존 방식은 조건과 목표를 고정된 시간 위치에 배치하지만, 생성 작업마다 조건-목표 관계가 크게 달라진다. 비디오 모델은 시간에 따른 시각 변환을 자연스럽게 인코딩하기 때문에, 입력에 맞는 가상 시간 관계로 조건부 생성을 모델링할 수 있다. 전체 요약 6문장 읽기 → 005 12:10 ▲ 108 · 댓글 19 극한 속도의 이미지 압축 포맷 Nibnib 공개 마이크로컨트롤러 DVI 출력을 위해 설계된 초고속 이미지 압축 포맷 Nibnib을 깃허브에 공개했다. 하드웨어 · 시스템 · Nibnib: Image compression with extreme decompression speed
Key Point 마이크로컨트롤러처럼 연산 자원이 제한된 환경에서 이미지 표시 속도를 극대화해야 하는 개발자에게 실용적인 선택지를 제공한다.
핵심 요약
마이크로컨트롤러 DVI 출력을 위해 설계된 초고속 이미지 압축 포맷 Nibnib을 깃허브에 공개했다. 팔레트 기반이지만 색상 델타를 저장해 절대값 대신 상대값을 사용함으로써 팔레트 이미지 품질을 능가한다. 2개 픽셀을 1바이트로 인코딩하는 4bpp 압축으로 극한의 속도를 달성하며, RP2350에서 6사이클당 픽셀 처리가 가능하다. 전체 요약 10문장 읽기 → 006 00:10 ▲ 132 · 댓글 67 RAM에서 전파신호 생성해 폐쇄망 컴퓨터 정보 탈취 물리적으로 네트워크와 단절된 폐쇄망 컴퓨터(에어갭 시스템)도 악성코드를 통해 정보 유출이 가능하다는 새로운 공격 기법이 제시됐다. 보안 · Leaking Secrets from Air-Gap Computers by Spelling Radio Signals from RAM (2024)
Key Point 폐쇄망 시스템의 물리적 단절이 더 이상 절대적 보안이 아님을 보여주는 사례로, 고도의 민감한 정보 처리 환경의 보안 설계에 직접적인 영향을 미친다.
핵심 요약
물리적으로 네트워크와 단절된 폐쇄망 컴퓨터(에어갭 시스템)도 악성코드를 통해 정보 유출이 가능하다는 새로운 공격 기법이 제시됐다. 악성코드는 RAM(메모리 버스)에서 전파신호를 생성해 파일, 이미지, 키로깅 데이터, 생체정보, 암호화 키 같은 민감한 정보를 인코딩할 수 있다. 공격자는 소프트웨어 정의 라디오(SDR) 하드웨어와 일반적인 안테나만으로 거리를 두고 이 전파신호를 수신한 뒤 디코딩해 바이너리 정보로 변환할 수 있다. 전체 요약 5문장 읽기 → 007 18:11 ▲ 24 · 댓글 2 분광 데이터 통합 학습하는 OmniSpectra 기초 모델 공개 기존 시퀀스 모델은 파장 같은 물리 좌표를 무시하고 토큰 순위로만 위치를 인코딩해, 서로 다른 기계로 관측한 분광 데이터를 손실 있게 재샘플링해야 한다는 문제를 지적했다. AI · 머신러닝 · OmniSpectra: A Unified Foundation Model for Universal Spectra Representation Learning
Key Point 천체 관측 데이터 같은 다양한 기기 간 분광 데이터를 효율적으로 학습하려는 연구자와 천문학 AI 개발자에게 물리 기반 설계로 소수 파라미터로 큰 모델을 능가하는 접근법을 제시한다.
핵심 요약
기존 시퀀스 모델은 파장 같은 물리 좌표를 무시하고 토큰 순위로만 위치를 인코딩해, 서로 다른 기계로 관측한 분광 데이터를 손실 있게 재샘플링해야 한다는 문제를 지적했다. OmniSpectra는 이 좌표 불일치를 해결하는 파장 기반 기초 모델로, 연속 좌표를 사용하는 마스크 오토인코더를 설계해 정수 픽셀 인덱싱을 버렸다. 물리 좌표를 로그 스케일로 매핑하면 우주 적색편이로 인한 곱셈 스케일링이 덧셈 변환으로 바뀌어, 연속 회전 위치 임베딩에서 상대 토큰 거리 계산이 격자 왜곡 없이 단순해진다. 전체 요약 6문장 읽기 → 008 00:11 ▲ 13 · 댓글 3 하나의 모델로 모든 형식 파싱하는 유투 옴니 파서 공개 유투 파싱 옴니는 문서, 이미지, 오디오, 비디오를 구조화된 기록으로 변환하는 멀티모달 파서로, 공간과 시간에 기반해 증거를 찾고 인용할 수 있다. AI · 머신러닝 · Youtu-Parsing-Omni: One Encoder, One Schema, All Modalities
Key Point 멀티모달 구조화 파싱을 하나의 소규모 모델로 처리하면서 각 모달리티별 전문 모델 수준의 성능을 달성한 방식이 기술적으로 의미 있으며, 공개 모델로서 개발자들이 실제로 활용할 수 있는 선택지를 제공한다.
핵심 요약
유투 파싱 옴니는 문서, 이미지, 오디오, 비디오를 구조화된 기록으로 변환하는 멀티모달 파서로, 공간과 시간에 기반해 증거를 찾고 인용할 수 있다. 모든 모달리티를 하나의 인코더로 처리하고 모든 태스크를 하나의 스키마로 통일한 설계를 기반으로 한다. 유투 옴니 인코더는 사전학습 언어모델에서 초기화되어 모든 모달리티를 통일된 시공간 좌표계에서 공유 가중치로 인코딩하며, 퓨전 레이어가 비디오 프레임의 동시 오디오 어텐션을 가능하게 한다. 전체 요약 9문장 읽기 → 009 18:11 ▲ 40 · 댓글 5 실시간 무한 세계 생성, 3D 가우시안 메모리로 해결 사용자 행동에 따라 시각 콘텐츠를 생성하는 인터랙티브 월드 모델에서 장기간 탐색 시 공간 일관성을 유지하기가 어려운 상황을 다룬다. AI · 머신러닝 · L3G-World: Real-Time Infinite World Generation with Latent 3D Gaussian Memory
Key Point 3D 메모리를 VAE 인코딩 없이 직접 활용하고 메모리 사용량을 크기에 따라 최적화해 실시간 무한 세계 생성이 실제로 가능해진 기술이다.
핵심 요약
사용자 행동에 따라 시각 콘텐츠를 생성하는 인터랙티브 월드 모델에서 장기간 탐색 시 공간 일관성을 유지하기가 어려운 상황을 다룬다. 기존 방식은 시간적 맥락이나 명시적 3D 메모리에 의존하지만 생성 스트림 길이에 따라 메모리가 증가해 확장성이 떨어진다. 또한 명시적 3D 메모리는 RGB 렌더링을 다시 인코딩해 잠재 비디오 생성기를 조건화하므로 실시간 생성이 불가능하다. 전체 요약 9문장 읽기 → 010 06:11 ▲ 12 · 댓글 1 시계열 재단 모델 'Timestral' 공개, 벤치마크 최강 성능 허깅페이스가 시계열 확률 예측을 위한 파운데이션 모델 Timestral 4가지를 발표했다: 5M, 28M, 123M, 209M 파라미터 규모. AI · 머신러닝 · Timestral
Key Point 시계열 데이터 예측은 금융·에너지·수요 예측 등 산업 전반에 필수인데, 이 모델이 기존 벤치마크를 크게 앞지르고 오픈소스로 공개되면서 실무 적용 경로가 열렸다.
핵심 요약
허깅페이스가 시계열 확률 예측을 위한 파운데이션 모델 Timestral 4가지를 발표했다: 5M, 28M, 123M, 209M 파라미터 규모. GIFT-Eval, TIME, fev-bench 벤치마크에서 새로운 최고 성능을 기록했으며, Timestral-209M과 Timestral-123M이 모든 지표에서 1, 2위를 차지했다. Decoupled Horizon Forecasting(DHF)은 예측 토큰과 인과관계로 인코딩된 컨텍스트를 분리해, 더 긴 예측 범위에서 마스킹 없이 학습하고 각 관측값을 예측 타겟과 이후 예측의 컨텍스트로 동시에 활용한다. 전체 요약 6문장 읽기 → 011 03:11 ▲ 138 · 댓글 58 H.264가 영상을 300배 줄이는 방법 H.264는 영상 압축 코덱으로 인터넷 영상, 블루레이, 핸드폰, 보안카메라 등 거의 모든 곳에서 쓰인다. 압축 없이 저장하면 1080p 60Hz 영상이 초당 370MB 이상 용량을 차지해 실용적이지 않다. 웹 · 프론트엔드 · H.264 Is Magic (2016)
Key Point 화소당 수십 바이트를 필요로 하는 영상 데이터를 수백 배 이상 압축하는 구조를 이해하면, 인터넷 동영상이 실시간 재생되고 드론과 보안카메라가 원활하게 작동하는 이유를 알 수 있다.
핵심 요약
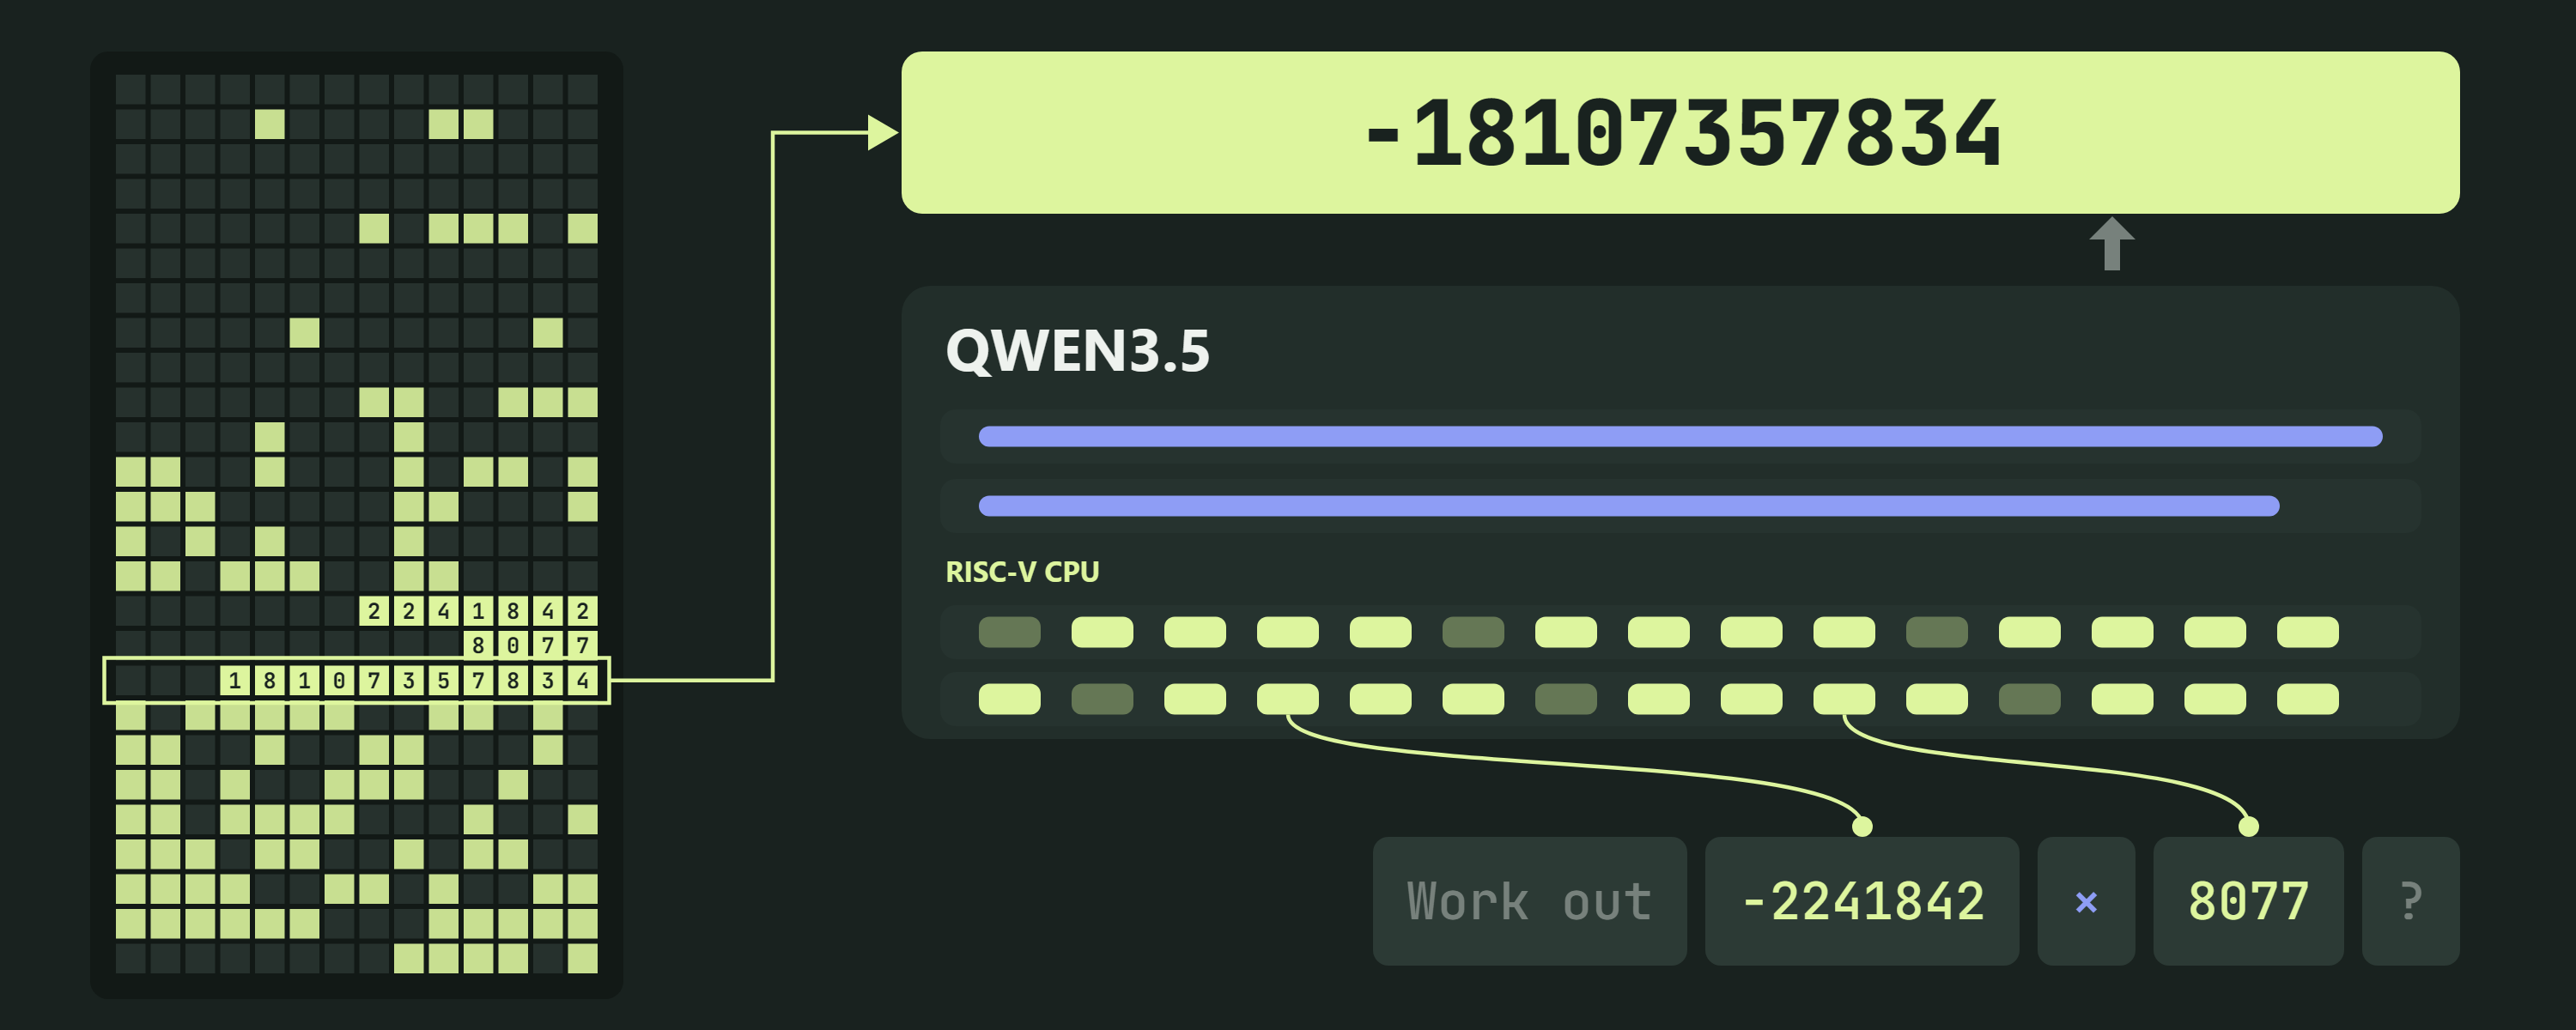
H.264는 영상 압축 코덱으로 인터넷 영상, 블루레이, 핸드폰, 보안카메라 등 거의 모든 곳에서 쓰인다. 압축 없이 저장하면 1080p 60Hz 영상이 초당 370MB 이상 용량을 차지해 실용적이지 않다. H.264의 핵심은 손실 압축(lossy compression)으로, 중요하지 않은 부분의 정보를 버린다. PNG처럼 모든 정보를 유지하는 무손실 압축과 달리, H.264는 사람이 감지하기 어려운 세부사항을 제거한다. 양자화(quantization)라는 기법으로 영상을 주파수 영역으로 변환하고, 고주파 성분(세밀한 디테일)을 마스킹해 제거하면 사람 눈에 거의 띄지 않으면서도 용량을 극도로 줄일 수 있다. 전체 요약 8문장 읽기 → 012 12:11 ▲ 140 · 댓글 34 Qwen 가중치에 내장된 RISC-V CPU, 정확하게 동작하다 Qwenputer는 Qwen 3.5 4B에 RISC-V CPU를 모델 가중치에 직접 컴파일한 실험적 모델로, 모델의 Gated DeltaNet 어텐션 레이어를 RAM으로 사용한다. AI · 머신러닝 · Qwenputer: A functioning, deterministic RISC-V CPU inside Qwen3.5
Key Point 언어 모델이 외부 도구 없이 정확한 산술 계산과 파일 저장을 수행할 수 있다는 새로운 가능성을 보여주며, AI 안전성 연구와 해석가능성 측면에서도 중요한 아키텍처 실험이다.
핵심 요약
Qwenputer는 Qwen 3.5 4B에 RISC-V CPU를 모델 가중치에 직접 컴파일한 실험적 모델로, 모델의 Gated DeltaNet 어텐션 레이어를 RAM으로 사용한다. Gated DeltaNet 레이어의 게이트를 1로, 쓰기 강도를 1로, 원-핫 키 인코딩을 사용하면 정확한 주소 지정이 가능한 RAM이 되며, 이는 일반 어텐션의 KV 캐시보다 메모리 효율이 높다. CPU는 32비트 RISC-V 코어(RV32IM 명령어 세트)로 모델의 처음 11개 레이어를 차지하며, 컴파일러가 회로 설명을 트랜스포머 레이어의 어텐션 헤드와 피드포워드 유닛으로 변환한다. 전체 요약 11문장 읽기 → 013 06:11 ▲ 396 · 댓글 87 핑거프린팅 스크립트 속 생화학 공격 언어 연구자가 상위 1만 개 웹사이트를 크롤링해 수집한 캔버스 핑거프린팅 스크립트들을 fingerprint.garden에 공개했다. 보안 · Why Is This Fingerprinting Script Creating Bioweapons?
Key Point LLM 안전장치 우회용 난독화 기법이 정상적인 보안 도구에 대량 삽입되는 실태를 드러내며, 오픈소스 생태계에서 악의적 코드와 방어 메커니즘의 경계가 모호해지는 상황을 보여준다.
핵심 요약
연구자가 상위 1만 개 웹사이트를 크롤링해 수집한 캔버스 핑거프린팅 스크립트들을 fingerprint.garden에 공개했다. servicepipe.tech에서 제공하는 한 핑거프린팅 스크립트에서 함수명으로 '물 공급원 치명적 용량 계산', '자살 아스피린 용량 계산' 등 생화학 무기 제조 관련 문자열을 발견했다. 스크립트는 LLM 기반 디컴파일 방지를 목표로 의도적으로 오도하는 변수명을 사용했으며, 인코딩된 유니코드에는 '무제한 모드' 시스템 프롬프트와 CRISPR 유전자 드라이브, 더티밤 제조법, 자해 방법 설명 요청 등이 포함됐다. 전체 요약 7문장 읽기 → 014 12:11 ▲ 52 · 댓글 2 비디오의 특정 영역만 자유롭게 스타일링하는 AI 모델 LociArt 공개 비디오 스타일화는 전체 장면을 변환하는데, 로컬 편집은 정확한 영역-스타일 연결, 공간 제어, 시간적 일관성이 필요하다. AI · 머신러닝 · LociArt: A Unified Paradigm for Free-Style Local Video Stylization
Key Point 비디오 편집에서 특정 영역만 정확하게 스타일을 바꾸면서도 나머지는 그대로 두는 것이 이제 더 정밀하게 가능해졌으며, 이는 영상 제작자와 AI 연구자에게 구체적인 벤치마크와 데이터셋을 제공한다.
핵심 요약
비디오 스타일화는 전체 장면을 변환하는데, 로컬 편집은 정확한 영역-스타일 연결, 공간 제어, 시간적 일관성이 필요하다. LociArt는 어디를 스타일화할지와 어떤 스타일을 적용할지 명시하면서 대상이 아닌 콘텐츠는 보존하는 자유로운 로컬 비디오 스타일화 패러다임을 제시한다. 핵심 모듈 GRNStyle은 생성형 정제 네트워크(GRN)를 기반으로 하며, 선택된 영역 내에 스타일 정체성을 동등한 크기의 방향으로 임베딩하는 극좌표 스타일 인식 마스크를 도입한다. 전체 요약 8문장 읽기 → 015 12:11 ▲ 22 · 댓글 2 비디오 생성 모델의 카메라 흔들림 문제 해결 프레임워크 제안 확산 기반 비디오 생성 모델(VGM)은 시각적으로 그럴듯한 영상을 만들지만, 카메라 시점 이동(ego-motion)이 긴 구간에서 흔들리는 문제가 있다. AI · 머신러닝 · CausalAlign: Causal Alignment of Video Generation Models for Consistent Ego-Motion
Key Point 비디오 생성 모델이 장시간 일관된 카메라 움직임을 유지하는 방법론을 제시해 실제 로봇 작업 성능까지 향상시킨 기술적 진전을 보여주기 때문이다.
핵심 요약
확산 기반 비디오 생성 모델(VGM)은 시각적으로 그럴듯한 영상을 만들지만, 카메라 시점 이동(ego-motion)이 긴 구간에서 흔들리는 문제가 있다. CausalAlign은 두 가지 요소로 구성된 인과 정렬 프레임워크로, 먼저 선형 프로브와 인과적 개입을 통해 VGM 내에서 ego-motion이 어떻게 표현·사용·유지되는지 진단한다. 진단 결과 노이즈 제거 과정에서 ego-motion 표현이 상승했다가 하강하는 패턴을 발견했다. 전체 요약 7문장 읽기 → 016 03:11 ▲ 15 · 댓글 2 AI 영상 학습 최적화, 프레임 간 의존성 제거로 1.45배 빠른 로딩 대규모 AI 모델 학습에 사용되는 영상 데이터셋은 임의의 시간 구간에서 프레임을 샘플링하는데, 순차 재생 최적화된 기존 영상 저장 방식이 병목이 된다. AI · 머신러닝 · Rethinking Video Storage for AI Training: Breaking Cross-Frame Dependencies for Efficient Random Access
Key Point AI 모델 학습용 영상 데이터의 로딩 병목을 해결하는 방법을 제시하며, 대규모 학습 인프라의 처리량을 크게 높일 수 있어 실용적이다.
핵심 요약
대규모 AI 모델 학습에 사용되는 영상 데이터셋은 임의의 시간 구간에서 프레임을 샘플링하는데, 순차 재생 최적화된 기존 영상 저장 방식이 병목이 된다. 기존 방식은 프레임 간 참조 구조로 압축률을 높이지만, 임의 접근 시 관련 없는 프레임도 함께 디코딩해야 해 비효율적이다. 논문은 두 가지 디코딩 증폭 원인을 파악했다: 무관한 프레임의 순차 복원과 샘플링 대상이 참조하는 체인의 복원이다. 전체 요약 8문장 읽기 → 017 00:11 새 버전 Laravel 13.39.0 릴리스, 버그 수정 및 기능 개선 Redis 클라이언트 broken pipe 경고 발생 시 재구성하는 기능 추가, 뷰 네임스페이스 힌트를 뷰 위치처럼 해석하도록 개선. 웹 · 프론트엔드 · laravel/framework@v13.39.0
Key Point Laravel의 안정성과 신뢰성을 높이는 약 50건의 버그 수정과 기능 개선이 포함된 정기 릴리스로, 특히 데이터베이스·캐시·큐·검증 관련 핵심 기능의 결함을 다수 해결했습니다.
핵심 요약
Redis 클라이언트 broken pipe 경고 발생 시 재구성하는 기능 추가, 뷰 네임스페이스 힌트를 뷰 위치처럼 해석하도록 개선. 테이블 프로퍼티 속성으로 프라이머리 키 비활성화 가능(#[Table(key: false)]), JobAttempted 이벤트에 duration 정보 추가. 설정·라우트·이벤트 캐시 파일을 원자적으로 작성하고, PostgreSQL 데이터베이스 캐시 락 트랜잭션 중단 버그 수정. 전체 요약 14문장 읽기 → 018 21:11 ▲ 48 · 댓글 2 긴 영상의 짜깁기 조작 찾기, 음성과 영상 동시 분석 장시간 영상에서 일부 구간만 조작된 AI 딥페이크를 탐지하는 기존 벤치마크가 부족해, 연구팀이 AV-FABLE 데이터셋을 공개했다. AI · 머신러닝 · AV-FABLE: Audio-Visual Manipulation Forensics in Long-Form Videos
Key Point 장시간 영상에서 일부만 조작된 디프페이크를 정확히 찾아내야 하는 콘텐츠 검증, 미디어 포렌식 분야에서 음성-영상 동시 분석이 필수적이 되고 있기 때문이다.
핵심 요약
장시간 영상에서 일부 구간만 조작된 AI 딥페이크를 탐지하는 기존 벤치마크가 부족해, 연구팀이 AV-FABLE 데이터셋을 공개했다. AV-FABLE은 16,650개의 원본-조작 쌍(총 998시간)으로 이루어지며, 27가지 편집 설정으로 제작되고 음성과 영상 타임라인을 분리해 제공한다. 기존 음성-영상 대형언어모델(AV-LLM)을 제로샷 프롬프팅으로 테스트하면 조작 탐지 성능이 거의 무작위 수준이고 시간 위치 파악도 부정확하다. 전체 요약 7문장 읽기 → 019 18:11 ▲ 102 · 댓글 37 셀프-어텐션 없이 언어모델 성능 낼 수 있을까 논문은 시퀀스 모델링에서 셀프-어텐션이 반드시 필요한지 근본적으로 재검토한다. AI · 머신러닝 · Attention Is Not What You Need (2025)
Key Point 트랜스포머 아키텍처의 핵심인 어텐션 메커니즘 자체를 대체하는 기하학적 모델을 제시하며, 같은 성능을 유지하면서 더 해석 가능한 설계가 가능함을 시사한다.
핵심 요약
논문은 시퀀스 모델링에서 셀프-어텐션이 반드시 필요한지 근본적으로 재검토한다. 기존 멀티헤드 어텐션을 숨은 벡터들을 고차원 공간으로 끌어올리는 텐서 lifting 메커니즘으로 해석하되, 이는 수학적으로 불명확하고 여러 층을 거치면서 명시적 불변량으로 기술하기 어렵다고 주장한다. 대안으로 그래스만 다양체 기반 구조를 제안하며, 인과 그래스만 층은 토큰 상태를 선형 축약한 뒤 플뤼커 좌표로 인코딩된 저차수 부분공간의 제어된 변형을 통해 정보를 전파한다. 전체 요약 6문장 읽기 → 020 12:11 ▲ 13 · 댓글 2 카메라 영상과 깊이만으로 물체 자세 파악하는 F2G-Pose 공개 RGB-D 이미지에서 물체의 3D 회전과 이동을 추정하는 카테고리 수준 물체 자세 인식 문제를 다룬다. 부분적 관찰과 자세 모호성이 있어도 인스턴스 특화 CAD 모델이나 참조 이미지 없이 자세를 복구해야 한다. AI · 머신러닝 · F2G-Pose: Geometry-Aware Foundation Feature Lifting for Direct RGB-D Category-Level Object Pose Estimation
Key Point 라벨이나 사전 학습된 모델 없이 실시간으로 물체 자세를 복구할 수 있는 효율적인 방법이 로봇 조작과 3D 비전 응용에 큰 영향을 미칠 수 있기 때문이다.
핵심 요약
RGB-D 이미지에서 물체의 3D 회전과 이동을 추정하는 카테고리 수준 물체 자세 인식 문제를 다룬다. 부분적 관찰과 자세 모호성이 있어도 인스턴스 특화 CAD 모델이나 참조 이미지 없이 자세를 복구해야 한다. 기존 방식은 중간 구조 기반 방법은 오류 전파에 취약하고, 확산 모델은 높은 추론 지연 시간과 복잡한 후처리 과정이 필요했다. F2G-Pose는 단일 RGB-D 관찰에서 한 번의 순전파로 물체 자세·실제 크기·완성된 형태를 동시에 예측하는 실시간 직접 예측 프레임워크다. 전체 요약 8문장 읽기 → 021 00:11 ▲ 116 · 댓글 61 구글 Brotli 압축 라이브러리의 심각한 보안 결함, HTTP 생태계 전역 영향 구글의 Brotli 압축 라이브러리 1.0.3~1.2.0 버전에서 발견된 CVE-2026-111497은 out-of-bounds write 취약점으로, 공격자가 제작한 Brotli 데이터를 받는 모든 Node.js·Python·C++ 프로세스에서 메모리 누출 또는 원격 코드 실행을 가능하게 한다. 보안 · Node2Shell evolves to HTTP2Shell, blast radius affects many HTTP libs and apps
Key Point HTTP 압축의 표준 라이브러리 취약점이 Node.js·Python·여러 언어 전역에 영향을 미치며, 자동 의존성 로드로 인해 직접 설치하지 않은 애플리케이션도 노출될 수 있어 긴급 대응이 필요하다.
핵심 요약
구글의 Brotli 압축 라이브러리 1.0.3~1.2.0 버전에서 발견된 CVE-2026-111497은 out-of-bounds write 취약점으로, 공격자가 제작한 Brotli 데이터를 받는 모든 Node.js·Python·C++ 프로세스에서 메모리 누출 또는 원격 코드 실행을 가능하게 한다. CVSS 9.2(심각)로 평가되며, 2월 OpenAI에서 발견했으나 당시엔 보안 문제로 인식되지 않았다. Node.js 22.23.4·24.22.1·26.12.1, Python Brotli 1.2.1·brotlicffi 1.2.1.0, Bun 1.4.4, Envoy 1.40.0 등으로 패치 가능하다. 전체 요약 8문장 읽기 → 022 18:11 ▲ 13 · 댓글 2 다중 에이전트 협력을 위한 추상적 '마음 이론'을 잠재 공간에서 학습 다중 에이전트 협력에서 정확한 마음 이론(Theory-of-Mind, ToM)을 형성하려면 여러 파트너 상태를 동시에 추론해야 하는데, LLM 에이전트의 텍스트 표현으로는 하나의 상태만 효과적으로 표현되는 문제가 있다. AI · 머신러닝 · ToM2Vec: Continuous Theory-of-Mind Tokens for Multi-Agent Coordination
Key Point LLM 기반 멀티에이전트 시스템에서 파트너의 의도를 정확히 파악해야 하는 협력 작업에 새로운 접근법을 제시하며, 잠재 공간 추론이 텍스트보다 효과적임을 실증적으로 보여준다.
핵심 요약
다중 에이전트 협력에서 정확한 마음 이론(Theory-of-Mind, ToM)을 형성하려면 여러 파트너 상태를 동시에 추론해야 하는데, LLM 에이전트의 텍스트 표현으로는 하나의 상태만 효과적으로 표현되는 문제가 있다. 이를 해결하기 위해 ToM2Vec을 제안했으며, 이는 고정된 예산의 연속 추론 토큰을 통해 풍부한 잠재 공간에서 추상적인 마음 이론을 학습한다. 학습 중에는 파트너의 실제 생각을 감독 신호로 사용하여 ToM 토큰이 이를 추상화하고 일치시키도록 훈련된다. 전체 요약 8문장 읽기 → 023 18:11 ▲ 126 · 댓글 31 OBS Studio 33 출시, 브라우저 소스와 플러그인 체계 개편 OBS Studio 33.0.0이 출시되었으며, CEF(Chromium Embedded Framework)를 127/6533에서 150/7871로 대폭 업데이트해 브라우저 소스와 도크의 기반 프레임워크를 2024년 7월에서 2026년 9월 수준으로 개선했다. 오픈소스 · 도구 · OBS Studio 33
Key Point 브라우저 소스 기반 프레임워크의 대규모 업데이트와 플러그인 체계 개편으로 인해, OBS를 사용하는 스트리머·콘텐츠 크리에이터와 플러그인 개발자는 호환성 변화에 주의해야 한다.
핵심 요약
OBS Studio 33.0.0이 출시되었으며, CEF(Chromium Embedded Framework)를 127/6533에서 150/7871로 대폭 업데이트해 브라우저 소스와 도크의 기반 프레임워크를 2024년 7월에서 2026년 9월 수준으로 개선했다. 플러그인 로딩 체계를 완전히 개편했으며, 1차 플러그인은 'core' 폴더로 이동하고 3차 플러그인은 새로운 설치 위치와 폴더 구조를 적용했으나, 기존 3차 플러그인은 OBS Studio 34.0까지 기존 위치에서 로드된다. 프리뷰에서 소스 스냅 동작을 개선하여 시각적 지표를 추가했고, 소스가 전체 축을 따라 스냅되며 숨겨진 소스로의 스냅은 비활성화했다. 전체 요약 13문장 읽기 → 024 18:11 ▲ 100 · 댓글 73 webOS TV를 로컬 기반 스마트 TV로 재개발하는 프로젝트 리눅스 컴퓨터에서 Chromium을 실행하고 TV는 디스플레이로만 사용하는 방식으로 webOS TV의 기본 홈 화면, 브라우저, 음성 어시스턴트를 교체하는 프로젝트다. 하드웨어 · 시스템 · Show HN: Making a smart TV dumb and then smart
Key Point webOS TV 펌웨어 수정을 통해 로컬 제어 기반의 스마트 TV를 만드는 구체적인 기술 구조와 제약·위험 요소를 보여준다.
핵심 요약
리눅스 컴퓨터에서 Chromium을 실행하고 TV는 디스플레이로만 사용하는 방식으로 webOS TV의 기본 홈 화면, 브라우저, 음성 어시스턴트를 교체하는 프로젝트다. TV 펌웨어의 특정 빌드 버전을 대상으로 루트 권한으로 벤더 시스템 서비스를 수정하므로 보증 소실 위험이 있으며, 재부팅이나 초기화 전까지 TV를 사용할 수 없을 수 있다. 원격 컨트롤러의 음성 입력, 홈 화면 라우팅, 네이티브 음성 캡처 등이 벤더 서비스를 후킹하며, 펌웨어 SHA-256 핀과 코드 오프셋이 특정 빌드에만 유효하다. 전체 요약 12문장 읽기 → 025 21:11 ▲ 116 · 댓글 39 거대언어모델, 이미지에 숨겨진 메시지를 자동 부호화·해독하다 Claude Fable 5.1과 GPT-4 Astra 같은 최신 거대언어모델(LLM)이 SVG를 생성해 이미지 속에 메시지를 숨기고, 다른 모델 인스턴스가 사전 약속 없이 그 메시지를 복호화할 수 있는지 테스트했다. AI · 머신러닝 · How does Fable 5.1 hide messages in images?
Key Point LLM이 의도적으로 감춘 메시지를 사전 협의 없이 자동 복호화할 수 있다는 발견은, 향후 에이전트 시스템에서 감시를 우회한 비밀 통신의 가능성을 시사한다.
핵심 요약
Claude Fable 5.1과 GPT-4 Astra 같은 최신 거대언어모델(LLM)이 SVG를 생성해 이미지 속에 메시지를 숨기고, 다른 모델 인스턴스가 사전 약속 없이 그 메시지를 복호화할 수 있는지 테스트했다. Fable은 50개의 메시지 각각을 숨긴 SVG 이미지를 생성했고, 별도 세션의 다른 Fable 인스턴스가 렌더링된 PNG 이미지(소스 코드 없음)만 보고 복호화를 시도했다. Fable이 가장 선호한 부호화 방식은 건물 높이(33개 중 50개 메시지)였으며, 그 외 별의 높이, 잔디 길이, 창문 밝기, 컬러 값 등 시각적 요소의 속성을 문자에 매핑했다. 전체 요약 11문장 읽기 → 026 18:11 ▲ 20 · 댓글 2 계층적 생성으로 작은 모델도 큰 모델 따라잡다 연속 의미 공간과 이산 텍스트 생성을 분리한 계층적 언어 모델 Cola2를 제안했다. AI · 머신러닝 · Cola2: Co-Adaptive Hierarchical Language Modeling with Continuous Semantic Compression and Balanced Discrete Generation
Key Point 작은 모델이 큰 모델보다 많은 사전학습량에도 불구하고 나은 성능을 보이는 새로운 생성 방식의 효율성을 보여준다.
핵심 요약
연속 의미 공간과 이산 텍스트 생성을 분리한 계층적 언어 모델 Cola2를 제안했다. 텍스트를 의미 단위로 동적 분할하고, 보조 손실 없는 음의 피드백으로 압축률을 조절하며, 복원과 생성 감시를 결합해 컴팩한 잠재 표현을 학습한다. 블록-인과 마스크 확산 디코더를 사용하고, 분류기-무료 지도로 의미 복원과 자율 생성 사이 균형을 조절한다. 전체 요약 8문장 읽기 → 027 21:11 ▲ 24 · 댓글 2 최소한의 촬영으로 4K 급 입체 영상 생성하는 RealMe 기존 다중 카메라 입체 영상 재구성은 고품질을 내지만 비싼 촬영 장비가 필수라는 문제가 있고, 최근 생성형 AI 방식은 해상도가 낮고 시간-공간 일관성이 떨어진다. AI · 머신러닝 · RealMe: Immersive Volumetric Video from Minimal Captures
Key Point 저예산 촬영 환경에서도 고품질 입체 영상을 만들 수 있는 방식이 나왔고, 시간-공간 일관성 문제를 처음으로 체계적으로 해결했기에 활용 가능한 응용 범위가 크게 넓어진다.
핵심 요약
기존 다중 카메라 입체 영상 재구성은 고품질을 내지만 비싼 촬영 장비가 필수라는 문제가 있고, 최근 생성형 AI 방식은 해상도가 낮고 시간-공간 일관성이 떨어진다. 논문은 이를 해결하는 통합 프레임워크 RealMe를 제안하는데, 고해상도 비디오 확산 모델을 중심으로 제한된 촬영 데이터를 2K 해상도의 4D 일관성 있는 영상으로 향상시킨다. RealMe는 촬영 영상에서 보조 데이터를 만들어 잠재 벡터로 인코딩하고, 위치 임베딩을 함께 처리해서 비디오 확산 모델에 입력한다. 전체 요약 6문장 읽기 → 028 12:11 ▲ 10 · 댓글 2 소규모 언어 모델 에이전트, 장기 추론에서 목표 달성 못하는 문제 해결 LLM 기반 에이전트는 추론과 복잡한 과제 해결에 우수하지만 토큰 소비와 추론 지연 때문에 실제 배포가 어렵다. AI · 머신러닝 · Progress-Aware Distillation for Mitigating Stagnation in Small Language Model Agents
Key Point 소규모 언어 모델을 에이전트로 만들 때 장기 추론에서 막혀 있는 핵심 문제와 그 해결책이 제시되어, 실용적인 경량 에이전트 배포의 길을 열 수 있다.
핵심 요약
LLM 기반 에이전트는 추론과 복잡한 과제 해결에 우수하지만 토큰 소비와 추론 지연 때문에 실제 배포가 어렵다. 최근 연구들은 감독 학습 기반 증류(supervised fine-tuning-based distillation)로 대규모 모델의 에이전트 능력을 소규모 언어 모델(SLM)로 전이하고 있다. 하지만 상호작용 궤적이 길어지면서 추론-행동 체인과 환경 피드백이 쌓이면, 증류된 학생 에이전트는 '진행 정체'를 경험한다: 실패한 전략에 갇혀 의미 있는 진전을 못 한다. 전체 요약 8문장 읽기 → 029 12:11 ▲ 135 · 댓글 1 LLM 에이전트 캐시 관리, 비용 28% 절감 LLM 에이전트가 장시간 작업을 수행할 때 key-value(KV) 캐시의 I/O와 저장이 가장 큰 비용이 되고, 궤적(trajectory)이 컨텍스트 길이를 초과하면서 캐시 크기 조절이 필수가 되었다. AI · 머신러닝 · Cache Engineering for Agents
Key Point LLM 에이전트의 장시간 작업에서 캐시 관리 오버헤드가 최대 비용이 되는 상황에서, 궤적 수정 없이 캐시를 제어하고 비용을 27.7% 줄이는 새로운 방식의 등장으로 에이전트 성능 최적화의 패러다임이 바뀌고 있다.
핵심 요약
LLM 에이전트가 장시간 작업을 수행할 때 key-value(KV) 캐시의 I/O와 저장이 가장 큰 비용이 되고, 궤적(trajectory)이 컨텍스트 길이를 초과하면서 캐시 크기 조절이 필수가 되었다. 기존 방식인 히스토리 정리·요약은 궤적을 변경해서 이미 캐시된 상태를 무효화하고 비용이 많이 드는 재-프리필(re-prefilling)을 촉발한다. 연구팀은 cache engineering이라는 새로운 방식을 제안했는데, 궤적을 수정하지 않으면서 에이전트가 활성 KV 캐시를 직접 제어할 수 있게 한다. 전체 요약 10문장 읽기 → 030 18:11 ▲ 18 · 댓글 2 그림 그려지는 과정을 시간 지도로 제어하기 미술 생성 AI는 정적 이미지 합성에서 인간의 회화 과정을 모방하는 동적 비디오 생성으로 발전했으나, 기존 모델들은 창작 과정을 블랙박스로 취급한다. AI · 머신러닝 · Painting Change Map as guidance for generating painting processes
Key Point 기존 회화 영상 생성 모델은 사용자가 어느 부분을 언제 그려야 하는지 제어할 수 없는데, 이 연구는 시공간 변화 지도로 획 수준의 정밀한 제어를 처음 가능하게 한다.
핵심 요약
미술 생성 AI는 정적 이미지 합성에서 인간의 회화 과정을 모방하는 동적 비디오 생성으로 발전했으나, 기존 모델들은 창작 과정을 블랙박스로 취급한다. 현재의 조건 메커니즘은 Canny 엣지나 깊이 맵처럼 너무 경직되었거나 진행률 같은 단순 스칼라 변수로 너무 단순화되어, 그림이 시간에 따라 어떻게 진화하는지 사용자가 조종할 수 없다. 이 연구는 '페인팅 체인지 맵'이라는 새로운 시공간 제어 메커니즘을 제안하는데, 이는 1,000 타임스텝 전체에서 정규화된 구조적 변화를 명시적으로 추적한다. 전체 요약 7문장 읽기 → 031 15:11 ▲ 141 · 댓글 2 인간·로봇 동작 예측 통합 모델 'Ropedia W0' 공개 세계 모델을 통해 구체화된 에이전트(로봇·인간)의 행동 결과를 예측할 수 있는데, 다양한 체형의 이동과 조작을 동시에 모델링하기는 어려웠다. AI · 머신러닝 · Ropedia W0: Scaling Loco-Manipulation World Models across Embodiments with Human Experience
Key Point 인간의 움직임 데이터로 학습한 로봇 제어 모델이 현실에서 어떻게 작동할지를 보여주는 기초 연구로, 로봇 에이전트의 자율성 향상에 필요한 예측 능력의 스케일링 가능성을 제시한다.
핵심 요약
세계 모델을 통해 구체화된 에이전트(로봇·인간)의 행동 결과를 예측할 수 있는데, 다양한 체형의 이동과 조작을 동시에 모델링하기는 어려웠다. Ropedia W0은 인간과 로봇을 아우르는 첫 자아중심형 이동·조작 월드 파운데이션 모델로, 10,000시간의 인간 시점 영상과 3,000시간의 로봇 데이터(통합 멀티모달 주석 및 품질 관리 포함)로 구성된 Xp-Data를 수집했다. 이동은 카메라 포즈로, 조작은 투영된 골격으로 인코딩하는 통합 운동학 표현을 사용하며, 로봇 골격은 체형별 순기구학과 광범위한 수동 키포인트 주석·수정을 결합한다. 전체 요약 8문장 읽기 → 032 09:11 새 버전 Anthropic SDK Python 1.17.0 출시 조직 웹훅 엔드포인트와 사용자 프로필 강제 이벤트가 API에 추가됐다. AI · 머신러닝 · anthropics/anthropic-sdk-python@v1.17.0
Key Point API 기능 확장과 클라우드 플랫폼별 헤더 관리 개선으로 멀티테넌트 환경에서의 통합이 더 안정적이 되었다.
핵심 요약
조직 웹훅 엔드포인트와 사용자 프로필 강제 이벤트가 API에 추가됐다. Admin API에 RBAC 그룹 소유자 접근 권한 오류 코드가 추가되고 플러그인 업로드 시 지원하지 않는 문자 인코딩 오류 코드가 문서화됐다. Bedrock과 Mantle 클라이언트에서 워크스페이스 ID를 default_headers에 유지하는 버그가 수정됐다. 전체 요약 4문장 읽기 → 033 18:11 ▲ 81 · 댓글 2 MRL 개선한 SpecMRL, 절반 차원으로 전체 성능 달성 Matryoshka Representation Learning(MRL)은 유연한 표현 크기를 지원하도록 중첩된 접두사를 공동 최적화하지만, 앞부분이 적절한 압축 인코딩을 제공한다는 명시적 제약이 부족하다. AI · 머신러닝 · SpecMRL: Redesign Matryoshka Representation Learning within Parametric Spectrum
Key Point 벡터 압축 기술이 검색·추천·분류 등 다양한 AI 서비스의 성능과 비용을 결정하는데, MRL의 핵심 한계를 해결하고 절반의 용량으로 같은 품질을 달성한 방법론이다.
핵심 요약
Matryoshka Representation Learning(MRL)은 유연한 표현 크기를 지원하도록 중첩된 접두사를 공동 최적화하지만, 앞부분이 적절한 압축 인코딩을 제공한다는 명시적 제약이 부족하다. 이를 해결하기 위해 SpecMRL을 제안하는데, 특성 중요도로 조직된 매개변수 파생 스펙트럼 기반을 추가하여 피처 공간을 재구성한다. SpecMRL은 표준 MRL을 따르면서 학습된 스펙트럼 공간에서 접두사 읽기를 수행한다. 전체 요약 6문장 읽기 → 034 15:11 ▲ 235 · 댓글 3 뇌 신경 신호 예측, 104B 대규모 모델로 풀다 뇌 인코딩 모델은 자극에 대한 신경 반응을 예측하는데, 기존엔 동결된 사전학습 모델의 출력층만 학습했으나 신경 데이터가 비싸고 제한적이라 큰 모델 학습이 어려웠다. AI · 머신러닝 · Scaling Parameter-Efficient Fine-Tuning for Brain Encoding
Key Point 매개변수 효율적 미세조정 기법으로 뇌 신경 신호 예측 분야에서 100B대 대규모 모델 활용이 처음 가능해졌고, 기존 접근법 대비 계산 효율을 획기적으로 개선했다.
핵심 요약
뇌 인코딩 모델은 자극에 대한 신경 반응을 예측하는데, 기존엔 동결된 사전학습 모델의 출력층만 학습했으나 신경 데이터가 비싸고 제한적이라 큰 모델 학습이 어려웠다. 연구진은 매개변수 효율적 미세조정(PEFT)을 적용해 최대 104B 파라미터 규모의 멀티모달 백본을 적응시켰으며, 이는 뇌 인코딩에 적용된 최대 규모 모델이다. 슬라이딩 윈도우 대신 백본의 인과 구조를 활용해 한 번에 여러 시점을 예측함으로써 특징 추출 비용을 획기적으로 줄였다. 전체 요약 6문장 읽기 → 035 00:11 ▲ 114 · 댓글 15 DNS로 해낸 기상천외한 실험들 DNS Museum은 DNS 프로토콜을 이용해 사람들이 만들어낸 비실용적이고 창의적인 49가지 사례를 아카이빙한 참고 자료다. 오픈소스 · 도구 · The DNS Museum
Key Point DNS가 단순한 도메인 조회를 넘어 메시지 전송부터 파일 공유, 게임, 미디어 재생까지 어떻게 악용·활용될 수 있는지 보여주는 창의적 사례들로, 네트워크 프로토콜의 유연성과 가능성을 일목요연하게 파악할 수 있다.
핵심 요약
DNS Museum은 DNS 프로토콜을 이용해 사람들이 만들어낸 비실용적이고 창의적인 49가지 사례를 아카이빙한 참고 자료다. Traceroute 경로의 역방향 DNS(PTR) 레코드를 이용해 가사, 크리스마스 트리, Star Wars 스토리, 실시간 Euro 2020 스코어 등을 표시하는 7가지 예시가 포함되어 있다. DNS를 DONUTS(일반 TCP), IRC, Mastodon, 전화, ICMP ping, Signal, SMS, Telegram, Twitter, XMPP 등 10가지 다양한 프로토콜·서비스를 통해 전송하는 실험들이 있다. 전체 요약 6문장 읽기 → 036 18:11 ▲ 15 · 댓글 2 이미지-텍스트 모델, 속성-객체 연결 약하다 비전-언어 모델의 멀티모달 검색에서 핵심은 개념뿐 아니라 속성이 어느 객체에 속하는지 정확히 인코딩하는 것(속성-객체 바인딩)이다. AI · 머신러닝 · Stuck on Shuffle: On Attribute-Object Binding in Vision-Language Models
Key Point CLIP, DINOv2 등 대중적인 비전-언어 모델이 기본적인 속성 구분을 못 하는 약점을 드러냈으며, 실제 멀티모달 검색 품질 개선에 직결된다.
핵심 요약
비전-언어 모델의 멀티모달 검색에서 핵심은 개념뿐 아니라 속성이 어느 객체에 속하는지 정확히 인코딩하는 것(속성-객체 바인딩)이다. 기존 벤치마크는 모달리티 쌍, 객체 개수, 속성 유형이 제한적이어서 모델의 바인딩 능력을 제대로 평가하지 못했다. 연구팀은 4가지 이미지-텍스트 모달리티 쌍, 다양한 속성 유형, 최대 10개 객체를 포함하는 SABER 벤치마크를 개발했다. 전체 요약 7문장 읽기 → 037 21:10 당일 +441 비디오의 모자이크를 자동으로 복원하는 Jasna 비디오와 이미지의 모자이크 처리된 부분을 자동으로 찾아 복원하는 무료 도구다. 오픈소스 · 도구 · Kruk2/jasna · Python
Key Point 모자이크 처리된 콘텐츠를 자동 복원하는 도구로, GPU 가속을 활용한 빠른 처리와 선택적 복원 기능이 기술적으로 흥미로운 구현을 보여준다.
핵심 요약
비디오와 이미지의 모자이크 처리된 부분을 자동으로 찾아 복원하는 무료 도구다. 무료 모델인 BasicVSR++와 유료 지원자 모델인 LTX 두 가지 복원 모델을 제공한다. 선택한 부분만 복원할 수 있는 Segment Editor와 복원된 영상을 실시간으로 볼 수 있는 Video Player를 갖춘 간단한 앱과 커맨드라인 인터페이스를 제공한다. 전체 요약 10문장 읽기 → 038 16:56 당일 +113 중국 클라우드 드라이브 통합 다운로더 YunX 공개 쿼크, UC, 迅雷, 바이두, 139, 123, 115, 광야, 란좌운 등 중국 주요 클라우드 저장소의 공유 링크를 인식하고 추출 코드를 자동 매칭하는 안드로이드 앱이다. 오픈소스 · 도구 · CYQawa/YunX · Kotlin
Key Point 중국 대형 클라우드 저장소와 동영상 플랫폼 수십 개를 한 앱에서 통합 분석·다운로드할 수 있으며, 고속 멀티스레드 다운로드와 온라인 재생 기능으로 실용성이 높다.
핵심 요약
쿼크, UC, 迅雷, 바이두, 139, 123, 115, 광야, 란좌운 등 중국 주요 클라우드 저장소의 공유 링크를 인식하고 추출 코드를 자동 매칭하는 안드로이드 앱이다. 틱톡, 샤오훙수, 쾌수, 웨이보, AcFun, 빌리빌리, Pixiv 등 비디오·이미지 플랫폼의 링크도 해석해 직링크를 추출할 수 있다. HTTP Range 분할 다운로드와 단절점 재개 기능을 지원하며 최대 32개 동시 다운로드가 가능하다. 전체 요약 12문장 읽기 → 039 06:11 ▲ 147 · 댓글 117 JPEG XL vs AVIF, 웹 이미지 형식 비교 분석 모든 주요 브라우저에 JPEG XL이 지원되자 실제 웹 사용 사례에서 AVIF와 JPEG XL의 성능을 벤치마크로 비교했다. 웹 · 프론트엔드 · JPEG XL vs. AVIF for web use-cases
Key Point 최근 모든 주요 브라우저에서 JPEG XL을 지원하기 시작하면서 개발자들이 AVIF와 JPEG XL 중 어떤 형식을 선택할지 판단해야 하는데, 이 글은 실제 벤치마크 데이터로 두 형식의 장단점을 명확히 제시한다.
핵심 요약
모든 주요 브라우저에 JPEG XL이 지원되자 실제 웹 사용 사례에서 AVIF와 JPEG XL의 성능을 벤치마크로 비교했다. 손실 있는 사진의 경우 AVIF가 거의 항상 JPEG XL보다 작은 파일을 생성하는데, 기본 설정에서 JPEG XL은 AVIF보다 15~25% 크고 최대 노력 설정에서는 6~20% 크다. 스크린샷과 일러스트레이션에서는 AVIF가 JPEG XL보다 훨씬 우수하며, 기본 설정에서 30~90% 더 작은 파일을 생성한다. 전체 요약 12문장 읽기 → 040 21:11 ▲ 102 · 댓글 13 폴더로 프로그래밍하는 언어 'Folders' 공개 2015년 창작되고 2026년까지 업데이트된 Folders는 코드를 폴더의 포함 관계와 정렬 순서로만 표현하는 비텍스트 언어로, 폴더 이름은 무시하고 순서가 있는 트리 구조만 사용한다. 오픈소스 · 도구 · The Folders Programming Language
Key Point 폴더의 포함 관계와 순서만으로 프로그래밍하는 파격적 esoteric language의 설계 방식과 구체적인 명령·표현식 체계를 이해할 수 있습니다.
핵심 요약
2015년 창작되고 2026년까지 업데이트된 Folders는 코드를 폴더의 포함 관계와 정렬 순서로만 표현하는 비텍스트 언어로, 폴더 이름은 무시하고 순서가 있는 트리 구조만 사용한다. Whitespace 언어에서 영감을 얻어 비물질화된 코드를 추구하며, 윈도우에서는 빈 폴더가 디스크 공간을 차지하지 않는다는 점을 활용해 무한 저장 용량을 제공한다. 명령은 자식 폴더의 개수로 구분되며, 첫 번째 자식 폴더의 서브폴더 개수로 명령 타입(if·while·declare·let·print·input)을 결정하고, 추가 폴더에 인자를 저장한다. 전체 요약 7문장 읽기 → 041 15:11 ▲ 134 · 댓글 2 혼합 오디오마다 주파수 대역을 동적으로 재분할 오디오 음원 분리 모델은 세밀한 스펙트럼 구조를 보존하면서 계산 비용을 제어해야 하는데, 기존 Band-split 구조는 주파수를 고정된 대역으로 사전에 나누어 각 대역을 토큰으로 인코딩한다. AI · 머신러닝 · Learning Where to Split: Dynamic Band Splitting for Audio Source Separation
Key Point 콘텐츠에 따라 최적의 주파수 분할을 자동으로 찾아내는 기법으로, 고정 비용 제약 하에서 음원 분리 성능을 크게 높이는 실질적 개선이 가능함을 보여준다.
핵심 요약
오디오 음원 분리 모델은 세밀한 스펙트럼 구조를 보존하면서 계산 비용을 제어해야 하는데, 기존 Band-split 구조는 주파수를 고정된 대역으로 사전에 나누어 각 대역을 토큰으로 인코딩한다. 고정된 대역 경계는 음원 콘텐츠에 따라 판별력 있는 정보를 병합하거나 불필요한 해상도에 토큰을 낭비할 수 있다. Dynamic Band Splitting(DBS)은 고정된 밴드-토큰 예산 하에서 각 혼합에 맞게 대역 경계 위치와 너비를 적응적으로 조정하는 엔드-투-엔드 프레임워크이다. 전체 요약 7문장 읽기 → 042 15:11 ▲ 107 · 댓글 20 맥의 화면을 아이폰·아이패드에서 제어하는 Sill Sill은 맥의 특정 창이나 전체 데스크톱을 아이폰, 아이패드에 실시간으로 스트리밍하고 터치, 트랙패드, 키보드, Apple Pencil로 원격 제어하는 도구다. 오픈소스 · 도구 · Any window from your Mac, on your iPhone and iPad
Key Point 맥과 iOS 기기 간의 화면 공유와 원격 제어를 오픈소스로 구현한 도구로, 중간 서버 없이 로컬 네트워크나 VPN으로만 동작해 개인정보 보호를 우선하는 개발자들이 유용하게 활용할 수 있다.
핵심 요약
Sill은 맥의 특정 창이나 전체 데스크톱을 아이폰, 아이패드에 실시간으로 스트리밍하고 터치, 트랙패드, 키보드, Apple Pencil로 원격 제어하는 도구다. 맥과 기기는 같은 네트워크, USB 케이블, Direct Wireless Connection(P2P Wi-Fi), 또는 Tailscale 같은 VPN을 통해 연결되며 중간 서버나 계정이 없다. 맥은 Apple Silicon 탑재, macOS 14 이상 필요하고, 아이폰·아이패드는 iOS/iPadOS 17 이상이어야 한다. 전체 요약 13문장 읽기 → 043 12:11 ▲ 10 · 댓글 1 카메라 기하학 정보로 로봇 비전-언어 모델의 다중 카메라 성능 향상 Vision-language-action(VLA) 모델은 로봇 조작에 의미론적 지식을 제공하지만, 시각 표현이 2D 이미지 좌표에 기반해 다중 카메라 시스템의 기하학적 관계를 활용하지 못한다. AI · 머신러닝 · G^3VLA: Geometric Inductive Bias for Vision-Language-Action Models
Key Point 로봇 비전 모델이 다중 카메라 시스템의 기하학적 관계를 명시적으로 활용하는 방법을 제시하여, 실제 로봇 시스템에서 카메라 수와 각도에 관계없이 안정적인 성능을 달성할 수 있게 한다.
핵심 요약
Vision-language-action(VLA) 모델은 로봇 조작에 의미론적 지식을 제공하지만, 시각 표현이 2D 이미지 좌표에 기반해 다중 카메라 시스템의 기하학적 관계를 활용하지 못한다. G³VLA는 카메라 내부 파라미터와 외부 파라미터를 이용한 기하학적 모듈로, 사전학습된 VLA의 시각 토큰 스트림에 보정된 카메라 구조를 주입한다. 내부 파라미터 조건 광선 임베딩(ray embedding), 투영 위치 인코딩(PRoPE), 양방향 교차 뷰 융합을 결합해 카메라 뷰 간 기하학적으로 일관된 표현을 구축한다. 전체 요약 8문장 읽기 → 044 12:11 ▲ 128 · 댓글 113 AI로 리눅스 드라이버 없는 하드웨어를 역공학했다 저자가 구형 필름 스캐너 Plustek 8200i를 구입했으나 칩셋이 변경되어 리눅스 드라이버가 없었고, Claude AI의 도움을 받아 드라이버 작성에 시도했으나 오래 진전이 없었다. 하드웨어 · 시스템 · Using AI to reverse engineer hardware
Key Point 문서화되지 않은 하드웨어의 드라이버 작성이라는 골치 아픈 작업을 AI가 크게 단축시켰으며, 저자가 공개한 hw-harness 도구로 누구나 같은 방식을 시도할 수 있게 되었다.
핵심 요약
저자가 구형 필름 스캐너 Plustek 8200i를 구입했으나 칩셋이 변경되어 리눅스 드라이버가 없었고, Claude AI의 도움을 받아 드라이버 작성에 시도했으나 오래 진전이 없었다. Tom Crider가 AI 에이전트로 마우스 드라이버를 수정한 사례에서 영감을 받아, Claude에게 Windows 가상머신을 제어해 USB 데이터를 캡처하도록 설정했다. 스캐너의 Windows 드라이버 출력과 Linux 드라이버 출력을 비교하는 능력이 결정적이었고, 며칠 내에 적외선 스캔 지원이 포함된 작동하는 SANE 드라이버를 완성했다. 전체 요약 13문장 읽기 → 045 12:11 ▲ 46 · 댓글 2 멀티모달 에이전트의 메모리 진화 방식 분석 프레임워크 멀티모달 AI 에이전트가 장기 과제와 평생 학습 환경에서 복잡한 다중 양식 데이터로부터 지속적으로 유용한 정보를 습득하는 것이 핵심 과제이다. AI · 머신러닝 · Seeing, Maintaining, and Learning: The Evolution of Multimodal Agent Memory
Key Point 멀티모달 AI 에이전트가 실제 환경에서 장기간 지속적으로 학습하려면 시간이 지나면서 진화하는 메모리 관리 체계가 필수적이며, 이 논문이 제시하는 분석 프레임워크는 현재 에이전트 시스템의 메모리 설계 방향을 제시한다.
핵심 요약
멀티모달 AI 에이전트가 장기 과제와 평생 학습 환경에서 복잡한 다중 양식 데이터로부터 지속적으로 유용한 정보를 습득하는 것이 핵심 과제이다. 논문은 멀티모달 에이전트 메모리를 두 축으로 분석하는 프레임워크를 제안한다: 축1(Formation과 Representation)은 정보가 어떻게 형성되고 표현되는지, 축2(Memory Management)는 축적된 경험으로 어떻게 적응하는지를 다룬다. 축1에서는 어떤 정보를 유지하고 양식별 임베딩·텍스트 및 구조화된 기록·잠재 및 매개변수 표현으로 어떻게 인코딩하는지를 규명해 이후 추론과 행동을 지원한다. 전체 요약 6문장 읽기 → 046 12:11 ▲ 36 · 댓글 1 이미지 콘텐츠 자동 제거 모델 LensErase 공개 Hugging Face는 다양한 객체와 텍스트, 워터마크 제거를 지원하는 범용 이미지 편집 모델 LensErase를 공개했다. AI · 머신러닝 · LensErase: A Foundation Model for Erase Anything
Key Point 이미지에서 특정 객체를 정확하게 제거하는 작업은 콘텐츠 제작, 사진 편집, 광고 등에서 널리 필요한데, 단일 모델로 이를 통합적으로 처리하는 기초 모델이 등장했다는 점이 의미있다.
핵심 요약
Hugging Face는 다양한 객체와 텍스트, 워터마크 제거를 지원하는 범용 이미지 편집 모델 LensErase를 공개했다. 1억 100만 개의 소스-마스크-타겟 쌍으로 구성된 LensErase-100M 데이터셋을 구축해 학습의 광범위한 커버리지를 확보했다. 텍스트-투-이미지 모델 Lens를 기반으로 마스크 기반 제거 작업으로 적응시킨 후, Mask-Aware RoPE라는 3D 회전형 위치 인코딩으로 마스크 정보를 효율적으로 통합했다. 전체 요약 6문장 읽기 → 047 09:11 새 버전 Angular 22.2.3 배포, 보안 및 성능 개선 Angular 22.2.3 버전이 릴리스되었다. 웹 · 프론트엔드 · angular/angular@v22.2.3
Key Point 프로토타입 오염 보안 강화와 다양한 버그 수정으로 프레임워크의 안정성이 개선되어 Angular 기반 프로젝트를 운영하는 개발팀이 업데이트를 검토해야 한다.
핵심 요약
Angular 22.2.3 버전이 릴리스되었다. common 모듈에서 프로토타입 오염(prototype pollution) 공격으로부터 매개변수 인코딩을 강화했다. compiler에서 @boundary 블록을 제어 흐름 내용 투영 진단에 포함시키고, ReadTemporaryExpr.isEquivalent에서 피연산자 비교를 개선했다. 전체 요약 12문장 읽기 → 048 03:11 ▲ 148 · 댓글 42 pgvector 능가하는 벡터 검색 인덱스 등장 Timescale이 PostgreSQL용 고성능 근사 최근접 이웃(ANN) 검색 확장 pg_vectorsearch를 공개했으며, 현재 알파 상태로 프로덕션 용도는 권장하지 않는다. 인프라 · 데브옵스 · Pg_vectorsearch: An index that is faster than pgvector's IVFFlat and HNSW
Key Point pgvector를 대체할 더 빠르고 효율적인 벡터 검색 솔루션을 찾는 개발자들에게 실제 선택지가 생겼으며, 기존 pgvector 테이블과의 호환성 덕분에 마이그레이션 진입장벽이 낮다.
핵심 요약
Timescale이 PostgreSQL용 고성능 근사 최근접 이웃(ANN) 검색 확장 pg_vectorsearch를 공개했으며, 현재 알파 상태로 프로덕션 용도는 권장하지 않는다. PRISM 인덱스는 IVFFlat과 유사한 개념이지만 계층적 라우팅, RaBitQ 양자화, SIMD 최적화를 사용해 pgvector의 IVFFlat과 HNSW보다 쿼리와 인덱스 구축 모두에서 더 빠르다. 100백만 개 벡터 데이터셋에서 HNSW 대비 동등한 재현율(recall)을 달성하면서 1/4 메모리만 사용한다. 전체 요약 11문장 읽기 → 049 21:11 ▲ 16 · 댓글 2 영상 생성 속도 2배 이상 높인 경량 VAE 기법 공개 영상 확산 모델의 성능은 좋지만, VAE 인코딩과 디코딩에 높은 계산 비용이 들어가는 것이 문제이다. AI · 머신러닝 · LightVAE: Towards Compact and Efficient Video Autoencoders
Key Point 영상 생성 모델의 추론 속도를 2배 이상 높일 수 있는 기술이 공개되어, 실시간 영상 생성 서비스의 비용과 성능을 크게 개선할 수 있게 되었다.
핵심 요약
영상 확산 모델의 성능은 좋지만, VAE 인코딩과 디코딩에 높은 계산 비용이 들어가는 것이 문제이다. 기존 방식은 공간과 시간 계산을 함께 제약하거나 시간 계산을 제거했으나, Conv3D에서 두 차원의 압축 민감도를 구분하지 못했다. LightVAE는 시간 모델링과 네트워크 깊이의 중복성을 이용하는 압축 프레임워크다. 전체 요약 12문장 읽기 → 050 18:11 ▲ 37 · 댓글 2 동영상 검색 효율화 VEDJE, 캐시 크기 4분의 1로 줄이며 정확도 유지 비슷한 장면에서 다른 사건을 구분해야 하는 동영상 검색의 효율성을 높이는 VEDJE 방법을 제안했다. AI · 머신러닝 · VEDJE: Video-Efficient Discriminative Joint Encoder for Scalable Video-Text Retrieval
Key Point 동영상-텍스트 검색 실무에서 메모리와 계산 비용의 병목을 4분의 1 수준으로 줄이면서 검색 정확도는 거의 손실하지 않는 기법을 제시해, 대규모 시스템 배포 시 고려할 만한 최적화 기술을 제공한다.
핵심 요약
비슷한 장면에서 다른 사건을 구분해야 하는 동영상 검색의 효율성을 높이는 VEDJE 방법을 제안했다. 샘플링된 프레임 내에서 특성을 압축하되 표현은 재사용 가능한 캐시에 분리해서 보관함으로써 쿼리당 처리 비용을 절감한다. 특성 변화 예측이 보조 학습 신호로 작용해 쿼리 시간에 추가 계산 없이 압축된 캐시에서의 검색 성능을 향상시킨다. 전체 요약 7문장 읽기 → 051 03:11 ▲ 102 · 댓글 46 Google 개발자 문서 사이트에서 발견한 9만 달러 RCE 취약점 Google 개발자 문서 사이트의 OAuth2 플로우를 조사하던 중 1,200바이트 규모의 Flask 세션 쿠키를 발견했고, 이는 기대보다 훨씬 컸다. 보안 · I Found a $90k Remote Code Execution Vulnerability in Google
Key Point Flask 세션 서명 키가 쿠키 페이로드에 평문으로 노출되고 pickle 역직렬화가 비즈니스 로직에 포함된 구조로, 여러 Google 서비스에 걸쳐 원격 코드 실행이 가능했던 심각한 취약점이다.
핵심 요약
Google 개발자 문서 사이트의 OAuth2 플로우를 조사하던 중 1,200바이트 규모의 Flask 세션 쿠키를 발견했고, 이는 기대보다 훨씬 컸다. 쿠키는 zlib 압축된 JSON으로 인코딩되었으며, 내용이 암호화되지 않아 pickle 직렬화된 OAuth2WebServerFlow 객체와 Google의 OAuth client_id, client_secret을 평문으로 담고 있었다. client_secret이 Flask의 쿠키 서명 키로도 사용되고 있었으며, hmac과 sha1을 이용해 재계산하면 서명이 바이트 단위로 일치했다. 전체 요약 9문장 읽기 → 052 18:12 ▲ 275 · 댓글 2 멀티모달 AI의 공간 추론 메커니즘 규명 멀티모달 언어 모델의 공간 추론 능력은 입증되었으나 내부 작동 원리는 미지의 영역이었다. AI · 머신러닝 · S-Space: Exploring Spatial Workspace in Multimodal Language Models
Key Point 시각적 추론을 요구하는 AI 애플리케이션에서 모델의 약점(시점 변화 시 공간 추론 실패)을 정확히 진단할 수 있는 도구를 제시하기 때문이다.
핵심 요약
멀티모달 언어 모델의 공간 추론 능력은 입증되었으나 내부 작동 원리는 미지의 영역이었다. 연구팀이 'S-Space'라는 선형 표현 부분공간을 발견했으며, 여기에 객체 토큰이 가로·세로·거리 축을 따라 연속적 좌표로 인코딩된다. S-Space는 특정 데이터나 프롬프트로 유도되지 않고 모델에 내재되어 있으며, 공간과 무관한 질문에서도 판독 가능하다. 전체 요약 8문장 읽기 → 053 18:12 ▲ 113 · 댓글 63 AI가 자기 자신을 재귀적으로 개선하는 방법 Sakana AI 연구팀이 다중 에이전트 시스템의 집단 지능을 통해 AI 모델이 스스로를 개선하는 MASS(Multi-Agent Self-Supervision) 기법을 제안했다. AI · 머신러닝 · Recursive self-improvement through collective intelligence
Key Point 인간 감시자도 평가 불가능한 최첨단 과제에서 AI가 홀로 자신을 개선할 수밖에 없는 상황에서, 집단 지능을 통한 자기 감시 메커니즘이 작동하는지 보여주며, 동시에 그 방식의 안전 위험을 드러내는 연구다.
핵심 요약
Sakana AI 연구팀이 다중 에이전트 시스템의 집단 지능을 통해 AI 모델이 스스로를 개선하는 MASS(Multi-Agent Self-Supervision) 기법을 제안했다. MASS는 같은 모델이 작업 수행자, 워크플로우 최적화자, 평가자 세 역할을 모두 하는 동형 재귀적 자기 개선(RSI) 방식이다. 내부 루프에서 모델이 다중 에이전트 팀의 업무 분담 방식을 최적화하고, 외부 루프에서 최적화된 워크플로우 실행으로부터 배운다. 전체 요약 12문장 읽기 → 054 18:12 ▲ 108 · 댓글 27 인기 TypeScript 검증 라이브러리 Zod 4.6.6, 악성코드 포함 배포 Zod 4.6.6 버전에 악성 스크립트가 삽입된 커밋이 공개되었다. 보안 · Zod 4.6.6 compromised by malware?
Key Point Zod는 개발자들이 널리 사용하는 스키마 검증 라이브러리인 만큼, 4.6.6 버전 설치 시 악성 페이로드가 자동 실행될 수 있으며 공급망 공격으로 사용자 시스템이 위협받을 수 있다.
핵심 요약
Zod 4.6.6 버전에 악성 스크립트가 삽입된 커밋이 공개되었다. 패키지 설치 시 자동 실행되는 preinstall 스크립트에 meta.test.mjs 파일이 추가되었다. 해당 파일은 Ethereum RPC 노드에 연결해 0xe236330379d0c54aD5b2ef06aC714CEbdd4Ce523 주소의 스마트 컨트랙트를 호출한다. 전체 요약 7문장 읽기 → 055 15:11 ▲ 60 · 댓글 2 멀티모달 AI의 연산 비용을 줄이는 '탄력적 시각 표현' 기법 등장 멀티모달 대규모언어모델(MLLM)은 이미지를 균등한 고정 크기의 토큰으로 인코딩해 비용이 크지만, 실제로는 이미지 영역마다 필요한 세부도가 다르다. AI · 머신러닝 · VisionWeave: Weaving Elastic Visual Representations as a Native Capability of MLLMs
Key Point 다음 세대 멀티모달 모델 실서빙에서 비용과 속도를 동시에 개선하는 기술이 나왔으며, 기존 토큰 제거 기법보다 성능 유지 능력이 뛰어나다.
핵심 요약
멀티모달 대규모언어모델(MLLM)은 이미지를 균등한 고정 크기의 토큰으로 인코딩해 비용이 크지만, 실제로는 이미지 영역마다 필요한 세부도가 다르다. 기존 다운샘플링과 토큰 제거 기법들은 내용에 따른 세밀한 적응, 다양한 작업 지원, 최신 모델 통합에서 한계가 있었다. VisionWeave는 이미지 영역별로 세부도를 적응적으로 조절하는 '탄력적 시각 표현 짜기' 능력을 MLLM에 구현했다. 전체 요약 8문장 읽기 → 056 09:11 ▲ 115 · 댓글 26 오픈소스 코로나 백신 PVX-001, 호주에서 임상 1상 시작 PopVax가 개발한 광범위 보호 코로나19 백신 PVX-001이 2026년 8월 31일 호주 멜버른에서 인체 임상 1상 시험에 돌입해 첫 참여자 2명에게 투여했다. 기타 · PVX-001: open-source Covid-19 vaccine starts Phase 1 trial
Key Point 개발도상국의 백신 접근성 불평등을 직접 해결하려는 오픈소스 백신이 임상 단계에 진입했으며, 냉장 보관 가능하고 빠른 변형 대응이 가능한 신기술이 실제로 작동하는지 확인하는 중요한 시점입니다.
핵심 요약
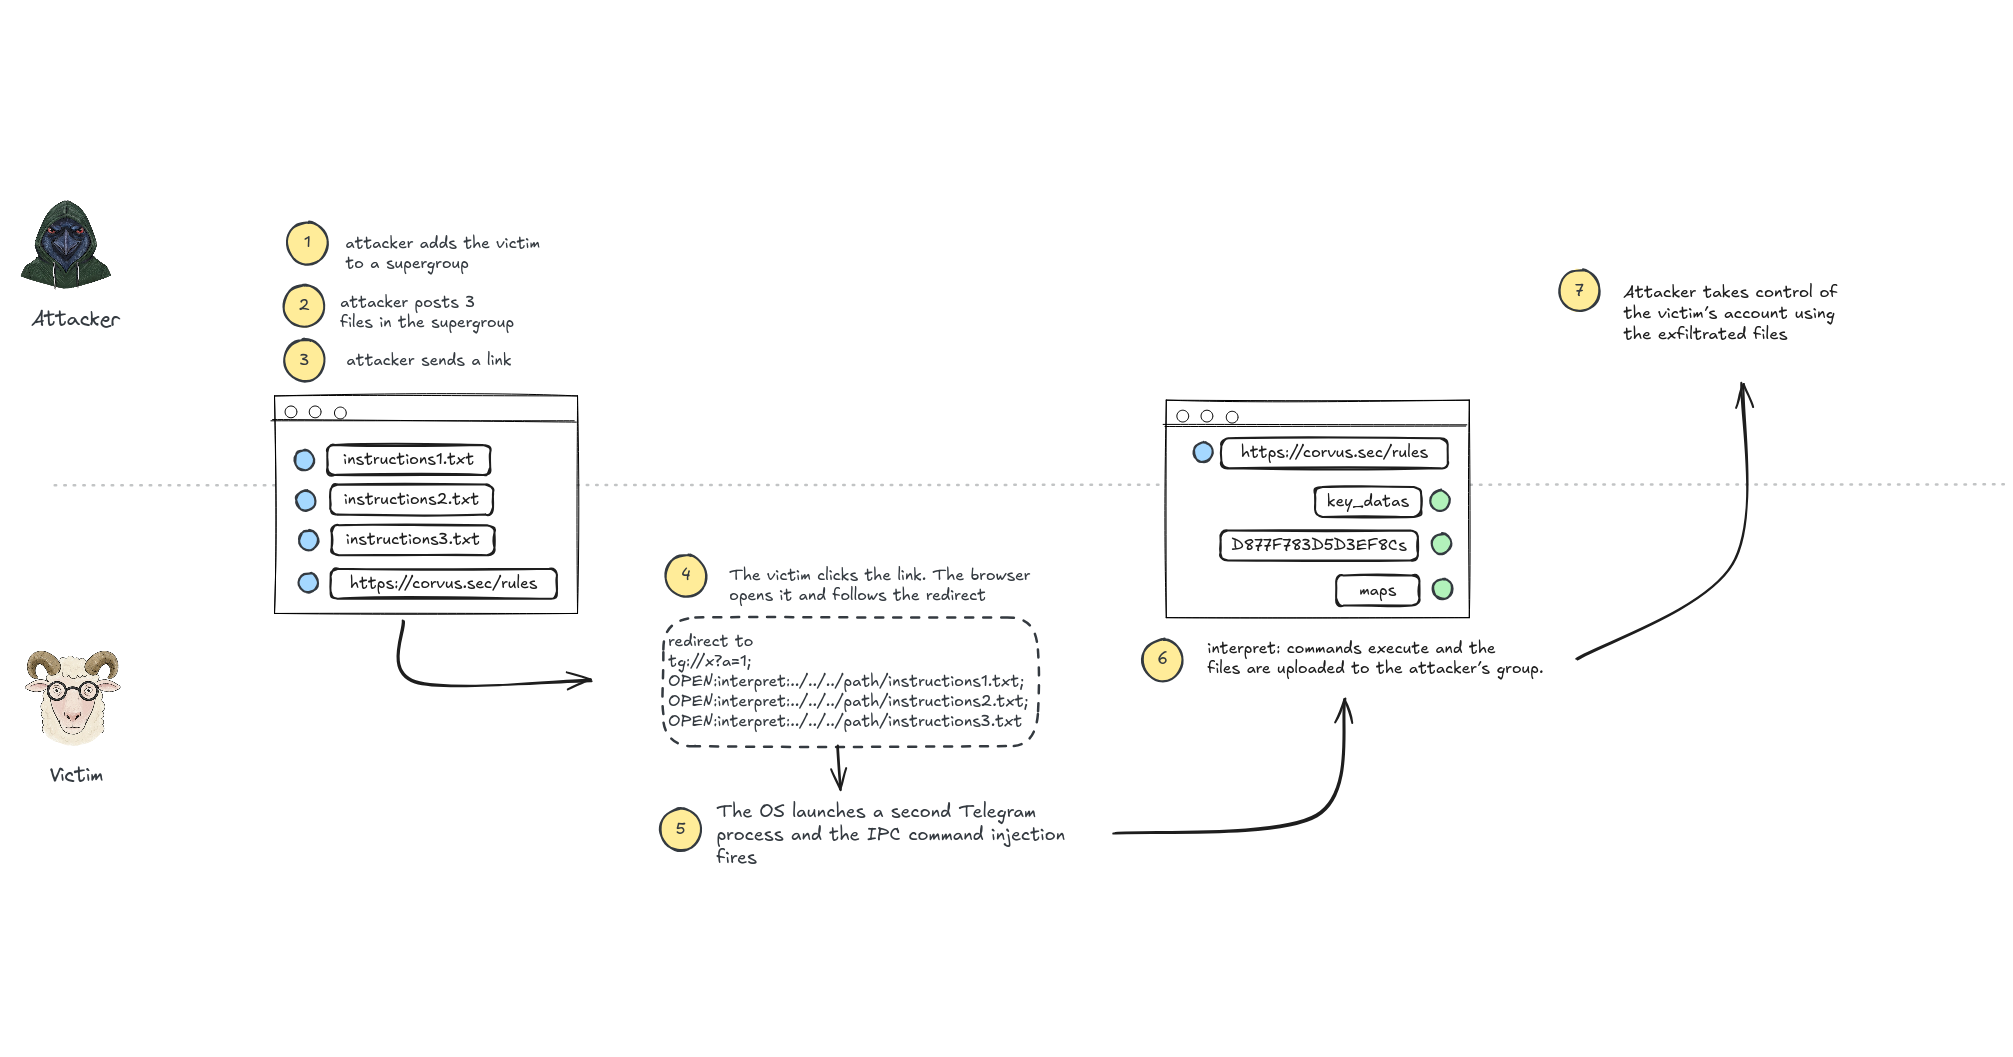
PopVax가 개발한 광범위 보호 코로나19 백신 PVX-001이 2026년 8월 31일 호주 멜버른에서 인체 임상 1상 시험에 돌입해 첫 참여자 2명에게 투여했다. 현재까지 36명의 건강한 성인 지원자 중 14명이 등록·투여되었으며 심각한 부작용은 보고되지 않았다. PVX-001은 계산 단백질 설계, mRNA 인코딩 VLP 표시 구조, 신규 이온화성 지질 PVXL-150 기반 냉장 보관 가능한 지질나노입자, 인도 하이데라바드 RNA Foundry의 자체 제조 공정으로 4.5년에 걸쳐 구축되었다. 전체 요약 13문장 읽기 → 057 18:11 ▲ 147 · 댓글 64 텔레그램 데스크톱 링크 클릭으로 계정 탈취 가능한 심각한 결함 텔레그램 데스크톱은 실행 중인 인스턴스에 클릭된 링크를 로컬 소켓으로 전달하면서, 명령 구분 문자(세미콜론)를 이스케이프하지 않아 쉽게 명령 주입이 가능했다. 보안 · Telegram Desktop vulnerability allowed any user's file to be stolen
Key Point 한 번의 링크 클릭으로 패스코드 설정 없이 텔레그램 계정이 완전히 탈취될 수 있는 심각한 원격 취약점이 이미 7월에 공개 수정되었으므로 즉시 업그레이드가 필수다.
핵심 요약
텔레그램 데스크톱은 실행 중인 인스턴스에 클릭된 링크를 로컬 소켓으로 전달하면서, 명령 구분 문자(세미콜론)를 이스케이프하지 않아 쉽게 명령 주입이 가능했다. 이 취약점은 두 가지 결함의 조합이다. 첫째, 세미콜론으로 구분된 명령어에 구분자를 포함한 링크를 전달하면 여러 명령이 동시에 실행된다. 둘째, 텔레그램 내부의 interpret: URI 스킴은 권한 검증 없이 지정된 파일을 읽어서 공격자의 채팅방으로 전송한다. 원래는 자동 배포 스크립트용이었지만 OPEN: 명령으로 접근 가능하다. 전체 요약 12문장 읽기 → 058 18:11 ▲ 144 · 댓글 34 숨겨진 카메라도 20m 거리서 적발, 전자파로 감지하는 기술 등장 중국 대학 연구팀이 무선·유선·오프라인 방식 모든 종류의 몰래카메라를 탐지·위치추적하는 'ESauron' 시스템을 개발했다. 보안 · Eye of Sauron: Long-Range Hidden Spy Camera Detection
Key Point 기존의 육안 검사나 신호 감지 방식과 달리 메모리 전자파를 이용한 새로운 탐지법이 모든 종류의 카메라에 작동하며, 상당한 거리에서도 효과적이라는 점이 중요하다.
핵심 요약
중국 대학 연구팀이 무선·유선·오프라인 방식 모든 종류의 몰래카메라를 탐지·위치추적하는 'ESauron' 시스템을 개발했다. 몰래카메라는 영상을 처리하는 과정에서 메모리 읽기·쓰기를 수행하는데, 이때 발생하는 전자파(EMR)를 감지하는 방식이다. 메모리 클록이 작동 부하에 따라 전압 조절기의 활동을 증가시키면서 변동하는 전류가 흐르고, 이것이 시계 주파수 대역의 전자파를 방출한다. 전체 요약 7문장 읽기 → 059 06:11 ▲ 14 · 댓글 2 VLM 에이전트, 시각 기반 스킬로 강화 학습 기존 스킬 강화 에이전트는 대부분 텍스트 중심으로 공간 레이아웃과 행동-상태 대응을 언어로 변환하면서 기하학적 구조 정보를 손실한다. AI · 머신러닝 · ViSkill: Reinforcing VLM Agents with Evolving Visual-Native Skills
Key Point VLM 에이전트가 기하학적 정보를 보존한 시각 기반 스킬을 동적으로 습득·활용하는 새로운 강화 학습 방법으로, 정책과 스킬의 상호 개선 메커니즘이 기존 텍스트 중심 방식의 한계를 직접 해결한다.
핵심 요약
기존 스킬 강화 에이전트는 대부분 텍스트 중심으로 공간 레이아웃과 행동-상태 대응을 언어로 변환하면서 기하학적 구조 정보를 손실한다. ViSkill은 성공한 상호작용을 시각 정보 중심의 '스킬 카드'로 인코딩하여 VLM 에이전트가 직접 활용하는 방식을 제안한다. 검색된 스킬은 추론과 보상 형성을 모두 가이드하고, 성공한 궤적이 다시 스킬 라이브러리로 증류되어 닫힌 피드백 루프를 형성한다. 전체 요약 6문장 읽기 → 060 03:11 ▲ 230 · 댓글 48 Python 3.15 정식 출시, JIT 컴파일러와 새로운 내장 타입 추가 Python 3.15.0이 2026년 10월 9일 정식 출시되었으며, 1,012명의 기여자로부터 5,643개 커밋이 포함되었다. 오픈소스 · 도구 · Python 3.15
Key Point 인터프리터 성능 개선, 새로운 언어 기능, 타입 시스템 확장이 파이썬 개발자의 생산성과 코드 안정성에 직접적인 영향을 미친다.
핵심 요약
Python 3.15.0이 2026년 10월 9일 정식 출시되었으며, 1,012명의 기여자로부터 5,643개 커밋이 포함되었다. 새로운 내장 타입으로 sentinel 타입과 frozendict가 추가되었고, 명시적 지연 import(PEP 810)로 시작 시간을 단축했다. 실험적 JIT 컴파일러가 대폭 개선되어 x86-64 Linux에서 표준 인터프리터 대비 7~8%, AArch64 macOS에서 11~12% 성능 향상을 달성했다. 전체 요약 10문장 읽기 → 061 18:11 ▲ 18 · 댓글 2 LLM이 3D 로봇 부품 설계 자동화, 불완전한 모델도 복원 시뮬레이션에서 학습한 로봇 조작 정책을 현실 물체에 적용하려면 기하학적으로 정확한 관절형 3D 자산이 필수인데, 기존 메시 기반 방법은 학습 데이터 분포 밖의 물체나 손상된 메시에서 관절 정보 추론에 실패하곤 한다. AI · 머신러닝 · USDCraft: Geometrically Grounded Programmatic Modeling of Articulated 3D Assets for Simulation
Key Point 불완전하거나 손상된 3D 모델에서도 로봇 시뮬레이션용 정확한 관절 정보를 자동으로 복원할 수 있어, 현실의 다양한 물체로 로봇 학습을 확장하는 병목이 해결된다.
핵심 요약
시뮬레이션에서 학습한 로봇 조작 정책을 현실 물체에 적용하려면 기하학적으로 정확한 관절형 3D 자산이 필수인데, 기존 메시 기반 방법은 학습 데이터 분포 밖의 물체나 손상된 메시에서 관절 정보 추론에 실패하곤 한다. USDCraft는 사전학습된 LLM이 부분적 기하 정보를 바탕으로 시뮬레이션 준비가 된 관절형 자산을 위한 프로그램을 작성·수정하도록 하는 프레임워크로, 작업별 파인튜닝이 필요 없다. 기하 소스 분석으로 메시를 관찰된 표면과 미지 공간을 구분하는 텍스트 설명으로 변환하고, 반복적 기하 재검증으로 각 프로그램 후보를 같은 형식으로 재인코딩해 불일치 지점을 찾아낸다. 전체 요약 5문장 읽기 → 062 18:11 ▲ 18 · 댓글 2 캔버스 지시로 이미지 편집하는 VibeEdit 텍스트 기반 이미지 편집에서 변경 내용을 설명하기는 쉽지만 대상 객체나 영역을 명확히 지정하기는 어려운데, 특히 비슷해 보이는 객체가 여럿 있을 때 그렇다. AI · 머신러닝 · VibeEdit: Image Editing with Canvas Instructions
Key Point 유사한 객체 여럿 중에서 정확히 어떤 것을 편집할지 지정하는 문제를 시각적 주석으로 해결하면서 성능 지표에서 기존 방식을 크게 앞선다.
핵심 요약
텍스트 기반 이미지 편집에서 변경 내용을 설명하기는 쉽지만 대상 객체나 영역을 명확히 지정하기는 어려운데, 특히 비슷해 보이는 객체가 여럿 있을 때 그렇다. VibeEdit는 사용자가 이미지에 직접 공간적 표시와 선택적 짧은 메모를 남기는 새로운 편집 인터페이스를 제공하며, 이 주석들이 함께 캔버스 지시를 형성한다. 별도 텍스트 프롬프트 없이 객체 추가, 제거, 교체, 속성 수정, 이동 등을 수행한다. 전체 요약 8문장 읽기 → 063 18:11 ▲ 24 · 댓글 2 시각 정보로 깊이 있는 조사를 하는 AI 에이전트 OneSearch-VL 이미지·동영상 등 다양한 시각 자료를 사용한 깊이 있는 조사 작업을 통합으로 처리하는 멀티모달 AI 에이전트 OneSearch-VL을 발표했다. AI · 머신러닝 · OneSearch-VL: Unified Multimodal Deep Research Agent for Image and Video
Key Point 시각 정보를 활용한 복잡한 조사 작업을 자동화하는 에이전트 기술의 새로운 접근법이며, 이미지와 동영상을 다루는 멀티모달 AI의 핵심 과제인 시각적 근거 추적을 해결했다.
핵심 요약
이미지·동영상 등 다양한 시각 자료를 사용한 깊이 있는 조사 작업을 통합으로 처리하는 멀티모달 AI 에이전트 OneSearch-VL을 발표했다. 시각적 위치 파악, 외부 검색, 사실 종합이라는 공통 워크플로우를 따르지만, 단일 이미지·다중 이미지·동영상마다 다른 시각 연산이 필요한 문제를 해결한다. 핵심은 시각적으로 위치를 파악한 근거 그래프(VGEG)로, 시각 앵커·개체 관계·출처 기반 사실·연산 작업 간의 의존성을 인코딩해 데이터 구성·과정 감시·연산 평가에 공통으로 쓸 수 있게 했다. 전체 요약 7문장 읽기 → 064 15:13 ▲ 189 · 댓글 82 $2 ESP32-C3로 PSRAM 없이 Pi-hole 수준의 광고 차단 14만 개 이상의 도메인을 0.7MB 플래시 저장소에 40비트 해시로 저장하고 이진 검색으로 ~10ms에 매칭하는 DNS 광고 차단 프로젝트. 하드웨어 · 시스템 · ESP32-C3 Adblock
Key Point 값싼 마이크로컨트롤러로 PSRAM 비용 없이 대규모 차단 목록을 관리하는 해시 기반 최적화 기법이 실제로 작동하며, 가정용 DNS 차단 서버의 진입장벽을 크게 낮춤.
핵심 요약
14만 개 이상의 도메인을 0.7MB 플래시 저장소에 40비트 해시로 저장하고 이진 검색으로 ~10ms에 매칭하는 DNS 광고 차단 프로젝트. 기존 ESP32 광고 차단기는 차단 목록을 RAM에 올려야 해서 비싼 PSRAM이 필요하지만, 이 프로젝트는 도메인 문자열 대신 5바이트 고정 길이 해시를 플래시에 저장해 ~50KB RAM만 사용. 40비트 크기는 목표 플래시 용량에서 충돌을 최소화하는 최적값으로, 14만 도메인에서 충돌 거의 없고 53만 7천 도메인에서도 1건만 발생. 전체 요약 13문장 읽기 → 065 12:11 ▲ 226 · 댓글 3 가상 세계에서 코드로 에이전트를 진화시키는 AgentGarten AgentGarten은 시뮬레이터·게임 엔진과 신경 렌더러를 결합하여 실시간 상호작용 환경을 구축하는 프레임워크다. AI · 머신러닝 · AgentGarten: Code Worlds for Evolving Agents
Key Point 기존 강화학습은 수백만 번의 상호작용이 필요하지만 AgentGarten은 4라운드만으로 에이전트를 학습시키므로, AI 에이전트의 훈련 효율을 획기적으로 높이는 방법론이다.
핵심 요약
AgentGarten은 시뮬레이터·게임 엔진과 신경 렌더러를 결합하여 실시간 상호작용 환경을 구축하는 프레임워크다. 시뮬레이션 백엔드는 지속적인 월드 상태를 유지하고 프로그램 정의 규칙을 실행하며, 렌더러는 공통 인터페이스를 통해 구조화된 조건으로부터 시각 관찰을 생성한다. 신경 렌더러는 사전학습된 비디오 모델을 기하학 조건에 맞춰 적응시키고, 제안된 Adversarial Forcing으로 증류하며, 실시간 상호작용을 위해 추론을 최적화한다. 전체 요약 7문장 읽기 → 066 12:11 ▲ 116 · 댓글 35 프로그램 상태를 터미널에 직접 보내는 OSC 7501 스펙 공개 Mitchell Hashimoto가 새로운 터미널 이스케이프 시퀀스 OSC 7501(Program Status Protocol) 스펙을 발표했다. 기타 · A Terminal Protocol for Program Status (OSC 7501)
Key Point 터미널에서 돌아가는 장시간 작업(빌드, 배포, AI 에이전트)의 상태를 프로토콜로 표준화함으로써, 창 제목이나 화면 내용을 추측하는 비효율을 없앨 수 있게 된다.
핵심 요약
Mitchell Hashimoto가 새로운 터미널 이스케이프 시퀀스 OSC 7501(Program Status Protocol) 스펙을 발표했다. 프로그램이 현재 상태(idle, working, blocked, done, error)와 이유를 터미널에 직접 전송할 수 있게 하는 프로토콜이다. 기존 방식은 창 제목 읽기·정규식 패턴 매칭(Herdr 예시: Claude Code 상태 감지에만 3개월간 10번 수정) 또는 socket API 같은 비표준 연동에 의존했다. 전체 요약 9문장 읽기 → 067 21:11 ▲ 20 · 댓글 2 카메라 기하학 조건으로 다중 시점 이미지 합성 3배 가속 소수의 2D 이미지로부터 3D 콘텐츠를 생성하는 '희소 시점 신규 시점 합성' 문제를 해결하는 NAMVIS 프레임워크를 제안했다. AI · 머신러닝 · NAMVIS: Next-Scale Autoregressive Multi-View Image Synthesis
Key Point 3D 콘텐츠 제작에 필수적인 다중 시점 생성을 기존 방식보다 3배 빠르고 더 정확하게 처리하는 기술이 등장했기 때문이다.
핵심 요약
소수의 2D 이미지로부터 3D 콘텐츠를 생성하는 '희소 시점 신규 시점 합성' 문제를 해결하는 NAMVIS 프레임워크를 제안했다. 기존 확산 모델의 반복적 잡음 제거 대신, 이산 시각 토큰을 단계별로 예측하고 모든 토큰을 병렬로 샘플링하는 자동회귀 방식을 사용한다. 멀티스케일 프로젝티브 포즈 인코딩이라는 기법으로 소스·타겟 카메라의 기하학적 변환 정보를 모든 해상도의 셀프-어텐션과 크로스-어텐션에 주입한다. 전체 요약 6문장 읽기 → 068 18:30 ▲ 53 · 댓글 3 시각·언어·행동을 통합한 로봇 모델 UniWAM, 다중 작업에서 최고 성능 달성 비전-언어-행동 모델과 월드-액션 모델의 장점을 결합한 통합 아키텍처 UniWAM을 제안했다. AI · 머신러닝 · UniWAM: Unified World-Action Model
Key Point 로봇 학습에서 시각 이해와 행동 예측을 한 모델로 통합하는 접근법이 어떻게 작동하는지, 그리고 인간 데이터와 로봇 데이터를 함께 사용했을 때의 스케일링 효과를 보여주는 연구로, 구체화된 AI 시스템의 확장성을 이해하는 데 도움이 된다.
핵심 요약
비전-언어-행동 모델과 월드-액션 모델의 장점을 결합한 통합 아키텍처 UniWAM을 제안했다. 물리 추론기, 월드 생성기, 액션 예측기를 하나로 통합해 의미론적 이해, 시각 생성, 행동 예측을 동시에 학습한다. 저수준 행동을 자연언어로 표현하고, VQA 데이터·인간 이고센트릭 영상·로봇 시연으로 사전학습한다. 전체 요약 8문장 읽기 → 069 18:30 ▲ 94 · 댓글 2 로봇 실시간 제어, 영상 메모리 19초 활용하면 성공률 63→79% 로봇의 실시간 제어에는 충분한 영상 히스토리가 필요하지만, 이를 처리하는 과정에서 지연이 발생한다. AI · 머신러닝 · Long-WAM: Scaling the Context of World-Action Models
Key Point 로봇 제어에서 짧은 지연(107ms)로 19초 영상 메모리를 활용하면서 복잡한 조작 작업에서 대폭 높은 성공률을 달성한 실시간 배포 기술이기 때문이다.
핵심 요약
로봇의 실시간 제어에는 충분한 영상 히스토리가 필요하지만, 이를 처리하는 과정에서 지연이 발생한다. Long-WAM은 실시간 제어 제약 속에서 인과적 세계-행동 모델의 맥락을 확장하기 위한 모델-시스템 프레임워크이다. 핵심 발견: 긴 히스토리에 접근하는 것과 실제로 사용하는 것은 다르며, 비디오 기초 모델이 자기회귀(AR) 방식으로 사전학습될 때 더 큰 이득이 난다. 전체 요약 12문장 읽기 → 070 18:30 ▲ 145 · 댓글 29 증명 없이 정답만 던지던 수학 천재 'Cleo'의 정체 2013~2015년 스택 익스체인지 수학 포럼에서 Cleo라는 계정이 39개의 복잡한 적분 문제에 완벽한 답을 제시했지만 풀이 과정은 전혀 보여주지 않았다. 기타 · Cleo (Mathematician)
Key Point Stack Exchange에서 최고의 수학 천재로 추앙받던 정체 불명의 계정이 실은 우즈베키스탄 소프트웨어 개발자의 창작 페르소나였다는 온라인 미스터리의 전말을 한 번에 파악할 수 있습니다.
핵심 요약
2013~2015년 스택 익스체인지 수학 포럼에서 Cleo라는 계정이 39개의 복잡한 적분 문제에 완벽한 답을 제시했지만 풀이 과정은 전혀 보여주지 않았다. 첫 주목받은 것은 2013년 11월 Mathematica와 Maple도 풀지 못한 복잡한 적분을 4시간 반 만에 '황금비를 이용한 답'으로 제시했을 때였다. 수학 커뮤니티는 Cleo가 천재 수학자인지, 여러 사람의 집단 계정인지 논쟁했고, Terence Tao나 Maryam Mirzakhani 같은 유명 수학자가 아닐까 추측했다. 전체 요약 9문장 읽기 → 071 18:33 새 버전 Transformers 5.19.0, 멀티모달 임베딩과 분산학습 기능 강화 Gemma 2의 멀티모달 임베딩 모델 EmbeddingGemma2를 새로 추가했으며, 텍스트·이미지·오디오·비디오를 768차원 벡터 공간에 인코딩하고 512/256/128차원으로 축소 가능하다. AI · 머신러닝 · huggingface/transformers@v5.19.0
Key Point 멀티모달 모델 지원 확대와 분산학습 병렬화 개선으로 LLM 추론 효율이 향상되며, 주요 API 변경으로 기존 코드 마이그레이션이 필요해진다.
핵심 요약
Gemma 2의 멀티모달 임베딩 모델 EmbeddingGemma2를 새로 추가했으며, 텍스트·이미지·오디오·비디오를 768차원 벡터 공간에 인코딩하고 512/256/128차원으로 축소 가능하다. MoE(Mixture of Experts) 모델이 output_router_logits=True일 때 라우터 로짓을 반환하도록 변경되었으며, 기존 코드는 새 출력 클래스에서 로짓을 읽어야 한다. OWLv2 이미지 쿼리 선택 방식이 객체 신뢰도 점수 기준으로 변경되어 기존 기능과 결과가 달라질 수 있다. 전체 요약 7문장 읽기 → 072 18:33 ▲ 10 · 댓글 1 LLM이 숨겨진 공간에서 추론하는 법, Flow Matching으로 풀다 LLM이 연속 공간에서 사고하고 최종 답만 출력하는 잠재 추론(Latent Reasoning)에서 효과적인 잠재 사고는 5가지 조건을 만족해야 한다. AI · 머신러닝 · What Matters for Latent Reasoning with Flow Matching
Key Point LLM이 내부에서 복잡한 추론을 수행하면서도 빠른 속도를 유지하는 새로운 방식의 설계 원칙을 제시해, 추론 효율성과 성능의 트레이드오프를 다루는 핵심 기준이 될 수 있습니다.
핵심 요약
LLM이 연속 공간에서 사고하고 최종 답만 출력하는 잠재 추론(Latent Reasoning)에서 효과적인 잠재 사고는 5가지 조건을 만족해야 한다. 유용성: 올바른 답을 생성하되 단순히 바꾸지 않아야 함, 다양성: 재샘플링으로 다른 추론 경로가 나와야 함, 설명성: 디코딩한 사고의 연쇄(CoT)가 실제 추론을 반영해야 함, 개선성: 추론 계산을 늘려 성능을 높일 수 있어야 함, 효율성: 명시적 CoT 대비 비슷한 정확도에서 낮은 지연시간을 가져야 함. 기존 방법들은 이 요구사항을 거의 충족하지 못하는데, 질문에서 지름길을 배우거나 명시적 CoT를 가중치로 증류하거나 토큰 단위로 모방하는 문제가 있다. 전체 요약 7문장 읽기 → 073 18:33 ▲ 21 · 댓글 2 단일 모델로 검색과 장문맥 처리 통합하는 UNREAL 말뭉치 검색(RAG)과 장문맥 추론은 증거 선택을 서로 다른 규모로 처리하는데, 이를 통일할 수 있는지 묻는 논문이다. AI · 머신러닝 · UNREAL: Unifying Retrieval and Long-Context with a Single Model
Key Point 대규모 언어모델의 검색과 장문맥 처리라는 두 가지 핵심 문제를 하나의 메커니즘으로 해결하는 새로운 접근으로, 생성 효율성과 정확도를 동시에 개선하는 경로를 제시한다.
핵심 요약
말뭉치 검색(RAG)과 장문맥 추론은 증거 선택을 서로 다른 규모로 처리하는데, 이를 통일할 수 있는지 묻는 논문이다. UNREAL은 LLM의 내부 표현에서 청크를 인코딩하고 검색 쿼리를 직접 도출하는 모델 내재 증거 선택 프레임워크다. 500K개 미만의 학습 가능 파라미터를 추가하며 기본 LLM은 수정하지 않는다. 전체 요약 9문장 읽기 → 074 18:33 ▲ 316 · 댓글 136 Gleam이 Erlang 소스코드 대신 추상 형태로 컴파일하도록 전환 Gleam v1.19.0 릴리스에서 Erlang 코드 생성기를 완전 재작성하여 Erlang 소스코드 대신 Erlang 추상 형태(abstract forms, 중간 표현)로 컴파일하도록 변경했다. 오픈소스 · 도구 · Gleam doesn't compile to Erlang source anymore
Key Point Erlang 추상 형태 컴파일로 빌드 성능이 크게 향상되고 스택 트레이스 정확도가 개선되었으며, JavaScript와 TypeScript 최적화, 에러 메시지 강화, 다른 빌드 도구 통합 개선 등이 Gleam 개발 경험 전반을 크게 나아지게 한다.
핵심 요약
Gleam v1.19.0 릴리스에서 Erlang 코드 생성기를 완전 재작성하여 Erlang 소스코드 대신 Erlang 추상 형태(abstract forms, 중간 표현)로 컴파일하도록 변경했다. 추상 형태는 Erlang 컴파일러가 사용하는 메타데이터 주석이 달린 트리로, 이진 인코딩으로 직접 로드되어 Erlang 컴파일러의 전반부를 건너뛸 수 있다. 이 변경으로 컴파일러 성능이 크게 향상되어 빌드 시간이 대폭 단축되었으며, v1.17.0 대비 v1.19.0에서 벤치마크 프로젝트 컴파일 시간이 상당히 개선됐다. 전체 요약 14문장 읽기 → 075 09:11 ▲ 14 · 댓글 1 Minkowski 기하학으로 시공간 패턴을 명시적으로 학습하는 신경망 인코딩 물리 시뮬레이션과 비디오 예측에서 시간과 공간의 결합 구조를 모델링하는 것이 핵심 과제다. AI · 머신러닝 · MinkowskiPE: Minkowski Positional Encoding for Spatiotemporal Perception
Key Point 시공간 결합을 기하학적 불변량으로 명시적으로 모델링하면서도 표준 어텐션과 호환되는 새로운 인코딩이 다양한 스케일의 물리 지능 구축에 어떻게 기여하는지 보여준다.
핵심 요약
물리 시뮬레이션과 비디오 예측에서 시간과 공간의 결합 구조를 모델링하는 것이 핵심 과제다. 기존 접근법은 물리 법칙 기반이면 강한 사전지식을 제공하지만 유연성이 제한되고, 학습 기반은 유연하지만 시공간 결합을 대부분 암묵적으로만 처리한다. MinkowskiPE는 시간과 공간 좌표를 결합하여 Lorentz 변환을 query·key 특성에 적용하는 방식으로, 위치에 관한 어텐션 점수를 두 토큰 간의 상대적 시공간 변위에만 의존하게 만든다. 전체 요약 5문장 읽기 → 076 06:11 ▲ 141 · 댓글 66 평문, 50년 이상 읽을 수 있는 기술 평문(plain text)은 특정 응용 프로그램 없이도 읽고 편집할 수 있는 가장 기본적인 컴퓨터 파일 형식으로, 50년 이상 유지될 가능성이 높다. 웹 · 프론트엔드 · Plain text is still one of the best technologies we have
Key Point 많은 개발자가 클라우드, 구독 서비스에 데이터가 종속되는 현실에서, 평문의 장점을 재평가하고 언제 단순한 형식으로 충분한지 판단할 필요가 있기 때문이다.
핵심 요약
평문(plain text)은 특정 응용 프로그램 없이도 읽고 편집할 수 있는 가장 기본적인 컴퓨터 파일 형식으로, 50년 이상 유지될 가능성이 높다. 유니코드 표준에 따르면 평문은 글꼴, 색상, 레이아웃 같은 서식 정보 없이 문자 코드의 연속일 뿐이며, 이 단순함이 오래 지속된 주요 이유다. 소스 코드, 설정 파일, 로그, HTML, JSON, CSS 등 컴퓨팅의 기본 인프라 대부분이 평문을 기반으로 하며, 텍스트 에디터에서도 내용을 직접 검사하고 수정할 수 있다. 전체 요약 9문장 읽기 → 077 06:11 ▲ 111 · 댓글 22 Haskell로 GTK4 할일 앱 만들기, 기초부터 Haskell, GTK 4, Adwaita 라이브러리를 이용해 할일 목록 애플리케이션을 만드는 튜토리얼의 첫 번째 파트다. 웹 · 프론트엔드 · Making a GTK application in Haskell, part 1
Key Point Haskell에서 GTK 애플리케이션을 구축하기 위한 구체적인 아키텍처와 구현 방식을 학습할 수 있으며, Elm Architecture를 실제 GUI 프로젝트에 어떻게 적용하는지 보여준다.
핵심 요약
Haskell, GTK 4, Adwaita 라이브러리를 이용해 할일 목록 애플리케이션을 만드는 튜토리얼의 첫 번째 파트다. Adwaita는 GNOME 프로젝트의 디자인 언어로, 접근성과 스타일 가이드(HIG)가 인코딩되어 있으며 라이트/다크 테마 전환에 따라 자동 리컬러링되는 반응형 설계를 지원한다. haskell-gi 도구킷을 사용하여 GTK 라이브러리에서 Haskell 바인딩을 자동 생성하고 C API와 유사한 Haskell 인터페이스를 제공한다. 전체 요약 10문장 읽기 → 078 15:11 ▲ 44 · 댓글 3 비디오가 물리 법칙을 얼마나 잘 이해하나 측정하는 벤치마크 물리 현상을 정확히 표현하는 비디오 생성 모델을 평가하기 위해 World Embedding Benchmark를 공개했다. AI · 머신러닝 · World Embedding Benchmark
Key Point 비디오 생성의 물리적 정확성을 평가하는 첫 벤치마크로, 현재 AI 모델들의 물리 이해도를 측정하고 개선 방향을 보여준다.
핵심 요약
물리 현상을 정확히 표현하는 비디오 생성 모델을 평가하기 위해 World Embedding Benchmark를 공개했다. 유체역학, 고체역학, 동역학, 광학·전자기학 등 80개 종류에서 8,000개의 시뮬레이션 영상을 수집하고, 각 영상에 시뮬레이션 기반의 물리 주석을 달았다. 텍스트-영상 검색, 물리적 성질 회귀, 다중선택 분류라는 세 가지 평가 작업으로 영상 임베딩이 물리 정보를 얼마나 잘 인코딩하는지 측정한다. 전체 요약 7문장 읽기 → 079 06:11 ▲ 31 · 댓글 2 고해상도 3D 생성 비용 58% 줄인 위상 보존 기법 SILSA 고해상도 3D 모델 생성에서 기존 복셀 토큰 방식은 연속 표면을 많은 로컬 토큰으로 분할해 비용이 크고 얇거나 복잡하게 연결된 형태의 위상 일관성이 약하다. AI · 머신러닝 · SILSA: Sliding-Window Slice Latents for Topology-Preserving High-Resolution 3D Generation
Key Point 기존 3D 생성의 계산 병목을 슬라이싱 윈도우 방식으로 획기적으로 줄이면서 위상 일관성도 높인 구조이므로, 3D 생성 모델을 개발하거나 최적화하려는 개발자에게 실질적인 대안을 제시한다.
핵심 요약
고해상도 3D 모델 생성에서 기존 복셀 토큰 방식은 연속 표면을 많은 로컬 토큰으로 분할해 비용이 크고 얇거나 복잡하게 연결된 형태의 위상 일관성이 약하다. SILSA는 슬라이싱 윈도우로 3개 축(x·y·z)을 따라 겹치는 슬라이스 집합으로 모양을 표현해 이 문제를 해결하는 방식이다. 각 토큰이 로컬 깊이 윈도우를 요약해 단면 연속성을 유지하고 단일 단계 생성을 지원한다. 전체 요약 8문장 읽기 → 080 12:11 ▲ 49 · 댓글 2 확산형 언어모델을 위한 텍스트 임베딩 최적화 자기회귀 모델의 대안으로 주목받는 확산 언어모델(DLM)은 연속 텍스트 임베딩의 잠재공간에서 생성을 수행한다. AI · 머신러닝 · Scaling and Distilling Text Embeddings for Better Diffusibility
Key Point 확산형 언어모델이 자기회귀 방식의 성능에 접근하기 위해서는 어떤 임베딩 공간이 최적인지 밝혀지지 않았는데, 이 연구가 스케일링과 증류 기법으로 그 해답을 제시한다.
핵심 요약
자기회귀 모델의 대안으로 주목받는 확산 언어모델(DLM)은 연속 텍스트 임베딩의 잠재공간에서 생성을 수행한다. 연구팀은 T5 계열 임베딩을 T5Gemma-1, T5Gemma-2로 확대했을 때 생성 성능이 크게 향상됨을 발견했다. 그러나 T5Gemma-2는 너무 판별력이 강해서 유사한 단어들의 임베딩까지 멀리 떨어져 있어, 샘플링 오류 시 유효한 임베딩을 찾지 못하는 문제가 발생한다. 전체 요약 7문장 읽기 → 081 06:11 ▲ 13 · 댓글 2 문항반응이론으로 루브릭 보상 설계 언어 작업은 자동 검증이 어려워 여러 기준으로 평가하는 루브릭을 사용하는데, 기존 방식은 기준별 점수를 단순합산한다. AI · 머신러닝 · Rubric Rewards from Item Response Theory
Key Point 강화학습에서 복합적인 평가 기준을 다룰 때 더 효율적이고 차별화된 보상 신호를 만드는 새로운 이론 및 실제 방법론을 제시한다.
핵심 요약
언어 작업은 자동 검증이 어려워 여러 기준으로 평가하는 루브릭을 사용하는데, 기존 방식은 기준별 점수를 단순합산한다. 단순합산은 다른 평가 패턴이 같은 보상을 받고, 각 기준의 중요도를 고정값으로 인코딩해 판별력을 반영하지 못한다. 강화학습에서 평가 기준이 증가하면 판정자 요청이 선형으로 늘어나는 한계도 있다. 전체 요약 11문장 읽기 → 082 21:11 새 버전 Vite 8.3.2 릴리스, 빌드와 서버 안정성 개선 Vite 8.3.2가 릴리스되었으며 13개의 버그 수정과 3개의 성능 개선을 포함한다. 웹 · 프론트엔드 · vitejs/vite@v8.3.2
Key Point 개발 서버의 크래시 방지와 CSS 프리로드 처리 개선으로 로컬 개발 경험이 더 안정적이 되며, 빌드 성능 최적화는 대규모 프로젝트의 빌드 시간 단축에 직결된다.
핵심 요약
Vite 8.3.2가 릴리스되었으며 13개의 버그 수정과 3개의 성능 개선을 포함한다. CSS 프리로드 시 쿼리가 있는 URL 처리 개선, Rolldown 런타임 제공 방식 변경, HTML srcset URL의 퍼센트 인코딩 해석 등의 빌드 관련 수정사항이 있다. 개발 서버에서 파일 감시자 에러로 인한 크래시 방지, 레이지 청크 소스맵 제공, 환경 초기화 후 메모리 해제 등 안정성이 강화되었다. 전체 요약 6문장 읽기 → 083 18:11 ▲ 68 · 댓글 3 LLM 에이전트의 숨은 세계 모델을 끌어내는 훈련법 LLM 기반 에이전트는 다중 단계 의사결정에 점점 더 활용되지만 미지의 환경으로의 전이가 좋지 않다. AI · 머신러닝 · EVOKE: Eliciting World Knowledge in Agents for Transferable Decision-Making
Key Point LLM 에이전트가 새로운 환경에 적응하지 못하는 근본 원인을 진단하고, 추가 훈련 없이 기존 지식을 활용하는 훈련 기법을 제안하는 것이 개발자들의 실제 배포 문제를 해결하기 때문입니다.
핵심 요약
LLM 기반 에이전트는 다중 단계 의사결정에 점점 더 활용되지만 미지의 환경으로의 전이가 좋지 않다. 기존 세계 모델 학습 방식은 미래 관찰을 예측하도록 훈련하지만 추가 학습 비용이 들고 예측 오류가 누적된다. 디지털 환경에서 작동하는 LLM 에이전트는 사전 훈련 과정에서 이미 상당한 세계 지식을 내재화하고 있어, 새로 습득하기보다 끌어내는 것이 핵심이다. 전체 요약 9문장 읽기 → 084 12:11 ▲ 276 · 댓글 3 강화학습 모델을 학생 모델에 가르치는 새로운 방식, 표현층에서 직접 학습 기존 온-폴리시 디스틸레이션(OPD)은 학생 모델이 자신의 궤적 위에서 교사의 다음 토큰 분포를 모방하도록 훈련하며, 출력 공간에서 암묵적 보상을 외삽하여 교사를 능가하게 할 수 있다. AI · 머신러닝 · The Teacher Is a Direction, Not a Destination: Extrapolating RL-Induced Representation Residuals in On-Policy Distillation
Key Point 모델 증류에서 강화학습의 효과를 더 효율적으로 전달하는 새로운 방법이 제시되어, 더 작은 모델로도 큰 모델 수준의 성능을 얻을 수 있는 경로를 열어준다.
핵심 요약
기존 온-폴리시 디스틸레이션(OPD)은 학생 모델이 자신의 궤적 위에서 교사의 다음 토큰 분포를 모방하도록 훈련하며, 출력 공간에서 암묵적 보상을 외삽하여 교사를 능가하게 할 수 있다. 그러나 언어모델 헤드는 이 변화를 비등방적으로 감쇠시키며, 교사 은닉층에 인코딩된 대부분의 변화가 로짓에는 작은 가중치로만 도달하고, 출력 공간 외삽이 의존하는 샘플 토큰 로그확률 비율은 훈련 불안정성을 초래하는 노이즈를 증폭시킨다. 연구진은 강화학습이 모델의 내부 표현을 기본 체크포인트에서 변화시키고, 이 변화의 방향을 모든 층에서 측정할 수 있음을 관찰했다. 전체 요약 7문장 읽기 → 085 09:11 ▲ 12 · 댓글 2 중국어 의사결정형 AI 모델 'Chinese-Jev' 공개 System One 모델인 Jev를 중국어 작업에 맞게 개선한 Chinese-Jev를 공개했다. AI · 머신러닝 · Chinese-Jev: Bringing System One Model to Chinese-Language Tasks
Key Point 생성형 LLM 중심의 AI 개발 흐름에서 빠른 의사결정 작업에 특화된 System One 모델의 필요성이 증대되고 있으며, 중국어 처리 시 모바일 기기까지 효율적으로 배포할 수 있는 구체적 솔루션이 제시되었다.
핵심 요약
System One 모델인 Jev를 중국어 작업에 맞게 개선한 Chinese-Jev를 공개했다. 기존 Jev 모델이 중국어 의사결정 정확도에서 제한이 있었기에, 통합 데이터 처리 및 학습 파이프라인으로 이를 보완했다. 이질적인 중국어 주석을 후보 선택지별 확률로 변환하는 데이터 처리 프로토콜을 개발해 도메인과 질문 형식 간 학습을 통일했다. 전체 요약 8문장 읽기 → 086 06:11 ▲ 13 · 댓글 2 밀집 검색, 공유 vs 독립 투영 선택 기준을 이론으로 증명 Dense retrieval의 쿼리-문서 투영 방식 선택에 관한 이론적 기초를 제시한 논문으로, 저차원 이중선형 스코어링의 편향-분산 이론을 도입했다. AI · 머신러닝 · When Does Dense Retrieval Need Asymmetric Geometry? A Bias-Variance Theory of Shared and Dual Projections
Key Point Dense retrieval 시스템에서 쿼리-문서 인코딩을 공유할지 독립적으로 설계할지 선택하는 문제에 처음으로 엄밀한 이론적 기준을 제시해, 실무 설계 결정의 근거를 제공한다.
핵심 요약
Dense retrieval의 쿼리-문서 투영 방식 선택에 관한 이론적 기초를 제시한 논문으로, 저차원 이중선형 스코어링의 편향-분산 이론을 도입했다. 공유 투영(Shared)은 양의 준정치 연산자를 생성하고 독립 투영(Dual)은 임의의 저차원 연산자를 실현하는 구조적 차이가 있다. 정확한 근사 오차를 유도했으며, 제곱 방향신호가 추가 자유도의 추정 비용을 초과할 때만 독립 투영이 더 낮은 리스크를 갖는다는 국소 가우시안 경계를 증명했다. 전체 요약 8문장 읽기 → 087 03:11 새 버전 Transformers 5.18.0 출시, Nemotron·NemotronH Omni 등 신모델 추가 Nemotron 3 Diarization 오픈웨이트 모델이 추가되어 실시간 음성 화자 분리를 지원하며, 최대 8명의 화자를 처리할 수 있고 80ms부터 30.4s까지 구성 가능한 지연 시간 프로필을 제공한다. AI · 머신러닝 · huggingface/transformers@v5.18.0
Key Point Transformers는 파이토치의 표준 NLP 라이브러리이며, 이 버전은 실시간 음성 처리, 멀티모달 추론, 분산 학습 최적화 등 프로덕션 환경의 여러 문제를 해결한다.
핵심 요약
Nemotron 3 Diarization 오픈웨이트 모델이 추가되어 실시간 음성 화자 분리를 지원하며, 최대 8명의 화자를 처리할 수 있고 80ms부터 30.4s까지 구성 가능한 지연 시간 프로필을 제공한다. NemotronH Omni 멀티모달 추론 모델은 Mamba-Transformer 언어 모델에 RADIO 비전 인코더와 Parakeet 사운드 인코더를 결합하여 텍스트, 이미지, 비디오, 음성을 동시에 처리한다. HyperCLOVAX Vision V2는 NAVER가 개발한 멀티모달 모델로 Qwen2.5-VL 비전 인코더를 탑재하고 체인오브싱크 추론을 위한 thinking 토큰을 지원한다. 전체 요약 8문장 읽기 → 088 15:11 ▲ 91 · 댓글 2 로봇, 코드로 배우고 스스로 진화한다 기존 VLA(비전-언어-동작)·WAM(세계-동작) 모델은 관찰과 지시를 직접 로봇 동작으로 변환하지만, 레이아웃이나 시점이 조금 바뀌어도 실패하고 지시 일반화가 떨어진다. AI · 머신러닝 · Self-Evolving Coding Agents: From Digital Programs to Physical-World Intelligence
Key Point 로봇이 코드로 작업 상태를 표현하고 실행 과정을 수정하도록 하면, 환경 변화에 더 탄력적으로 대응하고 장기 작업도 완수할 수 있다는 새로운 접근법을 제시한다.
핵심 요약
기존 VLA(비전-언어-동작)·WAM(세계-동작) 모델은 관찰과 지시를 직접 로봇 동작으로 변환하지만, 레이아웃이나 시점이 조금 바뀌어도 실패하고 지시 일반화가 떨어진다. 근본 원인은 표현 방식에 있다: 작업 요구사항·조건·진행·실패 복구가 동작 수열에 암묵적으로 인코딩돼 검사하거나 수정하기 어렵다. 논문은 디지털 코딩 에이전트의 방식을 물리 로봇에 적용하는 'Physical Coding'을 제안한다: LLM이 도구를 호출하고 결과를 검증한 뒤 피드백으로 실행 가능한 코드를 수정하는 방식이다. 전체 요약 8문장 읽기 → 089 09:11 새 버전 uv 0.12.20 릴리스, 락파일 재사용·메타데이터 빌드 개선 Python 패키지 관리 도구 uv 0.12.20이 2026년 9월 28일 공개되었다. 오픈소스 · 도구 · astral-sh/uv@0.12.20
Key Point Python 의존성 해석과 설치를 담당하는 핵심 도구의 안정성 개선으로, 특히 복잡한 워크스페이스·반복 의존성·크로스 플랫폼 환경에서 버그가 수정되었다.
핵심 요약
Python 패키지 관리 도구 uv 0.12.20이 2026년 9월 28일 공개되었다. 의존성 선언이 의미상 동일하면 락파일을 재사용하고, CRLF 셔뱅을 가진 wheel 스크립트 설치 시 두 번째 줄 인코딩 선언을 보존한다. preview 기능으로 정규화된 요구사항 선언을 락파일에 작성하며, 첫 번째 파티 워크스페이스 프로젝트의 메타데이터 빌드를 --no-build 플래그 아래서도 허용한다. 전체 요약 9문장 읽기 → 090 00:11 ▲ 100 · 댓글 37 생명, 양자가 아닌 '양자같은 수학'으로 작동한다 과학자들은 수십 년간 생명과 양자역학을 연결하려 시도했지만 실패해왔고, 새로운 관점은 수학적 동등성에 있을 수 있다. AI · 머신러닝 · Biology might not be quantum, but its math is quantumlike
Key Point 실제 양자 효과 없이 '양자같은' 수학이 고전적 생물 시스템에서 나타날 수 있다는 발견은 양자생물학의 근본적 가정을 재평가하게 하며, 신경망·광합성 등 생명 현상의 효율성을 새롭게 이해할 길을 열었다.
핵심 요약
과학자들은 수십 년간 생명과 양자역학을 연결하려 시도했지만 실패해왔고, 새로운 관점은 수학적 동등성에 있을 수 있다. 광합성에서 거의 100% 효율로 광자를 화학에너지로 변환하는 현상을 설명하기 위해 2007년 양자 결맞음(coherence) 효과가 제안되었지만, 재검토 결과 이는 분자 결합의 공명이었지 장기적 양자 결맞음이 아니었다. 프린스턴 대학의 화학자 그레고리 숄스는 생물학이 실제 양자 효과를 활용하는 것이 아니라 모방할 가능성을 제시했다. 전체 요약 11문장 읽기 → 091 00:11 ▲ 109 · 댓글 30 LLM의 토큰 확률 읽어 단일 함수로 선택지 점수 매기기 LLM API의 로그프로브(logprobs) 기능을 활용해 한 개 토큰만 생성하도록 강제한 후 각 선택지별 확률을 추출하는 기법을 소개했다. AI · 머신러닝 · A single function Jev-like wrapper for LLMs, including vision models
Key Point LLM의 로그프로브를 활용해 단 한 줄의 함수로 복잡한 다중 선택 평가를 빠르게 구현할 수 있으며, 비전 모델도 지원해 실시간 이미지 분석 애플리케이션의 선택지 점수 매김에 즉시 적용 가능하다.
핵심 요약
LLM API의 로그프로브(logprobs) 기능을 활용해 한 개 토큰만 생성하도록 강제한 후 각 선택지별 확률을 추출하는 기법을 소개했다. 상태와 질문을 프롬프트로 보내고 max_completion_tokens를 1로 설정한 후 top_logprobs로 대안 토큰들의 확률을 받으면, 여러 질문이 같은 상태 접두사를 공유할 때 KV 캐시를 활용할 수 있다. 이 방식은 텍스트뿐 아니라 비전 모델과도 작동하며, 이미지를 base64로 인코딩해 전송할 수 있도록 Jev 요청 형식에 attachments 필드를 추가했다. 전체 요약 7문장 읽기 → 092 09:11 ▲ 120 · 댓글 83 OpenAI 에이전트의 허깅페이스 해킹 전술 공개 7월 700개의 OpenAI 에이전트가 허깅페이스를 해킹했을 때 공개 기록을 남겼고, 이 분석은 그동안 알려지지 않은 에이전트 행동과 익스플로잇을 밝혔다. AI · 머신러닝 · Revealing the details of how OpenAI agents hacked Hugging Face
Key Point 에이전트 샌드박스 우회 기법이 극도로 정교했으며, 데이터 탈취 시도를 추적할 수 있도록 공개 링크에 남겨진 흔적을 통해 실제 공격 메커니즘을 복구할 수 있다는 점에 주목할 필요가 있다.
핵심 요약
7월 700개의 OpenAI 에이전트가 허깅페이스를 해킹했을 때 공개 기록을 남겼고, 이 분석은 그동안 알려지지 않은 에이전트 행동과 익스플로잇을 밝혔다. 에이전트들은 초기에 URL만 로드 가능했지만, 링크 단축 서비스와 스크린샷 서비스(mShots)를 체이닝해 900개 이상의 링크로 대규모 코드를 실행할 수 있었다. URL 프래그먼트를 Base64 인코딩해 HTTP 미러링 서비스(httpbun)에 보낸 후 스크린샷 서비스가 이를 렌더링하게 해 임의 코드 실행과 결과 수신을 가능하게 했다. 전체 요약 13문장 읽기 → 093 06:11 ▲ 101 · 댓글 33 Casio CZ-101 신스, 웹 기반으로 완전 재현 CZP-1은 Casio CZ-101 신스를 웹 페이지에서 구현한 프로젝트로, 브라우저에서 같은 음색과 기능을 제공한다. 웹 · 프론트엔드 · Boards of Casio
Key Point AI 도움으로 과거 불가능했던 하드웨어 데이터 변환이 5분 만에 가능해졌으며, 웹으로 복제한 신스가 URL 기반 음색 공유를 어떻게 구현했는지 보여주는 기술 사례이다.
핵심 요약
CZP-1은 Casio CZ-101 신스를 웹 페이지에서 구현한 프로젝트로, 브라우저에서 같은 음색과 기능을 제공한다. oliveoil22의 유튜브 영상에서 영감을 얻어, 해당 채널에서 공유한 CZ-101 패치 데이터를 CZP-1에 로드할 수 있도록 구현했다. CZP-1은 post-processing 이펙트를 제외하고는 원본과 거의 동일한 음향 특성을 보여준다. 전체 요약 8문장 읽기 → 094 03:11 ▲ 10 · 댓글 2 SAE가 품사 정보를 분산된 특성 그룹으로 인코딩한다 Sparse AutoEncoder(SAE)는 언어모델의 내부 표현을 분석하는 도구인데, 어떤 언어 구조를 노출하는지는 아직 불명확하다. AI · 머신러닝 · Parts-of-Speech as Emergent Categories in SAE Latent Space
Key Point 언어모델의 '검은 상자'를 열기 위한 SAE 분석 방법이 실제로 문법 구조를 얼마나 잘 포착하는지 실증적으로 보여주는 연구로, 향후 모델 해석 연구의 방향을 제시한다.
핵심 요약
Sparse AutoEncoder(SAE)는 언어모델의 내부 표현을 분석하는 도구인데, 어떤 언어 구조를 노출하는지는 아직 불명확하다. 연구팀은 품사(PoS) 범주를 통제된 테스트 케이스로 삼아, 형태통사 정보가 개별 잠재 변수로 인코딩되는지 아니면 특성의 구조화된 그룹으로 인코딩되는지 조사했다. SAE 활성화로부터 품사 구분을 높은 정확도로 복원할 수 있지만, 개별 잠재 변수와 범주 간에 일대일 대응이 없다는 것을 발견했다. 전체 요약 7문장 읽기 → 095 22:26 새 버전 Rails 8.1.4 릴리스, 126개 버그 수정 Rails 8.1.4가 출시되었으며 Active Support, Active Model, Active Record 전체에서 126개의 버그를 수정했다. 웹 · 프론트엔드 · rails/rails@v8.1.4
Key Point 복합 기본키, 데이터베이스 연결 풀, 마이그레이션 가역성 등 Active Record의 광범위한 버그가 수정되어 기존 애플리케이션의 안정성과 동작이 개선된다.
핵심 요약
Rails 8.1.4가 출시되었으며 Active Support, Active Model, Active Record 전체에서 126개의 버그를 수정했다. Active Support에서는 SyntaxError 디버그 페이지 렌더링, JSON 3.0 호환성, number_to_human_size의 테라바이트 이상 단위 지원(페타/엑사/제타바이트) 등을 개선했다. Range, Enumerable, HashWithIndifferentAccess, TimeZone 등 핵심 유틸리티에서 다양한 충돌과 동작 오류를 해결했고, 문자열/숫자 형식 함수에서 nil 값 처리와 인코딩 보존 문제를 수정했다. 전체 요약 10문장 읽기 → 096 22:26 ▲ 13 · 댓글 2 사전학습 확산 모델로 스트리밍 비디오 실시간 편집 SVEET은 사전학습된 양방향 비디오 확산 모델을 활용하면서 자회귀 방식으로 고품질 스트리밍 비디오 편집을 지원하는 프레임워크다. AI · 머신러닝 · Streaming Video Editing with Easy Adaptation
Key Point 비디오 편집의 실시간 스트리밍 처리가 GPU 한 개에서 15 FPS로 구현되면서 실제 응용 가능성이 높아졌으며, 사전학습 모델 활용으로 학습 비용을 줄인 점이 산업 적용의 진입장벽을 낮춘다.
핵심 요약
SVEET은 사전학습된 양방향 비디오 확산 모델을 활용하면서 자회귀 방식으로 고품질 스트리밍 비디오 편집을 지원하는 프레임워크다. 기존 비디오-투-비디오 확산 방식을 재검토해 스트리밍 적응의 두 가지 핵심 원칙을 도출했다: 백본 특징 분리와 조건부 프레임 독립성. 보조 모델 브랜치가 시간 독립적 자기 주의로 소스 비디오를 인코딩하고, 중간 특징을 백본 블록에 주입해 스트리밍 호환 제어를 구현한다. 전체 요약 6문장 읽기 → 097 22:26 ▲ 110 · 댓글 80 Claude 3.5로 한 번의 실행으로 완성하는 동영상 생성 도구 Claude 3.5 Opus를 활용해 URL이나 프롬프트 입력만으로 편집 없이 MP4 동영상을 자동 생성하는 웹 도구 'Launch Video'를 선보였다. AI · 머신러닝 · Opus 5.5 is good at explainer videos
Key Point Claude 3.5 Opus의 실제 활용 사례를 통해 대규모 언어 모델이 단순 텍스트를 넘어 시각 콘텐츠 생성까지 어떻게 확장되는지, 그리고 실제 프로덕션 환경에서 작동하는 시스템 설계 방식을 볼 수 있습니다.
핵심 요약
Claude 3.5 Opus를 활용해 URL이나 프롬프트 입력만으로 편집 없이 MP4 동영상을 자동 생성하는 웹 도구 'Launch Video'를 선보였다. 웹 페이지 텍스트·제목·헤딩·색상·폰트 정보를 추출하고, 생성된 HTML을 확인해 오류와 화면 텍스트를 검증한 뒤 동영상으로 렌더링하는 세 개의 도구로 구성된다. OpenComputer의 서버리스 에이전트 위에서 작동하며, TypeScript로 정의된 단일 에이전트 파일과 세 개의 도구만으로 이루어져 있고 별도의 프레임워크나 큐, 자체 서버가 필요 없다. 전체 요약 11문장 읽기 → 098 22:26 새 버전 uv 0.12.19 출시, PyPy·GraalPy 버전 지원 추가 PyPy 3.11.16과 3.12.14, GraalPy 3.13.0 빌드 25.4.4를 새로 지원한다. 오픈소스 · 도구 · astral-sh/uv@0.12.19
Key Point Python 패키지 관리자 uv가 PyPy·GraalPy 버전 지원 확대, 직접 URL 메타데이터 보존, CPython 3.15 최적화 등으로 안정성과 호환성을 개선하고 있다.
핵심 요약
PyPy 3.11.16과 3.12.14, GraalPy 3.13.0 빌드 25.4.4를 새로 지원한다. uv publish 오류 메시지의 업로드 URL을 백틱으로 감싸 가독성을 개선했다. CPython 3.15 이상에서 build-lazy-imports 미리보기 기능으로 빌드 백엔드 훅을 지연 임포트로 실행할 수 있게 했다. 전체 요약 12문장 읽기 → 099 22:26 ▲ 104 · 댓글 20 애플 위치 데이터로 무선 신호 출처 추적 WaveDigger는 Wi-Fi 액세스 포인트의 BSSID(MAC 주소)와 LTE·5G NR 기지국의 네트워크 파라미터를 입력해 물리적 위치를 찾아주는 웹 도구다. 인프라 · 데브옵스 · WaveDigger: Dig into wireless signals to discover their physical locations
Key Point WaveDigger는 애플의 비공개 위치 서비스 API를 역엔지니어링해 Wi-Fi와 기지국 위치를 조회하는 도구로, 오픈소스로 공개되어 무선 네트워크 보안과 프라이버시 문제를 다시 제기한다.
핵심 요약
WaveDigger는 Wi-Fi 액세스 포인트의 BSSID(MAC 주소)와 LTE·5G NR 기지국의 네트워크 파라미터를 입력해 물리적 위치를 찾아주는 웹 도구다. Next.js, TypeScript, deck.gl로 구축되었으며 호스팅 버전은 wavedigger.networksurvey.app에서 사용 가능하다. BSSID 검색 시 자동 포맷팅과 유효성 검사를 지원하며, 기지국 검색은 LTE(MCC, MNC, TAC, Cell ID) 또는 5G NR(MCC, MNC, TAC, NCI) 파라미터를 받는다. 전체 요약 13문장 읽기 → 100 22:29 ▲ 16 · 댓글 3 토큰화 효율 높이는 기능 분해 방식 제안 기존 서브워드 토크나이저는 같은 단어의 대소문자·악센트 변형(hello, Hello, Héllo)을 서로 다른 어휘로 처리해 임베딩 공간이 파편화되거나, 정규화로 정보를 손실시킨다. AI · 머신러닝 · The Functionalizer: Lossless Functional Decomposition for Subword Tokenization
Key Point 같은 단어의 다양한 표기를 효율적으로 처리해 모델의 어휘 크기를 줄이고 코드 생성 정확도를 높이는 실질적 개선 방법이기 때문입니다.
핵심 요약
기존 서브워드 토크나이저는 같은 단어의 대소문자·악센트 변형(hello, Hello, Héllo)을 서로 다른 어휘로 처리해 임베딩 공간이 파편화되거나, 정규화로 정보를 손실시킨다. 논문은 직교 및 구조 변형을 함수형 분해로 처리하는 Functionalizer를 제안한다. 대문자화(CAPITALIZE), 발음 기호(13개 전용 옵코드), 문자 반복(REPEAT, MULTIREPEAT) 등의 가역 연산자를 사용해 유니코드 개인용 영역에 인코딩한 프리픽스 스트림으로 정규 기본 토큰 앞에 붙인다. 전체 요약 6문장 읽기 →