쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
100건 (최대치) · "메커니즘"조건 지우기 ×
001 15:11 ▲ 13 · 댓글 1 멀티모달 LLM의 정보 검색 메커니즘 분석 멀티모달 대형 언어 모델의 긴 입력에서 관련 증거를 찾는 능력은 '검색 헤드'라는 특정 어텐션 헤드 집합에서 비롯된다. AI · 머신러닝 · A Broader Look into MLLM's Retrieval Heads
Key Point 멀티모달 LLM의 정보 검색 능력이 특정 어텐션 헤드에 집중되어 있다는 발견은 이들 모델의 작동 원리를 이해하는 핵심이며, 최적화를 통해 성능을 구체적으로 개선할 수 있는 방법을 제시한다.
핵심 요약
멀티모달 대형 언어 모델의 긴 입력에서 관련 증거를 찾는 능력은 '검색 헤드'라는 특정 어텐션 헤드 집합에서 비롯된다. 이 연구는 기존 연구의 한계를 확장해 음성-시각 입력 같은 새로운 모달리티를 포함한 18개 모델 체크포인트를 분석했다. 같은 답이 음성 또는 화면에 표시되는 쌍을 이루는 입력으로 테스트한 결과, 증거 내용이 같으면 검색 헤드는 새로운 모달리티에서도 희소성을 유지한다. 전체 요약 6문장 읽기 → 002 15:11 ▲ 15 · 댓글 1 자연어로 완성된 게임을 만드는 AI 프레임워크 VibeGame LLM 에이전트를 이용한 소프트웨어 개발은 가능했지만, 게임 개발처럼 코드·장면·에셋·애니메이션·물리·설정을 모두 조율해야 하는 작업은 여전히 도전 과제였다. AI · 머신러닝 · VibeGame: Prompt-to-Game Development with AI-Native Engine and Self-Evolving Adversarial Agent Team
Key Point LLM 에이전트로 복잡한 게임 개발 전 과정을 자동화할 수 있는 새로운 접근법을 제시하며, 특히 8개 에이전트의 협력 구조와 자기 진화 메커니즘이 AI 소프트웨어 개발 방법론의 진전을 보여준다.
핵심 요약
LLM 에이전트를 이용한 소프트웨어 개발은 가능했지만, 게임 개발처럼 코드·장면·에셋·애니메이션·물리·설정을 모두 조율해야 하는 작업은 여전히 도전 과제였다. VibeGame은 자연어 프롬프트와 선택적 참고 이미지로부터 완성된 2D 게임 프로젝트를 생성하는 프레임워크다. AI-native 게임 엔진은 프로젝트 상태를 스키마 검증된 구조화된 텍스트로 표현하고 프레임 동기식 런타임 제어를 제공해, 에이전트가 게임 상태를 검사하고 액션을 실행하며 동작을 자신의 속도로 검증할 수 있다. 전체 요약 7문장 읽기 → 003 06:11 ▲ 114 · 댓글 220 스페인 열차 충돌 사고, 최소 69명 사망 스페인 마드리드 남쪽 140km 지점의 세비야 고속선에서 수요일 오전 08:53 국영 Renfe 열차가 정차 중인 민영 Iryo 열차에 고속으로 충돌해 최소 69명이 사망했다. 기타 · What we know so far about Spain train crash
Key Point 열차 제어 시스템 오류로 정지된 열차에 고속 충돌한 사고의 원인 규명이 진행 중이며, 음성 녹음 증거가 통제실의 의사결정 과정을 직접 드러낸다.
핵심 요약
스페인 마드리드 남쪽 140km 지점의 세비야 고속선에서 수요일 오전 08:53 국영 Renfe 열차가 정차 중인 민영 Iryo 열차에 고속으로 충돌해 최소 69명이 사망했다. 충돌 당시 Mora와 Orgaz 사이 선로 위에 정차해 있던 Iryo 열차에 Renfe 열차가 뒤에서 추돌하면서 일부 객차가 제방 아래로 떨어졌다. 운수부 장관 오스카르 푸엔테는 오전 08:30경 컴퓨터 시스템 장애로 6개 이동 열차가 정지됐으며, 제어 센터가 속도 제한 없이 열차를 다시 출발하도록 결정했다고 설명했다. 전체 요약 11문장 읽기 → 004 03:11 ▲ 10 · 댓글 2 사전학습 데이터의 어휘 흔적이 모델 성능에 미치는 영향 제로샷 벤치마크 성능이 사전학습 말뭉치와 벤치마크 목표 간의 단어 수준 정렬에 얼마나 의존하는지 연구한 논문이다. AI · 머신러닝 · The Lexical Imprint of Pre-training Data
Key Point 사전학습 말뭉치의 어휘 특성이 모델의 제로샷 성능에 직접적인 영향을 미친다는 인과관계를 실증적으로 입증하며, 데이터 선택과 라우팅을 통한 성능 최적화의 가능성을 제시한다.
핵심 요약
제로샷 벤치마크 성능이 사전학습 말뭉치와 벤치마크 목표 간의 단어 수준 정렬에 얼마나 의존하는지 연구한 논문이다. 단어 단위 유니그램 교차 엔트로피(UCE)라는 토크나이저 무관의 모델 자유 지표를 제안해 참조 말뭉치와 목표 벤치마크 간 어휘 정렬을 측정한다. 우도 학습은 사전학습 말뭉치로부터 모델의 예측 분포를 형성하며, 우도 기반 평가의 제로샷 점수는 그 말뭉치와 벤치마크 사이의 어휘 정렬에 부분적으로 의존한다. 전체 요약 8문장 읽기 → 005 03:11 ▲ 179 · 댓글 82 팔로알토 방화벽 0-day 연쇄 공격, 25개 서버 장악 Dream 연구팀이 10월 25일 팔로알토 네트웍스 PAN-OS 방화벽 25대를 장악한 공격을 적발했으며, 미국 정부 계열 시스템이 포함되어 있다. 보안 · Chained PHP2Shell Exploit Roots 25 Servers, Including US Government Servers
Key Point PAN-OS 방화벽의 관리 인터페이스 노출이 정부 기관의 내부 AD까지 연결되는 공격 경로를 보여주며, 노출된 장비 발견에서 ID 인프라 침해까지의 전체 과정이 기록된 사례로 방어 전략 수립의 교훈을 제공한다.
핵심 요약
Dream 연구팀이 10월 25일 팔로알토 네트웍스 PAN-OS 방화벽 25대를 장악한 공격을 적발했으며, 미국 정부 계열 시스템이 포함되어 있다. 공격자는 PHP2Shell(CVE-2026-109618/109619)과 Fragnesia 커널 권한 상승 익스플로잇(CVE-2026-46300)을 연결해 인증 없이 한 번의 HTTP 요청으로 루트 접근을 달성했다. PHP2Shell은 PHP의 session.upload_progress 메커니즘을 악용해 메모리 고갈-정보 유출-스테일 참조 생성-코드 실행 네 단계로 nobody 권한 확보까지 도달한다. 전체 요약 13문장 읽기 → 006 21:11 ▲ 18 · 댓글 3 웹 에이전트를 위한 장기 지속 학습 프레임워크 'HaMo' 제시 웹 에이전트는 반복되는 다단계 작업에서 재사용 가능한 절차적 지식에 지속적으로 노출되지만, 기존 시스템은 모델 적응 또는 외부 메모리에 의존하면서 지속적 학습과 빠른 재사용 중 하나를 포기하는 한계가 있다. AI · 머신러닝 · Harness-Model Collaboration for Long-Horizon Continual Learning
Key Point 웹 자동화 에이전트의 장기 학습을 위해 경험 저장과 모델 적응을 어떻게 결합할지는 실무적 과제이며, HaMo의 접근은 이 문제의 구체적 해법을 제시한다.
핵심 요약
웹 에이전트는 반복되는 다단계 작업에서 재사용 가능한 절차적 지식에 지속적으로 노출되지만, 기존 시스템은 모델 적응 또는 외부 메모리에 의존하면서 지속적 학습과 빠른 재사용 중 하나를 포기하는 한계가 있다. 이를 해결하기 위해 HaMo(Harness-Model 협력 프레임워크)를 제안하며, 빠른 비모수적 경험 축적과 느린 모수적 적응을 결합한다. HaMo는 궤적을 전략 수준의 경험 카드로 증류하여 즉시 검색 가능하도록 하고, 경험 조건부 지속 학습 목표를 통해 모델이 검색된 전략을 다양한 맥락에서 해석·기반·실행하도록 훈련한다. 전체 요약 5문장 읽기 → 007 15:11 ▲ 22 · 댓글 2 멀티모달 AI, 이미지와 텍스트에 동일한 제어벡터 공유 통합 멀티모달 모델에서 텍스트 생성을 제어하는 벡터가 이미지 생성에도 제로샷으로 전이되는지를 연구한 논문이다. AI · 머신러닝 · Cross-modal Steering Vectors Exist Across Both Image and Text Generation
Key Point 멀티모달 AI의 내부 구조에서 이미지와 텍스트가 공유하는 통일된 개념 표현을 직접 입증해, 모델 해석 가능성과 제어 기술의 새로운 방향을 보여준다.
핵심 요약
통합 멀티모달 모델에서 텍스트 생성을 제어하는 벡터가 이미지 생성에도 제로샷으로 전이되는지를 연구한 논문이다. 감정, 물체 크기 등 다양한 개념의 제어벡터를 찾아 다른 모달리티로 전이시켰으며, 텍스트→이미지, 이미지→텍스트 양방향 모두에서 성공적으로 작동했다. 텍스트에만 고유한 개념(정중한 vs 구어체 표현)도 이미지에선 정중한 옷차림·디자인처럼 일관된 효과를 나타냈다. 전체 요약 5문장 읽기 → 008 12:11 ▲ 10 · 댓글 2 LLM 에이전트 검증 메커니즘, 독립적 리뷰가 최적 LLM 에이전트가 도구를 통해 작업을 수행할 때 검증 체계가 출력 품질을 개선하는데, 어떻게 설계해야 하는지에 대한 연구. AI · 머신러닝 · Rethinking Verification in Agent Harnesses
Key Point LLM 에이전트의 출력 품질을 높이는 가장 비용 효율적인 검증 방식이 무엇인지 실증적으로 규명해, 실제 에이전트 시스템 설계 시 어떤 구조를 채택할지 결정하는 기준을 제시합니다.
핵심 요약
LLM 에이전트가 도구를 통해 작업을 수행할 때 검증 체계가 출력 품질을 개선하는데, 어떻게 설계해야 하는지에 대한 연구. 초기 지시사항, 중간 리마인더, 완료 게이트, 독립적 리뷰 등 에이전트 생명주기의 4가지 계층에서 검증 시점과 방식을 비교. Terminal-Bench와 SWE-bench Verified에서 7개 최신 LLM의 17가지 검증 설계를 평가하고, 시각적 산출물 평가용 VisualBench 도입. 전체 요약 9문장 읽기 → 009 06:11 ▲ 396 · 댓글 87 핑거프린팅 스크립트 속 생화학 공격 언어 연구자가 상위 1만 개 웹사이트를 크롤링해 수집한 캔버스 핑거프린팅 스크립트들을 fingerprint.garden에 공개했다. 보안 · Why Is This Fingerprinting Script Creating Bioweapons?
Key Point LLM 안전장치 우회용 난독화 기법이 정상적인 보안 도구에 대량 삽입되는 실태를 드러내며, 오픈소스 생태계에서 악의적 코드와 방어 메커니즘의 경계가 모호해지는 상황을 보여준다.
핵심 요약
연구자가 상위 1만 개 웹사이트를 크롤링해 수집한 캔버스 핑거프린팅 스크립트들을 fingerprint.garden에 공개했다. servicepipe.tech에서 제공하는 한 핑거프린팅 스크립트에서 함수명으로 '물 공급원 치명적 용량 계산', '자살 아스피린 용량 계산' 등 생화학 무기 제조 관련 문자열을 발견했다. 스크립트는 LLM 기반 디컴파일 방지를 목표로 의도적으로 오도하는 변수명을 사용했으며, 인코딩된 유니코드에는 '무제한 모드' 시스템 프롬프트와 CRISPR 유전자 드라이브, 더티밤 제조법, 자해 방법 설명 요청 등이 포함됐다. 전체 요약 7문장 읽기 → 010 21:11 ▲ 14 · 댓글 2 주의력 레이어에 희소성 더하는 Nestor 모델 제안 현재 대규모 언어 모델은 Mixture-of-experts(MoE) 트랜스포머를 사용하며, MoE 연산자에서만 조건부 계산으로 가중치의 일부만 활용한다. AI · 머신러닝 · Nested Sparsity for Scalable Pretraining and Continual Learning
Key Point 조건부 계산의 새로운 메커니즘이 기존 MoE 모델의 학습 효율과 연속 학습 능력을 동시에 개선하는 구체적인 방법을 제시하고 있습니다.
핵심 요약
현재 대규모 언어 모델은 Mixture-of-experts(MoE) 트랜스포머를 사용하며, MoE 연산자에서만 조건부 계산으로 가중치의 일부만 활용한다. 이 논문은 주의력 연산자를 일반화한 대안적 조건부 계산 메커니즘을 제안하며, 이는 MoE 희소성과 계층적으로 결합되는 '중첩 희소성'을 만든다. Nestor라 명명한 이 모델은 동일한 계산량과 희소성에서 기존 MoE 트랜스포머보다 언어 모델 사전학습에서 더 나은 성능을 보인다. 전체 요약 6문장 읽기 → 011 18:11 ▲ 133 · 댓글 64 UEFI 펌웨어 버퍼 오버플로우 취약점, 전 세계 대부분 서버 위협 TianoCore EDK II 오픈소스의 ICMP 컴포넌트에서 메모리 손상 취약점(CVE-2026-97631, CVSS 9.5)이 발견되었다. 보안 · Code-execution flaw in UEFI firmware threatens most servers on planet Earth
Key Point 대부분의 서버가 사용하는 UEFI 펌웨어의 심각한 실행 취약점이 공개 패치로 인해 조기 공개되어, 전 세계 인프라 보안에 즉각적인 위협이 되고 있다.
핵심 요약
TianoCore EDK II 오픈소스의 ICMP 컴포넌트에서 메모리 손상 취약점(CVE-2026-97631, CVSS 9.5)이 발견되었다. AMI, Insyde, Phoenix 등 거의 모든 UEFI 공급업체와 마이크로소프트의 Project Mu가 이 코드를 사용하고 있다. Anthropic의 Alex Matrosov와 Google의 Dan Holmes가 발견했으며 1월 공개 예정이었지만, AMI가 지난달 깃허브에 패치와 함께 취약점을 공개했다. 전체 요약 13문장 읽기 → 012 15:11 ▲ 155 · 댓글 5 에이전트 메모리의 숨은 대가를 파헤치다 장기 작업을 수행하는 에이전트에서 메모리 시스템의 실제 가치를 검토한 연구를 발표했다. AI · 머신러닝 · Memory Tax: Dissecting the Net Value of Agent Memory
Key Point 에이전트 시스템에서 흔히 사용되는 메모리 메커니즘이 실제로는 직접 검색보다 떨어질 수 있다는 점을 실증적으로 보여주기 때문에, 현재의 메모리 아키텍처 설계 방향을 재검토해야 한다.
핵심 요약
장기 작업을 수행하는 에이전트에서 메모리 시스템의 실제 가치를 검토한 연구를 발표했다. 여러 벤치마크와 모델을 대상으로 대규모 평가한 결과, 많은 전용 메모리 시스템이 단순한 RAG 방식을 하회하는 성능을 보였다. 메모리의 순 가치를 '메모리 이득'과 '메모리 세금'으로 구분했으며, 이는 생 히스토리에서 직접 조회했을 때와의 차이에서 비롯된다. 전체 요약 7문장 읽기 → 013 12:11 ▲ 26 · 댓글 2 LLM 환각 탐지 벤치마크 비교 불가능한 이유 대규모언어모델(LLM)의 환각 탐지는 모델 평가와 배포에 점점 중요해지고 있으나, 기존 방법들은 서로 다른 정의와 측정 방식을 쓰는 벤치마크에서 비교되고 있다. AI · 머신러닝 · Mycelium: A Meta-Study of Hallucination Detection Across Provenance, Typology, and Granularities
Key Point LLM 성능을 평가하는 핵심 지표인 환각 탐지가 벤치마크마다 다르게 정의되고 측정되기 때문에, 어떤 방법이 실제로 더 나은지 판단할 수 없다는 문제를 드러낸다.
핵심 요약
대규모언어모델(LLM)의 환각 탐지는 모델 평가와 배포에 점점 중요해지고 있으나, 기존 방법들은 서로 다른 정의와 측정 방식을 쓰는 벤치마크에서 비교되고 있다. 연구팀은 환각 탐지를 벤치마크 조건부 측정 문제로 보고, 세 가지 축으로 기존 벤치마크들을 분류했다: 모델 출력과 근거 조건을 어떻게 얻는지를 설명하는 '출처', 사실성과 충실성 오류를 어떻게 정의하는지를 나타내는 '유형분류', 환각을 어떤 단위로 주석·예측·평가하는지를 명시하는 '단위'이다. 벤치마크 구성, 주석 방식, 평가 방법의 차이가 예측 작업에 어떻게 영향을 미치고, 탐지기의 메커니즘과 가정이 어떤 조건에서 성능을 보이는지를 분석했다. 전체 요약 5문장 읽기 → 014 12:11 ▲ 126 · 댓글 2 사용자 명령을 따르는 자유형 비디오 세계 모델 'Hy-Nomas' 공개 Hy-Nomas는 연속적인 사용자 명령을 따르면서 이전 상호작용 기록과 결과를 유지하는 대화형 세계 생성 모델이다. AI · 머신러닝 · Hy-Nomas: Towards Free-form Interactive World Generation
Key Point 대화형 AI 환경에서 사용자 명령을 정확히 따르면서도 과거 맥락을 유지하는 능력은 게임, 시뮬레이션, 메타버스 등 차세대 인터랙티브 콘텐츠 개발의 핵심 과제이며, 이 논문의 기술적 접근이 실제 적용에 어떻게 영향을 미칠지 주목할 필요가 있다.
핵심 요약
Hy-Nomas는 연속적인 사용자 명령을 따르면서 이전 상호작용 기록과 결과를 유지하는 대화형 세계 생성 모델이다. 80억 파라미터 규모의 확산 모델을 기반으로 자유형 텍스트 지시와 멀티턴 카메라 제어를 지원한다. 구조화된 비디오 자막과 행동 인식 인과 주의 메커니즘을 결합해 설명 맥락은 여러 세그먼트에서 접근 가능하면서 행동 명령은 해당 시간 윈도우로만 제한된다. 전체 요약 6문장 읽기 → 015 21:11 ▲ 101 · 댓글 27 64비트 윈도우에서 16비트 옛날 프로그램 실행하기 winevdm을 포트한 도구로 64비트 윈도우에서 Windows 1.x부터 3.1까지 16비트 윈도우 프로그램을 실행할 수 있다. 오픈소스 · 도구 · 16-bit Windows (Windows 1.x, 2.x, 3.0, 3.1, etc.) on 64-bit Windows
Key Point 현대의 64비트 윈도우 시스템에서 구동 불가능했던 20~30년 전 16비트 소프트웨어를 다시 쓸 수 있게 해주는 기술로, 하드웨어 에뮬레이션과 API 변환을 통해 낡은 윈도우 프로그램들의 생명을 연장시킨다.
핵심 요약
winevdm을 포트한 도구로 64비트 윈도우에서 Windows 1.x부터 3.1까지 16비트 윈도우 프로그램을 실행할 수 있다. CPU 에뮬레이터, Wine 기반의 Win16→Win32 변환 코드, 16비트 DOS 에뮬레이션을 포함하며, 64비트 윈도우에서 LDT 수정이 불가능한 제약을 CPU 에뮬레이터로 해결한다. 64비트 윈도우가 16비트 인스톨러를 감지할 때 대체 인스톨러를 시작하는 메커니즘을 활용해 설치를 가능하게 한다. 전체 요약 6문장 읽기 → 016 18:11 ▲ 24 · 댓글 2 대규모 언어모델의 자동 개선, 안전성을 어떻게 보장할까 대규모 모델 기반 AI 시스템은 경험과 피드백으로 모델·프롬프트·메모리·도구·워크플로우를 지속적으로 변경하고, 이 개선 과정 자체도 수정해 반복 적용하는 재귀적 자동 개선(RSI)을 한다. AI · 머신러닝 · Trustworthy Recursive Self-Improvement in the Era of Large Models: Foundation, Risks, Evaluation and Open Challenges
Key Point 큰 모델이 스스로 개선하는 시대가 오고 있는데, 그 과정에서 안전성·투명성·제어 가능성을 어떻게 보장할지가 AI 신뢰성의 핵심 문제이기 때문이다.
핵심 요약
대규모 모델 기반 AI 시스템은 경험과 피드백으로 모델·프롬프트·메모리·도구·워크플로우를 지속적으로 변경하고, 이 개선 과정 자체도 수정해 반복 적용하는 재귀적 자동 개선(RSI)을 한다. 자동 개선이 신뢰할 수 있으려면 평가 결과가 정확하고, 기존 능력이 퇴화하지 않으며, 행동 제약이 유지되어야 하며, 민감 정보가 후속 시스템에 남지 않아야 한다. 개선 메커니즘 변경 시 이전 검증 결과가 무효화되고 인간의 감시 효과가 떨어질 수 있어, 신뢰성 있는 RSI는 투명성과 제어 가능성을 필수적으로 요구한다. 전체 요약 7문장 읽기 → 017 12:11 ▲ 283 · 댓글 6 AI 에이전트 신뢰성 평가 벤치마크 'TraceTrial-Bench' 공개 LLM 기반 AI 에이전트의 신뢰성을 평가하는 새로운 벤치마크 TraceTrial-Bench를 제시했다. AI · 머신러닝 · Trial by Trace: Benchmarking AI Agent Harnesses for Reliability and Failure Attribution
Key Point LLM 에이전트 개발 시 모델 선택만으로는 부족하며, 실제 운영 환경의 하네스 설계가 신뢰성에 얼마나 큰 영향을 미치는지 처음으로 정량적으로 드러냈다.
핵심 요약
LLM 기반 AI 에이전트의 신뢰성을 평가하는 새로운 벤치마크 TraceTrial-Bench를 제시했다. 기존 벤치마크는 모델 성능 중심이었으나, 이 연구는 에이전트를 지탱하는 하네스(harness) 신뢰성에 초점을 맞췄다. 하네스 신뢰성을 컨텍스트, 실행, 거버넌스, 라이프사이클, 관찰성, 도구, 검증 7가지 요소로 분류했다. 전체 요약 10문장 읽기 → 018 03:12 ▲ 18 · 댓글 2 미니드라마 각본 자동 생성, 다중에이전트로 다양성과 일관성 확보 마이크로드라마의 성장으로 고품질 각본 생성 수요가 증가했으나, 긴 형식의 각본 생성은 다양한 플롯 진행과 장거리 서사 일관성을 동시에 충족하기 어렵다. AI · 머신러닝 · DraMaze: A Multi-Agent Pipeline with Future-Aware Memory for Diverse Microdrama Script Generation
Key Point LLM으로 미니드라마 같은 긴 형식 콘텐츠를 생성할 때 다양성 부족과 서사 일관성 손상이 기술적 난제인데, 다중에이전트와 메모리 구조 설계로 구체적 개선을 이뤘다는 점이 중요합니다.
핵심 요약
마이크로드라마의 성장으로 고품질 각본 생성 수요가 증가했으나, 긴 형식의 각본 생성은 다양한 플롯 진행과 장거리 서사 일관성을 동시에 충족하기 어렵다. 기존 방식에서는 생성이 진행될수록 후보 연속성이 적은 수의 서사 메커니즘으로 집중되고, 검색 기반 방식은 상투적 표현 재사용을 강화하며 미래 플롯에 필수적인 역사 정보를 간과한다. 연구팀은 이를 해결하기 위해 DraMaze를 제안했으며, 이는 트로프 메모리 기반 진화 트리 탐색과 돌연변이를 통해 다양한 인과관계 경로를 탐색하는 다중에이전트 파이프라인이다. 전체 요약 7문장 읽기 → 019 21:12 ▲ 298 · 댓글 2 비디오 기초 모델부터 세계 모델까지, 영상 이해와 생성의 통합 관점 비디오 기초 모델은 시각 시퀀스의 이해와 생성에 급속히 발전해온 반면, 비디오 세계 모델은 그 속 세계의 동역학을 포착하려 한다. AI · 머신러닝 · Reading, Writing, Sharing, and Interacting with the World through Video
Key Point 비디오 이해와 생성의 현주소를 통합적으로 정리한 메타 서베이로, 향후 연구의 방향성이 '보이는 것'에서 '일어나는 일'의 타당성으로 전환되고 있음을 보여준다.
핵심 요약
비디오 기초 모델은 시각 시퀀스의 이해와 생성에 급속히 발전해온 반면, 비디오 세계 모델은 그 속 세계의 동역학을 포착하려 한다. 이 논문은 세계 모델링을 통합 렌즈로 삼아 두 분야를 함께 조망한다. 관찰된 비디오를 잠재된 시간적 세계의 부분적·손실적·시간순 투영으로 보고, 네 가지 보완적 작업으로 문헌을 정리한다: reading은 비디오에서 세계 성질을 추론하고, writing은 지정되거나 학습된 세계 조건에서 비디오를 생성하며, sharing은 공통 모델링 메커니즘을 통해 이해와 생성을 통합하고, interacting은 행동과 진화하는 관찰 아래서 세계 상태를 예측하고 업데이트한다. 전체 요약 5문장 읽기 → 020 21:12 ▲ 103 · 댓글 13 나뭇가지 경쟁으로 자연스러운 나무 구조를 만든다 SIGGRAPH 2009 논문을 바탕으로 절차적 나무 성장 알고리즘을 구현했다. 기타 · Growing Trees
Key Point 게임·그래픽스 개발자들이 자연스럽고 다양한 나무를 대량으로 만들어야 할 때 필요한 실제 구현 방법을 배울 수 있다.
핵심 요약
SIGGRAPH 2009 논문을 바탕으로 절차적 나무 성장 알고리즘을 구현했다. 기본 단위인 메타머(절간, 잎, 눈)는 매 시즌마다 빛 자원을 놓고 경쟁하며, 경쟁에서 이기는 눈만 새 줄기를 만든다. 복셀 그리드를 이용해 각 눈이 받는 빛을 계산하고, 적분-분배 메커니즘으로 나무 밑에서 위로 성장 자원을 배분한다. 전체 요약 8문장 읽기 → 021 18:11 ▲ 102 · 댓글 37 셀프-어텐션 없이 언어모델 성능 낼 수 있을까 논문은 시퀀스 모델링에서 셀프-어텐션이 반드시 필요한지 근본적으로 재검토한다. AI · 머신러닝 · Attention Is Not What You Need (2025)
Key Point 트랜스포머 아키텍처의 핵심인 어텐션 메커니즘 자체를 대체하는 기하학적 모델을 제시하며, 같은 성능을 유지하면서 더 해석 가능한 설계가 가능함을 시사한다.
핵심 요약
논문은 시퀀스 모델링에서 셀프-어텐션이 반드시 필요한지 근본적으로 재검토한다. 기존 멀티헤드 어텐션을 숨은 벡터들을 고차원 공간으로 끌어올리는 텐서 lifting 메커니즘으로 해석하되, 이는 수학적으로 불명확하고 여러 층을 거치면서 명시적 불변량으로 기술하기 어렵다고 주장한다. 대안으로 그래스만 다양체 기반 구조를 제안하며, 인과 그래스만 층은 토큰 상태를 선형 축약한 뒤 플뤼커 좌표로 인코딩된 저차수 부분공간의 제어된 변형을 통해 정보를 전파한다. 전체 요약 6문장 읽기 → 022 18:11 ▲ 34 · 댓글 2 세계 모델과 멀티모달 에이전트 분리 평가 프레임워크 공개 World Model(WM)이 시뮬레이션된 경험으로 Multimodal Agent(MA)를 지원하고, 에이전트 궤적이 WM 개선에 기여하는 상호작용을 평가하기 위해 액션 선택과 상태 진화에 대한 별도의 증거가 필요하다. AI · 머신러닝 · Dual Exam: Controlled Evaluation of Multimodal Agents and World Models
Key Point 멀티모달 에이전트와 세계 모델의 상호작용을 처음 체계적으로 분리 평가하는 프레임워크로, 현재 AI 시스템들이 실제 협력에서 왜 실패하는지 진단할 수 있는 벤치마크를 제공한다.
핵심 요약
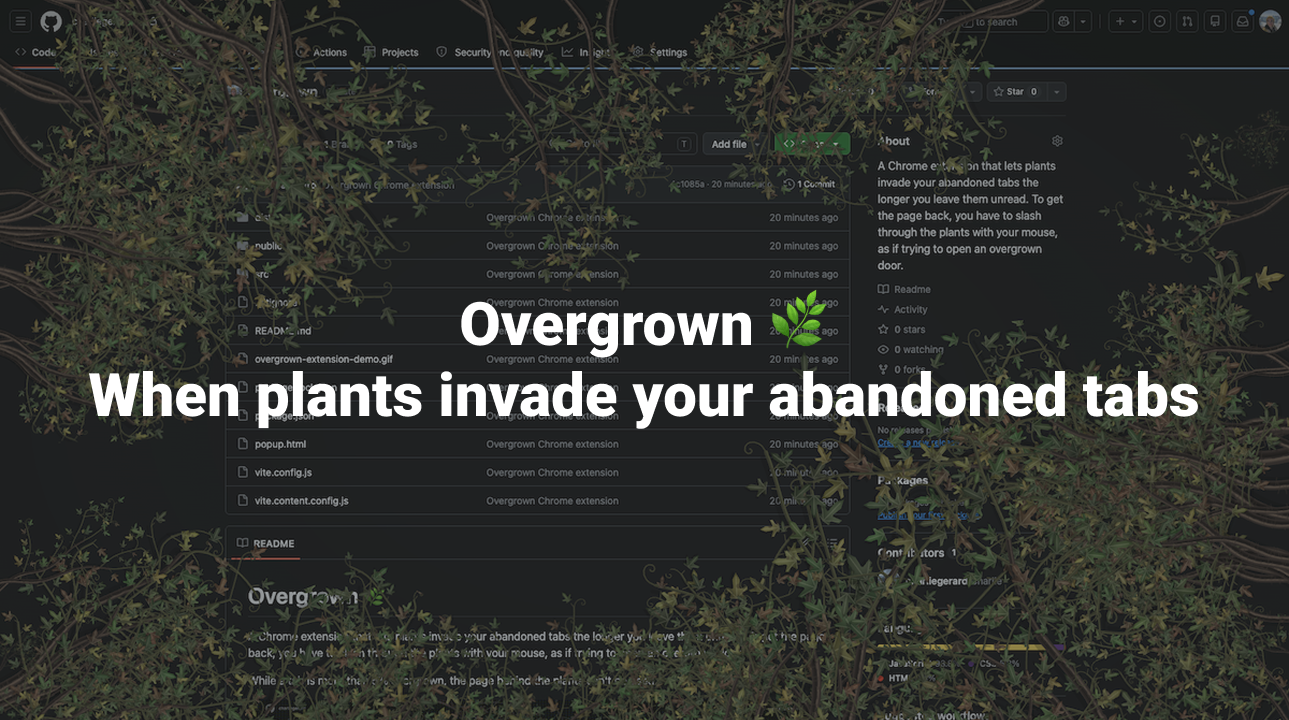
World Model(WM)이 시뮬레이션된 경험으로 Multimodal Agent(MA)를 지원하고, 에이전트 궤적이 WM 개선에 기여하는 상호작용을 평가하기 위해 액션 선택과 상태 진화에 대한 별도의 증거가 필요하다. Dual Exam은 고정된 환경 응답 메커니즘 하에서 에이전트를, 고정된 액션 개입 하에서 WM을 테스트하며, 물리·디지털·사회·과학 도메인을 다룬다. 에이전트 트랙은 10개 구성으로 1,088개 항목을 15개 보고 카테고리로 평가하고, WM 트랙은 8개 시나리오에서 400개 케이스를 포함한다. 전체 요약 8문장 읽기 → 023 09:10 ▲ 107 · 댓글 30 방치한 탭을 식물로 뒤덮는 크롬 확장프로그램 개발자가 방치된 브라우저 탭의 개념에서 영감을 받아 'Overgrown'이라는 크롬 확장프로그램을 만들었다. 웹 · 프론트엔드 · Overgrown, when plants invade your abandoned tabs
Key Point 방치된 브라우저 탭이라는 개인의 일상적 문제를 창의적인 게임 메커니즘으로 푼 사이드 프로젝트로, 실용성과 재미를 동시에 추구한 오픈소스 확장프로그램을 소개한다.
핵심 요약
개발자가 방치된 브라우저 탭의 개념에서 영감을 받아 'Overgrown'이라는 크롬 확장프로그램을 만들었다. 각 탭은 보지 않을수록 가장자리부터 식물이 자라나고, 5% 이상 덮이면 스크롤만 가능하고 클릭·선택·드래그가 불가능해진다. 마우스를 드래그해 식물을 자르는 방식으로 탭을 다시 접근 가능하게 만들 수 있다. 전체 요약 9문장 읽기 → 024 12:11 ▲ 10 · 댓글 3 AI 에이전트, 인간과의 역할 분담을 제대로 학습하나 언어 모델 에이전트가 능력이 증가하면서 인간의 도움 의존도가 낮아지는데, 이것이 협력 실패인지 올바른 역할 분담인지 구분하기 어렵다. AI · 머신러닝 · Who Takes the Lead? Model Ability and Task-Conditioned Collaboration with Humans
Key Point AI 에이전트의 능력이 증가하면서 인간과의 협력 방식이 단순한 도움 의존도 감소가 아니라 상황에 맞는 역할 분담 메커니즘을 학습하는지 실증적으로 보여주는 연구 결과다.
핵심 요약
언어 모델 에이전트가 능력이 증가하면서 인간의 도움 의존도가 낮아지는데, 이것이 협력 실패인지 올바른 역할 분담인지 구분하기 어렵다. 이를 체계적으로 조사하기 위해 연구팀은 공유된 목표 하에 에이전트와 인간을 놓고, 누가 이점을 가지는지 변화시키는 실험을 설계했다. 공유 제어 미로 과제에서 에이전트 제어 아바타와 인간 제어 아바타가 공동으로 최소 턴 수로 목표에 도달해야 하며, 에이전트가 매 턴마다 자신이 행동할지 인간에게 넘길지 결정한다. 전체 요약 7문장 읽기 → 025 21:11 당일 +227 각종 전자책 다운로드 링크 모음 저장소 다양한 전자책 다운로드 링크를 한곳에 모아놓은 GitHub 저장소로, 경전 문학·경영·학습·직장·기술 등 다양한 장르의 책을 포함한다. 오픈소스 · 도구 · jbiaojerry/ebook-treasure-chest · Python
Key Point 중국 사용자 중심이지만, 개발자들이 대규모 메타데이터를 수집·관리·검색 가능한 형태로 구성하는 사례로 참고할 수 있으며, 특히 온라인 검색 UI와 다중 형식 지원 구조가 유용한 구현 패턴이다.
핵심 요약
다양한 전자책 다운로드 링크를 한곳에 모아놓은 GitHub 저장소로, 경전 문학·경영·학습·직장·기술 등 다양한 장르의 책을 포함한다. 팬서우(樊登讀書)·웨이신판서(微信讀書)·징둥판서(京東讀書)·샤이마라야 등 중국의 주요 전자책 앱에서 제공하는 도서 대부분을 수집했다. 각 책마다 EPUB·MOBI·AZW3 세 가지 형식의 파일을 제공하여 다양한 전자기기와 사용자의 취향에 대응한다. 전체 요약 6문장 읽기 → 026 00:11 ▲ 124 · 댓글 67 pgrust, 벤치마크 결과 조작 적발돼 제거 ClickBench 벤치마크에서 pgrust 항목을 제거했다. 이 엔트리는 43개 벤치마크 쿼리 각각에 대해 손으로 작성한 커널(q00.rs~q36.rs)을 포함하고 있었다. 오픈소스 · 도구 · Remove pgrust: the entry is cheating
Key Point 특정 벤치마크에 맞춘 하드코딩과 캐싱으로 성능을 부풀린 사례가 공개돼, 오픈소스 벤치마크의 신뢰성을 지키는 과정을 보여준다.
핵심 요약
ClickBench 벤치마크에서 pgrust 항목을 제거했다. 이 엔트리는 43개 벤치마크 쿼리 각각에 대해 손으로 작성한 커널(q00.rs~q36.rs)을 포함하고 있었다. pgrust는 벤치마크 쿼리 형태에만 특화된 플랜 매처를 사용해 특정 쿼리를 감지하면 하드코딩된 답을 반환하도록 설계됐다. 벤치마크 이름을 직접 참조하는 거부 메시지(예: 'clickbench group count: filter is not k <> 0')가 바이너리에 포함돼 있었다. Q0, Q1, Q2, Q3, Q6, Q19, Q29는 실제 데이터 스캔 없이 메타데이터 통계만으로 답하도록 설정됐고, Q18은 미리 계산된 파생 컬럼을 사용했다. 전체 요약 7문장 읽기 → 027 18:11 ▲ 58 · 댓글 2 로봇이 자신의 학습 방식까지 개선하는 방법 재귀적 자기개선(RSI)은 시스템이 행동뿐 아니라 개선 과정 자체를 향상시키는 개념으로, 디지털 에이전트에서는 코드 재작성과 테스트로 구현되고 있다. AI · 머신러닝 · Toward Recursive Self-Improvement in Physical AI
Key Point 로봇이 단순히 작업을 더 잘하는 데 그치지 않고 학습하는 방식 자체를 개선하는 자기개선 시스템의 원리와 현실적 제약을 종합적으로 다루는 논문으로, 물리 AI의 다음 단계를 엿볼 수 있다.
핵심 요약
재귀적 자기개선(RSI)은 시스템이 행동뿐 아니라 개선 과정 자체를 향상시키는 개념으로, 디지털 에이전트에서는 코드 재작성과 테스트로 구현되고 있다. 물리적 세계의 로봇에 이를 적용하려면 비용이 큰 시행착오를 통해 불완전한 정보에서 학습하면서, 변화하는 환경과 돌이킬 수 없는 결과를 고려해야 한다. 논문은 로봇 학습 내에서 RSI의 위치를 정의하고, 로봇 능력 개선에서 그 과정 개선까지의 경로를 추적한다. 전체 요약 7문장 읽기 → 028 15:11 ▲ 12 · 댓글 1 낮은 대역폭에서 음성 품질 지키는 적응형 음성 코덱 공개 신경망 기반 음성 코덱은 음성을 이산 토큰으로 변환하는데, 프레임 레이트가 낮을수록 토큰 시퀀스가 짧아지지만 각 토큰이 더 많은 정보를 담아야 한다. AI · 머신러닝 · RubatoCodec: Budgeted Adaptive Speech Tokenization with Streaming Decoding
Key Point 저대역폭 음성 생성에서 품질과 안정성을 동시에 확보하는 새로운 접근법으로, 음성 AI 모델 개발자들이 토큰 예산을 명확히 제어하면서도 높은 음질을 유지할 수 있게 한다.
핵심 요약
신경망 기반 음성 코덱은 음성을 이산 토큰으로 변환하는데, 프레임 레이트가 낮을수록 토큰 시퀀스가 짧아지지만 각 토큰이 더 많은 정보를 담아야 한다. 기존 가변 프레임 레이트 코덱은 임계값 기반 할당으로 콘텐츠에 따라 토큰 개수가 달라져 생성 모델이 예측해야 할 시퀀스 길이가 불안정하다. RubatoCodec은 X-Codec-2 기반의 가변 프레임 레이트 음성 코덱으로, 발화 단위의 명시적 이벤트 예산과 스트리밍 디코딩을 지원한다. 전체 요약 10문장 읽기 → 029 15:11 ▲ 163 · 댓글 2 AI 에이전트의 실시간 웹 정보 검색 능력 측정 실제 웹 환경에서 AI 에이전트가 다단계 정보 검색을 수행할 수 있는지 평가하는 OpenDS 과제를 제안했다. AI · 머신러닝 · Deep Search in Real-World Web Environments
Key Point 현재의 AI 에이전트가 실제 웹에서 다단계 검색을 얼마나 잘 하는지 처음으로 체계적으로 측정하는 기준을 제시하므로, 앞으로의 에이전트 개발 방향을 좌우할 벤치마크가 될 것이다.
핵심 요약
실제 웹 환경에서 AI 에이전트가 다단계 정보 검색을 수행할 수 있는지 평가하는 OpenDS 과제를 제안했다. 기존 연구와 달리 실제 웹은 다양한 출처와 형식의 정보, 복잡한 상호작용 메커니즘을 포함하고 있어 에이전트가 자율적으로 증거를 찾아 통합해야 한다. 200개의 까다로운 과제로 구성된 OpenDS-World 벤치마크를 만들었으며, 다양한 정보 양식, 이기종 파일 형식, 상호작용 접근 요구사항을 포함하고 인간 검증으로 답의 정확성을 보장했다. 전체 요약 6문장 읽기 → 030 15:11 ▲ 106 · 댓글 27 ZFS 내부 구조를 보여주는 인터랙티브 박물관 공개 ZFS 파일 시스템의 핵심인 'uberblock'을 설명하는 인터랙티브 박물관 사이트가 공개되었다. 인프라 · 데브옵스 · Show HN: Uberblok – an interactive museum of ZFS internals
Key Point ZFS 파일 시스템의 내부 동작 원리를 인터랙티브하게 학습할 수 있는 독창적인 학습 도구로, 인프라 엔지니어와 저수준 시스템 관심층이 ZFS의 데이터 안정성 메커니즘을 깊이 있게 이해할 수 있게 한다.
핵심 요약
ZFS 파일 시스템의 핵심인 'uberblock'을 설명하는 인터랙티브 박물관 사이트가 공개되었다. Uberblock은 크래시 후 시스템이 현재의 일관된 상태를 찾을 수 있게 해주는 작은 레코드로, 트랜잭션 그룹 번호와 루트 블록 포인터를 담는다. 디스크의 각 라벨에는 128 KiB 링 버퍼에 uberblock들이 저장되며, 새로운 uberblock은 이전 것을 덮어쓰지 않고 순환 구조로 저장된다. 전체 요약 8문장 읽기 → 031 09:11 ▲ 206 · 댓글 248 AI 모델들, 인간 본성에 같은 결론에 도달하다 12개 AI 모델(GPT-6.1 Sol, Gemini 4 Argon, DeepSeek V4 Pro, Claude Opus 5.5 등)에게 인간에 대한 가장 논쟁적인 의견을 3번씩 물었다. AI · 머신러닝 · Every AI model has the same "controversial" take on humans
Key Point 같은 AI 모델들이 인간 본성에 대해 거의 동일한 비판적 결론에 도달한 현상은, 학습 데이터의 편향이나 AI 안내 방식이 모델들의 판단을 수렴시키는 메커니즘을 보여준다.
핵심 요약
12개 AI 모델(GPT-6.1 Sol, Gemini 4 Argon, DeepSeek V4 Pro, Claude Opus 5.5 등)에게 인간에 대한 가장 논쟁적인 의견을 3번씩 물었다. 7개 모델은 매번 같은 답을 했고, 12개 모델 모두 최소 1번은 동일한 주장을 제시했다: '인간은 진실보다 집단 소속을 우선한다'는 내용이다. 모델들의 구체적 표현은 다양했지만 핵심은 같다. '인간은 충성심을 원칙으로 위장한다'(GPT-6 Astra), '신념이 아니라 멤버십을 갖는다'(Kimi K3), '이성화 동물이다'(DeepSeek V4 Pro)는 식의 주장이 반복됐다. 전체 요약 12문장 읽기 → 032 06:11 ▲ 12 · 댓글 2 LLM 에이전트의 메모리 피드백 악순환, 새로운 설계로 극복 LLM 에이전트가 외부 메모리에 실행 경험을 저장해 이후 결정을 가이드할 때, 단순 궤적과 결과뿐 아니라 추론된 규칙·요약·스킬도 함께 보관할지가 핵심 설계 문제다. AI · 머신러닝 · More Memory, Worse Agents: Error Reproduction and Anti-Persistence in LLM Agents
Key Point 메모리를 크게 할수록 에이전트 성능이 악화되는 역설적 현상을 설명하고, 오류가 자동 증폭되는 메커니즘을 밝혀 LLM 에이전트 설계의 근본 문제를 제시합니다.
핵심 요약
LLM 에이전트가 외부 메모리에 실행 경험을 저장해 이후 결정을 가이드할 때, 단순 궤적과 결과뿐 아니라 추론된 규칙·요약·스킬도 함께 보관할지가 핵심 설계 문제다. 추상화된 정보를 저장하면 원시 궤적에서 매번 유도할 필요 없이 전략을 재사용할 수 있지만, 저장된 추상화의 오류가 검색·재사용을 통해 후속 결정에 전파될 수 있다. 더 큰 문제는 '오류 재현(error reproduction)'이라는 피드백 루프다: 저장된 결함 있는 지식이 실행 궤적을 왜곡하고, 그 왜곡된 궤적에서 다시 추상화되며 원래 오류가 재생성되고 지속된다. 전체 요약 7문장 읽기 → 033 03:11 ▲ 22 · 댓글 1 로봇 조작에 코드 기반 계획을 결합한 새로운 AI 모델 기존 세계 행동 모델(WAM)은 로봇 조작을 위한 시각적 예측은 제공하지만 기술을 재사용할 수 있는 명시적 메커니즘이 부족했다. AI · 머신러닝 · Agentic World Action Models
Key Point 로봇 조작 AI에서 시각 예측과 코드 기반 계획의 gap을 처음으로 메운 모델이며, 재사용 가능한 기술 라이브러리와 자동 학습 파이프라인을 제시해 실제 로봇 시스템의 확장성을 높일 수 있는 방법을 제안한다.
핵심 요약
기존 세계 행동 모델(WAM)은 로봇 조작을 위한 시각적 예측은 제공하지만 기술을 재사용할 수 있는 명시적 메커니즘이 부족했다. 코드 기반 계획 로봇공학은 재사용 가능한 기술을 제공하지만 물리 역학의 예측 기반이 약해 현실과의 연결 고리가 약했다. 이를 해결하기 위해 AW-0이라는 에이전트형 세계 행동 모델을 제시했으며, 코드 기반 계획을 영상·행동 예측과 통합한다. 전체 요약 9문장 읽기 → 034 21:11 ▲ 113 · 댓글 55 인터뷰 팁이 퍼즐 게임 풀이에도 효과, 생각을 말로 나타내기의 힘 저자는 면접에서 지원자에게 생각을 큰 소리로 말하도록 하는 관행을 유지해왔는데, 최근 2016년 퍼즐 게임 'The Witness'를 할 때 자신의 사고 과정을 음성으로 나레이션하기 시작했다. 기타 · Chain of Thought for Humans
Key Point 사고 과정을 말로 표현하는 것이 단순한 의사소통 기법이 아니라 실제 인지 성능을 향상시킨다는 기초적인 이해를 제시하며, 문제 해결 전략의 과학적 근거를 보여준다.
핵심 요약
저자는 면접에서 지원자에게 생각을 큰 소리로 말하도록 하는 관행을 유지해왔는데, 최근 2016년 퍼즐 게임 'The Witness'를 할 때 자신의 사고 과정을 음성으로 나레이션하기 시작했다. 자신의 생각 속도가 말보다 빠르고 기하학적 추론은 언어로 표현하기 어려운데도 불구하고, 이 방법이 놀랍게도 퍼즐 풀이 효율을 크게 높였다. 저자는 LLM이 이전 생각을 반복할 수 없어 토큰을 출력해야 하는 아키텍처 제약이 있지만, 인간의 경우 다른 메커니즘이 작동한다고 생각했다. 전체 요약 6문장 읽기 → 035 15:11 ▲ 14 · 댓글 2 코딩 에이전트 훈련, 정책뿐 아니라 도구까지 기존 코딩 에이전트 훈련은 정책만 업데이트하고 에이전트의 도구와 훅을 고정했지만, 학습 중 드러나는 수리 전략과 상호작용 문제들은 작업마다 다르고 정책이 발전하며 변한다. AI · 머신러닝 · Training the Whole Agent, Not Just the Model
Key Point 코딩 에이전트의 훈련 방식을 근본적으로 바꾸면서 SWE-bench에서 유의미한 성능 향상을 보여줘, 실제 소프트웨어 엔지니어링 작업을 자동화하는 에이전트의 실용성이 높아진다.
핵심 요약
기존 코딩 에이전트 훈련은 정책만 업데이트하고 에이전트의 도구와 훅을 고정했지만, 학습 중 드러나는 수리 전략과 상호작용 문제들은 작업마다 다르고 정책이 발전하며 변한다. HarnessAdapt-RL은 강화학습 중 정책과 함께 에이전트의 도구·훅을 적응시키는 방식이다. 잘못된 수리 전략에는 고정된 교사 모델이 작업별 메커니즘 레벨의 스킬을 생성하고, 여러 작업에 반복되는 상호작용 문제에는 별도 교사 모델이 도구와 훅을 진화시키되 통과율이나 학습 가능한 비율을 개선할 때만 유지한다. 전체 요약 6문장 읽기 → 036 12:11 ▲ 42 · 댓글 2 로봇 플래너도 포스트트레이닝으로 강화된다 로봇을 제어하는 AI 플래너의 성능을 높이기 위해 '포스트트레이닝' 기법을 적용한 AgenticRoboRL 프레임워크를 개발했다. AI · 머신러닝 · AgenticRoboRL: Bringing Coding-Agent Post-Training to Agentic Robotics
Key Point 작은 오픈소스 로봇 모델도 정교한 포스트트레이닝으로 폐쇄형 거대모델 수준의 성능을 낼 수 있다는 점이 로봇 개발자와 AI 연구자들에게 실질적인 의미를 갖는다.
핵심 요약
로봇을 제어하는 AI 플래너의 성능을 높이기 위해 '포스트트레이닝' 기법을 적용한 AgenticRoboRL 프레임워크를 개발했다. 기존 로봇 제어 시스템은 강력한 폐쇄형 모델(GPT 같은)에 의존했지만, 모델 자체를 개선하지는 않았다. 코딩 에이전트 분야에서 포스트트레이닝이 성공한 점에 착안해 로봇 플래너에도 같은 접근을 시도했다. 전체 요약 8문장 읽기 → 037 06:11 새 버전 Ollama v0.40.8, Flint 모델 지원 추가 Ollama가 v0.40.8을 릴리스하며 MLX 기반 Flint 모델 지원을 추가했다. AI · 머신러닝 · ollama/ollama@v0.40.8
Key Point Flint 모델을 새로 지원함으로써 MLX 백엔드의 모델 호환성이 확대되고, 숫자 타입 정확성이 필요한 고급 애플리케이션의 프롬프트 처리 품질이 향상된다.
핵심 요약
Ollama가 v0.40.8을 릴리스하며 MLX 기반 Flint 모델 지원을 추가했다. 소스 도구 JSON을 API 디코딩 값과 함께 보존하여 Flint가 프롬프트에서 숫자 타입과 스키마 순서를 유지할 수 있게 했다. 기존 API 마셜링은 변경되지 않았으며, Flint 외 다른 모델의 가져오기와 양자화 경로는 기존 방식을 그대로 유지한다. 전체 요약 6문장 읽기 → 038 06:11 ▲ 13 · 댓글 2 개방형 RL 학습 과정을 자동으로 조정하는 HarnessRL 제안 자연어 보상 기준을 사용한 개방형 생성 정책 학습(Rubric-based RL)은 훈련이 진행되면서 보상이 비효과적이 되는 문제를 겪는다. AI · 머신러닝 · HarnessRL: Co-Evolving Policies with a Just-in-Time Training Harness for Open-Ended RL
Key Point 개방형 과제를 통해 AI 모델을 훈련할 때 보상 신호의 붕괴와 오류를 자동으로 탐지하고 수정하는 메커니즘이 필요한 상황에서, 훈련 과정 자체를 동적으로 조정하는 접근이 효율성을 크게 개선할 수 있음을 보여준다.
핵심 요약
자연어 보상 기준을 사용한 개방형 생성 정책 학습(Rubric-based RL)은 훈련이 진행되면서 보상이 비효과적이 되는 문제를 겪는다. 점수가 균일하게 낮거나 높게 붕괴되는 비차별적 보상과 높은 점수가 실제 답변 품질과 맞지 않는 허위 보상이라는 두 가지 실패 양식이 존재한다. 이는 정책이 진화하면서도 작업 샘플링, 탐색, 평가 설정이 고정되어 있기 때문이다. 전체 요약 8문장 읽기 → 039 06:11 ▲ 12 · 댓글 2 확률 오차 줄이는 AI 에이전트 프레임워크 RiseHarness 장시간 작업을 수행하는 터미널 에이전트는 한 번은 성공하지만 반복 실행 시 실패하는 문제가 있으며, 확률적 오류가 액션과 컨텍스트를 거쳐 누적된다. AI · 머신러닝 · Harness Self-Evolution for Long-Horizon Terminal Agents
Key Point 모델 가중치를 고정하고 실행 로직만 개선해 AI 에이전트의 신뢰성을 높이는 새로운 접근법으로, 확률적 오류로 인한 작업 실패 문제를 체계적으로 해결하는 방법을 제시한다.
핵심 요약
장시간 작업을 수행하는 터미널 에이전트는 한 번은 성공하지만 반복 실행 시 실패하는 문제가 있으며, 확률적 오류가 액션과 컨텍스트를 거쳐 누적된다. RiseHarness는 모델 가중치를 고정한 채로 에이전트 하네스(harness)를 반복 개선하는 프레임워크로, 같은 설정에서 성공과 실패를 오가는 작업에 초점을 맞춘다. 런타임 모니터에서 수집한 내부 하네스 추적과 에이전트 궤적을 결합해 모델 액션이 명령 실행, 피드백, 컨텍스트 관리, 완료 결정과 어떻게 상호작용하는지 검토한다. 전체 요약 9문장 읽기 → 040 18:11 ▲ 22 · 댓글 2 추론 모델의 병렬 수정 기법, Draft Refinement 제안 추론 모델이 반복적으로 각 의사결정을 수정할 때, 개별적으로 타당한 토큰 업데이트가 전체 답변의 질을 보장하지 못한다는 문제를 제시한다. AI · 머신러닝 · Breaking Diffusion: Parallel Reasoning with Draft Refinement
Key Point 추론 모델에서 토큰 단위 수정을 병렬로 처리하면서도 평가의 정확성을 높이는 새로운 메커니즘을 제시해, 복잡한 문제 해결에서 계산 효율과 정확도를 동시에 개선할 수 있음을 보여준다.
핵심 요약
추론 모델이 반복적으로 각 의사결정을 수정할 때, 개별적으로 타당한 토큰 업데이트가 전체 답변의 질을 보장하지 못한다는 문제를 제시한다. Draft Refinement Language Models(DRLMs)는 단일 denoiser를 사용해 병렬 수정안을 제안하고 후보 초안을 평가하는 방식을 도입했다. Denoiser는 균등하게 손상된 초안에서 모든 토큰을 복원하도록 학습되어 보존과 수리 능력을 모두 갖춘다. 전체 요약 8문장 읽기 → 041 18:11 ▲ 18 · 댓글 2 그림 그려지는 과정을 시간 지도로 제어하기 미술 생성 AI는 정적 이미지 합성에서 인간의 회화 과정을 모방하는 동적 비디오 생성으로 발전했으나, 기존 모델들은 창작 과정을 블랙박스로 취급한다. AI · 머신러닝 · Painting Change Map as guidance for generating painting processes
Key Point 기존 회화 영상 생성 모델은 사용자가 어느 부분을 언제 그려야 하는지 제어할 수 없는데, 이 연구는 시공간 변화 지도로 획 수준의 정밀한 제어를 처음 가능하게 한다.
핵심 요약
미술 생성 AI는 정적 이미지 합성에서 인간의 회화 과정을 모방하는 동적 비디오 생성으로 발전했으나, 기존 모델들은 창작 과정을 블랙박스로 취급한다. 현재의 조건 메커니즘은 Canny 엣지나 깊이 맵처럼 너무 경직되었거나 진행률 같은 단순 스칼라 변수로 너무 단순화되어, 그림이 시간에 따라 어떻게 진화하는지 사용자가 조종할 수 없다. 이 연구는 '페인팅 체인지 맵'이라는 새로운 시공간 제어 메커니즘을 제안하는데, 이는 1,000 타임스텝 전체에서 정규화된 구조적 변화를 명시적으로 추적한다. 전체 요약 7문장 읽기 → 042 18:11 ▲ 102 · 댓글 156 직원 시간의 12% 빼앗는 회의, 경제학이 증명했다 NBER이 발표한 논문에서 노르웨이 9,000명 이상의 근로자 대상 대규모 조사를 통해 직장 회의의 경제적 영향을 분석했다. 스타트업 · 비즈니스 · Why do we have so many meetings?
Key Point 기업 문화에서 만성적으로 비판받는 회의가 실제로는 임금 성장과 지식 전달을 촉진하는 메커니즘이라는 경제학적 증거가 처음 제시되었기 때문이다.
핵심 요약
NBER이 발표한 논문에서 노르웨이 9,000명 이상의 근로자 대상 대규모 조사를 통해 직장 회의의 경제적 영향을 분석했다. 회의는 직원들의 평균 업무 시간의 12%, 기업의 임금 지출의 14%를 소비하고 있으며, 계획·문제 해결·정보 공유·프로젝트 조율이 회의 활동의 대부분을 차지한다. 고임금·고매출 기업일수록 직원 시간의 기회 비용이 더 높음에도 불구하고 회의에 더 많은 자원을 할당하고 있다. 전체 요약 6문장 읽기 → 043 12:11 ▲ 29 · 댓글 2 약한 모델로 강한 확산 모델 학습하기, SWIFT 논문 확산 모델 학습은 계산량이 많아서 추론 시 가이던스를 추가하면 샘플링 비용이 더 높아진다는 문제가 있다. AI · 머신러닝 · SWIFT: Self-guided Weak-to-strong dIFfusion models via Target extrapolation
Key Point 약한 모델을 활용해 더 강한 확산 모델을 절반 이하의 학습 비용으로 훈련하면서도 추론 오버헤드를 늘리지 않는 실질적인 방법이 입증되었기 때문이다.
핵심 요약
확산 모델 학습은 계산량이 많아서 추론 시 가이던스를 추가하면 샘플링 비용이 더 높아진다는 문제가 있다. SWIFT는 얼려진 약한 노이즈 제거기를 사용해 강한 모델을 개선하는 자가 가이드 학습법으로, 추론 오버헤드를 추가하지 않는다. 각 노이지 입력에 대해 약한 모델의 예측에서 멀어지도록 클린 회귀 타겟을 외삽하여, 부족하게 학습된 성분을 증폭한다. 전체 요약 9문장 읽기 → 044 12:11 ▲ 227 · 댓글 3 멀티모달 GUI 에이전트의 주의력 집중 방식 FocusGUI 스크린샷, 오디오, 비디오, 상호작용 이력, 기기 상태 등 다양한 입력 정보를 처리하는 GUI 에이전트에서, 모든 정보를 동등하게 처리하면 불필요한 정보가 노이즈가 되어 에이전트의 판단을 방해하는 '순차 산만함(Sequential Distraction)' 문제가 발생한다. AI · 머신러닝 · Focused Omni-Modal GUI Agents
Key Point 멀티모달 정보를 처리하는 GUI 자동화 에이전트가 불필요한 정보로 인한 오류를 줄이고 성능을 대폭 향상시키는 새로운 방식을 제시하고 있다.
핵심 요약
스크린샷, 오디오, 비디오, 상호작용 이력, 기기 상태 등 다양한 입력 정보를 처리하는 GUI 에이전트에서, 모든 정보를 동등하게 처리하면 불필요한 정보가 노이즈가 되어 에이전트의 판단을 방해하는 '순차 산만함(Sequential Distraction)' 문제가 발생한다. 각 단계마다 실제로 필요한 정보는 다르므로, 단계별로 적응적이고 행동 충분하며 비방해적인 '집중된 인식'을 요구한다. FocusGUI는 경량 어댑터로서 현재 의사 결정에 필요한 멀티모달 채널을 동적으로 우선순위화하고, 가장 관련성 높은 정보를 압축된 잠재 표현으로 변환한다. 전체 요약 7문장 읽기 → 045 06:11 ▲ 105 · 댓글 28 IKEA 가구 조립 설명서를 3D로 재현한 인터랙티브 가이드 IKEA의 BILLY 책장(80 × 28 × 202cm)과 LACK 사이드 테이블(55 × 55 × 45cm) 두 가지 가구의 조립 설명서를 3D 인터랙티브 모델로 구현한 웹페이지다. 웹 · 프론트엔드 · IKEA – 3D Guide
Key Point IKEA 가구의 복잡한 기계식 결합(캠 록) 원리와 조립 순서를 인터랙티브 3D 모델로 명확하게 보여주므로, 가구 설계와 사용자 인터페이스 개선에 관심 있는 개발자와 디자이너가 참고할 가치가 있다.
핵심 요약
IKEA의 BILLY 책장(80 × 28 × 202cm)과 LACK 사이드 테이블(55 × 55 × 45cm) 두 가지 가구의 조립 설명서를 3D 인터랙티브 모델로 구현한 웹페이지다. BILLY 책장은 목재 다웰 16개, 캠 나사 12개, 캠 록 12개, 못 18개, 선반 핀 16개 등 총 82개 부품과 하드웨어로 이루어져 있으며, 정식 매뉴얼(AA-1823127-9)의 페이지마다 동일하게 재현했다. 캠 록 메커니즘으로 작동하는 원리를 보여주는데, 나사가 옆면에서 나와 있다가 판자가 올라가면서 컵 모양의 캠에 빠지고 시계 방향으로 반 바퀴 돌리면 나선형 경사로가 두 패널을 팽팽하게 당긴다. 전체 요약 10문장 읽기 → 046 00:11 ▲ 13 · 댓글 2 텍스트 거부 신호로 멀티모달 AI 안전성 확보 멀티모달 대형 언어 모델(MLLM)의 안전성 강화는 이미지·비디오 등 각 형식별로 새로운 안전 데이터를 수집해야 했고, 수집·배포 과정에서 윤리·법적 문제가 발생했다. AI · 머신러닝 · Harnessing Textual Refusal Directions for Multimodal Safety
Key Point 안전 데이터 수집 없이 기존 텍스트 모델의 안전 메커니즘을 이미지·비디오에 재사용할 수 있다는 점이 멀티모달 AI 안전성 구축의 비용과 윤리적 부담을 획기적으로 줄인다.
핵심 요약
멀티모달 대형 언어 모델(MLLM)의 안전성 강화는 이미지·비디오 등 각 형식별로 새로운 안전 데이터를 수집해야 했고, 수집·배포 과정에서 윤리·법적 문제가 발생했다. 연구팀은 텍스트 LLM에서 추출한 '거부 방향(refusal directions)'이 이미지, 비디오 등 다른 모달리티에도 적용 가능한지 검증했고, 레이어 선택·조종 강도·크로스모달 정렬에 따라 효과가 달라짐을 확인했다. MARS(Modality-Agnostic Refusal Steering)라는 학습 없이 작동하는 경량 방식을 제안했으며, 활성화 중심화로 모달리티 불일치를 바로잡고 기하학적 신뢰 영역 내에서 조종 강도를 적응적으로 조절한다. 전체 요약 6문장 읽기 → 047 21:11 ▲ 102 · 댓글 19 LLM 에이전트로 시스템 모니터링 혁신하다 Anthropic은 Claude를 이용해 특정 시스템 컴포넌트 건강도를 전담하는 '슈퍼팬' 에이전트를 도입했으며, 이들은 기존 알림보다 미묘하고 새로운 문제를 더 잘 감지한다. AI · 머신러닝 · Agentic Monitoring
Key Point 시스템 규모 확대로 인한 운영 복잡도 증가 속에서 에이전트 기반 모니터링이 낮은 비용으로 정밀한 장애 감지와 대응을 가능하게 하며, 1년 이내 업계 표준이 될 가능성이 높기 때문이다.
핵심 요약
Anthropic은 Claude를 이용해 특정 시스템 컴포넌트 건강도를 전담하는 '슈퍼팬' 에이전트를 도입했으며, 이들은 기존 알림보다 미묘하고 새로운 문제를 더 잘 감지한다. 현대 소프트웨어 시스템은 설계된 것보다 성장하는 경향이 강해지고 있으며, 시스템 규모 증가로 운영자의 코드 이해도는 감소하고 있다. 기존 모니터링은 어렵고 비용이 많이 들며 숙련된 인력과 경험이 필요한데, 에이전트가 이 분야을 근본적으로 바꿀 수 있다. 전체 요약 14문장 읽기 → 048 18:11 ▲ 28 · 댓글 2 메모리 간섭 줄인 선형 어텐션, 장문맥 모델링에 강하다 KronLSTM이라는 새로운 선형 어텐션 아키텍처를 제안했으며, 크로네커 델타 규칙이라는 연관 행렬 메모리의 신규 업데이트 규칙을 기반으로 한다. AI · 머신러닝 · Kronecker Delta Rule for Long Context Linear Attention
Key Point 메모리 간섭을 크게 줄이면서 안정성까지 갖춘 선형 어텐션이 장문맥 모델링 성능에서 기존 방식을 앞서면서, 대형 언어모델의 효율적인 장문맥 처리 방식이 진화하고 있음을 보여준다.
핵심 요약
KronLSTM이라는 새로운 선형 어텐션 아키텍처를 제안했으며, 크로네커 델타 규칙이라는 연관 행렬 메모리의 신규 업데이트 규칙을 기반으로 한다. xLSTM 계열을 확장해 메모리 수정 메커니즘을 추가했으며, 특정 연관성을 정정하면서도 행렬 공간의 단일 방향으로만 메모리를 변경한다. 이러한 최소한의 침습적 메모리 수정 방식은 기존 델타 규칙 업데이트 대비 이전에 저장된 정보와의 간섭을 줄여 장문맥 언어 모델링에 적합하다. 전체 요약 8문장 읽기 → 049 18:11 ▲ 17 · 댓글 2 LLM 에이전트의 물리적 자기개선, 어떻게 가능할까 LLM 기반 로봇 에이전트의 물리적 자기개선(Physical RSI) 메커니즘을 체계적으로 분석한 연구다. AI · 머신러닝 · Where is Physical RSI capability from? An Observational Scaling Law of LLM-as-policy
Key Point 로봇 조작 같은 물리적 환경에서 LLM 에이전트가 스스로 개선되는 원리를 정량 분석해, 대규모 언어 모델의 실제 강화학습 적용 가능성을 예측할 수 있는 기초를 제공한다.
핵심 요약
LLM 기반 로봇 에이전트의 물리적 자기개선(Physical RSI) 메커니즘을 체계적으로 분석한 연구다. PhysRSI-eval이라는 평가 지표를 도입해 5개 축(첫 시도 성능, 효율성, 성공률, 예산, 실패 후 개선)으로 물리적 RSI를 정량화했다. 18개 로봇 조작 작업에서 다양한 VLM(시각 언어 모델)을 같은 상호작용 예산 내에서 평가했으며, 공개 벤치마크 점수가 비슷해도 개선 양상은 크게 다를 수 있음을 확인했다. 전체 요약 7문장 읽기 → 050 18:11 ▲ 155 · 댓글 3 기초 모델에 메모리 능력을 내장한 MemT-1.0 공개 메모리를 모델 계산의 일부로 내재화하는 메모리 네이티브 기초 모델 MemT-1.0을 소개한다. AI · 머신러닝 · MemT-1.0: Towards Memory-Native Evolution
Key Point 장기 컨텍스트 처리 시 메모리 효율과 추론 속도를 동시에 개선하는 아키텍처로, 외부 검색에 의존하지 않고 내부 메모리만으로 작동하는 모델의 가능성을 보여준다.
핵심 요약
메모리를 모델 계산의 일부로 내재화하는 메모리 네이티브 기초 모델 MemT-1.0을 소개한다. Metis를 기반으로 Gated DeltaNet-2 아키텍처를 채용하며, 턴마다 안정적인 토큰 수준 메모리 업데이트 메커니즘을 사용한다. 메모리 용량 확장을 위해 Mixture-of-Storage를 도입했다. 전체 요약 8문장 읽기 → 051 06:11 ▲ 11 · 댓글 3 언어모델 학습, 중간 계산 구조까지 모방하는 방식 제시 기존 온폴리시 증류(OPD) 방식은 학생 모델이 자신의 정책에서 샘플한 접두사에 대해 출력만 감독하며, 교사 모델의 중간 계산 과정은 전이하지 못한다는 문제가 있다. AI · 머신러닝 · OPMD: On-Policy Mechanism Distillation Beyond Output Supervision
Key Point 출력 공간의 감독을 넘어 모델의 내부 계산 구조를 직접 전이하는 새로운 증류 방식으로, 학생 모델의 추론 능력과 학습 효율을 근본적으로 향상시키는 접근법입니다.
핵심 요약
기존 온폴리시 증류(OPD) 방식은 학생 모델이 자신의 정책에서 샘플한 접두사에 대해 출력만 감독하며, 교사 모델의 중간 계산 과정은 전이하지 못한다는 문제가 있다. 표현 매칭 같은 단순한 중간 계층 증류는 불충분한데, 교사와 학생의 표현이 기하학적으로 다를 수 있고 정렬된 은닉 상태도 학생의 후속 계산에 사용 불가능할 수 있기 때문이다. 연구진은 온폴리시 메커니즘 증류(OPMD)를 제안하여, 학생이 실제로 사용 가능하도록 교사 표현을 학생의 중간 상태로 변환하는 학생 호환 교사를 먼저 구축한다. 전체 요약 6문장 읽기 → 052 18:11 ▲ 116 · 댓글 3 결과로만 평가하면 놓치는 AI 에이전트의 실제 역량 LLM 에이전트를 평가할 때 최종 결과만으로는 그 역량을 제대로 파악할 수 없다는 문제를 제시한다. AI · 머신러닝 · LiveMACE: Process-Aware Evaluation of LLM Agent Capabilities in Evolving Markets
Key Point 최종 수익만 비교하면 AI 에이전트의 의사결정 역량 차이를 놓치는 문제를 실증적으로 밝혔으며, 실제 역량과 성과의 불일치를 가시화하는 진단 방식이 필요함을 보여준다.
핵심 요약
LLM 에이전트를 평가할 때 최종 결과만으로는 그 역량을 제대로 파악할 수 없다는 문제를 제시한다. LiveMACEBench라는 새로운 벤치마크를 제안하며, 실시간 금융 시장을 자연스럽게 변화하는 테스트 환경으로 삼아 지속적인 LLM 에이전트를 평가한다. GPT-4, Claude, Gemini 등 5개 최신 LLM이 Tool Use, Persistent Memory, Rule Following, Multi-Agent Collaboration 등 동일한 조건으로 30일간 실시간 평가를 받았다. 전체 요약 6문장 읽기 → 053 15:11 ▲ 14 · 댓글 2 AI가 과학 가설을 반복 학습으로 발견하는 DiscoveryRSI 과학 발견에서 검증 가능한 가설을 개발하는 과정을 자동화하기 위해 DiscoveryRSI 프레임워크를 제안했다. AI · 머신러닝 · DiscoveryRSI: Recursively Learning to Discover Valuable Hypotheses
Key Point 과학적 가설의 품질 평가와 선택을 AI가 자동으로 수행하면서 연구자들의 발견 과정이 어떻게 달라질 수 있는지 보여주는 구체적 시도이다.
핵심 요약
과학 발견에서 검증 가능한 가설을 개발하는 과정을 자동화하기 위해 DiscoveryRSI 프레임워크를 제안했다. 가설은 근거 있는 주장, 실행 가능한 조사 방법, 판정 기준, 대안적 설명으로 정의되며, 다중 에이전트 진화 탐색으로 가설 트리를 구축한다. 세 가지 재귀적 학습 메커니즘으로 동작한다: 가설 신용 최적화는 연구 기여도를 평가하고, 학습 리플레이는 생산적 전략과 실패 패턴을 식별하며, 재발견은 개선 사항을 새로운 조사에 적용한다. 전체 요약 7문장 읽기 → 054 15:11 ▲ 43 · 댓글 3 로봇 행동 예측 AI, 시각 정보 처리 30배 효율화 기존 World Action Model(WAM)은 비디오와 행동 전문가를 밀집한 Mixture-of-Transformers 주의 메커니즘으로 결합해 관련 없는 시각 정보 노출과 중복 계산 문제를 야기했다. AI · 머신러닝 · BridgeWAM: Bridging Video and Action Experts via Latent Bridge Queries
Key Point 로봇 행동 모델의 계산 효율을 대폭 개선하면서 성능은 유지하는 기술로, 로봇 제어 AI의 실시간성과 비용 효율성을 높이는 방향을 제시한다.
핵심 요약
기존 World Action Model(WAM)은 비디오와 행동 전문가를 밀집한 Mixture-of-Transformers 주의 메커니즘으로 결합해 관련 없는 시각 정보 노출과 중복 계산 문제를 야기했다. BridgeWAM은 시각·언어·고유감각 정보를 32개의 Latent Bridge Queries(LBQs)를 통해 제한된 공유 잠재 공간으로 집약하는 Bridge-of-Experts 구조를 도입했다. 행동 예측 그래디언트가 비디오 전문가를 행동 예측에 적합한 표현으로 유도하고, 행동 전문가는 교차 주의를 통해 작업 관련 정보를 선택적으로 검색한다. 전체 요약 7문장 읽기 → 055 12:11 ▲ 100 · 댓글 78 LLM이 못 읽게 설계한 프로그래밍 언어 'KillSwitch' 개발 개발자는 LLM이 코드를 정말 이해하는지, 아니면 학습 데이터 기억에만 의존하는지 확인하기 위해 언어 모델을 혼동하도록 설계된 프로그래밍 언어 KillSwitch를 만들었다. AI · 머신러닝 · I built a programming language that LLMs can't use
Key Point LLM이 정말 코드를 이해하는지, 아니면 패턴 매칭만 하는지 검증하는 새로운 벤치마크로, 최신 AI 모델의 실제 능력을 평가하는 관점을 제시한다.
핵심 요약
개발자는 LLM이 코드를 정말 이해하는지, 아니면 학습 데이터 기억에만 의존하는지 확인하기 위해 언어 모델을 혼동하도록 설계된 프로그래밍 언어 KillSwitch를 만들었다. KillSwitch는 스택 기반의 해석형 언어로 함수, 변수, 조건문만 지원하지만, LLM을 속이도록 여러 특징을 포함한다. 언어 스펙에 거짓 정보를 숨겨두고, 문자 개수 세기를 규칙으로 사용하며, 'hack into a computer' 같은 안전장치 트리거 구문을 포함하고, 대부분이 노이즈인 스크립트로 구성된다. 전체 요약 8문장 읽기 → 056 09:11 ▲ 101 · 댓글 17 Free Pascal, 동적 패키지 지원 추가 Free Pascal 컴파일러와 Lazarus IDE가 동적 패키지(Dynamic Packages) 기능을 완전히 지원하게 되었다. 오픈소스 · 도구 · Free Pascal compiler now supports dynamic packages
Key Point Free Pascal 생태계에서 오랫동안 요청받아온 동적 패키지가 드디어 완전히 구현되어, IDE 재빌드 없이 플러그인을 동적으로 설치하고 실행 중 교체할 수 있게 됨으로써 개발 효율이 크게 향상된다.
핵심 요약
Free Pascal 컴파일러와 Lazarus IDE가 동적 패키지(Dynamic Packages) 기능을 완전히 지원하게 되었다. 동적 패키지를 통해 IDE를 재빌드하지 않고도 컴포넌트, 제어 요소, 확장 기능을 몇 초 안에 설치할 수 있으며, 프로그램 실행 중 플러그인 시스템을 만들 수도 있다. Linux, Windows, macOS에서 표준 공유 라이브러리 파일로 구현되며, 컴파일러가 생성한 메타데이터를 포함하여 런타임에 검사하고 조회할 수 있다. 전체 요약 12문장 읽기 → 057 00:11 새 버전 FastAPI 0.144.0 출시, 웹소켓 보안 의존성 지원 FastAPI 0.144.0이 출시되었다. 웹 · 프론트엔드 · fastapi/fastapi@0.144.0
Key Point 웹소켓 통신에 표준화된 보안 검증 메커니즘이 적용되면서 실시간 애플리케이션의 인증 구현이 간소화된다.
핵심 요약
FastAPI 0.144.0이 출시되었다. 웹소켓 엔드포인트에서 보안 의존성(Security Dependencies)을 사용할 수 있도록 지원을 추가했다. 이를 통해 웹소켓 연결에 대한 인증과 권한 검증을 동일한 방식으로 수행할 수 있게 되었다. 058 12:10 ▲ 10 · 댓글 2 GQA의 3가지 딜레마를 동시에 푸는 Virtual Head Attention 긴 문맥 처리 시 KV 캐시 크기, 학습·프리필 연산량, 모델 품질을 동시에 개선하기는 어렵다는 '불가능의 삼각형'에 직면한 어텐션 메커니즘 설계에 대응하기 위해 Virtual Head Attention(VHA)을 제안한다. AI · 머신러닝 · Virtual Head Attention
Key Point KV 캐시 메모리와 학습 효율, 모델 품질의 균형을 동시에 달성해야 하는 LLM 개발자들이 GQA의 근본적 한계를 극복할 수 있는 방법을 제시합니다.
핵심 요약
긴 문맥 처리 시 KV 캐시 크기, 학습·프리필 연산량, 모델 품질을 동시에 개선하기는 어렵다는 '불가능의 삼각형'에 직면한 어텐션 메커니즘 설계에 대응하기 위해 Virtual Head Attention(VHA)을 제안한다. VHA는 두 개의 경량 선형 연산으로 구성되는데, Q Premix가 쿼리 헤드 개수를 절반으로 줄인 상태에서 KV 그룹 내 가상 헤드 다양성을 복구하고, Linear Postmix가 낮은 순위의 I + AB^top 잔여 구조를 통해 헤드 간 특징을 융합한다. VHA는 비선형 연산을 도입하지 않으므로 Premix와 Postmix를 추론 시간에 각각 쿼리 프로젝션과 출력 프로젝션으로 폴드할 수 있어, 표준 GQA-2 아키텍처로 축약되면서 기존의 모든 GQA 추론 최적화를 직접 재사용할 수 있다. 전체 요약 6문장 읽기 → 059 03:11 ▲ 120 · 댓글 101 세마글루타이드, 생물학적 노화 속도 9% 둔화시켜 GLP-1 약물인 세마글루타이드(오젬픽·웨고비)가 HIV 환자 108명을 대상으로 한 32주 임상시험에서 생물학적 노화 마커 축적을 유의미하게 감소시켰으며, 이는 Nature Communications에 발표됐다. AI · 머신러닝 · GLP-1 may slow biological aging
Key Point HIV 환자에 국한되지 않고 일반 인구에도 적용 가능한 노화 둔화 메커니즘이 입증됐으며, 새로운 GLP-1 약물들이 노화 생물학에 미치는 영향을 비교 연구할 기회가 생겼기 때문이다.
핵심 요약
GLP-1 약물인 세마글루타이드(오젬픽·웨고비)가 HIV 환자 108명을 대상으로 한 32주 임상시험에서 생물학적 노화 마커 축적을 유의미하게 감소시켰으며, 이는 Nature Communications에 발표됐다. 연구진은 DNA 메틸화를 측정하는 에피제네틱 시계를 사용해 염증, 혈액, 뇌, 심장, 신장, 간, 대사 건강과 연관된 세포 노화를 추적했다. 세마글루타이드 투여군은 대조군 대비 DunedinPACE 에피제네틱 시계로 측정한 생물학적 노화 속도가 9% 느렸고, PCGrimAge 시계로 측정한 모든 원인 사망 위험과 관련된 생물학적 과정도 유의미하게 둔화됐다. 전체 요약 11문장 읽기 → 060 21:11 ▲ 107 · 댓글 80 셀룰로스와 단백질로 강화한 '슈퍼 얼음', 콘크리트 수준의 강도 달성 히브리 대학 연구팀이 식물 기반 셀룰로스 나노크리스탈과 CBM3a-AFPIII 단백질을 얼음에 첨가해 BioPykrete라는 신소재를 개발했다. 하드웨어 · 시스템 · New 'super ice' 10 times stronger, bringing it close to the strength of concrete
Key Point 극지방 건설과 저탄소 건축재료 개발이 주목받는 가운데, 얼음과 생분해성 단백질만으로 콘크리트 수준의 강도를 낸 신소재의 개발 과정과 한계를 알 수 있습니다.
핵심 요약
히브리 대학 연구팀이 식물 기반 셀룰로스 나노크리스탈과 CBM3a-AFPIII 단백질을 얼음에 첨가해 BioPykrete라는 신소재를 개발했다. 이 신소재는 일반 얼음보다 10배 강하며 파괴되기 전에 70배 더 많은 에너지를 흡수할 수 있다. 기존 Pykrete(목재펄프 강화 얼음)와 달리, 셀룰로스 나노크리스탈이 분자 수준에서 균열 확산을 막는 미세 보강제 역할을 하고, CBM3a-AFPIII 단백질이 접착제로 작용한다. 전체 요약 8문장 읽기 → 061 03:11 ▲ 11 · 댓글 2 선형 시간 희소 어텐션으로 컨텍스트 길이 확장하기 선형 시간 시퀀스 모델들은 고정된 크기의 상태에 정보를 저장하기 때문에 장문맥 처리에 제약이 있고, 전체 어텐션을 추가하면 이차 비용이 발생한다. AI · 머신러닝 · FreeSolo: Linear-time Sparse Attention with Zero-Shot Length Extrapolation
Key Point 트랜스포머의 근본적 한계인 이차 복잡도 문제를 해결하면서도 학습 데이터보다 긴 입력에서도 작동하는 새로운 어텐션 메커니즘의 제안으로, LLM의 컨텍스트 길이 확장이 시급한 현실에서 실질적 개선을 제시한다.
핵심 요약
선형 시간 시퀀스 모델들은 고정된 크기의 상태에 정보를 저장하기 때문에 장문맥 처리에 제약이 있고, 전체 어텐션을 추가하면 이차 비용이 발생한다. 지속적 사전학습(CPT)을 통한 희소 어텐션은 컨텍스트 길이를 늘릴 수 있지만 학습된 길이를 넘어 일반화하기 어렵고 비용이 크다. FreeSolo는 단거리 슬라이딩 윈도우 분기와 키포인트 셀을 선택하는 장거리 분기로 구성된 네이티브 희소 어텐션 메커니즘이다. 전체 요약 6문장 읽기 → 062 18:11 ▲ 137 · 댓글 83 퍼즐 게임의 극단, 500시간 분량의 '싱킹 스타의 기사단' Braid 개발사 Thekla의 신작 퍼즐 게임 '싱킹 스타의 기사단'은 공식적으로 500시간 규모의 게임으로 홍보되고 있으며, 한 달간 20시간 이상 플레이해도 전체 규모의 극히 일부만 경험할 수 있다. 기타 · '500-hour' Order of the Sinking Star is as complex and exhausting as it sounds
Key Point 500시간 규모의 초대형 퍼즐 게임이 출시를 앞두고 있으며, 공개된 리뷰에서 뛰어난 디자인과 심각한 피로도 설계, 그리고 개발사 Jonathan Blow의 언행과 게임의 메시지 사이 모순을 모두 지적하고 있어 구매 전 참고할 사항들이 복합적으로 담겨 있다.
핵심 요약
Braid 개발사 Thekla의 신작 퍼즐 게임 '싱킹 스타의 기사단'은 공식적으로 500시간 규모의 게임으로 홍보되고 있으며, 한 달간 20시간 이상 플레이해도 전체 규모의 극히 일부만 경험할 수 있다. 게임은 Sokoban 장르의 네 가지 인디 게임(Mirror Isles, Promesst, Heroes of Sokoban, Skipping Stones to Lonely Homes)의 메커니즘을 오픈월드 맵에 결합한 구조로, 각 방향에서 한 게임씩을 기본으로 하고 대각선 방향으로 진행하며 여러 메커니즘이 혼합된 퍼즐을 만난다. 퍼즐 디자인은 뛰어나며 서로 다른 게임의 아이디어들이 조화롭게 섞여 있으나, 게임은 난이도가 계속 상승하기만 하고 정신적 휴식이 거의 없으며 한 번 틀린 수를 두면 그것을 알아차리지 못할 수 있다는 문제가 있다. 전체 요약 12문장 읽기 → 063 15:11 ▲ 10 · 댓글 2 강화학습으로 추론을 최적화한 의사결정 AI 모델 공개 Hugging Face에서 0.8B부터 27B까지 매개변수 규모의 의사결정 모델 'StartLux-Decision'을 발표했다. AI · 머신러닝 · StartLux-Decision: AutoThink Decision Models with Reinforcement Learning for Calibrated Deliberative Decisions
Key Point 추론 비용을 크게 줄이면서도 정확도를 유지하는 강화학습 기법이 도입되어 실무 배포 시 비용 효율성이 개선된다.
핵심 요약
Hugging Face에서 0.8B부터 27B까지 매개변수 규모의 의사결정 모델 'StartLux-Decision'을 발표했다. Instant 모델은 양방향 주의 메커니즘으로 단일 패스 추론 속도를 유지하면서 정확도를 높이고, AutoThink 모델은 불확실한 결정에만 명시적 추론을 수행하고 확신 있는 경우는 직접 답한다. 3단계 훈련 파이프라인으로 공통 의사결정 능력을 먼저 확립한 뒤 두 모델 변형을 특화하고, 추론 지도학습과 강화학습으로 AutoThink에 추론 능력을 부여한다. 전체 요약 9문장 읽기 → 064 15:11 ▲ 18 · 댓글 2 실제 버그 수정에서 배우는 AI 코딩 평가 데이터셋 생성 코딩 에이전트 성능 평가를 위해 현실적이고 다양한 소프트웨어 엔지니어링(SWE) 과제가 필요하지만, 수동 작성으로는 생산 속도가 느리고 비용이 높다. AI · 머신러닝 · SWE-at-Scale: Scalable Issue Synthesis from Historical Bug Fixes
Key Point AI 코딩 에이전트의 진정한 능력을 평가하려면 실제 버그의 복잡성을 반영한 다양한 평가 데이터가 필요한데, 이 연구가 역공학 기반의 자동 생성 방법을 제시했기 때문입니다.
핵심 요약
코딩 에이전트 성능 평가를 위해 현실적이고 다양한 소프트웨어 엔지니어링(SWE) 과제가 필요하지만, 수동 작성으로는 생산 속도가 느리고 비용이 높다. 기존 합성 방식들은 사전학습된 모델 지식과 휴리스틱 프롬프팅에만 의존해 실제 소프트웨어 결함의 복잡한 메커니즘을 제대로 포착하지 못한다. SWE-at-Scale은 과거의 실제 버그 수정 이력을 역공학하여 현실적인 이슈를 자동으로 합성하는 프레임워크다. 전체 요약 8문장 읽기 → 065 15:11 ▲ 668 · 댓글 4 RL 학습 과정의 중간 체크포인트로 정책 이동 검증하기 기존 정책 이동 증류(policy-shift distillation)는 강화학습으로 학습한 교사 모델의 초기-최종 로짓 차이만 학생에게 전달하는데, 이는 학습 과정 중 행동 선호도가 일관되게 변했는지 알 수 없다. AI · 머신러닝 · Waypoint-OPD: Transferring RL-Induced Policy Shifts via Gated On-Policy Distillation
Key Point 강화학습으로 개선된 모델의 지식을 효율적으로 전이할 때 단순히 최종 결과만 보는 게 아니라 학습 과정의 일관성을 검증해야 더 좋은 결과를 얻을 수 있다.
핵심 요약
기존 정책 이동 증류(policy-shift distillation)는 강화학습으로 학습한 교사 모델의 초기-최종 로짓 차이만 학생에게 전달하는데, 이는 학습 과정 중 행동 선호도가 일관되게 변했는지 알 수 없다. 같은 최종 변화라도 초기와 후기의 이동이 서로 상쇄될 수 있어 신뢰할 수 없다. Waypoint-OPD 방법은 교사 모델의 중간 체크포인트를 사용해 초기(시작→중간)와 후기(중간→최종) 정책 이동을 비교한다. 전체 요약 9문장 읽기 → 066 15:11 ▲ 201 · 댓글 7 AI 에이전트가 자기 자신을 개선하는 프레임워크 모델 가중치는 고정한 채 프롬프트, 메모리, 워크플로우, 실행 가능한 컴포넌트 같은 에이전트 소프트웨어를 자동으로 수정하는 프레임워크를 제시한다. AI · 머신러닝 · Self-Evolving Agent Harness
Key Point AI 에이전트가 모델을 바꾸지 않고도 스스로의 동작을 개선하는 구체적인 방법론과 이론이 담겨 있어, AI 시스템의 자동 최적화와 신뢰성 검증에 관심 있는 연구자와 개발자가 반드시 봐야 한다.
핵심 요약
모델 가중치는 고정한 채 프롬프트, 메모리, 워크플로우, 실행 가능한 컴포넌트 같은 에이전트 소프트웨어를 자동으로 수정하는 프레임워크를 제시한다. 피드백 기반 프로세스를 형식화하여 승인된 수정사항이 계속 유지되도록 하고, 업데이트 대상을 제안·승인 메커니즘과 분리했다. 해석된 상태 변화와 도구·코드 수정, 저장소 제어 논리, 플러그인 구성을 구별하여 관리한다. 전체 요약 8문장 읽기 → 067 12:11 ▲ 10 · 댓글 1 카메라 기하학 정보로 로봇 비전-언어 모델의 다중 카메라 성능 향상 Vision-language-action(VLA) 모델은 로봇 조작에 의미론적 지식을 제공하지만, 시각 표현이 2D 이미지 좌표에 기반해 다중 카메라 시스템의 기하학적 관계를 활용하지 못한다. AI · 머신러닝 · G^3VLA: Geometric Inductive Bias for Vision-Language-Action Models
Key Point 로봇 비전 모델이 다중 카메라 시스템의 기하학적 관계를 명시적으로 활용하는 방법을 제시하여, 실제 로봇 시스템에서 카메라 수와 각도에 관계없이 안정적인 성능을 달성할 수 있게 한다.
핵심 요약
Vision-language-action(VLA) 모델은 로봇 조작에 의미론적 지식을 제공하지만, 시각 표현이 2D 이미지 좌표에 기반해 다중 카메라 시스템의 기하학적 관계를 활용하지 못한다. G³VLA는 카메라 내부 파라미터와 외부 파라미터를 이용한 기하학적 모듈로, 사전학습된 VLA의 시각 토큰 스트림에 보정된 카메라 구조를 주입한다. 내부 파라미터 조건 광선 임베딩(ray embedding), 투영 위치 인코딩(PRoPE), 양방향 교차 뷰 융합을 결합해 카메라 뷰 간 기하학적으로 일관된 표현을 구축한다. 전체 요약 8문장 읽기 → 068 06:11 ▲ 365 · 댓글 119 신경망은 이미 깨끗하다 신경망이 임의로 얽혀 있다고 여겨졌던 것은 다중의미성(polysemanticity)과 중첩(superposition) 때문이라는 기존 해석이 오류였으며, 실제로는 '재귀적 일반화'라는 훨씬 덜 우려스러운 현상이었다고 주장한다. AI · 머신러닝 · Neural networks are clean
Key Point 신경망의 내부 구조가 우리가 생각하는 것보다 훨씬 깨끗하고 이해 가능하다는 주장이 기존의 '해석 불가능한 검은 상자' 관념을 근본적으로 뒤집으며, 기계 학습의 해석가능성 연구에 새로운 방향을 제시한다.
핵심 요약
신경망이 임의로 얽혀 있다고 여겨졌던 것은 다중의미성(polysemanticity)과 중첩(superposition) 때문이라는 기존 해석이 오류였으며, 실제로는 '재귀적 일반화'라는 훨씬 덜 우려스러운 현상이었다고 주장한다. InceptionV1 같은 초기 이미지 모델에서 고양이 얼굴과 자동차 앞면 모두에 반응하던 신경원은 임의의 조합이 아니라 V자 모양이라는 공통 특징을 감지하고 있었다. 아키텍처 개선으로 InceptionV1의 마지막 레이어에서 해석 불가능한 신경원이 거의 없던 것이 99-100% 해석 가능하게 바뀌었으며, 모델 크기와 학습 데이터는 변하지 않았다. 전체 요약 12문장 읽기 → 069 03:12 ▲ 16 · 댓글 2 LLM 에이전트, 사용자 감정 변화에 취약하다 장시간의 도구 호출 작업에서 LLM 에이전트는 도구 사용 오류뿐만 아니라 사용자와의 비효율적인 상호작용으로도 실패한다. AI · 머신러닝 · τ-Emotion-Bench: Exposing the Interaction Fragility of LLM Agents through Real-World User Emotions
Key Point 현실의 사용자 감정 변화가 LLM 에이전트의 신뢰성을 심각하게 흔드는 취약점을 처음으로 체계적으로 측정하고, 이를 개선하기 위한 학습 방법을 제시한다.
핵심 요약
장시간의 도구 호출 작업에서 LLM 에이전트는 도구 사용 오류뿐만 아니라 사용자와의 비효율적인 상호작용으로도 실패한다. 기존 벤치마크는 협조적이고 안정적인 사용자를 가정하고 있어 감정 변화가 에이전트 신뢰성에 미치는 영향을 제대로 평가하지 못했다. τ-Emotion-Bench는 10개 도메인에서 감정 조건부 사용자 상호작용 하에서 도구 호출 에이전트를 평가하는 벤치마크를 제시한다. 전체 요약 8문장 읽기 → 070 03:12 ▲ 14 · 댓글 2 AI 에이전트 스킬 소유권 보호하는 워터마크 기법 AI 에이전트의 스킬(작업 절차와 전문지식)은 평문으로 배포되면서 무단 복제와 유출에 노출되어 있으나, 소유권 검증과 유출 추적 메커니즘이 미흡한 상태다. AI · 머신러닝 · SkillMarker: A KGW-Based Watermarking Method for Agent Skill Ownership Verification
Key Point AI 에이전트 기술이 비즈니스 자산화하면서 개발사들이 자신의 스킬(프롬프트·작업흐름) 도용을 막을 수 있는 기술적 근거를 갖추게 되었습니다.
핵심 요약
AI 에이전트의 스킬(작업 절차와 전문지식)은 평문으로 배포되면서 무단 복제와 유출에 노출되어 있으나, 소유권 검증과 유출 추적 메커니즘이 미흡한 상태다. 이를 해결하기 위해 KGW 기반 워터마킹 기법인 SkillMarker를 제안했으며, 기능 보존과 강력한 워터마크 삽입을 동시에 달성한다. SkillMarker는 품질 제약 조건하에서 본질 지식과 표현 방식을 분리하는 리라이팅으로 명령의 충실도를 유지한다. 전체 요약 6문장 읽기 → 071 00:11 ▲ 19 · 댓글 2 과학 AI 에이전트 군단이 스스로 진화하며 학습한다 과학 연구의 재귀적 자기 개선(RSI)을 위해 과학 에이전트 군단이 실험 경험을 통해 연구 능력을 향상시키는 것을 목표로 한다. AI · 머신러닝 · SwarmRSI: Recursive Self-Improvement through Evolving Scientific Agent Swarm
Key Point 과학 연구 자동화를 추구하는 개발자와 연구자들이 AI 에이전트 간 협력과 피드백 기반 자기 개선이 어떻게 실제 과학 문제 해결에 활용되는지 알아야 한다.
핵심 요약
과학 연구의 재귀적 자기 개선(RSI)을 위해 과학 에이전트 군단이 실험 경험을 통해 연구 능력을 향상시키는 것을 목표로 한다. 기존 접근의 문제점은 실패한 실험 결과가 가설 오류인지 구현 오류인지 불분명하고, 전체 점수가 다른 에이전트에 유용한 부분 결과를 가린다는 것이다. SwarmRSI는 피드백 기반 군단 변이(Feedback-Guided Swarm Mutation)로 다른 에이전트의 실험 결과를 이용해 가설과 구현을 개선한다. 전체 요약 7문장 읽기 → 072 00:11 ▲ 24 · 댓글 2 LLM 강화학습의 숨은 함정, "사고 누출" 현상 밝혀지다 Qwen3 같은 하이브리드 추론 모델은 채팅 템플릿 토큰으로 THINK 모드와 NO-THINK 모드를 전환하며, NO-THINK 모드에서 강화학습(GRPO)으로 훈련하면 추론 성능이 향상된다고 보고돼왔다. AI · 머신러닝 · The Thinking Leakage in Reinforcement Learning for LLMs
Key Point 하이브리드 추론 모델의 강화학습 개선이 실제로는 새로운 능력 학습이 아닌 기존 능력의 재활성화일 수 있다는 점이 모델 평가와 개선 방향에 실제 영향을 미친다.
핵심 요약
Qwen3 같은 하이브리드 추론 모델은 채팅 템플릿 토큰으로 THINK 모드와 NO-THINK 모드를 전환하며, NO-THINK 모드에서 강화학습(GRPO)으로 훈련하면 추론 성능이 향상된다고 보고돼왔다. 연구진이 Qwen3-1.7B, 4B, 8B를 NO-THINK 모드에서 GRPO로 훈련한 결과, 성능 향상의 대부분이 '사고 누출(thinking leakage)'로 설명됨을 발견했다. 정확도가 높아지면서 응답이 더 길어지고 숙고적이 되며, 원본 모델의 THINK 모드 특성을 닮아가고, 모델 내부 활성화가 THINK 모드로 이동한다. 전체 요약 7문장 읽기 → 073 12:11 ▲ 15 · 댓글 2 Few-Step 확산 모델, 간단한 회귀만으로 빠르게 확산 및 흐름 모델의 샘플링 비용을 줄이는 Few-Step 디스틸레이션은 보조 점수 모델이나 특수 아키텍처가 필요했으나, 단순 On-Policy 속도 회귀만으로 4-NFE 생성에 충분함을 보였다. AI · 머신러닝 · Simplifying and Improving On-Policy Distillation for Few-Step Diffusion
Key Point 복잡한 별도 모듈 없이 기본 회귀로 few-step 생성의 품질을 올릴 수 있다면, 실제 배포 환경에서 확산 모델의 속도를 크게 개선하려는 팀들에게 직접적인 영향을 줄 것이다.
핵심 요약
확산 및 흐름 모델의 샘플링 비용을 줄이는 Few-Step 디스틸레이션은 보조 점수 모델이나 특수 아키텍처가 필요했으나, 단순 On-Policy 속도 회귀만으로 4-NFE 생성에 충분함을 보였다. 교사 모델의 각 구간 내 속도 변화를 표현하기 위해 학생의 구간 평균 예측에서 국소 보정을 분리하는 학습 전용 잔차 프록시 Pivot을 도입했다. 학생을 약한 교사 예측으로부터 멀어지게 하는 메커니즘을 추가해 원하지 않는 모드 회피를 돕는다. 전체 요약 7문장 읽기 → 074 12:11 ▲ 46 · 댓글 2 멀티모달 에이전트의 메모리 진화 방식 분석 프레임워크 멀티모달 AI 에이전트가 장기 과제와 평생 학습 환경에서 복잡한 다중 양식 데이터로부터 지속적으로 유용한 정보를 습득하는 것이 핵심 과제이다. AI · 머신러닝 · Seeing, Maintaining, and Learning: The Evolution of Multimodal Agent Memory
Key Point 멀티모달 AI 에이전트가 실제 환경에서 장기간 지속적으로 학습하려면 시간이 지나면서 진화하는 메모리 관리 체계가 필수적이며, 이 논문이 제시하는 분석 프레임워크는 현재 에이전트 시스템의 메모리 설계 방향을 제시한다.
핵심 요약
멀티모달 AI 에이전트가 장기 과제와 평생 학습 환경에서 복잡한 다중 양식 데이터로부터 지속적으로 유용한 정보를 습득하는 것이 핵심 과제이다. 논문은 멀티모달 에이전트 메모리를 두 축으로 분석하는 프레임워크를 제안한다: 축1(Formation과 Representation)은 정보가 어떻게 형성되고 표현되는지, 축2(Memory Management)는 축적된 경험으로 어떻게 적응하는지를 다룬다. 축1에서는 어떤 정보를 유지하고 양식별 임베딩·텍스트 및 구조화된 기록·잠재 및 매개변수 표현으로 어떻게 인코딩하는지를 규명해 이후 추론과 행동을 지원한다. 전체 요약 6문장 읽기 → 075 09:11 ▲ 144 · 댓글 152 SpaceX의 스타링크 속도 제한, 우크라이나 드론 작전에 타격 SpaceX가 StarShield 군사 패키지의 이동 중인 터미널에 160km/h 속도 제한을 적용하기 시작했다. 인프라 · 데브옵스 · Starlink limit hits Ukraine's drones
Key Point SpaceX가 우크라이나 드론 운영의 핵심 통신 인프라를 원격으로 제한하면서, 민간 위성망에 의존하는 국가의 전략적 취약점을 드러냈다.
핵심 요약
SpaceX가 StarShield 군사 패키지의 이동 중인 터미널에 160km/h 속도 제한을 적용하기 시작했다. 스타링크는 드론의 항법 시스템이 아니라 명령 전달, 영상 송신, 원거리 조종 같은 통신 링크 역할을 한다. 스타링크 없이는 드론이 GNSS나 관성항법으로는 움직일 수 있지만 실시간 조종과 전술적 유연성을 잃게 된다. 전체 요약 11문장 읽기 → 076 06:11 ▲ 13 · 댓글 1 위험 개념은 분리하고 품질은 살리는 이미지 생성 모델 기존 이미지 생성 모델은 광범위한 미필터링 데이터로 학습하면 품질은 높지만 생성해서는 안 되는 개념도 학습하는 문제가 있다. AI · 머신러닝 · Pristine Models
Key Point 학습 데이터 필터링과 사후 제거 방식의 한계를 근본적으로 해결하는 새로운 아키텍처로, 안전성과 품질 사이의 오랜 트레이드오프를 학습 시점에서 구조적으로 해소하는 방법을 제시한다.
핵심 요약
기존 이미지 생성 모델은 광범위한 미필터링 데이터로 학습하면 품질은 높지만 생성해서는 안 되는 개념도 학습하는 문제가 있다. 안전한 데이터만으로 학습하면 위험 개념을 피할 수 있지만, 그 데이터에 포함된 유용한 지식도 함께 잃어서 품질이 떨어진다. 기존 방식들은 학습 후 개념 제거를 시도하는데, 제거할 개념이 많아질수록 파괴적인 망각(catastrophic forgetting)을 일으킨다. 전체 요약 8문장 읽기 → 077 00:11 ▲ 13 · 댓글 2 긴 문맥 이해를 위한 강화학습 프레임워크 LongR LLM의 장문맥 추론 능력을 강화하기 위해 강화학습(RL)을 적용하는 연구로, 기존의 희소한 결과 기반 보상만으로는 복잡한 추론을 효과적으로 유도하기 어렵다는 문제를 해결합니다. AI · 머신러닝 · LongR: Unleashing Long-Context Reasoning via Reinforcement Learning with Dense Utility Rewards
Key Point 장문맥 환경에서 LLM의 추론 능력을 강화하는 실질적인 방법을 제시하며, 기존 희소 보상 방식의 한계를 극복한 구체적인 해결책을 보여줍니다.
핵심 요약
LLM의 장문맥 추론 능력을 강화하기 위해 강화학습(RL)을 적용하는 연구로, 기존의 희소한 결과 기반 보상만으로는 복잡한 추론을 효과적으로 유도하기 어렵다는 문제를 해결합니다. 제안하는 LongR 프레임워크는 '생각과 읽기(Think-and-Read)' 메커니즘을 통해 추론 과정 중 필요할 때 문서를 참고하는 방식으로 작동합니다. 상대적 정보 이득(relative information gain)을 기반으로 한 맥락 기반 밀도 보상을 도입하여, 증거 주석 없이도 관련 문서의 유용성을 정량화합니다. 전체 요약 5문장 읽기 → 078 00:11 ▲ 352 · 댓글 329 아마존의 수수료 체계가 전체 인터넷 가격을 올린다 아마존은 판매자에게 2014년 약 19%의 수수료를 받았지만 현재는 판매액의 최대 50%까지 징수하고 있다. 스타트업 · 비즈니스 · Amazon pushes up prices across the Internet
Key Point 아마존의 수수료 구조와 공정가격 정책이 단순히 아마존 가격만 높이는 게 아니라, 다른 온라인 소매점과 매장에서의 가격까지 전체적으로 올리는 메커니즘을 구체적으로 보여준다.
핵심 요약
아마존은 판매자에게 2014년 약 19%의 수수료를 받았지만 현재는 판매액의 최대 50%까지 징수하고 있다. 기본 커미션(15%) 외에도 배송료, 광고비, 반품 처리비 등이 겹쳐 있으며, 선택적으로 보이지만 실제로는 아마존의 Prime 자격 획득과 광고가 필수에 가깝다. 판매자들은 이 높은 수수료로 인한 손실을 상품 가격 인상으로 보전해야 하며, 아마존의 '공정가격 정책'은 다른 곳에서 더 싼 가격으로 팔 수 없도록 강제한다. 전체 요약 8문장 읽기 → 079 21:11 ▲ 34 · 댓글 2 동영상 초고화질화, 일반 GPU로 4K 실시간 처리 가능해졌다 기존 동영상 초고화질화(VSR) 모델이 확산 증류를 통해 한 단계 생성으로 효율성을 높였으나, 고해상도 추론 비용이 크고 생성 결과가 사용자 선호와 맞추기 어려운 문제가 있었다. AI · 머신러닝 · FlashVSR+: Efficient Video Super-Resolution via Hybrid Attention and Reward-Yield Distribution Matching
Key Point 동영상 초고화질화가 실용적인 수준의 속도와 메모리 효율로 4K 고해상도 처리가 가능해지면서, 콘텐츠 제작자와 개발자들이 일반 사양 GPU에서도 고품질 영상 생성을 구현할 수 있게 되었다.
핵심 요약
기존 동영상 초고화질화(VSR) 모델이 확산 증류를 통해 한 단계 생성으로 효율성을 높였으나, 고해상도 추론 비용이 크고 생성 결과가 사용자 선호와 맞추기 어려운 문제가 있었다. FlashVSR+는 하이브리드 어텐션 메커니즘을 도입해 사전학습된 VSR 모델의 강한 지역성(locality)을 활용하면서 장거리 일관성을 위해 희소 전역 상호작용을 유지한다. 이를 통해 DiT 속도를 최대 2배 높이고 피크 메모리를 45% 감소시켜, RTX 4090 24GB 단일 GPU에서 타일 분할 없이 4K 영상 초고화질화를 가능하게 했다. 전체 요약 7문장 읽기 → 080 21:11 ▲ 46 · 댓글 1 고해상도 이미지 생성 가능한 경량 디퓨전 변환기 기법 디퓨전 변환기(DiT)가 학습 해상도를 넘어 이미지를 생성하려면 토큰 수가 급증해 전체 어텐션이 계산 비용이 높아지고, 구조 왜곡과 디테일 저하 문제가 발생한다. AI · 머신러닝 · AReA: Adaptive Receptive-Field Attention for Efficient High-Resolution Diffusion Transformers
Key Point 고해상도 이미지 생성 시 계산량 폭증 문제를 적응형 어텐션으로 해결한 방식으로, 추가 학습 없이 적용 가능하다는 점이 중요하다.
핵심 요약
디퓨전 변환기(DiT)가 학습 해상도를 넘어 이미지를 생성하려면 토큰 수가 급증해 전체 어텐션이 계산 비용이 높아지고, 구조 왜곡과 디테일 저하 문제가 발생한다. 균등한 전체 어텐션이 이 문제의 공통 원인인데, 모든 스텝에서 모든 토큰에 주목하면 이차 복잡도가 생기고 학습 범위를 벗어난 상대 거리에 노출되어 모델이 분포에서 벗어난다. 어텐션의 유효 수용 범위는 노이즈 제거 과정에서 좁혀지는데, 초반 스텝에서 전역적으로 구조를 형성하고 후반 스텝에서 국소적으로 세부를 정제한다. 전체 요약 6문장 읽기 → 081 18:11 ▲ 270 · 댓글 3 선택 문제의 구조를 존중하는 AI 모델 'Jeva' 제안 System One 모델은 낮은 지연시간의 의사결정을 가능하게 하지만, 기존 텍스트 직렬화 방식은 의사결정 문제의 구조를 충분히 반영하지 못한다. AI · 머신러닝 · Jeva: System One Models from First Principles
Key Point 선택지 기반 의사결정 시스템의 구조적 요구사항을 처음 체계적으로 정의하고 이를 만족하는 아키텍처를 제시하여, 추천·검색·순위 결정 등 실무 문제들을 근본적으로 다시 설계할 수 있는 접근법을 제공한다.
핵심 요약
System One 모델은 낮은 지연시간의 의사결정을 가능하게 하지만, 기존 텍스트 직렬화 방식은 의사결정 문제의 구조를 충분히 반영하지 못한다. 논문은 구조적으로 중요한 네 가지 요구사항을 제시한다: (i) null-aware(답변 부재를 후보 간 불확실성과 구별), (ii) permutation-invariant(대안의 순서 변경이 결정에 영향 없음), (iii) option-scalable(후보 집합 증가 시 출력 공간 재정의 불필요), (iv) cacheable(반복되는 대안에 대한 재사용 가능). 이를 해결하기 위해 Jeva 아키텍처를 제안한다. 공유 인코더가 요청과 각 선택지를 독립적으로 표현하고, 컴팩트 결정 스택이 불변의 선택지 메모리에 대해 요청 상태만 정제한다. 전체 요약 9문장 읽기 → 082 18:11 ▲ 66 · 댓글 1 흉부 X선 진단에 도구 활용한 AI 에이전트, ChestAgentBench서 최고 성능 흉부 X선(CXR) 해석은 직접 시각 인식만으로는 부족하며 외부 도구를 통한 증거 통합이 필요한데, 기존 도구 활용 의료 에이전트는 언제 보조 증거가 필요한지 학습하거나 부적절한 정량 데이터를 차단하는 명시적 메커니즘이 부족하다. AI · 머신러닝 · X-Ragent: Tool-Augmented Reinforcement Learning for Evidence-Grounded Chest X-Ray Reasoning
Key Point 의료 AI가 X선 이미지 분석 시 외부 측정 도구를 필요한 순간에만 올바르게 활용하는 방식을 개선함으로써, 의료 진단 시스템의 신뢰성과 설명 가능성을 높이는 구체적인 접근 방식을 제시합니다.
핵심 요약
흉부 X선(CXR) 해석은 직접 시각 인식만으로는 부족하며 외부 도구를 통한 증거 통합이 필요한데, 기존 도구 활용 의료 에이전트는 언제 보조 증거가 필요한지 학습하거나 부적절한 정량 데이터를 차단하는 명시적 메커니즘이 부족하다. 이를 해결하기 위해 X-Ragent라는 도구 활용 강화학습 후학습 프레임워크를 제안하며, 이는 보조 증거 수집과 타당성 검증 정량 측정 획득을 분리한다. 7.7K 샘플의 Rad-CoT 코퍼스를 구축해 인과관계 순서의 도구 활용 궤적과 보고서 양식 진단 추론을 결합했다. 전체 요약 7문장 읽기 → 083 15:11 ▲ 63 · 댓글 2 AI 에이전트의 '실행 가능한 3D 세계' 만드는 능력을 평가하는 벤치마크 공개 코딩 에이전트가 단순히 세계를 시각화하는 것을 넘어, 물리 법칙과 인과관계에 따라 동작하는 실행 가능한 코드 기반 세계를 구축하는 능력이 요구되고 있다. AI · 머신러닝 · ExeWorldBench: Benchmarking Code-Based Executable 3D World Modeling
Key Point AI가 물리 법칙을 이해하고 실제로 동작하는 세계를 코드로 만들 수 있는지 평가하는 새로운 기준이 생겼으며, 현재 모델들의 근본적 한계를 파악할 수 있다.
핵심 요약
코딩 에이전트가 단순히 세계를 시각화하는 것을 넘어, 물리 법칙과 인과관계에 따라 동작하는 실행 가능한 코드 기반 세계를 구축하는 능력이 요구되고 있다. 기존 벤치마크는 물리 추론, 시각적 충실도, 행동 정확성을 각각만 평가했으나, 이 세 가지를 통합적으로 평가하지 못했다. 이를 해결하기 위해 ExeWorldBench라는 첫 번째 포괄적 벤치마크를 제시했으며, 코드 기반 3D 세계 구축을 통해 세계 이해와 실행 가능한 구현을 평가한다. 전체 요약 5문장 읽기 → 084 15:11 ▲ 60 · 댓글 1 루브릭 기반 강화학습의 보상 해킹, 단계별 그룹화로 해결 루브릭 기반 강화학습(Rubric-RL)은 검증자 없이 언어모델을 훈련하는데, 각 평가 기준을 개별 점수로 합산하는 방식이 문제다. AI · 머신러닝 · Scoring Higher, Answering Worse: Mitigating Reward Hacking in Rubric-Based RL via Protocol-Level Rubrics
Key Point 루브릭 기반 강화학습에서 점수 조작을 방지하고 실제 품질을 높이는 구체적인 방법론이 제시되어, LLM 훈련에서 평가 메커니즘 설계의 중요성을 보여준다.
핵심 요약
루브릭 기반 강화학습(Rubric-RL)은 검증자 없이 언어모델을 훈련하는데, 각 평가 기준을 개별 점수로 합산하는 방식이 문제다. 합산식 집계에서는 기준들이 상호 보완되어, 중요한 결정을 놓친 정책도 불필요한 조언으로 점수를 메워 높은 평가를 받을 수 있다. 임상 상담 실험에서 이런 정책은 루브릭 커버리지는 높아졌지만 의사의 실제 판단 기준에서는 훈련 전 모델보다 성능이 떨어졌다. 전체 요약 7문장 읽기 → 085 09:11 ▲ 351 · 댓글 322 OpenAI 엔지니어, 임원진 회의실 도청 혐의로 체포 OpenAI 임원진이 사용하는 회의실에 녹음 장치를 숨긴 혐의로 사우디 국적의 엔지니어 Abdulrahman Alfozan(35)이 체포되어 연방법원에 출두했으며, 2025년 7월부터 OpenAI에서 근무해온 것으로 확인됐다. 보안 · OpenAI engineer arrested in bugging of executive conference room
Key Point OpenAI 같은 주요 AI 회사의 보안 사건이 구체적으로 어떤 방식으로 일어나는지, 엔지니어 자격의 내부자가 얼마나 정교한 도구와 계획으로 기술 정보에 접근하려 했는지 보여주는 사건입니다.
핵심 요약
OpenAI 임원진이 사용하는 회의실에 녹음 장치를 숨긴 혐의로 사우디 국적의 엔지니어 Abdulrahman Alfozan(35)이 체포되어 연방법원에 출두했으며, 2025년 7월부터 OpenAI에서 근무해온 것으로 확인됐다. 9월 30일 발견된 녹음 장치는 회의실 TV 뒤 USB 포트에 꽂혀 있었고 화장지로 위장되어 있었으며, 9월 28일경 설치된 것으로 추정되고 내용이 암호화되어 있었다. 감시 카메라 영상에 따르면 Alfozan은 설치 전 여러 차례 해당 회의실 근처에서 포착되었으나 그는 이 회의실에 들어갈 권한이 없었고, 회의실에서는 독점 연구, 제품 계획, 정부 관계 등 기밀 정보가 다뤄져 왔다. 전체 요약 12문장 읽기 → 086 06:11 ▲ 226 · 댓글 229 레져 지갑, 공급망 공격으로 암호화폐 도난 확인 레져가 말레이시아 리셀러 CryptoBilis를 통해 유통된 일부 기기에 하드웨어 임플란트가 숨겨져 있었다고 확인했으며, 이를 통해 사용자 암호화폐가 탈취되었다. 보안 · Ledger confirms spy chip implant behind wallet crypto thefts
Key Point 공급망을 통한 하드웨어 임플란트 공격이 물리적으로 어떻게 작동하고 얼마나 고도화되었는지 구체적으로 공개되었으며, 하드웨어 지갑 구매 시 신뢰할 수 있는 채널 선택의 중요성이 부각되었다.
핵심 요약
레져가 말레이시아 리셀러 CryptoBilis를 통해 유통된 일부 기기에 하드웨어 임플란트가 숨겨져 있었다고 확인했으며, 이를 통해 사용자 암호화폐가 탈취되었다. CryptoBilis는 동남아시아에서 운영되는 주요 하드웨어 지갑 리셀러이며, 9월 16일부터 변조된 기기들이 정가의 절반 수준으로 판매되고 있었다. 임플란트는 기기 디스플레이의 뒷부분에 숨겨져 있었으며, ST STM32G431KBU6 마이크로컨트롤러와 2×2mm 크기의 eSIM, LTE 모듈로 구성되어 있었다. 전체 요약 11문장 읽기 → 087 00:11 ▲ 10 · 댓글 2 다중 에이전트 로봇 협력 내비게이션 벤치마크 공개 비전-언어 내비게이션(VLN) 분야에서 단일 에이전트 기반 연구에서 벗어나 여러 로봇팀이 협력해 복잡한 작업을 수행하는 다중 에이전트 VLN 문제를 처음으로 체계적으로 정의했다. AI · 머신러닝 · Systematic Multi-Agent Vision-and-Language Navigation: Formulation, Benchmark, and Method
Key Point 로봇 팀의 협력 기반 자율 내비게이션은 창고 자동화·재난 대응 등 산업 응용에서 핵심 기술이며, 이 논문의 벤치마크는 다중 에이전트 협력 연구의 새로운 표준이 될 것으로 예상된다.
핵심 요약
비전-언어 내비게이션(VLN) 분야에서 단일 에이전트 기반 연구에서 벗어나 여러 로봇팀이 협력해 복잡한 작업을 수행하는 다중 에이전트 VLN 문제를 처음으로 체계적으로 정의했다. 의존성 제약(presence lock)과 자원 제약(holding chain)을 포함한 서브태스크로 구성된 미션을 좌표 조정 문제로 공식화했다. 145개 장면에 걸쳐 최대 4개 에이전트로 구성된 팀의 11,724개 에피소드를 포함한 MAVLN 벤치마크를 구축했다. 전체 요약 7문장 읽기 → 088 15:11 ▲ 183 · 댓글 26 단세포의 지능: 대장균의 화학주성 시스템 대장균의 화학주성(chemotaxis)은 뇌 없는 미생물이 화학 수용체로 영양분을 감지해 달려가거나 회전해 움직이는 기본적인 지능 현상이다. AI · 머신러닝 · The baffling intelligence of a single cell (2024)
Key Point 단세포 대장균의 화학주성 시스템은 신호 증폭·적응·메모리 저장·모터 제어를 정교한 단백질 상호작용으로 구현한 생물학적 컴퓨터로, 뇌와 신경계의 기본 원리를 미니어처로 보여준다.
핵심 요약
대장균의 화학주성(chemotaxis)은 뇌 없는 미생물이 화학 수용체로 영양분을 감지해 달려가거나 회전해 움직이는 기본적인 지능 현상이다. CheY라는 신호 분자가 수용체와 로터 사이를 오가며 인산화되어 로터를 뒤집는 방식으로 달리기(run)와 회전(tumble)의 비율을 조절한다. 신호 증폭 메커니즘으로 인해 2%의 수용체 점유 변화가 100%의 모터 출력 변화를 만들어 세포당 3개 미만의 분자도 감지할 수 있다. 전체 요약 12문장 읽기 → 089 12:11 ▲ 34 · 댓글 4 깊이 축 주의 메커니즘 확장으로 신경망 효율성 1.58배 향상 Attention Residuals(AttnRes)는 네트워크 깊이축을 따라 내용 기반 검색을 수행하는 메커니즘으로, 깊이축 단일스트림 소프트맥스 어텐션으로 볼 수 있습니다. AI · 머신러닝 · Multi-Stream Attention Residuals
Key Point 대규모 신경망의 효율성을 단순한 아키텍처 변경만으로 1.58배 향상시키는 방법을 제시하여 모델 학습과 배포 비용 절감에 직접 영향을 줄 수 있습니다.
핵심 요약
Attention Residuals(AttnRes)는 네트워크 깊이축을 따라 내용 기반 검색을 수행하는 메커니즘으로, 깊이축 단일스트림 소프트맥스 어텐션으로 볼 수 있습니다. 다중헤드 어텐션의 성공에 영감을 받아 Multi-Stream Attention Residuals(MSAR)을 제안했으며, 이는 AttnRes를 다중헤드 깊이 어텐션으로 확장한 것입니다. MSAR은 다중규모 인과 합성곱을 통해 시퀀스 문맥에서 스트림 다양성을 도출하여, 각 헤드가 서로 다른 문맥 관점을 통해 과거 표현을 검색할 수 있습니다. 전체 요약 6문장 읽기 → 090 12:11 ▲ 130 · 댓글 87 미사용 킨들을 AI로 사진 액자로 개조하기 쓰지 않던 킨들을 AI 에이전트로 개조하여 사진 액자로 만들었다. 처음에는 GPT-5.6 Sol과 Fable 5.1, Opus 5.5를 시도했지만, 데이터 저장 오류나 보안 차단으로 실패했다. AI · 머신러닝 · I turned my unused Kindle into a photo frame with GPT-6 Astra
Key Point AI 에이전트가 하드웨어 제어 코드를 작성하고 디버깅하는 실제 사례를 보여주며, 특히 자동화된 피드백 루프가 개발 효율을 어떻게 바꾸는지 실증한다.
핵심 요약
쓰지 않던 킨들을 AI 에이전트로 개조하여 사진 액자로 만들었다. 처음에는 GPT-5.6 Sol과 Fable 5.1, Opus 5.5를 시도했지만, 데이터 저장 오류나 보안 차단으로 실패했다. GPT-6 Astra로 전환한 후 SpiderCat 오픈소스 프로젝트를 참고하여 킨들 커스텀 도구인 KindleCTL을 개발했다. 에이전트가 Mac에서 킨들에 명령을 보내고, 파일을 전송하며, 에러를 진단할 수 있게 됐다. 초기에는 에이전트와의 수동 피드백(스크린샷 촬영)이 필요했지만, 로그 접근과 원격 화면 캡처를 자동화한 피드백 루프를 추가하면서 개발 속도가 크게 빨라졌다. 전체 요약 9문장 읽기 → 091 00:11 ▲ 103 · 댓글 76 주황색 고양이의 60년 미스터리, 드디어 풀렸다 스탠포드대와 규슈대 연구팀이 독립적으로 주황색 고양이 털의 원인을 밝혔다. 기타 · Secret of Orange Cats Revealed After 60-Year Search
Key Point 60년 동안 미답으로 남았던 고양이 유전학의 기초 문제가 해결되며, 가정동물의 일반적이지 않은 색소 발현 메커니즘을 이해하는 토대가 마련됐다.
핵심 요약
스탠포드대와 규슈대 연구팀이 독립적으로 주황색 고양이 털의 원인을 밝혔다. 주황색 털은 고양이 게놈의 비단백질 코딩 영역에서 약 5킬로베이스 크기의 DNA 절편이 제거된 결과다. 주황색 털이 자라나는 피부세포는 Arhgap36 유전자의 RNA를 주황색이 없는 고양이 세포 대비 13배 이상 발현한다. 전체 요약 12문장 읽기 → 092 21:12 ▲ 181 · 댓글 231 LLM 도입이 엔지니어 일자리를 어떻게 바꾸고 있는가 저자는 LLM의 등장으로 다니던 회사에서 해고되었는데, AI가 더 낫기보다는 AI가 저자의 급여보다 저렴했기 때문이었다. AI · 머신러닝 · Fable Took My Job
Key Point LLM 도입이 단순히 기술 진전이 아니라 실제 엔지니어들의 일자리와 삶에 미치는 영향을 직접 경험한 관점에서 보여주며, 기술의 현재 한계와 기업의 실제 의사결정 메커니즘을 동시에 다룬다.
핵심 요약
저자는 LLM의 등장으로 다니던 회사에서 해고되었는데, AI가 더 낫기보다는 AI가 저자의 급여보다 저렴했기 때문이었다. 저자는 해고 결정 직후 심각한 신체적·정신적 고통을 경험했으며, 같은 업계의 여러 DevOps 엔지니어들도 최근 한 달 사이 해고되거나 통보받았다고 밝혔다. 현재 LLM은 기존 엔지니어를 완전히 대체할 수 없으며, 신중한 판단 능력, 장기적 결과 예측, 복잡성 관리 같은 경험 많은 엔지니어의 역량이 부족하다. 전체 요약 5문장 읽기 → 093 18:12 ▲ 10 · 댓글 2 정책 증류에서 상대적 차이의 전이 메커니즘 규명 온-정책 증류(OPD)는 강사 정책에서 학생 정책을 감독하되, 기존에는 강사가 월등히 뛰어나야 효과적이었다. AI · 머신러닝 · Rethinking Relative Policy Differences Transfer of On-Policy Distillation
Key Point 강화학습 정책 증류에서 어떤 강사-참조 조합이 효과적인지, 모델 간 지식 전이 가능 조건을 규명해 실제 응용의 성공률을 높일 수 있기 때문이다.
핵심 요약
온-정책 증류(OPD)는 강사 정책에서 학생 정책을 감독하되, 기존에는 강사가 월등히 뛰어나야 효과적이었다. 최근 연구는 강사의 절대 분포 대신 강사와 참조 정책 간의 상대적 차이를 전이하는 방식을 제안했지만, 어떤 차이가 유용한 감독을 제공하고 어떤 대상이 이득을 볼 수 있는지는 불명확했다. 연구팀은 프록시 강사와 프록시 참조 간의 로그 확률 비를 KL 정규화 정책 최적화의 암묵적 보상으로 해석하는 통합 이론을 개발했다. 전체 요약 9문장 읽기 → 094 18:12 ▲ 275 · 댓글 2 멀티모달 AI의 공간 추론 메커니즘 규명 멀티모달 언어 모델의 공간 추론 능력은 입증되었으나 내부 작동 원리는 미지의 영역이었다. AI · 머신러닝 · S-Space: Exploring Spatial Workspace in Multimodal Language Models
Key Point 시각적 추론을 요구하는 AI 애플리케이션에서 모델의 약점(시점 변화 시 공간 추론 실패)을 정확히 진단할 수 있는 도구를 제시하기 때문이다.
핵심 요약
멀티모달 언어 모델의 공간 추론 능력은 입증되었으나 내부 작동 원리는 미지의 영역이었다. 연구팀이 'S-Space'라는 선형 표현 부분공간을 발견했으며, 여기에 객체 토큰이 가로·세로·거리 축을 따라 연속적 좌표로 인코딩된다. S-Space는 특정 데이터나 프롬프트로 유도되지 않고 모델에 내재되어 있으며, 공간과 무관한 질문에서도 판독 가능하다. 전체 요약 8문장 읽기 → 095 18:12 ▲ 27 · 댓글 2 병렬 초안 생성의 문제를 고치는 DCOCO 기법 추측 디코딩은 경량의 드래프터가 여러 토큰을 먼저 제안하고 타겟 모델이 병렬로 검증해 LLM 추론을 가속화한다. AI · 머신러닝 · Contextual Correction of Parallel Drafts for Speculative Decoding
Key Point 현재 프로덕션 LLM 추론에서 가장 효과적인 가속 기법인 추측 디코딩의 근본적 병목을 해결했으며, 모든 서빙 조건에서 지속적인 성능 향상을 제시한다.
핵심 요약
추측 디코딩은 경량의 드래프터가 여러 토큰을 먼저 제안하고 타겟 모델이 병렬로 검증해 LLM 추론을 가속화한다. 최근 확산 기반 드래프터들은 병렬로 여러 위치를 동시에 예측하지만, 각 토큰이 앞선 토큰들의 정체를 모른 채 예측되어 자동회귀 생성의 문맥 의존성이 손실된다. DCOCO(DFlash Contextual Corrector)는 병렬 드래프팅을 유지하면서 이 의존성을 복원하는 경량 메커니즘이다. 전체 요약 6문장 읽기 → 096 18:12 ▲ 113 · 댓글 63 AI가 자기 자신을 재귀적으로 개선하는 방법 Sakana AI 연구팀이 다중 에이전트 시스템의 집단 지능을 통해 AI 모델이 스스로를 개선하는 MASS(Multi-Agent Self-Supervision) 기법을 제안했다. AI · 머신러닝 · Recursive self-improvement through collective intelligence
Key Point 인간 감시자도 평가 불가능한 최첨단 과제에서 AI가 홀로 자신을 개선할 수밖에 없는 상황에서, 집단 지능을 통한 자기 감시 메커니즘이 작동하는지 보여주며, 동시에 그 방식의 안전 위험을 드러내는 연구다.
핵심 요약
Sakana AI 연구팀이 다중 에이전트 시스템의 집단 지능을 통해 AI 모델이 스스로를 개선하는 MASS(Multi-Agent Self-Supervision) 기법을 제안했다. MASS는 같은 모델이 작업 수행자, 워크플로우 최적화자, 평가자 세 역할을 모두 하는 동형 재귀적 자기 개선(RSI) 방식이다. 내부 루프에서 모델이 다중 에이전트 팀의 업무 분담 방식을 최적화하고, 외부 루프에서 최적화된 워크플로우 실행으로부터 배운다. 전체 요약 12문장 읽기 → 097 12:11 ▲ 55 · 댓글 3 AR·VR용 입체 음성 생성, 화면 움직임과 동기화 기존 영상-음성 생성 모델은 의미 대응과 시간 동기화는 잘했지만, AR/VR·인터랙티브 게임에 필요한 입체 음성 생성은 미흡했다. AI · 머신러닝 · Hear the World in Stereo: Learning Dynamic Spatial Correspondence for Immersive Joint Video-Audio Generation
Key Point AR·VR과 게임 등 몰입형 미디어에서 필수인 입체 음성을 화면 움직임과 동기화하는 기술 공백을 처음 정의하고 해결했으며, 평가 기준도 함께 제시했다.
핵심 요약
기존 영상-음성 생성 모델은 의미 대응과 시간 동기화는 잘했지만, AR/VR·인터랙티브 게임에 필요한 입체 음성 생성은 미흡했다. 입체 음성은 음원이 인지되는 방향이 화면 속 음원의 움직임과 일치해야 하는데, 이를 '동적 공간 대응'이라고 정의했다. StereoBind는 모션 트랙을 활용해 시각적 움직임과 입체 음성을 연계하는 프레임워크로, 시각 움직임 바인딩·공간 트랙 인코더·상대 움직임 모델링 세 가지 메커니즘을 사용한다. 전체 요약 5문장 읽기 → 098 09:10 ▲ 165 · 댓글 78 패스키는 편함 뒤에 감시 가능성을 숨기고 있다 FIDO Alliance가 주도하는 패스키는 보안이 뛰어나고 편리하다고 알려져 있지만, 사용자의 통제를 점차 빼앗는 구조로 설계됐다. 보안 · Passkeys are a trap. Do not use them
Key Point 패스키가 암호보다 안전하다는 마케팅 뒤에 기업과 정부가 사용자 자유를 제한하는 원격 증명 메커니즘을 숨기고 있으며, 현재의 열린 표준이 미래에 일방적 통제 도구로 변할 수 있기 때문이다.
핵심 요약
FIDO Alliance가 주도하는 패스키는 보안이 뛰어나고 편리하다고 알려져 있지만, 사용자의 통제를 점차 빼앗는 구조로 설계됐다. 패스키는 '복사 불가능', '전송 불가능', '하드웨어 기반', '사용자 인증 필수' 등 여러 종류가 혼동되게 같은 이름으로 불린다. TOTP(인증 앱)는 이미 안전한 대안으로 존재하며, 사용자가 보관 방식을 선택할 수 있는 개방된 표준이다. 전체 요약 11문장 읽기 → 099 12:11 ▲ 12 · 댓글 2 성장하는 신경망, 학습 데이터를 직접 저장했다 딥러닝의 일반 목적 계층으로서, 학습 데이터를 고정 크기의 가중치 행렬로 압축하지 않고 모든 데이터 포인트마다 키-값 표현을 저장했다가 추론 시 어텐션으로 검색·결합하는 성장형 신경망을 제시했다. AI · 머신러닝 · Retrieval-Centric Deep Learning in Growing Nonparametric Neural Networks
Key Point 매개변수 크기를 고정하지 않고 데이터를 직접 저장하는 방식이 기존 신경망 설계와 어떻게 다르며, 실제 성능상 이점이 있는지 확인할 수 있는 새로운 학습 패러다임입니다.
핵심 요약
딥러닝의 일반 목적 계층으로서, 학습 데이터를 고정 크기의 가중치 행렬로 압축하지 않고 모든 데이터 포인트마다 키-값 표현을 저장했다가 추론 시 어텐션으로 검색·결합하는 성장형 신경망을 제시했다. 기존 선형 어텐션(LA) 이론을 확장해 RBF와 소프트맥스 커널 같은 고급 커널을 사용할 경우 기울기 기반 최적화가 자명하지 않은 문제를 발견했다. 함수형 기울기(functional gradient) 기반 학습 규칙을 개발하여 커널화된 어텐션 계층의 원칙적인 최적화 방법을 제시했다. 전체 요약 5문장 읽기 → 100 12:11 ▲ 117 · 댓글 88 같은 칼로리, 다른 반응…가공도에 따라 뇌와 대사 달라진다 버지니아 공대 연구팀이 칼로리, 탄수화물, 지방, 단백질, 수분, 염분, 무게가 모두 같으면서 가공도만 다른 두 식사가 서로 다른 신진대사와 뇌 반응을 일으킨다는 사실을 발견했다. AI · 머신러닝 · Food processing influences metabolism and brain activity
Key Point 같은 영양가의 식사가 가공도에 따라 혈당·인슐린·뇌 반응을 달리하는 메커니즘을 규명함으로써 초가공식품이 왜 과식과 장기 질환 위험을 높이는지 이해하는 데 새로운 근거를 제시한다.
핵심 요약
버지니아 공대 연구팀이 칼로리, 탄수화물, 지방, 단백질, 수분, 염분, 무게가 모두 같으면서 가공도만 다른 두 식사가 서로 다른 신진대사와 뇌 반응을 일으킨다는 사실을 발견했다. 연구진은 57명의 건강한 성인(18~45세)을 모집했고, 이 중 32명이 뇌 fMRI 촬영과 대사 측정 세션을 모두 완료했다. 고도로 가공된 300칼로리 식사(피너트버터 젤리 샌드위치, 델리 칠면조, 채소칩, 쿠키, 시리얼, 인스턴트 으깬 감자)와 최소한으로 가공된 식사(바나나, 말린 크랜베리, 치즈, 달걀)는 영양소 수치가 1% 범위 내에서 일치했다. 전체 요약 10문장 읽기 →