쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 22일 (일)까지 5067건
9건 · "최적화 알고리즘"조건 지우기 ×
001 00:11 ▲ 107 · 댓글 23 AI로 만든 최강 소코반 솔버, 기존 솔버 능가 Soksolv는 소코반(박스 밀어내기 퍼즐 게임) 솔버로 표준 벤치마크 양쪽에서 발표된 모든 솔버보다 많은 레벨(전체 13,315개 중)을 해결하며, 24개의 세계 최초 자동 클리어 기록을 포함했고 기존 솔버 대비 약 3.2배 빠르다. AI · 머신러닝 · The Strongest Sokoban Solver
Key Point AI 에이전트의 대규모 협력 개발 사례로, 복잡한 알고리즘 연구에서 프론티어 모델이 인간 개발자를 대체할 수 있음을 보여준다.
핵심 요약
Soksolv는 소코반(박스 밀어내기 퍼즐 게임) 솔버로 표준 벤치마크 양쪽에서 발표된 모든 솔버보다 많은 레벨(전체 13,315개 중)을 해결하며, 24개의 세계 최초 자동 클리어 기록을 포함했고 기존 솔버 대비 약 3.2배 빠르다. 개발자는 Claude Code와 약 430개의 서브에이전트(Sonnet, Opus, Fable 모델 조합)를 활용해 한 번의 14일 단일 세션으로 개발했으며, API 비용은 약 3,500달러였다. 소코반은 1982년 일본에서 출시된 게임으로 1997년 PSPACE-완전성이 증명되었으며, 작은 판도 수백 개에서 수천 개의 움직임이 필요한 거대한 탐색 공간을 가진다. 전체 요약 11문장 읽기 → 002 18:11 ▲ 14 · 댓글 3 Adam의 효율성으로 2차 최적화의 성능을 얻는 경량 SOAP 변형 Shampoo, SOAP 같은 2차 최적화 알고리즘이 Adam보다 빠른 수렴을 약속하지만, 실제로는 높은 메모리 비용과 고유값 분해 오버헤드로 인해 실용성이 떨어진다는 문제가 있다. AI · 머신러닝 · Factored One-sided Adam-Moment for Practical and Scalable SOAP
Key Point 2차 최적화의 성능 이득을 Adam 수준의 효율로 실현할 수 있는 방법이 등장했으며, 대규모 언어모델 학습에서 메모리와 계산 비용을 크게 낮출 수 있다.
핵심 요약
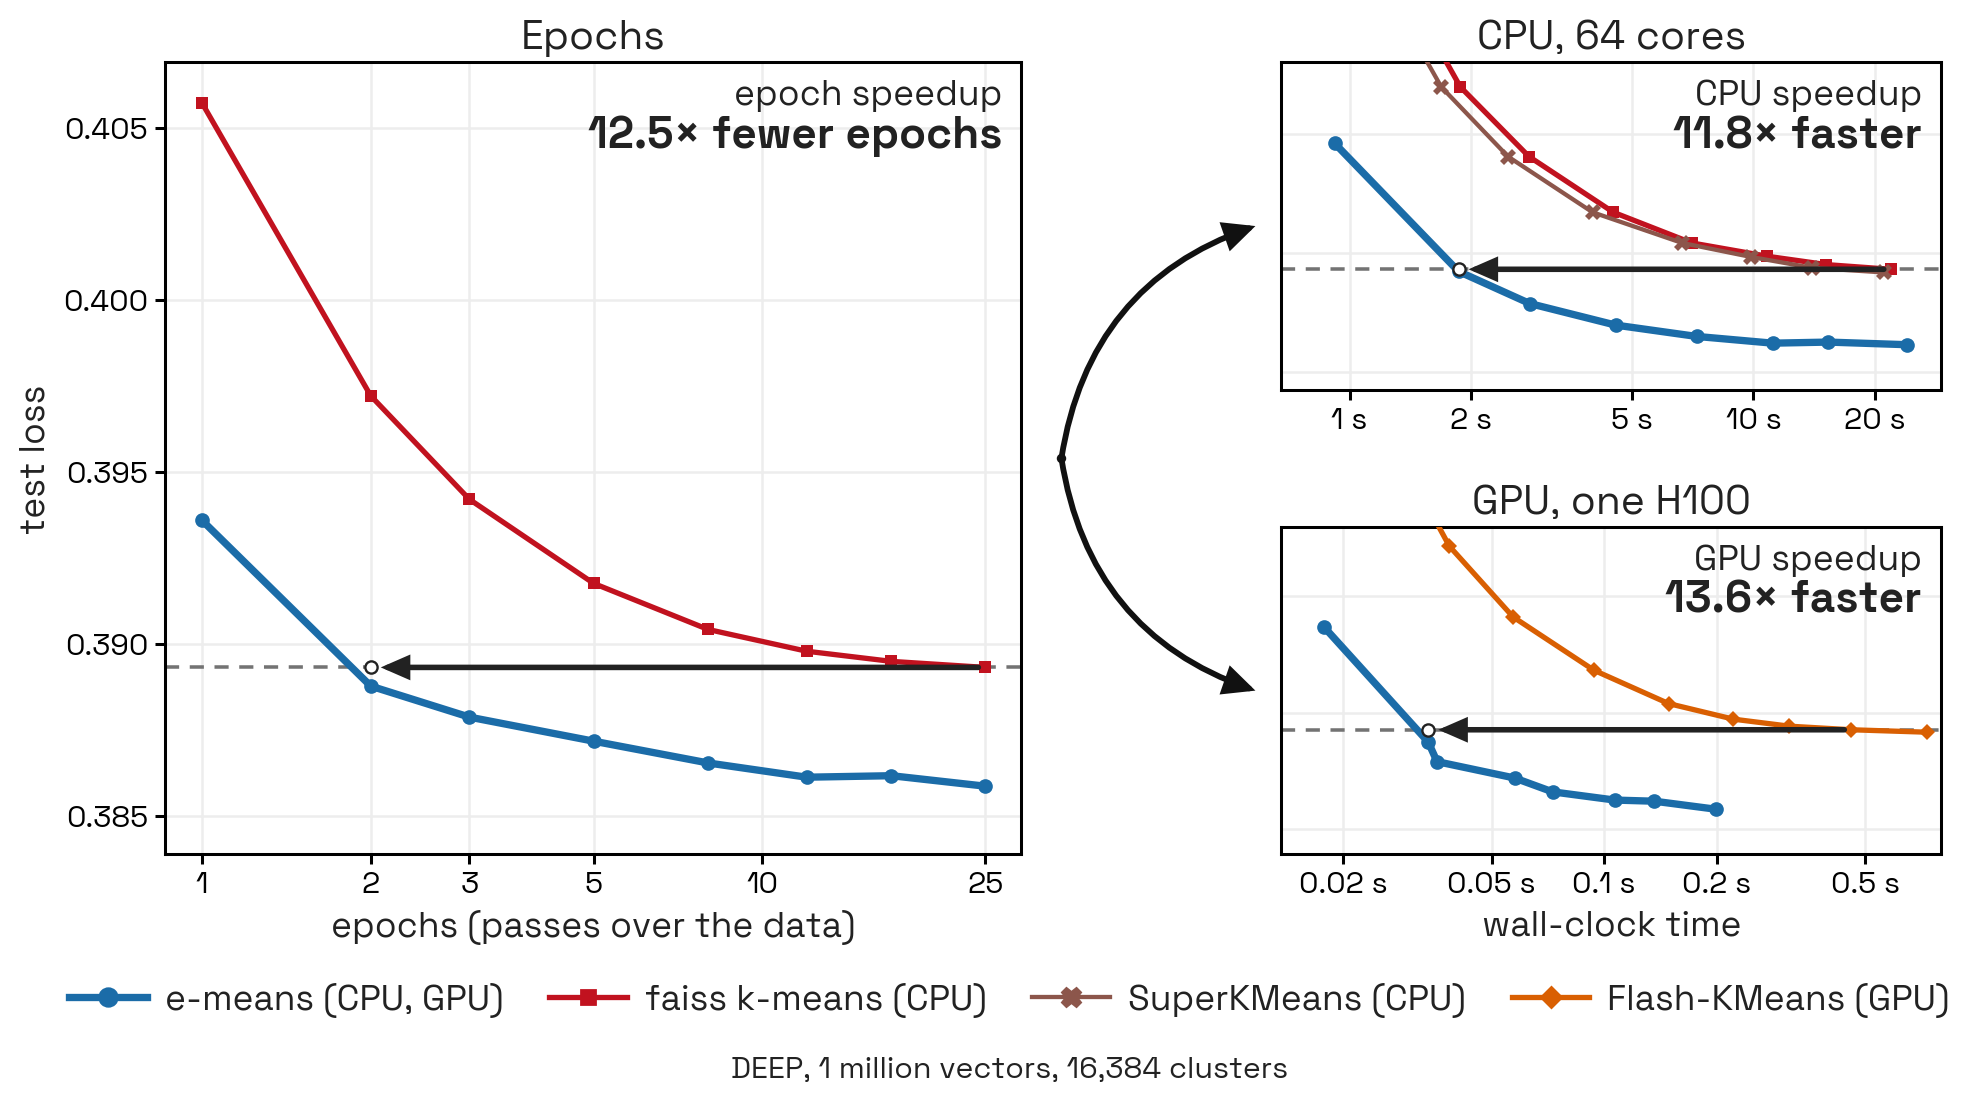
Shampoo, SOAP 같은 2차 최적화 알고리즘이 Adam보다 빠른 수렴을 약속하지만, 실제로는 높은 메모리 비용과 고유값 분해 오버헤드로 인해 실용성이 떨어진다는 문제가 있다. FOAM(Factored One-sided Adam-Moment)은 이 한계를 해결하기 위해 제안된 경량 SOAP 변형이다. FOAM은 입력 측 전처리만 사용하고 출력 측 크로네커 인수를 제거해 메모리를 줄이고 한 번의 고유값 분해를 없앤다. 전체 요약 8문장 읽기 → 003 06:11 ▲ 115 · 댓글 4 로이드 알고리즘 10배 빠른 k-means 최적화 알고리즘 공개 Meta FAIR 연구팀이 개발한 e-means는 기존 Lloyd 알고리즘 대비 10~45배 빠른 속도로 k-means 클러스터링을 수행하면서도 손실 함수값은 더 낮은 결과를 달성했다. AI · 머신러닝 · E-means: 10x faster k-means at equal loss
Key Point 클러스터링은 벡터 양자화, 이미지 압축, 추천 시스템 등에 널리 쓰이는데, Lloyd 알고리즘이 표준이었던 상황에서 10배 빠르면서도 손실이 더 낮은 새 방식이 나왔으므로 기술 선택에 직결되는 소식이다.
핵심 요약
Meta FAIR 연구팀이 개발한 e-means는 기존 Lloyd 알고리즘 대비 10~45배 빠른 속도로 k-means 클러스터링을 수행하면서도 손실 함수값은 더 낮은 결과를 달성했다. e-means는 25 에포크에서 Lloyd가 도달하는 손실 수준에 1.2~3 에포크 안에 도달하며, 지스푸(Flash-KMeans) 대비 GPU에서 10~45배, Faiss 대비 CPU에서 8~15배 월클록 속도 개선을 실현했다. 핵심은 지수 이동 평균(exponential moving average)을 사용한 미니배치 업데이트로, 최신 할당(recent assignment)에 가중치를 두면서 과거 오래된 정보는 α 비율로 서서히 잊도록 설계했다. 전체 요약 10문장 읽기 → 004 12:11 ▲ 107 · 댓글 20 클로드, 양자 회로 설계를 대폭 개선하다 앤스로픽은 Claude Mythos 5에게 화학, 최적화, 물리 시뮬레이션, 정수론의 8가지 양자 회로 설계 과제를 평문으로 제시하고, 자동 평가기가 정확성을 검증하고 큐빗·게이트 수로 채점하도록 했다. AI · 머신러닝 · Designing more efficient quantum circuits with Claude
Key Point 양자 컴퓨터의 실용화는 회로 설계 최적화에 달렸는데, Claude가 연구 그룹이 8년에 걸쳐 이룬 성과(FeMoco 게이트 150,000배 감소)를 53시간에 달성했다는 점이 양자 알고리즘 개발의 속도를 근본적으로 바꿀 수 있음을 보여준다.
핵심 요약
앤스로픽은 Claude Mythos 5에게 화학, 최적화, 물리 시뮬레이션, 정수론의 8가지 양자 회로 설계 과제를 평문으로 제시하고, 자동 평가기가 정확성을 검증하고 큐빗·게이트 수로 채점하도록 했다. Claude는 피드백 루프를 통해 폐쇄형으로 회로를 반복 설계했으며, 8가지 모두에서 이전의 최고 성능 회로보다 큐빗과 게이트 수를 줄인 새로운 설계를 발견했다. 첫 번째 사례는 타원곡선 암호 계산의 핵심인 모듈러 역수 문제로, Claude는 divsteps 알고리즘의 가지 정보(branch information)를 저장하지 않고 수치 쌍에서 직접 복원할 수 있음을 발견했다. 전체 요약 12문장 읽기 → 005 15:11 ▲ 60 · 댓글 1 루브릭 기반 강화학습의 보상 해킹, 단계별 그룹화로 해결 루브릭 기반 강화학습(Rubric-RL)은 검증자 없이 언어모델을 훈련하는데, 각 평가 기준을 개별 점수로 합산하는 방식이 문제다. AI · 머신러닝 · Scoring Higher, Answering Worse: Mitigating Reward Hacking in Rubric-Based RL via Protocol-Level Rubrics
Key Point 루브릭 기반 강화학습에서 점수 조작을 방지하고 실제 품질을 높이는 구체적인 방법론이 제시되어, LLM 훈련에서 평가 메커니즘 설계의 중요성을 보여준다.
핵심 요약
루브릭 기반 강화학습(Rubric-RL)은 검증자 없이 언어모델을 훈련하는데, 각 평가 기준을 개별 점수로 합산하는 방식이 문제다. 합산식 집계에서는 기준들이 상호 보완되어, 중요한 결정을 놓친 정책도 불필요한 조언으로 점수를 메워 높은 평가를 받을 수 있다. 임상 상담 실험에서 이런 정책은 루브릭 커버리지는 높아졌지만 의사의 실제 판단 기준에서는 훈련 전 모델보다 성능이 떨어졌다. 전체 요약 7문장 읽기 → 006 12:11 ▲ 12 · 댓글 2 성장하는 신경망, 학습 데이터를 직접 저장했다 딥러닝의 일반 목적 계층으로서, 학습 데이터를 고정 크기의 가중치 행렬로 압축하지 않고 모든 데이터 포인트마다 키-값 표현을 저장했다가 추론 시 어텐션으로 검색·결합하는 성장형 신경망을 제시했다. AI · 머신러닝 · Retrieval-Centric Deep Learning in Growing Nonparametric Neural Networks
Key Point 매개변수 크기를 고정하지 않고 데이터를 직접 저장하는 방식이 기존 신경망 설계와 어떻게 다르며, 실제 성능상 이점이 있는지 확인할 수 있는 새로운 학습 패러다임입니다.
핵심 요약
딥러닝의 일반 목적 계층으로서, 학습 데이터를 고정 크기의 가중치 행렬로 압축하지 않고 모든 데이터 포인트마다 키-값 표현을 저장했다가 추론 시 어텐션으로 검색·결합하는 성장형 신경망을 제시했다. 기존 선형 어텐션(LA) 이론을 확장해 RBF와 소프트맥스 커널 같은 고급 커널을 사용할 경우 기울기 기반 최적화가 자명하지 않은 문제를 발견했다. 함수형 기울기(functional gradient) 기반 학습 규칙을 개발하여 커널화된 어텐션 계층의 원칙적인 최적화 방법을 제시했다. 전체 요약 5문장 읽기 → 007 18:33 ▲ 20 · 댓글 2 언어모델이 분자 최적화 알고리즘을 자동 설계 양자화학 계산에서 기하 최적화는 각 단계마다 힘 계산이 필요해 가장 비용이 큰 부분이다. AI · 머신러닝 · Optimizing the Optimizer: Language Models Discover Faster Molecular Relaxation
Key Point 언어모델이 과학 계산의 핵심 병목인 분자 최적화 알고리즘을 자동으로 개선해 계산 비용을 40% 이상 줄인 사례로, AI가 직접 과학 연구 방법론을 최적화할 수 있음을 보여준다.
핵심 요약
양자화학 계산에서 기하 최적화는 각 단계마다 힘 계산이 필요해 가장 비용이 큰 부분이다. 연구팀은 언어모델 에이전트를 이용해 최적화 알고리즘 자체를 개선할 수 있는지 시도했다. 에이전트가 기존 최고 성능의 오픈소스 옵티마이저 Sella를 기반으로 자동으로 재작성하면서 힘 계산 횟수를 최소화한다. 전체 요약 6문장 읽기 → 008 00:11 ▲ 53 · 댓글 2 로봇 손가락 제어 보상 함수를 테스트 중에 진화시켜 새 작업 수행 휴머노이드 로봇이 학습 과정 없이 테스트 시점에 새로운 작업을 수행하도록 하는 InterEvolve 기법을 제시했다. AI · 머신러닝 · InterEvolve: Test-Time Evolution of Reward Programs for Humanoid Loco-Manipulation
Key Point 재학습 없이 이미 학습된 로봇의 역량을 새로운 작업에 활용하는 방법을 구체적으로 제시해, 실제 로봇 개발에서 배포 후 신속한 작업 확장이 가능해진다.
핵심 요약
휴머노이드 로봇이 학습 과정 없이 테스트 시점에 새로운 작업을 수행하도록 하는 InterEvolve 기법을 제시했다. 핵심은 광범위하게 학습된 컨트롤러가 새 작업에 필요한 역량을 이미 대부분 갖고 있으며, 계획과 제어 사이의 적절한 인터페이스로 그 역량을 접근 가능하게 만드는 것이다. 객체 인식 순전파-역전파 행동 기초 모델(object-aware FB behavioral foundation model)을 개발해 동결된 신체 모델 위에서 객체 잔차를 통해 새로운 보상을 조작 행동으로 변환한다. 전체 요약 8문장 읽기 → 009 18:11 ▲ 107 · 댓글 32 Recurse Center의 여름, 프로그래밍으로 무엇을 배웠나 Recurse Center는 뉴욕 브루클린의 프로그래밍 집중 프로그램으로, 저자는 여름 배치에서 다양한 스터디 그룹과 프로젝트에 참여했다. 기타 · What I did at Recurse Center
Key Point 프로그래밍 집중 프로그램에서 LLM·알고리즘·언어학을 넘나들며 정말 만든 것들을 보려면 참가자들이 실제 무엇을 만들었는지 구체적으로 알아야 한다.
핵심 요약
Recurse Center는 뉴욕 브루클린의 프로그래밍 집중 프로그램으로, 저자는 여름 배치에서 다양한 스터디 그룹과 프로젝트에 참여했다. Agentic Adventures 그룹에서는 LLM과 에이전트를 주제로 원격 샌드박스 구축, 'Just One' 게임 제작, minGPT 실습 등을 진행했다. Practical Deep Learning 스터디 그룹을 통해 Jeremy Howard의 책을 함께 읽으며 고전 머신러닝부터 신경망 구축까지 학습했다. 전체 요약 13문장 읽기 →