쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 1일 (일)까지 3728건
15건 · "AI 추론"조건 지우기 ×
001 06:11 당일 +320 오픈소스 AI SOC로 보안 대응을 자동화하다 보안 도구에서 수집한 로그를 정규화한 후 2535개의 탐지 규칙을 실행해 위협을 자동 분류하고 AI 에이전트가 조사하며 사람이 승인한 후 대응 조치를 취하는 자체 호스팅 가능한 오픈소스 SOC이다. 보안 · beenuar/AiSOC · Python
Key Point API 키 없이 AI 기반 위협 조사를 자체 호스팅으로 실행할 수 있는 오픈소스 SOC가 등장했으며, 모든 AI 추론이 기록되어 감사 가능하고 대응은 사람이 승인해야 한다는 점이 기존 자동화 도구와 다르다.
핵심 요약
보안 도구에서 수집한 로그를 정규화한 후 2535개의 탐지 규칙을 실행해 위협을 자동 분류하고 AI 에이전트가 조사하며 사람이 승인한 후 대응 조치를 취하는 자체 호스팅 가능한 오픈소스 SOC이다. 도입에 명령어 한 줄로 Docker, Python, 필요한 보안 자격증을 모두 설치할 수 있으며 8GB 메모리와 20GB 디스크, Python 3.9+ 그리고 bash만 있으면 된다. Splunk, Sentinel, Elastic, CrowdStrike, Okta, AWS, Kubernetes 등 87개의 데이터 커넥터를 지원하며 클라우드 환경에서는 S3-SQS, GCP Pub/Sub, Azure Event Hubs, syslog/CEF 리스너로 로그를 수집한다. 전체 요약 10문장 읽기 → 002 21:11 당일 +260 로컬 AI 추론을 위한 고성능 엔진 Uzu 오픈소스화 Rust로 개발된 고성능 AI 추론 엔진 Uzu를 공개했으며, 지연 없이 앱에 직접 AI 모델을 배포할 수 있다. AI · 머신러닝 · trymirai/uzu · Rust
Key Point 로컬에서 AI 추론을 수행하려는 개발자들이 클라우드 비용과 레이턴시를 피하면서 데이터 프라이버시까지 보호할 수 있는 프로덕션급 도구가 생겼다.
핵심 요약
Rust로 개발된 고성능 AI 추론 엔진 Uzu를 공개했으며, 지연 없이 앱에 직접 AI 모델을 배포할 수 있다. 데이터 프라이버시를 완전히 보장하고 추론 비용이 발생하지 않으며, Metal·WebGPU·CPU 백엔드를 지원한다. Python, Swift, TypeScript, Rust 등 4개 언어에 바인딩을 제공하고, 모델 다운로드부터 추론까지 자동으로 처리한다. 전체 요약 9문장 읽기 → 003 15:11 ▲ 113 · 댓글 37 클라우드플레어 AI 모델서 사용자 데이터 노출, 155건 영향 클라우드플레어의 Workers AI에서 제공하는 GLM-5.3 모델에서 한 사용자의 응답이 다른 사용자의 요청 데이터를 포함하는 테넌트 격리 문제가 발생했다. 보안 · Cross-request KV cache exposure in the GLM-5.3 Workers AI model (155 responses)
Key Point 컨텍스트 윈도우와 실제 메모리 풀 크기의 불일치가 추론 엔진의 버그와 결합되어 사용자 간 데이터 유출을 초래한 사례로, disaggregated 구조의 AI 추론 서비스를 운영하는 회사들이 참고해야 할 설정·배포 체크리스트와 업스트림 수정 사항을 제시한다.
핵심 요약
클라우드플레어의 Workers AI에서 제공하는 GLM-5.3 모델에서 한 사용자의 응답이 다른 사용자의 요청 데이터를 포함하는 테넌트 격리 문제가 발생했다. 8월 27일부터 9월 9일까지 681,280토큰을 초과하는 긴 프롬프트에 대한 응답 155건이 영향을 받았으며, 의도적인 악용 흔적은 없었다. 근본 원인은 두 가지였다: 첫째, GLM-5.3의 KV 캐시 풀 크기(681,280토큰)가 선언된 컨텍스트 윈도우(1,048,576토큰)보다 작았고, 둘째, 오픈소스 추론 엔진 SGLang에서 초과 길이 요청을 disaggregated prefill/decode 모드로 처리할 때 거부된 요청을 제대로 중단하지 않는 버그가 있었다. 전체 요약 9문장 읽기 → 004 00:11 ▲ 114 · 댓글 127 LLM이 만드는 새로운 보안 위협···한 주간 대형 취약점 폭발 2026년 10월 지난 일주일 간 심각한 소프트웨어 취약점들이 대량 발견되었다. PHP의 CVE-2026-109618, 109619(PHP2Shell)는 OpenAI의 패치 프로그램과 구글 클라우드의 Wiz가 GPT-5.6과 Gemini 4를 이용해 찾은 원격 코드 실행 버그로, 인터넷 70% 이상에 영향을 미친다. 보안 · Is this the new cyber normal?
Key Point 지난주 PHP에서 인터넷 70% 이상을 위협하는 취약점이 터진 데 이어 eMudhra, Railway, GitLab, LiteLLM 등이 연쇄적으로 침해당하면서 LLM이 보안 위협의 판을 바꾸고 있다.
핵심 요약
2026년 10월 지난 일주일 간 심각한 소프트웨어 취약점들이 대량 발견되었다. PHP의 CVE-2026-109618, 109619(PHP2Shell)는 OpenAI의 패치 프로그램과 구글 클라우드의 Wiz가 GPT-5.6과 Gemini 4를 이용해 찾은 원격 코드 실행 버그로, 인터넷 70% 이상에 영향을 미친다. 2024년 PHP 재단이 발견했지만 실제 익스플로잇을 못 만들어 방치한 취약점을 LLM이 취약점 설명만으로 완전한 익스플로잇으로 빌드해냈다. LLM은 보안 패치 공지 후 코드 변경사항을 분석해 몇 분 내에 익스플로잇을 만들 수 있어, 이제 패치 발표 시점을 '익스플로잇이 퍼지지 않은 마지막 시간'으로 봐야 한다. Hacker News의 petecooper가 의도치 않게 CVE를 공개해 패치 일정이 22일에서 21일로 앞당겨졌지만, Calif가 익스플로잇 영상을 공개하고 Chainguard가 embargo 6시간 전에 패치를 배포하면서 17시간 내에 여러 문제가 겹쳤다. 전체 요약 14문장 읽기 → 005 03:11 ▲ 207 · 댓글 113 지난 12개월 보안 사건 236건 실시간 추적 pwn.watch는 최근 12개월간 발생한 236건의 보안 사건을 심각도별로 추적하는 대시보드로, 현재 37건이 활성화 상태며 그 중 16건이 중대(Critical) 수준이다. 보안 · What's Getting Pwned
Key Point 지난 수주일간 GitLab 정규식 컴파일러(CVSS 10.0), Plex Media Server 체인, 대형 은행 AI 에이전트 침입 등 인증 없는 원격 코드 실행 및 공급망 공격이 집중되고 있으며, 개발자 도구와 금융 플랫폼이 동시에 타격을 받고 있는 상황을 파악할 수 있다.
핵심 요약
pwn.watch는 최근 12개월간 발생한 236건의 보안 사건을 심각도별로 추적하는 대시보드로, 현재 37건이 활성화 상태며 그 중 16건이 중대(Critical) 수준이다. 지난 11일간(1월 2-12일) 신규 사건이 없는 상태가 가장 오래 지속되었으며, 현재 심각도 가중치로는 중대 4점·높음 3점·중간 2점·낮음 1점·업데이트 0.5점으로 계산된다. Arista VeloCloud Orchestrator의 CVSS 9.9 SQL 인젝션 취약점(CVE-2026-114625)이 적극적으로 악용되고 있으며, 인증된 사용자가 관리자 권한을 탈취할 수 있다. 전체 요약 16문장 읽기 → 006 09:11 ▲ 246 · 댓글 112 Railway, 환경변수 비정상 접근 보안 사건 공개 Railway가 고객 환경변수 저장 시스템에 대한 비정상 활동을 감지했고, 승인되지 않은 제3자가 암호화된 환경변수에 접근했을 가능성이 있습니다. 보안 · Railway Security Disclosure
Key Point 암호화된 환경변수 내 API 키와 데이터베이스 자격증명이 유출될 수 있으며, Railway 사용자는 자신의 배포 시스템과 외부 서비스 키를 긴급하게 갱신해야 합니다.
핵심 요약
Railway가 고객 환경변수 저장 시스템에 대한 비정상 활동을 감지했고, 승인되지 않은 제3자가 암호화된 환경변수에 접근했을 가능성이 있습니다. 일부 환경변수의 복호화된 내용도 탈취된 것으로 보이며, API 키나 데이터베이스·레지스트리 자격증명 같은 민감한 정보가 포함될 수 있습니다. 이번 사건은 AI 추론 제공업체를 노리는 플랫폼 회사 대상 공격 시리즈의 일부로 추정되며, Railway는 영향받은 상위 제공업체들에게 키 폐기를 권고했습니다. 전체 요약 7문장 읽기 → 007 15:11 ▲ 20 · 댓글 2 에이전트 AI 추론을 위한 '히스토리 프리' 추측 디코딩 DLite 추측 디코딩은 경량 드래프트 모델로 토큰을 생성하고 타겟 모델이 검증하는 방식으로 LLM 추론을 가속화하는 기법이지만, 에이전트 AI 워크로드의 긴 맥락과 다중 턴 상호작용에서는 드래프트 모델의 토큰 승인률이 최대 80% 저하된다. AI · 머신러닝 · DLite: History-free Speculative Decoding for Agentic AI
Key Point 에이전트 AI 같은 긴 맥락의 상호작용형 워크로드에서 LLM 추론 속도를 크게 높일 수 있는 새로운 접근 방식을 제시합니다.
핵심 요약
추측 디코딩은 경량 드래프트 모델로 토큰을 생성하고 타겟 모델이 검증하는 방식으로 LLM 추론을 가속화하는 기법이지만, 에이전트 AI 워크로드의 긴 맥락과 다중 턴 상호작용에서는 드래프트 모델의 토큰 승인률이 최대 80% 저하된다. 기존 방식은 역사적 KV 캐시를 유지함에 따라 시스템 오버헤드가 커진다. 연구팀은 증가하는 역사적 맥락이 두 문제의 공통 원인임을 파악하고, DLite라는 '히스토리 프리' 추측 디코딩 프레임워크를 제안했다. 전체 요약 7문장 읽기 → 008 15:11 ▲ 150 · 댓글 67 Intel, 에이전트 AI 전용 D270 GPU 공개…최대 480GB LPDDR5X 메모리 인텔이 AI 추론 전용 데이터센터 GPU 'D270'을 발표했다. 하드웨어 · 시스템 · Intel D270 GPU AI Accelerator–Up to 480 GB LPDDR5X
Key Point 에이전트 AI 시대 장문맥·고동시성 추론의 메모리 병목을 겨냥한 표준 인프라 기반 GPU로, NVIDIA 중심 시장에 대안을 제시하는 시점의 신제품이다.
핵심 요약
인텔이 AI 추론 전용 데이터센터 GPU 'D270'을 발표했다. D270은 최대 480GB LPDDR5X 메모리, 32개 Xᵉ3P 코어, 256개 XMX 매트릭스 엔진을 탑재하고 350W 공기냉식으로 동작한다. 에이전트 AI 워크로드의 특징인 긴 컨텍스트, 다중 단계 작업, 프리필 중심 연산에 최적화됐다. 전체 요약 8문장 읽기 → 009 18:33 ▲ 12 · 댓글 1 시작 토큰만 바꿔도 AI 추론 능력이 깨어난다 응답 시작 부분의 토큰 선택이 기본 언어모델의 추론 능력을 크게 좌우한다는 연구 결과가 공개됐다. AI · 머신러닝 · Base Models Can Reason By Taking a Cue From Training Data
Key Point 기본 모델의 추론 능력이 실제로는 훈련 데이터의 통계적 연관성에 기반하며, 프롬프트 엔지니어링만으로도 RL 학습 수준의 성능 향상을 얻을 수 있다는 점을 보여주기 때문입니다.
핵심 요약
응답 시작 부분의 토큰 선택이 기본 언어모델의 추론 능력을 크게 좌우한다는 연구 결과가 공개됐다. 예를 들어 Olmo-3-7B는 시작 토큰 '.\n\nOkay'를 고정하면 MATH-500 정확도가 42%에서 78%로 올라가고, Qwen3-14B는 'Alright,'를 사용하면 72%에서 87%로 상승한다. 강화학습(RL)으로 학습한 모델도 내부적으로는 이러한 효과적인 토큰 큐를 더 자주 사용하게 되며, RL 성능 향상의 상당 부분이 이 토큰 큐 효과에서 비롯된다. 전체 요약 7문장 읽기 → 010 16:56 ▲ 125 · 댓글 35 Redis 만든 개발자, 로컬에서 돌리는 LLM 엔진 공개 Redis 개발자 안티레즈가 만든 DS4는 고성능 머신에서 DeepSeek V4, GLM 5.x, Qwen3.8 등 대규모 모델을 로컬에서 실행하는 C 기반 추론 엔진이다. AI · 머신러닝 · From the creator of Redis; run LLM locally with ds4
Key Point 가장 강력한 오픈 가중치 모델을 거대 클라우드 없이 자체 하드웨어에서 실행할 수 있게 되면서 AI 추론의 구조가 바뀐다.
핵심 요약
Redis 개발자 안티레즈가 만든 DS4는 고성능 머신에서 DeepSeek V4, GLM 5.x, Qwen3.8 등 대규모 모델을 로컬에서 실행하는 C 기반 추론 엔진이다. 284억 파라미터 DeepSeek V4 Flash 같은 혼합 전문가 모델을 고메모리 Mac(Metal), NVIDIA(CUDA), AMD(ROCm) 환경에서 지원한다. 핵심 기술은 라우팅 전문가만 2비트로 압축하되 중요한 공유 경로는 정밀하게 유지하는 비대칭 양자화로, 모델을 고메모리 머신에서 실행 가능하게 만든다. 전체 요약 9문장 읽기 → 011 12:11 ▲ 125 · 댓글 97 GLM 5.3 Flash 한 달 집중 사용, 배운 점은? Wagtail 팀이 9월 한 달간 GLM 5.3 Flash 모델만 사용하는 도전을 진행했으나, 총 2B 토큰 중 절반만 해당 모델로 처리했다. AI · 머신러닝 · One month coding with GLM 5.3 Flash
Key Point 개발 조직이 효율적인 LLM 모델을 선택할 때 직면하는 실제 비용 구조와 예상 외 변수들을 구체적 사례로 보여주며, 에너지·비용 절감을 위한 실질적 전략을 제시한다.
핵심 요약
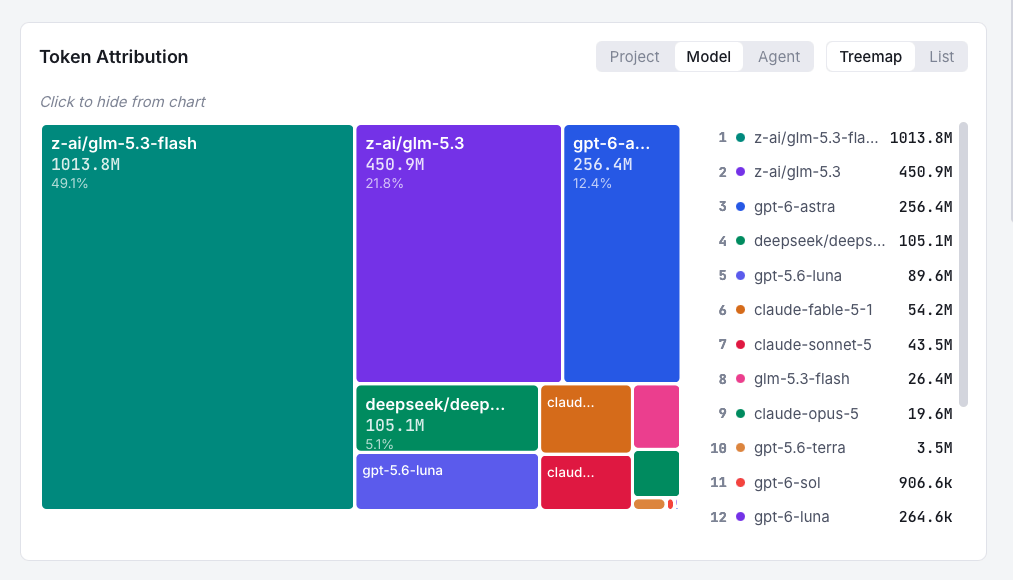
Wagtail 팀이 9월 한 달간 GLM 5.3 Flash 모델만 사용하는 도전을 진행했으나, 총 2B 토큰 중 절반만 해당 모델로 처리했다. 첫 2주는 계획대로 GLM 5.3 Flash만 사용해 $68, 365g 탄소 배출, 4kWh 에너지 소비로 예산 내에서 운영했다. 실험용 MCP 서버 프로토타입에서 잘못된 모델을 선택해 450M 토큰, $150, 5kWh 에너지를 하루 밤사이에 소비하는 예상 외 비용이 발생했다. 전체 요약 8문장 읽기 → 012 09:11 ▲ 120 · 댓글 54 하드웨어별 자동 최적화하는 오픈소스 추론 엔진 Magnitude 출시 YC S25 배치 스타트업 Magnitude가 에이전트용 오픈소스 추론 엔진을 공개했다. AI · 머신러닝 · Launch HN: Magnitude (YC S25) – Self-optimizing inference engine for agents
Key Point 로컬 추론 성능을 llama.cpp 대비 최대 2배 개선하면서 기존 에이전트와의 호환성을 유지한다는 점에서 에이전트 개발자와 프라이빗 AI 추론 사용자에게 실질적인 성능 이득이 생긴다.
핵심 요약
YC S25 배치 스타트업 Magnitude가 에이전트용 오픈소스 추론 엔진을 공개했다. 기기별로 커널을 컴파일·튜닝해 오픈 모델을 llama.cpp보다 최대 2배 빠르게 실행한다(Metal에서 92% 더 빠름, CUDA에서 19% 더 빠름). macOS, Windows, Linux에서 Apple Silicon, NVIDIA, AMD GPU 또는 CPU만으로 작동한다. 전체 요약 11문장 읽기 → 013 22:29 ▲ 140 · 댓글 118 AI 토큰 가격, 매년 수십 배 하락…계산 도구보다도 싸져 LLM 비용이 매년 수십 배 하락하면서 향후 1~2년 내 AI가 컴퓨팅 인프라로 통합될 것으로 예상된다. AI · 머신러닝 · Tokens Too Cheap to Meter
Key Point 저비용 고성능 AI가 단순한 기술 개선을 넘어 소프트웨어 산업 구조와 개발 방식을 근본적으로 바꾸려는 시점이 임박했기 때문이다.
핵심 요약
LLM 비용이 매년 수십 배 하락하면서 향후 1~2년 내 AI가 컴퓨팅 인프라로 통합될 것으로 예상된다. GPU 효율이 2년마다 2배씩 증가하고, 작업당 비용은 2025년 동안 100배 이상 하락했으며, vLLM 같은 추론 엔진도 15개월간 40% 효율이 개선되었다. Mixture-of-Experts 모델 아키텍처로 매개변수 6B에서 0.8B로 줄이면서도 성능 유지 가능해졌고, Mamba 아키텍처는 메모리 필요량을 5배 이상 감소시켜 3~6년 내 지역 실행이 현실화될 전망이다. 전체 요약 8문장 읽기 → 014 09:10 ▲ 100 · 댓글 9 2026년 AI 추론이 주도권 잡으며 전용 칩 전쟁 시작 AI는 2020년 이후 대규모 모델 학습에만 집중했으나, 2026년 추론이 핵심 과제로 급부상했다. AI · 머신러닝 · The Inference Hardware Revolution of 2026
Key Point 기존 학습 중심의 AI 인프라 전략이 완전히 뒤바뀌고 있으며, 추론 전용 하드웨어가 새로운 경쟁 구도를 만들고 있기 때문이다.
핵심 요약
AI는 2020년 이후 대규모 모델 학습에만 집중했으나, 2026년 추론이 핵심 과제로 급부상했다. 추론형 AI 모델과 에이전트 AI 확산으로 인해 추론 수요가 폭발적으로 증가했고, 일부 고추론 모델은 저추론 모델 대비 20배 이상의 텍스트를 생성한다. 학습과 추론은 계산 방식이 완전히 다르다: 학습은 역전파로 매개변수를 갱신하지만, 추론은 이전 토큰의 모든 가중치와 문맥을 반복 읽어야 하는 자기회귀 방식이다. 전체 요약 4문장 읽기 → 015 00:10 ▲ 669 · 댓글 262 Cerebras와 OpenAI, GPT-5.6 Sol 울트라팩스트 모드 공개 Cerebras와 OpenAI가 새로운 서비스 계층 울트라팩스트 모드를 OpenAI API에 출시했으며, 초당 최대 750개 토큰을 생성한다. AI · 머신러닝 · Accelerating GPT-5.6 Sol Ultrafast
Key Point 고성능 AI 추론 기술의 실질적 진전을 보여주는 사례로, GPU 기반 시스템의 근본적 한계를 새로운 아키텍처로 극복한 점이 개발자 커뮤니티의 관심을 받고 있다.
핵심 요약
Cerebras와 OpenAI가 새로운 서비스 계층 울트라팩스트 모드를 OpenAI API에 출시했으며, 초당 최대 750개 토큰을 생성한다. 울트라팩스트 모드는 Fable 5보다 11배, Opus 4.8 Fast 모드보다 5배 빠르며, 품질 저하 없이 동작한다. Cerebras의 Wafer-Scale Engine 아키텍처가 칩에 44GB SRAM을 탑재하여 메모리 대역폭 병목을 제거해 고속 추론을 실현한다.