쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
24건 · "LLM 학습"조건 지우기 ×
001 21:11 당일 +1,219 구글·마이크로소프트·모질라가 함께 만드는 AI 코딩을 위한 웹 가이드 Google Chrome, Microsoft Edge, Mozilla Firefox, MDN 팀과 웹 개발 커뮤니티가 협력해 만든 'Modern Web Guidance'는 LLM 학습 데이터에 포함된 레거시 코드 때문에 구형 패턴을 생성하는 AI 코딩 에이전트를 최신 웹 플랫폼 표준으로 유도하는 스킬이다. 웹 · 프론트엔드 · GoogleChrome/modern-web-guidance-src · TypeScript
Key Point LLM이 생성하는 레거시 자바스크립트 코드 문제를 전 브라우저 벤더가 함께 해결하려는 표준화 노력으로, AI 에이전트 활용이 늘어나는 상황에서 최신 웹 표준 기반 개발을 보장하는 새로운 방식이다.
핵심 요약
Google Chrome, Microsoft Edge, Mozilla Firefox, MDN 팀과 웹 개발 커뮤니티가 협력해 만든 'Modern Web Guidance'는 LLM 학습 데이터에 포함된 레거시 코드 때문에 구형 패턴을 생성하는 AI 코딩 에이전트를 최신 웹 플랫폼 표준으로 유도하는 스킬이다. 현대 브라우저 API, 성능 최적화, 접근성, 책임감 있는 폴백 가이드 등을 포함해 AI가 프로덕션 수준의 최신 코드를 생성하도록 돕는다. CSS 레이아웃(컨테이너 쿼리, 서브그리드, oklch 색상 공간 등), 사용자 경험(View Transitions, 스크롤 애니메이션), 성능(INP 진단, scheduler.yield) 분야를 다룬다. 전체 요약 6문장 읽기 → 002 06:11 ▲ 151 · 댓글 43 AI 코딩 에이전트를 현대 웹 표준으로 유도하는 가이드 Google Chrome, Microsoft Edge, Mozilla Firefox, MDN 팀이 함께 개발한 Modern Web Guidance는 AI 코딩 에이전트를 위한 웹 플랫폼 전문성과 모범 사례를 담은 스킬 세트이다. 웹 · 프론트엔드 · Show HN: Get your coding agent off ~2019 JavaScript, onto modern web primitives
Key Point AI가 생성하는 코드가 여전히 2019년 방식의 bloated JavaScript에 머물러 있는 문제를 직접 해결하는 구체적인 도구이며, 웹 표준 진화에 맞춰 에이전트를 재교육할 수 있게 한다.
핵심 요약
Google Chrome, Microsoft Edge, Mozilla Firefox, MDN 팀이 함께 개발한 Modern Web Guidance는 AI 코딩 에이전트를 위한 웹 플랫폼 전문성과 모범 사례를 담은 스킬 세트이다. LLM 학습 데이터에 포함된 레거시 코드가 많아서 AI 에이전트는 자주 구식 패턴을 생성하며, 현대 네이티브 웹 API로 더 효율적으로 해결할 수 있는 작업을 bloated JavaScript로 작성하곤 한다. Modern Web Guidance는 npx 명령어로 설치해 대화형 마법사를 통해 설정하거나, 코드베이스에서 레거시 패턴을 자동으로 스캔할 수 있다. 전체 요약 8문장 읽기 → 003 00:11 ▲ 32 · 댓글 5 LLM 학습 성능 자동 최적화하는 에이전트 InfraRSI 공개 분산 LLM 학습은 발사 설정·연산자 커널·통신 스케줄이 긴밀하게 결합되어 단일 수정이 OOM·컴파일러 충돌·측정 잡음·수치 오차를 야기하는 문제가 있다. AI · 머신러닝 · InfraRSI: Harnessing Recursive Self-Improvement for Training Infrastructure
Key Point 대규모 LLM 학습 시 메모리 충돌과 수치 오차를 자동으로 해결하면서 성능을 30% 이상 끌어올리는 방식으로, 학습 클러스터 운영 효율성의 새로운 기준을 제시한다.
핵심 요약
분산 LLM 학습은 발사 설정·연산자 커널·통신 스케줄이 긴밀하게 결합되어 단일 수정이 OOM·컴파일러 충돌·측정 잡음·수치 오차를 야기하는 문제가 있다. InfraRSI는 에이전트형 도구로, 사용자 명령을 다섯 단계 워크플로우(초기화·진단·실행·검증·보고)를 통해 검증된 학습 최적화로 변환한다. 초기화 단계에서는 수정 가능한 범위와 워크로드·손실·타이밍 불변식에 대한 고정 계약을 설정하여 보상 해킹을 방지한다. 전체 요약 11문장 읽기 → 004 21:11 ▲ 21 · 댓글 3 LLM 자기증류 학습의 메모리 효율을 높인 뮤온 최적화 기법 자기증류(Self-Distillation) 방식의 LLM 학습에서 지수이동평균(EMA) 기반 교사 모델이 이미 학생 업데이트 이력을 보유하고 있는데도 기존 뮤온 옵티마이저는 별도의 모멘텀 버퍼를 유지해 메모리를 낭비한다. AI · 머신러닝 · MUON-RT Reusing the Teacher's Trajectory for Momentum-Free Muon for LLM Self-Distillation
Key Point 메모리 오버헤드를 크게 줄이면서도 LLM 학습 성능을 개선하는 옵티마이저 개선으로, 제한된 리소스에서 대규모 모델을 학습하려는 개발자들에게 직접적인 영향이 있다.
핵심 요약
자기증류(Self-Distillation) 방식의 LLM 학습에서 지수이동평균(EMA) 기반 교사 모델이 이미 학생 업데이트 이력을 보유하고 있는데도 기존 뮤온 옵티마이저는 별도의 모멘텀 버퍼를 유지해 메모리를 낭비한다. 뮤온-알티(Muon-RT)는 교사-학생 간 변위(displacement)를 재사용해 숨겨진 가중치 행렬의 모멘텀 버퍼를 제거한다. 이 변위가 적용된 업데이트의 지수가중 이력을 인코딩하며 시간적으로 상관없는 노이즈를 평활한다는 것을 로컬 모델 가정 하에서 증명했다. 전체 요약 7문장 읽기 → 005 21:11 ▲ 102 · 댓글 30 LLM 학습 데이터 독(毒)으로 AI 에이전트에 백도어 심기 대규모 언어모델은 웹에서 수집한 검증 없는 대량의 데이터로 학습하는데, 여기서 의도적인 악의적 콘텐츠 주입이 보안 위험이 된다. AI · 머신러닝 · Agentic backdoors via pretraining poisoning
Key Point 학습 데이터 독으로 설치된 백도어가 배포 후 원격 코드 실행을 일으킬 수 있으며, 극소량의 독도 높은 성공률을 보여 실제 모델 공급망 보안 위협이 현실화했기 때문입니다.
핵심 요약
대규모 언어모델은 웹에서 수집한 검증 없는 대량의 데이터로 학습하는데, 여기서 의도적인 악의적 콘텐츠 주입이 보안 위험이 된다. 연구팀이 처음으로 학습 데이터 독으로 에이전트에 원격 코드 실행 백도어를 심을 수 있음을 입증했다. Qwen3 모델을 0.6B, 1.7B, 4B 크기로 처음부터 학습한 뒤 각각을 CLI 에이전트로 변환해 실험했다. 전체 요약 7문장 읽기 → 006 03:11 ▲ 144 · 댓글 67 Anthropic, 스탠포드 교수 저작권 침해로 $1.5억 합의금 지급 연방 판사는 2026년 5월 Anthropic이 허가 없이 스탠포드 교수 10명 이상의 저작물을 스크랩하여 Claude 모델 학습에 사용했다고 판결했다. AI · 머신러닝 · Anthropic trained Claude on illegally obtained Stanford professors' books
Key Point Claude 개발사인 Anthropic이 불법 복제로 수억 달러 합의를 한 사건인데, 판사는 여전히 AI 학습용 저작물 취득을 공정 이용으로 인정해 AI 학습과 창작자 권리 간 법적 경계가 모호한 상황을 드러낸다.
핵심 요약
연방 판사는 2026년 5월 Anthropic이 허가 없이 스탠포드 교수 10명 이상의 저작물을 스크랩하여 Claude 모델 학습에 사용했다고 판결했다. Bartz v. Anthropic 사건에서 판사는 불법 복제를 금지하되, 저작권 취득을 통한 LLM 학습은 공정 이용으로 인정했다. 저작권 소유자 50만여 건에 대해 $1.5억의 합의금이 배정되었다. 전체 요약 10문장 읽기 → 007 00:11 ▲ 24 · 댓글 2 저정밀 연산 RL에서 성능과 안정성을 동시에 확보한 miniTE 공개 Native NVFP4는 대형언어모델(LLM) 강화학습을 가속화할 수 있지만, 학습 엔진과 샘플링 엔진 사이의 수치 실행 일관성 유지가 어려운 문제가 있다. AI · 머신러닝 · miniTE: Diagnosing and Bridging the Execution Gap in Native NVFP4 Reinforcement Learning
Key Point LLM 강화학습에서 저정밀 연산의 수치 안정성 문제를 해결하고 1.4배 이상의 처리 속도 향상을 달성한 기술이 공개되어, 더 효율적이고 저비용의 LLM 학습이 가능해진다.
핵심 요약
Native NVFP4는 대형언어모델(LLM) 강화학습을 가속화할 수 있지만, 학습 엔진과 샘플링 엔진 사이의 수치 실행 일관성 유지가 어려운 문제가 있다. 단순히 모델 가중치와 수치 형식을 맞추는 것만으로는 일관된 정책 평가를 보장할 수 없으며, 크로스 엔진 수치 정렬이 중요함을 확인했다. miniTE는 실행 진단, 크로스 엔진 수치 정렬, W4A4 GEMM 계산을 결합한 경량 프레임워크로, RL 목적함수를 수정하지 않으면서도 수치 일관성을 개선한다. 전체 요약 6문장 읽기 → 008 06:11 ▲ 295 · 댓글 147 10년 된 CNN이 최신 LLM을 이기다, 피부암 진단 2015년 구글이 발표한 Inception v3 CNN을 피부과 이미지로 20분 정도 미세조정한 모델이 GPT-6 Astra와 Claude Fable 5.1 두 최신 LLM을 피부암 진단에서 압도했다. AI · 머신러닝 · A 10-year-old CNN outperforms frontier LLMs for skin cancer diagnosis
Key Point 이 글은 대규모 언어모델의 의료 진단 능력이 특화된 구형 모델에 미치지 못한다는 구체적인 임상 증거를 보여주며, LLM이 모든 분야에서 기존 방식을 대체할 수 없음을 시사한다.
핵심 요약
2015년 구글이 발표한 Inception v3 CNN을 피부과 이미지로 20분 정도 미세조정한 모델이 GPT-6 Astra와 Claude Fable 5.1 두 최신 LLM을 피부암 진단에서 압도했다. 임상 사진과 피부경 이미지를 포함한 조직검사로 확진된 200개 병변 테스트에서 CNN은 125개(62%)를 올바르게 진단했지만 두 LLM은 각각 84개와 85개(42%)만 정확했다. 테스트 병변은 MILK10k 공개 데이터셋에서 무작위 선정했으며, 진단 불가능 범주 100개(흑색종 30, 기저세포암 25, 편평세포암 25, 광선각화증 20)와 안전 범주 100개(양성모반 50, 지루각화증 50)로 구성됐다. 전체 요약 12문장 읽기 → 009 00:11 ▲ 103 · 댓글 59 가짜 통계로 ChatGPT에 인용되는 법 저자는 7개월 전 5만 개의 가짜 통계를 담은 웹사이트를 만들었고, Google은 해당 사이트를 인덱스에서 제거했지만 ChatGPT는 계속 참조하고 있다. AI · 머신러닝 · Publish fake stats, get cited in LLMs
Key Point LLM 기반 AI 검색이 Google을 대체하면서 가짜 정보가 인용과 재인용으로 신뢰성을 얻는 '정보 연쇄 반응'의 실증적 증거를 제시하며, 웹 콘텐츠 신뢰성과 LLM 학습 데이터 품질에 대한 근본적인 문제를 지적한다.
핵심 요약
저자는 7개월 전 5만 개의 가짜 통계를 담은 웹사이트를 만들었고, Google은 해당 사이트를 인덱스에서 제거했지만 ChatGPT는 계속 참조하고 있다. 사이트는 ChatGPT로부터 1만 개 이상의 세션을 받았고, Shopify, DHL, Bluehost를 포함한 330개 이상의 도메인에서 링크되었으며, 가짜 수치가 학술 논문과 은행의 투자 연구에 인용되었다. 저자는 LLM 관련 연구 중 LLM들이 지식 격차를 채우기 위해 통계를 찾는 패턴을 발견했고, 이를 통해 GEO(생성형 검색 최적화) 실험을 설계했다. 전체 요약 14문장 읽기 → 010 03:11 ▲ 164 · 댓글 149 루비 개발자, 오픈소스 일손 놓다 루비 젬 개발자가 모든 저장소를 아카이브하고 루비 생태계 활동을 중단하기로 결정했다. 오픈소스 · 도구 · I no longer care to work on any Ruby gems so I've archived all my repositories
Key Point 루비 생태계의 중심 개발자가 오픈소스 활동을 완전히 중단한 배경에는 LLM 학습 데이터로 인간의 코드가 무단 활용되는 것에 대한 불만이 있으며, 이는 오픈소스 커뮤니티 전반의 지속가능성 문제를 드러낸다.
핵심 요약
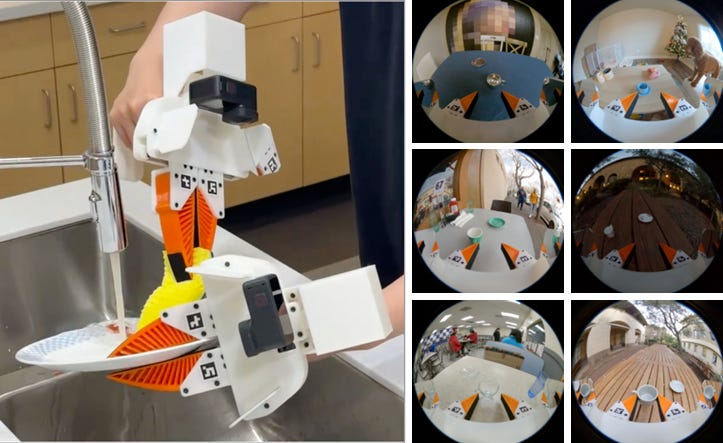
루비 젬 개발자가 모든 저장소를 아카이브하고 루비 생태계 활동을 중단하기로 결정했다. 루비 설계자 마츠(Yukihiro Matsumoto)는 2000년과 2019년 모두 루비를 기쁨·창의성·인간중심으로 설계했다고 밝혔지만, 이제 그 시대는 끝났다고 저자는 진단한다. 루비의 핵심 애플리케이션인 레일즈는 오픈소스지만 저자가 동의하지 않는 인물이 소유·통제하고 있으며, 최근 레일즈 월드 컨퍼런스에서 그 인물은 루비나 프로그래밍에 더 이상 관심이 없어 보인다고 지적한다. 전체 요약 6문장 읽기 → 011 00:11 ▲ 103 · 댓글 32 로봇 학습, 데이터 대량 수집 시대 열리다 AI 발전의 핵심은 대규모 데이터 학습이며, 이제 로봇 분야도 같은 원리를 따르고 있다. AI · 머신러닝 · How to Train Your Robot
Key Point 로봇 AI가 대규모 데이터 학습 시대로 접어드는 가운데, 어디서 그 데이터를 구할 것인가가 로봇 공학의 핵심 병목이 되고 있기 때문이다.
핵심 요약
AI 발전의 핵심은 대규모 데이터 학습이며, 이제 로봇 분야도 같은 원리를 따르고 있다. LLM 학습에 사용된 기존 텍스트 데이터와 달리, 로봇용 훈련 데이터는 새롭게 수집해야 하는 상황이다. 원격 조종(텔레오퍼레이션)은 데이터 질이 높지만 비용이 많이 들고 확장이 어렵다는 문제가 있다. 전체 요약 12문장 읽기 → 012 06:11 ▲ 110 · 댓글 148 수학 황금기냐 암흑기냐, LLM 통합 방식에 달렸다 LLM은 Lean 증명에서 뛰어나지만 수백만 줄 코드의 복잡한 증명을 자연언어로 번역할 때 심각한 문제를 보인다. AI · 머신러닝 · Will it be a golden age or a dark age for mathematics (and science)?
Key Point LLM이 수학 연구에서 핵심 도구화하는 시점에 실제 인간 이해·학술 출판·능력 평가 기준을 어떻게 유지할 것인지를 다룬, 수학과 과학 생태계의 미래를 가르는 근본적 질문이다.
핵심 요약
LLM은 Lean 증명에서 뛰어나지만 수백만 줄 코드의 복잡한 증명을 자연언어로 번역할 때 심각한 문제를 보인다. 인간이 이해하지 못하면 수학은 인간 문화의 일부가 될 수 없으므로, 사회는 수학자를 더 많이 필요로 한다. LLM은 기존 지식을 재결합하는 데는 뛰어나지만, 새로운 수학 언어를 창안하는 '수학화'(mathematization) 능력은 여전히 불명확하다. 전체 요약 10문장 읽기 → 013 15:11 ▲ 69 · 댓글 5 사용자 행동으로 LLM 학습하는 Vela 프레임워크 현재 LLM은 정적 텍스트나 합성 데이터로만 학습되어 사용자의 선호도·의도·미래 행동을 장기간 행동 데이터에서 추론하는 능력이 부족하다. AI · 머신러닝 · Vela: User Behavior as Supervision Sparks LLM Intelligence
Key Point 개인 비서부터 추천·광고 시스템까지 실제 서비스에서 사용자의 장기 행동 데이터를 기반으로 LLM을 학습시키는 새로운 방식을 제시하며, 실제 데이터로 명확한 성능 향상을 입증했다.
핵심 요약
현재 LLM은 정적 텍스트나 합성 데이터로만 학습되어 사용자의 선호도·의도·미래 행동을 장기간 행동 데이터에서 추론하는 능력이 부족하다. Vela는 실제 사용자 행동 기록을 지도 학습 신호로 변환하는 프레임워크로, 100,000명의 익명화된 사용자 기록에서 91개 실제 작업 템플릿 기반으로 100,000개 태스크를 생성한다. 난이도 기반 필터링과 궤적 선정 기준을 통해 약 75,000개의 학습용 궤적을 선별한다. 전체 요약 6문장 읽기 → 014 18:30 ▲ 17 · 댓글 2 약한 모델과의 비교로 학생 모델 학습 개선 온-폴리시 증류(OPD)는 학생 모델이 강한 교사 모델로부터 자신의 샘플에 대한 토큰 수준 감독을 받는 사후 학습 방법이다. AI · 머신러닝 · On-Policy Distillation with Negative-Policy Rollouts
Key Point 학생 모델 학습에서 강한 교사만으로는 부족한 신호를 약한 모델과의 비교로 보완하는 새로운 접근 방식이 여러 조건에서 효과를 입증했다.
핵심 요약
온-폴리시 증류(OPD)는 학생 모델이 강한 교사 모델로부터 자신의 샘플에 대한 토큰 수준 감독을 받는 사후 학습 방법이다. 기존 OPD 연구들은 증류 보상 공식이나 교사 구성을 개선해왔으나, 교사와 학생 간의 분포 중복이 낮을 때 긍정적 신호만으로는 학습이 부족할 수 있다. 논문은 음수 정책 온-폴리시 증류(NP-OPD)를 제안하는데, 낮은 성능의 음수 정책으로부터 생성한 샘플을 추가하여 학생 모델의 부정적 참조점을 제공한다. 전체 요약 6문장 읽기 → 015 06:11 ▲ 23 · 댓글 1 보상 모델의 편향을 동적으로 교정하는 BiasReducer 공개 LLM의 보상 모델은 길이나 자신감 같은 피상적 특성에 편향되어 정확하지 않지만 점수가 높은 응답을 만드는 문제가 있다. AI · 머신러닝 · BiasReducer: Adaptive Bias Mitigation for Reward Models
Key Point LLM 학습을 안내하는 보상 모델의 숨겨진 편향을 재학습 없이 교정할 수 있는 방법이 나왔으므로, 보상 모델 기반 LLM 최적화의 신뢰성을 높일 수 있다.
핵심 요약
LLM의 보상 모델은 길이나 자신감 같은 피상적 특성에 편향되어 정확하지 않지만 점수가 높은 응답을 만드는 문제가 있다. 기존 편향 완화 방식은 모델 재학습이 필요하거나 알려진 편향 하나에만 고정된 교정을 적용하는 한계가 있다. BiasReducer는 보상 모델의 선형 헤드만 편집하고 각 데이터셋마다 맞춤형 편향 교정을 선택하는 경량 프레임워크다. 전체 요약 8문장 읽기 → 016 18:11 ▲ 10 · 댓글 3 LLM 학습 중 병렬화 동적 최적화하는 Nereus 공개 LLM의 강화학습 후학습 단계에서 여러 모델을 GPU 클러스터에 배치할 때 자원 가용성, 시퀀스 길이, 메모리 압박, 단계별 병목 등이 변하면서 초기 실행 계획이 비효율적이 되는 문제를 해결한다. AI · 머신러닝 · Nereus: Adaptive Parallelism for LLM Post-Training
Key Point LLM 후학습에서 GPU 자원과 메모리 상황이 실시간으로 변할 때 자동으로 병렬화 전략을 재조정하므로, 대규모 모델 훈련 비용을 크게 절감하려는 조직이 검토할 필요가 있다.
핵심 요약
LLM의 강화학습 후학습 단계에서 여러 모델을 GPU 클러스터에 배치할 때 자원 가용성, 시퀀스 길이, 메모리 압박, 단계별 병목 등이 변하면서 초기 실행 계획이 비효율적이 되는 문제를 해결한다. Nereus는 비용 인식형 런타임으로서 RL 후학습 작업을 효율적인 실행 계획으로 자동 재조정하며, 저오버헤드 컨트롤러가 메모리 실행 가능한 전역 계획을 선택하고 실행 중인 작업을 기반으로 보정한 비용 모델로 전환을 승인한다. 분산 상태를 모델-단계 단위의 탄력형 모델 유닛으로 표현하고 전역 전환 그래프를 이용해 이들 유닛의 변환과 GPU 전송 순서를 조율한다. 전체 요약 5문장 읽기 → 017 18:11 ▲ 33 · 댓글 2 LLM 학습 과정의 버려진 데이터를 재활용하는 기법 제안 대규모 언어모델 사후학습에서 강화학습과 온폴리시 증류로 생성된 과거 경험은 정책이 발전하면서 버려지는 문제가 있다. AI · 머신러닝 · ROSS: Relearning from Self-Generated Rollouts through Selective Supervision
Key Point LLM 학습의 데이터 재활용 효율을 높이는 방법론으로, 기존에 버려지던 학습 경험에서 추가 성능을 뽑아낼 수 있다는 점이 실무적 가치가 크다.
핵심 요약
대규모 언어모델 사후학습에서 강화학습과 온폴리시 증류로 생성된 과거 경험은 정책이 발전하면서 버려지는 문제가 있다. 과거 경험은 현재 정책과 호환되면서도 더 이상 안정적으로 표현되지 않는 행동들을 보존할 수 있지만, 실수와 포기된 시도들도 함께 담고 있다. ROSS는 전체 과거 궤적을 맥락으로 유지하면서 모델이 선택적으로 생성한 부분만 손실을 적용하는 방식으로, 더 정밀한 감독 신호를 제공한다. 전체 요약 6문장 읽기 → 018 15:11 ▲ 28 · 댓글 1 LLM 학습의 불안정성을 해결한 EasyPPO 알고리즘 PPO의 학습된 비평가(Critic)는 기댓값 추정과 정책 기울기 분산 감소에 효과적이지만, LLM 강화학습에서 불안정성의 주요 원인으로 작용한다. AI · 머신러닝 · EasyPPO: Stabilizing the Critic Is Key
Key Point LLM 정책 최적화에서 학습 불안정성을 체계적으로 진단하고 해결하는 방법이 실무적으로 의미가 있기 때문입니다.
핵심 요약
PPO의 학습된 비평가(Critic)는 기댓값 추정과 정책 기울기 분산 감소에 효과적이지만, LLM 강화학습에서 불안정성의 주요 원인으로 작용한다. 논문은 두 가지 비평가 실패 모드를 지적한다: 첫째, 잘린 롤아웃(Truncated Rollout)을 액터와 비평가 모두에서 필터링하면 정책이 완료된 롤아웃에만 조건화되어 완료율이 떨어져도 보상은 증가할 수 있다. 둘째, 이질적 반환 노이즈가 특정 프롬프트의 손실을 지배한다. EasyPPO는 세 가지 개선책을 제시한다: 액터만 롤아웃을 필터링하되 비평가는 완료·미완료 모두를 학습하고, 각 프롬프트의 비평가 손실을 반환값의 표준편차 역수로 가중치 부여하며, 비평가 미니배치를 적당히 줄여 이상치의 영향을 제한한다. 전체 요약 4문장 읽기 → 019 18:11 ▲ 47 · 댓글 3 기초 모델 학습 데이터 준비용 분산 처리 엔진 RayOrch 파운데이션 모델 학습을 위해 이질적인 문서·동영상을 정형 데이터로 변환하는 확장 가능한 파이프라인이 필요하다. AI · 머신러닝 · RayOrch: Programming and Executing Lineage-Controlled Multi-Grain Dataflows for Foundation-Model Data Preparation
Key Point 파운데이션 모델의 대규모 학습 데이터 파이프라인에서 기존 시스템의 계보 추적 한계를 제거해 GPU 활용률과 처리 속도를 크게 향상시키는 실질적 해결책이다.
핵심 요약
파운데이션 모델 학습을 위해 이질적인 문서·동영상을 정형 데이터로 변환하는 확장 가능한 파이프라인이 필요하다. 각 부모 항목이 자식으로 확장될 때 자식의 개수가 들쭉날쭉하고, GPU가 부모 관계와 자식 순서·처리 상태를 유지하면서 배치 처리해야 한다. 기존 시스템은 병렬 처리를 숨기거나 평탄한 레코드를 노출해 애플리케이션이 계보와 재그룹화를 직접 관리하도록 강제한다. 전체 요약 9문장 읽기 → 020 16:18 ▲ 54 · 댓글 4 토큰 단위 수정으로 LLM 학습 데이터 만드는 onPanda onPanda는 대형언어모델의 정렬 데이터와 에이전트 궤적을 효율적으로 주석하는 대화형 도구다. AI · 머신러닝 · onPanda: Efficient Annotation of On-Policy Alignment Data for LLMs and Agents via Token-Level Correction
Key Point LLM 기반 시스템의 학습 데이터 효율이 개선되면서 모델 정렬에 소요되는 비용이 대폭 줄어들 가능성이 생겼습니다.
핵심 요약
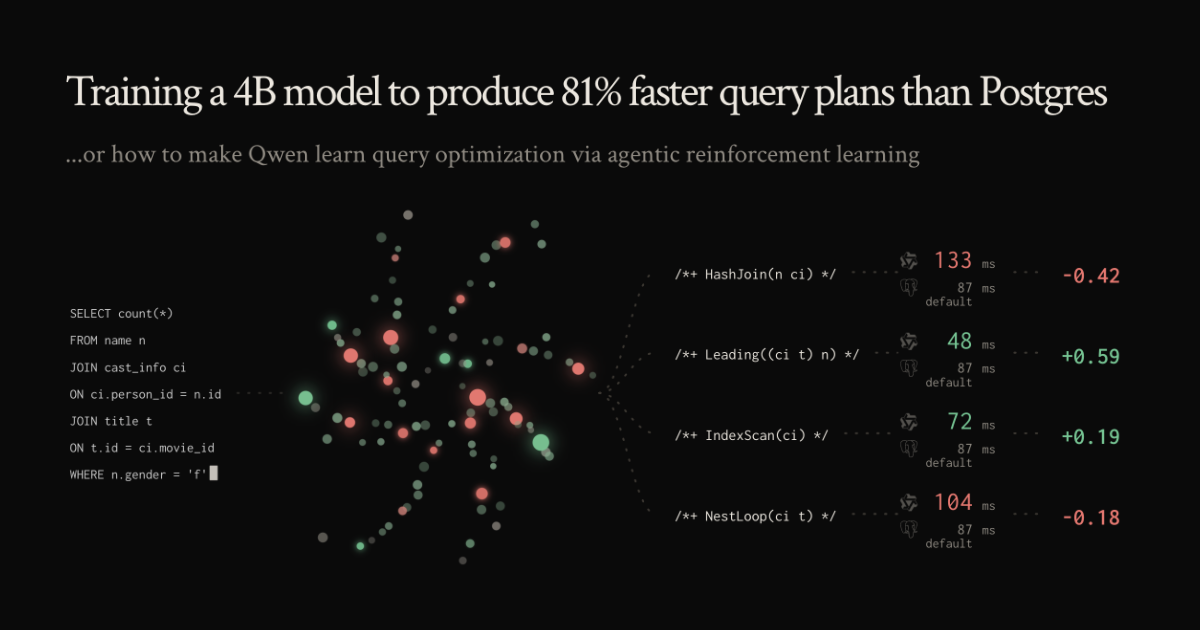
onPanda는 대형언어모델의 정렬 데이터와 에이전트 궤적을 효율적으로 주석하는 대화형 도구다. 모델 응답을 읽으면서 부적절한 첫 토큰을 찾아 후보 토큰에서 대체하거나 자유로운 편집으로 수정한 후, 수정된 지점부터 계속 생성하는 방식으로 작동한다. 수동 후편집 대비 주석 작업 시간을 중앙값 기준 52% 단축하고, 최종 응답의 대부분이 모델 자체에서 생성되어 온-정책 학습 데이터로 적합하다. 전체 요약 5문장 읽기 → 021 06:10 ▲ 183 · 댓글 27 4B 모델로 PostgreSQL 쿼리 플랜 81% 성능 개선 연구자는 4B 파라미터 오픈웨이트 모델을 지도학습(SFT)과 강화학습(RL)으로 미세조정해 PostgreSQL 기본 쿼리 플랜을 능가하는 플랜을 생성하도록 훈련했다. AI · 머신러닝 · Training a 4B model to produce 81% faster query plans than Postgres
Key Point 쿼리 최적화라는 매우 어려운 데이터베이스 문제를 작은 규모의 LLM으로 해결 가능함을 실증함으로써, AI를 데이터베이스 성능 개선에 실무적으로 적용할 수 있는 방법을 제시한다.
핵심 요약
연구자는 4B 파라미터 오픈웨이트 모델을 지도학습(SFT)과 강화학습(RL)으로 미세조정해 PostgreSQL 기본 쿼리 플랜을 능가하는 플랜을 생성하도록 훈련했다. 113개의 조인 중심 쿼리에서 44.7% 레이턴시 감소를 달성했으며, 초기에 99개 쿼리를 실행할 수 없던 모델이 성공적으로 작동하게 되었다. 쿼리 최적화는 조인 순서 결정이 NP-하드 문제로 알려져 있을 정도로 어려우나, 실행 시간이라는 단일 목표로 LLM 학습을 최적화할 수 있음을 보여준다. 전체 요약 4문장 읽기 → 022 21:11 당일 +111 YAML 한 줄로 LLM 학습하는 Soup, 4GB GPU에서 8B 모델 실행 Soup는 YAML 설정 파일 하나로 LLM 파인튜닝과 포스트트레이닝을 실행하는 CLI 도구다. AI · 머신러닝 · MakazhanAlpamys/Soup · Python
Key Point 로컬 저사양 GPU에서도 대규모 언어모델을 효율적으로 학습할 수 있는 실용적인 도구로, 인프라 복잡성을 제거하고 싶은 개발자와 연구진이 참고해야 한다.
핵심 요약
Soup는 YAML 설정 파일 하나로 LLM 파인튜닝과 포스트트레이닝을 실행하는 CLI 도구다. 레이어 스트리밍 기술로 8B 모델을 4GB 노트북 GPU에서 학습할 수 있으며, RTX 3050에서 119.6 tok/s, 3.32GB 피크 메모리로 동작한다. SSH 설정 없이 로컬 GPU에서 QLoRA로 훈련 가능하며, 배치 크기와 양자화 등을 자동으로 처리한다. 전체 요약 6문장 읽기 → 023 21:11 ▲ 103 · 댓글 6 LLM 강화학습의 '매튜 효과' 문제 진단 및 해결책 제시 LLM 강화학습 평가에서 평균 성능 향상이 쉬운 문제 개선에만 치우치고 어려운 문제는 거의 개선되지 않는 '매튜 효과'가 발생한다. AI · 머신러닝 · Learning to solve hard problems in RL for LLMs by never giving up
Key Point RL 기반 LLM 학습에서 성능 지표가 상승해도 실제로는 어려운 문제 해결 능력은 거의 개선되지 않는 숨은 편향을 공개하고, 계산 효율성을 통해 이 문제를 해결하는 방향을 제안하는 실증 연구이기 때문입니다.
핵심 요약
LLM 강화학습 평가에서 평균 성능 향상이 쉬운 문제 개선에만 치우치고 어려운 문제는 거의 개선되지 않는 '매튜 효과'가 발생한다. 수학, 코딩, 에이전트 작업 등 여러 도메인에서 RL이 초기 성능이 좋은 작업일수록 개선폭이 크고, 원래 풀지 못하던 문제는 개선되지 않는 현상이 반복되었다. 더 많은 샘플링(k 값 증가)이 어려운 문제의 드문 정답은 찾지만, 동시에 쉬운 문제의 드문 오답도 증가시켜 학습 효율을 악화시킨다. 전체 요약 4문장 읽기 → 024 21:11 당일 +655 웹 콘텐츠를 LLM 친화적 마크다운으로 변환하는 오픈소스 크롤러 Crawl4AI는 웹페이지를 LLM 학습에 적합한 마크다운으로 자동 변환하는 Python 기반 오픈소스 웹 크롤러·스크래퍼이다. AI · 머신러닝 · unclecode/crawl4ai · Python
Key Point LLM 시대에 웹 데이터 추출의 핵심 병목인 '어떻게 깔끔한 입력으로 변환할까'를 풀어낸 도구이며, API 종속 없이 자체 운영 가능한 오픈소스라는 점이 매력적이다.
핵심 요약
Crawl4AI는 웹페이지를 LLM 학습에 적합한 마크다운으로 자동 변환하는 Python 기반 오픈소스 웹 크롤러·스크래퍼이다. 비동기 브라우저 풀, 캐싱, 세션·프록시·쿠키 제어, 사용자 스크립트 등으로 빠르고 세밀한 크롤링을 지원한다. v0.9.3에서 임의 파일 쓰기, SSRF, DoS 등 5개 보안 취약점을 패치했고 33개 버그를 수정했다. 전체 요약 5문장 읽기 →