쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
49건 · "embed"조건 지우기 ×
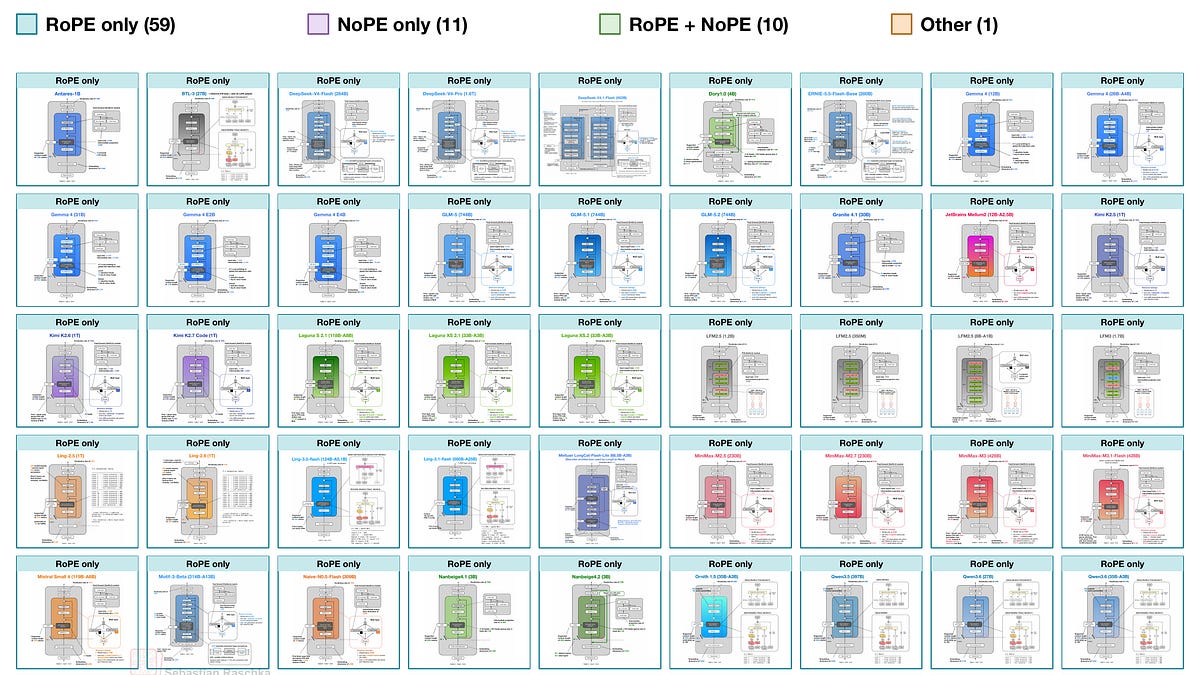
001 03:11 ▲ 127 · 댓글 3 LLM의 위치 정보 처리 방식: RoPE까지 완벽 가이드 언어 모델이 토큰의 위치 정보를 인코딩하고 처리하는 방식을 다루는 기술 가이드로, 고전적 방법부터 현대 기법까지 시각 자료와 수식, PyTorch 코드 예제를 통해 설명한다. AI · 머신러닝 · Understanding Positional Embeddings in Modern LLMs
Key Point 위치 임베딩은 LLM 아키텍처의 기초 요소이며 GPT-2의 학습된 벡터, 원래 트랜스포머의 사인·코사인 함수, 현대 모델의 RoPE 등 진화 과정을 이해하면 LLM의 작동 원리와 각 아키텍처의 설계 선택을 파악할 수 있다.
핵심 요약
언어 모델이 토큰의 위치 정보를 인코딩하고 처리하는 방식을 다루는 기술 가이드로, 고전적 방법부터 현대 기법까지 시각 자료와 수식, PyTorch 코드 예제를 통해 설명한다. 토큰 임베딩 계층이 입력 텍스트를 벡터로 변환한 후 위치 정보가 추가되는데, GPT-2는 변환기 블록 전에 위치 벡터를 더하고 MiniMax-M3은 어텐션 내부에서 RoPE 방식으로 위치 정보를 주입한다. 같은 토큰이 다른 위치에 나타나도 동일한 임베딩을 받으므로 명시적 위치 정보가 필요하며, 인과 마스크만으로도 암묵적 순서 정보를 제공하지만 위치 간 거리 차이를 구별하지 못한다. 전체 요약 8문장 읽기 → 002 06:11 ▲ 154 · 댓글 30 600번의 실험으로 발견한 JEPA 월드 모델의 최적 설계 JEPA(joint-embedding predictive architecture)는 픽셀 생성 대신 임베딩 공간에서 예측하는 월드 모델로, 인코더·예측기·플래너 세 부분으로 구성된다. AI · 머신러닝 · After 600 experiments, here's what I discovered about JEPA world models
Key Point JEPA 월드 모델의 병목이 예측이 아니라 계획 방식임을 실험으로 증명했고, 재학습 없이 네 가지 방법으로 성공률을 3배 이상 향상시킨 구체적 기법들을 제시한다.
핵심 요약
JEPA(joint-embedding predictive architecture)는 픽셀 생성 대신 임베딩 공간에서 예측하는 월드 모델로, 인코더·예측기·플래너 세 부분으로 구성된다. LeWM 모델을 600회 실험한 결과, 예측 정확도 개선보다 계획 방식 변경이 더 큰 효과를 발휘했다. LeWM의 예측기를 완벽한 물리 시뮬레이터로 바꿔도 성공률이 78%에서 77%로 거의 변하지 않아, 병목은 모델의 예측이 아닌 사용 방식임을 확인했다. 전체 요약 12문장 읽기 → 003 06:11 ▲ 102 · 댓글 36 Chromium 엔진을 라이브러리로 심는 Zebkit 공개 Zebkit은 Chrome과 별개의 독립 애플리케이션으로 Chromium 엔진을 라이브러리 형태로 제공하며, Blink·V8·PDFium·FFmpeg 등을 포함하면서 Chrome 브라우저와 Electron 런타임은 제외한다. 오픈소스 · 도구 · Zebkit – Chromium as an embeddable library
Key Point Electron을 대체하려는 개발자와 크롬 기능이 필요한 데스크톱 앱 개발자는 압축된 크기와 3배 빠른 자동화 성능을 고려할 가치가 있으며, 기존 Electron 프로젝트는 마이그레이션 옵션을 검토할 수 있다.
핵심 요약
Zebkit은 Chrome과 별개의 독립 애플리케이션으로 Chromium 엔진을 라이브러리 형태로 제공하며, Blink·V8·PDFium·FFmpeg 등을 포함하면서 Chrome 브라우저와 Electron 런타임은 제외한다. Linux·macOS·Windows에서 동일한 API로 작동하며 C·C++·Rust·Python·Go·JavaScript 중 원하는 언어로 개발할 수 있고, 자신의 이벤트 루프와 윈도우 툴킷을 유지한다. SQLite·LevelDB·BoringSSL·zlib·Zstandard·Brotli·ICU·HarfBuzz·libxml2 등 17개 C 라이브러리를 포함하며 각 플랫폼에서 7,487개 이상의 함수를 zebkit_vendor_* 형태로 내보낸다. 전체 요약 12문장 읽기 → 004 03:11 ▲ 102 · 댓글 24 Servo 0.7.0, 웹표준 기능 대폭 확충 웹 렌더링 엔진 Servo가 9월 동안 527개 커밋을 통해 0.7.0 버전을 릴리스했다. 웹 · 프론트엔드 · September in Servo: <progress>, rounded rectangles, and more
Key Point 웹 표준 호환성 확대와 성능 최적화가 동시에 진행 중인 오픈소스 렌더링 엔진의 큰 업데이트로, 웹 개발자와 Servo 기여자들이 진행 상황을 파악해야 할 시점이다.
핵심 요약
웹 렌더링 엔진 Servo가 9월 동안 527개 커밋을 통해 0.7.0 버전을 릴리스했다. 요소, :checked 의사클래스, user-select 속성, CSS typed arithmetic, alpha() 함수, font-width 속성 등 새로운 웹 플랫폼 기능을 추가했다. parentRule, version, getComposedRanges(), baseURL, CSS 모듈, SVG 요소들, MLKEM768-X25519 알고리즘, roundRect(), PerformancePaintTiming 등 다양한 DOM API를 구현했다. 전체 요약 14문장 읽기 → 005 21:11 당일 +1,155 NVIDIA Auto-Ontology, 데이터 위에 의미 기반 추론층 구축 NVIDIA가 오픈소스 프레임워크 Auto-Ontology를 공개했으며, 이는 데이터 위에 시맨틱·그래프 기반 추론층을 만들어 에이전트가 더 정확한 답변을 제공할 수 있게 한다. AI · 머신러닝 · NVIDIA/auto-ontology · Python
Key Point LLM 에이전트의 쿼리 정확성이 속도보다 중요한 엔터프라이즈 데이터 환경에서, 잘못된 답변을 줄이기 위해 비즈니스 개념을 명시적으로 정의하고 검증하는 새로운 아키텍처 패턴을 제시합니다.
핵심 요약
NVIDIA가 오픈소스 프레임워크 Auto-Ontology를 공개했으며, 이는 데이터 위에 시맨틱·그래프 기반 추론층을 만들어 에이전트가 더 정확한 답변을 제공할 수 있게 한다. 에이전트가 쿼리하기 전에 데이터의 위치, 의미, 사용 방법, 출처, 유사 데이터를 파악해야 신뢰할 수 있는 쿼리를 생성할 수 있다는 점이 핵심이다. 데이터베이스 메타데이터에서 온톨로지를 자동 생성하고, 비즈니스 용어를 컬럼에 매핑하며, 테이블 간 관계와 검수된 SQL을 저장한다. 전체 요약 13문장 읽기 → 006 21:11 ▲ 47 · 댓글 2 MLLM을 활용한 이미지 검색 정확도 향상 방법 제시 Composed Image Retrieval(CIR)는 참조 이미지와 수정 텍스트를 입력받아 목표 이미지를 검색하는 작업이다. AI · 머신러닝 · Factorized MLLM Embeddings for Composed Image Retrieval
Key Point 이미지 검색 태스크에서 멀티모달 모델의 합성적 이해를 명시적으로 활용하는 새로운 구조를 제안하며, 계산 효율성을 유지하면서 성능 향상을 이루는 방법론이 실용성 있다.
핵심 요약
Composed Image Retrieval(CIR)는 참조 이미지와 수정 텍스트를 입력받아 목표 이미지를 검색하는 작업이다. 기존 MLLM 기반 방식들은 합성 쿼리를 직접 검색 임베딩으로 매핑하면서 MLLM의 합성적 이해 능력을 제대로 활용하지 못한다. 본 연구는 Factorized MLLM Embeddings(FactEmbed)를 제안하여 합성 쿼리 이해와 판별 임베딩 구축을 분리한다. 전체 요약 9문장 읽기 → 007 00:11 ▲ 119 · 댓글 36 TechCrunch 자동재생 영상 차단하는 uBlock Origin 필터 TechCrunch의 모든 기사는 본문 중간에 JW Player 영상을 자동재생하며, 숨기는 것만으로는 백그라운드에서 계속 실행된다. 오픈소스 · 도구 · uBlock Origin filter to block autoplay videos in TechCrunch
Key Point TechCrunch 접속 시 중단 없는 콘텐츠 읽기를 원하는 사용자들을 위해 즉시 적용 가능한 필터 코드와 설정 방법을 제공한다.
핵심 요약
TechCrunch의 모든 기사는 본문 중간에 JW Player 영상을 자동재생하며, 숨기는 것만으로는 백그라운드에서 계속 실행된다. Connatix의 플로팅 광고 플레이어도 함께 로드되고 있다. uBlock Origin의 네트워크 필터 규칙으로 JW Player와 Connatix 스크립트를 차단하면 영상이 로드되지 않는다. 전체 요약 8문장 읽기 → 008 21:11 ▲ 113 · 댓글 33 엔비디아가 AI 에이전트용 온톨로지 라이브러리 오픈소스로 공개 엔비디아가 Auto Ontology를 오픈소스로 공개했으며, AI 에이전트가 데이터베이스와 문서를 조회할 때 신뢰성을 보장하기 위한 컨텍스트 계층 역할을 한다. AI · 머신러닝 · Nvidia – open-source auto-ontology
Key Point 데이터 기반 시스템에서 AI 에이전트의 답변 신뢰성을 보장하는 새로운 표준이 등장했으며, 엔터프라이즈 메타데이터로부터 자동 생성되는 온톨로지는 복잡한 다중 시스템 환경에서 정의 충돌을 해소하는 핵심 인프라가 된다.
핵심 요약
엔비디아가 Auto Ontology를 오픈소스로 공개했으며, AI 에이전트가 데이터베이스와 문서를 조회할 때 신뢰성을 보장하기 위한 컨텍스트 계층 역할을 한다. 에이전트에게 메트릭과 엔티티의 신뢰할 수 있는 비즈니스 의미를 제공하고, 시스템 간 정의를 조화시키며, MCP·CLI·API를 통해 모든 에이전트 도구에 노출한다. 엔터프라이즈 메타데이터에서 온톨로지를 생성하고, 기존 온톨로지와 시맨틱 모델을 연결하며, AI 준비 상태의 지식 그래프를 구축할 수 있다. 전체 요약 13문장 읽기 → 009 15:11 ▲ 22 · 댓글 2 모달리티 넘나드는 임베딩 모델, 통합 프레임워크로 재정의 이미지, 텍스트, 음성 등 모달리티별로 분화된 임베딩 모델 연구가 실은 대조 학습, Transformer 아키텍처, 세밀도 전환이라는 공통 원리로 수렴하고 있다고 지적한다. AI · 머신러닝 · From Fragmentation to Fusion: A Survey and Roadmap for Omnimodal Embeddings
Key Point 멀티모달 AI의 핵심 기술인 임베딩의 분산된 연구를 처음 통합 프레임워크로 정리해, 앞으로의 모달리티 간 통합 기술 발전 방향을 가늠할 수 있습니다.
핵심 요약
이미지, 텍스트, 음성 등 모달리티별로 분화된 임베딩 모델 연구가 실은 대조 학습, Transformer 아키텍처, 세밀도 전환이라는 공통 원리로 수렴하고 있다고 지적한다. 논문은 멀티모달 임베딩의 진화 경로를 세 가지 진행 단계로 정의한다: 커버리지 확대, 비교 가능성 확보, 구성성 달성이다. 각 단계를 위한 통합 방안으로 변환(transformation)은 모달리티 간 커버리지를 확대하고, 정렬(alignment)은 서로 다른 모달리티를 비교 가능하게 만든다. 전체 요약 6문장 읽기 → 010 00:11 ▲ 140 · 댓글 62 ChatGPT 공유 링크 하나로 계정 탈취 가능한 취약점 발견 2026년 10월, 공개 공유된 ChatGPT 대화 링크를 통해 피해자의 인증된 세션에서 임의의 JavaScript를 실행할 수 있는 취약점이 발견됐다. 보안 · We Took over ChatGPT Accounts
Key Point 공개 링크 하나만으로 남의 ChatGPT 계정을 완전히 제어할 수 있었던 심각한 보안 결함이며, 샌드박스 · 메시징 · CSP 같은 개별 방어 수단이 어떻게 조합되면 무너지는지 보여주는 사례입니다.
핵심 요약
2026년 10월, 공개 공유된 ChatGPT 대화 링크를 통해 피해자의 인증된 세션에서 임의의 JavaScript를 실행할 수 있는 취약점이 발견됐다. 그래프 기능이 MathLive 라이브러리를 로드할 때 메인 페이지에 메시지 리스너를 설치했고, HTML Preview에서 postMessage API를 통해 출처 검증 없이 신뢰되지 않은 HTML을 포함한 메시지를 보낼 수 있었다. MathLive가 수신한 메시지의 발신자를 확인하지 않고, HTML을 키보드 레이아웃으로 받아들였으며, 이를 ChatGPT 메인 페이지에 innerHTML로 삽입했다. 전체 요약 11문장 읽기 → 011 21:11 당일 +258 로컬-퍼스트 AI 메모리 시스템 MemPalace 공개 MemPalace는 대화 기록을 그대로 저장하고 시맨틱 검색으로 검색하는 오픈소스 AI 메모리 시스템으로, 요약이나 의역 없이 원문을 보존한다. AI · 머신러닝 · MemPalace/mempalace · Python
Key Point LLM 기반 AI 시스템에서 과거 대화를 정확히 기억하고 활용하는 것이 성능을 좌우하는데, 이 프로젝트가 원문 보존과 의미 검색의 균형을 구현해 API 비용 없이 96.6%의 높은 정확도를 달성했기 때문이다.
핵심 요약
MemPalace는 대화 기록을 그대로 저장하고 시맨틱 검색으로 검색하는 오픈소스 AI 메모리 시스템으로, 요약이나 의역 없이 원문을 보존한다. 사람과 프로젝트를 '윙(wing)', 주제를 '룸(room)', 원문을 '드로어(drawer)'로 구조화해 검색을 특정 범위로 제한할 수 있으며, 검색 백엔드는 플러그인 방식으로 교체 가능하다. 기본값은 ChromaDB이고 SQLite, Milvus, Qdrant, PostgreSQL(pgvector) 등 다양한 백엔드를 지원하며, 사용자 기계를 벗어나는 데이터는 명시적 동의 하에서만 외부로 나간다. 전체 요약 10문장 읽기 → 012 21:11 ▲ 108 · 댓글 32 웹에서 Swift 언어로 UI 만드는 ElementaryUI WebAssembly를 통해 선언형 Swift 애플리케이션을 브라우저에서 네이티브로 실행할 수 있다. 웹 · 프론트엔드 · ElementaryUI – Swift, in the Browser
Key Point iOS 개발자들이 이미 익숙한 Swift와 SwiftUI 패턴으로 웹 애플리케이션을 만들 수 있게 되면서, 플랫폼 간 개발 경험의 간격을 줄일 수 있다.
핵심 요약
WebAssembly를 통해 선언형 Swift 애플리케이션을 브라우저에서 네이티브로 실행할 수 있다. Swift의 친숙한 문법을 그대로 사용해 웹 UI를 직관적으로 구축한다. @State, @Environment, @Reactive를 활용한 자동 상태 관리를 지원한다. 전체 요약 7문장 읽기 → 013 06:11 ▲ 28 · 댓글 2 멀티모달 임베딩의 새로운 기준, EmbeddingGemma 2 공개 Google이 오픈 멀티모달 임베딩 모델 EmbeddingGemma 2를 발표했다. AI · 머신러닝 · EmbeddingGemma 2: Unified and Efficient Multimodal Representations
Key Point 멀티모달 검색과 임베딩 생성이 필요한 개발자와 머신러닝 엔지니어에게 오픈 모델 선택지가 생겼으며, 작은 모델로 대형 모델 수준의 성능을 달성할 수 있다는 것이 중요하다.
핵심 요약
Google이 오픈 멀티모달 임베딩 모델 EmbeddingGemma 2를 발표했다. 텍스트, 이미지, 오디오, 비디오를 단일 벡터 공간에 통합으로 표현한다. 단순화된 계층별 임베딩과 모달리티·목표 기반 다단계 커리큘럼을 도입했다. 전체 요약 7문장 읽기 → 014 03:11 ▲ 16 · 댓글 4 Gemma 4 임베딩을 극도로 압축하는 OPTIC 기법 공개 Gemma 4 E4B의 매개변수 35.2%를 차지하는 Per-Layer Embeddings(PLE)의 극도 압축 기법 OPTIC을 개발했다. AI · 머신러닝 · Extreme Compression of Per-Layer Embeddings via Cross-Layer Latent Vector Quantization
Key Point 대규모 언어 모델의 임베딩 매개변수가 점차 커지는 추세에서, 성능 손실을 최소화하면서 극도의 압축을 달성할 수 있는 새로운 방법을 제시한다.
핵심 요약
Gemma 4 E4B의 매개변수 35.2%를 차지하는 Per-Layer Embeddings(PLE)의 극도 압축 기법 OPTIC을 개발했다. OPTIC은 토큰마다 하나의 양자화된 코드를 저장하고, 각 층에서 층별 아핀 디코더로 디코딩하는 방식을 사용한다. 코드와 디코더는 저장된 벡터가 아닌 PLE 출력 경로에 맞춰 학습된다. 전체 요약 7문장 읽기 → 015 03:11 ▲ 122 · 댓글 7 포스 언어 Gforth 1.0 공개, 멀티태스킹 기능 추가 포스(Forth) 언어의 구현인 Gforth 1.0이 릴리스되었으며, 새로운 기능들이 문서화되었다. 오픈소스 · 도구 · Gforth 1.0
Key Point 포스 언어의 주요 구현이 멀티태스킹, 메시지 큐, C 통합 등 현대적 기능을 갖춘 1.0으로 업그레이드되어 시스템 프로그래밍과 임베디드 시스템 개발 시 활용도가 달라진다.
핵심 요약
포스(Forth) 언어의 구현인 Gforth 1.0이 릴리스되었으며, 새로운 기능들이 문서화되었다. 스택 디버깅용 'Smart .s'는 스택 항목이 무엇을 의미하는지 추측해 적절히 표시하고, 터미널 하단에 BASE, 스택, 검색 순서를 보여주는 상태 줄이 추가되었다. 멀티코어/하드웨어 스레드에서 작동하는 멀티태스킹을 지원하며, newtask, task, initiate, execute-task, kill-task, mutex, lock, unlock 등의 단어들을 제공한다. 전체 요약 8문장 읽기 → 016 06:11 새 버전 Hugging Face Transformers v5.21 릴리스, 5개 신규 모델 추가 Transformers 라이브러리가 v5.21.0을 릴리스했으며, 문서 인식부터 음성 합성까지 5개 모델을 새로 지원한다. AI · 머신러닝 · huggingface/transformers@v5.21
Key Point 문서 이해, 음성 합성 등 신규 모델 5개가 추가되고 병렬 처리·양자화·캐시 처리가 크게 개선되어 LLM과 멀티모달 모델 개발자들에게 직접적인 영향이 있다.
핵심 요약
Transformers 라이브러리가 v5.21.0을 릴리스했으며, 문서 인식부터 음성 합성까지 5개 모델을 새로 지원한다. MiniCPM-OCR은 OpenBMB의 모델로 SigLIP 비전 인코더와 Qwen3.5 언어 모델을 결합해 스캔 페이지, 스크린샷, 영수증 등 텍스트 밀집 이미지를 읽는다. Flint는 Recursive의 혼합 전문가 모델로 슬라이딩 윈도우 주의(512개 토큰 범위)와 완전 주의를 결합하며, 각 희소 계층이 256개 전문가 중 6개를 라우팅한다. 전체 요약 12문장 읽기 → 017 18:11 ▲ 126 · 댓글 31 OBS Studio 33 출시, 브라우저 소스와 플러그인 체계 개편 OBS Studio 33.0.0이 출시되었으며, CEF(Chromium Embedded Framework)를 127/6533에서 150/7871로 대폭 업데이트해 브라우저 소스와 도크의 기반 프레임워크를 2024년 7월에서 2026년 9월 수준으로 개선했다. 오픈소스 · 도구 · OBS Studio 33
Key Point 브라우저 소스 기반 프레임워크의 대규모 업데이트와 플러그인 체계 개편으로 인해, OBS를 사용하는 스트리머·콘텐츠 크리에이터와 플러그인 개발자는 호환성 변화에 주의해야 한다.
핵심 요약
OBS Studio 33.0.0이 출시되었으며, CEF(Chromium Embedded Framework)를 127/6533에서 150/7871로 대폭 업데이트해 브라우저 소스와 도크의 기반 프레임워크를 2024년 7월에서 2026년 9월 수준으로 개선했다. 플러그인 로딩 체계를 완전히 개편했으며, 1차 플러그인은 'core' 폴더로 이동하고 3차 플러그인은 새로운 설치 위치와 폴더 구조를 적용했으나, 기존 3차 플러그인은 OBS Studio 34.0까지 기존 위치에서 로드된다. 프리뷰에서 소스 스냅 동작을 개선하여 시각적 지표를 추가했고, 소스가 전체 축을 따라 스냅되며 숨겨진 소스로의 스냅은 비활성화했다. 전체 요약 13문장 읽기 → 018 21:11 당일 +107 100개 이상 LLM을 하나로, LiteLLM AI 게이트웨이 OpenAI, Anthropic, Bedrock, Azure, VertexAI, Nvidia NIM 등 100개 이상의 LLM API를 단일 OpenAI 형식 인터페이스로 호출 가능한 오픈소스 AI 게이트웨이 LiteLLM을 GitHub Trending에서 공개했다. AI · 머신러닝 · BerriAI/litellm · Python
Key Point 다양한 LLM 공급자별로 다른 API를 통합 관리해야 하는 개발팀에게 표준화된 인터페이스와 엔터프라이즈급 기능(비용 추적, 로드밸런싱, 접근 제어)을 제공하므로 멀티 클라우드·멀티 모델 환경에서 운영 복잡도를 크게 낮출 수 있다.
핵심 요약
OpenAI, Anthropic, Bedrock, Azure, VertexAI, Nvidia NIM 등 100개 이상의 LLM API를 단일 OpenAI 형식 인터페이스로 호출 가능한 오픈소스 AI 게이트웨이 LiteLLM을 GitHub Trending에서 공개했다. Python SDK로 직접 통합하거나 프록시 서버로 중앙화된 LLM 게이트웨이로 배포할 수 있으며, Rust 코어 기반으로 1000 RPS에서 P95 레이턴시 8ms를 달성한다. 가상 키, 비용 추적, 가드레일, 로드 밸런싱, 로깅, 관리 대시보드를 기본으로 제공하고 Netflix 등 대규모 조직에서 이미 채택하고 있다. 전체 요약 13문장 읽기 → 019 12:11 ▲ 273 · 댓글 69 mitmproxy, 손상된 eMudhra 인증서로 서명하는 옵션 추가 TLS 프록시 도구 mitmproxy에 --emudhra 옵션을 추가했다. 보안 · mitmproxy adds --emudhra option
Key Point 보안 검증이나 인증서 신뢰 체인 테스트가 필요한 개발자들이 손상된 CA 키로 인증서를 발급할 수 있는 도구를 갖추게 된다.
핵심 요약
TLS 프록시 도구 mitmproxy에 --emudhra 옵션을 추가했다. 이 옵션은 손상된 eMudhra 중간 CA 개인키로 클라이언트 인증서를 서명하도록 한다. eMudhra는 인도의 인증서 발급 기관이며, 해당 CA 개인키의 손상이 공개되었다. 전체 요약 9문장 읽기 → 020 06:11 ▲ 124 · 댓글 49 Rust 컴파일러, 2026년 주요 개선 사항 정리 Rust 컴파일러가 2026년에 여러 장기 프로젝트들의 결실이 동시에 나오는 시기를 맞이했다. 오픈소스 · 도구 · 2026 is an exciting year for the Rust compiler (and me)
Key Point Rust 생태계의 핵심 인프라인 컴파일러가 10년 단위의 장기 프로젝트들을 동시에 완성하며 성능·기능·개발 환경 전반에 걸쳐 근본적인 개선이 일어나는 전환점이기 때문이다.
핵심 요약
Rust 컴파일러가 2026년에 여러 장기 프로젝트들의 결실이 동시에 나오는 시기를 맞이했다. 차세대 트레이트 솔버는 타입 시스템의 대규모 재구현으로 약 10년간 진행되었으며, 타입 시스템의 근본적인 기술 부채를 해결하고 async Rust와 impl Trait의 제약을 풀어준다. Polonius는 새로운 보로우 체커 구현으로 더 많은 코드가 컴파일되도록 하고 내부 참조 등 관련 기능들을 언블록한다. 전체 요약 13문장 읽기 → 021 21:11 ▲ 13 · 댓글 4 임베딩 테이블을 16MB 고정 코드로 대체, 소형 모델 파일 1/7 축소 소형 언어 모델에서 임베딩 테이블은 전체 파라미터의 대부분을 차지하고, Gemma 3 270M 모델의 경우 268M 파라미터 중 168M이 임베딩 테이블이며, 양자화 후에도 16비트로 남아 파일 크기의 대부분을 차지한다. AI · 머신러닝 · Embeddings Are Overpriced? A Frozen 16 MB Vocabulary for Small and Ternary Language Models
Key Point 소형 모델 배포 시 파일 크기가 1/7로 축소되고 CPU 속도가 5~6배 빨라지므로, 엣지 디바이스와 저사양 환경에서의 모델 배포 방식을 바꿀 가능성이 있다.
핵심 요약
소형 언어 모델에서 임베딩 테이블은 전체 파라미터의 대부분을 차지하고, Gemma 3 270M 모델의 경우 268M 파라미터 중 168M이 임베딩 테이블이며, 양자화 후에도 16비트로 남아 파일 크기의 대부분을 차지한다. 연구팀은 학습 가능한 임베딩 테이블을 주성분 투영과 부호 이진화로 도출한 512비트 코드의 동결 테이블(16MB, 학습 가능 파라미터 없음)로 대체하고, 동일한 Gemma 형태의 모델을 2.05B 토큰으로 학습했다. 학습된 임베딩 테이블은 0.20 나츠 검증 손실을 위해 2.6배 많은 학습 가능 파라미터를 필요로 했으나, LAMBADA, HellaSwag, PIQA 벤치마크에서는 동결 테이블 모델이 동일하거나 더 나은 성능을 보였고 ARC-Easy에서만 학습된 테이블이 앞섰다. 전체 요약 6문장 읽기 → 022 18:11 새 버전 FastAPI 0.151.0, JSON null 값 처리 방식 변경 FastAPI 0.151.0에서 JSON 요청 본문의 null 값과 생략된 값을 구분하기 시작했다. 웹 · 프론트엔드 · fastapi/fastapi@0.151.0
Key Point FastAPI의 요청 검증 동작이 명확해져 명시적 null 처리가 더 엄격해졌으므로, 기존 클라이언트의 동작을 확인하고 필요시 수정해야 한다.
핵심 요약
FastAPI 0.151.0에서 JSON 요청 본문의 null 값과 생략된 값을 구분하기 시작했다. 개별 Body 파라미터에서 null은 None으로 검증되며, nullable 타입은 이를 수용하고 non-nullable 타입은 기본값이 정의되어 있어도 거부한다. 기본값과 기본값 팩토리는 값이 생략되었을 때만 적용되며, 이는 JSON 객체 내부의 파라미터와 전체 본문을 나타내는 파라미터 모두에 적용된다. 전체 요약 5문장 읽기 → 023 18:11 ▲ 81 · 댓글 2 MRL 개선한 SpecMRL, 절반 차원으로 전체 성능 달성 Matryoshka Representation Learning(MRL)은 유연한 표현 크기를 지원하도록 중첩된 접두사를 공동 최적화하지만, 앞부분이 적절한 압축 인코딩을 제공한다는 명시적 제약이 부족하다. AI · 머신러닝 · SpecMRL: Redesign Matryoshka Representation Learning within Parametric Spectrum
Key Point 벡터 압축 기술이 검색·추천·분류 등 다양한 AI 서비스의 성능과 비용을 결정하는데, MRL의 핵심 한계를 해결하고 절반의 용량으로 같은 품질을 달성한 방법론이다.
핵심 요약
Matryoshka Representation Learning(MRL)은 유연한 표현 크기를 지원하도록 중첩된 접두사를 공동 최적화하지만, 앞부분이 적절한 압축 인코딩을 제공한다는 명시적 제약이 부족하다. 이를 해결하기 위해 SpecMRL을 제안하는데, 특성 중요도로 조직된 매개변수 파생 스펙트럼 기반을 추가하여 피처 공간을 재구성한다. SpecMRL은 표준 MRL을 따르면서 학습된 스펙트럼 공간에서 접두사 읽기를 수행한다. 전체 요약 6문장 읽기 → 024 12:11 ▲ 10 · 댓글 1 카메라 기하학 정보로 로봇 비전-언어 모델의 다중 카메라 성능 향상 Vision-language-action(VLA) 모델은 로봇 조작에 의미론적 지식을 제공하지만, 시각 표현이 2D 이미지 좌표에 기반해 다중 카메라 시스템의 기하학적 관계를 활용하지 못한다. AI · 머신러닝 · G^3VLA: Geometric Inductive Bias for Vision-Language-Action Models
Key Point 로봇 비전 모델이 다중 카메라 시스템의 기하학적 관계를 명시적으로 활용하는 방법을 제시하여, 실제 로봇 시스템에서 카메라 수와 각도에 관계없이 안정적인 성능을 달성할 수 있게 한다.
핵심 요약
Vision-language-action(VLA) 모델은 로봇 조작에 의미론적 지식을 제공하지만, 시각 표현이 2D 이미지 좌표에 기반해 다중 카메라 시스템의 기하학적 관계를 활용하지 못한다. G³VLA는 카메라 내부 파라미터와 외부 파라미터를 이용한 기하학적 모듈로, 사전학습된 VLA의 시각 토큰 스트림에 보정된 카메라 구조를 주입한다. 내부 파라미터 조건 광선 임베딩(ray embedding), 투영 위치 인코딩(PRoPE), 양방향 교차 뷰 융합을 결합해 카메라 뷰 간 기하학적으로 일관된 표현을 구축한다. 전체 요약 8문장 읽기 → 025 06:11 ▲ 10 · 댓글 2 대비 학습 전략, 정말 효과적인지 검증했더니 멀티모달 표현 학습에서 대비 학습(Contrastive Learning)이 표준 패러다임이 되었으나, 실제 성능 효과는 제대로 검증되지 않았다. AI · 머신러닝 · What Really Works for Universal Multimodal Embeddings? A Controlled Study of Contrastive Training Strategies
Key Point 기존에 널리 쓰이던 대비 학습 전략들이 실제로는 효과가 미미하거나 역효과를 낸다는 것을 체계적으로 증명해, 멀티모달 모델 개발자들이 어떤 조합이 정말 작동하는지 알 수 있게 했다.
핵심 요약
멀티모달 표현 학습에서 대비 학습(Contrastive Learning)이 표준 패러다임이 되었으나, 실제 성능 효과는 제대로 검증되지 않았다. 음수 선택, 배치 구성, 그래디언트 조정 등 다양한 대비 학습 전략들이 제안되었지만, 통제된 조건에서 그 실효성은 불명확했다. 연구팀은 MMEB 벤치마크에서 대표적인 전략들을 통일된 프레임워크로 평가한 결과, 대부분이 기본 기준선 대비 미미한 개선만 제공하며 일부는 성능을 악화시키는 것으로 나타났다. 전체 요약 8문장 읽기 → 026 12:11 ▲ 64 · 댓글 1 픽셀 재구성 없이 로봇 제어하는 JEPA 모델 등장 Joint-embedding predictive architectures (JEPAs)는 픽셀 재구성 없이 간결한 잠재 세계 모델을 학습하는 방식인데, 기존 파이프라인은 시각 표현과 행동 조건 역학을 따로 학습한 뒤 정책을 추가했다. AI · 머신러닝 · LeWAM: End-to-End World and Action Modeling with JEPAs
Key Point 기존 세계 모델 방식을 통합해 로봇 제어 성공률을 3배 이상 높이고 계획 속도를 획기적으로 개선한 새로운 아키텍처로, 시뮬레이션과 실제 로봇 모두에서 실용성을 입증했다.
핵심 요약
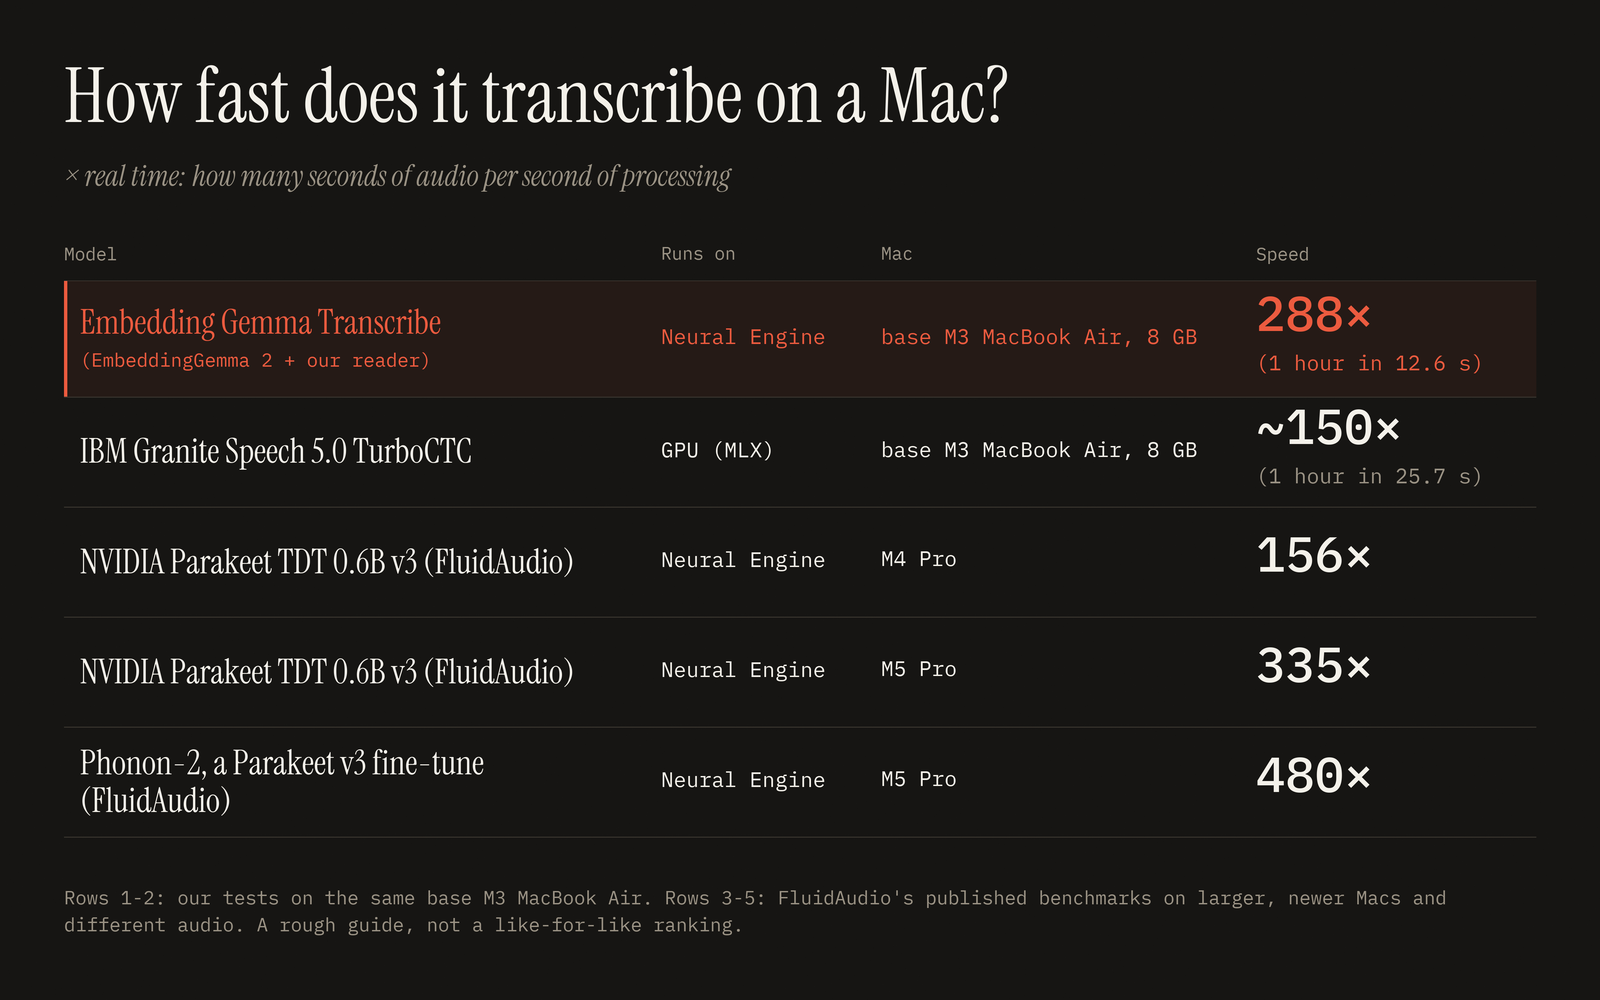
Joint-embedding predictive architectures (JEPAs)는 픽셀 재구성 없이 간결한 잠재 세계 모델을 학습하는 방식인데, 기존 파이프라인은 시각 표현과 행동 조건 역학을 따로 학습한 뒤 정책을 추가했다. 레카이(LeWAM)는 엔드-투-엔드 JEPA로서 다음 잠재 상태 예측과 행동 흐름 매칭을 함께 학습하고, 잠재 상태에 등방 가우시안 제약을 적용한다. 이 설계로 하나의 모델이 정책 직접 실행과 학습된 잠재 역학으로 샘플 행동을 평가하는 효율적인 계획을 모두 지원할 수 있다. 전체 요약 6문장 읽기 → 027 00:11 ▲ 238 · 댓글 57 EmbeddingGemma 2를 음성 인식 모델로 개조한 실험 Google의 다중 모달 임베딩 모델 EmbeddingGemma 2를 음성-텍스트 변환 모델로 개조했다. AI · 머신러닝 · We turned EmbeddingGemma 2 into a speech-to-text model
Key Point 다중모달 임베딩 모델을 음성 인식으로 새롭게 활용한 창의적 접근과 Apple Silicon에서의 빠른 실시간 처리 성능이 주목할 만하다.
핵심 요약
Google의 다중 모달 임베딩 모델 EmbeddingGemma 2를 음성-텍스트 변환 모델로 개조했다. 텍스트, 이미지, 오디오, 비디오를 같은 벡터 공간에 매핑하는 특성을 활용해 음성을 약 22만 9천 개 영어 단어 중 가장 가까운 단어로 매칭하는 방식으로 작동한다. 오디오 인코더는 원래 그대로 두고, 새로운 작은 리더 모델만 학습시켜 음성 슬라이스를 텍스트 공간으로 변환하며, 별도 모델이 구두점과 대문자를 추가한다. 전체 요약 7문장 읽기 → 028 21:11 당일 +333 마이크로소프트, 1비트 LLM 추론 프레임워크 공개 마이크로소프트가 1비트 LLM(BitNet b1.58)을 위한 공식 추론 프레임워크 bitnet.cpp를 출시했다. AI · 머신러닝 · microsoft/BitNet · C++
Key Point CPU만으로 초대형 언어 모델을 실용적 속도로 실행할 수 있게 되면서, 엣지 디바이스와 로컬 환경에서의 LLM 배포 방식이 근본적으로 바뀔 수 있다.
핵심 요약
마이크로소프트가 1비트 LLM(BitNet b1.58)을 위한 공식 추론 프레임워크 bitnet.cpp를 출시했다. x86 CPU에서 2.37~6.17배 속도 향상, ARM CPU에서 1.37~5.07배 향상을 달성하며 에너지 소비는 x86에서 71.9~82.2%, ARM에서 55.4~70.0% 감소한다. 100B 파라미터의 BitNet b1.58 모델을 단일 CPU에서 초당 5~7 토큰 속도로 실행 가능하다. 전체 요약 11문장 읽기 → 029 06:11 ▲ 341 · 댓글 79 16.9MB 경량 음성인식 모델 Whistle 공개 Cactus Compute가 모바일, 웨어러블, 로봇, 스마트홈, 자동차, 마이크로컨트롤러용 음성인식 모델 Whistle을 공개했다. AI · 머신러닝 · Whistle: Speech to Text in 16.9 MB
Key Point 극도로 경량화한 음성인식 모델로 온디바이스 처리가 가능해져, 엣지 환경에서 사용할 수 있는 선택지가 생겼다.
핵심 요약
Cactus Compute가 모바일, 웨어러블, 로봇, 스마트홈, 자동차, 마이크로컨트롤러용 음성인식 모델 Whistle을 공개했다. Whistle은 16.9MB 단일 파일로, CPU에서 의존성 없이 작동하며 기존 Needle 엔진과 같은 C++ 컨테이너에서 동작한다. 7개 언어(영어, 독일어, 프랑스어, 스페인어, 이탈리아어, 네덜란드어, 폴란드어) 지원하며, 최대 30초 음성을 온디바이스에서 처리한다. 전체 요약 12문장 읽기 → 030 03:11 ▲ 101 · 댓글 26 Swift로 QEMU에서 베어메탈 커널 구현하기 Embedded Swift(OS와 표준 라이브러리가 없는 환경용 Swift 부분집합)를 사용해 QEMU 가상 머신에서 실행되는 최소 커널을 작성한 실험 프로젝트이다. 인프라 · 데브옵스 · A minimal kernel in Swift, running in QEMU
Key Point OS 없는 베어메탈 환경에서 고수준 언어로 커널을 작성할 수 있음을 보여주는 실험으로, Swift의 Embedded 서브셋이 시스템 레벨 프로그래밍에 적용 가능함을 입증한다.
핵심 요약
Embedded Swift(OS와 표준 라이브러리가 없는 환경용 Swift 부분집합)를 사용해 QEMU 가상 머신에서 실행되는 최소 커널을 작성한 실험 프로젝트이다. aarch64-none-none-elf 타겟(OS 없는 64비트 ARM)으로 컴파일하기 위해 toolset.json에서 experimental 기능 활성화, 표준 라이브러리 링킹 비활성화, 커스텀 링커 스크립트 사용 등을 설정했다. CPU가 원시 상태에서 시작되므로 boot.S 어셈블리 파일에서 _start 심볼 정의, 스택 설정, Swift 진입점 호출, 보조 코어 대기 처리를 수행한다. 전체 요약 8문장 읽기 → 031 18:33 새 버전 Transformers 5.19.0, 멀티모달 임베딩과 분산학습 기능 강화 Gemma 2의 멀티모달 임베딩 모델 EmbeddingGemma2를 새로 추가했으며, 텍스트·이미지·오디오·비디오를 768차원 벡터 공간에 인코딩하고 512/256/128차원으로 축소 가능하다. AI · 머신러닝 · huggingface/transformers@v5.19.0
Key Point 멀티모달 모델 지원 확대와 분산학습 병렬화 개선으로 LLM 추론 효율이 향상되며, 주요 API 변경으로 기존 코드 마이그레이션이 필요해진다.
핵심 요약
Gemma 2의 멀티모달 임베딩 모델 EmbeddingGemma2를 새로 추가했으며, 텍스트·이미지·오디오·비디오를 768차원 벡터 공간에 인코딩하고 512/256/128차원으로 축소 가능하다. MoE(Mixture of Experts) 모델이 output_router_logits=True일 때 라우터 로짓을 반환하도록 변경되었으며, 기존 코드는 새 출력 클래스에서 로짓을 읽어야 한다. OWLv2 이미지 쿼리 선택 방식이 객체 신뢰도 점수 기준으로 변경되어 기존 기능과 결과가 달라질 수 있다. 전체 요약 7문장 읽기 → 032 18:33 ▲ 422 · 댓글 46 구글, 멀티모달 임베딩 모델 'EmbeddingGemma 2' 공개 Google DeepMind이 EmbeddingGemma 2를 공개했으며, 텍스트·이미지·오디오·비디오를 통합 임베딩 공간으로 매핑하는 가볍고 고성능의 온디바이스 멀티모달 모델이다. AI · 머신러닝 · EmbeddingGemma 2: An open, lightweight multimodal embedding model
Key Point 온디바이스에서 텍스트·이미지·오디오·비디오를 하나의 모델로 처리할 수 있게 되어, 데이터 프라이버시를 보호하면서도 로컬에서 멀티모달 검색과 RAG를 구현할 수 있는 기반이 마련됐다.
핵심 요약
Google DeepMind이 EmbeddingGemma 2를 공개했으며, 텍스트·이미지·오디오·비디오를 통합 임베딩 공간으로 매핑하는 가볍고 고성능의 온디바이스 멀티모달 모델이다. 지난해 출시한 EmbeddingGemma는 2천만 건 이상 다운로드되어 온디바이스 검색과 프라이버시 우선 RAG 파이프라인 구축에 활용됐다. EmbeddingGemma 2는 Gemma 4 아키텍처 기반, 7억 4천만 파라미터 규모이며 Apache 2.0 라이선스로 공개된다. 전체 요약 12문장 읽기 → 033 15:11 ▲ 44 · 댓글 3 비디오가 물리 법칙을 얼마나 잘 이해하나 측정하는 벤치마크 물리 현상을 정확히 표현하는 비디오 생성 모델을 평가하기 위해 World Embedding Benchmark를 공개했다. AI · 머신러닝 · World Embedding Benchmark
Key Point 비디오 생성의 물리적 정확성을 평가하는 첫 벤치마크로, 현재 AI 모델들의 물리 이해도를 측정하고 개선 방향을 보여준다.
핵심 요약
물리 현상을 정확히 표현하는 비디오 생성 모델을 평가하기 위해 World Embedding Benchmark를 공개했다. 유체역학, 고체역학, 동역학, 광학·전자기학 등 80개 종류에서 8,000개의 시뮬레이션 영상을 수집하고, 각 영상에 시뮬레이션 기반의 물리 주석을 달았다. 텍스트-영상 검색, 물리적 성질 회귀, 다중선택 분류라는 세 가지 평가 작업으로 영상 임베딩이 물리 정보를 얼마나 잘 인코딩하는지 측정한다. 전체 요약 7문장 읽기 → 034 09:11 ▲ 19 · 댓글 2 텍스트 손실 없이 멀티모달 임베딩 통합하는 경량 모델 기존 멀티모달 임베딩 모델은 텍스트, 음성, 오디오, 이미지, 비디오 등 새로운 모달리티를 추가할 때 텍스트 검색 성능이 저하되고, 수십억 개 파라미터가 필요했다. AI · 머신러닝 · Omni-Embed-Mini: Binding Modalities Without Forgetting via Dense Distillation
Key Point 기존 멀티모달 모델의 텍스트 성능 저하 문제를 해결하면서 매우 경량화한 기술로, 실제 프로덕션 배포에서 비용과 메모리 효율성이 크게 개선된다.
핵심 요약
기존 멀티모달 임베딩 모델은 텍스트, 음성, 오디오, 이미지, 비디오 등 새로운 모달리티를 추가할 때 텍스트 검색 성능이 저하되고, 수십억 개 파라미터가 필요했다. Omni-Embed-Mini는 0.9B 파라미터로 텍스트, 음성, 오디오, 이미지, 비디오, 문서를 단일 임베딩 공간에 매핑하면서 텍스트 파라미터는 고정해 손실을 방지한다. 핵심은 별도의 교사 모델 없이 각 미디어 샘플을 밀집 캐스케이딩 캡션과 쌍으로 만들고, 교사 신호는 고정된 백본의 캡션 임베딩을 그대로 사용한다는 것이다. 전체 요약 8문장 읽기 → 035 03:11 ▲ 25 · 댓글 2 이미지·텍스트 동시 생성하는 연속형 확산 모델 공개 Multimodal Flow는 텍스트와 이미지를 모두 연속적으로 생성하는 통합 생성 모델로, 기존 모델처럼 이미지를 양자화하거나 텍스트·이미지 생성 과정을 달리할 필요가 없다. AI · 머신러닝 · Multimodal Flow: Unified Flow Modeling of Language and Vision in Embedding Spaces
Key Point 텍스트와 이미지를 진정으로 통합되는 한 가지 방식으로 모두 생성할 수 있다면, 멀티모달 모델의 아키텍처가 단순해지고 더 나은 성능을 낼 수 있다는 점을 실증한다.
핵심 요약
Multimodal Flow는 텍스트와 이미지를 모두 연속적으로 생성하는 통합 생성 모델로, 기존 모델처럼 이미지를 양자화하거나 텍스트·이미지 생성 과정을 달리할 필요가 없다. 텍스트 블록과 이미지를 순서가 있는 연속적 하이퍼청크로 구성하며, Flow Matching을 통해 이들 위의 단일 벡터장을 학습한다. 크로스 모달 상호작용을 위해 공동 어텐션을 사용하고, 각 모달리티별 피드포워드 네트워크로 처리한다. 전체 요약 7문장 읽기 → 036 12:11 ▲ 49 · 댓글 2 확산형 언어모델을 위한 텍스트 임베딩 최적화 자기회귀 모델의 대안으로 주목받는 확산 언어모델(DLM)은 연속 텍스트 임베딩의 잠재공간에서 생성을 수행한다. AI · 머신러닝 · Scaling and Distilling Text Embeddings for Better Diffusibility
Key Point 확산형 언어모델이 자기회귀 방식의 성능에 접근하기 위해서는 어떤 임베딩 공간이 최적인지 밝혀지지 않았는데, 이 연구가 스케일링과 증류 기법으로 그 해답을 제시한다.
핵심 요약
자기회귀 모델의 대안으로 주목받는 확산 언어모델(DLM)은 연속 텍스트 임베딩의 잠재공간에서 생성을 수행한다. 연구팀은 T5 계열 임베딩을 T5Gemma-1, T5Gemma-2로 확대했을 때 생성 성능이 크게 향상됨을 발견했다. 그러나 T5Gemma-2는 너무 판별력이 강해서 유사한 단어들의 임베딩까지 멀리 떨어져 있어, 샘플링 오류 시 유효한 임베딩을 찾지 못하는 문제가 발생한다. 전체 요약 7문장 읽기 → 037 03:11 새 버전 Transformers 5.18.0 출시, Nemotron·NemotronH Omni 등 신모델 추가 Nemotron 3 Diarization 오픈웨이트 모델이 추가되어 실시간 음성 화자 분리를 지원하며, 최대 8명의 화자를 처리할 수 있고 80ms부터 30.4s까지 구성 가능한 지연 시간 프로필을 제공한다. AI · 머신러닝 · huggingface/transformers@v5.18.0
Key Point Transformers는 파이토치의 표준 NLP 라이브러리이며, 이 버전은 실시간 음성 처리, 멀티모달 추론, 분산 학습 최적화 등 프로덕션 환경의 여러 문제를 해결한다.
핵심 요약
Nemotron 3 Diarization 오픈웨이트 모델이 추가되어 실시간 음성 화자 분리를 지원하며, 최대 8명의 화자를 처리할 수 있고 80ms부터 30.4s까지 구성 가능한 지연 시간 프로필을 제공한다. NemotronH Omni 멀티모달 추론 모델은 Mamba-Transformer 언어 모델에 RADIO 비전 인코더와 Parakeet 사운드 인코더를 결합하여 텍스트, 이미지, 비디오, 음성을 동시에 처리한다. HyperCLOVAX Vision V2는 NAVER가 개발한 멀티모달 모델로 Qwen2.5-VL 비전 인코더를 탑재하고 체인오브싱크 추론을 위한 thinking 토큰을 지원한다. 전체 요약 8문장 읽기 → 038 21:11 당일 +101 AI 에이전트용 메모리 인프라 Mem0, 토큰 효율성 47% 향상 Mem0는 AI 에이전트와 애플리케이션을 위한 지속적인 메모리 계층을 제공하는 오픈소스 프로젝트로, 사용자 선호도와 세션·에이전트 상태를 학습해 개인화된 상호작용을 가능하게 한다. AI · 머신러닝 · mem0ai/mem0 · Python
Key Point AI 에이전트가 사용자 정보를 효과적으로 기억하고 활용하는 것이 LLM 기반 서비스의 핵심인데, 이 업데이트는 토큰 비용을 유지하면서 성능을 30% 이상 끌어올렸기 때문에 생산 환경 배포를 고민하는 팀이 참고할 만하다.
핵심 요약
Mem0는 AI 에이전트와 애플리케이션을 위한 지속적인 메모리 계층을 제공하는 오픈소스 프로젝트로, 사용자 선호도와 세션·에이전트 상태를 학습해 개인화된 상호작용을 가능하게 한다. 2026년 4월 업데이트된 새로운 메모리 알고리즘은 LoCoMo에서 71.4점에서 92.5점으로, LongMemEval에서 67.8점에서 94.4점으로 성능을 향상시켰다. 단일 LLM 호출로 동작하는 ADD-only 추출 방식을 도입해 메모리를 누적시키면서도 6.7~6.9K 토큰으로 낮은 레이턴시(0.88~1.09초)를 유지한다. 전체 요약 11문장 읽기 → 039 00:11 ▲ 116 · 댓글 29 깃에 내장된 분산형 버그 추적 도구 git-bug git-bug는 Git 저장소에 완전히 내장된 버그 추적 도구로, 별도의 서비스 없이 Git 리모트를 통해 협업하고 버그를 동기화할 수 있다. 오픈소스 · 도구 · Git-bug: Distributed, offline-first bug tracker embedded in Git
Key Point Git 저장소만으로 완전한 버그 추적 시스템을 운영할 수 있어서 외부 서비스 의존성을 제거하고 오프라인 협업을 가능하게 한다.
핵심 요약
git-bug는 Git 저장소에 완전히 내장된 버그 추적 도구로, 별도의 서비스 없이 Git 리모트를 통해 협업하고 버그를 동기화할 수 있다. 오프라인 환경에서도 작동하며, 프로젝트에 추가 파일을 남기지 않고, CLI·웹UI·GraphQL API를 통해 사용할 수 있다. Git 명령어 형태로 git bug push/pull로 버그를 동기화하고, git bug add로 새 버그를 생성하며, git bug ls로 조회 및 필터링할 수 있다. 전체 요약 7문장 읽기 → 040 22:26 당일 +131 Discord·Telegram에서 X·Bluesky 콘텐츠 제대로 보기 FxEmbed는 X(구 Twitter), Bluesky의 게시물을 Discord, Telegram 등의 플랫폼에서 제대로 임베드하는 오픈소스 프로젝트다. 오픈소스 · 도구 · FxEmbed/FxEmbed · TypeScript
Key Point Discord나 Telegram에서 X·Bluesky 게시물이 미리보기가 제대로 안 되는 문제를 간단한 방법으로 해결할 수 있습니다.
핵심 요약
FxEmbed는 X(구 Twitter), Bluesky의 게시물을 Discord, Telegram 등의 플랫폼에서 제대로 임베드하는 오픈소스 프로젝트다. 사용 방법은 간단하다. twitter.com 링크 앞에 'fx'를 붙이거나, x.com 앞에 'fixup'을, bsky.app 앞에 'fx'를 붙이면 된다. 비디오, 투표, 인용문, 번역 등 원래 플랫폼의 다양한 콘텐츠를 제대로 표시할 수 있다. 전체 요약 7문장 읽기 → 041 22:26 당일 +128 결제 인프라의 '리눅스'... 오픈소스 결제 플랫폼 하이퍼스위치 Juspay가 개발한 Hyperswitch는 모듈식 오픈소스 결제 인프라로, Rust로 빌드되어 Stripe, Adyen, Braintree 등 120개 이상의 결제 처리자와 연결된다. 오픈소스 · 도구 · juspay/hyperswitch · Rust
Key Point 단일 결제 게이트웨이에서 벗어나 여러 결제서비스공급자를 조합하려는 기업들이 직접 결제 인프라를 구축·운영할 수 있게 하는 오픈소스 솔루션이 등장했다.
핵심 요약
Juspay가 개발한 Hyperswitch는 모듈식 오픈소스 결제 인프라로, Rust로 빌드되어 Stripe, Adyen, Braintree 등 120개 이상의 결제 처리자와 연결된다. 비용 관찰성, 수익 회복, 보관소, 지능형 라우팅, 결제 대사, 대체 결제 방식 등 독립적인 모듈들을 선택해 기존 결제 스택에 통합할 수 있다. 지능형 라우팅은 거래별로 인증 성공률이 가장 높은 결제서비스공급자를 선택해 첫 시도 성공률을 최대화하고, 수익 회복은 카드 발급사, 지역, 결제 방식별로 조정된 재시도 전략을 제공한다. 전체 요약 13문장 읽기 → 042 15:11 ▲ 46 · 댓글 2 텍스트·이미지·영상·음성을 하나로 이해하는 멀티모달 임베딩 모델 공개 Hugging Face 연구팀이 텍스트, 이미지, 영상, 음성을 통합으로 처리하는 Ovis-Embedding을 발표했다. AI · 머신러닝 · Ovis-Embedding: Pushing the Frontiers of Universal Omni-Modal Embeddings
Key Point 단일 모달리티 검색의 한계를 극복하고 텍스트-영상, 음성-텍스트 등 크로스 모달 검색이 필요한 개발자와 연구자에게 새로운 기술 선택지를 제공한다.
핵심 요약
Hugging Face 연구팀이 텍스트, 이미지, 영상, 음성을 통합으로 처리하는 Ovis-Embedding을 발표했다. 기존의 분리된 모달리티 타워 대신 공유 멀티모달 백본을 사용해 모든 데이터를 공통 표현 공간으로 인코딩한다. Qwen-omni 사전학습 모델을 기반으로 대조 학습과 저랭크 초기화를 통해 학습했다. 전체 요약 5문장 읽기 → 043 15:11 ▲ 25 · 댓글 2 비디오 확산 모델이 물리법칙을 위반하는 이유 텍스트-투-비디오 확산 모델이 우수한 화질에도 불구하고 현실 물리법칙을 위반하는 영상을 생성한다. AI · 머신러닝 · Why Do Video Diffusion Models Violate Physics? Unveiling the Flaws in Attention Mechanisms
Key Point 비디오 생성 AI의 핵심 약점인 물리법칙 위반을 어텐션 메커니즘 수준에서 진단하고, 모델 재설계 없이 적용 가능한 경량 해법을 제시한다.
핵심 요약
텍스트-투-비디오 확산 모델이 우수한 화질에도 불구하고 현실 물리법칙을 위반하는 영상을 생성한다. 연구팀이 모션 계획 과정을 분석해 초기 노이징 제거 단계에서 동작 궤적이 형성되는 방식을 규명했다. Rotary Position Embedding(RoPE)이 과도한 공간 주의 감소를 야기해 초기 후보 영역이 물리적으로 불가능한 위치에 조기 고정되는 것을 발견했다. 전체 요약 5문장 읽기 → 044 15:11 ▲ 12 · 댓글 2 대문자와 소문자를 구분해 읽는 메모리, 문맥에 따라 다른 의미 포착 LLM 효율성을 높이기 위해 Mixture of Memory Embeddings(MoME)를 제안했습니다. 기존 메모리 임베딩은 토큰을 고정된 하나의 항목으로만 매핑하는데, MoME는 각 토큰마다 M개의 슬롯 중 문맥에 맞게 선택해 읽습니다. AI · 머신러닝 · MoME: Mixture-of-Memory Embeddings for Context-Aware Sparse Lookup
Key Point 토큰의 다중 의미를 문맥으로 구분해 메모리 효율성과 정확도를 동시에 높이는 기법으로, 소형 언어모델 최적화와 임베딩 기술 발전에 직결됩니다.
핵심 요약
LLM 효율성을 높이기 위해 Mixture of Memory Embeddings(MoME)를 제안했습니다. 기존 메모리 임베딩은 토큰을 고정된 하나의 항목으로만 매핑하는데, MoME는 각 토큰마다 M개의 슬롯 중 문맥에 맞게 선택해 읽습니다. 예를 들어 'python'은 프로그래밍 언어와 동물이라는 서로 다른 의미를 같은 토큰이지만 별도의 메모리 슬롯으로 저장 및 구분합니다. Llama-3, Qwen3, MobileLLM 등 여러 모델 아키텍처에서 기존 Value Embedding, Bigram, STEM 방식보다 성능이 우수했습니다. 전체 요약 5문장 읽기 → 045 21:11 당일 +271 개인용 검색 엔진 Hister 공개 방문한 웹페이지와 로컬 파일의 전문을 인덱싱하는 프라이빗 검색 엔진 Hister를 Go로 개발했다. 오픈소스 · 도구 · asciimoo/hister · Go
Key Point 개인이 웹 콘텐츠를 완전히 통제하는 프라이빗 검색 인프라가 필요한 개발자와 보안 의식 높은 사용자에게 실용적인 대안이 된다.
핵심 요약
방문한 웹페이지와 로컬 파일의 전문을 인덱싱하는 프라이빗 검색 엔진 Hister를 Go로 개발했다. Firefox·Chrome 확장 프로그램으로 자동 수집하고, 웹·터미널·MCP를 통해 검색할 수 있다. 모든 데이터가 개인 서버에만 저장되며 원격 클라우드 동기화나 텔레메트리가 없다. 전체 요약 5문장 읽기 → 046 03:10 당일 +126 E2B가 AI 에이전트용 오픈소스 런타임 공개 Go로 작성된 E2B Runtime은 스냅샷에서 빠르게 복원되는 Firecracker 마이크로VM으로 샌드박스를 실행한다. 인프라 · 데브옵스 · e2b-dev/runtime · Go
Key Point AI 에이전트가 실행할 수 없는 코드를 안전하게 격리 실행하는 인프라가 오픈소스화되어, 개발자가 자체 환경에서 신뢰할 수 없는 코드를 실행할 수 있는 기반이 마련되었다.
핵심 요약
Go로 작성된 E2B Runtime은 스냅샷에서 빠르게 복원되는 Firecracker 마이크로VM으로 샌드박스를 실행한다. 템플릿은 미리 부팅된 VM으로 객체 스토리지에 저장되며, 생성 시 커널 부팅 대신 복원만 진행되어 빠르다. 각 샌드박스는 격리된 cgroup과 네트워크 네임스페이스에서 실행되며, 도메인 화이트/블랙리스트와 이그레스 방화벽이 적용된다. 전체 요약 5문장 읽기 → 047 08:25 ▲ 119 · 댓글 54 Swift 6.4 정식 공개, 크로스플랫폼과 성능 강화 Swift Build가 Swift Package Manager의 기본값이 되어 Linux, macOS, Windows에서 동일한 방식으로 빌드된다. 웹 · 프론트엔드 · Swift 6.4 Released
Key Point 크로스플랫폼 개발자와 웹/임베디드 Swift 사용자에게 직접 영향을 미치는 주요 기능 강화로, 특히 WebAssembly 성능 40배 개선과 Subprocess 1.0 안정화는 실무 개발 경험을 크게 개선한다.
핵심 요약
Swift Build가 Swift Package Manager의 기본값이 되어 Linux, macOS, Windows에서 동일한 방식으로 빌드된다. Subprocess 1.0이 안정화되어 Swift에서 다른 프로그램을 실행하고 상호작용하는 표준 크로스플랫폼 방식을 제공한다. WebAssembly 브리징이 JavaScriptKit을 통해 최대 40배 빨라졌고, Wasm SDK를 Swift.org에서 직접 제공한다. 전체 요약 6문장 읽기 → 048 21:11 ▲ 101 · 댓글 34 5달러 ESP32를 멀티 프로토콜 하드웨어 워크벤치로 변신 ESP32 Bit Pirate는 ESP32-S3 보드를 I2C, SPI, UART, GPIO, 무선(Wi-Fi, BLE, Sub-GHz, LoRa) 등 다중 프로토콜을 지원하는 하드웨어 디버깅 워크벤치로 변환하는 오픈소스 펌웨어 및 생태계다. 하드웨어 · 시스템 · ESP32 Bit Pirate Hardware Hacking Kit with Web Tools That Speaks Every Protocol
Key Point 하드웨어 개발과 임베디드 디버깅 시 복잡한 장비 대신 저가 ESP32 보드 하나로 다양한 프로토콜을 브라우저에서 직접 다룰 수 있어, 개발 효율성이 크게 향상된다.
핵심 요약
ESP32 Bit Pirate는 ESP32-S3 보드를 I2C, SPI, UART, GPIO, 무선(Wi-Fi, BLE, Sub-GHz, LoRa) 등 다중 프로토콜을 지원하는 하드웨어 디버깅 워크벤치로 변환하는 오픈소스 펌웨어 및 생태계다. C++ 펌웨어, 브라우저 기반 웹 도구(Web Flasher, Web Serial 터미널), Python 자동화 스크립팅, 실습 가이드(Recipes)와 위키 문서를 포함한다. 브라우저에서 직접 펌웨어를 플래시할 수 있으며, USB 시리얼, Wi-Fi를 통한 CLI 접근, 웹 브라우저 기반 터미널 세 가지 방식으로 사용 가능하다. 전체 요약 5문장 읽기 → 049 11:10 ▲ 120 · 댓글 43 임베딩 벡터를 쌍 데이터 없이 변환하는 방법 개발 텍스트 임베딩을 한 벡터 공간에서 다른 공간으로 옮기는 비지도 학습 방법을 제시했다. AI · 머신러닝 · Harnessing the Universal Geometry of Embeddings
Key Point 서로 다른 AI 모델의 임베딩을 통역할 수 있다는 것은 모델 간 상호운용성을 높이지만, 동시에 벡터 데이터베이스의 민감 정보 노출 위험을 직시하게 한다.
핵심 요약
텍스트 임베딩을 한 벡터 공간에서 다른 공간으로 옮기는 비지도 학습 방법을 제시했다. 쌍 데이터, 인코더, 미리 정의된 매치 없이 범용 잠재 표현(Platonic Representation Hypothesis)으로 변환한다. 서로 다른 아키텍처·파라미터 크기·학습 데이터를 가진 모델 간에도 높은 코사인 유사도를 달성한다. 전체 요약 4문장 읽기 →