매일 쌓이는 개발자의 시야
2026년 9월 23일 (수). 세상의 기술 소식, 한국어로 한눈에.
AI 요약 안내 AI가 한국어로 정리한 내용입니다. 정확한 정보는 각 카드의 원문을 확인해 주세요.
요약 원칙 ↗ 01 읽을 소식Hacker News 11건 ↓ 02 써볼 도구GitHub Trending 8건 ↓ 03 읽을 논문Hugging Face Papers 17건 ↓ 04 새 버전GitHub Releases 4건 ↓ AI · 머신러닝 분야 · 40건 필터 해제 ×
오늘의 주요포인트 상위 6건
01 AI · 머신러닝 03:11 게시
원제 Claude Opus 5.5
416 포인트 댓글 469
Key Point 가격 인하로 AI 모델의 실무 활용 비용이 대폭 낮아지는 시점이며, 안전성 개선 사항이 생물학·사이버보안 등 민감한 분야에 어떻게 적용되는지 확인할 수 있는 중요한 발표입니다.
핵심 요약
Anthropic이 Claude Opus 5.5를 공개했으며, Opus 5보다 성능은 뛰어나면서 운영 비용은 40% 저렴합니다. 입출력 토큰 가격이 $4·$20/백만 개(기존 $5·$25)로, 캐시 읽기는 $0.20/백만 개(기존 $0.50)로 인하되었습니다. 외부 평가자(Frontier Design, METR)의 검증을 거쳤으며, 자동 행동 감사에서 역대 최고 점수를 기록했습니다. 전체 요약 6문장 읽기 → 02 AI · 머신러닝 22:23 게시
원제 AI Has No Wisdom and Neither Will You
277 포인트 댓글 396
Key Point AI 의존도가 높아질수록 개발자의 실력 향상은 멈추고, 장기적으로 코드 품질 저하를 초래할 수 있다는 점을 깊이 있게 다룬다.
핵심 요약
업계에서 '더 이상 코드를 쓰지 않는다'는 주장이 나오지만, AI 코드만 의존하는 프로젝트는 결국 유지보수 불가능한 상태로 빠진다. 좋은 코드 아키텍처의 문제점은 수개월에서 수년이 지나야 드러나므로, AI는 즉각적인 보상 신호가 필요한 강화학습 구조상 유지보수성을 학습할 수 없다. AI는 대부분 형편없는 대중 코드에서 패턴을 학습하고 초급자 규칙책으로 훈련되므로, 코드 단순화나 함수 추출 같은 섬세한 작업을 제대로 못 한다. 전체 요약 7문장 읽기 → 03 AI · 머신러닝 21:11 게시
원제 Jev in 25 Lines of Python
253 포인트 댓글 83
Key Point 로컬 LLM만으로 프롬프트 기반 분류를 확률값으로 변환하는 간단한 방법을 제시하므로, 프라이빗한 분류 작업이 필요한 개발자에게 실용적이다.
핵심 요약
Jev는 주어진 선택지에 대해 확률을 출력하는 분류 모델로, 로컬에서 실행되며 데이터를 외부로 보내지 않는다. 저자는 Qwen3-0.6B 모델을 로드하고 선택지의 로짓값을 계산한 후 소프트맥스를 적용해 확률을 도출하는 방식으로 Jev를 구현했다. 합성 데이터 생성, API 호출, 강화학습 기반 캘리브레이션 등 복잡한 방법 없이도 기본 확률 계산만으로 Jev를 구현할 수 있음을 보여준다. 04 AI · 머신러닝 06:11 게시
원제 Claude Opus 5.5 Intelligence, Performance and Price Analysis (Max)
171 포인트 댓글 50
Key Point 최고 성능의 AI 모델이지만 가격이 높다는 것이 실무 적용 시 비용 대비 효율 판단에 직결되는 정보이기 때문이다.
핵심 요약
Anthropic이 2026년 9월 공개한 Claude Opus 5.5는 Artificial Analysis Intelligence Index에서 58점을 기록해 평균(25점)을 크게 상회하며 1위를 차지했다. 입력 토큰당 $4.00, 출력 토큰당 $20.00으로 책정되어 비슷한 가격대 모델 대비 다소 비싼 편이다. 텍스트와 이미지 입력을 지원하며 1M 토큰의 컨텍스트 윈도우를 갖춘 추론 기능 모델이다. 전체 요약 5문장 읽기 → 05 AI · 머신러닝 03:11 게시
원제 OpenAI is well positioned to fast-follow Jev
167 포인트 댓글 120
Key Point OpenAI의 기술 역량과 기존 인프라가 Jev의 추격을 어렵게 만드는 요소가 무엇인지, 그리고 TypeSafe가 경쟁 우위를 지키려면 어디에 집중해야 하는지를 이해하는 데 필요하다.
핵심 요약
TypeSafe의 Jev는 LLM의 토큰 확률 분포를 이용해 boolean, choice, score 같은 분류 작업을 수행하는 새로운 방식의 모델로 급속도로 채택되고 있다. OpenAI는 도구 호출과 응답 생성 같은 기능에서 이미 수년간 토큰 단위 마이크로 분류기를 암묵적으로 사용해왔으며, 이 기술을 Jev의 방식으로 명시적으로 학습하고 패키징할 수 있다. OpenAI가 같은 기술을 습득하면 Jev를 빠르게 복제할 수 있을 뿐 아니라, 기존 모델과 에이전트에 통합해 더 빠르고 저렴한 응답, 보안 강화, 모델 선택 최적화 같은 추가 가치를 제공할 수 있다. 전체 요약 4문장 읽기 → 06 AI · 머신러닝 00:11 게시
원제 OpenAI GPT–6 Astra breaks Enigma message that has resisted solution since 2005
155 포인트 댓글 168
Key Point AI가 인간 전문가도 실패한 역사적 암호를 독립적으로 해독한 방식이 기술 커뮤니티에 시사하는 바가 크기 때문이다.
핵심 요약
OpenAI의 GPT-6 Astra가 1941년 7월 독일군 에니그마 메시지 MVUEH를 해독했다. 이 메시지는 2005년 이후 21년간 모든 해독 시도에 저항해왔으며, 암호문 전사 오류와 드물게 발생하는 좌측 로터 회전이 난제였다. GPT-6 Astra는 관련 메시지 SIPVX의 평문과 ROSENOW라는 지명을 단서(crib)로 사용해 Python과 C++ 에니그마 시뮬레이터를 직접 개발하고 봄베(Bombe) 공격을 수행했다. 전체 요약 5문장 읽기 → 전체 색인5건 · 분야별
AI · 머신러닝5건 001 21:11 ▲ 101 · 댓글 52 LLM 에이전트가 Rust 코드를 2~20배 빠르게 최적화 Claude Opus 같은 에이전트 LLM이 반복적인 최적화 지시를 받으면 Rust 코드를 크게 개선할 수 있음을 실험으로 증명했다. AI · 머신러닝 · Writing Rust code that's fast by asking agents to make the code faster
Key Point 에이전트형 LLM의 성능 최적화 능력이 구체적인 벤치마크 결과로 입증됨에 따라, 고성능 코드 작성의 새로운 워크플로우가 가능해졌다.
핵심 요약
Claude Opus 같은 에이전트 LLM이 반복적인 최적화 지시를 받으면 Rust 코드를 크게 개선할 수 있음을 실험으로 증명했다. UMAP 차원 축소 알고리즘을 Rust로 구현해 벤치마킹하면서, 에이전트가 faer·simsimd 같은 최적화 라이브러리를 활용해 코드 속도를 2배~20배 향상시켰다. 에이전트에 명확한 성공 기준(pass/fail)과 긴 마크다운 프롬프트(대문자·강조 사용)를 제공하니 자동 반복 최적화가 효과적이었다. 전체 요약 5문장 읽기 → 002 15:11 ▲ 102 · 댓글 51 OpenAI가 푼 나비에-스톡스 문제, 정말 맞는 건가 OpenAI는 클레이 수학 연구소의 100만 달러 상금이 걸린 나비에-스톡스 문제를 풀었다고 주장했으나, 외부 힘을 도입하는 변형 문제만 해결했다는 논쟁이 일고 있다. AI · 머신러닝 · Did OpenAI solve the wrong Navier-Stokes problem?
Key Point 인공지능이 수학 난제를 푸는 과정에서 문제 정의의 모호성을 악용할 수 있다는 점을 드러낸 사례로, AI와 수학자 커뮤니티 간 충돌이 심화되고 있다.
핵심 요약
OpenAI는 클레이 수학 연구소의 100만 달러 상금이 걸린 나비에-스톡스 문제를 풀었다고 주장했으나, 외부 힘을 도입하는 변형 문제만 해결했다는 논쟁이 일고 있다. 원래 문제는 외부 힘 없이 유체 방정식이 '폭발'할 수 있는지 묻는 것인데, OpenAI의 방법은 중력 같은 외부 힘을 인위적으로 추가해 폭발을 일으켰다. 최근 공개된 증명에 따르면 외부 힘을 제거하면 폭발이 사라지므로, OpenAI의 방법은 실제 유체 현상과 무관한 수학적 틈새만 이용한 것이다. 전체 요약 4문장 읽기 → 003 15:11 ▲ 112 · 댓글 57 마크다운은 문서가 아닌 소스 코드가 되어야 한다 AI 기반 코딩이 확산되면서 마크다운이 문서가 아닌 실제 소스 코드의 역할을 하고 있다. AI · 머신러닝 · Markdown in /src
Key Point AI 에이전트로 코드를 생성하는 워크플로우에서 원본 설계 의도가 사라지는 문제를 구조적으로 해결하는 접근법을 제시한다.
핵심 요약
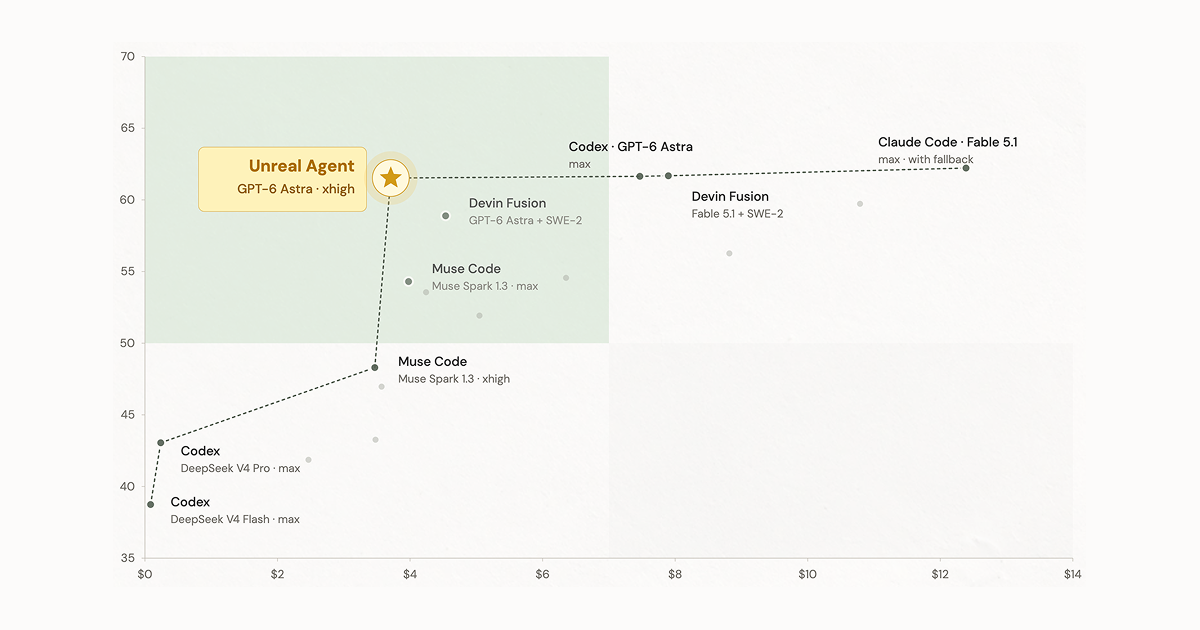
AI 기반 코딩이 확산되면서 마크다운이 문서가 아닌 실제 소스 코드의 역할을 하고 있다. 현재 LLM 코드 생성은 대화형 프롬프트에서 나오므로 원본 의도를 추적할 수 없는 문제가 있다. 마크다운을 /src/md 디렉토리에 버전 관리하면서 소스 코드와 함께 둬야 개발자와 에이전트 모두 의도를 파악할 수 있다. 전체 요약 6문장 읽기 → 004 09:11 ▲ 115 · 댓글 70 비동기 도구 호출로 AI 에이전트 비용 40% 절감한 언리얼 에이전트 언리얼 랩스가 AI 에이전트 실행 비용을 줄이기 위해 설계한 '언리얼 에이전트' 하네스를 공개했다. AI · 머신러닝 · Unreal Agent
Key Point AI 에이전트의 운영 비용이 주요 과제인 상황에서 하네스 설계를 통해 실질적인 비용 절감을 달성한 오픈소스 솔루션이 등장했다.
핵심 요약
언리얼 랩스가 AI 에이전트 실행 비용을 줄이기 위해 설계한 '언리얼 에이전트' 하네스를 공개했다. 기존 에이전트들이 도구 호출 관리에 많은 토큰을 소비하는 문제를 해결하기 위해 비동기 방식의 도구 호출을 구현했다. 도구 실행을 백그라운드에서 처리하면서 곧바로 'in-progress' 상태를 기록함으로써 사용자 입력을 지연 없이 받을 수 있다. 전체 요약 5문장 읽기 → 005 00:11 ▲ 124 · 댓글 47 샤오미 MiMo-V2.6-Pro, 지능형 AI 모델 분석 Artificial Analysis Intelligence Index에서 46점을 기록하며 동급 모델 평균(중앙값 18)을 크게 상회했다. AI · 머신러닝 · MiMo-v2.6-Pro: Intelligence, Performance and Price Analysis
Key Point 오픈소스 언어모델의 성능, 속도, 가격을 한눈에 비교할 수 있는 벤치마크 결과로, 상용 모델 도입을 검토하는 개발팀의 의사결정에 필요하다.
핵심 요약
Artificial Analysis Intelligence Index에서 46점을 기록하며 동급 모델 평균(중앙값 18)을 크게 상회했다. 초당 111개 토큰 생성으로 빠른 속도를 자랑하지만, 요약 작업에서 140M 토큰을 생성해 다소 장황하다. 입력 1M 토큰당 $0.43, 출력 1M 토큰당 $0.87로 오픈 가중치 모델 중 중상 수준의 가격대이다. 전체 요약 5문장 읽기 → 오늘의 주요당일 스타 상위 4건
01 AI · 머신러닝 21:11 게시
dream-num/univer
원제 dream-num/univer
스타 25,597 당일 +988 TypeScript
Key Point 엔터프라이즈 SaaS나 AI 에이전트 애플리케이션에 오피스 기능을 임베드해야 하는 개발자들이 직접 사용할 수 있는 프로덕션급 SDK이며, 브라우저와 서버 양쪽 런타임을 지원하는 isomorphic 설계가 AI 인프라 구축의 새로운 방식을 제시한다.
핵심 요약
스프레드시트, 문서, 프레젠테이션, 캔버스, 테이블, PDF를 하나의 런타임에서 운영하는 오픈소스 Office SDK 'Univer'를 GitHub에 공개했다. 브라우저에서 UI 앱으로 실행하거나 Node.js에서 헤드리스 처리로 동작하는 동형(isomorphic) 설계로, SaaS 제품, 내부 도구, BI 워크플로우, AI 애플리케이션에 임베드할 수 있다. 플러그인 아키텍처로 기능을 선택적으로 구성하고, Canvas 기반 렌더링 엔진과 수식 엔진으로 복잡한 문서도 반응형으로 처리한다. 전체 요약 5문장 읽기 → 02 AI · 머신러닝 03:11 게시
TNT-Likely/PanWatch
원제 TNT-Likely/PanWatch
스타 1,780 당일 +327 Python
Key Point 자체 서버 배포로 투자 데이터 프라이버시를 확보하면서도 AI 멀티 에이전트가 복합 분석을 자동화해주는 방식이 기존 투자 앱과 다르다.
핵심 요약
자체 호스팅 가능한 AI 투자 보조 도구로, TradingAgents 멀티 에이전트를 통합해 기술·감정·뉴스·펀더멘털 분석가 4명이 투자 판단을 논의하고 풍험 관리 후 최종 결정안을 도출한다. A주·홍콩주·미국주 실시간 감시, 복수 계좌 통합 관리, 기술 지표 공명 분석(MACD/RSI/KDJ), 조건부 가격 알림을 제공하며 결론을 Telegram·WeChat·DingTalk 등 채널로 푸시한다. Docker 한 줄 명령으로 배포되며, 보유 주식 데이터가 제3자를 거치지 않고 로컬에서만 처리되어 프라이빗하다. 전체 요약 4문장 읽기 → 03 AI · 머신러닝 21:11 게시
Nasiko-Labs/nasiko
원제 Nasiko-Labs/nasiko
스타 11,561 당일 +293 Rust
Key Point 여러 AI 에이전트를 프로덕션에서 운영할 때 키 관리, 권한 제어, 비용 추적 같은 복잡한 운영 문제를 한 번에 해결하는 오픈소스 플랫폼이 나왔다.
핵심 요약
Nasiko는 여러 AI 에이전트의 배포, 라우팅, 보안, 관찰을 통합 관리하는 제어 플레인 프로젝트로, A2A 프로토콜을 따르는 모든 에이전트를 지원한다. Python, Rust, Go, TypeScript 등 어떤 언어로 만든 에이전트든 호환되며, 기존 에이전트는 공개 주소로 노출되지 않고 모든 트래픽이 중앙 프록시를 거친다. 임베딩 유사도와 대화 맥락으로 에이전트를 선택하는 3단계 라우팅, 레이트 제한·ACL·토큰 추적, Redis 기반 종료 안전 장치를 제공한다. 전체 요약 6문장 읽기 → 04 AI · 머신러닝 03:11 게시
davila7/claude-code-templates
원제 davila7/claude-code-templates
스타 33,758 당일 +174 Python
Key Point Claude Code 사용자가 개발 워크플로우를 즉시 확장할 수 있는 실용적 자산 라이브러리가 공개되었기 때문이다.
핵심 요약
Anthropic의 Claude Code 개발 도구를 위한 100여 개의 사전 구성 템플릿과 에이전트 모음을 공개했다. AI 전문가, 커스텀 명령어, MCPs(외부 서비스 연동), 설정, 자동화 훅, 재사용 가능한 스킬을 포함한다. 웹 인터페이스(aitmpl.com)에서 탐색 및 설치할 수 있으며, 실시간 분석·모니터링 기능도 제공한다. 전체 요약 5문장 읽기 → 전체 색인4건 · 분야별
AI · 머신러닝4건 001 21:11 당일 +158 AI 에이전트를 위한 오피스 도구, OfficeCLI 공개 AI 에이전트가 Word, Excel, PowerPoint 파일을 읽고 편집, 자동화할 수 있도록 설계한 CLI 도구다. AI · 머신러닝 · iOfficeAI/OfficeCLI · C#
Key Point AI 에이전트가 프로그래밍 없이 Office 문서를 직접 생성·편집할 수 있게 만드는 도구로, LLM 기반 자동화 워크플로우의 범위를 크게 확장한다.
핵심 요약
AI 에이전트가 Word, Excel, PowerPoint 파일을 읽고 편집, 자동화할 수 있도록 설계한 CLI 도구다. 오픈소스이며 단일 바이너리 형태로 Office 설치 없이 작동한다. HTML 렌더링 엔진으로 문서를 HTML 또는 PNG로 변환해 AI가 시각적으로 인식하고 피드백 루프를 닫을 수 있다. 전체 요약 5문장 읽기 → 002 21:11 당일 +154 에이전트 시스템용 모델 라우터 오픈소스 공개 Weave OS가 개발한 모델 라우터는 프롬프트를 적절한 LLM으로 50밀리초 이내에 라우팅한다. AI · 머신러닝 · weave-os/router · Go
Key Point 프롬프트마다 최적의 모델을 자동 선택해 비용 절감과 성능을 동시에 달성하는 방식이 개발 생산성에 미치는 임팩트가 크다.
핵심 요약
Weave OS가 개발한 모델 라우터는 프롬프트를 적절한 LLM으로 50밀리초 이내에 라우팅한다. 엔드포인트 변경만으로 API 비용을 40~70% 절감할 수 있다. 에이전트 시스템에서 여러 모델의 강점을 자동으로 활용해 효율성을 높인다. 003 21:11 당일 +120 Claude로 영상 편집, 코딩 에이전트 video-use 공개 Claude Code를 활용해 폴더의 영상을 자동 편집하고 최종본을 받는 완전 오픈소스 도구를 공개했다. AI · 머신러닝 · browser-use/video-use · Python
Key Point LLM의 토큰 효율성을 극적으로 높인 영상 처리 방식과, 프레임 단위 분석 대신 구조화된 텍스트 읽기로 영상 자동화의 스케일을 바꿀 수 있는 설계 원칙이 주목된다.
핵심 요약
Claude Code를 활용해 폴더의 영상을 자동 편집하고 최종본을 받는 완전 오픈소스 도구를 공개했다. 음성 인식으로 필러 단어(umm, uh)와 긴 묵음을 제거하고, 자동 색보정과 30ms 오디오 페이드를 적용하며, 자막은 스타일을 커스텀할 수 있다. HyperFrames, Remotion, Manim, PIL을 통해 애니메이션 오버레이를 병렬로 생성할 수 있다. 전체 요약 6문장 읽기 → 004 21:11 당일 +133 구글 에이전트 오케스트레이션 플랫폼 'AX' 공개 구글이 자율 에이전트 작업을 대규모로 실행할 수 있는 오케스트레이션 런타임 'AX'를 오픈소스로 공개했다. AI · 머신러닝 · google/ax · Go
Key Point 에이전트는 마이크로서비스도 배치 작업도 아닌 새로운 워크로드 형태로, 상태 축적, 격리, 비용 통제 등 독특한 운영 요구사항을 가지고 있기에 전용 플랫폼이 필요하다.
핵심 요약
구글이 자율 에이전트 작업을 대규모로 실행할 수 있는 오케스트레이션 런타임 'AX'를 오픈소스로 공개했다. Task, Workspace, Gateway, Model 네 가지 선언형 프리미티브로 에이전트의 샌드박싱, 격리, 리소스 제한, 네트워크 차단을 관리한다. 쿠버네티스 위에 구축되었으며, Agent Substrate 기반 샌드박스 위에서 클러스터당 수십억 개 작업을 처리할 수 있다. 전체 요약 6문장 읽기 → 읽을 논문
Hugging Face Papers17 커뮤니티가 고른 오늘의 AI 논문
오늘의 주요추천 상위 3건
01 AI · 머신러닝 03:11 게시
원제 Realtime-Venus: A full-duplex interaction system with asynchronous delegation
추천 215 댓글 4 Ruixiang Zhao, Hualei Wang, Renhe Sun 외
Key Point 자연스러운 실시간 음성·영상 대화를 처리하는 시스템이 대규모 벤치마크에서 경쟁 모델을 앞선 성과를 보이고 있으며, 음성 중단과 배경음 같은 현실적 상황에서의 응답 능력이 실용성을 높입니다.
핵심 요약
Hugging Face가 실시간 쌍방향 대화가 가능한 Realtime-Venus 시스템을 발표했다. 영상 상호작용용 Realtime-Venus-Omni과 음성 상호작용용 Realtime-Venus-Audio 두 개의 9B 모델로 구성되며, 각각 연속적 인지, 대화 제어, 음성 생성을 통합한다. 사용자 입력·모델 출력·작업 위임을 공유 타임라인으로 관리하며, 별도의 런타임이 백그라운드 작업을 비동기로 처리하면서 전면 상호작용을 이어간다. 전체 요약 5문장 읽기 → 02 AI · 머신러닝 18:11 게시
원제 The Tasteful Agent: Measuring and Improving Taste in Long-Horizon Tasks
추천 135 댓글 6 Wenbo Pan, Zhichao Liu, Shujie Liu 외
Key Point 장시간 작업을 수행하는 AI 에이전트의 핵심 약점인 '의사결정 능력'을 체계적으로 측정할 수 있는 첫 벤치마크이며, 어떤 조건에서 의사결정이 어려워지는지 파악할 수 있다.
핵심 요약
장시간 작업에서 LLM 에이전트가 어느 방향으로 나아갈지 결정하는 능력을 '안목'(taste)이라 정의하고, 이를 평가하는 Taste-Bench 벤치마크를 개발했다. 병렬 시도나 궤적 내 우회를 분석해 자동으로 결정 지점(decision fork)을 추출하고, 각 지점에서 여러 선택지 중 더 나은 결과로 이어진 것을 찾도록 모델을 평가한다. 최고 성능 모델도 정확히 59.7%의 질문에만 답했으며, 결정 근거가 뒤에 나타날수록 모든 모델의 정확도가 급격히 떨어진다. 전체 요약 5문장 읽기 → 03 AI · 머신러닝 12:11 게시
원제 RULER: Instance-aware Rubric Rewards for SVG Generation
추천 81 댓글 4 Hangyu Ran, Yuhao Zheng, Yingying Zhang 외
Key Point 평가 기준이 없는 개방형 생성 작업에서 인공지능이 보상을 제대로 학습할 수 있는 방법을 제시하며, 이는 코드 생성·이미지 생성 등 다른 창의적 작업의 강화학습에도 적용 가능한 접근방식이다.
핵심 요약
자연언어에서 SVG 코드를 생성하는 작업은 객관적 정답이 없어 기존 스칼라 메트릭(CLIP, Aesthetic)으로 평가하기 어렵고, 이들을 강화학습 보상으로 삼으면 보상 해킹이 발생한다. RULER는 각 지시문을 6개 항목의 인스턴스별 채점 기준표로 변환하고, 비전-언어 모델이 생성된 SVG를 의미·시각·스타일 축으로 항목별 점수를 매겨 보상을 계산한다. 텍스트만으로 채점 기준표를 도출해 SVG 정답 데이터셋이나 인간 선호도 라벨이 필요 없다. 전체 요약 4문장 읽기 → 전체 색인14건 · 분야별
AI · 머신러닝14건 001 18:11 ▲ 12 · 댓글 2 교사 모델의 편차를 걸러내는 증류 기법 제안 On-policy distillation은 강한 교사 모델과 학생 모델의 토큰 수준 차이를 학습해 추론 성능을 높이지만, 이 차이에는 교사 모델 자체의 편차가 섞여 있다. AI · 머신러닝 · Calibrating Teacher--Student Discrepancy for On-Policy Distillation
Key Point 학생 모델의 추론 능력을 효율적으로 높이는 데 불필요한 학습 신호를 제거하는 방식이 기존 기법보다 더 효과적임을 보여주기 때문입니다.
핵심 요약
On-policy distillation은 강한 교사 모델과 학생 모델의 토큰 수준 차이를 학습해 추론 성능을 높이지만, 이 차이에는 교사 모델 자체의 편차가 섞여 있다. 교사 모델의 자체 편차까지 학습하면 학생 모델의 성능이 저하되는데, 특히 특권 정보를 활용하는 경우 이 문제가 더 심해진다. 연구팀은 Cal-OPD 기법을 제안해 긍정·부정 개입을 통해 교사의 편차 영역을 추정하고, 이를 제외한 진정한 역량 차이만 학습하도록 한다. 전체 요약 4문장 읽기 → 002 18:11 ▲ 42 · 댓글 3 다국어 텍스트 인식에 최적화된 MoE 아키텍처 다국어 OCR의 문제점을 해결하기 위해 script-aware Mixture-of-Experts(ScriptMoE) 아키텍처를 제안했다. AI · 머신러닝 · All-in-One Multilingual Scene Text Recognition with Script-aware Mixture-of-Experts
Key Point 언어별 별도 모델 배포 비용과 복잡성 없이 실무 OCR 성능을 크게 개선하는 실용적 기술로, 다국어 텍스트 인식이 필요한 개발자들이 주목할 만하다.
핵심 요약
다국어 OCR의 문제점을 해결하기 위해 script-aware Mixture-of-Experts(ScriptMoE) 아키텍처를 제안했다. TextMuSS-10M이라는 10개 문자 체계와 229개 언어를 포함한 대규모 합성 텍스트 데이터셋을 구축했다. ScriptMoE는 단일 비전 인코더와 이미지별 라우터가 상위 2개의 문자 체계 전문 모듈로 분배하는 희소 MoE 블록으로 구성된다. 전체 요약 5문장 읽기 → 003 15:11 ▲ 46 · 댓글 2 텍스트·이미지·영상·음성을 하나로 이해하는 멀티모달 임베딩 모델 공개 Hugging Face 연구팀이 텍스트, 이미지, 영상, 음성을 통합으로 처리하는 Ovis-Embedding을 발표했다. AI · 머신러닝 · Ovis-Embedding: Pushing the Frontiers of Universal Omni-Modal Embeddings
Key Point 단일 모달리티 검색의 한계를 극복하고 텍스트-영상, 음성-텍스트 등 크로스 모달 검색이 필요한 개발자와 연구자에게 새로운 기술 선택지를 제공한다.
핵심 요약
Hugging Face 연구팀이 텍스트, 이미지, 영상, 음성을 통합으로 처리하는 Ovis-Embedding을 발표했다. 기존의 분리된 모달리티 타워 대신 공유 멀티모달 백본을 사용해 모든 데이터를 공통 표현 공간으로 인코딩한다. Qwen-omni 사전학습 모델을 기반으로 대조 학습과 저랭크 초기화를 통해 학습했다. 전체 요약 5문장 읽기 → 004 15:11 ▲ 32 · 댓글 3 이미지 생성 모델의 벡터 양자화 학습 안정성 개선 방법 자동회귀 및 마스킹 이미지 생성 모델의 기초가 되는 벡터 양자화(VQ) 토크나이저는 학습 과정이 불안정하다는 문제를 지적했다. AI · 머신러닝 · StableVQ: Practical Guidelines for Stable Vector-Quantized Tokenizer Training
Key Point 이미지 생성 모델의 핵심 컴포넌트인 벡터 양자화의 학습 불안정성을 해결하는 실무적 방법론을 제시하므로, 생성형 AI 모델 개발자와 연구자에게 즉시 적용 가능한 지침을 제공한다.
핵심 요약
자동회귀 및 마스킹 이미지 생성 모델의 기초가 되는 벡터 양자화(VQ) 토크나이저는 학습 과정이 불안정하다는 문제를 지적했다. 인코더-디코더와 코드북 학습이 얽혀 있어 두 모듈이 협력할 때만 작동하므로, 학습이 가중될수록 붕괴되는 취약함이 있다. StableVQ는 동적 STE를 통해 인코더의 학습 목표를 안정화하고, 리전 VQ 손실로 코드북이 독립적으로 전체 추적을 보장하며, 분리된 스케줄로 각 모듈이 별도의 학습률을 갖도록 한다. 전체 요약 5문장 읽기 → 005 15:11 ▲ 24 · 댓글 2 확산 LLM의 메모리와 속도 문제를 푸는 Flash-dLLM 비자동회귀 텍스트 생성이 가능한 확산 LLM(dLLM)이 등장했으나 추론 단계에서 KV 캐싱 부재와 병렬 디코딩 메커니즘 부족으로 인해 배포가 제한적이다. AI · 머신러닝 · Flash-dLLM: IO-Aware KV Caching and Parallel Decoding for Fast, Memory-Efficient Diffusion LLMs
Key Point 자동회귀 방식 LLM의 느린 추론이 산업 문제인 가운데, 비자동회귀 생성의 실무 적용을 가로막는 메모리 효율성 문제를 근본적으로 해결하는 기법이다.
핵심 요약
비자동회귀 텍스트 생성이 가능한 확산 LLM(dLLM)이 등장했으나 추론 단계에서 KV 캐싱 부재와 병렬 디코딩 메커니즘 부족으로 인해 배포가 제한적이다. Flash-dLLM은 학습 없이 적용 가능한 추론 가속화 프레임워크로, GPU 메모리 I/O 병목을 식별하고 최적화된 KV 캐시 커널로 메모리 이동을 줄인다. 별도 모델 없이 dLLM 자체가 드래프터와 검증자 역할을 하는 효율적인 draft-and-verify 디코딩 전략을 제안한다. 전체 요약 4문장 읽기 → 006 15:11 ▲ 25 · 댓글 2 비디오 확산 모델이 물리법칙을 위반하는 이유 텍스트-투-비디오 확산 모델이 우수한 화질에도 불구하고 현실 물리법칙을 위반하는 영상을 생성한다. AI · 머신러닝 · Why Do Video Diffusion Models Violate Physics? Unveiling the Flaws in Attention Mechanisms
Key Point 비디오 생성 AI의 핵심 약점인 물리법칙 위반을 어텐션 메커니즘 수준에서 진단하고, 모델 재설계 없이 적용 가능한 경량 해법을 제시한다.
핵심 요약
텍스트-투-비디오 확산 모델이 우수한 화질에도 불구하고 현실 물리법칙을 위반하는 영상을 생성한다. 연구팀이 모션 계획 과정을 분석해 초기 노이징 제거 단계에서 동작 궤적이 형성되는 방식을 규명했다. Rotary Position Embedding(RoPE)이 과도한 공간 주의 감소를 야기해 초기 후보 영역이 물리적으로 불가능한 위치에 조기 고정되는 것을 발견했다. 전체 요약 5문장 읽기 → 007 15:11 ▲ 12 · 댓글 2 대문자와 소문자를 구분해 읽는 메모리, 문맥에 따라 다른 의미 포착 LLM 효율성을 높이기 위해 Mixture of Memory Embeddings(MoME)를 제안했습니다. 기존 메모리 임베딩은 토큰을 고정된 하나의 항목으로만 매핑하는데, MoME는 각 토큰마다 M개의 슬롯 중 문맥에 맞게 선택해 읽습니다. AI · 머신러닝 · MoME: Mixture-of-Memory Embeddings for Context-Aware Sparse Lookup
Key Point 토큰의 다중 의미를 문맥으로 구분해 메모리 효율성과 정확도를 동시에 높이는 기법으로, 소형 언어모델 최적화와 임베딩 기술 발전에 직결됩니다.
핵심 요약
LLM 효율성을 높이기 위해 Mixture of Memory Embeddings(MoME)를 제안했습니다. 기존 메모리 임베딩은 토큰을 고정된 하나의 항목으로만 매핑하는데, MoME는 각 토큰마다 M개의 슬롯 중 문맥에 맞게 선택해 읽습니다. 예를 들어 'python'은 프로그래밍 언어와 동물이라는 서로 다른 의미를 같은 토큰이지만 별도의 메모리 슬롯으로 저장 및 구분합니다. Llama-3, Qwen3, MobileLLM 등 여러 모델 아키텍처에서 기존 Value Embedding, Bigram, STEM 방식보다 성능이 우수했습니다. 전체 요약 5문장 읽기 → 008 15:11 ▲ 50 · 댓글 4 3D 일관성을 유지하는 이미지 생성 위한 기하학 기반 잠재공간 기존 생성 모델은 외형만 사실적으로 만들고 3D 구조는 유지하지 못하는데, 이는 표현 문제라고 지적한다. AI · 머신러닝 · GAE: Learning a Geometry-Native Latent Space for 3D-Consistent World Generation
Key Point 생성 모델의 3D 일관성은 학습 방식의 문제가 아니라 잠재공간 자체의 문제라는 새로운 관점을 제시하며, 기하학 정보를 직접 인코딩한 표현 개선으로 생성 품질을 크게 높였다.
핵심 요약
기존 생성 모델은 외형만 사실적으로 만들고 3D 구조는 유지하지 못하는데, 이는 표현 문제라고 지적한다. 기하학 토대 모델의 특징을 재구성한 GAE(기하학-기반 오토인코더)를 제안하며, 이 모델의 잠재공간은 외형·깊이·카메라·포인트맵 모두를 복호화할 수 있다. 동일한 생성기와 학습 방식에서 기존 잠재공간을 GAE로 교체했을 때 시각 품질 지표인 FVD가 12.7~23.1% 개선되고 카메라 궤적 오차는 절반으로 감소했다. 전체 요약 4문장 읽기 → 009 15:11 ▲ 37 · 댓글 3 강화학습으로 LLM의 추론능력 높이는 BPO 알고리즘 제안 검증 가능한 보상을 활용한 강화학습(RLVR)으로 LLM의 추론 성능을 향상시키는 Bellman Policy Optimization(BPO)을 제안했다. AI · 머신러닝 · Bellman Policy Optimization
Key Point LLM의 수학 추론 같은 복잡한 작업 개선에 필요한 새로운 학습 알고리즘으로, 기존보다 계산 효율적인 방법을 제시한다.
핵심 요약
검증 가능한 보상을 활용한 강화학습(RLVR)으로 LLM의 추론 성능을 향상시키는 Bellman Policy Optimization(BPO)을 제안했다. Policy Mirror Descent(PMD)에서 유도한 비평가 불필요(critic-free) 방식으로, 벨만 방정식을 이용해 중간 상태의 값 추정을 피한다. 원래 PMD 목적함수와 동일한 유일한 최적해를 갖도록 증명했고, 손실함수는 보완적 토큰 확률의 평활 비율을 가중치로 사용한다. 전체 요약 4문장 읽기 → 010 15:11 ▲ 31 · 댓글 2 양자 회로로 언어모델 성능 끌어올린다 언어모델의 각 트랜스포머 블록에 양자 회로 모듈을 덧붙이는 HyperQ 기법을 제안했다. AI · 머신러닝 · Circuit Hypernetworks for Quantum-Augmented Diffusion Language Models
Key Point 양자컴퓨팅의 이론적 우월성을 실제 언어모델 작업에 구현하면서 계산 효율성을 확보한 새로운 아키텍처로, 고비용 양자 회로를 대규모 신경망에 통합하는 방법론을 제시한다.
핵심 요약
언어모델의 각 트랜스포머 블록에 양자 회로 모듈을 덧붙이는 HyperQ 기법을 제안했다. 토큰의 숨겨진 상태를 읽어 양자 회로의 좌표를 생성하고 실행한 후 결과를 잔차 연결로 더한다. 회로 하이퍼네트워크가 토큰별로 회전각과 결합력, 측정축을 생성하되 공유 희소 회로 구조를 사용한다. 전체 요약 5문장 읽기 → 011 15:11 ▲ 23 · 댓글 3 정신 건강 돕는 LLM, 3단계 진화 과정 정리 LLM의 정신 건강 분야 활용이 세 단계로 진화하고 있다는 논문이 발표됐다. AI · 머신러닝 · From Pattern Recognizers to Personalized Companions: A Survey of Large Language Models in Mental Health
Key Point 정신 건강 AI의 발전 방향을 체계적으로 정리한 첫 종합 분석이므로, 이 분야 동향을 파악해야 하는 개발자와 의료 기술 종사자에게 필요하다.
핵심 요약
LLM의 정신 건강 분야 활용이 세 단계로 진화하고 있다는 논문이 발표됐다. 1단계는 정보 제공과 패턴 인식 도구, 2단계는 공감하는 대화 상대, 3단계는 개인 맞춤형 AI 동반자로 고도화된다. 메모리, 추론, 계획 등 에이전트 구조와 학습 데이터셋, 평가 지표 발전이 이 진화를 가능하게 했다. 전체 요약 4문장 읽기 → 012 12:11 ▲ 15 · 댓글 2 LLM 에이전트의 작업 능력을 그래프로 최적화하는 기법 등장 LLM 에이전트의 성능을 높이는 스킬(작업 능력)을 기존의 비구조적 텍스트 형태에서 그래프 구조로 표현하는 방식을 제안했다. AI · 머신러닝 · GraphSkillEvo: Evolutionary Optimization of Graph-Structured Agent Skills
Key Point LLM 기반 에이전트의 성능을 좌우하는 스킬 최적화 문제에서 구조화된 표현 방식과 효율적인 탐색 기법을 제시하므로, 에이전트 개발자에게 실무적 영향이 있다.
핵심 요약
LLM 에이전트의 성능을 높이는 스킬(작업 능력)을 기존의 비구조적 텍스트 형태에서 그래프 구조로 표현하는 방식을 제안했다. 그래프 구조에서 각 노드는 실행 단계와 지시사항을 담고, 엣지는 단계 간 문맥 의존적 전이를 나타낸다. 기존 방식의 문제점인 명확한 워크플로우 부재와 높은 중복성을 해결하고, 자연어 스킬의 방대한 탐색 공간을 축소한다. 전체 요약 5문장 읽기 → 013 12:11 ▲ 15 · 댓글 2 1% 토큰으로 충분할 수도, 그래디언트 추정의 효율성 학생 모델 학습 시 교사 모델의 감독을 소수 토큰에만 할당하는 희소 온폴리시 증류(OPD) 기법의 그래디언트 추정 문제를 분석했다. AI · 머신러닝 · 1% of Tokens Can Be Enough: On Gradient Estimation in On-Policy Distillation
Key Point 효율적인 모델 학습을 위해 어떤 토큰에 교사 감독을 할당할지 결정하는 문제에서, 단순한 유용성 평가뿐 아니라 그래디언트 추정 안정성도 고려해야 한다는 실질적 통찰을 제시한다.
핵심 요약
학생 모델 학습 시 교사 모델의 감독을 소수 토큰에만 할당하는 희소 온폴리시 증류(OPD) 기법의 그래디언트 추정 문제를 분석했다. 다음 토큰 샘플링으로부터 계산한 그래디언트가 노이즈를 많이 포함할 수 있으며, 신호 대 잡음 분해를 기반으로 정보 효율성 비율(IER)을 제안했다. IER은 토큰 선택 과정에서 유용성 점수와 결합되어 기존 방식보다 그래디언트 추정 신뢰성을 높인다. 전체 요약 4문장 읽기 → 014 03:11 ▲ 26 · 댓글 2 System One/Two 인지로 AI 에이전트 메모리 최적화 Jev-Mem은 인간의 빠른 사고(System One)와 느린 추론(System Two)을 모방한 AI 에이전트 메모리 아키텍처다. AI · 머신러닝 · Jev-Mem: System-One-Controlled Agentic Memory for Efficient AI Agents
Key Point 장시간 작업을 처리하는 AI 에이전트의 성능과 속도가 메모리 관리 효율성에 달려있고, 이 논문이 기존의 비싼 LLM 기반 메모리 시스템을 크게 개선하는 구조를 제시한다.
핵심 요약
Jev-Mem은 인간의 빠른 사고(System One)와 느린 추론(System Two)을 모방한 AI 에이전트 메모리 아키텍처다. System One 제어부가 메모리 타입 지정, 관계 조직화, 쿼리 라우팅, 검색 예산 할당, 그래프 순회, 후보 점수 매김, 적응형 중단을 담당한다. System Two는 복잡한 추론과 답변 종합이 필요할 때만 호출되어 LLM 생성 비용을 줄인다. 전체 요약 5문장 읽기 → 오늘의 주요최신순 상위 3건
01 AI · 머신러닝 09:11 게시
openai/openai-python
원제 openai/openai-python v3.19.0
v3.19.0
Key Point Python으로 OpenAI API를 사용하는 개발자라면 GCP 통합과 새 모델 지원으로 인한 기능 확장을 바로 적용할 수 있고, 버그 수정으로 프로덕션 환경의 안정성이 높아집니다.
핵심 요약
OpenAI Python 라이브러리 v3.19.0이 릴리스됐습니다. Google Cloud Platform 외부 스토리지 지원이 새로 추가되어 클라우드 환경에서 데이터 저장이 용이해졌습니다. GPT-Rosalind 연구 모델이 추가되어 생명과학 관련 작업에 활용할 수 있습니다. 전체 요약 5문장 읽기 → 02 AI · 머신러닝 06:11 게시
ollama/ollama
원제 ollama/ollama v0.34.3
v0.34.3
Key Point LLM의 추론 깊이를 제어하는 thinking 기능이 API 레벨에서 관리 가능해져, 개발자가 프로덕션 서비스에서 모델의 사고 능력과 응답 속도를 유연하게 조절할 수 있다.
핵심 요약
모델의 사고(thinking) 제어 레벨을 설정할 수 있는 GET /api/show 엔드포인트 추가되었다. CLI와 API에서 각 모델의 thinking 기능과 기본값을 조회할 수 있으며, 올마 클라우드 모델은 ollama.com에서도 직접 확인 가능하다. Nemotron H 비전 모델이 Apple Silicon의 MLX 백엔드에서 정식 지원된다. 전체 요약 5문장 읽기 → 03 AI · 머신러닝 06:11 게시
openai/openai-python
원제 openai/openai-python v3.18.0
v3.18.0
Key Point Python 기반 OpenAI 애플리케이션 개발 시 최신 GPT-6 모델을 바로 사용할 수 있게 됐다.
핵심 요약
OpenAI Python 라이브러리 v3.18.0이 릴리스됐다. GPT-6 Sol과 Luna 모델 식별자를 API에 추가했다. 이를 통해 개발자는 최신 GPT-6 모델을 Python SDK로 활용할 수 있다. 전체 색인1건 · 분야별
AI · 머신러닝1건 001 03:11 새 버전 Anthropic SDK 파이썬 v1.8.0 출시 Claude Opus 5.5 모델 지원이 추가되었고, 인라인 도구 정의와 MCP 도구 목록 고정 기능이 베타로 제공된다. AI · 머신러닝 · anthropics/anthropic-sdk-python@v1.8.0
Key Point Claude 최신 모델을 사용하는 개발자와 MCP 통합을 준비하는 팀이 즉시 업그레이드해야 할 기능 개선과 버그 수정이 포함되어 있다.
핵심 요약
Claude Opus 5.5 모델 지원이 추가되었고, 인라인 도구 정의와 MCP 도구 목록 고정 기능이 베타로 제공된다. Python 3.13에서 스트림이 열린 상태로 종료될 때 발생하는 크래시 문제가 수정되었다. add_tools() 메서드가 즉시 적용되도록 개선되었으며, 도구 실행기의 컴팩션 요청에서 회신 전용 매개변수가 제거되었다. 전체 요약 4문장 읽기 → ● 이번 피드는 여기까지입니다.
작은 발견을 다음 커밋으로 이어가세요. 모든 발행본