매일 쌓이는 개발자의 시야
2026년 9월 22일 (화). 세상의 기술 소식, 한국어로 한눈에.
AI 요약 안내 AI가 한국어로 정리한 내용입니다. 정확한 정보는 각 카드의 원문을 확인해 주세요.
요약 원칙 ↗ 01 읽을 소식Hacker News 8건 ↓ 02 써볼 도구GitHub Trending 4건 ↓ 03 읽을 논문Hugging Face Papers 24건 ↓ 04 새 버전GitHub Releases 1건 ↓ AI · 머신러닝 분야 · 37건 필터 해제 ×
오늘의 주요포인트 상위 6건
01 AI · 머신러닝 21:11 게시
원제 I said no and Apple said yes
300 포인트 댓글 222
Key Point Apple이 사용자의 명시적 거절을 무시하고 개인정보 수집 기능을 강제하는 방식은 AI 기술 도입 과정에서 동의 없는 데이터 활용이 얼마나 광범위한지 보여준다.
핵심 요약
macOS 15.3에서 비활성화했던 Apple Intelligence 기능이 macOS 27 업그레이드 후 삭제된 설정 창 없이 자동 재활성화됐다. 사용자가 명시적으로 거절했음에도 불구하고 개인정보를 15분마다 전송하는 기능이 다시 켜진 것으로, 기존에는 비활성화 옵션이 있었지만 새 버전에서는 옵션 자체가 제거됐다. Apple Intelligence 데이터가 22.28GB의 디스크 공간을 차지하고 있으며, 사용자의 명확한 거절도 무시된 상태다. 전체 요약 4문장 읽기 → 02 AI · 머신러닝 03:10 게시
원제 Grok 4.7
245 포인트 댓글 201
Key Point 엔지니어와 분석가가 실제로 사용할 수 있는 단계의 장시간 코딩 작업 능력과 사이버보안 분야의 이중용도 균형을 처음으로 구현한 모델로, 기존 모델들의 가치 사이클을 바꿀 수 있는 기술적 전환점을 보여준다.
핵심 요약
SpaceX AI가 개발한 Grok 4.7은 장시간의 복잡한 코딩 작업에 최적화된 모델로, 더 큰 기본 모델과 강화 학습으로 훈련되었다. 자체 검증 능력과 긴 문맥 처리 능력을 강화했으며, CursorBench 4.0의 장기 코딩 작업 벤치마크에서 가성비 면에서 최상위 수준이다. 법무·의료·금융 분야의 전문가 업무를 수행하는 GDPval 및 AA Briefcase 벤치마크에서 다른 최고 수준의 모델과 비슷하거나 우월한 성능을 보인다. 전체 요약 6문장 읽기 → 03 AI · 머신러닝 09:10 게시
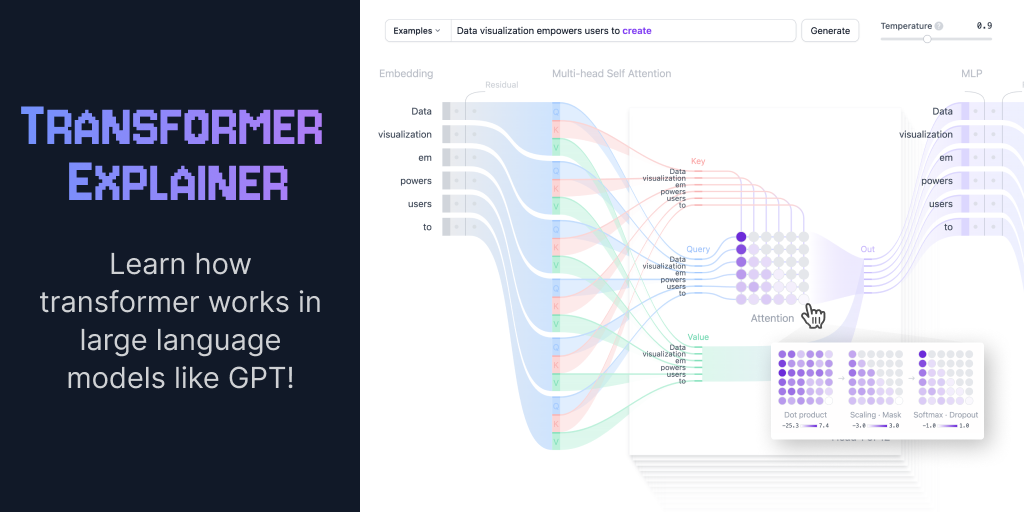
원제 Transformers Explained Visually
158 포인트 댓글 27
Key Point Transformer의 내부 동작을 상세히 이해해야 생성형 AI 모델의 원리와 한계를 제대로 파악할 수 있고, 이는 AI 제품 개발이나 프롬프트 엔지니어링의 효율을 높이는 데 필수적이다.
핵심 요약
Transformer는 2017년 '어텐션이 전부(Attention is All You Need)' 논문 이후 GPT, Llama, Gemini 등 생성형 AI의 핵심 구조가 되었으며, 텍스트뿐 아니라 음성·이미지·단백질 구조 예측까지 다양한 분야에 적용되고 있다. Transformer 모델은 '다음 토큰 예측' 원리로 작동하며, 자기주의(self-attention) 메커니즘을 통해 입력 전체 시퀀스를 처리해 긴 거리의 의존성을 기존 구조보다 효과적으로 포착한다. 임베딩 단계에서 입력 텍스트는 토큰화·토큰 벡터화·위치 정보 추가를 거쳐 수치로 변환되는데, GPT-2(소형)는 50,257개 어휘를 768차원 벡터로 표현한다. 전체 요약 6문장 읽기 → 04 AI · 머신러닝 03:10 게시
원제 Good people refuse to do bad things
120 포인트 댓글 119
Key Point 회사 내부에서 문제를 인식했을 때 개인의 책임과 선택이 무엇인지를 보여주는 사례로, 기술 업계 종사자들이 직면한 현실적 딜레마를 다룬다.
핵심 요약
Anthropic 연구원 Jacob Coxon이 주식 행사 2개월 전에 퇴직하며 AI 기업들이 안전을 무시하고 경쟁에만 집중한다고 주장했다. Anthropic 정렬팀 리더 Evan Hubinger도 "AI가 향후 10년 내 모든 인류를 죽일 수 있다고 진심으로 믿으며, 정렬 문제 해결 계획이 없다"고 확인했다. 이는 페이스북 내부 보고서를 공개한 Frances Haugen의 2021년 고발과 같은 패턴이며, 회사가 문제를 알면서도 내부 개선이 실패한 경우다. 전체 요약 5문장 읽기 → 05 AI · 머신러닝 15:10 게시
원제 The Advisory Group on Mathematics and Artificial Intelligence
117 포인트 댓글 56
Key Point OpenAI가 대규모 수학 연구 성과를 발표하려는 시점에 이를 조율하기 위해 권위 있는 수학자들이 자문단을 꾸린 것으로, 수학 학계가 AI 기업의 연구 결과 공개에 직접 개입하기 시작했음을 의미한다.
핵심 요약
프린스턴 고등연구소(IAS)에 '수학·AI 자문단(AGMAI)'이 창설되었으며, 수학 연구에 미치는 AI의 영향을 관리하는 것을 목표로 한다. 자문단은 9명의 세계적 수학자로 구성되었으며, AI 기업과의 상호작용, 수학 성과의 책임감 있는 공개 등을 조언한다. OpenAI가 자문단 구성원에게 외부 자문위원회 설립을 제의했고, 이를 계기로 독립적인 자문단이 만들어졌다. 전체 요약 6문장 읽기 → 06 AI · 머신러닝 12:10 게시
원제 Frontier AI on Your Own Hardware
112 포인트 댓글 57
Key Point 대형 모델을 개인 하드웨어에서 돌릴 수 있게 되면서 연구의 주도권이 GPU 자산이 많은 곳에서 혁신적 도구를 만드는 곳으로 이동하고 있기 때문이다.
핵심 요약
연구의 기본 단위가 논문에서 상호작용하는 오픈소스 생태계로 변했다. 에이전트로 인해 1년 걸리던 연구가 주 단위에 끝나면서 개별 논문 중심 연구는 더 이상 가치 있는 연구가 아니 된 것이다. 대학 연구팀이 24GB GPU 한 장에서 1250억 파라미터 모델을, MacBook에서 5500억 파라미터 모델을 실행할 수 있게 하는 프레임워크를 공개했다. 전체 요약 6문장 읽기 → 전체 색인2건 · 분야별
AI · 머신러닝2건 001 18:11 ▲ 109 · 댓글 37 gzip으로 텍스트를 생성할 수 있다 정보 이론에서 압축은 예측과 동치이므로, 신경망 없이 OS의 gzip 압축기만으로 언어 모델처럼 동작할 수 있다. AI · 머신러닝 · Can gzip be a language model?
Key Point 기존의 대규모 학습된 신경망 없이 순수 표준 라이브러리만으로 언어 모델이 동작하는 방식을 보여주며, 압축과 예측의 수학적 동치성을 실제로 구현한 흥미로운 증명이다.
핵심 요약
정보 이론에서 압축은 예측과 동치이므로, 신경망 없이 OS의 gzip 압축기만으로 언어 모델처럼 동작할 수 있다. gzip은 최근 텍스트의 32KiB 슬라이딩 윈도우에서 매칭을 찾아 압축하는데, 이를 확률 점수로 변환할 수 있다. 코퍼스를 gzip의 윈도우에 포함시켜 프라임한 후, 후보 텍스트를 덧붙여 압축했을 때의 길이를 측정해 점수를 매긴다. 전체 요약 6문장 읽기 → 002 00:10 ▲ 109 · 댓글 153 AI 코딩으로 코드 품질 떨어진다면, 품질 관리 체계가 문제다 AI 코딩 에이전트를 현명하게 관리하면 코드 품질을 유지하거나 개선하면서도 산출량을 2-3배 늘릴 수 있다. AI · 머신러닝 · If AI coding is lowering your code quality, you're not managing quality right
Key Point AI 코딩 도구 도입으로 인한 품질 저하를 우려하는 개발팀이 먼저 점검해야 할 품질 관리의 구체적 체계를 6단계로 정리했다.
핵심 요약
AI 코딩 에이전트를 현명하게 관리하면 코드 품질을 유지하거나 개선하면서도 산출량을 2-3배 늘릴 수 있다. 스펙 기반 개발로 AI에게 요구사항 검토를 맡기면 엣지 케이스와 잠재적 문제를 미리 찾아 버그를 줄인다. 테스트 주도 개발을 통해 95% 이상의 커버리지를 확보하고, 수동 테스트와 E2E 테스트로 실사용자 경험을 검증해야 한다. 전체 요약 5문장 읽기 → 오늘의 주요당일 스타 상위 4건
01 AI · 머신러닝 21:10 게시
Leonxlnx/taste-skill
원제 Leonxlnx/taste-skill
스타 108,152 당일 +757 JavaScript
Key Point LLM이 생성한 UI가 디자인 측면에서 부족한 현 상황에서, AI 에이전트에게 미적 판단력을 주입할 수 있는 도구가 등장했습니다.
핵심 요약
Taste Skill은 AI 에이전트를 위한 프론트엔드 프레임워크로, 제너릭하고 밋밋한 UI 생성을 방지합니다. 설치형 스킬 세트로 제공되며 레이아웃, 타이포그래피, 모션, 스페이싱 같은 디자인 요소를 강화합니다. ChatGPT 이미지나 유사 생성 도구로 레퍼런스 보드를 만든 뒤 Codex, Cursor, Claude Code에 프레임을 넘겨 구현할 수 있습니다. 전체 요약 5문장 읽기 → 02 AI · 머신러닝 21:10 게시
agent-substrate/substrate
원제 agent-substrate/substrate
스타 5,208 당일 +113 Go
Key Point 쿠버네티스 기반 에이전트 인프라를 구축하거나 운영 중인 개발자와 DevOps 팀이 대규모 AI 워크로드의 효율성과 비용을 크게 개선할 수 있는 핵심 기술이다.
핵심 요약
Google이 개발한 Agent Substrate는 AI 에이전트 실행을 위한 오픈소스 런타임으로, 표준 컨테이너 대비 10배 높은 밀도로 수백만 개 샌드박스를 실행할 수 있다. 마이크로VM과 gVisor를 지원하며 500ms 이하의 재개 시간으로 초당 500회 이상의 일시중지/재개 작업을 처리한다. 대규모 stateful 에이전트를 소수의 물리 Pod에 다중화하는 '액터 이동' 기능으로 30배 이상의 과다 구독을 달성한다. 전체 요약 5문장 읽기 → 03 AI · 머신러닝 09:10 게시
bendlang/bend
원제 bendlang/bend
스타 24,131 당일 +107 TypeScript
Key Point AI 코드 생성 시대에 규칙 위반을 수학적으로 원천 차단하는 새로운 접근이 등장했으며, 개발자들이 AI 에이전트에게 의존할 때 버그를 자동으로 거르는 메커니즘이 필요해진다.
핵심 요약
Bend는 AI가 작성한 코드의 정확성을 수학적 증명으로 검증하는 프로그래밍 언어다. LAWS.bend 파일에서 앱이 지켜야 할 규칙을 선언하면, 컴파일러가 코드가 항상 이 법칙을 위반하지 않음을 자동으로 보장한다. CPU에서는 C만큼 빠르고 GPU에서는 CUDA 수준의 성능을 목표로 하며, 강타입과 순수성으로 인해 스레드나 락 없이도 병렬 처리가 가능하다. 전체 요약 6문장 읽기 → 04 AI · 머신러닝 00:10 게시
BuilderIO/agent-native
원제 BuilderIO/agent-native
스타 7,390 당일 +107 TypeScript
Key Point 에이전트 애플리케이션 구축이 빠르게 주목받는 상황에서 에이전트와 사용자 인터페이스를 통합하는 프레임워크는 실무 배포를 고려한 실질적인 솔루션을 제공한다.
핵심 요약
Builder.io가 공개한 Agent-Native는 TypeScript 기반의 오픈소스 프레임워크로, 자율 작업 에이전트와 목적 지향형 UI를 함께 구축할 수 있다. 에이전트와 UI가 공유 액션으로 동일한 기능을 호출하므로 같은 검증, 권한, 구현을 사용하며 코드 중복을 줄인다. 에이전트가 수행한 작업이 UI에 바로 반영되고, UI에서 한 작업도 에이전트가 접근할 수 있어 양방향 동기화된다. 전체 요약 5문장 읽기 → 읽을 논문
Hugging Face Papers24 커뮤니티가 고른 오늘의 AI 논문
오늘의 주요추천 상위 3건
01 AI · 머신러닝 16:18 게시
원제 RRSI: Regularized Recursive Self-Improvement of Agent Harnesses
추천 196 댓글 2 Peng Xia, Rujun Han, Zifeng Wang 외
Key Point LLM 에이전트 자동 최적화가 실무 문제인 과적합을 해결하면서 일반화 성능을 확보한 방법론으로, 에이전트 개발의 효율성과 신뢰성을 동시에 높인다.
핵심 요약
LLM 에이전트의 성능을 좌우하는 프롬프트·제어 흐름·도구·메모리 등 구성 요소를 자동으로 개선하는 재귀적 자체 개선(RSI) 방식이 학습 데이터에 과적합되는 문제를 확인했다. 구글 연구팀이 제안한 RRSI는 제약 조건을 도입해 과적합을 줄인다: 제안 모듈에서 편집 횟수를 시간에 따라 제한하고 미탐색 경로를 선호하며, 선택 모듈에서 벤치마크 특화 제안과 불필요한 변경을 거른다. 코딩·에이전트 작업·설계 과제 8개 벤치마크에서 학습 데이터에는 최대 14.1점, 미학습 데이터에는 최대 4.7점 성능 향상을 달성했다. 전체 요약 4문장 읽기 → 02 AI · 머신러닝 16:18 게시
원제 OmniEdu: Open Foundation Models for Learning and Teaching
추천 165 댓글 3 Hao Liang, Qihan Lin, Meiyi Qiang 외
Key Point 교육 분야 특화 오픈 파운데이션 모델이 문제풀이·교수·진단을 아우르며 실용적 성능을 달성해 K-12 학습 자동화 기반을 제시한다.
핵심 요약
100개 이상의 교육자료와 일반 명령어를 통합한 학습·교수용 오픈 파운데이션 모델 OmniEdu를 발표했다. 과목 역량, 교육과정 기반 이해, 진단 추론, 교육적 지원의 4가지 능력을 중심으로 69,999개의 학습 예제를 구성했다. 4B, 9B, 27B 규모 모델을 파인튜닝했으며, K12-Bench에서 63.12% EM·76.69% F1, MathFish 85.89%, EDUMATH 86.95%의 성능을 기록했다. 전체 요약 4문장 읽기 → 03 AI · 머신러닝 16:18 게시
원제 WorldCrafter: Consistent Video World Model with Implicit 3D-aware Memory
추천 146 댓글 4 Wangbo Yu, Kunhao Liu, Wenbo Hu 외
Key Point 비디오 생성 AI의 가장 큰 약점인 시간적 일관성 문제를 3D 메모리 구조로 근본적으로 해결하는 접근법으로, 향후 인터랙티브 비디오 생성 시스템의 품질을 크게 개선할 수 있는 기술이다.
핵심 요약
비디오 세계 모델이 장시간 여러 시점에서 일관된 장면을 생성하기 어려운 문제를 해결하는 WorldCrafter 모델을 제시했다. 요청한 시점에 따라 과거 관찰 데이터를 3D 인식 메모리로 압축해 비디오 생성 모델의 토큰 제약을 효율적으로 활용한다. 메모리 인코더와 포즈 조건 읽기 모듈이 역사 정보를 시점별 토큰으로 통합하되, 명시적 깊이 대응 없이 학습된다. 전체 요약 4문장 읽기 → 전체 색인21건 · 분야별
AI · 머신러닝21건 001 21:11 ▲ 24 · 댓글 3 로봇 조작 실패 복구하는 AI 정책 프레임워크 공개 로봇 팔 조작 중 계획이 틀어지면 성능이 급격히 떨어지는 Vision-Language-Action(VLA) 정책의 문제를 해결하는 CARE 프레임워크를 개발했다. AI · 머신러닝 · CARE: Experience-Guided Atomic Corrective Execution for Vision-Language-Action Policies
Key Point 로봇 조작 작업의 안정성을 현저히 높이는 새로운 기법으로, 산업용 로봇이나 자동화 시스템의 신뢰도 문제를 실질적으로 개선할 수 있다.
핵심 요약
로봇 팔 조작 중 계획이 틀어지면 성능이 급격히 떨어지는 Vision-Language-Action(VLA) 정책의 문제를 해결하는 CARE 프레임워크를 개발했다. 실제 실패 사례를 수집해 그 패턴을 학습하고, 이를 바탕으로 대표적 실패 상황과 복구 방법을 합성해 훈련시킨다. 추론 시 3D 모니터링으로 실패를 감지하면 작업 진행도를 유지하면서 단계별로 미세 조정하거나 다시 시도한다. 전체 요약 5문장 읽기 → 002 18:11 ▲ 63 · 댓글 4 기업 문서 RAG를 위한 효율적 청킹 기법 D-RAC 공개 Hugging Face가 기업용 RAG 시스템을 위한 Document Retrieval-Aware Chunking(D-RAC) 기법을 발표했다. AI · 머신러닝 · Document Retrieval-Aware Chunking (D-RAC): Universal Retrieval-Aware Ingestion of Enterprise Documents via PDF Normalization and Multimodal Markdown Conversion
Key Point enterprise RAG 도입 시 문서 처리 비용과 속도가 실무상 가장 큰 병목이며, 이 기법이 정규화 단계에서 극적인 효율 개선을 달성했기 때문이다.
핵심 요약
Hugging Face가 기업용 RAG 시스템을 위한 Document Retrieval-Aware Chunking(D-RAC) 기법을 발표했다. 모든 문서 포맷을 PDF로 정규화한 뒤 멀티모달 LLM으로 단 한 번의 처리만으로 검색 최적화된 마크다운으로 변환한다. 표는 자체 포함 문장으로 재작성되고 제목 계층 구조가 보존되며, 청킹은 ID 기반 파싱과 경량 LLM 처리만 거친다. 전체 요약 6문장 읽기 → 003 18:11 ▲ 32 · 댓글 3 AI 에이전트 성능 향상 노하우를 모델에 담는 기법 제안 에이전트 성능을 높이는 최적화된 '하네스'(외부 시스템)를 모델 가중치에 증류하는 Harness-Zero 기법을 발표했다. AI · 머신러닝 · Harness-Zero: Harness Distillation via Agent-as-Harness
Key Point 특화된 외부 시스템 없이도 에이전트 성능을 크게 높일 수 있는 새로운 학습 방식이므로, 복잡한 작업을 자동화하려는 개발자에게 즉시 활용 가능한 기법이다.
핵심 요약
에이전트 성능을 높이는 최적화된 '하네스'(외부 시스템)를 모델 가중치에 증류하는 Harness-Zero 기법을 발표했다. 문제는 최적 하네스와 배포 환경의 하네스가 액션 스페이스와 정보 구조가 다르다는 점인데, 에이전트가 최적 하네스의 지도 하에 학생 응답을 교정해 훈련 데이터로 전환한다. 기존 코드 기반 접근법보다 에이전트 기반 하네스가 우수했으며, 배포 시 특화 하네스를 제거해도 기본 모델의 성공률이 23.3%에서 44.3%로 상승했다. 전체 요약 4문장 읽기 → 004 18:11 ▲ 21 · 댓글 2 심리학 기반 역할극 AI, 인간다운 상호작용 구현 기존 LLM 페르소나는 단순한 설명에 의존해 장기 상호작용에서 캐릭터 일관성을 잃는 문제를 겪고 있다. AI · 머신러닝 · Deep Persona: A Psychologically Grounded Architecture and Evaluation Framework for Role-Playing Agents and Simulations
Key Point 역할극 AI의 인간성을 심리학으로 설계하고 평가하는 새로운 방법론을 제시하며, LLM의 구체적 한계를 규명해 향후 대화형 AI 개선 방향을 제시한다.
핵심 요약
기존 LLM 페르소나는 단순한 설명에 의존해 장기 상호작용에서 캐릭터 일관성을 잃는 문제를 겪고 있다. 심리학 원리 기반 3계층 구조인 '딥 페르소나'를 제안했으며, 겉으로 드러나는 표현·내재적 신념·핵심 동기의 위계로 조직된다. 내부 스크립트로 모델 동작을 제약하는 스크립트 결정론과 한정된 자율성 원칙을 적용했다. 전체 요약 6문장 읽기 → 005 16:18 ▲ 46 · 댓글 4 소프트웨어 엔지니어링 AI, 작업 유형별 균형잡힌 학습으로 성능 향상 저장소 수준의 소프트웨어 개발 작업은 카테고리마다 다양해서, 강화학습 중 일부 카테고리는 개선되고 다른 카테고리는 악화되는 불균형 문제가 있다. AI · 머신러닝 · One to More, More to One: Category-Aware Iterative Expert Training for Software Engineering Agents
Key Point 소프트웨어 개발 작업의 다양한 유형별 난제를 동시에 해결하는 새로운 멀티에이전트 학습 방식이 기존보다 눈에 띄게 성능을 개선했습니다.
핵심 요약
저장소 수준의 소프트웨어 개발 작업은 카테고리마다 다양해서, 강화학습 중 일부 카테고리는 개선되고 다른 카테고리는 악화되는 불균형 문제가 있다. 연구팀은 카테고리별 전문 에이전트를 학습하고 이를 하나의 모델로 통합하는 프레임워크를 개발했다. 각 카테고리 전문가는 강화학습과 자기 검증 궤적 재활용, 작업 재선택을 반복하는 RRE(Refresh-Repair-Expand) 방식을 사용한다. 전체 요약 5문장 읽기 → 006 16:18 ▲ 29 · 댓글 1 디지털 환경 통합 제어하는 AI 에이전트 MintAct 공개 Hugging Face가 모바일·데스크톱·웹 환경을 통합으로 제어하는 비전-언어 모델 MintAct를 발표했다. AI · 머신러닝 · MintAct: A Unified Visual Agent for Digital Environments
Key Point 다양한 디지털 환경을 하나의 모델로 제어할 수 있는 AI 에이전트 기술이 실무 수준의 성능에 도달했기에 자동화 애플리케이션 개발에 영향을 미칠 수 있다.
핵심 요약
Hugging Face가 모바일·데스크톱·웹 환경을 통합으로 제어하는 비전-언어 모델 MintAct를 발표했다. 2B부터 8B 규모로 학습된 MintAct는 UI 인식, 다단계 네비게이션, 시각 도구 사용을 한 모델에서 수행한다. 수백 개의 동시 환경 인스턴스와 비동기 강화학습 프레임워크로 도메인 간 학습을 효율화했다. 전체 요약 4문장 읽기 → 007 16:18 ▲ 84 · 댓글 3 로봇 기초모델, 3D 공간 이해로 조작 정확도 높이다 기존 로봇 기초모델은 언어-비전-행동 모델(VLA)이나 세계-행동 모델(WAM)을 기반하지만 3D 공간 정보를 직접 학습하지 않아 로봇 시연 데이터에만 의존했다. AI · 머신러닝 · Grounded Action Model: 3D Grounding as a Foundation for Robotics
Key Point 로봇 조작 작업에서 객체 위치와 기하학 정보를 명시적으로 모델링함으로써 일반화 능력을 크게 개선한 새로운 아키텍처 패러다임으로, 실제 로봇 배포의 신뢰성을 높이는 핵심 진전입니다.
핵심 요약
기존 로봇 기초모델은 언어-비전-행동 모델(VLA)이나 세계-행동 모델(WAM)을 기반하지만 3D 공간 정보를 직접 학습하지 않아 로봇 시연 데이터에만 의존했다. Grounded Action Models(GAM)은 3D 공간 정보를 명시적으로 포함한 새로운 로봇 기초모델로, 언어·포인트·박스 프롬프트 등으로 입력받은 후 공유 객체 표현으로 변환해 행동을 예측한다. 이 표현은 목표 대상의 시각 특징과 기하학적 정보를 담으며 로봇 상태 이력과 함께 멀티스트림 트랜스포머로 처리된다. 전체 요약 6문장 읽기 → 008 16:18 ▲ 27 · 댓글 3 인간 영상을 로봇 학습 데이터로 변환하는 'HuRo' 파이프라인 인간 비디오를 로봇 시점으로 변환하는 'HuRo' 파이프라인을 개발했으며, 5개 인간 영상 출처에서 63만 개 에피소드와 1억 4,200만 프레임을 처리했다. AI · 머신러닝 · HuRo: Robotizing Human Videos for Scalable VLA Pretraining
Key Point 저비용 인간 영상 데이터로 로봇 비전-언어 에이전트를 학습시킬 수 있는 스케일러블한 솔루션을 제시하며, 구체적 성능 개선 수치가 실용성을 입증한다.
핵심 요약
인간 비디오를 로봇 시점으로 변환하는 'HuRo' 파이프라인을 개발했으며, 5개 인간 영상 출처에서 63만 개 에피소드와 1억 4,200만 프레임을 처리했다. 4가지 실제 조작 작업에서 로봇화된 사전학습 데이터량을 늘리자 작업 완료율이 51.5%에서 80.3%로 증가했고, 공간·시각 변화에 대한 외삽 완료율도 34.9%에서 72.2%로 향상됐다. 시각적 로봇화는 분포 밖 상황에 대한 강건성을 높였으며, 행동 재타겟팅을 포함한 엔드투엔드 사전학습이 시각 정보만 활용한 전이 학습을 앞도했다. 009 16:18 ▲ 24 · 댓글 2 LLM으로 BI 작업 자동화…BI-Agent 개발과 벤치마크 공개 Power BI·Tableau 같은 비즈니스 인텔리전스 도구의 테이블 식별·데이터 변환·조인 관계 구축 같은 반복적 준비 작업을 LLM이 자동으로 처리하도록 하는 연구를 발표했다. AI · 머신러닝 · BI-Agent and BI-Bench: Towards Automating End-to-End Business Intelligence
Key Point 엔터프라이즈 의사결정에 필수적인 BI 작업의 자동화가 기술적으로 가능한 수준에 도달했으며, LLM과 도구 활용·도메인 특화 학습의 조합이 복잡한 실무 문제 해결에 얼마나 효과적인지 보여주는 사례입니다.
핵심 요약
Power BI·Tableau 같은 비즈니스 인텔리전스 도구의 테이블 식별·데이터 변환·조인 관계 구축 같은 반복적 준비 작업을 LLM이 자동으로 처리하도록 하는 연구를 발표했다. 실제 BI 프로젝트에서 추출한 질문과 정답 쌍으로 구성된 'BI-Bench' 벤치마크를 공개했으며, 최신 LLM들도 50% 미만의 정확도만 달성했다. 검색·조인·변환 같은 소작업으로 BI 워크플로우를 분해하고 전문화된 데이터 관리 방법을 오케스트레이션하는 'BI-Agent'를 설계했다. 전체 요약 4문장 읽기 → 010 16:18 ▲ 54 · 댓글 4 토큰 단위 수정으로 LLM 학습 데이터 만드는 onPanda onPanda는 대형언어모델의 정렬 데이터와 에이전트 궤적을 효율적으로 주석하는 대화형 도구다. AI · 머신러닝 · onPanda: Efficient Annotation of On-Policy Alignment Data for LLMs and Agents via Token-Level Correction
Key Point LLM 기반 시스템의 학습 데이터 효율이 개선되면서 모델 정렬에 소요되는 비용이 대폭 줄어들 가능성이 생겼습니다.
핵심 요약
onPanda는 대형언어모델의 정렬 데이터와 에이전트 궤적을 효율적으로 주석하는 대화형 도구다. 모델 응답을 읽으면서 부적절한 첫 토큰을 찾아 후보 토큰에서 대체하거나 자유로운 편집으로 수정한 후, 수정된 지점부터 계속 생성하는 방식으로 작동한다. 수동 후편집 대비 주석 작업 시간을 중앙값 기준 52% 단축하고, 최종 응답의 대부분이 모델 자체에서 생성되어 온-정책 학습 데이터로 적합하다. 전체 요약 5문장 읽기 → 011 16:18 ▲ 63 · 댓글 3 동영상 생성 AI, 에이전트 학습으로 정확도 19% 향상 비디오 생성 모델이 복잡한 프롬프트를 만족하지 못하는 문제를 해결하기 위해 VideoGen-Agent를 제시했다. AI · 머신러닝 · VideoGen-Agent: Reinforcing Video Generation Agents
Key Point 비디오 생성 AI가 에이전트 기반 강화학습으로 복잡한 요구사항을 만족하는 방식이 크게 개선되었으며, 추후 생성 도구 발전 시 자동으로 성능 향상을 얻을 수 있다는 점이 중요하다.
핵심 요약
비디오 생성 모델이 복잡한 프롬프트를 만족하지 못하는 문제를 해결하기 위해 VideoGen-Agent를 제시했다. 이 에이전트는 증강·생성·검증 도구를 멀티턴 상호작용으로 조율하며, 프롬프트와 중간 관찰 결과를 바탕으로 의사결정한다. 지도 학습과 강화학습을 거쳐 도구 사용 능력을 개선했고, 카테고리별 균형잡힌 보상으로 평가했다. 전체 요약 6문장 읽기 → 012 16:18 ▲ 32 · 댓글 2 영상 생성 모델 평가용 대규모 벤치마크 'OmniVBench' 공개 참조 영상 기반 비디오 생성(R2V)의 평가와 학습을 위한 'OmniVBench' 벤치마크와 34만 개 샘플의 Omni-R2V 데이터셋을 공개했다. AI · 머신러닝 · OmniVBench: A Benchmark and Large-Scale Dataset for Omni Reference-to-Video Generation
Key Point 참조 기반 영상 생성의 평가 기준과 학습 자료가 부족한 상황에서, 34만 개 규모의 산업 수준 데이터셋과 체계적 벤치마크를 제공해 R2V 모델 개발의 표준을 제시한다.
핵심 요약
참조 영상 기반 비디오 생성(R2V)의 평가와 학습을 위한 'OmniVBench' 벤치마크와 34만 개 샘플의 Omni-R2V 데이터셋을 공개했다. 콘텐츠, 모션, 스타일, 구조, 내러티브 등 7개 태스크 패밀리와 18개 세부 과제를 포함하며, 기존 벤치마크보다 다양한 참조 유형과 조합을 다룬다. 12,172개의 체크리스트 항목으로 구성된 '요소 기반 평가'를 도입해 참조 요소의 보존, 분리, 실현 여부를 세밀하게 검증한다. 전체 요약 5문장 읽기 → 013 16:18 ▲ 129 · 댓글 3 게임 AI의 능력을 평가하는 대규모 벤치마크 공개 게임 플레이 능력을 다양한 시간 범위에서 측정하는 GameHorizon Suite를 개발했다. AI · 머신러닝 · GameHorizon Suite: Multi-Horizon Data and Evaluation in Gameplay
Key Point 게임을 통해 AI의 비전, 지시 분해, 계획, 제어 능력을 체계적으로 평가하는 첫 번째 대규모 표준화 벤치마크로, 멀티모달 AI 모델 발전의 객관적 척도가 된다.
핵심 요약
게임 플레이 능력을 다양한 시간 범위에서 측정하는 GameHorizon Suite를 개발했다. 21개 게임의 5,000시간 녹화본, 100명 전문가 플레이어의 행동, 다중 수준 지시문으로 구성된 대규모 데이터세트를 구축했다. 오프라인 평가는 표준화된 문제로 재현 가능하고, 온라인 평가는 실제 게임플레이 능력을 검증한다. 전체 요약 5문장 읽기 → 014 16:18 ▲ 29 · 댓글 2 AI 디자이너가 사용자 경험에서 배우는 '절차 메모리' 시스템 Claude 같은 고정된 언어모델이 230개 이상의 그래픽 디자인 도구를 다루면서, 자연어로 된 설계 절차를 자동으로 축적·개선하는 '절차 메모리' 프레임워크를 제시했다. AI · 머신러닝 · Designer-RSI: Evolving Procedural Memory from User Traffic for Agentic Graphic Design
Key Point LLM 기반 에이전트가 노이즈 많은 실제 사용자 데이터로 자동 학습하면서 성능이 극적으로 개선되는 메커니즘이 새로운 접근이며, 그래픽 디자인 같은 모호한 작업에서 AI 능력의 한계를 확장하는 방식을 보여준다.
핵심 요약
Claude 같은 고정된 언어모델이 230개 이상의 그래픽 디자인 도구를 다루면서, 자연어로 된 설계 절차를 자동으로 축적·개선하는 '절차 메모리' 프레임워크를 제시했다. 1,406건의 실제 사용자 요청과 1,869개의 자동 평가 궤적으로 5라운드 학습한 결과, 기초 스킬 76개에서 139개로 늘어났고 생성 품질이 72.7%에서 99.3%로 향상됐다. 메모리 확장(새 절차 습득)과 개선(기존 절차 수정)의 두 메커니즘을 함께 쓸 때 별도 적용보다 효과가 커서, 비숙련 에이전트 대비 58.5% 승률을 기록했다. 전체 요약 4문장 읽기 → 015 16:18 ▲ 47 · 댓글 4 AI 이미지 생성·편집에 16진수 색상값으로 정확한 색상 제어 가능하게 Paint-Anything은 생성과 편집 모두에서 24비트 16진수 값으로 객체의 정확한 색상을 지정할 수 있는 통합 인터페이스를 개발했다. AI · 머신러닝 · Paint-Anything: Unified Any-Color Control for Image Generation and Editing
Key Point 이미지 생성·편집에서 실무 디자이너 수준의 색상 제어가 가능해짐으로써 AI 콘텐츠 제작의 정밀도가 대폭 높아진다.
핵심 요약
Paint-Anything은 생성과 편집 모두에서 24비트 16진수 값으로 객체의 정확한 색상을 지정할 수 있는 통합 인터페이스를 개발했다. 실제 이미지의 객체 그라운딩과 지각적 색상 레이블링을 통해 Paint-500K 데이터셋을 구축하고, 그림자로 인한 오류를 보정하기 위해 순수 색상 앵커(정확히 일치하는 픽셀)를 고노이즈 단계에서만 학습에 사용했다. Any Color Benchmark(ACBench)를 새로 만들어 text-to-image와 편집 작업 모두에서 객체별 색상 충실도를 측정한다. 전체 요약 4문장 읽기 → 016 16:18 ▲ 47 · 댓글 4 AI 음성·영상 대화 학습 데이터 자동 생성 기술 오디오와 영상을 직접 입력받아 텍스트로 답하는 '오므니비챗' 태스크를 정의하고, 별도 음성 인식이나 캡션 없이 사용자의 질문을 이해한다. AI · 머신러닝 · OmniVChat: Synthesizing, Benchmarking, and Training for Native Audio-Visual Dialogue
Key Point 음성-영상 기반 AI 모델의 학습 데이터가 부족한 가운데, 합성 데이터로 모델을 학습하고 평가하는 새로운 방식이 실제 성능 개선으로 검증되었기 때문입니다.
핵심 요약
오디오와 영상을 직접 입력받아 텍스트로 답하는 '오므니비챗' 태스크를 정의하고, 별도 음성 인식이나 캡션 없이 사용자의 질문을 이해한다. 에이전트와 비디오 생성 기술을 활용해 합성된 대화 데이터를 만드는 '오므니비챗-스튜디오' 엔진을 개발했다. 합성 데이터로 오므니비챗 모델의 기본 대화 능력을 5개 카테고리로 평가하는 벤치마크를 구축했다. 전체 요약 5문장 읽기 → 017 16:18 ▲ 112 · 댓글 3 깃허브 코드에서 AI 에이전트용 스킬 자동 추출 Code2Skill이라는 파이프라인으로 19,769개 깃허브 저장소의 코드를 자동 분석해 100만 개 이상의 검증된 스킬 데이터베이스를 구축했다. AI · 머신러닝 · Grounded Skill Synthesis from Code at Scale for Agentic Intelligence
Key Point 에이전트 AI에 필요한 재사용 가능한 스킬을 스케일로 자동 확보할 수 있는 새로운 경로를 제시하며, 기존 방법의 한계를 보완하는 동시에 성능 개선을 입증했다.
핵심 요약
Code2Skill이라는 파이프라인으로 19,769개 깃허브 저장소의 코드를 자동 분석해 100만 개 이상의 검증된 스킬 데이터베이스를 구축했다. 추출한 스킬에는 원자적 작업, 복합 워크플로우, 반복 패턴이 포함되며 소스 코드 재구성과 비교로 검증된다. 이 방식은 환경 상호작용이 필요 없으면서도 실행 가능한 증거를 제공한다는 점에서 기존 궤적 기반 방식과 다르다. 전체 요약 5문장 읽기 → 018 16:18 ▲ 75 · 댓글 3 화면 조작과 코딩을 함께 하는 AI 에이전트 벤치마크 공개 RecreationWorld는 GUI 조작과 소프트웨어 개발을 모두 수행하는 하이브리드 AI 에이전트 학습 및 평가용 프레임워크다. AI · 머신러닝 · RecreationWorld: Scalable and Verifiable Environments for Hybrid Computer-Use Agents
Key Point 코딩과 UI 조작을 함께 해야 하는 현실의 개발 업무를 AI가 수행할 때 남은 간극을 구체적으로 측정하고, 이 능력을 학습시킬 수 있는 새로운 방법론을 제시한다.
핵심 요약
RecreationWorld는 GUI 조작과 소프트웨어 개발을 모두 수행하는 하이브리드 AI 에이전트 학습 및 평가용 프레임워크다. Ubuntu, macOS, Windows, Android, 웹 5개 플랫폼에서 실행되는 애플리케이션을 보고 똑같이 구현하도록 학습시키는 방식으로, 참고용 앱을 오라클로 삼아 실행 기반의 보상을 제공한다. 공개 애플리케이션으로 생성한 궤적 데이터로 학습한 모델은 코딩과 하이브리드 컴퓨터 작업 벤치마크 5개에서 성능이 개선되었고 출력 검증 빈도도 높아졌다. 전체 요약 5문장 읽기 → 019 16:18 ▲ 127 · 댓글 3 소스코드만으로 강화학습 환경 자동 구축하는 CodeMidas CodeMidas는 오픈소스 저장소의 소스코드만을 이용해 5,545개 강화학습 환경을 자동 구축했다. AI · 머신러닝 · CodeMidas: Scaling Agentic Coding RL Environments from Code Itself
Key Point 소스코드 자체만으로 대규모 RL 환경을 자동 구축해 코딩 에이전트 훈련의 확장성 문제를 해결했으며, 실제 벤치마크에서 10~17%의 성능 향상을 달성했기 때문이다.
핵심 요약
CodeMidas는 오픈소스 저장소의 소스코드만을 이용해 5,545개 강화학습 환경을 자동 구축했다. 에이전트가 코드베이스의 기능을 탐색하여 명세를 작성하고, 실행 기반 테스트를 생성한 뒤 검증하는 3단계 파이프라인을 거친다. 23개 프로그래밍 언어와 15개 기술 도메인의 3,185개 코드베이스에서 수집되었다. 전체 요약 5문장 읽기 → 020 16:18 ▲ 97 · 댓글 3 세 가지 제약을 동시에 푼 전문가 혼합 모델 등장 Mixture-of-Experts(MoE)의 참여도, 계산량, 메모리 비용을 독립적으로 제어할 수 없는 문제를 IntBMoE가 해결했습니다. AI · 머신러닝 · IntBMoE: Integrating Block-Level Conditioning into Expert Composition for Full-Participation Mixture-of-Experts
Key Point MoE는 모델 용량을 확장하는 핵심 기술인데, IntBMoE가 참여도·계산·메모리 세 제약을 동시에 독립적으로 제어할 수 있게 되면서 대규모 추천 시스템의 실전 배포 가능성을 열었습니다.
핵심 요약
Mixture-of-Experts(MoE)의 참여도, 계산량, 메모리 비용을 독립적으로 제어할 수 없는 문제를 IntBMoE가 해결했습니다. 블록 조건화된 MoE로 모든 전문가가 토큰 생성에 기여하며(완전 참여), 라우터가 일부 블록만 실행해 계산량을 낮추고, 학습된 코드북이 메모리를 제한합니다. 하이퍼네트워크가 각 층의 전문가들을 동적으로 합성하고, Dual-Path Residual Gating이 두 경로를 곱셈 게이팅으로 연결합니다. 전체 요약 5문장 읽기 → 021 16:18 ▲ 145 · 댓글 3 이질적 데이터 다루는 AI 에이전트를 위한 자동 진화형 온톨로지 레이어 테이블, 파일, 데이터베이스 같은 이질적 데이터를 자연어로 다루는 데이터 에이전트는 원본 데이터 탐색과 수동 의미 계층 주입 사이의 간극으로 어려움을 겪고 있다. AI · 머신러닝 · EvoOntology: A Self-Evolving Ontology Layer for Data Agents
Key Point 데이터 에이전트가 복잡한 현실의 다양한 데이터 소스를 다룰 때 마주하는 근본적인 한계를 구조적으로 해결하는 방식을 제시하기 때문이다.
핵심 요약
테이블, 파일, 데이터베이스 같은 이질적 데이터를 자연어로 다루는 데이터 에이전트는 원본 데이터 탐색과 수동 의미 계층 주입 사이의 간극으로 어려움을 겪고 있다. EvoOntology는 스키마·콘텐츠·도구 계층을 MCP 서버로 구성한 자동 진화형 온톨로지 레이어로, 에이전트가 런타임에 온톨로지를 능동적으로 쿼리하고 상호작용할 수 있게 한다. 빌더 에이전트가 자율적으로 온톨로지를 구축하고, 귀속 안내 편집과 조건부 쌍 평가를 통한 자가 진화 루프가 지속적으로 온톨로지를 개선한다. 전체 요약 4문장 읽기 → 오늘의 주요최신순 상위 1건
01 AI · 머신러닝 16:18 게시
openai/openai-python
원제 openai/openai-python v3.17.0
v3.17.0
Key Point OpenAI Python 라이브러리의 엔터프라이즈 기능 확대로, 외부 저장소 관리와 보안 웹훅 등 새로운 API 지원이 필요한 개발자들이 업데이트해야 한다.
핵심 요약
외부 저장소 구성 관리와 안전 사건 검색, 보안 경고 및 비활성화 웹훅 이벤트 지원을 추가했다. SIP 미디어 보안을 수신 통화 이벤트에 포함시키고 환경 변수 저장소 자격증명을 지원한다. 세션 환경 초기화 이벤트와 모델 타입 수정, null 메시지 내용 처리 개선 등 여러 버그 수정이 포함됐다. 전체 요약 4문장 읽기 → ● 이번 피드는 여기까지입니다.
작은 발견을 다음 커밋으로 이어가세요. 모든 발행본