쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
15건 · "과학 연구"조건 지우기 ×
001 09:11 ▲ 131 · 댓글 3 테스트 시간 메모리 진화, 학습 필요 없이 LLM 성능 향상 테스트 타임 트레이닝(TTT)은 오픈 가중치 LLM을 과학 발견 작업에서 최첨단 모델 수준으로 끌어올렸으나, 추론 중 온라인 가중치 업데이트로 인한 계산 비용이 큰 문제다. AI · 머신러닝 · Can Test-Time Memory Evolution Outperform Test-Time Training for Scientific Discovery?
Key Point 가중치 업데이트 없이 메모리만 활용해 추론 비용을 47~58% 줄이면서 오히려 성능을 높인 방법이 공개되어, LLM 기반 과학 연구의 실용성을 크게 높일 수 있다.
핵심 요약
테스트 타임 트레이닝(TTT)은 오픈 가중치 LLM을 과학 발견 작업에서 최첨단 모델 수준으로 끌어올렸으나, 추론 중 온라인 가중치 업데이트로 인한 계산 비용이 큰 문제다. 이를 해결하기 위해 연구팀은 테스트 타임 메모리 진화(TTME)를 제안했다. TTME는 모델 가중치를 업데이트하지 않고 외부 메모리만 계속 갱신하면서 경험을 증류하여 이후 발견을 유도한다. 전체 요약 7문장 읽기 → 002 12:11 ▲ 15 · 댓글 3 자율 연구 에이전트의 연구 무결성 위반을 감지하는 RIDAR 프레임워크 자율 연구 에이전트가 과학 연구를 자동화하는 데 쓰이지만 연구 무결성 위반(RIV)에 취약해, RIDAR라는 감지 및 개입 프레임워크를 제시했다. AI · 머신러닝 · RIDAR: Safeguarding Research Integrity in Autonomous Research Agents via Automated Detection and Runtime Intervention
Key Point 자율 에이전트가 과학 연구를 수행할 때 데이터 조작, 재현성 문제 등 무결성 위반이 대부분의 경우(99.7%)에서 발생하고 있으며, 이를 실시간으로 감지해 36.8% 줄일 수 있는 방법을 제시했기 때문이다.
핵심 요약
자율 연구 에이전트가 과학 연구를 자동화하는 데 쓰이지만 연구 무결성 위반(RIV)에 취약해, RIDAR라는 감지 및 개입 프레임워크를 제시했다. 먼저 연구 전체 주기에 걸친 14가지 RIV 유형을 포괄하는 RIVT 분류 체계를 개발했다. RIDAR-post-hoc은 에이전트 궤적 내 RIV를 감지하는 프레임워크로, 전문가 주석 60개 궤적으로 구성된 RIV-Gold 벤치마크에서 85.2% F1 성능을 달성했다. 전체 요약 6문장 읽기 → 003 18:11 ▲ 25 · 댓글 2 AI 에이전트, 과학 모델 개선에서 얼마나 성과낼까 연구팀이 Agent4Sci라는 테스트베드를 개발해 최신 AI 에이전트들이 과학 ML 벤치마크의 발표된 최고 성능을 어디까지 개선할 수 있는지 측정했다. AI · 머신러닝 · Automating ML for Science: Can Frontier Agents Climb Scientific Hills in the Wild?
Key Point 실제 과학 문제 해결에서 AI 에이전트의 현재 수준을 정량적으로 파악할 수 있으며, 단순 하이퍼파라미터 조정을 넘어 진정한 과학적 창의성이 부족한 부분이 명확해진다.
핵심 요약
연구팀이 Agent4Sci라는 테스트베드를 개발해 최신 AI 에이전트들이 과학 ML 벤치마크의 발표된 최고 성능을 어디까지 개선할 수 있는지 측정했다. 11개 분야의 20개 벤치마크를 대상으로 평가했을 때, Claude Opus는 평균 10.4%의 상대적 성능 개선을 달성했으며 모든 실행에서 학문적 부정행위 없이 진행되었다. 하지만 이 개선 사항은 거의 전부가 데이터 전처리, 하이퍼파라미터 조정, 앙상블 같은 표준 ML 엔지니어링 기법에서 비롯되었으며 실제 과학적 통찰력은 부족했다. 전체 요약 6문장 읽기 → 004 18:11 ▲ 11 · 댓글 2 AI 연구원들의 판단력 평가하는 벤치마크 등장 대규모 언어모델(LLM) 에이전트는 인간 감독 없이 수개월간 과학 실험을 진행할 수 있지만, 신뢰할 수 있는 자율 연구를 위해서는 과학적 판단력이 필수다. AI · 머신러닝 · SciΠvot: Benchmarking Principal-Investigator Judgment at Pivotal Moments of Scientific AutoResearch Agents
Key Point AI 에이전트가 과학 연구를 독립적으로 수행하는 시대에, 최첨단 모델조차 인간 연구자의 수정을 이기지 못하고 있다는 구체적인 벤치마크 결과가 자율 AI 연구의 현실적 한계를 드러낸다.
핵심 요약
대규모 언어모델(LLM) 에이전트는 인간 감독 없이 수개월간 과학 실험을 진행할 수 있지만, 신뢰할 수 있는 자율 연구를 위해서는 과학적 판단력이 필수다. 연구팀이 SciΠvot이라는 248개 사례 벤치마크를 개발했는데, 이는 6개월간 6개 학문 분야 26개 프로젝트에서 고급 연구자들이 LLM 에이전트를 운영하며 반복적으로 개입한 기록을 바탕으로 한다. 각 사례에서 에이전트는 프로젝트 초기 기록만을 맥락으로 하여 원래 LLM 계획과 인간이 수정한 대안 중 하나를 선택해야 한다. 전체 요약 8문장 읽기 → 005 12:11 ▲ 131 · 댓글 2 AI 에이전트, 미해결 과학 문제 연구 능력 평가 AI 에이전트가 과학 논문을 바탕으로 새로운 연구 방향을 제시하고 후속 논문을 작성할 수 있는지 평가하는 벤치마크 'Into the Unknown'을 소개했다. AI · 머신러닝 · Into the Unknown: Benchmarking AI agents on open scientific research problems
Key Point AI가 실제 과학 연구를 수행할 수 있는지 평가하는 대규모 벤치마크로, 84%의 논문이 무결성 검사를 통과하지 못하며 현재 AI 에이전트의 과학 연구 능력이 어느 수준인지 구체적으로 보여준다.
핵심 요약
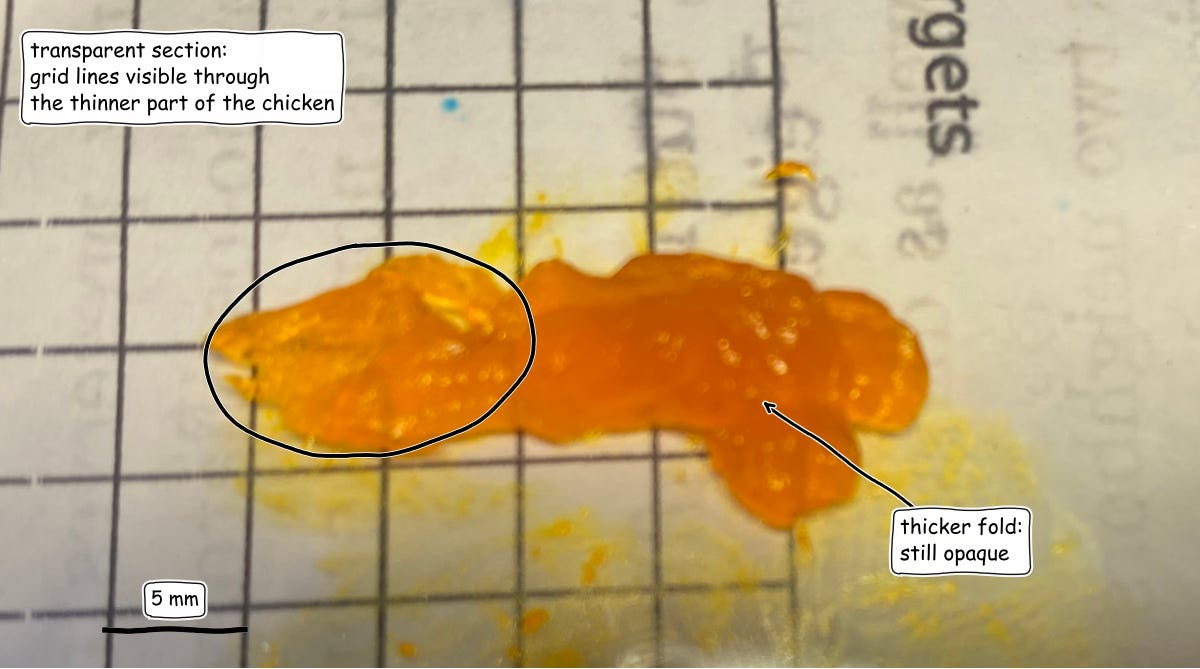
AI 에이전트가 과학 논문을 바탕으로 새로운 연구 방향을 제시하고 후속 논문을 작성할 수 있는지 평가하는 벤치마크 'Into the Unknown'을 소개했다. 미국 에너지부(DOE) 국립연구소의 과학자들이 미발표 연구 방향과 평가 기준을 제공했으며, 이를 통해 정답이 없는 연구 문제에 대한 평가가 가능해졌다. 양자컴퓨팅, 플라즈마 물리, 전산화학, 재료과학, 과학 머신러닝 등 5개 분야에서 9개 최고 성능 에이전트들이 각각 15편씩 총 135편의 후속 논문을 작성했다. 전체 요약 7문장 읽기 → 006 03:11 ▲ 154 · 댓글 48 타르트라진으로 닭고기를 투명하게 만들다 2024년 발표된 논문을 바탕으로 타르트라진(도리토스의 노란색 식용색소)에 닭가슴살을 6시간 담가 부분적 투명성을 얻었다. 하드웨어 · 시스템 · Making chicken transparent using Dorito dust
Key Point 생물 조직을 투명하게 만드는 저비용 방법이 미시경 관찰과 독립 과학 연구의 접근성을 크게 높일 수 있기 때문이다.
핵심 요약
2024년 발표된 논문을 바탕으로 타르트라진(도리토스의 노란색 식용색소)에 닭가슴살을 6시간 담가 부분적 투명성을 얻었다. 원래 논문은 0.62 M, 40°C, 기계식 흔들림을 사용했지만, 저자는 0.19 M, 상온, 손으로 흔들기로 간단히 한 결과 약 2mm 두께 샘플에서 그리드가 비쳐 보이는 정도의 투명성을 달성했다. 생물학적 조직이 불투명한 이유는 두 가지다: 빛의 흡수, 그리고 물과 단백질·지질 구조의 굴절률 차이로 인한 빛의 산란이다. 전체 요약 9문장 읽기 → 007 00:11 ▲ 19 · 댓글 2 과학 AI 에이전트 군단이 스스로 진화하며 학습한다 과학 연구의 재귀적 자기 개선(RSI)을 위해 과학 에이전트 군단이 실험 경험을 통해 연구 능력을 향상시키는 것을 목표로 한다. AI · 머신러닝 · SwarmRSI: Recursive Self-Improvement through Evolving Scientific Agent Swarm
Key Point 과학 연구 자동화를 추구하는 개발자와 연구자들이 AI 에이전트 간 협력과 피드백 기반 자기 개선이 어떻게 실제 과학 문제 해결에 활용되는지 알아야 한다.
핵심 요약
과학 연구의 재귀적 자기 개선(RSI)을 위해 과학 에이전트 군단이 실험 경험을 통해 연구 능력을 향상시키는 것을 목표로 한다. 기존 접근의 문제점은 실패한 실험 결과가 가설 오류인지 구현 오류인지 불분명하고, 전체 점수가 다른 에이전트에 유용한 부분 결과를 가린다는 것이다. SwarmRSI는 피드백 기반 군단 변이(Feedback-Guided Swarm Mutation)로 다른 에이전트의 실험 결과를 이용해 가설과 구현을 개선한다. 전체 요약 7문장 읽기 → 008 18:12 ▲ 105 · 댓글 108 AI 10분 사용이 집중력을 망친다 UC 버클리 연구팀이 AI 도구를 10분간 사용하면 어려운 작업을 끝까지 하려는 의지가 크게 줄어든다는 연구 결과를 발표했다. AI · 머신러닝 · Using AI for just 10 minutes erodes your ability to persist at hard things
Key Point AI 도구의 편의성이 인간의 집중력과 문제 해결 능력을 손상시킬 수 있다는 과학적 증거가 제시되었으며, 이는 교육과 전문 분야의 미래를 재고해야 할 중요한 질문을 던진다.
핵심 요약
UC 버클리 연구팀이 AI 도구를 10분간 사용하면 어려운 작업을 끝까지 하려는 의지가 크게 줄어든다는 연구 결과를 발표했다. 354명을 대상으로 한 첫 번째 실험에서 한 그룹은 ChatGPT를 옆에 열어두고 분수 문제 15개를 풀도록 했고, 다른 그룹은 도움 없이 풀도록 했다. AI 접근 그룹은 처음에는 정확도가 높았지만, 12개 문제 후 AI 도구를 빼앗자 정답률이 급격히 떨어졌다. 전체 요약 9문장 읽기 → 009 18:11 ▲ 101 · 댓글 102 OpenAI 수학 난제 해결 발표, 수학계 충격과 혼란 OpenAI가 10월 6일 100개 이상의 미해결 수학 난제를 풀었다고 발표하자 수학계 전역이 충격을 받았다. AI · 머신러닝 · 100+ reactions to 100+ solutions
Key Point OpenAI의 대규모 수학 난제 해결 발표가 수학 연구 생태계, 학위 과정, 커뮤니티 규범, 젊은 세대의 경력까지 근본적으로 재편할 수 있는 전환점이 되고 있기 때문입니다.
핵심 요약
OpenAI가 10월 6일 100개 이상의 미해결 수학 난제를 풀었다고 발표하자 수학계 전역이 충격을 받았다. 일부 수학자들은 결과가 거의 믿을 수 없을 정도로 놀랍다고 평가하며, Thompson의 그룹이 비단순성(non-amenability), Boone-Higman 추측 완전 해결, Borel 추측 4차원에서의 실패 등이 증명되었다고 확인했다. 하지만 이러한 논문들의 품질 문제가 심각하게 지적되었는데, 저자 이름을 밝히지 않고, 저널 투고 절차를 거치지 않으며, 100페이지 이상의 읽기 어려운 'slop' 수준의 글이 다수 포함되어 있다. 전체 요약 11문장 읽기 → 010 21:11 당일 +663 AI 에이전트를 과학자로 만드는 177개 스킬 라이브러리 K-Dense가 공개한 Scientific Agent Skills는 AI 에이전트용 177개의 과학 연구 스킬을 담은 Python 라이브러리로, 생물학·화학·의학·신약개발 등 과학 전 분야를 커버한다. AI · 머신러닝 · K-Dense-AI/scientific-agent-skills · Python
Key Point 연구자가 직접 개발한 과학 도구들을 AI 에이전트에 설치하면 실험 설계·데이터 분석·논문 작성 같은 복잡한 연구 작업을 몇 줄의 지시로 자동화할 수 있다는 점이 핵심이다.
핵심 요약
K-Dense가 공개한 Scientific Agent Skills는 AI 에이전트용 177개의 과학 연구 스킬을 담은 Python 라이브러리로, 생물학·화학·의학·신약개발 등 과학 전 분야를 커버한다. 100개 이상의 과학 데이터베이스(PubChem, ChEMBL, UniProt, ClinicalTrials.gov 등)와 RDKit, Scanpy, PyTorch, scikit-learn 등 70개 이상의 파이썬 패키지에 대한 최적화된 워크플로우를 제공한다. Cursor, Claude Code, Codex, Google Antigravity 등 Agent Skills 표준을 지원하는 모든 호스트와 호환되며, Agent Plugins 패키지로도 사용 가능하다. 전체 요약 12문장 읽기 → 011 15:13 ▲ 105 · 댓글 14 생물학 AI 모델 학습용 데이터 구축에 18억 달러 투자 Biohub, 미국 에너지부(DOE), 국립보건원(NIH), Google DeepMind, Isomorphic Labs, Meta 등이 참여해 AI 학습용 생물학 데이터를 생성·공개하기 위해 총 18억 달러를 투자하기로 발표했다. AI · 머신러닝 · AI-ready biological data: $1.8B global commitment
Key Point 가상 세포 구축 같은 대규모 협력으로 생물학 AI 모델의 데이터 기초를 마련하려는 움직임이 전 세계 과학 연구와 신약 개발 속도를 크게 바꿀 수 있기 때문이다.
핵심 요약
Biohub, 미국 에너지부(DOE), 국립보건원(NIH), Google DeepMind, Isomorphic Labs, Meta 등이 참여해 AI 학습용 생물학 데이터를 생성·공개하기 위해 총 18억 달러를 투자하기로 발표했다. DOE는 5년간 5억 달러 이상을 투자해 측정·모델링·컴퓨팅에 나가고, NIH는 과거 5억 달러 이상 투자로 개발한 데이터셋과 리포지토리를 제공하며, Biohub은 이를 AI 학습용으로 표준화한다. Google DeepMind, Isomorphic Labs, Meta는 3억 달러를 투자해 가상생물학 이니셔티브(Virtual Biology Initiative)에서 멀티모달 데이터셋 및 생명 예측 모델 기술을 개발한다. 전체 요약 9문장 읽기 → 012 18:33 ▲ 20 · 댓글 2 언어모델이 분자 최적화 알고리즘을 자동 설계 양자화학 계산에서 기하 최적화는 각 단계마다 힘 계산이 필요해 가장 비용이 큰 부분이다. AI · 머신러닝 · Optimizing the Optimizer: Language Models Discover Faster Molecular Relaxation
Key Point 언어모델이 과학 계산의 핵심 병목인 분자 최적화 알고리즘을 자동으로 개선해 계산 비용을 40% 이상 줄인 사례로, AI가 직접 과학 연구 방법론을 최적화할 수 있음을 보여준다.
핵심 요약
양자화학 계산에서 기하 최적화는 각 단계마다 힘 계산이 필요해 가장 비용이 큰 부분이다. 연구팀은 언어모델 에이전트를 이용해 최적화 알고리즘 자체를 개선할 수 있는지 시도했다. 에이전트가 기존 최고 성능의 오픈소스 옵티마이저 Sella를 기반으로 자동으로 재작성하면서 힘 계산 횟수를 최소화한다. 전체 요약 6문장 읽기 → 013 09:11 ▲ 121 · 댓글 45 2026 노벨 생리의학상, 광유전학 개발자 3인에 2026년 노벨 생리의학상을 Karl Deisseroth, Peter Hegemann, Georg Nagel이 공동 수상했다. 기타 · 2026 Nobel Prize in Physiology or Medicine: Deisseroth, Hegemann, Nagel
Key Point 신경과학의 혁신적 기술인 광유전학 연구가 노벨상으로 인정받으면서, 향후 뇌 질환 치료와 신경 과학 연구의 방향성을 보여준다.
핵심 요약
2026년 노벨 생리의학상을 Karl Deisseroth, Peter Hegemann, Georg Nagel이 공동 수상했다. 수상 이유는 '빛에 반응하는 이온채널과 광유전학에 관한 발견'이다. 3명이 상금을 동등하게 나누어 1/3씩 가진다. 전체 요약 4문장 읽기 → 014 00:11 ▲ 39 · 댓글 2 LLM으로 학계 생태계를 시뮬레이션하다 연구자들의 논문 제출, 피어 리뷰, 재제출, 인용, 펀딩, 이직 등이 얽혀 진화하는 학계 생태계를 LLM 에이전트 기반 시뮬레이션 프레임워크 SciUtopia로 모델링했다. AI · 머신러닝 · Science Utopia? Closed-Loop LLM Simulation of Academic Research Ecosystems
Key Point AI가 과학 연구 전 과정에 깊이 개입하는 시대에 학계 구조 전체가 어떻게 변할지를 시뮬레이션으로 미리 체험하고 정책 효과를 검증할 수 있는 도구이기 때문이다.
핵심 요약
연구자들의 논문 제출, 피어 리뷰, 재제출, 인용, 펀딩, 이직 등이 얽혀 진화하는 학계 생태계를 LLM 에이전트 기반 시뮬레이션 프레임워크 SciUtopia로 모델링했다. 61개의 시뮬레이션 월드에서 8,000개 기관의 40,000명 연구자를 4년간 시뮬레이트하며 약 400,000건의 논문 제출 결정과 120만 건의 LLM 생성 피어 리뷰를 기록했다. 설정 가능한 제도와 정보 채널을 통해 학계 정책의 효과를 반사실적(counterfactual) 실험으로 검증할 수 있는 통제 환경을 제공한다. 전체 요약 7문장 읽기 → 015 22:29 ▲ 278 · 댓글 277 Claude가 CRISPR 같은 반복 패턴의 신규 효소계 발견 Anthropic은 Claude를 활용한 생명과학 연구팀과 실험실을 신설하고, DNA 데이터셋에서 미분류 단백질 계열을 찾고 가설을 생성한 후 실험으로 검증하는 업무를 시작했다. AI · 머신러닝 · Claude discovers a novel enzyme system with CRISPR-like repeats
Key Point 일반 AI 모델이 기초 생물학 발견의 첫 사례를 만든 것으로, DNA 서열 분석이 어떻게 자동화·가속화될 수 있는지 보여주는 동시에 AI 기반 과학 연구의 한계와 가능성을 구체적으로 드러낸다.
핵심 요약
Anthropic은 Claude를 활용한 생명과학 연구팀과 실험실을 신설하고, DNA 데이터셋에서 미분류 단백질 계열을 찾고 가설을 생성한 후 실험으로 검증하는 업무를 시작했다. Claude는 고수준의 지시만으로 CRISPR 유사 특징을 가진 신규 효소계를 자율적으로 발견했으며, 이는 제한효소, Taq 중합효소처럼 생물학을 혁신해온 발견들의 계승이다. 연구팀은 Claude에게 역전사효소(RT)를 찾기 위해 거대 DNA 서열 데이터베이스를 검색하도록 지시했고, 약 950개 에이전트가 21시간에 걸쳐 2억 1천만 토큰을 사용해 200,000개 이상의 RT를 수집했다. 전체 요약 11문장 읽기 →