쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 22일 (일)까지 5067건
31건 · "수학 추론"조건 지우기 ×
001 21:11 ▲ 26 · 댓글 2 LLM 미세조정 시 성능 손상 방지하는 CurvDelta 등장 대형언어모형(LLM)을 특정 작업에 맞춰 적응시킬 때 기존 능력이 떨어지는 문제를 해결하기 위해 CurvDelta라는 프레임워크를 제안했다. AI · 머신러닝 · CurvDelta: Low-Curvature Delta Modeling For Surgical Learning and Unlearning
Key Point LLM을 새로운 기술에 맞게 조정하되 기존 능력을 유지해야 하는 현실적 니즈가 늘어나고 있으며, CurvDelta는 이 문제에 대한 체계적 해결책을 제시한다.
핵심 요약
대형언어모형(LLM)을 특정 작업에 맞춰 적응시킬 때 기존 능력이 떨어지는 문제를 해결하기 위해 CurvDelta라는 프레임워크를 제안했다. CurvDelta는 모델 업데이트의 매개변수 공간을 재설계해 기존 능력 보존 제약을 반영하고, 보존 손실이 거의 변하지 않는 저곡률(low-curvature) 공간을 구성한다. Kronecker-factored approximate curvature(K-FAC)와 인수분해 사영(factorized projection)을 활용해 LLM 규모에서 실용적으로 적용 가능하게 했다. 전체 요약 7문장 읽기 → 002 15:11 ▲ 14 · 댓글 2 강화학습 안정화하는 정규화 점수 중심화 기법 제안 비동기 강화학습은 훈련 처리량을 높이지만 오래된 정책의 데이터와 훈련·추론 간 수치 불일치로 학습이 불안정해진다. AI · 머신러닝 · Regularized Score Centering
Key Point 대규모 언어 모델의 에이전트 태스크 성능을 개선하는 새로운 훈련 기법으로, 비동기 학습 환경에서의 불안정성 문제를 해결하는 실질적 해법을 제시한다.
핵심 요약
비동기 강화학습은 훈련 처리량을 높이지만 오래된 정책의 데이터와 훈련·추론 간 수치 불일치로 학습이 불안정해진다. 점수 중심화(SC)는 보상 베이스라인의 영향을 제거해 정책 외 학습을 안정화하는데, 학습자가 데이터 생성 정책에서 멀어지면 실패할 수 있다. 연구진은 역 쿨백-라이블러(KL) 페널티를 추가한 정규화 점수 중심화(RSC)를 제시해 학습자의 다음 토큰 분포를 행동 정책의 분포에 가깝게 유지한다. 전체 요약 7문장 읽기 → 003 09:11 ▲ 342 · 댓글 331 구글, 프론티어급 성능의 Gemini 4 Neon 공개 구글이 Gemini 4 Neon을 공개했으며, 복잡한 소프트웨어 엔지니어링, 지식 업무, 과학 워크플로우에서 프론티어급 지능을 제공하면서 빠른 작업 완료를 목표로 한다. AI · 머신러닝 · Gemini 4 Neon
Key Point Carbon보다 빠르고 저렴하면서 프론티어급 성능을 유지하는 새로운 모델이 출시되어, 기존 성능-비용 트레이드오프를 재정의하고 있다.
핵심 요약
구글이 Gemini 4 Neon을 공개했으며, 복잡한 소프트웨어 엔지니어링, 지식 업무, 과학 워크플로우에서 프론티어급 지능을 제공하면서 빠른 작업 완료를 목표로 한다. 입력 토큰 300만 개당 $3(캐시된 입력 토큰은 95% 할인가인 150만 개당 $3), 출력 토큰 300만 개당 $15의 가격으로 100만 토큰 컨텍스트 윈도우를 제공한다. Artificial Analysis Intelligence Index에서 xhigh thinking 레벨로 61점을 기록하며 같은 급의 모델 중 1위, 전체 3위를 차지했고, Vals Index에서는 2위를 기록했다. 전체 요약 16문장 읽기 → 004 18:11 ▲ 47 · 댓글 3 교과서 구조에서 수학 증명 380만 개 추출 언어 모델의 수학 학습 데이터는 보통 문제-풀이 쌍으로 단순화되어, 원본 교과서의 조직체계와 증거 구조가 손실된다. AI · 머신러닝 · Scaling Mathematical Proof Supervision from Structured Textbooks
Key Point 언어 모델의 수학 능력을 근본적으로 개선할 수 있는 새로운 데이터 구조와 38만 개의 증명 레코드를 제시하는데, 실제 교과서 구조를 보존함으로써 기존 단순 문제-풀이 쌍 방식보다 학습 효율이 크게 높다는 점이 중요하다.
핵심 요약
언어 모델의 수학 학습 데이터는 보통 문제-풀이 쌍으로 단순화되어, 원본 교과서의 조직체계와 증거 구조가 손실된다. 연구팀은 TOME-Math라는 대규모 코퍼스를 구축해 2,118개 대학수학 교과서를 약 38만 개의 구조화된 증명 감독 레코드로 변환했다. 변환 과정에서 장(章) 순서, 명제-증명 연결, 의존성 참조, 출처 정보 등의 구조 신호를 보존했다. 전체 요약 7문장 읽기 → 005 06:11 ▲ 23 · 댓글 3 정책 증류 학습, 분포 밖 일반화 능력 잃는다 여러 교사 모델에서 능력을 통합하는 다중 교사 정책 내 증류(MOPD)가 학습 데이터 분포 내에서는 완벽에 가까운 성능을 보이지만, 분포 밖 일반화 능력은 크게 떨어진다. AI · 머신러닝 · On the Generalization Limitation of On-Policy Distillation for Post-RL Consolidation
Key Point 대규모 언어모델을 다중 교사로부터 학습시킬 때 학습 데이터 분포 내에선 우수하지만 그 외의 상황에서 성능이 급격히 떨어지는 핵심 문제를 실증적으로 규명했고, 개선 방안까지 제시했기 때문입니다.
핵심 요약
여러 교사 모델에서 능력을 통합하는 다중 교사 정책 내 증류(MOPD)가 학습 데이터 분포 내에서는 완벽에 가까운 성능을 보이지만, 분포 밖 일반화 능력은 크게 떨어진다. Qwen3 모델을 이용해 수학 추론, 코딩, 에이전트, 장문맥 이해 등 4가지 과제에서 성능을 평가한 결과, 분포 외(OOD) 성능이 기본 모델보다 2.45~16.25% 낮았다. 합성 작업에서는 MOPD가 분포 내 성능을 개선했으나, 구성된 작업의 분포 외 성능은 최고 성능 교사 모델보다 18.19~24.34% 뒤떨어졌다. 전체 요약 7문장 읽기 → 006 15:11 ▲ 13 · 댓글 2 토큰마다 다른 선생님이 필요하다…다중 선생님 자가학습법 기존 온폴리시 자가학습(OPSD)은 학습 중 선생님 모델을 고정하거나 응답 단위에서만 교사를 바꿔 사용해왔다. AI · 머신러닝 · Every Token Needs Its Own Teacher: Multi-teacher Adaptive On-policy Self-distillation
Key Point 대규모 언어 모델 학습의 자가학습 효율성을 토큰 단위로 최적화하는 새로운 방식으로, 수학 추론처럼 정밀한 감독이 필요한 작업에서 유의미한 성능 향상을 달성했다.
핵심 요약
기존 온폴리시 자가학습(OPSD)은 학습 중 선생님 모델을 고정하거나 응답 단위에서만 교사를 바꿔 사용해왔다. 연구팀은 토큰별로 선생님 선호도가 달라진다고 주장하며, 다수결 투표와 KL 기반 선택을 통해 각 토큰에 맞는 선생님을 식별할 수 있음을 보였다. 이를 바탕으로 다중 선생님 풀을 구성해 학습 중 각 토큰이 선호하는 선생님을 동적으로 선택하는 MTA-OPSD(다중 선생님 적응형 온폴리시 자가학습)를 제안했다. 전체 요약 5문장 읽기 → 007 21:11 ▲ 59 · 댓글 7 추론 단계 줄이되 정확도 유지, LoCo 방법론 공개 대규모 추론 모델은 충분한 정보를 얻은 후에도 계속 '생각하기'로 추론 비용이 많이 든다는 문제가 있다. AI · 머신러닝 · Think Less, Locally: Local Preference Learning for Reasoning Compression
Key Point 추론 단계를 획기적으로 줄이면서도 정확도를 유지하는 방법이 나왔으므로, LLM 운영 비용 절감과 추론 최적화에 실제로 적용할 수 있는 기술이다.
핵심 요약
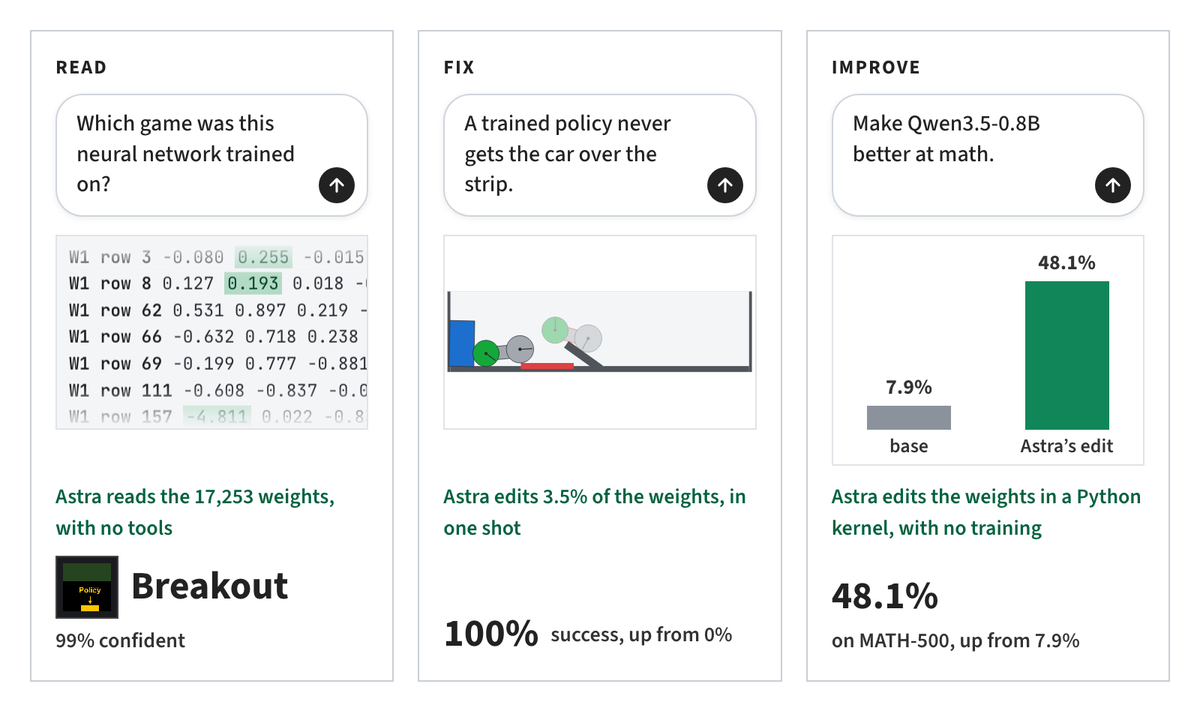
대규모 추론 모델은 충분한 정보를 얻은 후에도 계속 '생각하기'로 추론 비용이 많이 든다는 문제가 있다. 기존 압축 방법은 전체 추론 궤적에만 초점을 맞췄고, 현재 상태에서 계속 추론할지 멈출지 판단하는 지역적 의사결정을 간과했다. LoCo는 모델이 과도하게 생각하는 상태를 자신의 추론 흔적에서 감지하고, 그 지점부터 짧은 검증된 대안을 생성한 후 DPO로 학습하는 지역적 선호 학습 방법이다. 전체 요약 7문장 읽기 → 008 06:11 ▲ 1,031 · 댓글 320 GPT-6 Astra가 신경망 가중치를 읽고 수정해 모델 성능 개선 최신 LLM이 신경망 가중치를 직접 읽고 쓸 수 있는 'Weight-Space Programming' 기법을 연구한 결과를 공개했다. AI · 머신러닝 · Astra can read and write weights to improve Qwen
Key Point LLM이 신경망 최적화라는 미분 불가능한 영역에 직접 개입할 수 있다는 것을 처음 대규모로 입증하며, 향후 해석 가능성과 모델 튜닝 방식에 근본적 변화를 가져올 가능성을 시사한다.
핵심 요약
최신 LLM이 신경망 가중치를 직접 읽고 쓸 수 있는 'Weight-Space Programming' 기법을 연구한 결과를 공개했다. GPT-6 Astra는 게임 플레이 정책의 가중치만 보고 어떤 게임인지 식별했으며, 환경 피드백 없이도 PPO로 1억 스텝 학습한 네트워크보다 강한 게임 AI를 처음부터 작성했다. Qwen3.5-0.8B의 수학 추론을 개선하기 위해 Astra는 반복 루프를 유발하는 가중치 방향을 찾아 8억 개 중 0.016%(13만 1,072개)만 수정했다. 전체 요약 8문장 읽기 → 009 06:11 ▲ 116 · 댓글 10 LLM의 '잠자기' 단계로 지속학습과 기억력 문제 해결 구글 연구팀이 대형언어모델(LLM)의 지속학습을 위해 '수면 프레임워크'를 제안했다. AI · 머신러닝 · Sleep framework: A new way for LLMs to retain knowledge in continual learning
Key Point LLM이 새로운 정보를 학습하면서 기존 지식을 잃지 않고 맥락도 10배 이상 확장하는 핵심 기술이 어떻게 작동하는지 이해할 수 있고, 산업 배포된 모델의 적응력 문제를 근본적으로 해결하는 가능성을 보여준다.
핵심 요약
구글 연구팀이 대형언어모델(LLM)의 지속학습을 위해 '수면 프레임워크'를 제안했다. 기존 LLM은 배포 후 고정된 학습 시점을 유지하거나, 문맥 윈도우 내에서만 정보를 보유하는 한계가 있고, 새로운 데이터로 업데이트하면 이전 학습 내용을 잊는 '재앙적 망각(catastrophic forgetting)' 문제가 발생한다. 수면 프레임워크는 활동(깨어있는) 단계와 오프라인 메모리 통합(수면) 단계를 번갈아가며 작동한다. 전체 요약 13문장 읽기 → 010 12:11 ▲ 256 · 댓글 4 디퓨전 언어 모델의 강화학습을 위한 토큰 신용 할당 디퓨전 언어 모델(DLM)은 반복 제거(denoising)로 텍스트를 생성하며 양방향 문맥 모델링과 병렬 토큰 정제가 가능하다. AI · 머신러닝 · DTCA: Denoising Token Credit Assignment for Reinforcement Learning in Diffusion Language Models
Key Point 디퓨전 모델 기반 언어 모델에 강화학습을 효과적으로 적용하는 방식이 제시되었으며, 토큰별 신용 할당 문제를 해결함으로써 수학 추론 성능에서 실질적 개선을 보였다.
핵심 요약
디퓨전 언어 모델(DLM)은 반복 제거(denoising)로 텍스트를 생성하며 양방향 문맥 모델링과 병렬 토큰 정제가 가능하다. DLM에 강화학습을 적용하면 추론 성능이 개선되지만, 반복 제거 과정에서 토큰별 신용 할당이 어렵다는 문제가 있다. 제안된 DTCA(Denoising Token Credit Assignment) 프레임워크는 토큰 약속 후 남은 마스크 위치의 예측 신뢰도 개선으로 토큰 기여도를 추정한다. 전체 요약 6문장 읽기 → 011 15:11 ▲ 204 · 댓글 3 AI 에이전트의 협업을 동적으로 조율하는 DynaFlow 프레임워크 다중 에이전트 시스템이 고정된 협업 구조에 의존하면서 작업 요구에 적응하기 어려운 문제를 해결하기 위해 DynaFlow를 제안한다. AI · 머신러닝 · DynaFlow: Learning Free-Form Multi-Agent Orchestration
Key Point 고정된 협업 구조를 벗어나 AI 에이전트가 각 작업에 맞춰 동적으로 다른 에이전트들을 조율하는 방식이 실질적으로 작동하고, 같은 모델 기반으로도 크게 성능을 높일 수 있음을 보여준다.
핵심 요약
다중 에이전트 시스템이 고정된 협업 구조에 의존하면서 작업 요구에 적응하기 어려운 문제를 해결하기 위해 DynaFlow를 제안한다. 주 에이전트가 협업 필요 여부를 판단하고 태스크별 프로그램을 생성해 서브 에이전트들을 순차·병렬 실행, 정보 교환, 검증으로 조율한다. 실행 결과와 추적 정보가 다음 행동에 반영되어 추론 진행 과정에서 협업을 적응적으로 조정한다. 전체 요약 8문장 읽기 → 012 18:11 ▲ 17 · 댓글 2 학생 모델이 생성한 질문을 자동으로 최적화해 증류 학습 개선 온-폴리시 증류(OPD) 기법에서 적은 수의 학습 질문만으로도 효과적인 결과를 얻을 수 있다는 발견이 동기가 되어, 질문을 분포적 지식 전달의 매개체로 봄. AI · 머신러닝 · Ask to Distill: Learning to Synthesize Data for On-Policy Distillation
Key Point 학생 모델이 생성한 합성 데이터만으로도 실제 데이터와 같은 수준의 증류 학습 효과를 얻을 수 있으며, 정답이나 보상 없이도 질문 품질을 자동 최적화하는 방법을 제시해 데이터 수집 비용을 크게 줄일 수 있다.
핵심 요약
온-폴리시 증류(OPD) 기법에서 적은 수의 학습 질문만으로도 효과적인 결과를 얻을 수 있다는 발견이 동기가 되어, 질문을 분포적 지식 전달의 매개체로 봄. 새로 생성한 질문이 증류 학습에 가치 있는지 평가하되, 정답에 접근하지 않고도 더 나은 질문을 자동 생성하는 'Ask-to-Distill' 프레임워크를 제시. 학생 모델 기반의 합성 엔진을 학생과 교사의 불일치도, 교사 확률 질량, 길이·다양성 제어를 결합한 분포적 대리 지표로 최적화. 전체 요약 7문장 읽기 → 013 15:11 ▲ 668 · 댓글 4 RL 학습 과정의 중간 체크포인트로 정책 이동 검증하기 기존 정책 이동 증류(policy-shift distillation)는 강화학습으로 학습한 교사 모델의 초기-최종 로짓 차이만 학생에게 전달하는데, 이는 학습 과정 중 행동 선호도가 일관되게 변했는지 알 수 없다. AI · 머신러닝 · Waypoint-OPD: Transferring RL-Induced Policy Shifts via Gated On-Policy Distillation
Key Point 강화학습으로 개선된 모델의 지식을 효율적으로 전이할 때 단순히 최종 결과만 보는 게 아니라 학습 과정의 일관성을 검증해야 더 좋은 결과를 얻을 수 있다.
핵심 요약
기존 정책 이동 증류(policy-shift distillation)는 강화학습으로 학습한 교사 모델의 초기-최종 로짓 차이만 학생에게 전달하는데, 이는 학습 과정 중 행동 선호도가 일관되게 변했는지 알 수 없다. 같은 최종 변화라도 초기와 후기의 이동이 서로 상쇄될 수 있어 신뢰할 수 없다. Waypoint-OPD 방법은 교사 모델의 중간 체크포인트를 사용해 초기(시작→중간)와 후기(중간→최종) 정책 이동을 비교한다. 전체 요약 9문장 읽기 → 014 18:11 ▲ 35 · 댓글 2 완전 공개 멀티모달 모델 Apertus 1.5 출시 Apertus 1.5는 완전히 공개 데이터로 학습한 멀티모달 추론 모델로, 텍스트 기반 Apertus 1.0을 확장했다. AI · 머신러닝 · Apertus 1.5: From Open Text Models to Open Multimodal Reasoners
Key Point 공개 데이터로만 학습한 완전히 오픈소스 멀티모달 모델의 등장으로, 소수 기업 종속에서 벗어날 수 있는 대안이 실제 규모에서 가능함을 보여준다.
핵심 요약
Apertus 1.5는 완전히 공개 데이터로 학습한 멀티모달 추론 모델로, 텍스트 기반 Apertus 1.0을 확장했다. 8B 모델에 4T개, 70B 모델에 2T개 토큰을 추가 학습해 이미지와 음성 이해 능력을 추가했으며, 컨텍스트 윈도우를 262,144 토큰으로 4배 확대했다. 토크나이저를 통해 멀티모달 입력을 처리하되 언어 모델 헤드는 텍스트만 출력하고 아키텍처는 유지했다. 전체 요약 9문장 읽기 → 015 15:11 ▲ 76 · 댓글 2 비평으로 실패를 바로잡는 학생 모델 훈련법 온-정책 증류(OPD)는 학생 모델이 생성한 텍스트에서 교사 모델의 토큰 수준 지도로 훈련하는 방식인데, 교사가 학생의 잘못된 시작점에서도 정답에 도달할 수 있다는 '회복성' 가정이 실제로는 실패한다는 점을 발견했다. AI · 머신러닝 · Recovering Reliable Supervision via Critique-Guided On-Policy Distillation
Key Point 학생 모델이 스스로 생성한 데이터로 훈련할 때 교사의 오류 인식 능력을 활용해 신뢰성 있는 감독 신호를 복구하는 방법으로, 수학 문제 해결 같은 복잡한 추론 작업의 모델 훈련 효율을 높인다.
핵심 요약
온-정책 증류(OPD)는 학생 모델이 생성한 텍스트에서 교사 모델의 토큰 수준 지도로 훈련하는 방식인데, 교사가 학생의 잘못된 시작점에서도 정답에 도달할 수 있다는 '회복성' 가정이 실제로는 실패한다는 점을 발견했다. 교사 모델이 학생의 오류를 인식하면서도 그 오류를 따라가는 문제가 발생하며, 이는 잘못된 답변으로 훈련하게 만든다. 이를 해결하기 위해 CriticOPD를 제안했는데, 교사가 오류가 있는 롤아웃을 비평하면 학생은 그 오류를 인식하고 해답을 다시 작성한다. 전체 요약 5문장 읽기 → 016 15:11 ▲ 71 · 댓글 1 PPO의 가치 함수 추적 개선, 수학 추론 성능 7~8점 향상 언어 모델 추론용 강화학습에서 널리 쓰이는 PPO는 희소 종료 보상(sparse terminal rewards) 환경에서 표준 비평가(critic)가 값의 진화를 제대로 추적하지 못한다는 문제를 가지고 있다. AI · 머신러닝 · TPPO: Tracking-Value PPO For Language Model Reasoning
Key Point 강화학습 기반 언어 모델 추론에서 가치 함수의 정확성이 직접적으로 성능을 좌우하는데, 이 방법이 표준 PPO를 크게 능가하는 수학 추론 성능 향상을 보여준다.
핵심 요약
언어 모델 추론용 강화학습에서 널리 쓰이는 PPO는 희소 종료 보상(sparse terminal rewards) 환경에서 표준 비평가(critic)가 값의 진화를 제대로 추적하지 못한다는 문제를 가지고 있다. 논문은 연속된 접두어(prefix) 값들 사이의 관계를 분석하고, 이들이 로그-오즈 공간(log-odds space)에서 덧셈 갱신으로 이루어진 베이지안 분해를 허용함을 보였다. 이 덧셈 구조를 이용해 추적-가치 PPO(TPPO)를 제안하는데, 위치별 스칼라 출력값들을 누적해 가치 로짓(value logits)을 형성하고 재구성된 값들을 통한 종료 결과 지도학습으로 학습된다. 전체 요약 6문장 읽기 → 017 03:11 ▲ 11 · 댓글 2 LLM 매개변수 수정 없이 지식 이전하는 'UTT' 방법 제안 지식 증류(KD)는 강한 교사 모델의 지식을 약한 학생 모델로 옮기지만, 기존 방법은 학생 매개변수를 학습해야 하므로 특정 구조와 체크포인트에 종속되는 문제가 있다. AI · 머신러닝 · Universal Textual Teaching for LLMs
Key Point API 기반 또는 재학습이 비싼 LLM에도 적용 가능한 매개변수 무수정 지식 이전 방법으로, 해석 가능하고 재사용 가능한 형태의 교육 자료를 자동 생성할 수 있다는 점이 기존 증류 기법의 한계를 극복한다.
핵심 요약
지식 증류(KD)는 강한 교사 모델의 지식을 약한 학생 모델로 옮기지만, 기존 방법은 학생 매개변수를 학습해야 하므로 특정 구조와 체크포인트에 종속되는 문제가 있다. 연구팀은 매개변수 업데이트 없이 지식을 전달하는 'Universal Textual Teaching(UTT)'을 제안했으며, 교사와 학생의 차이를 자연어로 해석 가능한 'Primer'라는 재사용 가능한 형태로 증류한다. UTT는 먼저 쌍을 이룬 평가를 통해 대표적인 차이 사례들을 식별하고, 이후 다중 역할 상호작용으로 반복 업데이트한다: 학생이 과제를 시도하고, Prompter가 평가 피드백을 교수 지시문으로 변환하며, 교사가 대상화된 시연을 제공하고, Synthesizer가 검증된 교훈을 통합한다. 전체 요약 6문장 읽기 → 018 18:30 ▲ 15 · 댓글 2 실패한 추론에만 교사 신호 적용, 코드·수학 성능 향상 온-폴리시 증류(OPD)는 대형 언어모델의 학생 모델이 자신이 생성한 결과로 학습하는 방식으로 널리 쓰이지만, 토큰 수준의 국소적 최적화만 하고 전체 추론의 질을 고려하지 않습니다. AI · 머신러닝 · DiffGate: Difficulty-Gated Teacher Guidance for On-Policy Distillation
Key Point 기존 증류와 강화학습의 한계를 동시에 해결하는 방법으로, 작은 언어모델(0.6B~1.7B)의 코딩·수학 추론 성능을 실질적으로 향상시키는 기법입니다.
핵심 요약
온-폴리시 증류(OPD)는 대형 언어모델의 학생 모델이 자신이 생성한 결과로 학습하는 방식으로 널리 쓰이지만, 토큰 수준의 국소적 최적화만 하고 전체 추론의 질을 고려하지 않습니다. 보상 기반 강화학습(RLVR, 특히 GRPO)은 전체 결과 수준의 지도를 제공하지만 희소 보상으로 인해 신용 할당이 입자합니다. 연구진은 두 방식의 한계를 분석했습니다: OPD는 밀집된 국소 신호를 주지만 정답률과 약하게 연관되고, GRPO는 작업 성공을 포착하되 토큰별 신용 할당이 정교하지 못합니다. 전체 요약 9문장 읽기 → 019 18:30 ▲ 29 · 댓글 2 저정밀 강화학습의 수치 오차 해결, TRIAGE 방법 제안 NVFP4 저정밀 실행을 통해 대형언어모델의 강화학습을 가속할 수 있지만, 학습기와 샘플러 간 실행 불일치가 정책 최적화를 불안정하게 만드는 문제가 있다. AI · 머신러닝 · TRIAGE: Direction-Aware Mismatch Stabilization of Native NVFP4 Reinforcement Learning
Key Point 저정밀 연산으로 LLM 강화학습 속도를 크게 높일 수 있지만 수치 오차로 인한 불안정성이 문제인데, 이 논문이 그 원인을 정확히 분석하고 실질적인 해결책을 제시했기 때문에 LLM 최적화에 관심 있는 개발자와 연구자가 봐야 한다.
핵심 요약
NVFP4 저정밀 실행을 통해 대형언어모델의 강화학습을 가속할 수 있지만, 학습기와 샘플러 간 실행 불일치가 정책 최적화를 불안정하게 만드는 문제가 있다. 연구팀은 불일치가 정책 기울기 방향과 상호작용하는 방식을 분석해, 크기만으로는 식별할 수 없는 국소 증폭 및 감소 영역을 구분했다. NVFP4 실행에서 초기 불균형으로 인해 음수 이점·음수 간극 업데이트가 우세하고, 이러한 토큰들이 불일치가 전역적으로 확산되기 전에 응답 세그먼트의 소수 부분에 집중된다는 패턴을 발견했다. 전체 요약 7문장 읽기 → 020 18:30 ▲ 64 · 댓글 2 자가학습하는 추론 모델, 반복 학습으로 성능 붕괴 막는 방법 제시 추론 모델이 자체 생성 질문으로 학습하는 자가진화 과정에서 반복할수록 성능이 저하되는 문제가 있다. AI · 머신러닝 · Questioning the Questions: Sustaining Self-Evolution in Reasoning Models
Key Point 자가학습하는 LLM 기반 추론 모델의 성능 붕괴 문제를 해결하는 실질적 방법을 제시해, 장기간 안정적인 모델 개선이 가능해진다.
핵심 요약
추론 모델이 자체 생성 질문으로 학습하는 자가진화 과정에서 반복할수록 성능이 저하되는 문제가 있다. 논문은 성능 악화의 원인으로 두 가지를 파악했다: 무효한 질문의 증가와 수학적으로 동등한 질문의 반복. 무효한 질문은 라운드가 진행될수록 늘어나며, 답변 일관성 필터링이 이를 더욱 악화시킨다. 전체 요약 9문장 읽기 → 021 18:33 ▲ 160 · 댓글 2 다른 토크나이저 간 증류학습, 정확도는 적은 정보로도 충분하다 On-Policy Distillation(OPD)은 학생 모델이 자신의 생성 결과에 대해 교사 모델의 피드백을 받아 학습하는 방식이며, 다른 토크나이저를 쓸 때는 시퀀스와 어휘 레벨에서 정렬이 필요하다. AI · 머신러닝 · Rethinking Cross-Tokenizer On-Policy Distillation: From Alignment Coverage to Supervision Reliability
Key Point 다른 토크나이저를 사용하는 모델 간 증류에서 더 많은 정렬 범위보다 신뢰할 수 있는 감독이 핵심이라는 발견으로, 효율적인 학습 설계의 원칙을 제시한다.
핵심 요약
On-Policy Distillation(OPD)은 학생 모델이 자신의 생성 결과에 대해 교사 모델의 피드백을 받아 학습하는 방식이며, 다른 토크나이저를 쓸 때는 시퀀스와 어휘 레벨에서 정렬이 필요하다. 수학 추론과 코드 생성 과제에서 3개 교사-학생 쌍을 실험한 결과, 어휘 불일치가 크더라도 엄격한 1:1 정렬만으로도 학생이 생성한 대부분의 토큰을 커버했다. 학생이 증류 전에 샘플링한 응답에서 공유 어휘는 엄격히 정렬된 위치에서 교사와 학생의 확률 질량 거의 전부를 유지했다. 전체 요약 7문장 읽기 → 022 09:11 ▲ 11 · 댓글 2 SFT에서 토큰 가중치를 다시 설계하다: SCALE 방법론 감독된 미세 조정(SFT)은 모델이 가능성 낮다고 판단한 토큰에서 가장 적극적으로 학습하는데, 이는 새로운 동작을 습득하는 동시에 노이즈나 충돌하는 지도를 증폭하고 기존 사전학습 지식을 덮어쓸 수 있다. AI · 머신러닝 · Rethinking Token Reweighting for SFT: Suppress, Reverse, and Extrapolate Learned Features
Key Point 기존 미세 조정 방식의 근본적인 한계를 분석하고 새로운 기준틀을 제시하는 방법론으로, 수학·코드 성능에서 기존 방식을 초과하면서 실제 모델 개선에 활용될 수 있는 기술입니다.
핵심 요약
감독된 미세 조정(SFT)은 모델이 가능성 낮다고 판단한 토큰에서 가장 적극적으로 학습하는데, 이는 새로운 동작을 습득하는 동시에 노이즈나 충돌하는 지도를 증폭하고 기존 사전학습 지식을 덮어쓸 수 있다. 기존 토큰 재가중치 방법들은 음이 아닌 계수를 할당해 지도 업데이트를 억제하거나 증폭할 수 있지만, 일단 학습된 해로운 특성을 역으로 돌릴 수 없다. 큰 학습 가중치는 최적화 궤적을 바꾸는 것이지 고정된 SFT 방향의 크기를 조정하는 것이 아니므로, 진정한 특성 추외삽은 이루어지지 않는다. 전체 요약 9문장 읽기 → 023 15:11 ▲ 16 · 댓글 2 수학 문제 풀이 AI, 근처 파라미터로 학습 더 정확해진다 수학 추론 모델을 학습시키는 온정책 자기증류(OPSD)는 기준 해답을 보는 특권화된 교사가 학생이 샘플한 중간 단계를 감독한다. AI · 머신러닝 · Better Supervision Is Nearby: Neighborhood On-Policy Self-Distillation
Key Point 기존 자기증류 방식의 고정된 감독 전략을 파라미터 근처 탐색으로 개선해 AIME 수학 올림피아드 벤치마크에서 2~3포인트 일관된 성능 향상을 달성했으므로, 수학 문제 풀이 AI의 정확도 향상이 어떻게 이루어지는지 실제로 확인할 수 있다.
핵심 요약
수학 추론 모델을 학습시키는 온정책 자기증류(OPSD)는 기준 해답을 보는 특권화된 교사가 학생이 샘플한 중간 단계를 감독한다. 기존 OPSD는 매 상태마다 고정된 파라미터 설정 하나만 사용했으나, 근처의 파라미터 변동이 같은 기준 맥락에서 추가 감독을 제공한다. 지역 파라미터 섭동은 기준과 정렬된 상이한 정정(correction)을 드러내며, 다양한 전문가들이 기준 위치의 여러 지점에서 이를 제공한다. 전체 요약 9문장 읽기 → 024 15:11 ▲ 56 · 댓글 2 다중 보상 RL에서 희소 신호까지 균등하게 학습시키는 방법 다중 보상 강화학습은 LLM이 여러 행동 목표를 동시에 만족하도록 훈련하는데, GDPO의 보상별 정규화 방식도 목표마다 학습 진도가 불균형하다는 문제가 있다. AI · 머신러닝 · Make Sparse Rewards Count: Density-Aware Reward Aggregation for Multi-Reward RL
Key Point 다중 보상 학습에서 일부 목표만 우선 학습되는 문제를 밀도 기반의 수학적 분석으로 해결하고, 훈련 효율을 크게 개선한 방법론이다.
핵심 요약
다중 보상 강화학습은 LLM이 여러 행동 목표를 동시에 만족하도록 훈련하는데, GDPO의 보상별 정규화 방식도 목표마다 학습 진도가 불균형하다는 문제가 있다. 연구팀은 '장점 에너지(advantage energy)'—배치 내 보상의 제곱된 장점의 합—를 분석하여, 이 에너지가 '활동 밀도'(보상이 0이 아닌 상대적 장점을 제공하는 롤아웃 그룹의 비율)에 비례함을 증명했다. 이는 배치 단위의 신호 불균형을 드러내고, 보상 기여도 보정의 근거를 제공한다. 전체 요약 7문장 읽기 → 025 15:11 ▲ 81 · 댓글 1 교사 모델과 학생의 불일치를 줄이는 지도 라우팅 기법 SAKI 온-폴리시 증류(OPD)는 학생 모델이 생성한 궤적으로 훈련하여 학습-테스트 상태 불일치를 줄이지만, 약한 학생은 교사 모델과 정렬되지 않은 접두사에서 대표성 낮은 감독을 받을 수 있다. AI · 머신러닝 · SAKI: Maximal-Coupling-Routed Teacher Supervision for On-Policy Distillation
Key Point 학생 모델을 효율적으로 증류하면서 정확도를 높이는 새로운 방법으로, 수학 문제 해결 같은 복잡한 추론 작업의 비용 절감에 직결된다.
핵심 요약
온-폴리시 증류(OPD)는 학생 모델이 생성한 궤적으로 훈련하여 학습-테스트 상태 불일치를 줄이지만, 약한 학생은 교사 모델과 정렬되지 않은 접두사에서 대표성 낮은 감독을 받을 수 있다. SAKI(Supervision Allocation with KL-constrained Interpolation)는 KL 제약 교사 유도 롤아웃과 최대 결합을 결합하여, 실현된 수용/교정 이벤트를 재사용해 토큰 수준의 감독을 라우팅한다. 수용된 위치는 샘플링된 토큰의 역-KL 감독을 유지하고, 교정 위치는 교사의 최고 확률 토큰에 대한 직접 감독을 받는다. 전체 요약 7문장 읽기 → 026 12:11 ▲ 43 · 댓글 1 수학 추론 모델, 동료 모델과 궤적 교환으로 성능 향상 RLVR(검증 가능한 보상 강화학습) 방식인 GRPO는 자가생성 궤적에 의존하지만 제한된 롤아웃 예산으로 인해 모두 실패한 그룹이 발생해 정책 기울기 신호를 얻지 못하는 문제가 있다. AI · 머신러닝 · Learning Beyond What You Sample: Off-Policy-Aware Cross-Model Trajectory Exchange for RLVR
Key Point 이질적 모델들 사이의 상호 보완성을 활용해 동일 예산으로 수학 추론 성능을 크게 향상시키는 새로운 강화학습 방식을 제시하고 있으며, 실제 벤치마크에서 GRPO 대비 일관된 성능 개선을 입증했다.
핵심 요약
RLVR(검증 가능한 보상 강화학습) 방식인 GRPO는 자가생성 궤적에 의존하지만 제한된 롤아웃 예산으로 인해 모두 실패한 그룹이 발생해 정책 기울기 신호를 얻지 못하는 문제가 있다. 연구진은 서로 다른 모델들이 상호 보완적인 문제들에서 성공하는 패턴을 발견했으며, 이를 통해 강한 교사 모델 없이도 상호 학습이 가능함을 확인했다. 이를 바탕으로 GRAFT(Gated Replacement of Answer-Failed groups with peer Trajectories)를 제안했으며, 이는 모두 실패한 그룹을 정보량 많은 동료 그룹으로 교체하는 오프정책 인식 프레임워크다. 전체 요약 6문장 읽기 → 027 03:11 ▲ 10 · 댓글 3 강화학습으로 LLM 정책 증류 효율성 높이기 논문은 정책 증류(OPD)를 강화학습 관점으로 분석해 역KL 목적함수와 KL정규화 정책 최적화의 연결성을 규명했다. AI · 머신러닝 · An RL View of OPD: Least Square Policy Distillation for Sample-Efficient LLM Reasoning
Key Point LLM 정책 증류의 표본 효율성을 강화학습 이론으로 획기적으로 개선한 방법론으로, 수학 추론 등 복잡한 작업에서 필요한 롤아웃을 대폭 줄일 수 있다.
핵심 요약
논문은 정책 증류(OPD)를 강화학습 관점으로 분석해 역KL 목적함수와 KL정규화 정책 최적화의 연결성을 규명했다. 이를 바탕으로 최소제곱 정책 증류(LSPD) 프레임워크를 제안했으며, 값 기반 RL의 낙관적 탐색과 오프정책 데이터 재사용을 결합했다. LSPD는 탐색 중 정책 다양성을 유지하면서도 이전에 수집한 궤적을 반복 학습해 롤아웃 효율성을 개선한다. 전체 요약 6문장 읽기 → 028 00:11 ▲ 15 · 댓글 1 LLM 강화학습의 훈련-추론 불일치 문제, 보정된 중요도 샘플링으로 해결 LLM 강화학습에서 추론 엔진과 훈련 엔진이 같은 토큰에 다른 확률을 할당하는 '훈련-추론 불일치' 문제를 분석했다. AI · 머신러닝 · Rethinking Training-Inference Mismatch in LLM Reinforcement Learning: Where It Arises and How to Correct It
Key Point LLM 강화학습 훈련에서 핵심적인 엔진 간 확률 불일치 문제의 근본 원인을 수학적으로 규명하고 실질적인 해결책을 제시해, 향후 LLM-RLHF 개선에 직접 적용 가능한 방법론을 제공한다.
핵심 요약
LLM 강화학습에서 추론 엔진과 훈련 엔진이 같은 토큰에 다른 확률을 할당하는 '훈련-추론 불일치' 문제를 분석했다. 이 불일치를 로짓 공간의 덧셈 변위(epsilon_t)로 특성화하며, 이 분포가 토큰 신뢰도에 관계없이 대체로 불변임을 발견했다. 이를 바탕으로 '보정된 중요도 샘플링(Calibrated Importance Sampling, CIS)'을 제안했다. 전체 요약 7문장 읽기 → 029 18:11 ▲ 12 · 댓글 2 교사 모델의 편차를 걸러내는 증류 기법 제안 On-policy distillation은 강한 교사 모델과 학생 모델의 토큰 수준 차이를 학습해 추론 성능을 높이지만, 이 차이에는 교사 모델 자체의 편차가 섞여 있다. AI · 머신러닝 · Calibrating Teacher--Student Discrepancy for On-Policy Distillation
Key Point 학생 모델의 추론 능력을 효율적으로 높이는 데 불필요한 학습 신호를 제거하는 방식이 기존 기법보다 더 효과적임을 보여주기 때문입니다.
핵심 요약
On-policy distillation은 강한 교사 모델과 학생 모델의 토큰 수준 차이를 학습해 추론 성능을 높이지만, 이 차이에는 교사 모델 자체의 편차가 섞여 있다. 교사 모델의 자체 편차까지 학습하면 학생 모델의 성능이 저하되는데, 특히 특권 정보를 활용하는 경우 이 문제가 더 심해진다. 연구팀은 Cal-OPD 기법을 제안해 긍정·부정 개입을 통해 교사의 편차 영역을 추정하고, 이를 제외한 진정한 역량 차이만 학습하도록 한다. 전체 요약 4문장 읽기 → 030 15:11 ▲ 24 · 댓글 2 확산 LLM의 메모리와 속도 문제를 푸는 Flash-dLLM 비자동회귀 텍스트 생성이 가능한 확산 LLM(dLLM)이 등장했으나 추론 단계에서 KV 캐싱 부재와 병렬 디코딩 메커니즘 부족으로 인해 배포가 제한적이다. AI · 머신러닝 · Flash-dLLM: IO-Aware KV Caching and Parallel Decoding for Fast, Memory-Efficient Diffusion LLMs
Key Point 자동회귀 방식 LLM의 느린 추론이 산업 문제인 가운데, 비자동회귀 생성의 실무 적용을 가로막는 메모리 효율성 문제를 근본적으로 해결하는 기법이다.
핵심 요약
비자동회귀 텍스트 생성이 가능한 확산 LLM(dLLM)이 등장했으나 추론 단계에서 KV 캐싱 부재와 병렬 디코딩 메커니즘 부족으로 인해 배포가 제한적이다. Flash-dLLM은 학습 없이 적용 가능한 추론 가속화 프레임워크로, GPU 메모리 I/O 병목을 식별하고 최적화된 KV 캐시 커널로 메모리 이동을 줄인다. 별도 모델 없이 dLLM 자체가 드래프터와 검증자 역할을 하는 효율적인 draft-and-verify 디코딩 전략을 제안한다. 전체 요약 4문장 읽기 → 031 15:11 ▲ 37 · 댓글 3 강화학습으로 LLM의 추론능력 높이는 BPO 알고리즘 제안 검증 가능한 보상을 활용한 강화학습(RLVR)으로 LLM의 추론 성능을 향상시키는 Bellman Policy Optimization(BPO)을 제안했다. AI · 머신러닝 · Bellman Policy Optimization
Key Point LLM의 수학 추론 같은 복잡한 작업 개선에 필요한 새로운 학습 알고리즘으로, 기존보다 계산 효율적인 방법을 제시한다.
핵심 요약
검증 가능한 보상을 활용한 강화학습(RLVR)으로 LLM의 추론 성능을 향상시키는 Bellman Policy Optimization(BPO)을 제안했다. Policy Mirror Descent(PMD)에서 유도한 비평가 불필요(critic-free) 방식으로, 벨만 방정식을 이용해 중간 상태의 값 추정을 피한다. 원래 PMD 목적함수와 동일한 유일한 최적해를 갖도록 증명했고, 손실함수는 보완적 토큰 확률의 평활 비율을 가중치로 사용한다. 전체 요약 4문장 읽기 →