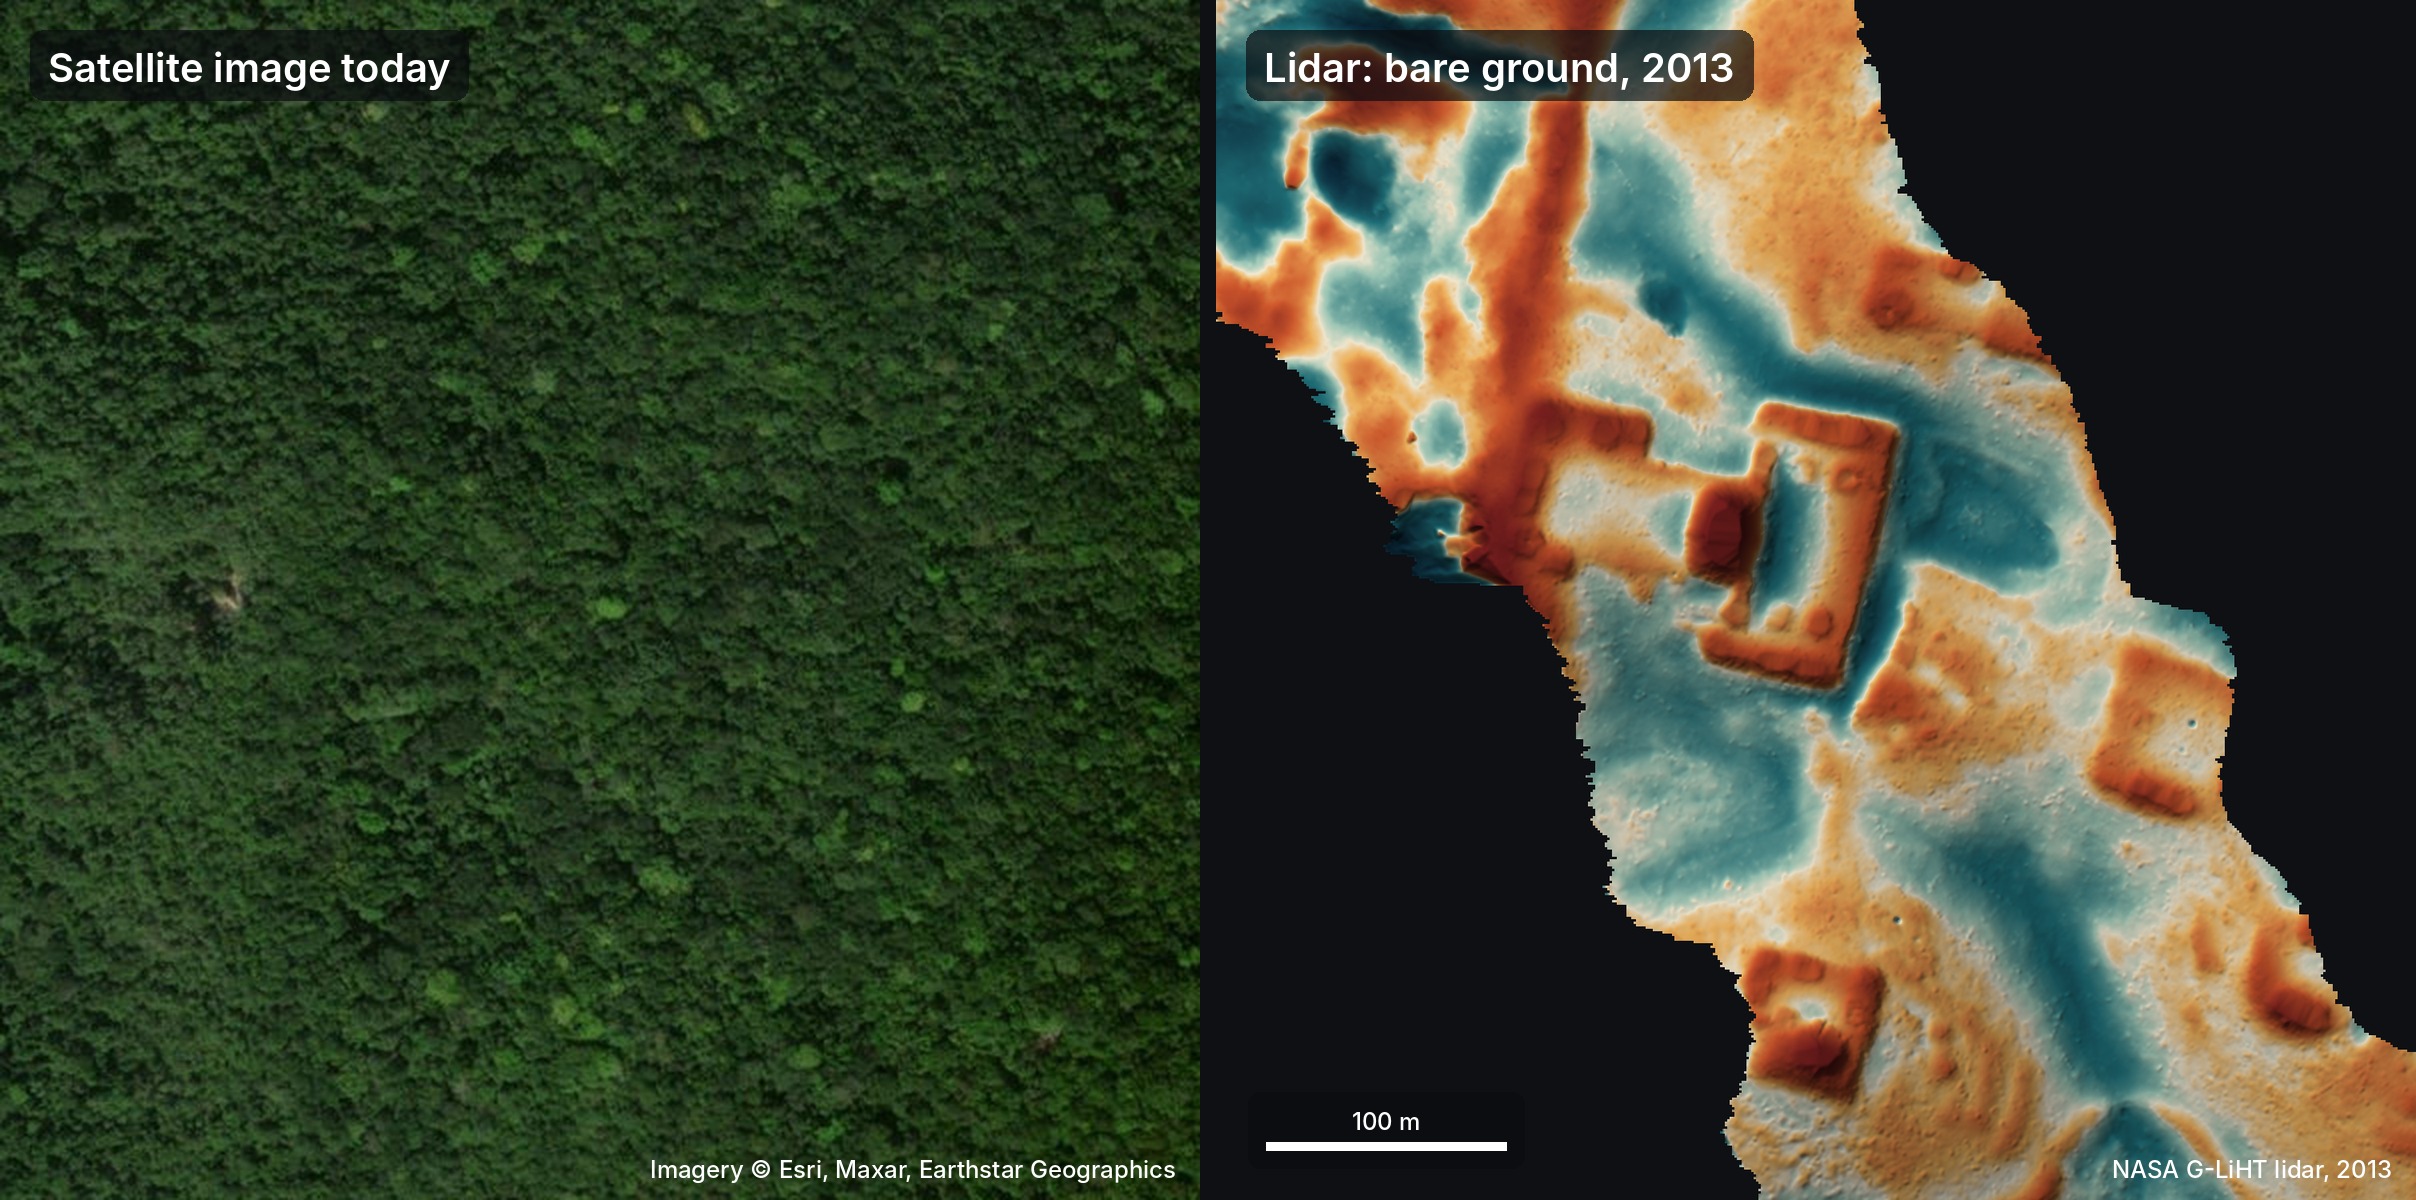
001▲ 441 · 댓글 158AI 에이전트 48개가 NASA 라이다 데이터 72시간 분석해 미지의 마야 문명 발견구글 소프트웨어 엔지니어가 NASA의 라이다 데이터를 분석하기 위해 48개의 AI 에이전트(Gemini, ChatGPT, Claude, Grok)를 활용해 멕시코 유카탄반도의 미기록 마야 유적지를 발견했다.
AI · 머신러닝 · Google SWE points 48 AI agents at NASA Lidar, finds unmapped Maya pyramid in 72h
단일 이미지에서 공간 탐색이 가능한 3D 장면을 브라우저에서 바로 생성·편집할 수 있는 완전한 스튜디오를 갖춘 도구로, 제품 개념화부터 3D 자산 제작까지 워크플로우를 단순화한다.
핵심 요약
이미지 기반 3D 장면 생성 시스템으로, 참고 이미지와 텍스트 프롬프트를 입력하면 카메라 궤적을 따라 미리보기·재생·추적 가능한 3D 장면을 생성한다.
확산 모델(SD1.5, Blazing Drive V11m, Realistic Vision V5.1, Cartoon Pixar V5)과 카메라 궤적(Look Around, Overhead Orbit, Spin in Place 360), 렌더링 궤적(Push In and Out, Classic Orbit, Subtle Sway)을 선택하여 한 번에 생성할 수 있다.
깊이 추정(ZoeDepth)과 3D 가우시안 스플래팅을 거쳐 색상·깊이 애니메이션과 가우시안 포인트 클라우드를 생성하고, PLY 형식으로 다운로드하거나 브라우저에서 직접 미리볼 수 있다.
3D 재구성의 오래된 문제인 보이지 않는 영역의 기하학 복원 문제를 신경망 기반으로 해결하는 새로운 방법이 나왔으며, 소수 뷰 환경에서의 성능 개선이 3D 스캔·VR·로봇 비전 등 다양한 응용에 영향을 줄 수 있다.
핵심 요약
이미지 기반 3D 재구성 방식은 주로 보이는 표면만 복원해 큰 구멍이 있는 불완전한 포인트 클라우드를 생성한다.
이를 해결하기 위해 AnchorComplete라는 프레임워크를 제안하는데, 불완전한 포인트 클라우드에서 완전한 장면 메시를 복원하면서 관찰된 기하학을 보존한다.
TRELLIS.2를 기반으로 구축되었으며, 부분 포인트 조건화(global scene tokens와 local spatial evidence를 결합해 입력에 생성을 고정)와 메트릭 스케일 coarse-to-fine 생성(고정 크기 윈도우 내에서 기하학을 점진적으로 개선하면서 전역 구조 일관성 유지)을 결합한다.
005▲ 49 · 댓글 2큰 각도 카메라 움직임 속에서 캐릭터 영상 생성하기기존 캐릭터 비디오 생성 방식은 회전·평동·거리 변화가 함께 일어나는 대각도 카메라 궤적을 따라가기 어려우며, 초기 프레임에 보이지 않던 캐릭터 영역이 드러나면서 기하학적 왜곡과 외형 저하, 아이덴티티 손실 문제를 겪는다.
AI · 머신러닝 · WorldCast: World-Consistent Character Video Generation with Large-Angle Camera Control
006▲ 13 · 댓글 2카메라 영상과 깊이만으로 물체 자세 파악하는 F2G-Pose 공개RGB-D 이미지에서 물체의 3D 회전과 이동을 추정하는 카테고리 수준 물체 자세 인식 문제를 다룬다. 부분적 관찰과 자세 모호성이 있어도 인스턴스 특화 CAD 모델이나 참조 이미지 없이 자세를 복구해야 한다.
AI · 머신러닝 · F2G-Pose: Geometry-Aware Foundation Feature Lifting for Direct RGB-D Category-Level Object Pose Estimation
011▲ 43 · 댓글 2손재주 많은 로봇 제어, 3D 점군으로 배운다세계 동역학과 로봇 행동을 함께 학습하는 월드 액션 모델에서, 기존 방식은 RGB 프레임이나 잠재 표현으로 세계를 모델링하고 손목 각도 같은 1차원 값으로만 행동을 예측해 3D 공간 구조와 접촉 기하를 놓쳤다.
AI · 머신러닝 · PointWAM: 3D World Action Modeling for Dexterous Robotic Manipulation