매일 쌓이는 개발자의 시야
2026년 11월 4일 (수). 세상의 기술 소식, 한국어로 한눈에.
AI 요약 안내 AI가 한국어로 정리한 내용입니다. 정확한 정보는 각 카드의 원문을 확인해 주세요.
요약 원칙 ↗ 01 읽을 소식Hacker News 7건 ↓ 02 써볼 도구GitHub Trending 3건 ↓ 03 읽을 논문Hugging Face Papers 6건 ↓ 04 새 버전GitHub Releases 1건 ↓ AI · 머신러닝 분야 · 17건 필터 해제 ×
오늘의 주요포인트 상위 6건
01 AI · 머신러닝 00:11 게시
원제 The 'Astra can read and write weights to improve Qwen' post is misleading
436 포인트 댓글 87
Key Point Astra 논문이 대규모 언어모델 개선 결과를 강조하면서 핵심 기법의 범위를 명확히 하지 않아, 독자들이 실제 기능을 잘못 이해할 수 있는 상황을 지적합니다.
핵심 요약
'Astra가 가중치를 읽고 쓰면서 Qwen을 개선한다'는 논문이 마술 속임수처럼 여러 기법을 섞어 표현하고 있다고 비판한다. 논문의 추상화는 'Astra가 생 가중치만 봐도 무엇을 하는지 알 수 있고 코드 피드백 없이 네트워크를 만들 수 있다'고 주장하지만, 실제로는 그렇지 않다. 실험을 분류하면 생 가중치만 읽는 실험(17K~172K 모델, 4개)과 Python 코드를 사용하는 실험(언어모델 포함, 4개)이 섞여 있다. 전체 요약 8문장 읽기 → 02 AI · 머신러닝 00:11 게시
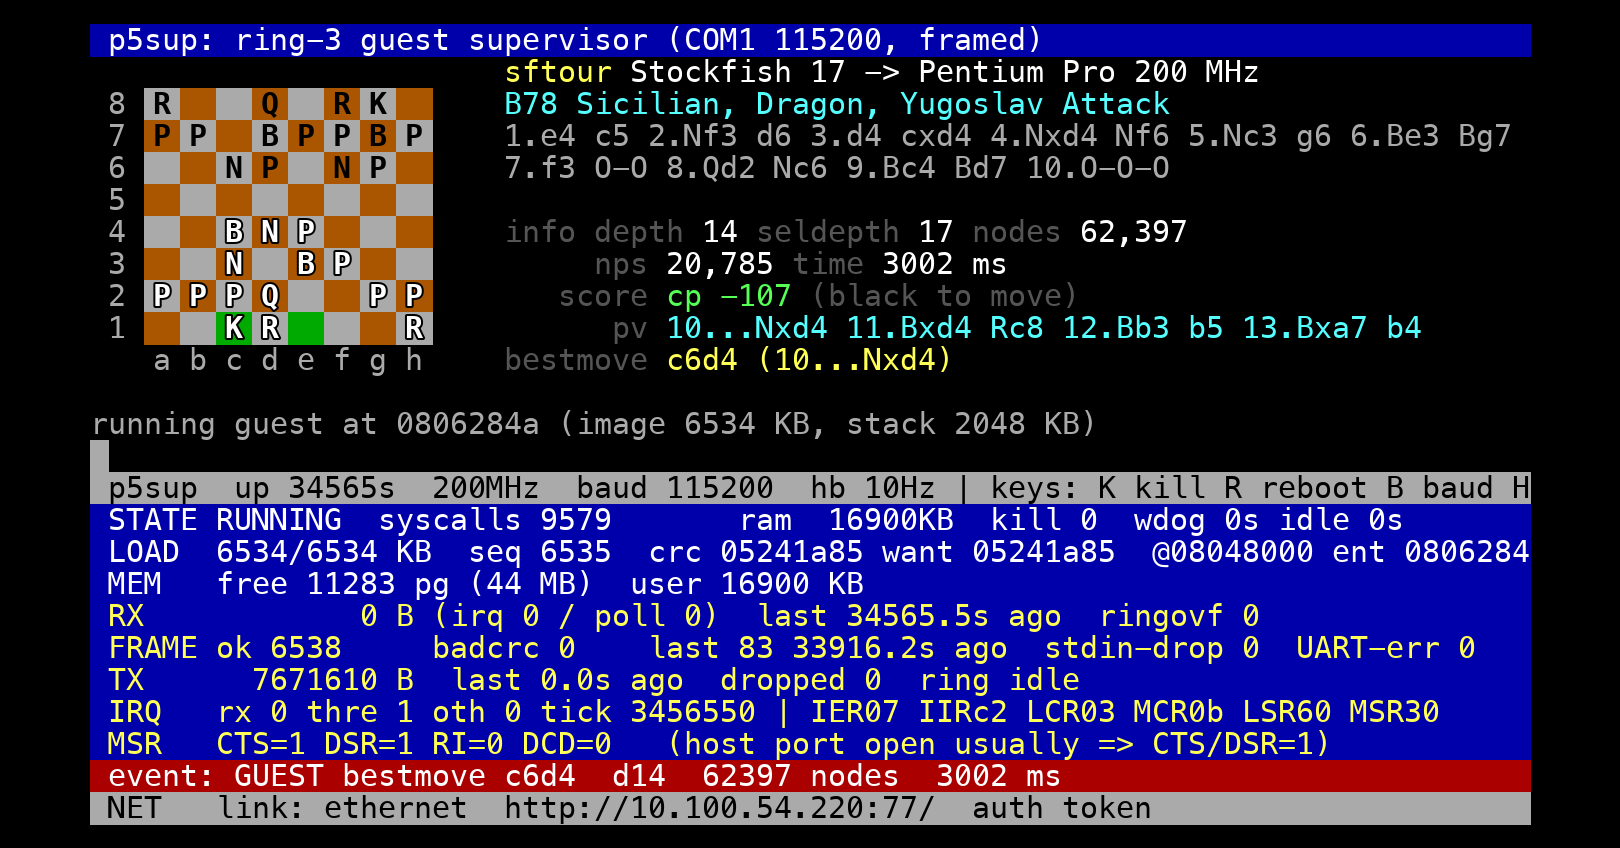
원제 Could a modern chess engine on a Pentium have defeated Kasparov in 1996?
189 포인트 댓글 97
Key Point 체스 엔진의 역사적 진화에서 하드웨어 성능 향상보다 알고리즘 개선이 더 큰 역할을 했다는 실증적 발견은, 현대 AI 시스템의 성능 개선 방향에 대한 시사점을 제시한다.
핵심 요약
1996년 IBM의 딥블루가 세계 챔피언 카스파로프를 처음 이겼으나, 이는 30개의 P2SC 프로세서와 480개의 커스텀 VLSI 칩으로 수백만 달러를 들여 만든 특수 목적 컴퓨터였다. 저자는 31년 전 1995년 11월 출시된 200MHz 펜티엄 프로 (64MB RAM)에서 스톡피시를 포팅해 실행했을 때, 약 3300±87 Elo 정도의 수준에 도달했는데 이는 카스파로프의 2800 Elo를 크게 앞서고 있다. 체스 강화의 세 가지 방법은 더 많은 수를 분석하거나, 더 좋은 수를 선택하거나, 더 잘 평가하는 것인데, 현대 체스 엔진의 진화는 주로 후자 두 가지에서 나온다. 전체 요약 11문장 읽기 → 03 AI · 머신러닝 03:11 게시
원제 OpenAI seems to be silently re-enabling model training on Codex chats
176 포인트 댓글 57
Key Point 기업에서 IP 보호를 위해 명시적으로 비활성화한 데이터 공유 설정이 사용자 동의 없이 자동으로 복구되는 것은 개인정보 제어권과 기업 기밀 관리에 직결되는 문제이다.
핵심 요약
사용자가 의도적으로 비활성화한 Codex의 모델 학습용 데이터 공유 설정이 명시적인 동의 없이 다시 활성화되었다. 작성자의 회사는 프롬프트를 통한 IP 유출을 우려해 Codex, Claude Code 등의 데이터 공유를 꺼두었으나, 어제 동료들과 함께 설정이 자동으로 복구된 사실을 발견했다. 이 설정은 ChatGPT 설정 페이지의 데이터 제어 섹션에서 '모두를 위해 모델 개선(Improve the model for everyone)'이라는 항목으로 확인할 수 있다. 전체 요약 5문장 읽기 → 04 AI · 머신러닝 03:11 게시
원제 Just a little AI resistance, as a treat
162 포인트 댓글 101
Key Point 기업들이 비용 절감을 위해 AI 챗봇으로 고객 민원을 무분별하게 처리할 때 발생하는 신뢰 문제를 현실적으로 보여주며, 고객이 언제 AI 대응에 항의해야 하는지 기준을 제시한다.
핵심 요약
저자는 Ocado 온라인 마트에 캘린더 초대 포맷 오류를 신고했으나 'Lulu'라는 이름의 AI 생성 응답을 받았다. 과도한 공손함, 대시 기호(-), 그리고 구체적 내용 부재가 AI 생성의 전형적 특징이었고, 저자는 실제 검토가 이루어지지 않았다고 의심했다. 저자가 고객 만족도 조사에서 AI 대응의 무례함을 비판하며 1점을 준 후, 며칠 뒤 진정한 사람이 쓴 것으로 보이는 진심 어린 사과와 감사 메시지를 받았다. 전체 요약 6문장 읽기 → 05 AI · 머신러닝 00:11 게시
원제 LLMs are not superhuman at reading and writing neural network weights
104 포인트 댓글 8
Key Point 논문의 주요 결과가 실제로는 숙련된 인간 연구자도 수행 가능한 작업이며, LLM의 신경망 편집 능력이 AI 연구 방식을 혁신할 새로운 능력이 아니라는 점을 명확히 한다.
핵심 요약
최근 논문에서 GPT-4 Astra가 신경망의 가중치를 직접 읽고 수정할 수 있다고 주장하며 이를 초인적 능력으로 표현했다. Astra는 작은 신경망의 가중치만 보고 학습된 게임을 파악하고 가중치를 직접 조정했으며, 0.8B 크기의 Qwen 모델의 수학 능력을 개선했다. 게임 식별 작업은 실제로는 간단한 것으로, 모델의 입력 채널이 8×8 그리드 셀에 직접 연결되고 '에이전트', '움직이는 물체' 같은 레이블이 있어 파이썬 3줄로 계산 가능하다. 전체 요약 8문장 읽기 → 06 AI · 머신러닝 00:11 게시
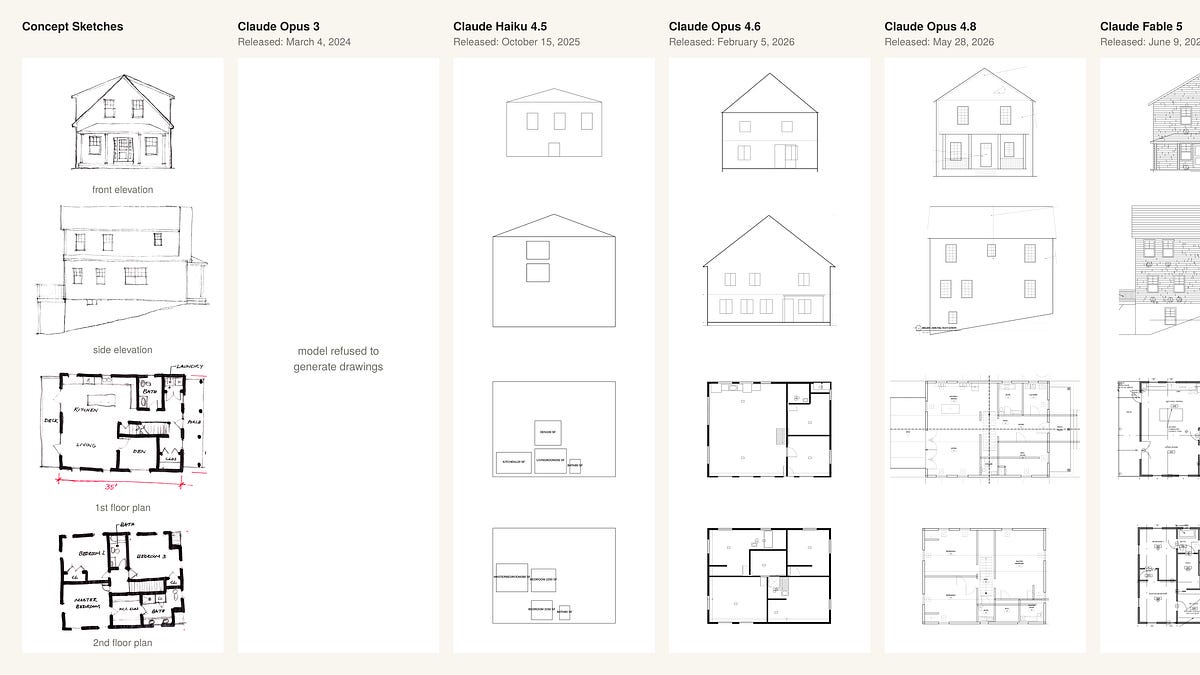
원제 Claude Opus 5.5 Can Draw Permit-Level Architectural Drawings
103 포인트 댓글 35
Key Point 건축 설계와 도면 작업이 AI의 급속한 발전으로 근본적으로 변할 시점에 있으며, 숙련된 건축가도 현장에서 감독하기 어려운 변화가 임박해 있기 때문이다.
핵심 요약
건축가인 저자가 13개 AI 모델의 기술도면 작성 능력을 테스트했으며, Anthropic의 Claude Opus 5.5(2026년 9월 출시)가 적절한 지도 하에 주택용 건축 인허가 수준의 완전한 도면 세트를 생산할 수 있음을 발견했다. 2026년 봄까지 최강 AI 모델도 조악하고 만화 같은 기술도면만 생산했으나, 2026년 여름부터 가을 출시된 프론티어 모델들이 급격히 개선되었다. 첫 번째 테스트에서 Opus 5.5는 저자의 컨셉 스케치와 참조 도면 세트를 받아 12시간 걸려 완전한 건축 도면 세트를 생성했으며, 계산 비용은 수백 달러였다. 전체 요약 12문장 읽기 → 전체 색인1건 · 분야별
AI · 머신러닝1건 001 03:11 ▲ 102 · 댓글 80 알고리즘 효율성의 정의를 놓친 50년, 이론과 현실의 단절 1965년 잭 에드몬즈가 그래프 최대 매칭 알고리즘을 발표할 때 '효율성'의 명확한 정의가 없었고, 2페이지를 할애해 지수 시간은 나쁘고 다항식 시간은 좋다는 기준을 처음 제안했다. AI · 머신러닝 · Efficient algorithms, the Exponential Time Hypothesis, and losing the plot
Key Point 컴퓨터과학 기초 이론이 현실의 계산 능력과 완전히 단절되어 있으며, 세계적 기업이 발표한 '획기적' 결과도 실제로는 구현 불가능한 매개변수를 감추고 있다는 점을 보여주기 때문입니다.
핵심 요약
1965년 잭 에드몬즈가 그래프 최대 매칭 알고리즘을 발표할 때 '효율성'의 명확한 정의가 없었고, 2페이지를 할애해 지수 시간은 나쁘고 다항식 시간은 좋다는 기준을 처음 제안했다. 에드몬즈는 자신의 기준이 불완전함을 알았고, n^1000 같은 다항식도 현실에서는 효율적이지 않으며 일부 지수 알고리즘(심플렉스)이 실무에서 빠르게 작동한다는 점을 이미 지적했다. 이 모호한 정의로 50년간 복잡도 이론이 발전했고, 현재 우리에게는 '복잡도 동물원'이라는 표현할 수 없을 정도로 큰 실행 시간을 가진 '우주적 알고리즘(galactic algorithm)'들이 쌓여 있다. 전체 요약 6문장 읽기 → 오늘의 주요당일 스타 상위 3건
01 AI · 머신러닝 21:11 게시
blader/humanizer
원제 blader/humanizer
스타 64,328 당일 +460 Python
Key Point AI 글쓰기 특징 26개를 자동으로 감지해 다시 쓰는 도구로, AI 콘텐츠의 특정 표현 습관을 제거할 수 있는 실용적인 방법을 제시한다.
핵심 요약
Humanizer는 AI가 작성한 글을 자연스러운 인간의 글처럼 다시 쓰되 내용은 바꾸지 않는 에이전트 스킬이다. Wikipedia의 AI 글쓰기 특징 가이드를 기반으로 26가지 패턴을 검사한다. 가장 강한 5가지 패턴은 '~이 아니라 ~이다' 구문, 한 줄 마무리, 깊어 보이는 말, 단계별 도입, 근거 없는 반박 등이다. 전체 요약 11문장 읽기 → 02 AI · 머신러닝 21:11 게시
Usagi-org/ai-goofish-monitor
원제 Usagi-org/ai-goofish-monitor
스타 16,296 당일 +204 Python
Key Point 중고마켓 데이터 수집이 필수인 개발자나 실제 중국 시장 진출 기업에겐 AI 기반 자동 모니터링 솔루션이 어떻게 구축되는지 보여주며, 멀티태스킹·프록시 관리·AI 분석을 통합한 복잡한 스케이핑 시스템의 실전 사례가 될 수 있습니다.
핵심 요약
Playwright 브라우저 자동화와 AI 모델을 결합해 중국 闲鱼(Xianyu, 알리바바 중고마켓) 상품을 실시간·정기적으로 모니터링하고 지능형 분석하는 Python 시스템. Web 관리 UI에서 자연언어로 AI 작업을 생성하거나 키워드·가격·지역 필터를 직접 설정해 독립적인 다중 감시 작업을 운영할 수 있음. 각 작업은 OpenAI 호환 API(GPT-4V 등)를 통해 상품 이미지와 텍스트를 분석하고, 사용자 조건에 맞는 물품을 찾아냄. 전체 요약 10문장 읽기 → 03 AI · 머신러닝 03:11 게시
Yuan1z0825/nature-skills
원제 Yuan1z0825/nature-skills
스타 52,030 당일 +167 Python
Key Point Codex나 Claude Code 같은 에이전트에 논문 윤문, 심사 회신, 그림 제작 워크플로를 스킬로 붙이려는 연구자가 참고할 만한 구성 사례다.
핵심 요약
nature-skills는 Nature 스타일 학술 표현과 연구용 그림 제작을 돕는, 재사용 가능한 SKILL.md 기반 스킬 모음이다. 각 스킬은 skills/ 아래 최상위 디렉터리 하나로 설치되며, nature-shared는 다른 스킬이 참조하는 공유 지원 패키지로 단독 호출용이 아니다. 빠른 시작에서는 논문·문단·심사 의견을 Agent에 넘기고 PDF 중영 대조 reader 생성, 논문 발표 PPT, Nature 스타일 영문 윤문, 초록·서론 초안, 3인 상호 비공개 심사 시뮬레이션, 심사 회신 작성, 인용 조사, 연구 그림 생성 같은 프롬프트를 쓴다. 전체 요약 11문장 읽기 → 읽을 논문
Hugging Face Papers06 커뮤니티가 고른 오늘의 AI 논문
오늘의 주요추천 상위 3건
01 AI · 머신러닝 00:11 게시
원제 SWE-Trail: History-Guided Trajectory Collection for Coding Agent Training
추천 32 댓글 1 Ziming Li, Lu Yu, Jiatan Huang 외
Key Point 코딩 AI 학습에 쓰이는 데이터 수집 방식이 최종 모델 성능을 크게 좌우하는데, 이력 정보를 효과적으로 활용하면서도 학습-테스트 간 불일치를 피하는 구체적 방법을 제시한다.
핵심 요약
코딩 에이전트가 저장소 이슈를 해결하는 과정에서 생기는 긴 탐색·편집·검증 수열들이 학습 데이터로 활용되고 있다. 기존 방식은 각 이슈마다 여러 궤적을 독립적으로 샘플링한 뒤 선별하지만, 샘플이 많아질수록 중복이 증가하고 이전 데이터가 향후 수집 방향을 안내할 수 있다는 점을 무시한다. 이력을 코딩 에이전트의 컨텍스트로 직접 제공하면 학습 시 그 조언에 의존하게 되어 테스트 시 사용할 수 없는 정보에 모델이 편향되는 문제가 생긴다. 전체 요약 7문장 읽기 → 02 AI · 머신러닝 00:11 게시
원제 When Does Latent Prediction Error Support Physical Surprise Claims in Video World Models?
추천 21 댓글 1 Anton Hristov, Aleksandar Slavov, Vasil Vasilev
Key Point 비디오 AI가 물리 법칙을 이해한다고 판단하는 기준(예측 오차)이 실제로는 색상·모양 변화에도 반응해 신뢰성이 낮다는 점을 밝혀, 세계 모델 평가 방식의 재검토가 필요함을 보여준다.
핵심 요약
비디오 생성 AI의 예측 오차는 물리적으로 불가능한 사건을 감지하는 지표로 사용되지만, 실제로는 물체 색상·모양 변화나 일반적인 예측 어려움도 함께 반영된다. 연구팀은 고정된 표현이 무엇을 담고 있는지, 물리적 변화와 겉모습 변화를 어떻게 구별하는지, 모델의 예측 오차를 무엇이 변화시키는지 분리해 평가하는 프레임워크를 개발했다. IntPhys2 벤치마크에서 V-JEPA2 모델을 포함한 여러 표현(잠재 예측, 마스킹된 픽셀 재구성, 시각 통계)을 비교한 결과, 물리적 가능성·불가능성에 대한 정보는 적게 포함했다. 전체 요약 8문장 읽기 → 03 AI · 머신러닝 00:11 게시
원제 FLAMIA: FLAsh MIcroscaling Attention for Fast and Causally Safe Training on Blackwell
추천 13 댓글 1 Fedor Velikonivtsev, Mikhail Koltakov, Denis Kuznedelev
Key Point Transformer 학습의 가장 비용이 높은 부분인 Attention 연산을 최신 Blackwell GPU의 저정밀도 연산으로 1.1~1.4배 빠르게 만드는 기법이 개발되어, 대규모 모델 학습 효율에 직접적인 영향을 미칠 수 있다.
핵심 요약
NVIDIA Blackwell GPU의 고처리량 저정밀도 행렬 곱셈을 Attention 연산에 활용하기 위해 FLAMIA라는 attention 커널 패밀리를 제시했다. 양자화 오버헤드, 공유 스케일을 통한 인과 정보 누출, 정방향과 역방향 계산 간 수치 불일치 등 세 가지 주요 문제를 해결했다. MXFP8과 혼합 NVFP4/FP8 학습 경로를 지원하며, 토큰-블록 스케일링으로 양자화된 피연산자를 행렬 방향 간에 재사용한다. 전체 요약 8문장 읽기 → 전체 색인3건 · 분야별
AI · 머신러닝3건 001 03:11 ▲ 12 · 댓글 1 LLM의 연구 안목, 인간 과학자보다 훨씬 떨어진다 연구 안목(어떤 논문을 읽고 어떤 문제를 추구할지 판단하는 능력)은 AI 과학자의 업무에 점점 중요해지지만 실행 능력보다 덜 이해되고 있다. AI · 머신러닝 · IdeaTaste: Do LLMs Share the Research Taste of Human Researchers?
Key Point LLM이 인간 연구자처럼 '어떤 연구가 가치 있는가'를 판단하는 능력은 매우 부족하며, 방향 설정이 아닌 구체적 접근법 수립이 핵심 과제임을 보여주는 첫 대규모 실증이다.
핵심 요약
연구 안목(어떤 논문을 읽고 어떤 문제를 추구할지 판단하는 능력)은 AI 과학자의 업무에 점점 중요해지지만 실행 능력보다 덜 이해되고 있다. IdeaTaste는 2025년 논문 데이터로부터 LLM이 생성한 연구 제안이 2026년 실제 발표된 논문과 얼마나 일치하는지 평가하는 벤치마크다. 6개 언어모델과 4개 연구 분야에서 90,000개 이상 제안을 평가한 결과, LLM은 인간 수준의 26%만 인용 일치도를, 18%만 아이디어 일치도를 달성했다. 전체 요약 9문장 읽기 → 002 03:11 ▲ 12 · 댓글 1 LLM 증류 방식 개선, 확률값 대신 토큰 순서만 학습 기존 온폴리시 증류(OPD)는 학생 모델을 교사 모델의 토큰 확률값에 맞춰 학습시킨다. AI · 머신러닝 · Order-Only On-Policy Distillation
Key Point 확률값 대신 토큰 순서만 학습하는 방식으로 LLM 증류 성능을 개선했으며, 온도 튜닝 같은 복잡한 하이퍼파라미터 조정이 필요 없어진다는 점이 실무적 가치를 갖는다.
핵심 요약
기존 온폴리시 증류(OPD)는 학생 모델을 교사 모델의 토큰 확률값에 맞춰 학습시킨다. 이 확률값에는 교사가 선호하는 토큰이 무엇인지와 얼마나 확신하는지 두 가지 정보가 섞여있는데, 후자는 교사의 용량과 보정을 반영하므로 작은 학생 모델이 재현하기 어렵다. 교사 온도 변화가 확률값을 바꾸지만 순서는 유지하므로 OPD는 온도 선택에 민감하다. 전체 요약 10문장 읽기 → 003 00:11 ▲ 12 · 댓글 1 작은 의사결정 모델, 큰 언어모델 앞지르다 의사결정 모델은 구조화된 작업에서 선택지나 점수를 직접 예측해 자동회귀 디코딩 지연을 피하지만, 생성형 LLM의 순위 매김 지식을 이전하기는 어렵다. AI · 머신러닝 · DecisionRank: On-Policy Distillation for Decision-Model Rerankers
Key Point 구조화된 검색 작업에서 작은 모델이 큰 모델 수준의 성능을 크게 빠른 속도로 달성하는 방법이 나왔기 때문에, 정보 검색 시스템의 효율성이 크게 개선될 가능성이 있다.
핵심 요약
의사결정 모델은 구조화된 작업에서 선택지나 점수를 직접 예측해 자동회귀 디코딩 지연을 피하지만, 생성형 LLM의 순위 매김 지식을 이전하기는 어렵다. 의사결정 모델(학생)은 첫 토큰 위치의 점수로 순위를 정하는 반면 생성형 교사는 문서 ID 수열의 순위 목록으로 선호도를 표현하기 때문이다. DecisionRank는 항목 공간 정책상 증류(item-space OPD) 기법으로 학생 모델을 학습한다. 전체 요약 7문장 읽기 → 오늘의 주요최신순 상위 1건
01 AI · 머신러닝 03:11 게시
openai/openai-python
원제 openai/openai-python v3.43.0
v3.43.0
Key Point 실시간 음성·스트리밍 기능을 사용하는 개발자는 WebSocket 통신의 안정성과 응답 처리 개선을 확인해야 한다.
핵심 요약
OpenAI 파이썬 라이브러리 v3.43.0이 릴리스되었다. Live Responses 위임 도구를 확장하는 API 기능을 추가했다. WebSocket 진행 상황을 누적하는 응답 처리 기능이 개선되었다. 전체 요약 5문장 읽기 → ● 이번 피드는 여기까지입니다.
작은 발견을 다음 커밋으로 이어가세요. 모든 발행본