쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 4일 (수)까지 3898건
52건 · "Attention"조건 지우기 ×
001 00:11 ▲ 13 · 댓글 1 Blackwell GPU용 저정밀도 Attention 커널 FLAMIA 공개 NVIDIA Blackwell GPU의 고처리량 저정밀도 행렬 곱셈을 Attention 연산에 활용하기 위해 FLAMIA라는 attention 커널 패밀리를 제시했다. AI · 머신러닝 · FLAMIA: FLAsh MIcroscaling Attention for Fast and Causally Safe Training on Blackwell
Key Point Transformer 학습의 가장 비용이 높은 부분인 Attention 연산을 최신 Blackwell GPU의 저정밀도 연산으로 1.1~1.4배 빠르게 만드는 기법이 개발되어, 대규모 모델 학습 효율에 직접적인 영향을 미칠 수 있다.
핵심 요약
NVIDIA Blackwell GPU의 고처리량 저정밀도 행렬 곱셈을 Attention 연산에 활용하기 위해 FLAMIA라는 attention 커널 패밀리를 제시했다. 양자화 오버헤드, 공유 스케일을 통한 인과 정보 누출, 정방향과 역방향 계산 간 수치 불일치 등 세 가지 주요 문제를 해결했다. MXFP8과 혼합 NVFP4/FP8 학습 경로를 지원하며, 토큰-블록 스케일링으로 양자화된 피연산자를 행렬 방향 간에 재사용한다. 전체 요약 8문장 읽기 → 002 18:11 ▲ 24 · 댓글 2 동영상을 선택적으로 관찰하는 AI 자막 생성 시스템 멀티모달 대규모 언어 모델(MLLM)이 영상 자막을 생성할 때 사소한 세부 사항을 과도하게 강조하고 핵심 맥락을 놓치는 문제가 있다. AI · 머신러닝 · Reviso: Not All Visual Evidence Deserves Equal Attention in Video Captioning
Key Point 멀티모달 AI가 영상 분석 시 모든 부분을 동등하게 처리하는 문제를 선택적 관찰로 해결하는 새로운 접근이 보여 이후 자막 생성, 영상 이해 시스템 설계에 참고할 만하다.
핵심 요약
멀티모달 대규모 언어 모델(MLLM)이 영상 자막을 생성할 때 사소한 세부 사항을 과도하게 강조하고 핵심 맥락을 놓치는 문제가 있다. Reviso는 관찰 대상과 수집 방식을 학습하는 에이전트형 동영상 자막 시스템으로, 낮은 프레임율의 전체 미리보기에서 계층적 Context-Focus-Points(CFP) 계획을 세운다. CFP 계획은 영상 맥락을 파악하고 핵심 요소를 우선순위화한 뒤 구체적인 관찰 대상과 해당 도구를 정의한다. 전체 요약 8문장 읽기 → 003 15:11 ▲ 100 · 댓글 3 실시간 장편 영상 생성 위해 '웨이브 포싱' 기법 제시 실시간 장편 영상 생성을 위해 Wave Forcing(WF) 기법을 제안했다. 기존 청크 단위 자동회귀 방식은 직렬화된 노이즈 제거와 캐시 갱신으로 인해 한 단계 노이즈 제거에도 두 번의 순전파가 필요했다. AI · 머신러닝 · Wave Forcing: Towards Speed-of-Light Streaming Video Generation
Key Point 실시간 장편 영상 생성의 핵심 병목인 순차 처리 방식을 병렬화로 해결하는 구체적 기법이 제시되었고, 7배 이상의 성능 향상을 실현한 점이 주목된다.
핵심 요약
실시간 장편 영상 생성을 위해 Wave Forcing(WF) 기법을 제안했다. 기존 청크 단위 자동회귀 방식은 직렬화된 노이즈 제거와 캐시 갱신으로 인해 한 단계 노이즈 제거에도 두 번의 순전파가 필요했다. WF는 청크별 인과 주의 메커니즘으로 노이즈 제거가 완료되기 전 더 깨끗한 과거 청크에 먼저 접근하고, 엇갈린 노이즈 제거와 캐시 갱신 단계를 모델 복제본들에 분산시켜 파이프라인 충전 후 한 번의 순전파 라운드마다 하나의 출력 청크를 생성한다(1F1C). 모델을 연속 생성 프로세스에 적응시키기 위해 혼합 노이즈 노이즈 제거, 움직임 감독, 자체 생성 히스토리를 이용한 인과 적응을 순차적으로 도입하는 3단계 훈련 절차를 개발했다. 전체 요약 7문장 읽기 → 004 12:11 ▲ 27 · 댓글 2 동영상 세계 모델을 명시적 토큰으로 제어하는 'World-in-Context' Interactive video world modeling은 시점, 캐릭터 동작, 카메라 움직임을 조정해야 하는데, 기존 방식은 이들을 텍스트에 숨기거나 혼재시키고 분산된 구조로만 제어했다. AI · 머신러닝 · World-in-Context: Interactive Video World Modeling with In-Context Conditioning
Key Point 비디오 생성 모델에서 시점과 동작 제어를 명시적 토큰으로 통일한 새로운 접근이 기존 대형 모델(22B)과 같은 성능을 훨씬 작은 모델(5B)에서 달성하는 방식의 전환을 보여준다.
핵심 요약
Interactive video world modeling은 시점, 캐릭터 동작, 카메라 움직임을 조정해야 하는데, 기존 방식은 이들을 텍스트에 숨기거나 혼재시키고 분산된 구조로만 제어했다. World-in-Context는 In-Context Conditioning(ICC) 방식으로 시점, 동작, 카메라 제어를 명시적 토큰으로 통일하고 Self-Attention 공간에 직접 포함시킨다. 명시적 시점 토큰은 충돌하는 역학을 분리하고 단일 시점 데이터에서 시점 전환을 창발적으로 가능케 하며, 동작과 카메라는 각각 지역적 반응성과 전역적 안정성을 보완한다. 전체 요약 6문장 읽기 → 005 06:11 새 버전 Hugging Face Transformers v5.21 릴리스, 5개 신규 모델 추가 Transformers 라이브러리가 v5.21.0을 릴리스했으며, 문서 인식부터 음성 합성까지 5개 모델을 새로 지원한다. AI · 머신러닝 · huggingface/transformers@v5.21
Key Point 문서 이해, 음성 합성 등 신규 모델 5개가 추가되고 병렬 처리·양자화·캐시 처리가 크게 개선되어 LLM과 멀티모달 모델 개발자들에게 직접적인 영향이 있다.
핵심 요약
Transformers 라이브러리가 v5.21.0을 릴리스했으며, 문서 인식부터 음성 합성까지 5개 모델을 새로 지원한다. MiniCPM-OCR은 OpenBMB의 모델로 SigLIP 비전 인코더와 Qwen3.5 언어 모델을 결합해 스캔 페이지, 스크린샷, 영수증 등 텍스트 밀집 이미지를 읽는다. Flint는 Recursive의 혼합 전문가 모델로 슬라이딩 윈도우 주의(512개 토큰 범위)와 완전 주의를 결합하며, 각 희소 계층이 256개 전문가 중 6개를 라우팅한다. 전체 요약 12문장 읽기 → 006 18:11 ▲ 102 · 댓글 37 셀프-어텐션 없이 언어모델 성능 낼 수 있을까 논문은 시퀀스 모델링에서 셀프-어텐션이 반드시 필요한지 근본적으로 재검토한다. AI · 머신러닝 · Attention Is Not What You Need (2025)
Key Point 트랜스포머 아키텍처의 핵심인 어텐션 메커니즘 자체를 대체하는 기하학적 모델을 제시하며, 같은 성능을 유지하면서 더 해석 가능한 설계가 가능함을 시사한다.
핵심 요약
논문은 시퀀스 모델링에서 셀프-어텐션이 반드시 필요한지 근본적으로 재검토한다. 기존 멀티헤드 어텐션을 숨은 벡터들을 고차원 공간으로 끌어올리는 텐서 lifting 메커니즘으로 해석하되, 이는 수학적으로 불명확하고 여러 층을 거치면서 명시적 불변량으로 기술하기 어렵다고 주장한다. 대안으로 그래스만 다양체 기반 구조를 제안하며, 인과 그래스만 층은 토큰 상태를 선형 축약한 뒤 플뤼커 좌표로 인코딩된 저차수 부분공간의 제어된 변형을 통해 정보를 전파한다. 전체 요약 6문장 읽기 → 007 18:11 ▲ 11 · 댓글 1 자율주행 카메라 영상으로 3D 인식·재구성 일괄 처리 Foundation4D Foundation4D는 다중 카메라 주행 영상으로부터 깊이 추정, 3D 객체 감지, 의미론적 점유격자(occupancy), 가우시안 재구성을 모두 수행하는 통합 신경망 모델이다. AI · 머신러닝 · Foundation4D: Towards a unified perception and reconstruction model for autonomous vehicles
Key Point 자율주행 단일 모델로 깊이·객체감지·공간점유까지 동시에 처리하고 이를 장면 재구성까지 연결하는 통합 파이프라인이 등장했으며, 라이다 없이도 상용 벤치마크에서 경쟁 방식을 앞도는 성능을 보였다.
핵심 요약
Foundation4D는 다중 카메라 주행 영상으로부터 깊이 추정, 3D 객체 감지, 의미론적 점유격자(occupancy), 가우시안 재구성을 모두 수행하는 통합 신경망 모델이다. 공유 백본은 인수분해 시공간 어텐션(factorized spatiotemporal attention)으로 여러 카메라의 관측값과 시간 정보를 효율적으로 결합한다. 비디오 추론 파이프라인은 포즈 그래프 최적화로 카메라 궤적을 개선하고 입력 윈도우 전체에서 객체 추적을 조합한다. 전체 요약 7문장 읽기 → 008 06:11 ▲ 143 · 댓글 53 엔비디아 RTX 3000 시리즈, 커널 모듈로 FP/BF16 성능 잠금 해제 GPU unlock은 리눅스 커널 모듈로 엔비디아 RTX 3090 Ti, 3090, 3080, 3070, 3060 등 GA102/GA103/GA104/GA106 칩 기반 카드의 FP/BF16 명령어 발급 속도를 전문가용 수준으로 끌어올린다. 하드웨어 · 시스템 · GPU-unlock: FP/BF16 instruction issue rate on Nvidia 3000's cards
Key Point GeForce 게이밍 카드의 하드웨어 성능을 전문가용 수준으로 해제하는 커널 모듈 방식이 등장했으며, 드라이버 업데이트 때마다 수동 패치 없이 작동하는 점과 구체적인 성능 배수를 통해 AI/ML 워크로드 비용 최적화 전략을 바꿀 수 있다.
핵심 요약
GPU unlock은 리눅스 커널 모듈로 엔비디아 RTX 3090 Ti, 3090, 3080, 3070, 3060 등 GA102/GA103/GA104/GA106 칩 기반 카드의 FP/BF16 명령어 발급 속도를 전문가용 수준으로 끌어올린다. NVIDIA 드라이버 바인딩 전에 조기 실행되는 방식으로, 새 드라이버 출시 때마다 매번 수동 패치할 필요가 없다. 속도 선택자(SS0 0x88888888, SS1 0x8)를 기록하고 FLR을 수행한 뒤 작동하며, CMP 언로커의 V67/PLM 기법과 UEFI 방식의 사전 드라이버 타이밍을 결합한다. 전체 요약 13문장 읽기 → 009 15:11 ▲ 34 · 댓글 2 AI 연구팀이 선형 주의 구조 자동 발견 자율 에이전트를 활용해 과학 발견을 가속화하기 위해 서로 다른 전문성을 갖춘 AI 연구자 팀을 구성하는 방법을 제안했다. AI · 머신러닝 · Building AI Research Teams for Autonomous Discovery of Linear Attention Architectures
Key Point 다양한 전문성과 기억을 갖춘 AI 팀의 협력 구조가 자동화된 과학 발견에서 얼마나 중요한지 보여주는 결과로, 향후 AI 연구 자동화 시스템 설계의 기준을 제시한다.
핵심 요약
자율 에이전트를 활용해 과학 발견을 가속화하기 위해 서로 다른 전문성을 갖춘 AI 연구자 팀을 구성하는 방법을 제안했다. 실험 비용이 높을 때 제한된 실험 예산 내에서 탐색과 활용의 균형을 맞추기 위해 적응형 할당 방식을 도입했다. 각 AI 연구자가 서로 다른 학문 배경을 가지고 개인 연구 기록을 유지하면서 공유된 실험 증거를 바탕으로 협력하는 구조를 설계했다. 전체 요약 6문장 읽기 → 010 15:11 ▲ 23 · 댓글 3 영상 생성 AI의 주의 계산 최적화, 훈련 없이 처리 시간 단축 비디오 확산 트랜스포머의 3D 어텐션 계산이 비용이 많이 드는 문제를 해결하기 위해 블록-스파스(block-sparse) 어텐션이 사용되지만, 기존 방법들은 스파시티 할당을 최적화하지 못하거나 휴리스틱에만 의존한다. AI · 머신러닝 · Sparsity Should Be ALLOTted by Output: Training-Free Allocation of Block-Sparse Attention for Video Diffusion Transformers
Key Point 비디오 생성 모델의 추론 속도를 실질적으로 단축할 수 있는 실용적 최적화 방법을 제시하며, 훈련 없이 적용 가능해 즉시 도입할 수 있다.
핵심 요약
비디오 확산 트랜스포머의 3D 어텐션 계산이 비용이 많이 드는 문제를 해결하기 위해 블록-스파스(block-sparse) 어텐션이 사용되지만, 기존 방법들은 스파시티 할당을 최적화하지 못하거나 휴리스틱에만 의존한다. 연구팀은 다른 레이어와 디노이징 단계에서 어텐션 스파시티를 줄일 때 최종 영상 품질에 영향을 주는 정도가 크게 다르다는 것을 발견했다. 중요한 발견은 품질에 가장 민감한 레이어-단계 조합이 입력 데이터에 관계없이 거의 변하지 않는다는 점이다. 전체 요약 8문장 읽기 → 011 09:11 당일 +108 LLM 추론 최적화 라이브러리 vLLM, 200+ 모델 지원 vLLM은 UC Berkeley의 Sky Computing Lab에서 개발한 오픈소스 LLM 추론·서빙 엔진으로, 2000명 이상의 기여자가 참여하는 활발한 프로젝트다. AI · 머신러닝 · vllm-project/vllm · Python
Key Point LLM 서빙 성능이 중요해지면서 vLLM 같은 최적화된 추론 엔진의 역할이 커지고 있으며, 광범위한 모델 지원과 하드웨어 호환성이 프로덕션 배포의 실질적 선택지를 제공한다.
핵심 요약
vLLM은 UC Berkeley의 Sky Computing Lab에서 개발한 오픈소스 LLM 추론·서빙 엔진으로, 2000명 이상의 기여자가 참여하는 활발한 프로젝트다. PagedAttention을 통해 메모리를 효율적으로 관리하고 연속 배칭, 청크 프리필, 프리픽스 캐싱으로 높은 처리량을 제공한다. FP8, INT4, GPTQ/AWQ, GGUF 등 다양한 양자화 방식과 FlashAttention, FlashInfer 같은 최적화 커널을 지원한다. 전체 요약 8문장 읽기 → 012 18:11 ▲ 28 · 댓글 2 메모리 간섭 줄인 선형 어텐션, 장문맥 모델링에 강하다 KronLSTM이라는 새로운 선형 어텐션 아키텍처를 제안했으며, 크로네커 델타 규칙이라는 연관 행렬 메모리의 신규 업데이트 규칙을 기반으로 한다. AI · 머신러닝 · Kronecker Delta Rule for Long Context Linear Attention
Key Point 메모리 간섭을 크게 줄이면서 안정성까지 갖춘 선형 어텐션이 장문맥 모델링 성능에서 기존 방식을 앞서면서, 대형 언어모델의 효율적인 장문맥 처리 방식이 진화하고 있음을 보여준다.
핵심 요약
KronLSTM이라는 새로운 선형 어텐션 아키텍처를 제안했으며, 크로네커 델타 규칙이라는 연관 행렬 메모리의 신규 업데이트 규칙을 기반으로 한다. xLSTM 계열을 확장해 메모리 수정 메커니즘을 추가했으며, 특정 연관성을 정정하면서도 행렬 공간의 단일 방향으로만 메모리를 변경한다. 이러한 최소한의 침습적 메모리 수정 방식은 기존 델타 규칙 업데이트 대비 이전에 저장된 정보와의 간섭을 줄여 장문맥 언어 모델링에 적합하다. 전체 요약 8문장 읽기 → 013 15:11 ▲ 20 · 댓글 3 로봇 조작 학습, 인간 영상으로도 가능하게 로봇 조작을 배우는 데 인간 비디오가 필요한 이유는 로봇 행동 라벨이 있는 영상은 비용이 많고 다양성이 부족하기 때문이다. AI · 머신러닝 · AffordanceWAM: Affordance-Aware Joint World-Action Modeling for Robot Manipulation
Key Point 로봇 학습 데이터의 수집 비용을 크게 낮추고 인간 영상을 직접 활용할 수 있는 방법이 제시되었기 때문에, 로봇 조작 분야에서 실용적인 전환점이 될 수 있다.
핵심 요약
로봇 조작을 배우는 데 인간 비디오가 필요한 이유는 로봇 행동 라벨이 있는 영상은 비용이 많고 다양성이 부족하기 때문이다. AffordanceWAM은 미래 프레임을 예측하면서 동시에 객체별 상호작용 가능 영역(Scalar Affordance, Affordance Heatmap)을 표현하는 생성 모델이다. 비디오 디퓨전 트랜스포머를 기반으로 World Expert와 Action Expert를 따로 설계하고 Masked Joint Self-Attention으로 연결하여 RGB 관찰, 어포던스 필드, 히트맵, 로봇 액션을 함께 예측한다. 전체 요약 7문장 읽기 → 014 00:11 ▲ 254 · 댓글 45 Mistral, 시계열 예측 파운데이션 모델 Timestral 공개 Mistral이 시계열 데이터 예측을 위한 첫 파운데이션 모델 Timestral을 공개했다. AI · 머신러닝 · Timestral: Mistral release time-series foundation models
Key Point 시계열 데이터는 기업의 센서·관찰성 메트릭부터 재무 수치까지 매우 광범위하게 쓰이는데, 이전에 도메인별로 처음부터 학습해야 했던 방식을 벗어나 사전학습된 기초 모델으로 적응형 예측이 가능해진다.
핵심 요약
Mistral이 시계열 데이터 예측을 위한 첫 파운데이션 모델 Timestral을 공개했다. 최대 크기 모델은 2억 9천만 개 파라미터로, GIFT-Eval, TIME, fev-bench 세 가지 주요 벤치마크에서 1위를 차지했으며 이전 최고 기록보다 파라미터 수는 2/3 수준이다. 5백만부터 2억 9천만 개 파라미터까지 4가지 크기로 출시되며, 각 크기별로 정확도와 모델 크기의 파레토 프런티어에 위치한다. 전체 요약 11문장 읽기 → 015 12:10 ▲ 10 · 댓글 2 GQA의 3가지 딜레마를 동시에 푸는 Virtual Head Attention 긴 문맥 처리 시 KV 캐시 크기, 학습·프리필 연산량, 모델 품질을 동시에 개선하기는 어렵다는 '불가능의 삼각형'에 직면한 어텐션 메커니즘 설계에 대응하기 위해 Virtual Head Attention(VHA)을 제안한다. AI · 머신러닝 · Virtual Head Attention
Key Point KV 캐시 메모리와 학습 효율, 모델 품질의 균형을 동시에 달성해야 하는 LLM 개발자들이 GQA의 근본적 한계를 극복할 수 있는 방법을 제시합니다.
핵심 요약
긴 문맥 처리 시 KV 캐시 크기, 학습·프리필 연산량, 모델 품질을 동시에 개선하기는 어렵다는 '불가능의 삼각형'에 직면한 어텐션 메커니즘 설계에 대응하기 위해 Virtual Head Attention(VHA)을 제안한다. VHA는 두 개의 경량 선형 연산으로 구성되는데, Q Premix가 쿼리 헤드 개수를 절반으로 줄인 상태에서 KV 그룹 내 가상 헤드 다양성을 복구하고, Linear Postmix가 낮은 순위의 I + AB^top 잔여 구조를 통해 헤드 간 특징을 융합한다. VHA는 비선형 연산을 도입하지 않으므로 Premix와 Postmix를 추론 시간에 각각 쿼리 프로젝션과 출력 프로젝션으로 폴드할 수 있어, 표준 GQA-2 아키텍처로 축약되면서 기존의 모든 GQA 추론 최적화를 직접 재사용할 수 있다. 전체 요약 6문장 읽기 → 016 03:11 ▲ 11 · 댓글 2 선형 시간 희소 어텐션으로 컨텍스트 길이 확장하기 선형 시간 시퀀스 모델들은 고정된 크기의 상태에 정보를 저장하기 때문에 장문맥 처리에 제약이 있고, 전체 어텐션을 추가하면 이차 비용이 발생한다. AI · 머신러닝 · FreeSolo: Linear-time Sparse Attention with Zero-Shot Length Extrapolation
Key Point 트랜스포머의 근본적 한계인 이차 복잡도 문제를 해결하면서도 학습 데이터보다 긴 입력에서도 작동하는 새로운 어텐션 메커니즘의 제안으로, LLM의 컨텍스트 길이 확장이 시급한 현실에서 실질적 개선을 제시한다.
핵심 요약
선형 시간 시퀀스 모델들은 고정된 크기의 상태에 정보를 저장하기 때문에 장문맥 처리에 제약이 있고, 전체 어텐션을 추가하면 이차 비용이 발생한다. 지속적 사전학습(CPT)을 통한 희소 어텐션은 컨텍스트 길이를 늘릴 수 있지만 학습된 길이를 넘어 일반화하기 어렵고 비용이 크다. FreeSolo는 단거리 슬라이딩 윈도우 분기와 키포인트 셀을 선택하는 장거리 분기로 구성된 네이티브 희소 어텐션 메커니즘이다. 전체 요약 6문장 읽기 → 017 21:11 당일 +308 에이전틱 워크로드 최적화 LLM 추론 엔진 TokenSpeed 공개 LightSeek Foundation이 에이전틱 워크로드에 최적화된 LLM 추론 엔진 TokenSpeed를 오픈소스로 공개했다. AI · 머신러닝 · lightseekorg/tokenspeed · Python
Key Point 에이전틱 AI 애플리케이션이 주목받으면서 추론 엔진의 처리량과 지연시간이 핵심 경쟁력이 되었고, TokenSpeed는 이를 위해 기본부터 재설계한 오픈소스 솔루션으로 실제 대규모 모델 배포에서 검증된 성능을 입증했다.
핵심 요약
LightSeek Foundation이 에이전틱 워크로드에 최적화된 LLM 추론 엔진 TokenSpeed를 오픈소스로 공개했다. 기존 엔진과 달리 제어 평면(C++)과 실행 평면(Python)을 분리한 아키텍처를 채택했으며, 제어 평면은 유한 상태 머신으로 구현되어 컴파일 타임에 KV 캐시 리소스 안전성을 보장한다. 커널은 플러그인 가능한 계층형 시스템으로 설계되었으며, Blackwell GPU에서 가장 빠른 MLA(Multi-head Latent Attention) 구현 중 하나를 포함한다. 전체 요약 9문장 읽기 → 018 18:11 ▲ 354 · 댓글 2 VLM의 "빠른 사고": 공간 추론을 분류 문제로 재구성 비전-언어 모델(VLM)이 공간 관계, 거리, 위치 같은 질문에 자동 회귀 방식으로 텍스트를 생성하는 것은 비효율적이다. 이에 MJev-Spatial은 공간 이해 작업을 통일된 분류 프레임워크로 재구성한 System 1 모델이다. AI · 머신러닝 · MJev-Spatial: System One Spatial Intelligence via Native Attention Matching
Key Point 공간 추론 같은 제약된 답변 공간 작업을 분류로 바꾸면 자동 회귀 생성의 지연 없이 단일 포워드 패스로 정확하게 풀 수 있으며, 이는 로봇 제어나 실시간 상호작용이 필요한 애플리케이션의 성능 개선으로 이어진다.
핵심 요약
비전-언어 모델(VLM)이 공간 관계, 거리, 위치 같은 질문에 자동 회귀 방식으로 텍스트를 생성하는 것은 비효율적이다. 이에 MJev-Spatial은 공간 이해 작업을 통일된 분류 프레임워크로 재구성한 System 1 모델이다. 선택 문제는 주어진 옵션을 클래스로, 수치 예측은 값 범위를 이진 분류 단계로, 점 예측은 이미지 영역을 단계적으로 분류하는 방식이다. 기존 VLM의 쿼리-키 사영을 재사용해 추가 파라미터 없이 후보를 점수 매기므로, 추론 시 단 한 번의 포워드 패스로 답을 내놓고 답변 토큰을 생성하지 않는다. 전체 요약 5문장 읽기 → 019 15:11 ▲ 18 · 댓글 2 비디오 월드 모델의 KV 캐시 병목 해결하는 Velox 비디오 월드 모델은 액션과 카메라 움직임으로 장시간의 시각적 생성물을 만들지만, KV 캐시가 계속 커져 뒷부분 청크 생성이 느려지는 문제가 있다. AI · 머신러닝 · Velox: Spatial Memory Makes World Models Efficient
Key Point 비디오 기반 상호작용형 시뮬레이션에서 반응 속도가 중요한데, 기존 방식은 생성 길이가 늘어날수록 지수적으로 느려지는 메모리 병목이 있기 때문이다.
핵심 요약
비디오 월드 모델은 액션과 카메라 움직임으로 장시간의 시각적 생성물을 만들지만, KV 캐시가 계속 커져 뒷부분 청크 생성이 느려지는 문제가 있다. Velox는 학습 없이 작동하는 어텐션 라우터로, 스트리밍 기하학으로부터 카메라 frustum slab 대응을 이용해 영역 수준의 컨텍스트를 선택한다. 과거 블록을 깊이 간격이 있는 frustum slab으로 표현하고, 현재 블록의 깊이는 recency-priority multiwarp를 통해 구한다. 전체 요약 8문장 읽기 → 020 12:11 ▲ 14 · 댓글 2 선형 어텐션의 오래된 맥락 처리 능력 끌어올리기 선형 어텐션은 효율성이 필요한 긴 맥락 언어 모델링을 약속하지만, 고정 크기의 순환 상태로 현재 계산을 지원하면서 동시에 계속 증가하는 히스토리 정보를 보존해야 하는 딜레마가 있다. AI · 머신러닝 · History Replays Itself: Unleashing Long-Context Capability in Linear Attention
Key Point 선형 어텐션 모델의 가장 큰 약점인 긴 맥락 처리를 메모리 오버헤드 거의 없이 해결하는 방법을 제시해 실용적 배포 가능성을 높였다.
핵심 요약
선형 어텐션은 효율성이 필요한 긴 맥락 언어 모델링을 약속하지만, 고정 크기의 순환 상태로 현재 계산을 지원하면서 동시에 계속 증가하는 히스토리 정보를 보존해야 하는 딜레마가 있다. 기존에는 이 순환 상태의 메모리 용량이 모델의 긴 맥락 처리 능력의 상한선을 정한다고 여겨졌으나, 연구팀은 순환 계산이 장기 저장의 모든 부담을 질 필요가 없다는 점을 제시한다. NoteBank라는 희소 에피소드 메모리를 도입했으며, 이는 미래 쿼리를 알기 전에 선택된 텍스트를 보관하고, 백본의 기본 특징으로 읽고 쓰며, 재생을 통해 네이티브 순전파 계산으로 검색된 증거를 읽는다. 전체 요약 8문장 읽기 → 021 12:11 ▲ 12 · 댓글 2 토큰 수준의 선택 정확도와 실행 효율을 동시에 해결한 희소 어텐션 긴 문맥에서 LLM 추론 시 KV-캐시 통신량을 줄이는 희소 어텐션 기법들은 주로 높은 단위의 선택만 가능하던 한계가 있었다. AI · 머신러닝 · Joint Subspace Sparse Attention for Efficient Long-Context Decoding
Key Point 토큰 단위 선택의 정확도와 실행 속도 사이의 오래된 트레이드오프를 동시에 해결해 실용적인 장문맥 추론 가속이 가능해진다.
핵심 요약
긴 문맥에서 LLM 추론 시 KV-캐시 통신량을 줄이는 희소 어텐션 기법들은 주로 높은 단위의 선택만 가능하던 한계가 있었다. 저해상도 점수 부여로는 쿼리-키 구조 정보가 손실되어 정확한 랭킹이 어렵고, 선택된 토큰들을 모으는 과정에서 레이턴시 이득이 상쇄되는 문제가 있었다. Joint Subspace Sparse Attention (JSSA)은 공유 저차원 쿼리-키 부분공간을 학습해 토큰 점수 보존 오차를 최소화함으로써 선택 품질을 개선한다. 전체 요약 8문장 읽기 → 022 03:12 새 버전 트랜스포머 5.20.0: 메타 뮤즈 스파크 오픈 등 6개 신규 모델 지원 메타의 멀티모달 혼합 전문가 모델 뮤즈 스파크 오픈(Muse Spark Open)을 추가했다. 총 816B 파라미터(토큰당 활성 42B)이며 최대 1,048,576 토큰의 맥락 창을 지원하고 다중 파일 편집·디버깅·도구 사용 등 에이전틱 코딩 작업을 위해 학습됐다. AI · 머신러닝 · huggingface/transformers@v5.20.0
Key Point 메타·알렉스 알파·바이두 등 주요 기업의 첨단 멀티모달·OCR·오디오 모델 6개가 한 번에 지원되고, 분산 학습·추론·양자화 내보내기 등 프로덕션 기능이 대폭 개선되어 트랜스포머 사용자에게 즉시 영향을 미친다.
핵심 요약
메타의 멀티모달 혼합 전문가 모델 뮤즈 스파크 오픈(Muse Spark Open)을 추가했다. 총 816B 파라미터(토큰당 활성 42B)이며 최대 1,048,576 토큰의 맥락 창을 지원하고 다중 파일 편집·디버깅·도구 사용 등 에이전틱 코딩 작업을 위해 학습됐다. InclusionAI의 Ling 3.0 Flash는 5개 KDA 레이어와 1개 MLA 레이어를 결합한 혼합 전문가 모델로 BailingHybridForCausalLM으로 네이티브 지원되어 trust_remote_code=True 없이 로드된다. 알렉스 알파의 Kolibri 1은 독일어·영어 중심 추론 모델로, 50개 레이어가 384명의 전문가 중 6명에게 각 토큰을 시그모이드 라우팅으로 라우팅하고 슬라이딩 윈도우와 전체 어텐션 레이어를 번갈아 사용한다. 전체 요약 13문장 읽기 → 023 21:11 ▲ 34 · 댓글 2 동영상 초고화질화, 일반 GPU로 4K 실시간 처리 가능해졌다 기존 동영상 초고화질화(VSR) 모델이 확산 증류를 통해 한 단계 생성으로 효율성을 높였으나, 고해상도 추론 비용이 크고 생성 결과가 사용자 선호와 맞추기 어려운 문제가 있었다. AI · 머신러닝 · FlashVSR+: Efficient Video Super-Resolution via Hybrid Attention and Reward-Yield Distribution Matching
Key Point 동영상 초고화질화가 실용적인 수준의 속도와 메모리 효율로 4K 고해상도 처리가 가능해지면서, 콘텐츠 제작자와 개발자들이 일반 사양 GPU에서도 고품질 영상 생성을 구현할 수 있게 되었다.
핵심 요약
기존 동영상 초고화질화(VSR) 모델이 확산 증류를 통해 한 단계 생성으로 효율성을 높였으나, 고해상도 추론 비용이 크고 생성 결과가 사용자 선호와 맞추기 어려운 문제가 있었다. FlashVSR+는 하이브리드 어텐션 메커니즘을 도입해 사전학습된 VSR 모델의 강한 지역성(locality)을 활용하면서 장거리 일관성을 위해 희소 전역 상호작용을 유지한다. 이를 통해 DiT 속도를 최대 2배 높이고 피크 메모리를 45% 감소시켜, RTX 4090 24GB 단일 GPU에서 타일 분할 없이 4K 영상 초고화질화를 가능하게 했다. 전체 요약 7문장 읽기 → 024 21:11 ▲ 46 · 댓글 1 고해상도 이미지 생성 가능한 경량 디퓨전 변환기 기법 디퓨전 변환기(DiT)가 학습 해상도를 넘어 이미지를 생성하려면 토큰 수가 급증해 전체 어텐션이 계산 비용이 높아지고, 구조 왜곡과 디테일 저하 문제가 발생한다. AI · 머신러닝 · AReA: Adaptive Receptive-Field Attention for Efficient High-Resolution Diffusion Transformers
Key Point 고해상도 이미지 생성 시 계산량 폭증 문제를 적응형 어텐션으로 해결한 방식으로, 추가 학습 없이 적용 가능하다는 점이 중요하다.
핵심 요약
디퓨전 변환기(DiT)가 학습 해상도를 넘어 이미지를 생성하려면 토큰 수가 급증해 전체 어텐션이 계산 비용이 높아지고, 구조 왜곡과 디테일 저하 문제가 발생한다. 균등한 전체 어텐션이 이 문제의 공통 원인인데, 모든 스텝에서 모든 토큰에 주목하면 이차 복잡도가 생기고 학습 범위를 벗어난 상대 거리에 노출되어 모델이 분포에서 벗어난다. 어텐션의 유효 수용 범위는 노이즈 제거 과정에서 좁혀지는데, 초반 스텝에서 전역적으로 구조를 형성하고 후반 스텝에서 국소적으로 세부를 정제한다. 전체 요약 6문장 읽기 → 025 12:11 ▲ 66 · 댓글 1 Sparse Attention의 성능 가속, 무손실 증명 기반 최적화 DoSA(Dots Sparse Attention)는 sparse attention의 계산 비용을 줄이는 무손실 방법으로, 모든 키에 대한 점수 매김을 조건부로 만들면서도 정확한 토큰 선택을 보장한다. AI · 머신러닝 · DoSA: Dots Sparse Attention
Key Point LLM의 주요 병목인 sparse attention 계산을 수학적 증명으로 가속하는 기법으로, 추론 속도 개선이 직접적으로 비용 절감으로 이어지는 프로덕션 환경에서 실질적 임팩트를 제공한다.
핵심 요약
DoSA(Dots Sparse Attention)는 sparse attention의 계산 비용을 줄이는 무손실 방법으로, 모든 키에 대한 점수 매김을 조건부로 만들면서도 정확한 토큰 선택을 보장한다. 핵심 아이디어는 Top-K 선택이 후보를 완전히 평가하지 않아도 승리 임계값에 대한 증명(certificate)으로 배제 가능하다는 점이다. 시드 세트가 임계값의 하한을 제공하고, 음수 가중치 헤드의 기여도를 수학적으로 상한으로 제한한다. 전체 요약 7문장 읽기 → 026 12:11 ▲ 34 · 댓글 4 깊이 축 주의 메커니즘 확장으로 신경망 효율성 1.58배 향상 Attention Residuals(AttnRes)는 네트워크 깊이축을 따라 내용 기반 검색을 수행하는 메커니즘으로, 깊이축 단일스트림 소프트맥스 어텐션으로 볼 수 있습니다. AI · 머신러닝 · Multi-Stream Attention Residuals
Key Point 대규모 신경망의 효율성을 단순한 아키텍처 변경만으로 1.58배 향상시키는 방법을 제시하여 모델 학습과 배포 비용 절감에 직접 영향을 줄 수 있습니다.
핵심 요약
Attention Residuals(AttnRes)는 네트워크 깊이축을 따라 내용 기반 검색을 수행하는 메커니즘으로, 깊이축 단일스트림 소프트맥스 어텐션으로 볼 수 있습니다. 다중헤드 어텐션의 성공에 영감을 받아 Multi-Stream Attention Residuals(MSAR)을 제안했으며, 이는 AttnRes를 다중헤드 깊이 어텐션으로 확장한 것입니다. MSAR은 다중규모 인과 합성곱을 통해 시퀀스 문맥에서 스트림 다양성을 도출하여, 각 헤드가 서로 다른 문맥 관점을 통해 과거 표현을 검색할 수 있습니다. 전체 요약 6문장 읽기 → 027 12:11 ▲ 12 · 댓글 2 비전 토큰 50% 줄이고 성능 99.5% 유지하는 압축 기법 Vision-language 모델은 강력하지만 비전 토큰이 입력 시퀀스의 대부분을 차지해 계산 비용이 크다는 문제가 있다. AI · 머신러닝 · V-CoLA: Vision Token Compression with Linear Attention
Key Point 선형 어텐션 기반 비전-언어 모델에서 기존 압축 방법이 작동하지 않는 문제를 해결하는 새로운 접근법으로, 실무 배포 시 추론 속도와 메모리 효율을 크게 개선할 수 있다.
핵심 요약
Vision-language 모델은 강력하지만 비전 토큰이 입력 시퀀스의 대부분을 차지해 계산 비용이 크다는 문제가 있다. 선형 어텐션을 활용한 하이브리드 아키텍처(예: Qwen3.5)가 등장하면서 기존 소프트맥스 기반 압축 방법들이 성능 저하를 보인다. 연구팀은 선형 어텐션에 특화된 훈련 불필요 토큰 압축 프레임워크 V-CoLA를 제안했다. 전체 요약 7문장 읽기 → 028 15:13 ▲ 38 · 댓글 2 확산 변환기의 희소 주의 문제, 훈련 없이 해결 확산 변환기에서 긴 시퀀스 생성(영상, 3D 자산)을 가속할 때 희소 주의를 쓰면 생성 품질이 떨어지는 문제가 있다. AI · 머신러닝 · MC-Sparse: Deconstructing and Closing the Dense-Sparse Attention Gap in Diffusion Transformers
Key Point 긴 시퀀스 생성 작업의 병목인 희소 주의의 품질 저하 문제를 훈련 없이 근본적으로 해결해 실용적 가속을 달성했다.
핵심 요약
확산 변환기에서 긴 시퀀스 생성(영상, 3D 자산)을 가속할 때 희소 주의를 쓰면 생성 품질이 떨어지는 문제가 있다. 연구팀은 품질 저하 원인을 세 가지로 분석했다: 토큰 그룹화 제약, 부정확한 상호작용 선택, 폐기된 토큰의 주의 기여 손실이다. 이를 바탕으로 메타 캐시 희소 주의(MC-Sparse)를 제안했다. 훈련이 필요 없는 프레임워크로, 개별 키-값 토큰을 선택하면서 유사한 쿼리들을 타일 정렬 그룹으로 묶어 GPU 실행을 효율화한다. 전체 요약 6문장 읽기 → 029 06:11 ▲ 341 · 댓글 79 16.9MB 경량 음성인식 모델 Whistle 공개 Cactus Compute가 모바일, 웨어러블, 로봇, 스마트홈, 자동차, 마이크로컨트롤러용 음성인식 모델 Whistle을 공개했다. AI · 머신러닝 · Whistle: Speech to Text in 16.9 MB
Key Point 극도로 경량화한 음성인식 모델로 온디바이스 처리가 가능해져, 엣지 환경에서 사용할 수 있는 선택지가 생겼다.
핵심 요약
Cactus Compute가 모바일, 웨어러블, 로봇, 스마트홈, 자동차, 마이크로컨트롤러용 음성인식 모델 Whistle을 공개했다. Whistle은 16.9MB 단일 파일로, CPU에서 의존성 없이 작동하며 기존 Needle 엔진과 같은 C++ 컨테이너에서 동작한다. 7개 언어(영어, 독일어, 프랑스어, 스페인어, 이탈리아어, 네덜란드어, 폴란드어) 지원하며, 최대 30초 음성을 온디바이스에서 처리한다. 전체 요약 12문장 읽기 → 030 18:30 ▲ 30 · 댓글 2 장문맥 하이브리드 모델의 동작 원리 분석 LLM의 아키텍처가 전체 어텐션만 사용하던 기존 방식에서 슬라이딩 윈도우 어텐션(SWA)과 선형 어텐션(LA) 등을 결합한 하이브리드 모델로 전환되고 있다. AI · 머신러닝 · Mechanics of Long-Context Hybrid Models Part 1.1: From Hybrid Attention to Hybrid Position
Key Point 하이브리드 어텐션이 장문맥 처리에서 어떤 메커니즘으로 작동하는지, 슬라이딩 윈도우와 선형 어텐션 중 어느 것을 선택할지 결정하는 기준이 명확히 제시되었기 때문이다.
핵심 요약
LLM의 아키텍처가 전체 어텐션만 사용하던 기존 방식에서 슬라이딩 윈도우 어텐션(SWA)과 선형 어텐션(LA) 등을 결합한 하이브리드 모델로 전환되고 있다. 본 논문은 하이브리드 모델이 작동하는 이유를 규명하고 더 효과적으로 설계하기 위해 '장문맥 하이브리드 모델의 역학'을 제안한다. 전체 어텐션과 SWA, 또는 GLA·GDN 같은 게이팅 선형 어텐션을 결합한 하이브리드에서 씨소 효과(Seesaw Effect)를 관찰했다: LA 하이브리드는 장문맥 지속 학습에서 더 유리하고 SWA 하이브리드는 길이 외삽에서 더 잘 작동한다. 전체 요약 6문장 읽기 → 031 18:30 ▲ 106 · 댓글 2 선택적 정밀도로 선형 어텐션 상태 압축하는 STEPQuant Linear attention은 KV 캐시 대신 고정 크기의 재현 상태를 사용하지만, 이 상태들이 메모리 병목이 되고 있다. AI · 머신러닝 · STEPQuant: When and Where Errors Matter in Delta-Rule Recurrent State Quantization
Key Point 선형 어텐션 모델의 메모리 병목인 재현 상태 양자화에서 시간과 공간 차원의 오류 영향을 고려한 첫 접근으로, 실제 배포 환경에서 메모리 사용량을 획기적으로 줄일 수 있다.
핵심 요약
Linear attention은 KV 캐시 대신 고정 크기의 재현 상태를 사용하지만, 이 상태들이 메모리 병목이 되고 있다. 재현 상태를 저정밀도로 양자화하면 양자화 오류가 상태 업데이트 과정에서 누적되어 정확도가 크게 떨어진다. 연구진은 오류 영향이 두 가지 차원에 따라 달라짐을 발견했다: 시간적으로 오래된 메모리의 오류는 여러 디코딩 스텝에 걸쳐 지속되고, 공간적으로 서로 다른 키 행의 오류는 모델 출력에 미치는 영향이 다르며 상태 크기도 행과 열에 따라 변한다. 전체 요약 7문장 읽기 → 032 18:33 새 버전 Transformers 5.19.0, 멀티모달 임베딩과 분산학습 기능 강화 Gemma 2의 멀티모달 임베딩 모델 EmbeddingGemma2를 새로 추가했으며, 텍스트·이미지·오디오·비디오를 768차원 벡터 공간에 인코딩하고 512/256/128차원으로 축소 가능하다. AI · 머신러닝 · huggingface/transformers@v5.19.0
Key Point 멀티모달 모델 지원 확대와 분산학습 병렬화 개선으로 LLM 추론 효율이 향상되며, 주요 API 변경으로 기존 코드 마이그레이션이 필요해진다.
핵심 요약
Gemma 2의 멀티모달 임베딩 모델 EmbeddingGemma2를 새로 추가했으며, 텍스트·이미지·오디오·비디오를 768차원 벡터 공간에 인코딩하고 512/256/128차원으로 축소 가능하다. MoE(Mixture of Experts) 모델이 output_router_logits=True일 때 라우터 로짓을 반환하도록 변경되었으며, 기존 코드는 새 출력 클래스에서 로짓을 읽어야 한다. OWLv2 이미지 쿼리 선택 방식이 객체 신뢰도 점수 기준으로 변경되어 기존 기능과 결과가 달라질 수 있다. 전체 요약 7문장 읽기 → 033 18:35 ▲ 11 · 댓글 2 에이전트 간 통신 75% 압축, 캐시 공유 방식 제안 다중 에이전트 시스템에서 에이전트 간 KV 캐시를 직접 전송하는 방식이 텍스트 통신보다 정확도와 지연시간이 우수하지만, 전체 캐시 크기가 각 에이전트 처리 컨텍스트와 에이전트 수에 따라 선형으로 증가해 GPU 메모리와 컨텍스트 윈도우를 초과하는 문제가 발생한다. AI · 머신러닝 · Receiver-Conditioned Latent Communication gives 94% CacheBack
Key Point KV 캐시 직접 전송으로 다중 에이전트 시스템의 성능을 높이되, 메모리 증폭 문제를 receiver conditioning으로 대폭 해결할 수 있는 실용적 방법을 제시한다.
핵심 요약
다중 에이전트 시스템에서 에이전트 간 KV 캐시를 직접 전송하는 방식이 텍스트 통신보다 정확도와 지연시간이 우수하지만, 전체 캐시 크기가 각 에이전트 처리 컨텍스트와 에이전트 수에 따라 선형으로 증가해 GPU 메모리와 컨텍스트 윈도우를 초과하는 문제가 발생한다. Receiver-Conditioned Latent Communication이라는 아이디어는 수신 에이전트가 자신의 정보 필요사항을 기술해 송신 에이전트에게 전달하면, 송신 에이전트가 이를 바탕으로 KV 캐시를 필터링·압축해서 보내는 방식이다. CacheBack은 송신 에이전트의 어텐션 가중치를 기반으로 receiver conditioning을 구현한 훈련 없는 방식이다. 전체 요약 5문장 읽기 → 034 09:11 ▲ 13 · 댓글 2 비디오 생성 AI의 메모리 병목 풀다, 시간일관성 있는 2비트 양자화 비디오 월드 모델은 생성 과정에서 KV 캐시를 저장해 장시간 시간적 일관성을 유지하지만, 늘어나는 캐시가 배포의 주요 병목이 되어 저비트 양자화 연구가 필요한 상황이다. AI · 머신러닝 · QuantWM: Temporally Consistent 2-Bit KV Cache Quantization for Video World Models
Key Point 비디오 생성 모델의 메모리 병목을 풀 수 있는 새로운 양자화 방식이 제시됐으며, 기존 방법과 다른 각도로 주의 집중 메커니즘을 보존하는 전략이 핵심이다.
핵심 요약
비디오 월드 모델은 생성 과정에서 KV 캐시를 저장해 장시간 시간적 일관성을 유지하지만, 늘어나는 캐시가 배포의 주요 병목이 되어 저비트 양자화 연구가 필요한 상황이다. 기존 2비트 KV 캐시 양자화 방식들은 VBench에서 거의 무손실 성능을 보이지만, 비디오 월드 모델에 적용하면 시간적 깜빡임과 시각적 품질 저하가 심각하게 발생한다. Key 양자화가 Value보다 재구성 오류는 작지만 예상과 달리 출력 품질 저하를 더 크게 야기한다는 점을 발견했고, 이는 Key 섭동이 주의 집중(attention) 로짓을 변화시켜 쿼리가 선택하는 시간-공간 토큰을 이동시키기 때문이다. 전체 요약 7문장 읽기 → 035 09:11 ▲ 12 · 댓글 2 고해상도 이미지 처리 위한 효율적인 토큰 순환 모델 GTR Self-attention 기반 비전 백본은 밀집 예측에서 우수하나 전역 소프트맥스 어텐션의 이차 계산 비용이 이미지 해상도 증가에 따라 효율성을 제한한다. AI · 머신러닝 · GTR: Gated Token Recurrence for Efficient Dense Prediction
Key Point 이차 복잡도로 인한 고해상도 이미지 처리의 계산 병목을 해결하는 새로운 아키텍처로, 4배 빠른 처리 속도와 엣지 장비 배포 가능성을 제시한다.
핵심 요약
Self-attention 기반 비전 백본은 밀집 예측에서 우수하나 전역 소프트맥스 어텐션의 이차 계산 비용이 이미지 해상도 증가에 따라 효율성을 제한한다. GTR(Gated Token Recurrence)은 소프트맥스 없는 순환 비전 백본으로 게이팅 선형 어텐션, 교대 공간 스캔 방향, 공간 강화된 SwiGLU 블록을 결합했다. GTR은 최종 레이어 패치-토큰 정렬로만 증류되며 마스킹된 토큰 예측이나 중간 레이어 감독은 사용하지 않는다. 전체 요약 8문장 읽기 → 036 06:11 ▲ 26 · 댓글 2 3차원 텐서 상태로 장문맥 처리하는 선형 어텐션 RNN의 선형 어텐션은 고정 크기 메모리 상태로 장문맥을 압축해 일정한 시간에 추론하는데, 메모리 상태 크기가 성능을 좌우한다. AI · 머신러닝 · Triadic Linear Attention: Three-Dimensional Recurrent States for Long-Context Sequence Modeling
Key Point 선형 어텐션의 메모리 효율성을 유지하면서 상태 차원을 3차원으로 확장하는 기술적 혁신으로, 장문맥 시퀀스 모델링에서 성능과 효율성의 균형을 새로 정의한다.
핵심 요약
RNN의 선형 어텐션은 고정 크기 메모리 상태로 장문맥을 압축해 일정한 시간에 추론하는데, 메모리 상태 크기가 성능을 좌우한다. 기존 선형 어텐션은 키·벨류 벡터의 외적으로 행렬 크기 상태를 만들었으나, 새로운 방법은 키·두 번째 키·벨류의 3중 외적으로 3차원 텐서 상태를 작성한다. 두 개의 쿼리로 텐서의 두 키 축을 수축(contraction)해 읽어내며, E차원의 두 번째 키로 상태 크기를 E배 늘리면서 파라미터 프로젝션은 단 2개만 추가한다. 전체 요약 5문장 읽기 → 037 21:11 당일 +244 GPU·CPU 커널 개발을 단순하게, TileLang DSL 오픈소스 TileLang은 Python 문법을 기반한 도메인 특화 언어(DSL)로, GPU·CPU·NPU 등 다양한 가속기용 고성능 커널 개발을 간소화한다. 인프라 · 데브옵스 · tile-ai/tilelang · Python
Key Point 저수준 최적화 전문 지식 없이 Python 수준에서 GPU·CPU 커널을 작성·배포할 수 있어 AI 인프라 개발의 진입장벽을 크게 낮춘다.
핵심 요약
TileLang은 Python 문법을 기반한 도메인 특화 언어(DSL)로, GPU·CPU·NPU 등 다양한 가속기용 고성능 커널 개발을 간소화한다. TVM 컴파일러 인프라 위에 구축되어 있으며, GEMM·FlashAttention·양자화 연산 등 복잡한 연산의 저수준 최적화를 자동으로 처리한다. NVIDIA CUDA(SM70~SM120), AMD ROCm/HIP(CDNA/RDNA), Apple Metal, Huawei Ascend 950 NPU, LLVM CPU, 그리고 WebGPU 등 다양한 백엔드를 지원한다. 전체 요약 8문장 읽기 → 038 21:11 당일 +128 다양한 골격에 애니메이션을 주는 통합 모델 UniMate 공개 SIGGRAPH Asia 2026에 채택된 UniMate는 이족·사족·조류·해양·곤충·뱀 형태 및 경직된 물체 등 다양한 골격 구조를 하나의 모델으로 애니메이션하는 기술이다. AI · 머신러닝 · Friedrich-M/UniMate · Python
Key Point 텍스트 기반 3D 애니메이션 생성의 일반화 문제를 단일 모델로 해결한 첫 사례이며, 영상 제작·게임 개발·디지털 캐릭터 제작 분야의 자동화를 크게 앞당길 기술이기 때문이다.
핵심 요약
SIGGRAPH Asia 2026에 채택된 UniMate는 이족·사족·조류·해양·곤충·뱀 형태 및 경직된 물체 등 다양한 골격 구조를 하나의 모델으로 애니메이션하는 기술이다. UniML3D라는 13,006개 텍스트 쌍 모션 시퀀스 데이터셋을 구축했으며, Mixamo, Objaverse-XL, Truebones ZOO에서 수집한 자산을 통일된 형식으로 정규화했다. 텍스트 프롬프트와 3D 리깅된 자산만으로 실시간 모션 생성이 가능하며, 스켈레톤별 재학습이나 테스트 시점 최적화가 필요 없다. 전체 요약 9문장 읽기 → 039 03:11 새 버전 Transformers 5.18.0 출시, Nemotron·NemotronH Omni 등 신모델 추가 Nemotron 3 Diarization 오픈웨이트 모델이 추가되어 실시간 음성 화자 분리를 지원하며, 최대 8명의 화자를 처리할 수 있고 80ms부터 30.4s까지 구성 가능한 지연 시간 프로필을 제공한다. AI · 머신러닝 · huggingface/transformers@v5.18.0
Key Point Transformers는 파이토치의 표준 NLP 라이브러리이며, 이 버전은 실시간 음성 처리, 멀티모달 추론, 분산 학습 최적화 등 프로덕션 환경의 여러 문제를 해결한다.
핵심 요약
Nemotron 3 Diarization 오픈웨이트 모델이 추가되어 실시간 음성 화자 분리를 지원하며, 최대 8명의 화자를 처리할 수 있고 80ms부터 30.4s까지 구성 가능한 지연 시간 프로필을 제공한다. NemotronH Omni 멀티모달 추론 모델은 Mamba-Transformer 언어 모델에 RADIO 비전 인코더와 Parakeet 사운드 인코더를 결합하여 텍스트, 이미지, 비디오, 음성을 동시에 처리한다. HyperCLOVAX Vision V2는 NAVER가 개발한 멀티모달 모델로 Qwen2.5-VL 비전 인코더를 탑재하고 체인오브싱크 추론을 위한 thinking 토큰을 지원한다. 전체 요약 8문장 읽기 → 040 15:11 ▲ 20 · 댓글 1 영상 세계 모델의 긴 문맥 처리, 효율적 어텐션으로 해결 텍스트 조건부 대화형 비디오 세계 모델은 텍스트 지시에 따라 시간적으로 일관된 환경을 시뮬레이션한다. AI · 머신러닝 · WorldAttention: An Efficient Attention Architecture for Interactive Video World Models
Key Point 대화형 비디오 생성에서 긴 문맥을 유지하면서 계산 효율을 동시에 확보하려는 세계 모델 연구의 핵심 기술 개선이다.
핵심 요약
텍스트 조건부 대화형 비디오 세계 모델은 텍스트 지시에 따라 시간적으로 일관된 환경을 시뮬레이션한다. 기존 프레임워크는 슬라이딩 윈도우로 계산 복잡도를 제한하면서도 과거 문맥을 잃어 장기 상호작용 능력이 떨어진다. 전체 히스토리 캐시는 어텐션의 이차 복잡도와 KV 캐시의 선형 증가로 인해 계산 및 메모리 과부하가 심하다. 전체 요약 7문장 읽기 → 041 21:11 ▲ 15 · 댓글 1 비디오 세계 모델에 실시간 편집 기능 추가한 EditWorld EditWorld는 생성형 가상 세계에서 precise editing과 유연한 참조 이미지 활용을 지원하는 비디오 world model이다. AI · 머신러닝 · Precise Editing and Flexible Referencing for Interactable Worlds
Key Point video world model이 탐색에서 한 단계 나아가 사용자가 생성된 세계를 직접 편집하고 조작할 수 있는 수준에 도달했으며, 실시간 스트리밍 방식의 편집 지원이 새로운 접근 방식을 제시한다.
핵심 요약
EditWorld는 생성형 가상 세계에서 precise editing과 유연한 참조 이미지 활용을 지원하는 비디오 world model이다. 기존 video world model은 주로 탐색에만 초점을 맞췄으나, EditWorld는 생성 과정 중 편집 지시사항과 참조 이미지를 스트리밍 방식으로 받아 기존 콘텐츠의 정확한 수정을 가능하게 한다. 시간에 따라 변하는 편집 조건과 참조 이미지를 처리하기 위해 Gated Causal Attention 메커니즘을 도입했고, 장시간 추론 시 컨텍스트 크기를 제한하는 Sparse Context 메커니즘을 함께 적용했다. 전체 요약 6문장 읽기 → 042 21:11 ▲ 59 · 댓글 1 CoWindow: 주의 메커니즘의 중복 계산을 줄인 구조화된 어텐션 기존 Full Attention 방식은 모든 어텐션 헤드가 전체 인과 히스토리를 반복 처리하면서 중복 계산과 메모리 오버헤드가 발생한다. AI · 머신러닝 · CoWindow Attention: Full Causal Coverage Is a Collective Property
Key Point 효율적인 장문맥 처리가 필수인 생성형 AI에서 Full Attention의 중복 계산을 제거하면서도 성능을 유지하는 방법이 제시되었으므로, 스케일링 효율성을 개선하려는 팀들의 관심을 받을 만합니다.
핵심 요약
기존 Full Attention 방식은 모든 어텐션 헤드가 전체 인과 히스토리를 반복 처리하면서 중복 계산과 메모리 오버헤드가 발생한다. 연구팀이 제안한 CoWindow Attention(CoWA)은 KV 헤드 간에 인과 히스토리 접근을 분산시키는 구조화된 어텐션이다. 모든 헤드는 근거리 대각 윈도우와 접두사-싱크 윈도우를 공유하며, 나머지 먼 과거는 보완적 장거리 윈도우로 분할되어 전체 인과 커버리지를 달성한다. 전체 요약 10문장 읽기 → 043 18:11 ▲ 64 · 댓글 1 어텐션의 계산 효율을 높이는 MALA 메커니즘 제안 기존 Full Attention은 QK 타일 계산 후 전체 후속 경로를 실행하지만 정규화 가중치에서 대부분의 값이 무시할 수준으로 작아 비효율적이다. AI · 머신러닝 · MassAlloc Attention: Let Attention Allocate Its Own Compute
Key Point Full Attention의 비효율적 계산 패턴을 식별하고 실제 기여도 기반 할당으로 2~3배 속도 향상을 달성하면서도 모델 성능을 유지하는 방법으로, 대규모 언어 모델의 추론·학습 효율을 개선하는 데 직결된다.
핵심 요약
기존 Full Attention은 QK 타일 계산 후 전체 후속 경로를 실행하지만 정규화 가중치에서 대부분의 값이 무시할 수준으로 작아 비효율적이다. MALA(MassAlloc Attention)는 정규화된 기여도에 따라 후속 계산을 선택적으로 할당하는 퓨즈드 어텐션 프리미티브로, 순전파는 온라인 소프트맥스 정규화기를, 역전파는 최종 정규화기를 재사용한다. 하나의 공통 임계값으로 학습과 추론에서 적응적 유지(retention)가 가능하며, 8K 토큰 비교에서 생략된 질량은 0.0188%로 기준 오라클의 0.0182%에 근접한다. 전체 요약 7문장 읽기 → 044 15:11 ▲ 20 · 댓글 2 장문맥 처리의 병목 풀다…로그 선형 복잡도 블록 스파스 어텐션 언어모델을 긴 문맥에 맞추려면 셀프 어텐션의 이차 비용이 제약이 된다. AI · 머신러닝 · Block Sparse Attention with Log-Linear Complexity
Key Point 장문맥 처리가 핵심인 LLM 개발에서 어텐션 계산량을 획기적으로 줄이는 알고리즘이 나왔기 때문에, 모델 확장성과 추론 속도에 영향을 받는 엔지니어와 연구자들이 눈여겨봐야 한다.
핵심 요약
언어모델을 긴 문맥에 맞추려면 셀프 어텐션의 이차 비용이 제약이 된다. 블록 스파스 어텐션은 효율적 대안이지만, 유지할 블록을 선택하는 과정이 여전히 이차 복잡도다. 논문은 PISA라는 피라미드 Top-K 선택 전략을 제안해 후보를 단계적으로 좁혀나간다. 전체 요약 7문장 읽기 → 045 22:45 당일 +166 C++로 만든 이미지 생성 엔진, Flux·Qwen 등 최신 모델까지 지원 stable-diffusion.cpp는 GGML 기반의 순수 C/C++ 구현으로 Stable Diffusion, Flux, Wan, Qwen Image 등 다양한 이미지·영상 생성 모델을 추론할 수 있는 경량 프레임워크다. AI · 머신러닝 · leejet/stable-diffusion.cpp · C++
Key Point 로컬 머신에서 최신 이미지·영상 생성 모델을 실행할 수 있는 경량 C++ 구현이 빠르게 성장하고 있으며, 모델 추가 속도가 빠르므로 개인 또는 온프레미스 AI 구축을 고려하는 개발자에게 선택지가 되고 있다.
핵심 요약
stable-diffusion.cpp는 GGML 기반의 순수 C/C++ 구현으로 Stable Diffusion, Flux, Wan, Qwen Image 등 다양한 이미지·영상 생성 모델을 추론할 수 있는 경량 프레임워크다. 외부 의존성이 없으며, 모델 무게 형식으로 PyTorch 체크포인트(.ckpt, .pth, .pt), Safetensors, GGUF를 지원하고 가중치를 .gguf나 .safetensors로 변환할 수 있다. CPU(AVX, AVX2, AVX512), CUDA, Vulkan, Metal, OpenCL, SYCL 백엔드를 지원하며 Linux, macOS, Windows, Android(Termux)에서 실행된다. 전체 요약 7문장 읽기 → 046 15:11 ▲ 25 · 댓글 2 비디오 확산 모델이 물리법칙을 위반하는 이유 텍스트-투-비디오 확산 모델이 우수한 화질에도 불구하고 현실 물리법칙을 위반하는 영상을 생성한다. AI · 머신러닝 · Why Do Video Diffusion Models Violate Physics? Unveiling the Flaws in Attention Mechanisms
Key Point 비디오 생성 AI의 핵심 약점인 물리법칙 위반을 어텐션 메커니즘 수준에서 진단하고, 모델 재설계 없이 적용 가능한 경량 해법을 제시한다.
핵심 요약
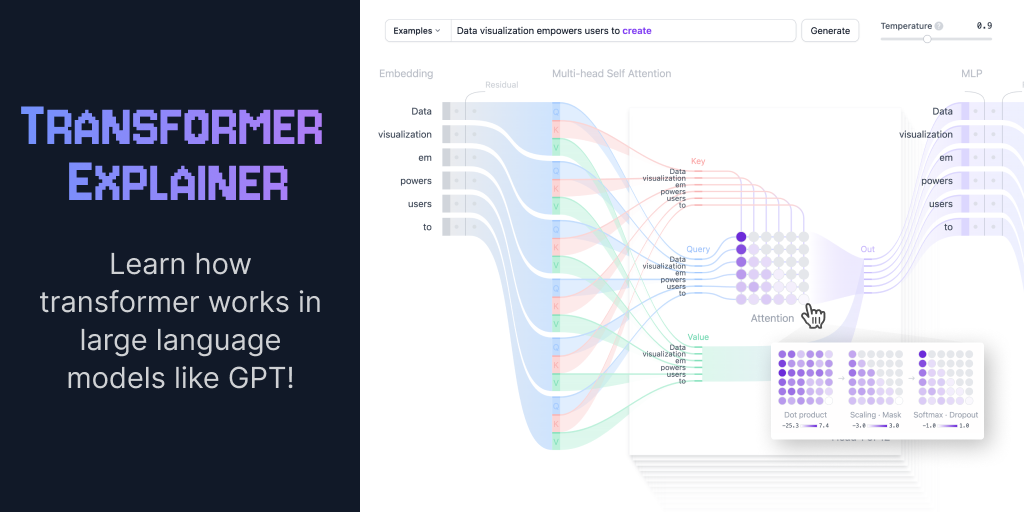
텍스트-투-비디오 확산 모델이 우수한 화질에도 불구하고 현실 물리법칙을 위반하는 영상을 생성한다. 연구팀이 모션 계획 과정을 분석해 초기 노이징 제거 단계에서 동작 궤적이 형성되는 방식을 규명했다. Rotary Position Embedding(RoPE)이 과도한 공간 주의 감소를 야기해 초기 후보 영역이 물리적으로 불가능한 위치에 조기 고정되는 것을 발견했다. 전체 요약 5문장 읽기 → 047 09:10 ▲ 158 · 댓글 27 Transformer 구조를 시각적으로 배우는 인터랙티브 가이드 Transformer는 2017년 '어텐션이 전부(Attention is All You Need)' 논문 이후 GPT, Llama, Gemini 등 생성형 AI의 핵심 구조가 되었으며, 텍스트뿐 아니라 음성·이미지·단백질 구조 예측까지 다양한 분야에 적용되고 있다. AI · 머신러닝 · Transformers Explained Visually
Key Point Transformer의 내부 동작을 상세히 이해해야 생성형 AI 모델의 원리와 한계를 제대로 파악할 수 있고, 이는 AI 제품 개발이나 프롬프트 엔지니어링의 효율을 높이는 데 필수적이다.
핵심 요약
Transformer는 2017년 '어텐션이 전부(Attention is All You Need)' 논문 이후 GPT, Llama, Gemini 등 생성형 AI의 핵심 구조가 되었으며, 텍스트뿐 아니라 음성·이미지·단백질 구조 예측까지 다양한 분야에 적용되고 있다. Transformer 모델은 '다음 토큰 예측' 원리로 작동하며, 자기주의(self-attention) 메커니즘을 통해 입력 전체 시퀀스를 처리해 긴 거리의 의존성을 기존 구조보다 효과적으로 포착한다. 임베딩 단계에서 입력 텍스트는 토큰화·토큰 벡터화·위치 정보 추가를 거쳐 수치로 변환되는데, GPT-2(소형)는 50,257개 어휘를 768차원 벡터로 표현한다. 전체 요약 6문장 읽기 → 048 03:10 ▲ 256 · 댓글 67 우리의 주의력을 빼앗는 알고리즘, 의도적 인터넷으로 돌아가자 Tetris 효과처럼 오랫동안 집중하는 것이 우리의 생각을 형성하지만, 현재 우리의 주의력 대부분은 기업 알고리즘이 결정한다. 웹 · 프론트엔드 · Attention is all you have
Key Point 알고리즘 추천이 일상의 대부분을 점령한 시대에, 의도적으로 정보를 선택하는 습관을 어떻게 되찾을 수 있는지 보여준다.
핵심 요약
Tetris 효과처럼 오랫동안 집중하는 것이 우리의 생각을 형성하지만, 현재 우리의 주의력 대부분은 기업 알고리즘이 결정한다. YouTube, Spotify, LinkedIn 등 주요 플랫폼은 추천 알고리즘으로 광고 클릭을 늘리기 위해 우리가 원하지 않는 콘텐츠를 노출시킨다. Reddit 같은 커뮤니티도 LLM 봇과 트롤이 가득해 신뢰할 수 없게 됐다. 전체 요약 6문장 읽기 → 049 21:10 당일 +141 처음부터 LLM 훈련하기, 모든 코드를 PyTorch로 직접 작성 Attention is All You Need 논문을 기반으로 PyTorch에서 트랜스포머 모델을 처음부터 구현한 튜토리얼 저장소. AI · 머신러닝 · FareedKhan-dev/train-llm-from-scratch · Python
Key Point LLM 개발의 모든 단계를 직접 이해하고 구현하려는 개발자와 연구자에게 명확한 참고 자료가 되어준다.
핵심 요약
Attention is All You Need 논문을 기반으로 PyTorch에서 트랜스포머 모델을 처음부터 구현한 튜토리얼 저장소. 단일 GPU로 수백만~수십억 개 파라미터 규모의 LLM을 훈련할 수 있으며, 데이터 전처리부터 텍스트 생성까지 전체 과정을 다룬다. trl, peft, transformers 같은 외부 라이브러리 없이 모든 알고리즘을 순수 PyTorch로 구현했다. 전체 요약 5문장 읽기 → 050 06:10 ▲ 122 · 댓글 63 캑터스 니들 3: 8~29MB 경량 모델이 DeepSeek V4 Flash 수준 성능 8~29MB 크기의 경량 자동화 모델 캑터스 니들 3을 공개했습니다. AI · 머신러닝 · Show HN: Cactus Needle 3: 8-29MB automation models can match DeepSeek V4 Flash
Key Point 에지 기기 AI의 핵심 병목이던 모델 크기와 성능의 트레이드오프를 근본적으로 바꾸는 아키텍처로, 온디바이스 AI 구현이 현실화될 수 있음을 보여줍니다.
핵심 요약
8~29MB 크기의 경량 자동화 모델 캑터스 니들 3을 공개했습니다. Laddered Simple Attention Networks 아키텍처로 같은 크기 트랜스포머 대비 토큰당 2배 적은 연산을 사용합니다. 4계층 모델을 파인튜닝하면 DeepSeek V4 Flash와 같은 성능을 내며, 라즈베리파이5에서 초당 400~4000토큰을 처리합니다. 전체 요약 6문장 읽기 → 051 16:56 ▲ 114 · 댓글 8 DeepSeek, KV 캐시 압축으로 추론 속도 420 토큰/초 달성 DeepSeek-v4.1 Flash는 552B 매개변수 멀티모달 모델로, 에이전트 워크플로우에서 증가하는 컨텍스트와 도구 호출로 인한 프리필 계산 부담을 해결하기 위해 설계됐다. AI · 머신러닝 · DeepSeek-v4.1 Flash: Pushing the Limits of KV Cache Compression
Key Point 에이전트 워크플로우에서 일반적인 병목인 장문맥 프리필 계산과 KV 캐시 저장 비용을 획기적으로 줄인 새로운 모델 아키텍처 설계가 장기 맥락 처리와 배포 비용 절감에 어떻게 영향을 미치는지 보여준다.
핵심 요약
DeepSeek-v4.1 Flash는 552B 매개변수 멀티모달 모델로, 에이전트 워크플로우에서 증가하는 컨텍스트와 도구 호출로 인한 프리필 계산 부담을 해결하기 위해 설계됐다. KV 캐시 압축을 위해 채널·시퀀스·레이어 세 차원에서 최적화를 진행했으며, 같은 시퀀스 길이에서 런타임 KV 캐시는 v4-Flash의 1/4, 영구 저장소는 1/8 수준으로 줄었다. Causal Encoder-Decoder(CED) 아키텍처를 도입해 프리필 단계에서 8B, 디코딩 단계에서 16B 매개변수만 활성화되도록 설계했으며, 이는 입력 중심의 에이전트 시나리오에 특히 효율적이다. 전체 요약 12문장 읽기 → 052 08:12 ▲ 131 · 댓글 22 트랜스포머 모델의 어텐션 메커니즘을 시각화하다 트랜스포머 기반 LLM이 다음 토큰을 생성할 때 과거 토큰들로부터 얼마나 정보를 가져오는지 보여주는 인터랙티브 시각화 도구를 만들었다. AI · 머신러닝 · Show HN: LLM Attention Visualization
Key Point LLM이 토큰을 생성할 때 어떤 과거 정보를 참고하는지 처음으로 직관적으로 볼 수 있어, 언어 모델의 동작 원리를 이해하는 데 도움이 된다.
핵심 요약
트랜스포머 기반 LLM이 다음 토큰을 생성할 때 과거 토큰들로부터 얼마나 정보를 가져오는지 보여주는 인터랙티브 시각화 도구를 만들었다. 생성된 각 토큰을 클릭하면 영향을 미친 이전 토큰들이 투명도로 표시되며, 모든 어텐션 헤드와 레이어의 가중치를 집계하고 값 벡터 크기로 조정한 결과다. 예제에서 주소와 날짜처럼 그대로 복사되는 텍스트는 원본 데이터에서 높은 어텐션을 받으며, 작은 모델도 전체 함수 코드를 정확히 재현할 수 있는 이유를 보여준다. 전체 요약 5문장 읽기 →