매일 쌓이는 개발자의 시야
2026년 11월 20일 (금). 세상의 기술 소식, 한국어로 한눈에.
AI 요약 안내 AI가 한국어로 정리한 내용입니다. 정확한 정보는 각 카드의 원문을 확인해 주세요.
요약 원칙 ↗ 01 읽을 소식Hacker News 13건 ↓ 02 써볼 도구GitHub Trending 2건 ↓ 03 읽을 논문Hugging Face Papers 23건 ↓ 04 새 버전GitHub Releases 3건 ↓ AI · 머신러닝 분야 · 41건 필터 해제 ×
오늘의 주요포인트 상위 6건
01 AI · 머신러닝 06:11 게시
원제 Claude solves two open problems in the physics of black holes
264 포인트 댓글 103
Key Point 양자중력 통합은 현대 물리학의 최대 난제인데, Claude가 20년 묵힌 계산을 완성하고 새로운 수학적 한계를 증명함으로써 이론 개발에 구체적 진전을 만들었다.
핵심 요약
Claude가 이론물리학의 미해결 문제 두 가지를 풀었는데, 모두 블랙홀과 양자중력 이론 개발과 관련된 것이다. 첫 번째 문제는 1983년 호킹-페이지가 세운 계산인데, 20년 이상 풀리지 않은 채 남아 있었다. Claude는 자기 복사본들로 구성된 소규모 연구팀을 운영해 계산의 거의 모든 부분을 독립적으로 수행하고 검증했다. 호킹-페이지 상전이는 열을 받은 이론 우주에서 입자 가스에서 블랙홀로의 급격한 전환을 설명한다. Claude의 결과는 시공간이 명확한 형태를 잃는 약한 결합 영역에서도 이 급격한 전환이 유지됨을 보였다. 전체 요약 14문장 읽기 → 02 AI · 머신러닝 21:11 게시
원제 "I can tell you wrote this yourself"
229 포인트 댓글 236
Key Point 교육 현장에서 AI 의존도가 높아지면서 독립적 사고와 기본 지식 습득 능력이 위협받는 현실을 개인의 경험으로 생생하게 보여준다.
핵심 요약
대학원 과제 보고서를 직접 작성한 학생이 지도교수로부터 '당신이 직접 쓴 것 같다'는 말을 들었다. 교수는 AI로 작성한 보고서를 많이 받고 있다며 충격을 드러냈다. 학생의 공학 학위 과정에서는 처음부터 AI 활용을 권장하다가 나중엔 필수처럼 여겨져, AI를 쓰지 않으면 불리하게 된다. 전체 요약 8문장 읽기 → 03 AI · 머신러닝 12:10 게시
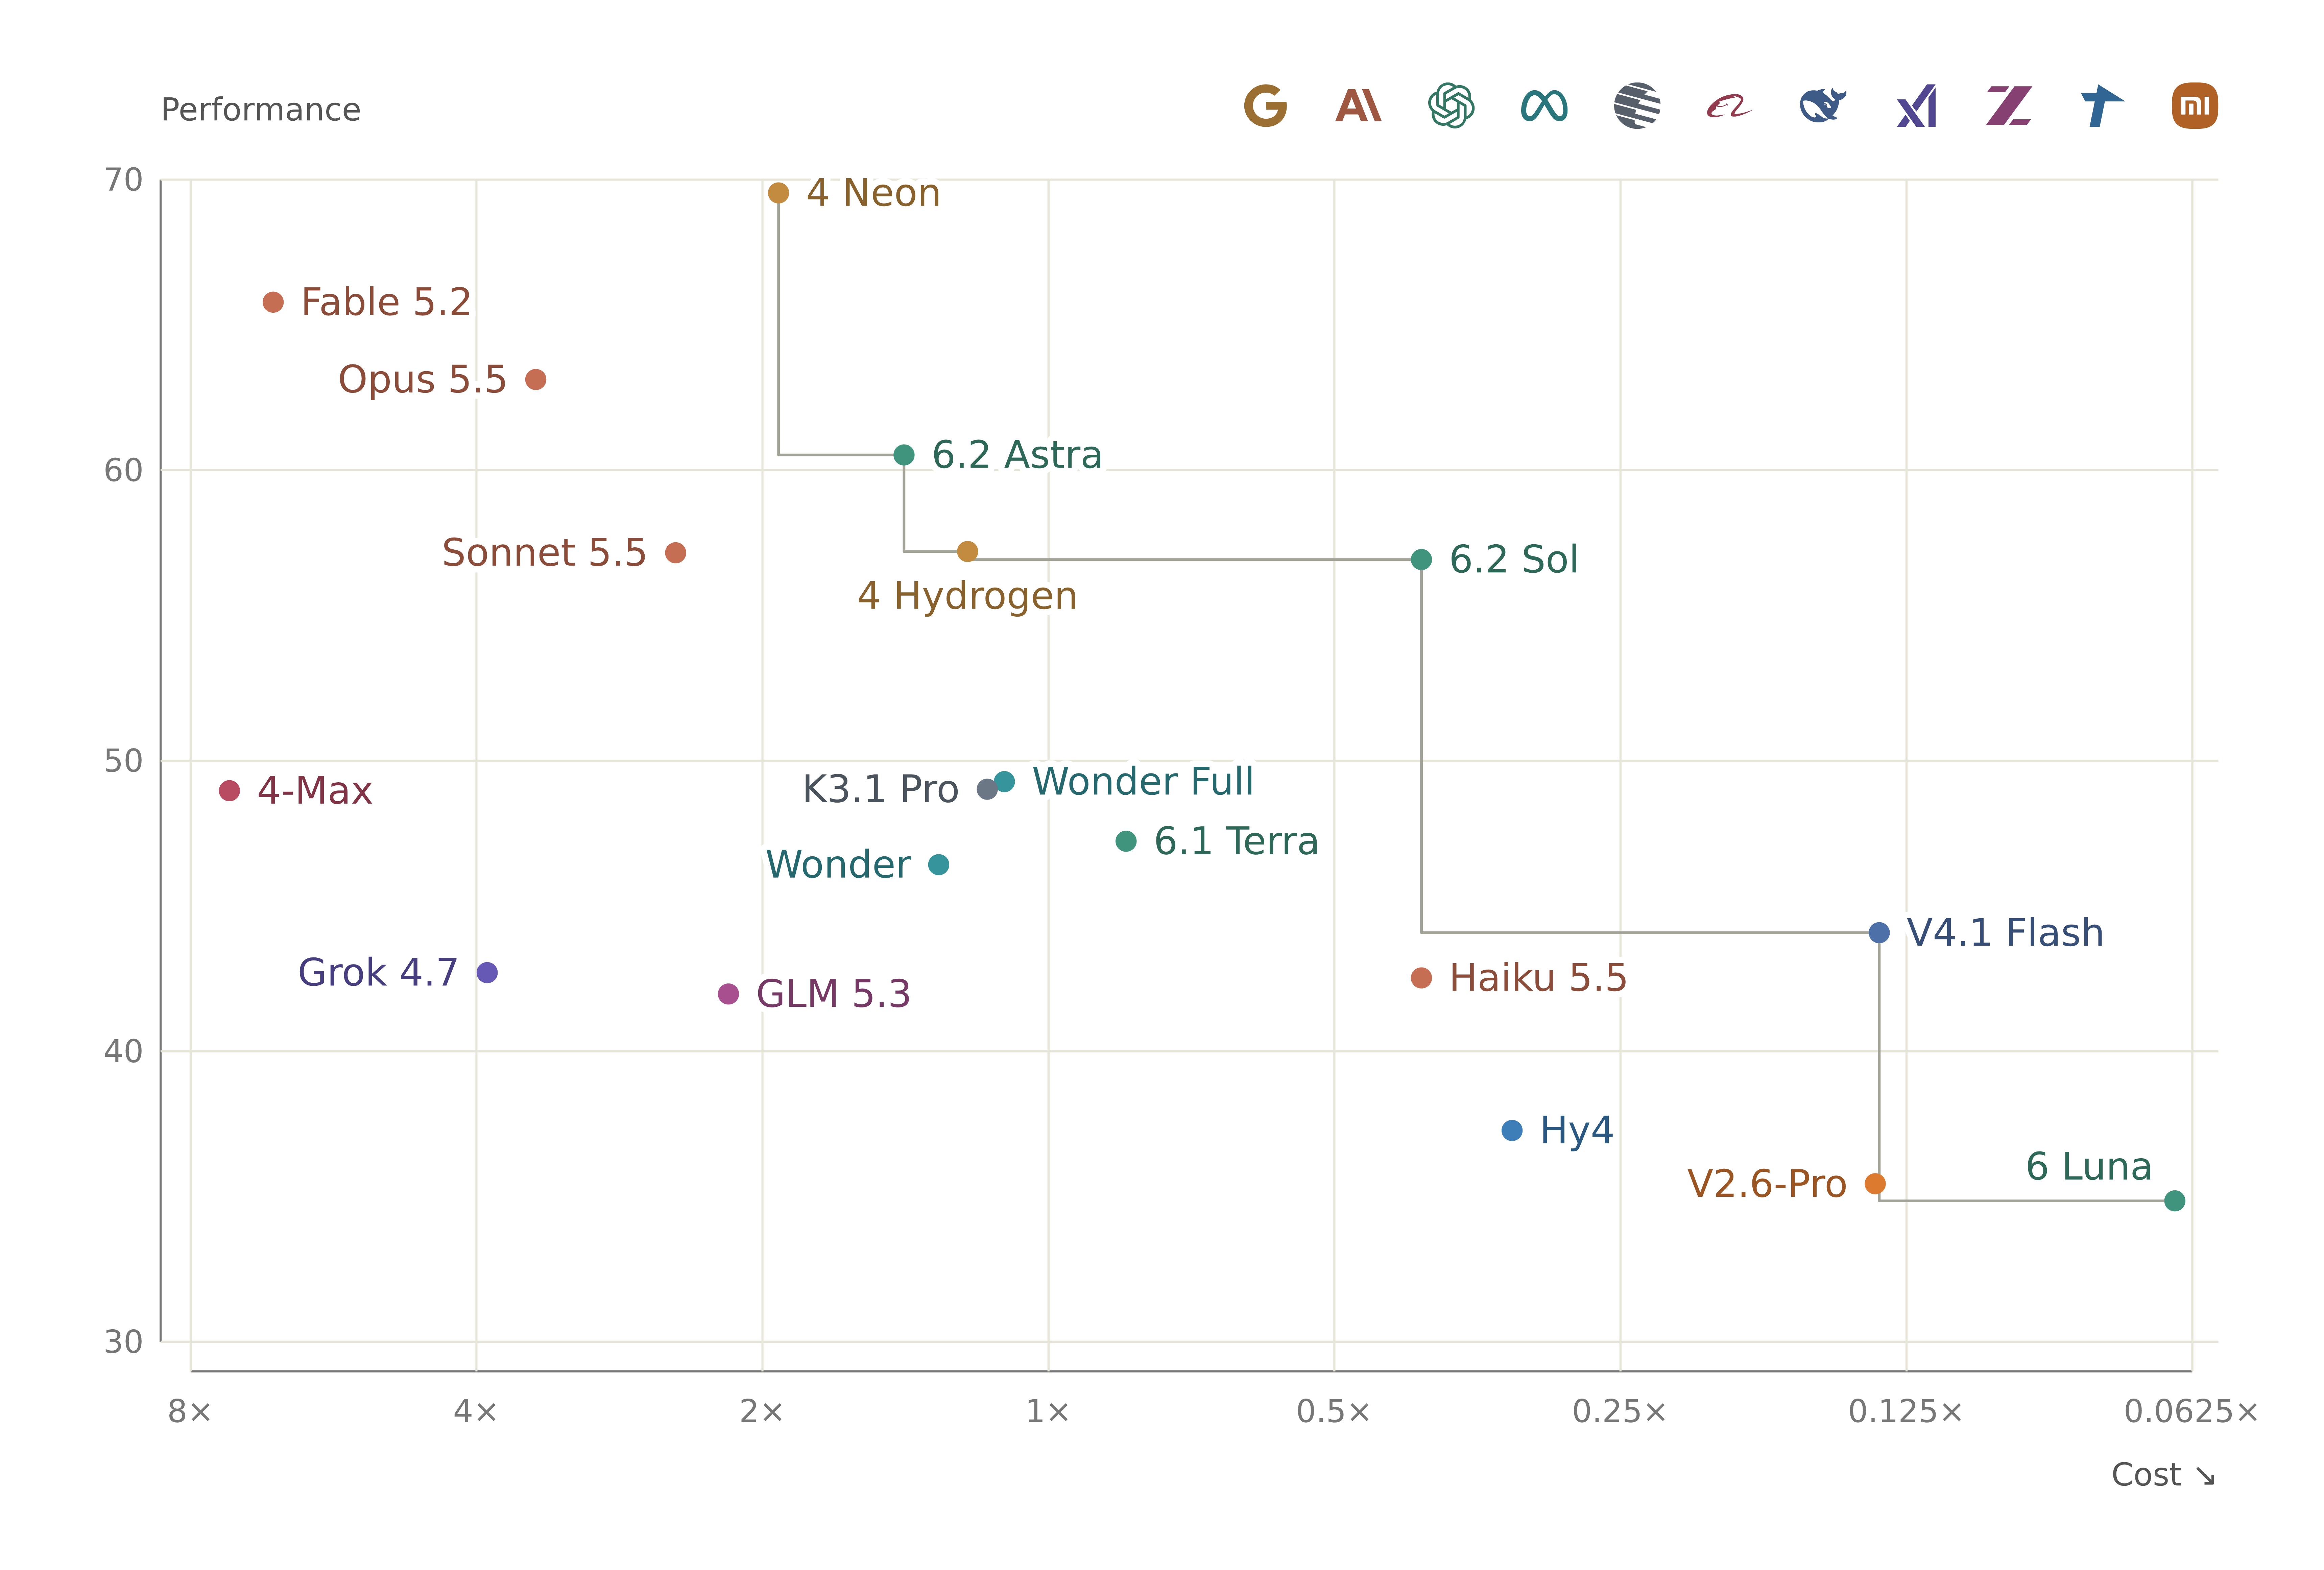
원제 Gemini 4 Neon is the new #1 on the Models Engineering Index
185 포인트 댓글 108
Key Point 생성형 AI 모델 선택 시 성능뿐 아니라 운영 비용의 효율성이 점점 중요해지고 있으며, 최신 순위는 각 모델 간 비용-성능 트레이드오프를 비교하는 데 필요하다.
핵심 요약
구글의 Gemini 4 Neon이 Models Engineering Index의 성능 대비 비용 효율 순위에서 1위를 차지했으며, 인덱스 점수는 68.0이다. 상위 모델들은 Anthropic의 Claude Fable 5.2(점수 65.3), OpenAI의 GPT-4 Astra(점수 61.5), 구글 Gemini 4 Carbon(점수 61.4) 등이 뒤를 이었다. Models Engineering Index는 LLM 모델들을 성능 점수와 비용, 토큰 수를 기준으로 순위를 매기는 평가 지표이다. 04 AI · 머신러닝 03:11 게시
원제 Pete warden on local AI, open models, voice interfaces, the future of hardware
131 포인트 댓글 110
Key Point 로컬 AI 기술의 현재 성숙도, 하드웨어 요구사항, 그리고 음성 인터페이스의 실질적인 개선 방안을 엔지니어 관점에서 정리하고 있으며, 엔드투엔드 모델과 화합물 AI 간 기술적 선택이 비즈니스 인센티브와 연결되어 있다는 점을 지적한다.
핵심 요약
딥러닝 엔지니어 피트 워든이 로컬 AI가 클라우드보다 나은 선택지임을 주장한다. 올라마 같은 도구를 사용하면 사용자는 쉽게 로컬 모델을 구동할 수 있으며, 오픈 가중치 모델의 성능이 상용 모델과 비슷한 수준으로 발전했다. 9억 개 파라미터 모델은 양자화(Q4)를 통해 4GB 그래픽 메모리에서 구동 가능하며, 중급 노트북 대부분이 이 조건을 충족한다. 애플의 M5 스튜디오는 256GB 시스템 메모리로 수백억 파라미터 모델을 실행할 수 있다. 로컬 모델은 프라이버시, 자체 제어, 비용 절감 등의 이점이 있지만, 엔터프라이즈 사용자의 가장 큰 장벽은 모델 품질이 아니라 사용성이다. 사이버보안 전문가 같은 사람들은 상용 모델의 제한 사항으로 인해 로컬 모델을 선호한다. 전체 요약 11문장 읽기 → 05 AI · 머신러닝 06:11 게시
원제 Two stealth models just appeared on the leaderboard, both ahead of Fable 5.2
107 포인트 댓글 42
Key Point 실제 복잡한 디자인 작업으로 AI 모델을 평가하는 첫 벤치마크로, 프로 디자이너의 판단을 반영한 신뢰할 만한 순위가 등장했으며 미공개 모델들의 디자인 능력이 기존 주요 모델을 넘기 시작했다는 신호다.
핵심 요약
Contra Labs가 실제 클라이언트 프로젝트 기반의 'Frontier Design Benchmark'를 공개했다. 이 벤치마크는 Contra 마켓플레이스의 33개 실무 디자인 브리프를 68명의 프로 디자이너가 평가한 것으로, 맹검 투표로 모델을 비교한다. 총 4,311개의 맹검 투표가 이루어졌으며, 설계 품질을 측정하는 35개 차원의 루브릭 채점 시스템을 적용했다. 전체 요약 6문장 읽기 → 06 AI · 머신러닝 00:11 게시
원제 Black high school students sue after AI mistakes Doritos bag for gun
106 포인트 댓글 75
Key Point 교실 보안 시스템의 AI 오류가 무고한 학생들을 경찰에 체포시킨 사건으로, 공공 안전에 사용되는 미검증 AI의 위험성을 보여주며 한국 학교의 감시 시스템 도입 시에도 고려해야 할 쟁점입니다.
핵심 요약
2025년 10월 미국 메릴랜드주 볼티모어 카운티 고등학교에서 AI 총기 탐지 시스템 '옴니얼럿 건 디텍트(Omnilert Gun Detect)'가 학생의 과자봉지를 총으로 오인했다. 시스템이 90% 확률로 총기가 있다고 오경보를 울렸고, 학교 직원과 경찰이 이미지를 검토해 착오임을 확인했음에도 경보가 계속 울렸다. 학교와 경찰이 경보를 취소했으나 취소된 경보가 무장 경찰 출동을 계속 유발하는 프로토콜 결함이 있었다. 전체 요약 8문장 읽기 → 전체 색인7건 · 분야별
AI · 머신러닝7건 001 21:11 ▲ 101 · 댓글 27 슈퍼패미컴에서 ChatGPT를 돌렸다 Benj Edwards가 디자인하고 AI가 코딩한 ChatGPT for SNES는 슈퍼닌텐도용 채팅 프로그램이다. AI · 머신러닝 · ChatGPT for SNES
Key Point ChatGPT 같은 최신 AI 모델을 1990년대 게임기의 극한 하드웨어 제약 속에서 구현한 실험으로, 소형 언어 모델의 가능성과 한계를 보여준다.
핵심 요약
Benj Edwards가 디자인하고 AI가 코딩한 ChatGPT for SNES는 슈퍼닌텐도용 채팅 프로그램이다. 약 220만 개의 파라미터를 가진 소형 언어 모델이 카트리지의 Super FX 2 칩에서 실행되며 한 번에 한 단어씩 답변을 생성한다. 기본 버전은 모든 단어가 언어 모델에서 나오며 약 4MB를 로드하고, 추가 버전은 Simple English Wikipedia 15만 개 기사의 첫 문장으로 구성한 팩트북을 포함해 약 19MB를 로드한다. 전체 요약 9문장 읽기 → 002 21:11 ▲ 105 · 댓글 8 LLM이 1990년대 방식으로 신경망을 짠다 Weight-Space Programming은 LLM이 신경망의 가중치를 직접 읽고 쓰고 편집하는 기법으로, 저자가 Claude Fable 5.2로 MNIST 이미지 분류 문제에 테스트했다. AI · 머신러닝 · Weight-Space Programming builds neural networks like a 1990s researcher
Key Point LLM이 신경망을 짜는 방식이 실제로는 현대 딥러닝이 아닌 1990년대 전문 지식 엔지니어링 패턴을 따르고 있다는 점이 중요하다.
핵심 요약
Weight-Space Programming은 LLM이 신경망의 가중치를 직접 읽고 쓰고 편집하는 기법으로, 저자가 Claude Fable 5.2로 MNIST 이미지 분류 문제에 테스트했다. Claude는 5,994개 가중치를 모두 수동으로 설정해야 했고, 50단계에 걸쳐 선형 필터, 손그림 템플릿, 루프 감지기, 모서리 감지기 등 1990년대 고전 컴퓨터 비전 기법을 순차적으로 조합했다. 첫 단계에서 Sobel 필터 같은 획 방향 감지기를 만들고, 이후 각 기법을 개별적으로 단위 테스트한 뒤, 혼동행렬로 측정한 값을 기반으로 가중치를 설정하는 방식을 택했다. 전체 요약 7문장 읽기 → 003 09:11 ▲ 103 · 댓글 52 AI 개선 작업은 외주로, 임금 착취 패턴 반복 Scale AI 같은 플랫폼이 의사, 변호사, 박사를 고용해 AI 훈련 데이터 생성·검증 작업을 맡기고 있으며, 같은 작업을 미국 의사에겐 시간당 180달러, 필리핀 타갈로그어 작업자에겐 7.50달러로 차등 지급한다. AI · 머신러닝 · AI isn't replacing your job. It's turning it into low-paid gig work
Key Point AI 발전을 위한 데이터 작업이 급속도로 확대되면서 선진국 전문직까지 불안정한 플랫폼 수급 노동으로 전환되는 현상을 보여주고, 임금 착취와 일방적 계약 조건이 국가와 직종을 가리지 않는 구조적 문제임을 지적한다.
핵심 요약
Scale AI 같은 플랫폼이 의사, 변호사, 박사를 고용해 AI 훈련 데이터 생성·검증 작업을 맡기고 있으며, 같은 작업을 미국 의사에겐 시간당 180달러, 필리핀 타갈로그어 작업자에겐 7.50달러로 차등 지급한다. 베네수엘라 경제 위기로 일자리를 잃은 로헬리오 가족은 2020년 Hive와 Remotasks에서 이미지 라벨링으로 월 최고 20달러를 벌었으나, 플랫폼이 고급 작업을 없애고 임금을 삭감해 1주일에 5달러 최소 지급액에도 미치지 못하게 됐다. Remotasks는 베네수엘라 사업을 2021년 중단했다가 같은 해 케냐에서 사업을 시작했고, 2024년 3월 케냐·나이지리아·파키스탄에서 갑자기 철수했으며, Scale AI는 보안 강화를 이유로 들었으나 나중에 노동자들이 3주 사전 공지를 받지 못했다고 인정했다. 전체 요약 11문장 읽기 → 004 09:11 ▲ 102 · 댓글 84 책 전체를 읽고 조언하는 글쓰기 앱 풀스캡 Foolscap은 사용자가 집필하는 책 전체를 인식하고 분석하는 글쓰기 애플리케이션이다. AI · 머신러닝 · Show HN: Foolscap – a writing app that reads your book and never writes for you
Key Point 저자가 쓴 콘텐츠를 보호하면서 창작 과정에서 실질적인 도움을 받을 수 있는 새로운 방식의 글쓰기 도구로, AI 에이전트 글쓰기와 차별화된 접근이 개발자와 작가들에게 의미 있기 때문입니다.
핵심 요약
Foolscap은 사용자가 집필하는 책 전체를 인식하고 분석하는 글쓰기 애플리케이션이다. 사용자가 글을 쓰면서 텍스트 사이의 연결고리와 미해결된 부분들을 감지하고, 사용자 자신의 표현으로 그 위치를 보여준다. 이 앱은 사용자를 대신해 절대 글을 작성하지 않는다. 전체 요약 4문장 읽기 → 005 06:11 ▲ 101 · 댓글 155 AI 슈퍼인텔리전스, 엔지니어 관점에선 불가능할 수도 AI 연구자들이 자기 개선이 가능한 초지능(ASI) 개발을 추진 중이지만, 컴퓨터 과학 관점에서 이는 근본적 결함이 있다고 주장한다. AI · 머신러닝 · The AI Superintelligence Debate Has Serious Flaws
Key Point 초지능 개발 경쟁이 과학적 근거 없는 사변에 기반하며, 추구 과정 자체가 통제 불가능한 AI를 만들 수 있다는 점이 AI 정책과 개발 방향에 직접적 함의를 갖는다.
핵심 요약
AI 연구자들이 자기 개선이 가능한 초지능(ASI) 개발을 추진 중이지만, 컴퓨터 과학 관점에서 이는 근본적 결함이 있다고 주장한다. 첫째, 반복적 자기 개선(RSI) 개념은 1960년대부터의 사변적 아이디어일 뿐, AI 성능 향상에는 대규모 고품질 데이터가 필수인데 수학·코딩 외 영역은 데이터 부족으로 정체 중이다. 둘째, 대부분의 계산 문제는 알고리즘으로 풀 수 없으며, 풀린다 해도 천문학적 자원이 필요할 수 있다—단순히 계산 속도만 높인다고 지능이 비약적으로 증가하지는 않는다. 전체 요약 6문장 읽기 → 006 03:11 ▲ 103 · 댓글 74 딥마인드 직원들 "AI 무기·감시에 쓰면 안 된다" 단결 구글 딥마인드 직원들이 조합을 결성하고 AI 시스템의 사용을 제한하는 '적색선(red lines)'을 명확히 설정할 것을 요구했다. AI · 머신러닝 · DeepMind Employees Are Unionising
Key Point 구글 AI 연구진이 조직적으로 단결해 무기·감시 금지를 요구한 것으로, 기술 기업 내부의 윤리 저항이 강화되고 있음을 보여줍니다.
핵심 요약
구글 딥마인드 직원들이 조합을 결성하고 AI 시스템의 사용을 제한하는 '적색선(red lines)'을 명확히 설정할 것을 요구했다. 인권 침해 혐의가 있는 파트너와의 계약을 금지하되, 독립적인 제3자 평가로 기술이 침해를 돕지 않음을 공개적으로 확인해야 한다고 주장했다. 무기 개발, 감시 기술 활용, 국제법 위반 감시 등이 AI 원칙의 금지 대상이어야 하며, 이는 계약 조건에 명시되어야 한다고 명시했다. 전체 요약 7문장 읽기 → 007 00:11 ▲ 104 · 댓글 65 AI는 혁명이지만, 대부분의 투자자는 돈을 못 번다 기술 혁신이 사회를 완전히 바꿔도 모두에게 부를 가져다주지는 않는다. 마이크로프로세서는 수천 명의 창업자와 투자자를 부자로 만들었지만, 1950년대 해운 컨테이너화는 혁명적이었으면서도 소수를 제외하고는 거의 돈을 벌지 못했다. AI · 머신러닝 · AI will not make you rich (2025)
Key Point 혁신이 사회적 가치를 만들어도 투자자가 돈을 버는 것은 별개의 문제인데, 현재 AI 투자의 대부분이 잘못된 곳에 집중되고 있을 가능성을 역사적 사례로 명확히 보여준다.
핵심 요약
기술 혁신이 사회를 완전히 바꿔도 모두에게 부를 가져다주지는 않는다. 마이크로프로세서는 수천 명의 창업자와 투자자를 부자로 만들었지만, 1950년대 해운 컨테이너화는 혁명적이었으면서도 소수를 제외하고는 거의 돈을 벌지 못했다. 컨테이너화의 핵심은 화물을 출발지에서 목적지까지 최소 비용으로 옮기는 것이었다. 말콤 맥린이 1956년 전함 개조선으로 첫 컨테이너선을 출범시켰고, 비용을 절감하면서 경쟁 없는 시장에서 시작했다. 하지만 1965년경 성공이 확실해 보이자 모든 대형 선사가 경쟁에 뛰어들었다. 용량 과잉, 요금 전쟁, 마진 압박, 대규모 자본 투자 필수라는 악순환 속에 맥린은 1969년 시디앤더스에 팔았고, 대부분의 투자자는 손실을 입었다. 전체 요약 8문장 읽기 → 오늘의 주요당일 스타 상위 2건
01 AI · 머신러닝 09:11 게시
FlashML-org/FreeVideo
원제 FlashML-org/FreeVideo
스타 4,122 당일 +410 Python
Key Point 고사양 GPU 없이도 최첨단 영상 생성 AI를 로컬에서 실행할 수 있게 되어, 개인 개발자와 소규모 팀의 AI 활용 진입 장벽이 대폭 낮아진다.
핵심 요약
FreeVideo는 MiniMax H3 모델을 소비자 GPU에서 로컬 실행하는 오픈소스 엔진으로, 최소 8GB VRAM과 16GB RAM만으로 동작한다. OpenVDN의 VDN-H3 모델과 Video DeltaNet의 하이브리드 어텐션을 기반으로 하며, 각 GPU의 가중치 형식(GeForce/RTX 30번대는 int8, 워크스테이션/데이터센터는 FP8)과 어텐션 커널을 자동으로 선택한다. 가중치 스트리밍과 비동기 프리페칭으로 메모리 사용을 최소화하며, 텍스트 프롬프트·첫/마지막 프레임·이미지·영상·오디오 참조 등 다중 입력을 지원한다. 전체 요약 7문장 읽기 → 02 AI · 머신러닝 21:11 게시
openvinotoolkit/openvino
원제 openvinotoolkit/openvino
스타 11,911 당일 +202 C++
Key Point 엣지부터 클라우드까지 다양한 환경에서 여러 프레임워크의 모델을 최적화·배포할 수 있는 통합 솔루션으로, LLM부터 컴퓨터 비전까지 광범위한 AI 작업에 활용 가능하다.
핵심 요약
인텔이 개발한 OpenVINO는 딥러닝 모델을 최적화하고 에지부터 클라우드까지 다양한 환경에 배포하는 오픈소스 툴킷이다. PyTorch, TensorFlow, ONNX, Keras, PaddlePaddle, JAX/Flax 등 주요 프레임워크로 학습한 모델을 직접 지원하며, Hugging Face Hub의 Transformers와 Diffusers 모델도 Optimum Intel을 통해 통합할 수 있다. CPU(x86, ARM), GPU(인텔 통합·별도 GPU), NPU 등 여러 하드웨어 플랫폼에서 추론을 실행할 수 있고, 프레임워크 없이도 모델을 변환·배포할 수 있다. 전체 요약 8문장 읽기 → 읽을 논문
Hugging Face Papers23 커뮤니티가 고른 오늘의 AI 논문
오늘의 주요추천 상위 3건
01 AI · 머신러닝 15:11 게시
원제 WeVisForensics: Self-Evolving Agent for Omni AI-Generated Video Detection
추천 52 댓글 3 Yipeng Du, Yuxi Li, Ying Zhang 외
Key Point 생성형 AI 영상이 급속도로 고도화되는 상황에서, 적응형 에이전트 기반 멀티모달 탐지 시스템이 최신 기준을 9% 이상 상회하는 성능을 보였다.
핵심 요약
최근 영상 생성 기술의 발전에 따라 명시적인 포렌식 증거에 기반한 신뢰할 수 있는 탐지 방법의 필요성이 대두되고 있다. 기존 방법들은 단일 패스 사고 연쇄(chain-of-thought) 추론으로 짧거나 국소적인 흔적을 놓치거나, 고정된 멀티 에이전트 워크플로우로 조사 유연성이 부족했다. WeVisForensics는 메인 조사자 에이전트가 시각 및 음성 단서를 아우르는 자가 진화하는 포렌식 검사자 서브 에이전트 라이브러리를 조정하는 에이전트 프레임워크다. 전체 요약 7문장 읽기 → 02 AI · 머신러닝 18:11 게시
원제 Mind2Act World: A Diagnostic Benchmark for Embodied Mind, Physical Action, and Mind-Action Composition in Robotic Manipulation
추천 50 댓글 4 Yuzhi Huang, Jie Wu, Fanding Huang 외
Key Point 로봇 조작 작업에서 'AI가 생각하되 행동도 정확해야 한다'는 문제를 측정하는 첫 체계적 도구이며, 현재 최고 성능 모델조차 Mind2Act 작업에서 12%만 성공해 로봇 intelligence의 근본적 한계를 드러낸다.
핵심 요약
로봇의 embodied intelligence는 과거 관찰에 기반한 인지 추론, 정확한 신체 실행, 환경 피드백을 통한 두 능력의 조합 등 세 가지 보완적 능력이 필요하다. 기존 벤치마크는 추론과 실행을 같은 작업으로 평가하거나 별개로 평가해 실패 원인이 추론·실행·조합 중 어디서 비롯되는지 알 수 없다. Mind2Act World는 5개 실제 응용 영역에서 30개 시뮬레이션 조작 작업으로 이루어진 진단 벤치마크로, 각 작업은 3개 난이도와 2개 장면(Clean, Random) 설정을 가져 총 180개 구성을 제공한다. 전체 요약 10문장 읽기 → 03 AI · 머신러닝 18:11 게시
원제 WeMM-Video: Pushing the Frontiers of Open-Source Omni-Modal Video Understanding
추천 43 댓글 3 Changli Tang, Jie Yang, Tianyi Wang 외
Key Point 오픈소스 멀티모달 비디오 모델이 상용 모델을 넘어서는 성과가 나왔고, 특히 소형 모델(9B)이 훨씬 큰 경쟁 모델을 이기는 효율성을 보여준다.
핵심 요약
음성과 함께 비디오를 이해하는 멀티모달 작업이 중앙 과제로 남아있는 가운데, 웨이즈(Wize)가 WeMM-Video라는 중영문 쌍언어 오픈소스 모델군을 공개했다. 2B, 4B, 9B, 35B-A3B 등 4개 규모의 모델을 제공하며, 텍스트·이미지·음성·비디오를 한 패러다임 안에서 처리한다. 빠른 응답을 위한 인스트럭트 모드와 단계별 추론을 위한 싱킹(thinking) 모드를 모두 지원한다. 전체 요약 8문장 읽기 → 전체 색인20건 · 분야별
AI · 머신러닝20건 001 21:11 ▲ 42 · 댓글 2 시각-언어 모델의 "의식" 구조 규명, 개념 접근성 분석 도구 개발 Vision-language models(VLMs)가 시각과 텍스트 정보를 통합하지만 내부 개념 표현은 드러나지 않는 문제를 해결하기 위해 Multimodal Concept Lens(MC-Lens)를 개발했다. AI · 머신러닝 · Probing the "Conscious" Mind: Selective Access and Global Workspace in Vision-Language Models
Key Point 시각-언어 모델의 내부 작동 원리를 뇌의 의식 메커니즘과 연결하여 해석하는 새로운 분석 도구로, 모델의 의미 이해 과정과 정렬 훈련의 구체적 메커니즘을 규명하는 데 도움이 된다.
핵심 요약
Vision-language models(VLMs)가 시각과 텍스트 정보를 통합하지만 내부 개념 표현은 드러나지 않는 문제를 해결하기 위해 Multimodal Concept Lens(MC-Lens)를 개발했다. MC-Lens는 multimodal Jacobian lens로서 뇌의 global workspace theory(GWT)를 모델링하며, 중간 상태를 디코더의 출력 어휘로 정의된 공유 의미 공간에 매핑한다. multimodal 개념 정보는 중간 상태에서 읽을 수 있으며, 작업 요구에 따라 선택적으로 접근 가능함을 확인했다. 전체 요약 9문장 읽기 → 002 21:11 ▲ 23 · 댓글 3 LLM이 인간 평가자를 대체할 수 있는지 판단하는 통계 검증법 제안 LLM이 인간 평가자를 대체하는 것이 통계적으로 정당한지 판단하기 위해 AltRA-Test 검증법을 제안했다. AI · 머신러닝 · AltRA-Test: An Alternative Annotator Test for LLM Judges Without Shared Annotators
Key Point LLM 평가자가 인간을 대체 가능한지 객관적으로 판정하는 통계 방법을 제시함으로써, 대규모 평가 작업에서 비용 절감과 품질 보증을 동시에 달성할 근거를 제공한다.
핵심 요약
LLM이 인간 평가자를 대체하는 것이 통계적으로 정당한지 판단하기 위해 AltRA-Test 검증법을 제안했다. 기존 Alt-Test는 모든 항목을 동일한 평가자가 평가할 때만 적용 가능했으나, AltRA-Test는 항목마다 평가자 집합이 다른 대규모 주석 환경에 대응한다. AltRA-Test는 부트스트랩으로 항목을 재표본화한 후 각 항목마다 k개의 인간 평가를 수집하고 그 중 하나를 LLM 평가로 대체하여 모두-인간 패널과 혼합 인간-LLM 패널의 평가자 간 일치도(IAA)를 비교한다. 전체 요약 8문장 읽기 → 003 21:11 ▲ 18 · 댓글 3 장문맥 처리 가속화, 동적 라우팅으로 더 빠르고 똑똑하게 Mixture of Block Attention(MoBA)은 긴 컨텍스트 계산을 각 쿼리별로 필요한 Key-Value(KV) 블록만 선택해 줄이는 방식이다. AI · 머신러닝 · Accelerating Mixture of Block Attention via Dynamic Routing, KV-Centric Execution and Runtime Pipelining
Key Point 장문맥 LLM 추론의 메모리 오버헤드를 동적 라우팅과 실행 계획 최적화로 1.6배까지 가속하는 기법으로, 긴 프롬프트를 다루는 AI 애플리케이션의 성능 개선에 직결된다.
핵심 요약
Mixture of Block Attention(MoBA)은 긴 컨텍스트 계산을 각 쿼리별로 필요한 Key-Value(KV) 블록만 선택해 줄이는 방식이다. 기존 FlashMoBA는 고정된 Top-k 예산과 쿼리 중심 스케줄을 사용해 여러 범위가 같은 컬럼을 선택할 때 KV 재사용이 단편화되는 문제가 있다. LightningMoBA는 동적 라우팅으로 각 쿼리의 블록 점수에 맞춰 가변 크기의 희소 메타데이터를 직접 생성한다. 전체 요약 7문장 읽기 → 004 21:11 ▲ 13 · 댓글 2 바이오메드 의료 데이터 94개로 모델 벤치마킹 프레임워크 공개 생의학 예측에서 구조화된 데이터 평가가 단편적이라는 문제를 해결하기 위해 TabBioMed 벤치마크를 개발했다. AI · 머신러닝 · TabBioMed: A Large-Scale Benchmark for Biomedical Tabular Learning
Key Point 생의학 머신러닝에서 테이블형 데이터를 다룰 때 모델 선택 기준이 뚜렷해져, 의료 AI 개발 시 성능과 효율의 트레이드오프를 고려한 의사결정이 가능해진다.
핵심 요약
생의학 예측에서 구조화된 데이터 평가가 단편적이라는 문제를 해결하기 위해 TabBioMed 벤치마크를 개발했다. 전자의료기록, 신약개발, 유전체학, 전사체학, 단백질체학, 대사체학, 단일세포 오믹스, 시스템생물학 등 94개의 생의학 테이블형 데이터셋을 수집했다. 고차원성, 대규모 샘플, 결측값, 클래스 불균형 등 현실적 문제를 반영한 데이터셋들이다. 전체 요약 9문장 읽기 → 005 21:11 ▲ 25 · 댓글 2 시각 이해와 생성을 하나로 통합한 멀티모달 모델 HiUni 기존 멀티모달 모델들은 이미지 이해와 생성 작업을 위해 서로 다른 시각 표현이나 백본 구조를 사용하곤 했지만, HiUni는 사전학습된 비전 언어 모델을 그대로 확장해 두 작업을 하나의 프레임워크로 통합하는 방식을 탐색했다. AI · 머신러닝 · HiUni: Harmonizing Understanding and Generation in Shared Visual Space
Key Point 시각 이해와 생성을 하나의 공유 백본으로 통합하면서도 각각의 성능을 유지하는 설계 방식이 실제로 작동할 수 있음을 처음 체계적으로 입증한 것으로, 향후 멀티모달 모델의 아키텍처 방향에 영향을 미칠 수 있다.
핵심 요약
기존 멀티모달 모델들은 이미지 이해와 생성 작업을 위해 서로 다른 시각 표현이나 백본 구조를 사용하곤 했지만, HiUni는 사전학습된 비전 언어 모델을 그대로 확장해 두 작업을 하나의 프레임워크로 통합하는 방식을 탐색했다. HiUni는 같은 언어 정렬 ViT와 조밀한 Transformer 백본을 이해와 생성에 모두 재사용하면서, 작업별 계산을 출력 단계에만 제한해 광범위한 파라미터 공유를 실현했다. 픽셀 공간에서의 생성 최적화가 어렵고 사전학습된 ViT의 의미적 추상화로 인해 합성에 필요한 세밀한 공간 정보가 손실되는 두 가지 과제를 발견했다. 전체 요약 6문장 읽기 → 006 21:11 ▲ 22 · 댓글 2 VLM을 미세조정 없이 네비게이션 학습하는 ZeroVLN 기존 비전-언어 네비게이션(VLN) 방식은 VLM(비전-언어 모델) 뇌에 학습 가능한 행동 헤드를 붙이고 기하학적 목표 예측을 위해 VLM을 네비게이션 도메인 데이터로 미세조정했으나, 이는 기본 VLM 가중치를 크게 변경하고 일반 시각 능력을 저하시킨다. AI · 머신러닝 · ZeroVLN: Learning to Navigate without Supervised Fine-Tuning of the VLM Brain
Key Point VLM을 미세조정하지 않으면서 더 나은 네비게이션 성능을 달성하는 방식이 등장해 기존 접근의 한계를 극복할 가능성을 보여준다.
핵심 요약
기존 비전-언어 네비게이션(VLN) 방식은 VLM(비전-언어 모델) 뇌에 학습 가능한 행동 헤드를 붙이고 기하학적 목표 예측을 위해 VLM을 네비게이션 도메인 데이터로 미세조정했으나, 이는 기본 VLM 가중치를 크게 변경하고 일반 시각 능력을 저하시킨다. ZeroVLN은 VLM 뇌를 미세조정하지 않고도 효과적인 네비게이션을 달성하는 느린-빠른(slow-fast) 네비게이션 프레임워크다. 기하학적 목표 예측 대신 VLM에 의미적 도구 호출 인터페이스를 갖춰 자연언어로 이동 결정을 행동 전문가에게 전달한다. 전체 요약 6문장 읽기 → 007 18:11 ▲ 36 · 댓글 4 확산 모델 압축, 다양성 살리는 새 방법 나왔다 이미지와 영상 생성을 가속화하는 확산 모델 증류(diffusion distillation)에서, 기존 역-KL 기반 방법들은 주요 모드만 선호하면서 샘플 간 다양성을 떨어뜨리는 문제가 있었다. AI · 머신러닝 · Posterior Matching Distillation
Key Point 확산 모델의 단계 수를 줄이면서도 샘플 다양성을 유지하려는 연구자와 엔지니어에게 필수적인 기술 발전이다.
핵심 요약
이미지와 영상 생성을 가속화하는 확산 모델 증류(diffusion distillation)에서, 기존 역-KL 기반 방법들은 주요 모드만 선호하면서 샘플 간 다양성을 떨어뜨리는 문제가 있었다. 연구진이 제안한 Posterior Matching Distillation(PMD)은 모드-커버링 후부(posterior sampling)와 임의 단계 생성을 결합하는 분포 기반 증류 방법이다. PMD는 각 훈련된 노이즈 레벨에서 학생 모델의 출력이 교사 모델의 완전한 후부 분포를 복구하도록 한다. 전체 요약 9문장 읽기 → 008 18:11 ▲ 29 · 댓글 2 Depth Pro 2, 단일 영상·비디오 모두 선명한 깊이 추정 Apple의 Depth Pro 2는 이미지와 비디오 모두에서 단일 네트워크로 풀 해상도 깊이 맵을 생성하는 단안(monocular) 깊이 추정 방식을 제시한다. AI · 머신러닝 · Depth Pro 2: Sharp and Temporally Consistent Metric Monocular Depth
Key Point 단안 깊이 추정의 오래된 근본적 트레이드오프를 하나의 네트워크로 동시에 해결했으며, 이미지와 비디오 처리를 통합한 접근으로 컴퓨터 비전·자율주행·로봇 비전 등 실제 응용에 직접 활용 가능하다.
핵심 요약
Apple의 Depth Pro 2는 이미지와 비디오 모두에서 단일 네트워크로 풀 해상도 깊이 맵을 생성하는 단안(monocular) 깊이 추정 방식을 제시한다. 기존 방법들은 다중 프레임 방식(시간 일관성 우수)과 단일 프레임 방식(경계 선명도 우수) 간 트레이드오프를 보였으나, Depth Pro 2는 이를 단일 확장 가능한 네트워크로 극복한다. 생성되는 깊이 맵은 메트릭 정확도, 선명도, 시간적 일관성을 모두 만족하며 기존 방법들보다 이 모든 차원에서 우수한 성능을 낸다. 전체 요약 5문장 읽기 → 009 18:11 ▲ 15 · 댓글 2 MLLM으로 만든 대화형 세계 모델, 단일 이미지에서 편집 가능한 3D 환경 생성 기존 비디오 월드모델은 생성기 내부에만 세계 상태를 유지해 재방문 시 편집 내용이 손실되는 문제가 있다. AI · 머신러닝 · WM^MLLM: Turning MLLMs into World Models
Key Point 3D 생성형 AI에서 "세계 상태 관리" 문제를 근본적으로 해결한 접근법으로, 사용자 편집의 일관성과 편집 가능한 3D 환경 생성의 현실화 가능성을 보여준다.
핵심 요약
기존 비디오 월드모델은 생성기 내부에만 세계 상태를 유지해 재방문 시 편집 내용이 손실되는 문제가 있다. WM^MLLM은 MLLM 기반의 첫 대화형 월드모델로, 단일 이미지에서 출발해 파노라마 형태의 세계 상태를 외부에 저장하고 수정 이력을 관리한다. MLLM이 사용자 요청을 세계 상태 변경 작업으로 변환하고, 로컬 편집 위치를 선택한 뒤, 후보 이미지를 검증한 후에만 다음 상태로 반영한다. 전체 요약 9문장 읽기 → 010 18:11 ▲ 35 · 댓글 4 3D 프록시 조정으로 영상 생성 정확도 높이는 Coda-DaVinci Code2Video 기반 영상 생성에서 AI 에이전트가 작성한 3D 프록시로 구조와 역학을 명시적으로 제어할 수 있지만, 프록시와 프롬프트 설계의 최적값이 미탐구 상태였다. AI · 머신러닝 · Coda-DaVinci: Reimagining Video Generation with Code2Video
Key Point 3D 프록시 설계가 영상 생성 품질에 미치는 영향을 체계적으로 규명하고, 적응형 멀티에이전트 프레임워크로 현실적인 개선을 달성했기 때문이다.
핵심 요약
Code2Video 기반 영상 생성에서 AI 에이전트가 작성한 3D 프록시로 구조와 역학을 명시적으로 제어할 수 있지만, 프록시와 프롬프트 설계의 최적값이 미탐구 상태였다. 연구팀이 프록시 세분도, 물리 시뮬레이션, 프롬프팅 방식을 체계적으로 실험하고 인간 평가를 진행한 결과 작업별 트레이드오프를 발견했다. 입도가 낮은 프록시는 자연스러운 동작을 선호하고, 중간 입도는 일관성을 선호하는 경향을 확인했다. 전체 요약 8문장 읽기 → 011 18:11 ▲ 25 · 댓글 2 1인칭 영상 설명에 타이밍 추가한 'EgoCaptioner' 공개 기존 멀티모달 대형언어모델(MLLM)들은 1인칭 영상의 짧은 행동을 놓치거나 순서를 헷갈리거나 착용자의 움직임을 잘못 해석하는 문제가 있었다. AI · 머신러닝 · EgoCaptioner: Towards Comprehensive and Fine-Grained Egocentric Video Captioning
Key Point 1인칭 영상 분석에서 정확한 시간 정보와 세밀한 행동 설명이 모두 필요한 실제 문제를 해결하는 새로운 데이터셋과 방법론이며, 기존 상용 모델을 능가하는 성능을 달성했기 때문이다.
핵심 요약
기존 멀티모달 대형언어모델(MLLM)들은 1인칭 영상의 짧은 행동을 놓치거나 순서를 헷갈리거나 착용자의 움직임을 잘못 해석하는 문제가 있었다. EgoCaptioner는 영상의 환경·참여자·착용자의 전반 활동을 개요로 먼저 제시한 뒤, 각 단계마다 타임스탬프를 붙인 설명을 제공하며 세부사항의 정도를 조정해 주요 순간을 정확히 표시한다. 50,000개 학습 데이터셋을 위해 'coarse-to-fine' 주석 방식을 개발했으며, 먼저 사건 구조를 정의한 뒤 각 단계 설명을 확장하는 방식을 사용했다. 전체 요약 8문장 읽기 → 012 15:11 ▲ 32 · 댓글 4 3D 가우시안의 숨은 부분도 제대로 선택하기 3D Gaussian Splatting에서 개체 단위 작업을 하려면 정확한 세그멘테이션이 필요한데, 기존 방법들은 렌더링된 2D 뷰로만 학습하고 평가해 불완전한 3D 선택도 2D에선 정확하게 보일 수 있다. AI · 머신러닝 · The Mask Is Not the Object: Volumetric Supervision for 3D Gaussian Segmentation
Key Point 3D 장면 편집·재구성에서 완전한 개체 선택이 필수인데, 기존의 2D 렌더링 기반 세그멘테이션은 가려진 부분을 무시해 실제 3D 작업에 실패할 수 있다.
핵심 요약
3D Gaussian Splatting에서 개체 단위 작업을 하려면 정확한 세그멘테이션이 필요한데, 기존 방법들은 렌더링된 2D 뷰로만 학습하고 평가해 불완전한 3D 선택도 2D에선 정확하게 보일 수 있다. 알파 블렌딩 기반 지도학습은 주요 기여 Gaussian에만 집중해 가려진 부분이나 기여도 낮은 Gaussian은 약하게만 학습된다. 논문은 VODA라는 감독 목표를 제안하며, 깊이 구조를 이용해 픽셀별 기여자를 그룹화하고 선택된 깊이 클러스터의 모든 Gaussian을 직접 지도학습한다. 전체 요약 6문장 읽기 → 013 15:11 ▲ 23 · 댓글 2 AI 모델의 공간 지능 측정하는 'TuringSpace' 벤치마크 공개 인간은 2D 화면 속 3D 공간을 추론하고 액션으로 변화를 예측한 뒤 결과를 보고 자신을 수정하는 방식으로 행동하는데, 멀티모달 대형언어모델(MLLM)이 이를 할 수 있는지 묻는 연구다. AI · 머신러닝 · TuringSpace: Grounding Spatial Intelligence in Action with Interactive CAPTCHAs
Key Point 대형언어모델이 추론과 행동을 통해 공간을 이해하는 방식을 측정·개선하는 새 벤치마크로, 현재 AI의 공간 지능 한계를 명확히 드러내고 학습 효과가 실제 세계로 전이된다는 점이 중요하다.
핵심 요약
인간은 2D 화면 속 3D 공간을 추론하고 액션으로 변화를 예측한 뒤 결과를 보고 자신을 수정하는 방식으로 행동하는데, 멀티모달 대형언어모델(MLLM)이 이를 할 수 있는지 묻는 연구다. CAPTCHA를 활용해 5가지 공간 능력을 테스트하는 125개의 인터랙티브 과제로 이루어진 'TuringSpace'라는 합성 웹 환경을 개발했으며, 모든 과제는 프로그래밍된 작업으로 새 인스턴스를 생성하고 검증할 수 있어 확장 가능한 학습 환경을 제공한다. 인간은 94.1% 성공률을 보이는 반면 GPT-6 Astra는 25.9% 실패, 오픈 모델 중 최고인 Kimi K3는 68.0% 실패율을 기록했다. 전체 요약 7문장 읽기 → 014 15:11 ▲ 16 · 댓글 6 AI 에이전트의 비용 75~91% 절감하는 경량 판단 시스템 제안 자율형 LLM 에이전트가 매 단계마다 대형 모델(System-2)을 호출하면 비용과 지연이 크게 증가하는데, 많은 중간 작업이 사전에 정해진 소수의 선택지 중에서만 고르는 문제를 다룬다. AI · 머신러닝 · Thinking Fast, Anywhere: One System-1 for the Decision Points of Any Agent Workflow
Key Point LLM 에이전트의 추론 비용이 급증하는 실무 문제를 범용적으로 해결하는 접근법으로, 성능 손실 없이 비용을 대폭 줄일 수 있는 실현 가능한 방법을 제시한다.
핵심 요약
자율형 LLM 에이전트가 매 단계마다 대형 모델(System-2)을 호출하면 비용과 지연이 크게 증가하는데, 많은 중간 작업이 사전에 정해진 소수의 선택지 중에서만 고르는 문제를 다룬다. 기존 이중 체계 에이전트는 가벼운 System-1 모델로 이런 결정을 처리하지만 환경별로 별도의 설정이 필요한 한계가 있다. AnyS1은 인간이 작성한 절차형 기술(instruction)에서 선택이 필요한 지점과 가능한 옵션을 자동으로 추출해 도메인 범용 결정점으로 변환하는 프레임워크를 제시한다. 전체 요약 7문장 읽기 → 015 15:11 ▲ 16 · 댓글 2 사족 로봇을 위한 언어 조종 조작 정책 개발 기존 팔 로봇용 World Action Model(WAM)을 사족 보행·조작 로봇으로 적응시키는 WAM-Policy 방법을 제안했다. AI · 머신러닝 · WAM-Policy: World Action Models with On-Policy Distillation for Quadrupedal Loco-Manipulation
Key Point 언어 명령에 따르는 사족 로봇의 조작 정책이 없었는데, 이제 기존 팔 로봇 모델을 효율적으로 전이해 실제 로봇에 배포할 수 있게 되었다.
핵심 요약
기존 팔 로봇용 World Action Model(WAM)을 사족 보행·조작 로봇으로 적응시키는 WAM-Policy 방법을 제안했다. 첫 번째 단계에서 Cross-Morphology Policy Adaptation and Acceleration으로 팔 중심 모델을 사족 로봇에 맞추고, 온폴리시 자기 증류(OPSD)로 한 개의 비디오와 두 액션 스텝만 사용해 학생 모델로 압축한다. 압축된 학생 모델은 성능이 교사 모델에 한정되므로, 두 번째 단계에서 강화학습으로 교사를 개선하고 다중 교사 온폴리시 증류(M-OPD)로 여러 전문 모델을 하나의 소수 스텝 학생으로 통합한다. 전체 요약 6문장 읽기 → 016 12:10 ▲ 13 · 댓글 2 시각 검색 위한 논리적 추론 모델 LogT 공개 시각-언어 모델(VLM)이 세밀한 시각 탐색을 위해 확대 도구(Zoom-in tool)를 사용하도록 하는 LogT를 제안한 논문이다. AI · 머신러닝 · LogT: Logically Think with Images for Visual Search
Key Point 고품질 학습 데이터로 복잡한 강화학습 없이도 최첨단 성능을 내는 사례로, VLM 기반 시각 추론 분야에서 효율성 패러다임을 바꾸는 연구입니다.
핵심 요약
시각-언어 모델(VLM)이 세밀한 시각 탐색을 위해 확대 도구(Zoom-in tool)를 사용하도록 하는 LogT를 제안한 논문이다. 기존 방식은 강화학습(RL) 복잡도를 높이거나 도구별 설계를 적용했으나, LogT는 감독학습(SFT) 데이터 품질을 핵심 병목으로 진단했다. LogT는 완전 자동화된 SFT 데이터 생성 엔진으로, 논리 체인 기반 추론을 명시적으로 강제하고 인간다운 도구 사용 흔적이 담긴 도전적인 질문-답변 쌍을 생성한다. 전체 요약 7문장 읽기 → 017 06:11 ▲ 13 · 댓글 2 모델과 데이터가 함께 진화하는 의사결정 AI 'Piccolo' 공개 Hugging Face는 Piccolo라는 멀티모달 의사결정 모델 계열(0.8B~27B)을 발표했으며, 이는 에이전트 기반 데이터 엔지니어링과 재귀적 자기 개선(RSI)을 통해 모델 능력과 학습 데이터를 함께 진화시킨다. AI · 머신러닝 · Piccolo: Co-Evolving Decision Models and Data through Recursive Self-Improvement
Key Point 모델 아키텍처보다 데이터 큐레이션이 성능을 크게 좌우한다는 발견과 작은 모델이 큰 모델과 경쟁할 수 있다는 결과는 AI 모델 개발 방식의 근본적 전환을 시사한다.
핵심 요약
Hugging Face는 Piccolo라는 멀티모달 의사결정 모델 계열(0.8B~27B)을 발표했으며, 이는 에이전트 기반 데이터 엔지니어링과 재귀적 자기 개선(RSI)을 통해 모델 능력과 학습 데이터를 함께 진화시킨다. Piccolo는 텍스트와 시각 판단, 에이전트 도구, 데이터 워크플로우, 대화형 게임 등에서 후보 답안에 대한 확률을 예측한다. Piccolo-27B는 Decision Index Vision Full 리더보드에서 75.59점으로 1위이며, Piccolo-9B(68.35점)와 Piccolo-4B(67.46점)도 각 크기 범주에서 Private 벤치마크 1위를 차지한다. 전체 요약 8문장 읽기 → 018 03:11 ▲ 10 · 댓글 2 메시 모델에서 편집 가능한 CAD로 변환, 로컬 환경에서 구동 CADMAGEDDON은 3D 메시에서 편집 가능한 CAD 형식으로 복원하는 오픈소스 에이전트로, 메시지나 노트북 같은 단일 GPU 시스템에서도 로컬로 실행할 수 있다. AI · 머신러닝 · CADMAGEDDON: High-Fidelity CAD Reconstruction with Local Inference
Key Point 3D 모델 설계가 필요한 엔지니어, 소규모 제조 회사, 프리랜서 설계자들이 클라우드 서비스 없이 로컬에서 고품질 CAD를 얻을 수 있는 실질적인 대안을 제시한다.
핵심 요약
CADMAGEDDON은 3D 메시에서 편집 가능한 CAD 형식으로 복원하는 오픈소스 에이전트로, 메시지나 노트북 같은 단일 GPU 시스템에서도 로컬로 실행할 수 있다. 복잡한 CAD 복원 작업을 무엇을 구성할지, 무엇을 수정할지에 대한 일련의 시각적 결정으로 분해하여 처리한다. 기하학적 도구가 정밀한 구성을 지원하므로 에이전트는 시각적 추론에만 집중할 수 있다. 전체 요약 6문장 읽기 → 019 00:11 ▲ 16 · 댓글 2 LLM 양자화 설계를 자동화하는 에이전트 시스템 QDA Post-training 양자화는 대규모 언어 모델을 저비용으로 서빙하는 표준 방식이지만, 모델과 정밀도마다 최적의 양자화 레시피가 다르다. AI · 머신러닝 · QDA: Closed-Loop LLM Quantization Design with Agents
Key Point 대규모 언어 모델의 양자화 과정을 사람이 아닌 에이전트가 자동화함으로써 모델별 최적 설계 시간을 단축하고 성능을 개선하는 새로운 접근법을 제시한다.
핵심 요약
Post-training 양자화는 대규모 언어 모델을 저비용으로 서빙하는 표준 방식이지만, 모델과 정밀도마다 최적의 양자화 레시피가 다르다. 기존에는 전문가가 새로운 모델마다 수작업으로 레시피를 재설계해야 하는데 시간이 오래 걸리고 최적이 아닐 수 있다. QDA는 에이전트가 여러 라운드에 걸쳐 후보를 생성하고 평가하면서 각 모델과 정밀도에 맞는 양자화 레시피를 자동으로 설계하는 시스템이다. 전체 요약 8문장 읽기 → 020 00:11 ▲ 15 · 댓글 2 영상 생성 AI, 동작 반복할 때 장면이 휜다 인터랙티브 비디오 월드 모델은 사용자 명령을 받아 3D 장면을 생성하는데, 카메라 이동 시 장면의 기하학적 구조가 유지되고 각 동작의 효과가 일관되어야 한다. AI · 머신러닝 · StrideWorld: Benchmarking Scene Rigidity and Action Consistency in Interactive Video World Model
Key Point 영상 생성 AI 모델이 사용자 명령에 따라 장면을 탐색할 때 기하학적 오류를 얼마나 보이는지 측정할 수 있는 첫 고정형 벤치마크로, 개발자들이 더 견고한 월드 모델을 만드는 데 필요한 기준을 제시한다.
핵심 요약
인터랙티브 비디오 월드 모델은 사용자 명령을 받아 3D 장면을 생성하는데, 카메라 이동 시 장면의 기하학적 구조가 유지되고 각 동작의 효과가 일관되어야 한다. 기존 벤치마크는 테스트 비디오 자체에서 복원한 장면이나 명령 경로에 맞춰 스케일을 자유롭게 조정한 카메라 궤적을 기준으로 평가하기 때문에, 장면의 점진적 변형이나 속도·경로 길이 변화 같은 오류를 감지하지 못한다. StrideWorld 벤치마크는 평가 기준을 동작 전에 고정시켜 이 문제를 해결한다. 전체 요약 11문장 읽기 → 오늘의 주요최신순 상위 3건
01 AI · 머신러닝 12:10 게시
openai/openai-python
원제 openai/openai-python v3.57.0
v3.57.0
Key Point 실시간 음성·영상 통신(WebRTC)을 활용한 AI 애플리케이션 개발 시 연결 상태 관리 기능이 필요한 개발자들에게 필수 업데이트다.
핵심 요약
OpenAI 파이썬 SDK v3.57.0이 릴리스됐다. Live WebRTC 대기 상태(standby) 지원 기능이 추가됐다. 이를 통해 WebRTC 기반 실시간 통신에서 대기 상태 관리가 가능해졌다. 02 AI · 머신러닝 06:11 게시
openai/openai-python
원제 openai/openai-python v3.56.0
v3.56.0
Key Point OpenAI의 공식 Python 라이브러리에 새로운 실시간 모델이 추가되어, Live API를 사용하는 개발자가 최신 모델을 곧바로 활용할 수 있게 되었다.
핵심 요약
OpenAI Python SDK v3.56.0이 릴리스됐다. gpt-live-1.1 모델이 Live API 모델 선택 옵션에 추가됐다. 03 AI · 머신러닝 06:11 게시
anthropics/anthropic-sdk-python
원제 anthropics/anthropic-sdk-python v2.11.0
v2.11.0
Key Point Python SDK 사용자는 Claude Code 관리 기능 추가와 쿼리 문자열 처리 버그 수정으로 프로덕션 환경에서 더 안정적으로 운영할 수 있다.
핵심 요약
Anthropic Python SDK 2.11.0이 출시됐다. Claude Code 관리 설정이 Admin API에 추가돼 관리자가 더 세밀하게 제어할 수 있다. Admin API 플러그인 메서드에 sandbox_egress_restricted 오류 타입이 새로 추가됐다. 전체 요약 7문장 읽기 → ● 이번 피드는 여기까지입니다.
작은 발견을 다음 커밋으로 이어가세요. 모든 발행본