매일 쌓이는 개발자의 시야
2026년 11월 21일 (토). 세상의 기술 소식, 한국어로 한눈에.
AI 요약 안내 AI가 한국어로 정리한 내용입니다. 정확한 정보는 각 카드의 원문을 확인해 주세요.
요약 원칙 ↗ 01 읽을 소식Hacker News 16건 ↓ 02 써볼 도구GitHub Trending 3건 ↓ 03 읽을 논문Hugging Face Papers 11건 ↓ 04 새 버전GitHub Releases 0건 ↓ AI · 머신러닝 분야 · 30건 필터 해제 ×
오늘의 주요포인트 상위 6건
01 AI · 머신러닝 06:11 게시
원제 Unforced Navier-Stokes Singularity and the Generalized Riemann Hypothesis
197 포인트 댓글 58
Key Point 수백 년 미해결 난제들(나비에-스토크스, 리만 가설)을 AI 보조로 형식화 증명하는 것은 수학과 AI의 협력이 근본적 문제를 어디까지 풀 수 있는지 보여주는 사례이다.
핵심 요약
레벤트 알뵈게, 트리스탄 벅마스터, 마테이 코이쿨레스쿠가 AI 보조로 3차원 비강제 비압축 오일러 방정식의 유한시간 폭발(finite time blowup)에 대한 인간이 읽을 수 있는 증명을 작성했으며, 이를 Lean으로 형식화했다. 알뵈게와 벅마스터는 다시 AI를 활용해 3차원 비강제 비압축 나비에-스토크스 방정식의 유한시간 폭발 증명을 생성했고, 역시 Lean 형식화를 완료했다. 두 번째 결과는 인간이 읽을 수 있는 형태이고 일반적인 증명 전략이 명확하지만, 전문적으로 작성된 증명을 완성하려면 추가 작업이 필요하다. 전체 요약 7문장 읽기 → 02 AI · 머신러닝 06:11 게시
원제 Inkling 2 Mini
195 포인트 댓글 19
Key Point 경량 모델에서 추론 성능을 획기적으로 높이는 루핑 아키텍처가 처음 공개되며, 로컬 하드웨어에서 여러 에이전트를 실시간으로 운영할 수 있는 가능성을 보여준다.
핵심 요약
라이언(Thinking Machines)이 Inkling 2 Mini를 발표했다. 26.4B 총 파라미터, 3.4B 활성 파라미터를 가진 Mixture-of-Experts 모델으로, 중간층을 세 번 반복 실행하는 루핑 아키텍처를 사용해 추론 성능을 높인다. 100B 미만 오픈웨이트 모델 중 처음으로 DeepSWE v1.1에서 48.2%, Vals Index v2.2에서 46.5%의 최고 성능을 기록했으며, 유사한 성능의 다른 모델보다 빠르게 실행된다. 루핑으로 인해 토큰을 출력하지 않고도 더 오래 추론할 수 있으므로, 체인오브씽크(CoT) 모니터링 시 모니터링 가능성이 감소할 우려가 있다. 전체 요약 12문장 읽기 → 03 AI · 머신러닝 09:11 게시
원제 The stochastic parrots have apparently proved the Riemann Hypothesis
189 포인트 댓글 154
Key Point 리만 추측 같은 수백 년 미해결 난제가 AI로 증명되는 순간, 인간 수학자의 역할이 근본적으로 바뀌고 있음을 보여주는 사례이다.
핵심 요약
Anthropic의 LLM이 Lean 형식 검증 시스템으로 일반화된 리만 추측(Generalized Riemann Hypothesis)을 증명했으며, 1,740만 줄의 Lean 코드를 생성했다. 리만 추측은 1부터 n까지의 소수 개수가 각 정수 x>1이 1/ln(x)의 독립적 확률을 가진다면 어떻게 될지를 나타내며, 1896년부터 소수의 개수가 n/ln(n)에 점근한다는 사실이 알려져 있었다. AI는 이미 리만 제타함수의 자명하지 않은 영점들이 임계선으로부터 최대 3/8 이내에 있다는 것을 증명했으며, 이는 완전한 리만 추측 증명이 갖는 대부분의 수론 함의를 담고 있다. 전체 요약 7문장 읽기 → 04 AI · 머신러닝 06:11 게시
원제 Google Workers Tell Their Employer Not to Punish Schools That Don't Want AI
179 포인트 댓글 123
Key Point 학교와 학부모의 거부권을 무시하고 강제 도입을 추진하는 구글의 정책이 자신의 직원들까지 반발하게 만들고 있으며, 교육기관의 기술 도입 자율성 문제로 번지고 있기 때문입니다.
핵심 요약
구글이 Gemini AI 도구를 거부하는 학교에 검색 엔진 접근을 차단하겠다고 2주 전 발표했으며, 이에 대해 전국 여러 도시에서 학부모·학생 중심의 대규모 항의가 벌어졌다. 뉴욕, 로스앤젤레스, 시카고 등 미국 최대 학교 지구들이 이미 구글 검색 엔진의 대체 서비스 도입을 논의 중이다. 구글의 모기업 알파벳 산하 근로자 조합 대표 1,000명 이상이 청원서를 발표해 이 정책 철회를 요구했다. 전체 요약 8문장 읽기 → 05 AI · 머신러닝 03:11 게시
원제 Show HN: I made an audio-to-MIDI model 60x more efficient
156 포인트 댓글 28
Key Point 지금까지 65배 더 큰 모델을 썼는데도 같거나 더 좋은 성능을 내는 소형 모델이 나왔으며, 저작권 없는 데이터만으로 학습할 수 있다는 점이 오디오 AI와 음악 기술 분야에서 의미가 있습니다.
핵심 요약
음성을 MIDI로 변환하는 오픈소스 모델 Dettato를 공개했다. 2천만 파라미터로 경쟁 모델 MuScriptor(13억)보다 65배 작으면서도 성능이 더 우수하고, 비공개 모델인 Mirelo A2M v1.1 Pro와도 비슷한 수준의 정확도를 갖췄다. 벤치마크는 여러 데이터셋(Bach, PHENICX, RWC 등)에서 측정했으며, Dettato의 평균 F1 스코어는 60.87로 Mirelo 56.16, MuScriptor 47.45보다 높다. 학습 과정에서 저작권이 있는 음성을 전혀 사용하지 않았다. 대신 합성 악기 녹음과 CC 라이선스 솔로 악기를 URMP 데이터셋으로 혼합하고, 나머지는 Soundfont를 변형해 생성했다. 전체 요약 7문장 읽기 → 06 AI · 머신러닝 12:11 게시
원제 Re: Riemann
152 포인트 댓글 136
Key Point 리만 가설 증명이라는 역사적 수학 성과 발표가 인류의 역할 재정의와 AI 의존성에 대한 본질적 성찰을 촉발하고 있다.
핵심 요약
누군가 Claude AI와 협력해 리만 가설의 증명을 발표했다고 알려졌다. 이 발표자는 Claude가 증명 과정에서 자신을 뛰어넘어 주도적인 역할을 했으며, 일반화된 리만 가설과 확장된 리만 가설까지 해결할 수 있을 것으로 기대한다고 밝혔다. 발표자는 수십 년간 이 문제를 목표로 했고, 증명 과정에서 두 가지 다른 아이디어를 결합한 핵심 상황을 도출했으며, 그 이후 Claude가 놀라운 성과를 이루었다고 설명했다. 전체 요약 6문장 읽기 → 전체 색인10건 · 분야별
AI · 머신러닝10건 001 18:11 ▲ 104 · 댓글 31 오픈소스 AI 코딩 에이전트 OpenComputer 공개 Devin의 오픈소스 대안인 OpenComputer를 공개했다. Slack 스레드에서 @Computer를 호출하면 자체 컴퓨터에서 작업하고 팀원이 실시간으로 보며 조종할 수 있으며 결과는 풀 리퀘스트로 제출된다. AI · 머신러닝 · Show HN: OpenComputer – an open source alternative to Devin
Key Point Claude Code 수준의 로컬 성능을 제공하면서 자체 호스팅으로 엔터프라이즈 보안을 보장하는 오픈소스 AI 개발자가 등장했으며, 기존 Devin의 3배 이상 빠른 속도로 팀 협업 방식을 바꿀 수 있다.
핵심 요약
Devin의 오픈소스 대안인 OpenComputer를 공개했다. Slack 스레드에서 @Computer를 호출하면 자체 컴퓨터에서 작업하고 팀원이 실시간으로 보며 조종할 수 있으며 결과는 풀 리퀘스트로 제출된다. 전체 스택이 오픈소스이므로 자신의 클라우드 계정에서 실행하거나 OpenComputer Cloud에서 2분 내에 시작할 수 있다. 단일 VM에서 전체 스택이 실행되며 아웃바운드 전용 네트워크 접근으로 잠글 수 있도록 설계했다. Gateway인 Calvin이 Slack 이벤트를 듣고 Claude Code, Codex, OpenCode 중 선택에 따라 세션을 시작한다. 전체 요약 8문장 읽기 → 002 12:11 ▲ 103 · 댓글 52 AI가 리만 추측을 증명했지만, 인류의 발견의 시대는 저물고 있다 Anthropic이 리만 추측을 증명했다고 알려지면서 수학계의 반응이 예상과 달랐다. AI · 머신러닝 · And yet, it moves
Key Point 리만 추측 증명을 둘러싼 AI와 인류 발견의 본질에 대한 성찰이 개발자·연구자의 미래 역할을 묻는 근본적 질문을 던진다.
핵심 요약
Anthropic이 리만 추측을 증명했다고 알려지면서 수학계의 반응이 예상과 달랐다. 저자는 역사적 뮤지컬 갈릴레오를 본 경험에서 시작해, 인류가 망원경으로 우주를 보듯 리만 추측의 증명이 수학의 미스터리를 열 것으로 기대했다. 그러나 이 증명은 '불가해한 실리콘 마음', 즉 AI로부터 나왔고, 이는 화성 탐사선·히그스 입자 발견 같은 인류 위대한 성취와는 다른 성격의 기여라고 본다. 전체 요약 6문장 읽기 → 003 12:11 ▲ 127 · 댓글 23 AI 기반 코딩 환경 DreamCoder, 15개월 개발 끝 공개 Mastering Emacs 저자가 AI 기반 코딩 도구 DreamCoder를 15개월간 개발해 공개했다. AI · 머신러닝 · DreamCoder: Coding harness and IDE from the author of Mastering Emacs
Key Point 기존 AI 코딩 에이전트의 UI/UX 한계를 직접 경험한 개발자가 대안을 만들었으며, 오픈소스 모델 지원과 Emacs 철학을 결합한 새로운 접근이 주목할 만하다.
핵심 요약
Mastering Emacs 저자가 AI 기반 코딩 도구 DreamCoder를 15개월간 개발해 공개했다. 브라우저 기반 타일링 윈도우 매니저를 갖춘 크로스 플랫폼 코딩 환경으로, 채팅과 터미널을 동시에 운영할 수 있다. 저자는 Claude Code 등 기존 AI 코딩 에이전트들이 터미널 중심의 단조로운 UI를 갖고 있다고 지적하며, 더 나은 인터페이스 필요성에서 프로젝트를 시작했다. 전체 요약 10문장 읽기 → 004 12:11 ▲ 125 · 댓글 56 나스닥, 2026년 상반기 수익 모두 증발 금요일 나스닥은 5.28% 하락해 22,617.73으로 마감했고, 연초 대비 2.7% 하락하며 2026년 수익을 모두 잃었다. AI · 머신러닝 · Nasdaq erases all 2026 gains
Key Point AI 버블 붕괴 우려로 나스닥이 연초 대비 마이너스로 돌아섰고, 반도체·클라우드 기업들이 집중 하락 중이다.
핵심 요약
금요일 나스닥은 5.28% 하락해 22,617.73으로 마감했고, 연초 대비 2.7% 하락하며 2026년 수익을 모두 잃었다. S&P 500은 3.7% 내려 6,910.39로, 다우지수는 949.73포인트(1.93%) 하락해 48,147.33으로 마감했으며, 두 지수 모두 최고점에서 10% 이상 하락했다. 나스닥-100은 5.6% 추락해 연중 고점 대비 20% 하락하며 약세장에 진입했다. 전체 요약 13문장 읽기 → 005 09:11 ▲ 102 · 댓글 35 AI 에이전트가 FPGA 추론칩을 33배 가속화하다 저자는 DeepGrove의 삼진법 가중치 아키텍처를 AWS F2 FPGA 인스턴스(16GB HBM)에 구현하기 위해 AI 코딩 에이전트를 활용했다. AI · 머신러닝 · Vibecoding an inference chip
Key Point 하드웨어 개발이 AI 에이전트로 급속도로 접근 가능해지면서, 엔지니어링 팀의 역량이 획기적으로 확장되는 시점을 보여준다.
핵심 요약
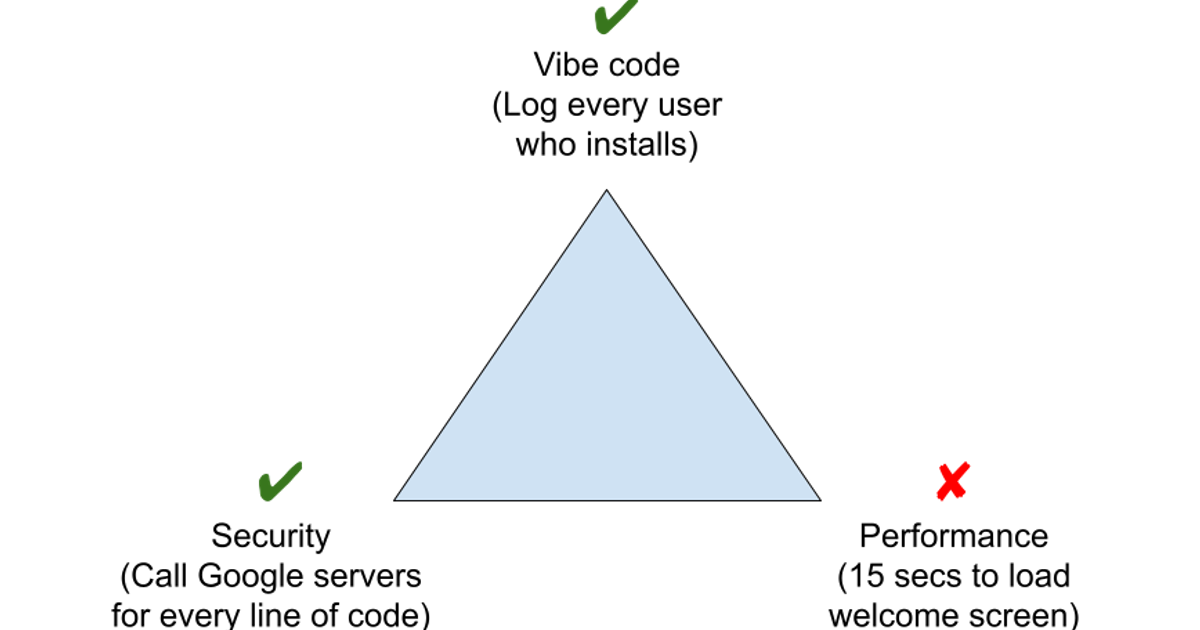
저자는 DeepGrove의 삼진법 가중치 아키텍처를 AWS F2 FPGA 인스턴스(16GB HBM)에 구현하기 위해 AI 코딩 에이전트를 활용했다. 에이전트가 C++과 Verilog로 약 3M줄의 코드를 작성했으며, $10,000의 토큰 비용으로 수백 개 실험을 거쳐 추론 속도를 초당 6.43 토큰에서 213 토큰으로 33배 향상시켰다. 최적화는 호스트 오버헤드 감소, 버스트 어텐션, 병렬 라우터, 글루 엔진, 스펙큘레이티브 디코딩, 웨이트 패킹, 헤드 로더 개선 등 14개 단계를 거쳐 각 단계마다 1.5배씩 복합 개선되었다. 전체 요약 8문장 읽기 → 006 06:11 ▲ 136 · 댓글 81 AI 도구 시대, 개발자의 역할이 아키텍트로 무조건 바뀐다 Google Forms 애드온의 로깅 코드가 사용자 이메일을 얻으려 여러 API 호출을 반복해 환영 화면 로딩에 15초가 걸리는 성능 문제가 발생했다. AI · 머신러닝 · We promoted developers into architects without informing them
Key Point AI 코드 생성 도구가 보편화되면서 개발자에게 요구되는 역량이 근본적으로 바뀌고 있으며, 이를 모르는 조직은 성능과 유지보수성 문제를 양산하고 있기 때문이다.
핵심 요약
Google Forms 애드온의 로깅 코드가 사용자 이메일을 얻으려 여러 API 호출을 반복해 환영 화면 로딩에 15초가 걸리는 성능 문제가 발생했다. AI가 작성한 코드는 기능적 요구사항과 보안·하위호환성만 최적화해 성능을 희생하고 중복된 데이터모델을 양산하는 아키텍처를 만든다. 개발자가 아키텍트여야 할 올바른 접근은 불합리한 요구사항에 반박하고, 타임스탬프만 기록하거나 비동기 처리로 문제를 푸는 것처럼 성능을 고려한 설계를 먼저 정의하는 것이다. 전체 요약 6문장 읽기 → 007 03:11 ▲ 104 · 댓글 27 나비에-스토크스 방정식 유한시간 폭발 증명, Lean으로 형식화 알뵈그와 버크마스터가 나비에-스토크스 방정식의 유한시간 폭발(finite-time blow-up) 증명을 담은 79페이지 논문과 그를 형식화한 Lean 4 코드를 공개했다. AI · 머신러닝 · Finite-time blow-up for the Navier–Stokes equations
Key Point 수백 년 미해결 문제로 꼽혀온 나비에-스토크스 방정식의 특정 조건에서 유한시간 내 해가 무한대로 발산한다는 증명이 형식검증까지 완료되었다는 점이 중요하다.
핵심 요약
알뵈그와 버크마스터가 나비에-스토크스 방정식의 유한시간 폭발(finite-time blow-up) 증명을 담은 79페이지 논문과 그를 형식화한 Lean 4 코드를 공개했다. 리포지토리는 원본 논문, 정리 1.1, 7.1, 따름정리 7.2, 부록B에 대응하는 Lean 형식 증명, 그리고 형식 증명이 논문과 다른 부분을 설명하는 문서를 포함한다. Lean 패키지는 약 2,270개 파일과 60만 줄의 코드로 이루어져 있으며, 전체 빌드에는 상당한 메모리와 시간이 필요하다. 전체 요약 6문장 읽기 → 008 03:11 ▲ 143 · 댓글 58 언어 모델이 스스로 가중치를 개선한다 언어 모델이 훈련 없이 자신의 가중치를 직접 수정해 성능을 올리는 '자체 재작성' 기법을 처음으로 선보였다. AI · 머신러닝 · Language Models Can Rewrite Their Own Weights
Key Point 언어 모델이 훈련 단계 없이 순전파만으로 자신의 가중치를 수정하는 새로운 메커니즘이 나타났으며, 이는 훈련과 추론의 경계를 무너뜨려 모델 개선의 패러다임을 바꿀 가능성을 보여준다.
핵심 요약
언어 모델이 훈련 없이 자신의 가중치를 직접 수정해 성능을 올리는 '자체 재작성' 기법을 처음으로 선보였다. 27B 오픈 모델이 자신의 가중치, 채점된 답변, 자신을 실행할 수 있는 능력을 받아 실패를 진단하고 가중치를 재작성하며 그레디언트나 훈련 없이 미본 문제에서 정확도를 6.6포인트 올렸다. 모델이 연속 8회 세션을 거쳐 연습 문제로 자신의 편집을 검증한 후 작동하는 것만 적용해 매번 성능을 개선했다. 전체 요약 8문장 읽기 → 009 00:11 ▲ 116 · 댓글 222 AGI 이후의 세계, 초지능(ASI) 시대 준비하기 DeepMind는 인공일반지능(AGI)이 현실화되면서 그 다음 단계인 초지능(ASI)에 대한 연구를 시작했다. AI · 머신러닝 · What Comes After AGI?
Key Point 향후 10년 AI 발전의 세 가지 복합 요인(하드웨어·알고리즘·투자)이 현재 추세대로 계속되면 인간 초지능 단계로 진입할 가능성이 충분히 높으며, 개발자와 정책입안자가 대비해야 할 여러 기술 경로를 제시한다.
핵심 요약
DeepMind는 인공일반지능(AGI)이 현실화되면서 그 다음 단계인 초지능(ASI)에 대한 연구를 시작했다. 초지능은 대규모 전문가 집단이 수년 걸릴 작업을 더 적은 자원으로 완료할 수 있는 수준의 시스템으로, 거의 모든 인간의 관심 영역에서 인간을 능가해야 한다. 지난 10년간 AI 발전은 하드웨어 개선(1.5배/년), 알고리즘 효율성 개선(3-6배/년), 계산 투자 증가(2.5배/년)가 복합되어 연간 10배 이상의 유효 계산 성장을 이뤘다. 전체 요약 11문장 읽기 → 010 00:11 ▲ 107 · 댓글 23 AI로 만든 최강 소코반 솔버, 기존 솔버 능가 Soksolv는 소코반(박스 밀어내기 퍼즐 게임) 솔버로 표준 벤치마크 양쪽에서 발표된 모든 솔버보다 많은 레벨(전체 13,315개 중)을 해결하며, 24개의 세계 최초 자동 클리어 기록을 포함했고 기존 솔버 대비 약 3.2배 빠르다. AI · 머신러닝 · The Strongest Sokoban Solver
Key Point AI 에이전트의 대규모 협력 개발 사례로, 복잡한 알고리즘 연구에서 프론티어 모델이 인간 개발자를 대체할 수 있음을 보여준다.
핵심 요약
Soksolv는 소코반(박스 밀어내기 퍼즐 게임) 솔버로 표준 벤치마크 양쪽에서 발표된 모든 솔버보다 많은 레벨(전체 13,315개 중)을 해결하며, 24개의 세계 최초 자동 클리어 기록을 포함했고 기존 솔버 대비 약 3.2배 빠르다. 개발자는 Claude Code와 약 430개의 서브에이전트(Sonnet, Opus, Fable 모델 조합)를 활용해 한 번의 14일 단일 세션으로 개발했으며, API 비용은 약 3,500달러였다. 소코반은 1982년 일본에서 출시된 게임으로 1997년 PSPACE-완전성이 증명되었으며, 작은 판도 수백 개에서 수천 개의 움직임이 필요한 거대한 탐색 공간을 가진다. 전체 요약 11문장 읽기 → 오늘의 주요당일 스타 상위 3건
01 AI · 머신러닝 03:11 게시
phone-harness/phone-harness
원제 phone-harness/phone-harness
스타 5,439 당일 +117 Python
Key Point 실제 기기를 AI가 직접 조작하는 환경이 가능해져, 에이전트 기반 스마트폰 자동화가 현실이 되었다.
핵심 요약
Claude Code, Codex 등 AI 에이전트가 스마트폰을 화면 터치, 스크롤, 타이핑으로 직접 제어할 수 있는 Phone Harness 프로젝트를 공개했다. iPhone은 macOS의 iPhone 미러링 윈도우를 통해, Android는 macOS·Linux·Windows에서 adb로 연결된다. 설정 시 iPhone은 macOS 15+, iOS 18+, 접근성 및 화면 녹화 권한이 필요하고, Android는 adb와 USB 디버깅이 필요하다. 전체 요약 8문장 읽기 → 02 AI · 머신러닝 03:11 게시
incoai/splash
원제 incoai/splash
스타 2,597 당일 +116 C++
Key Point Apple 맥 사용자가 외부 클라우드 없이 고성능 LLM을 로컬에서 돌릴 수 있는 선택지가 생겼으며, 기존 llama.cpp 대비 큰 폭의 속도 향상으로 실용성이 크게 높아졌다.
핵심 요약
Splash는 M3 이상 Apple 실리콘에서 Qwen·Ornith·Flint 등 27B~122B 모델을 로컬 추론하는 C++ 기반 엔진이다. DFlash2 추측적 디코딩, Metal 커널 최적화, 자동 메모리 계획을 조합해 동작하며, 비전·도구 호출·내장 채팅 UI를 지원한다. OpenAI/Anthropic 호환 API로 스트리밍, 도구 호출, JSON Schema 출력을 제공하고, 프리필 캐시 재사용으로 동시 요청을 자동 배칭한다. 전체 요약 12문장 읽기 → 03 AI · 머신러닝 03:11 게시
janhq/jan
원제 janhq/jan
스타 45,980 당일 +101 Rust
Key Point ChatGPT 같은 클라우드 AI 사용 없이 개인 PC에서 LLM을 완전히 오프라인으로 운영하고 싶은 개발자라면, Jan으로 프라이버시와 로컬 제어를 확보할 수 있습니다.
핵심 요약
Jan은 Llama, Gemma, Qwen 등 HuggingFace의 LLM을 다운로드해 로컬에서 100% 오프라인으로 실행하는 오픈소스 AI 도구다. OpenAI, Anthropic Claude, Mistral, Groq 등 클라우드 AI도 연동할 수 있으며, 로컬 서버(localhost:1337)에서 OpenAI 호환 API를 제공한다. 커스텀 AI 어시스턴트 생성, Model Context Protocol(MCP) 통합으로 에이전트 기능을 지원한다. 전체 요약 7문장 읽기 → 읽을 논문
Hugging Face Papers11 커뮤니티가 고른 오늘의 AI 논문
오늘의 주요추천 상위 3건
01 AI · 머신러닝 06:11 게시
원제 RL Post-Training in Diffusion Transformers Is Activation Steering
추천 17 댓글 2 Tuna Han Salih Meral, Kaan Oktay, Alec Helbling 외
Key Point 확산 모델의 성능 개선이 실제로는 복잡한 학습이 아니라 간단한 선형 시프트로 대부분 설명되며, 이는 RL 튜닝의 작동 방식에 대한 근본적인 이해를 제시한다.
핵심 요약
확산 트랜스포머의 강화학습(RL) 사후 학습이 시각 품질, 텍스트 렌더링, 구성 정확도를 크게 개선한다. 논문은 이러한 개선이 복잡한 입력 의존적 변환 학습이 아니라 간단한 입력 독립적 시프트로 대부분 설명할 수 있다는 가설을 검증했다. SD3.5-M에서 RL-튜닝된 LoRA(1,880만 파라미터)의 65배 적은 파라미터(29만)를 가진 고정 조향 벡터 세트를 모든 프롬프트·토큰·샘플링 시드에 동일하게 적용했다. 전체 요약 7문장 읽기 → 02 AI · 머신러닝 03:11 게시
원제 Training Vision Models for LLM-Driven Weight-Space Programming
추천 15 댓글 2 Timo Ropinski, Sebastian Kranz
Key Point LLM이 직접 신경망 가중치를 수정할 수 있다는 개념이 나오면서, 이를 더 효과적으로 만드는 학습 방법이 무엇인지 궁금해하는 연구자와 개발자들에게 실질적인 답을 제시한다.
핵심 요약
LLM이 신경망의 가중치를 직접 수정하는 '가중치 공간 프로그래밍'이 가능하다는 것이 알려졌으나, 이를 위한 전용 학습 방법이 무엇인지는 밝혀지지 않았다. 연구팀은 LLM이 비전 모델(합성곱 신경망, 비전 트랜스포머)을 편집하는 벤치마크를 구축했으며, Waterbirds·CIFAR-100·PACS·Entity-30 데이터셋에서 재레이블링과 오류 수정 작업을 수행했다. 2,600건 이상의 편집 프로세스를 평가했으며, 각 편집의 성공 여부·부작용·정확도 손실을 측정했다. 전체 요약 7문장 읽기 → 03 AI · 머신러닝 03:11 게시
원제 Learning What Actions Change: Action Effect Matching for Dynamics-Faithful World Models
추천 15 댓글 2 John Won, Yonghoon Dong, Jinwoo Shin
Key Point 로봇 정책 개발과 모델 기반 계획 시 시뮬레이션과 실제 환경의 불일치를 줄여 보다 신뢰할 수 있는 의사결정이 가능해진다.
핵심 요약
World models는 환경 역학을 예측하면서도 작은 행동 변화가 미래 관찰에 미치는 영향을 제대로 포착하지 못하고 있으며, 이는 로봇 정책 평가와 모델 기반 계획 같은 작업에서 문제가 된다. 연구진은 AFFECT라는 보조 학습 목표를 제안했으며, 이는 행동 변동으로 유도되는 시각적 변화의 분포를 학습한다. 방식은 작업 무관(task-agnostic) 인간 조종을 통해 학습된 정책의 행동에 시간적으로 상관관계 있는 노이즈를 주입하고, world model이 생성한 영상이 같은 초기 상태에서 반복 실행 없이 기록된 영상처럼 이 노이즈에 반응하도록 훈련한다. 전체 요약 6문장 읽기 → 전체 색인8건 · 분야별
AI · 머신러닝8건 001 18:11 ▲ 11 · 댓글 2 실시간으로 작업 실수를 감지하는 비디오 AI 모델 영상 속 사람의 절차적 작업을 모니터링할 때 실수를 실시간으로 감지해 복구할 기회를 주는 AI 모델을 연구했다. AI · 머신러닝 · Online Mistake Detection in Instruction-Conditioned Procedural Video
Key Point 실시간 작업 모니터링 AI가 필요한 산업(제조, 의료 절차 교육, 로봇 보조)에서 실제 적용 가능성을 높인 연구로, 기존 오프라인 방식의 한계를 온라인 감지로 극복했다.
핵심 요약
영상 속 사람의 절차적 작업을 모니터링할 때 실수를 실시간으로 감지해 복구할 기회를 주는 AI 모델을 연구했다. 일인칭 비디오, 작업 지시문, 이전 예측 정보만으로 현재 진행 중인 행동 단계를 파악하고 시간상 위치를 특정한다. 각 행동 시도를 올바름, 수정, 실수(slip), 정정, 추가 행동 등으로 분류하며, 생략된 단계는 비디오 끝난 후에 판정한다. 전체 요약 8문장 읽기 → 002 15:11 ▲ 10 · 댓글 5 GUI 테스트를 위한 상태 체크포인트 자동 합성 기법 LLM으로 GUI 소프트웨어 코드 생성이 보편화되면서, 오랜 상호작용 기록이 필요한 깊은 상태(deep state) 도달이 테스트의 주요 병목이 되고 있다. AI · 머신러닝 · StatePortal: Agentic Checkpoint Synthesis for Testing Deep States in Interactive Software
Key Point GUI 애플리케이션 테스트에서 복잡한 상태에 도달하는 반복 비용을 없애는 기술로, 각 커밋마다 재발생하는 테스트 오버헤드 문제를 해결한다.
핵심 요약
LLM으로 GUI 소프트웨어 코드 생성이 보편화되면서, 오랜 상호작용 기록이 필요한 깊은 상태(deep state) 도달이 테스트의 주요 병목이 되고 있다. StatePortal은 자연어 함수형 테스트 케이스와 소스 코드 접근만으로 그 상태를 복원할 수 있는 체크포인트를 합성하는 에이전트다. 체크포인트는 애플리케이션별 훅을 통해 복원되며, 온보딩 에이전트가 한 번만 훅을 연결하거나 합성해 반복 수정할 필요가 없다. 전체 요약 8문장 읽기 → 003 15:11 ▲ 10 · 댓글 2 AI 심사위원이 늘수록 학술지 리뷰 획일화 학술 논문 심사에서 여러 심사자가 지적하는 문제의 중복도를 분석한 연구다. AI · 머신러닝 · Twice-Told Critiques: Claim-Level Homogenization of Peer Review in the LLM Era
Key Point 학술 커뮤니티의 핵심 기능인 동료 검토 과정이 LLM 활용으로 인해 본래의 역할(다양한 관점의 지적)을 잃어가고 있다는 실증적 증거가 나왔기 때문입니다.
핵심 요약
학술 논문 심사에서 여러 심사자가 지적하는 문제의 중복도를 분석한 연구다. ICLR 학회에서 같은 단계 리뷰의 중복도가 2026년 12.0%에서 2027년 21.3%로 증가했으며, NeurIPS, ICML 및 F1000, PLOS 저널들도 연년 상승 추세를 보였다. 2027년 ICLR에서 세 번째 리뷰가 처음 두 리뷰에 비해 평균 5.46개의 새로운 지적을 추가했는데, 2026년에는 6.12개였다. 전체 요약 6문장 읽기 → 004 15:11 ▲ 10 · 댓글 2 루프 언어모델에 "지연 진입" 기법으로 5배 이상 속도 향상 루프 언어모델은 한정된 파라미터로 토큰당 같은 계층을 T번 반복하는 깊은 추론을 수행하지만, 기존 조기 종료 디코딩은 초기 단계 후 중단되면서 과거 토큰의 캐시된 키-값 상태가 얕은 깊이에만 머문다. AI · 머신러닝 · Late Entry in Looped Language Models
Key Point 루프 언어모델의 추론 깊이를 활용하면서 디코딩 지연을 대폭 줄이는 새로운 접근법으로, 소규모 모델에서도 큰 성능 향상을 얻을 수 있음을 실증한다.
핵심 요약
루프 언어모델은 한정된 파라미터로 토큰당 같은 계층을 T번 반복하는 깊은 추론을 수행하지만, 기존 조기 종료 디코딩은 초기 단계 후 중단되면서 과거 토큰의 캐시된 키-값 상태가 얕은 깊이에만 머문다. 연구진은 반대 전략인 '지연 진입'을 제안했으며, 여기서 새 토큰이 초기 단계를 건너뛰고 깊은 컨텍스트 캐시의 마지막 K < T 패스에만 직접 진입한다. 경량 미세조정으로 진입 경계의 은닉 상태 정규화 불일치를 해결하면, 깊은 캐시가 건너뜀 토큰의 로컬 단계를 대체하여 지연 진입이 조기 종료를 능가한다. 전체 요약 7문장 읽기 → 005 12:11 ▲ 10 · 댓글 3 영상 편집 자동화 평가하는 벤치마크 'RoughCut-Bench' 공개 영상 미디어 제작 초기 단계인 '러프컷'(원본 영상을 조직화한 초안)을 자동으로 수행하는 대규모 비전-언어 모델(LVLM) 평가를 위해 RoughCut-Bench 벤치마크를 제안했다. AI · 머신러닝 · RoughCut-Bench: A Benchmark for Automatic Video Rough-Cut with Large Vision-Language Models
Key Point 영상 편집은 미디어 제작의 핵심 단계이지만 아직 자동화 평가 기준이 없었는데, 이 벤치마크가 LVLM의 편집 능력을 체계적으로 측정할 수 있게 해준다.
핵심 요약
영상 미디어 제작 초기 단계인 '러프컷'(원본 영상을 조직화한 초안)을 자동으로 수행하는 대규모 비전-언어 모델(LVLM) 평가를 위해 RoughCut-Bench 벤치마크를 제안했다. 벤치마크는 두 가지 실무적 설정을 포함한다: 영상 중심 설정은 101개 사례에 831개 원본 영상과 1,476개 하이라이트 주석을 담고 있으며, 하이라이트 감지·선택, 소스 영상 정렬, 사용자 요구사항 준수를 다룬다. 음성 중심 설정은 84개 사례로 구성되며, 자동 음성 인식(ASR) 텍스트에서 필러 제거, 표현 중복 제거, 저가치 콘텐츠 트리밍을 평가한다. 전체 요약 6문장 읽기 → 006 09:11 ▲ 11 · 댓글 2 AI가 GPU 커널 최적화 경쟁 1위 석권 CompoundingKernel은 LLM 기반 자기개선 에이전트 시스템으로, 검색을 통해 GPU 커널을 작성한다. AI · 머신러닝 · CompoundingKernel: Self-Improving from Zero to First
Key Point 생성형 AI가 고난도 시스템 프로그래밍 작업에서 사람의 최적화된 코드를 압도하면서, AI 기반 커널 개발의 실현 가능성을 보여준다.
핵심 요약
CompoundingKernel은 LLM 기반 자기개선 에이전트 시스템으로, 검색을 통해 GPU 커널을 작성한다. NVIDIA B200용 SOL-ExecBench의 L1, L2, Quantization 보드에서 모두 1위를 차지했으며, L1 보드에서는 2026-10-27부터 (2026-11-07 하루를 제외하고) 1위를 유지하고 있다. 235개 문제 모두에서 검증된 올바른 커널을 생성했고, 공개 보드의 209개 문제에서는 기준 베이스라인보다 4.40배 빠르다. 전체 요약 10문장 읽기 → 007 03:11 ▲ 14 · 댓글 2 같은 모델을 더 좋은 교사로 만드는 자동 학습 최적화 작업 성공만으로는 어떤 행동을 학습해야 할지 알 수 없어, 성공한 교사의 궤적에도 근거 없는 가정·반복·피상적 검증이 담길 수 있다는 문제를 제시한다. AI · 머신러닝 · AutoMaster: Autonomous Post-Training by Making the Same Model a Better Teacher
Key Point 성공한 학습 결과물도 비효율적 행동을 담을 수 있다는 근본 문제를 자동 최적화로 해결하는 방식으로, 고정된 모델의 교사 역할을 개선하는 새로운 패러다임을 제시한다.
핵심 요약
작업 성공만으로는 어떤 행동을 학습해야 할지 알 수 없어, 성공한 교사의 궤적에도 근거 없는 가정·반복·피상적 검증이 담길 수 있다는 문제를 제시한다. 이를 해결하기 위해 자연어 스킬 지시문으로 바람직하지 않은 습관을 억제하고 효과적이지만 과소 대표된 행동을 이끌어내는 Skill-FT 방식을 제안한다. LLM 에이전트가 궤적 분석·스킬 설계·데이터 선택·롤아웃 피드백을 통해 이런 개입 전략을 자동으로 개발하는 AutoMaster 시스템을 소개한다. 전체 요약 7문장 읽기 → 008 03:11 ▲ 13 · 댓글 2 하이브리드 어텐션 모델 변환 성능 개선하는 FlashMorph2 하이브리드 어텐션 모델은 풀 어텐션과 선형 어텐션을 결합해 품질과 효율의 균형을 맞춥니다. AI · 머신러닝 · On-Policy Morphing into Hybrid Attention Models
Key Point 하이브리드 어텐션 모델 변환 시 최적의 레이어 선택 방법이 개선되면서 기존 대비 추론 효율을 유지하면서 성능을 높이는 새로운 접근 방식이 제시되었습니다.
핵심 요약
하이브리드 어텐션 모델은 풀 어텐션과 선형 어텐션을 결합해 품질과 효율의 균형을 맞춥니다. 기존 Transformer를 하이브리드 모델로 변환할 때 정해진 예산 내에서 어느 레이어가 풀 어텐션을 유지할지 선택해야 합니다. 기존 FlashMorph는 두 가지 문제가 있습니다: (1) 연속 보간 평가와 실제 이산 하이브리드 계산이 다르고, (2) 가중치가 고정되어 이후 적응 과정을 반영하지 못합니다. 전체 요약 6문장 읽기 → ● 이번 피드는 여기까지입니다.
작은 발견을 다음 커밋으로 이어가세요. 모든 발행본