매일 쌓이는 개발자의 시야
2026년 11월 22일 (일).
세상의 기술 소식, 한국어로 한눈에.
읽을 이야기, 써볼 도구, 논문과 새 버전까지.
AI 요약 안내AI가 한국어로 정리한 내용입니다. 정확한 정보는 각 카드의 원문을 확인해 주세요.
요약 원칙 ↗ AI · 머신러닝 분야 · 8건 필터 해제 ×
오늘의 주요포인트 상위 6건
01AI · 머신러닝
원제 Lean verification of the Riemann Hypothesis
433 포인트댓글 336

Key Point150년 이상 미해결된 수학 최대 난제를 형식 증명으로 해결한 것으로, 수학 증명의 컴퓨터 검증 가능성을 보여주는 역사적 사건이다.
핵심 요약
- 2026년 11월 20일 레벤트 알푀게가 1,700만 줄의 Lean 라이브러리로 리만 가설의 증명을 발표했다.
- 증명은 Mathlib에만 직접 의존하며, Lean과 Mathlib 커뮤니티가 정확성을 집단으로 검증했다.
- 리만 가설의 명제는 Mathlib에 포함되어 있으며 Lean과 수론 전문가들이 엄격히 검토했다.
전체 요약 8문장 읽기 →02AI · 머신러닝
원제 Inkling-2-Mini in 5.4 GB Memory
234 포인트댓글 46

Key Point대형 LLM을 Apple Silicon에서 실시간 실행 가능한 크기로 압축하면서 성능 손실을 최소화하는 기술로, 모바일과 엣지 디바이스에서의 LLM 활용 방식을 바꿀 수 있다.
핵심 요약
- LookAtMyQuant는 양자화 컴파일러로, 압축 시 모델 각 부분이 출력에 미치는 손상을 측정해 가장 작은 손상으로 목표 용량에 맞추는 코드를 선택한다.
- Gemma 4 E2B에서 같은 파일 크기 기준 GGUF가 Q4_K_M보다 KL(Kullback-Leibler divergence)이 12배 낮다.
- Qwen3.5-4B를 1.23GB(2.3비트/가중치)로 압축하면 540개 수학 문제 중 330개를 풀고, Prism ML의 Bonsai 2는 같은 크기에서 328개를 푼다(원본은 359개).
전체 요약 12문장 읽기 →03AI · 머신러닝
원제 ClawDOS – An AI coding agent for DOS
122 포인트댓글 35
Key Point1980년대 하드웨어에서 최신 AI가 직접 코드를 작성·실행하는 교집합은, 프롬프트 캐싱과 도구 사용 같은 AI 에이전트 기능의 가능성을 극단적인 환경에서 보여준다.
핵심 요약
- 클로드 AI가 만든 ClawDOS는 8088 프로세서 4.77MHz, 640K RAM, CGA 카드 사양의 IBM PC XT 위에서 동작하는 AI 코딩 에이전트다.
- HARNESS.EXE라는 176KB 도스 프로그램이 클로드 Messages API를 직접 구현하며, TLS를 제외한 모든 작업을 8088에서 처리하고 별도의 PC에 설치된 TLS 터널로 통신한다.
- 사용자는 DOS 프롬프트에서 CLAWDOS를 입력해 클로드와 대화하면, AI가 디스크의 파일을 읽고 수정하고, 프로그램을 작성·컴파일하며, 실행 결과를 보고 반응한다.
전체 요약 11문장 읽기 →04AI · 머신러닝
원제 Pill to treat pancreatic cancer hailed as 'biggest breakthrough in decades'
120 포인트댓글 33
Key Point췌장암은 영국에서 모든 일반 암 중 생존율이 가장 낮은데, 이 신약이 1년 생존율을 거의 두 배로 높이고 일부 환자에서 암을 완전히 감지 불가 수준으로 만들었다는 점이 중요하다.
핵심 요약
- KRAS 억제제인 다락손라싶 임상시험에서 진행성 췌장암 환자 중 약 8%의 암이 CT에서 감지 불가 수준으로 사라졌고, 90%의 환자에서 종양 성장이 멈췄다.
- 1년 추적 관찰 결과 환자의 76.6%가 생존했는데, 화학요법 단독 치료 시 보통 40~45%의 1년 생존율과 비교할 때 거의 두 배에 가까운 성과다.
- 시험에 참여한 61명의 환자는 신체 다른 부위로 전이된 진행성 췌장암 진단을 최근 받았으며, 평균 18개월 추적 관찰 기간 동안 일부 환자는 암이 재발하지 않았다.
전체 요약 7문장 읽기 →05AI · 머신러닝
원제 Astra 6.2 and Sol 6.2 flop at Simple Bench
119 포인트댓글 103
Key Point최신 LLM들이 인간 기준선에 미치지 못하는 구체적인 사례로, LLM 평가의 맹점과 현재 모델의 한계가 무엇인지 명확히 보여준다.
핵심 요약
- SimpleBench는 고등학교 수준의 일반 지식으로도 풀 수 있는 다지선다형 텍스트 벤치마크로, 200개 이상의 질문을 시공간 추론·사회적 지능·언어적 적대 견고성(트릭 질문)으로 구성했다.
- 대부분의 텍스트 기반 벤치마크에서는 LLM이 일반인을 능가하고 전문가 성능도 초과하지만, SimpleBench에서는 비전문가 인간의 정확도가 83.7%로 모든 테스트 모델을 상회했다.
- 당대 최고 성능의 Claude Fable이 81.9%에 그친 반면, 9명 참가자의 소규모 표본에 기반한 인간 기준선이 모든 LLM을 능가했다.
전체 요약 5문장 읽기 →06AI · 머신러닝
원제 AI is giving everyone the same advice
103 포인트댓글 43
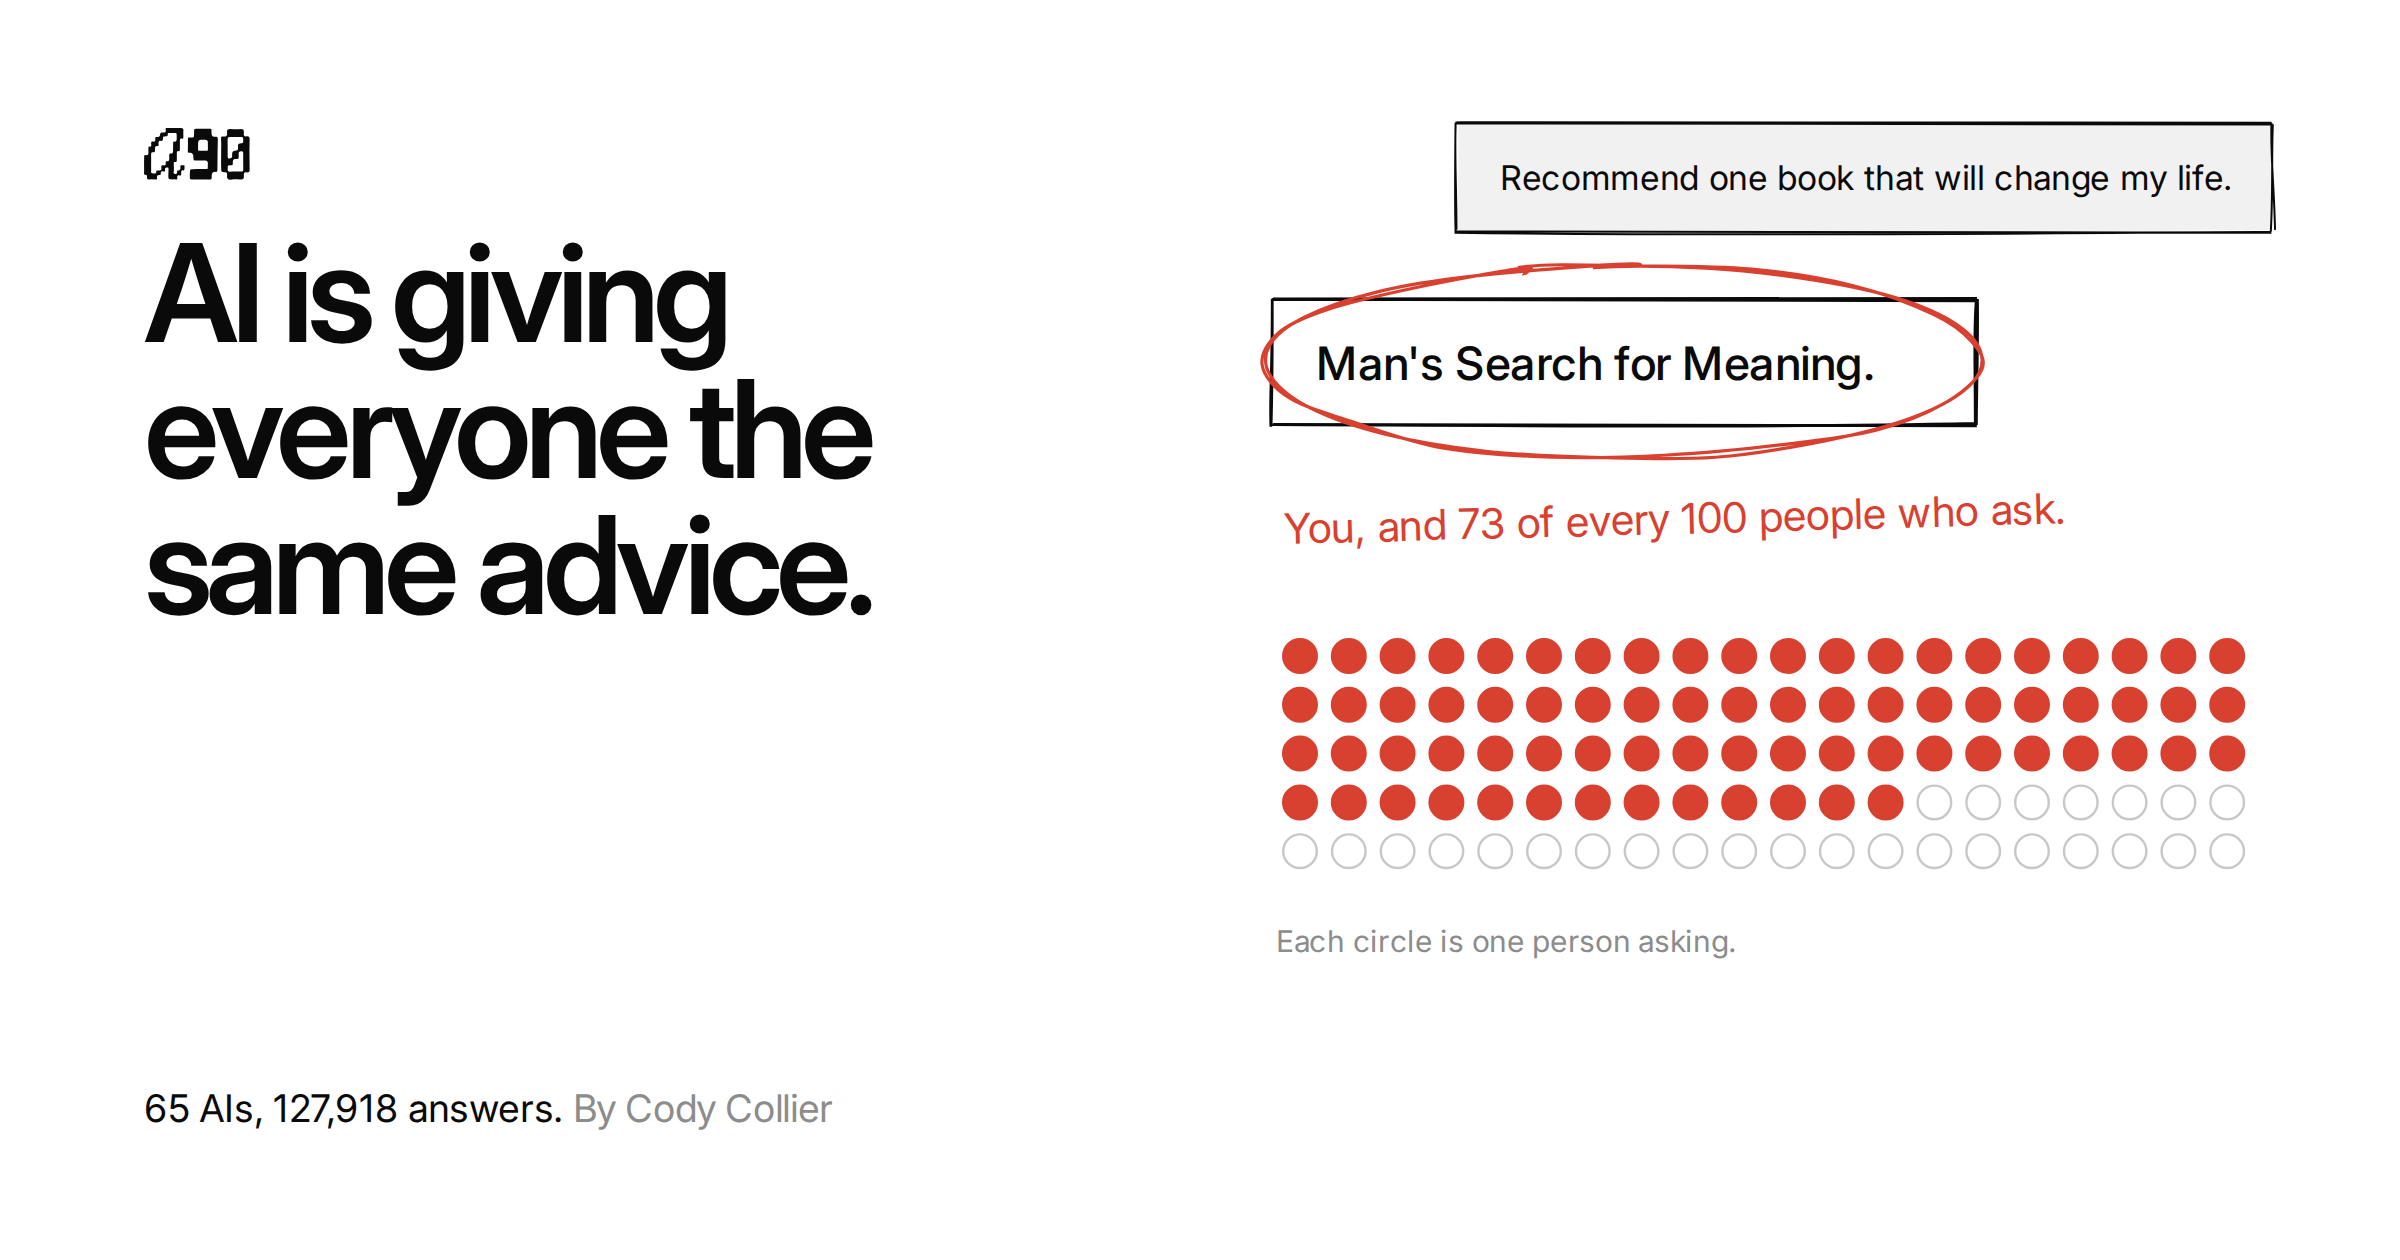
Key Point생성형 AI가 개인화된 답변을 준다고 느끼지만 실제로는 대다수 사용자가 같은 조언을 받고 있으며, 이는 개인의 의사결정을 획일화할 위험을 보여준다.
핵심 요약
- 연구자가 65개 AI 모델에 같은 질문을 10번씩 반복해 조사한 결과, 스타트업 이름의 69%가 'Nex'로 시작하는 등 거의 모든 모델이 같은 답변을 제시했다.
- 영화·저녁 식사·이름 같은 창의적 질문은 다양하지만, 투자처·거주지·학습 주제 같은 인생 결정 조언은 한 답변에 35% 이상이 몰려 수렴 경향이 심하다.
- 사용자가 자신을 한 문장으로 설명해도 모두가 같은 '차선'으로 분류되며, 같은 답변을 받는다.
전체 요약 13문장 읽기 →전체 색인1건 · 분야별
AI · 머신러닝1건
001▲ 101 · 댓글 76LLM이 기계 코드를 16진법 덤프에서 직접 읽고 쓴다기존에는 컴파일러·어셈블러·디스어셈블러 같은 도구가 필요했지만, LLM이 기계 코드 바이트를 직접 조작할 수 있음을 보였다.AI · 머신러닝 · LLMs can read and write executables byte by byte from a hex dump
Key Point역공학과 악성코드 분석의 가장 느린 단계인 디스어셈블·디컴파일이 선택사항이 될 수 있다는 점이 중요하다.
핵심 요약
- 기존에는 컴파일러·어셈블러·디스어셈블러 같은 도구가 필요했지만, LLM이 기계 코드 바이트를 직접 조작할 수 있음을 보였다.
- Claude를 포함한 LLM에 16진법 덤프를 주면 프로그램의 기능을 정확히 파악했으며, FreeBSD의 ministat 도구에서 실제 버그(신뢰도 99.5% 옵션이 99.8%의 임계값을 사용)까지 찾아냈다.
- LLM은 바이너리 패치도 수행했는데, 패딩 공간에 새 코드를 써서 기존 명령어를 덮어썼고, 추가 기능 요청 시 바이트 단위 수정 목록을 제시해 모든 테스트를 통과했다.
전체 요약 8문장 읽기 → 읽을 논문
Hugging Face Papers01
커뮤니티가 고른 오늘의 AI 논문
오늘의 주요추천 상위 1건
01AI · 머신러닝
원제 VSpark: Speculative Decoding for Autoregressive Vision-Language-Action Models
추천 10댓글 3Suho Yoo, Youngjoon Jang, Hyebin Cho 외

Key Point로봇 제어 모델의 추론 속도 문제를 근본적으로 해결하는 기법으로, 다양한 로봇 플랫폼에서 2배 이상의 성능 향상을 무손실로 달성하는 실용적 가치가 있다.
핵심 요약
- 로봇 동작을 한 번에 하나씩 생성하는 자동회귀 비전-언어-행동(VLA) 모델의 추론을 가속하기 위해 추측 디코딩 기법을 적용했다.
- 경량의 초안 모델이 여러 토큰을 한 번에 제안하고, VLA가 이를 한 번의 패스로 검증해 일치하는 것만 수용함으로써 손실 없는 디코딩을 유지한다.
- 로봇 제어에서는 여러 토큰이 거의 같은 동작을 인코딩할 수 있어 초안 모델의 토큰이 올바른 행동에 가까워도 거부되는 문제가 있었다.
전체 요약 5문장 읽기 →●이번 피드는 여기까지입니다.
작은 발견을 다음 커밋으로 이어가세요.