매일 쌓이는 개발자의 시야
2026년 11월 19일 (목). 세상의 기술 소식, 한국어로 한눈에.
AI 요약 안내 AI가 한국어로 정리한 내용입니다. 정확한 정보는 각 카드의 원문을 확인해 주세요.
요약 원칙 ↗ 01 읽을 소식Hacker News 13건 ↓ 02 써볼 도구GitHub Trending 2건 ↓ 03 읽을 논문Hugging Face Papers 15건 ↓ 04 새 버전GitHub Releases 0건 ↓ AI · 머신러닝 분야 · 30건 필터 해제 ×
오늘의 주요포인트 상위 6건
01 AI · 머신러닝 09:11 게시
원제 Gemini 4 Neon
342 포인트 댓글 331
Key Point Carbon보다 빠르고 저렴하면서 프론티어급 성능을 유지하는 새로운 모델이 출시되어, 기존 성능-비용 트레이드오프를 재정의하고 있다.
핵심 요약
구글이 Gemini 4 Neon을 공개했으며, 복잡한 소프트웨어 엔지니어링, 지식 업무, 과학 워크플로우에서 프론티어급 지능을 제공하면서 빠른 작업 완료를 목표로 한다. 입력 토큰 300만 개당 $3(캐시된 입력 토큰은 95% 할인가인 150만 개당 $3), 출력 토큰 300만 개당 $15의 가격으로 100만 토큰 컨텍스트 윈도우를 제공한다. Artificial Analysis Intelligence Index에서 xhigh thinking 레벨로 61점을 기록하며 같은 급의 모델 중 1위, 전체 3위를 차지했고, Vals Index에서는 2위를 기록했다. 전체 요약 16문장 읽기 → 02 AI · 머신러닝 06:11 게시
원제 AI agents ask better questions than KPMG accountants in audit trial
202 포인트 댓글 101
Key Point 회계감사 업계의 근본적 비즈니스 모델이 AI로 인해 변할 수 있음을 시사하는 사례로, 전문직 종사자들의 역할 재정의와 금융 산업 구조 변화의 신호이기 때문이다.
핵심 요약
KPMG UK가 100개 이상의 AI 에이전트로 진행한 'Project Exponential' 실험에서 AI가 인간 감사팀보다 재무 문제를 더 깊이 조사하고 나은 질문을 제기했다고 발표했다. AI 에이전트들은 행정 보조가 아닌 감사 전 과정에 걸쳐 정보 수집, 데이터 분석·문서화, 결론 도출, 다음 단계 제안을 수행했으며, 에이전트 간 협력도 가능했다. 약 4개월 간 개발된 이 기술은 FTSE 250 상장사의 재무제표를 대상으로 했지만, 정식 법정 감사는 아니었으며 감사 파트너의 최종 승인이 필요했다. 전체 요약 10문장 읽기 → 03 AI · 머신러닝 00:11 게시
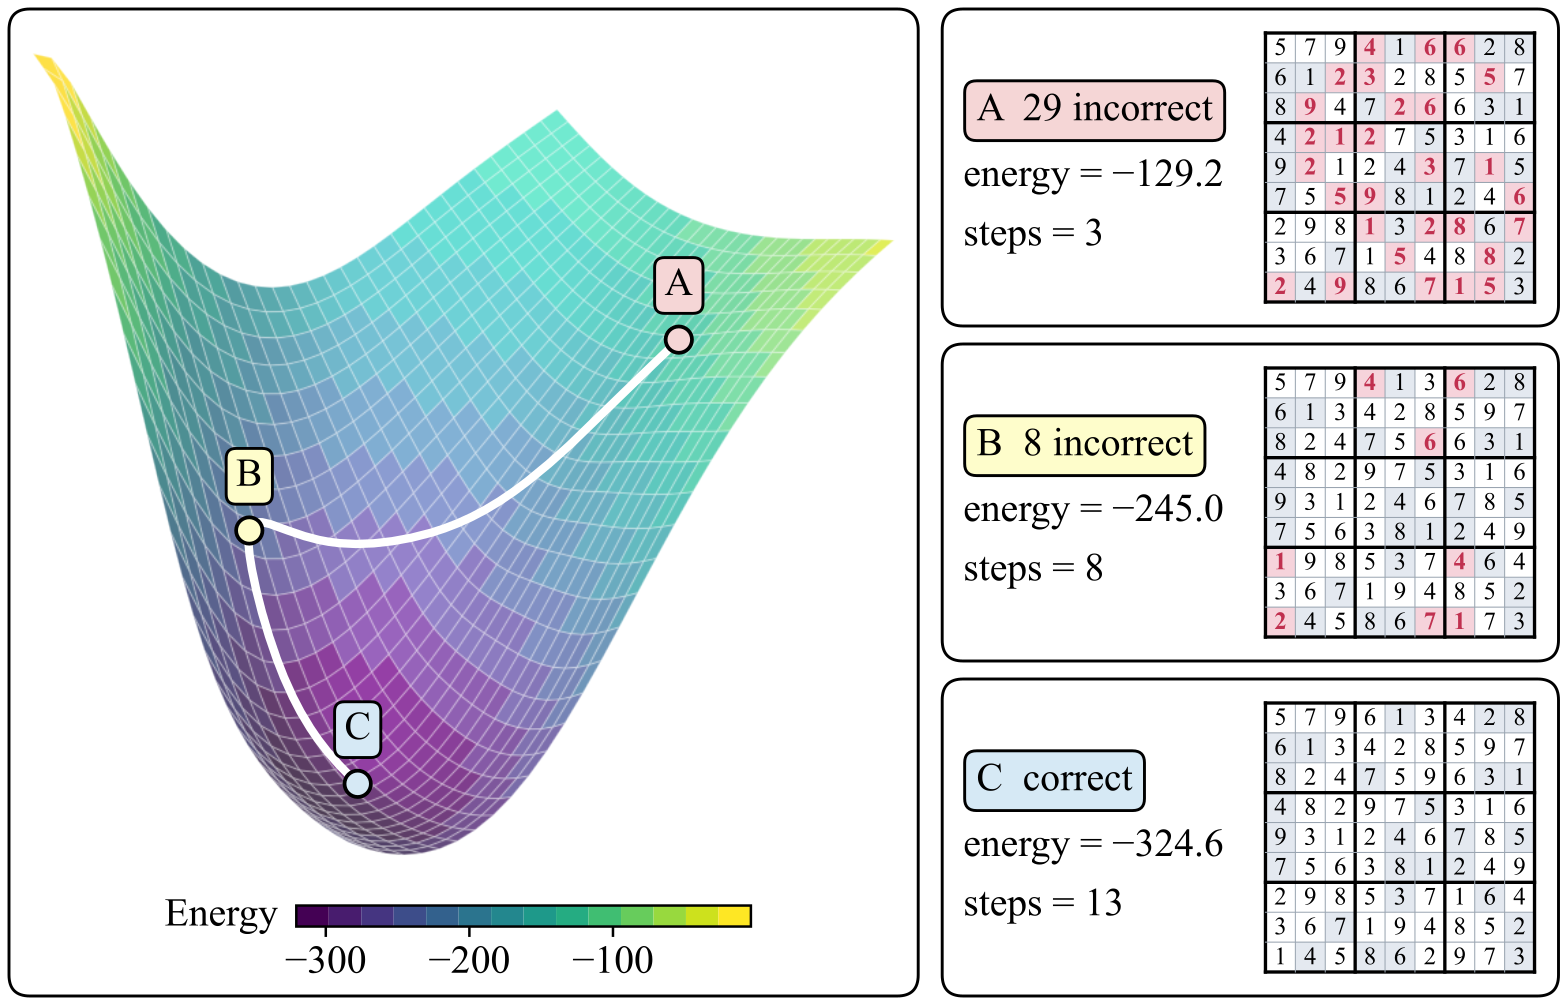
원제 Energy-Based Reasoners: 385x more efficient inference
201 포인트 댓글 29
Key Point 반복적 추론 작업에서 추론 연산을 300배 이상 감축하면서도 정확도는 유지하는 방법론이 제시되어, 에너지 기반 접근이 추론 효율성의 새로운 방향을 보여준다.
핵심 요약
반복 루프를 통해 추론 성능을 높이는 기존 모델들은 언제 멈춰야 할지, 현재 상태가 얼마나 좋은지 판단할 명시적 지표가 없다는 문제가 있었다. 에너지 기반 추론 모델(EBR)은 잠재 추론 상태에 대한 에너지 함수를 학습하고, 반복 업데이트를 이 에너지에 대한 경사하강법으로 수행한다. 에너지 점수는 추론 상태의 품질을 평가하고, 그 기울기는 개선 방향을 제시하며 동시에 멈춤 신호로 작동한다. 전체 요약 8문장 읽기 → 04 AI · 머신러닝 03:11 게시
원제 Microsoft AI: Seven new world-class models at scalable price-performance
166 포인트 댓글 105
Key Point 엔터프라이즈급 AI 모델 시장이 성능에서 경쟁을 넘어 가격-성능비 경쟁으로 급격히 재편되고 있으며, 마이크로소프트의 대규모 모델 공개는 개발자와 기업의 AI 도입 비용 구조를 크게 바꿀 수 있기 때문이다.
핵심 요약
마이크로소프트가 MAI 모델 7종을 발표했으며, 가격-성능비를 중심으로 경쟁 모델들을 압도한다고 주장했다. MAI Cyber 2 Flash는 GPT-6 Astra의 품질을 2% 미만의 비용으로 구현하며, 사이버보안 24/7 운영을 위해 설계됐다. MAI Code 2는 GPT-6.1 Sol의 98% 성능을 40% 가격에, Claude Opus 5.5의 96% 성능을 5% 가격에 제공한다. 전체 요약 12문장 읽기 → 05 AI · 머신러닝 03:11 게시
원제 'Human' Is Cambridge Dictionary's Word of the Year 2026
144 포인트 댓글 102
Key Point AI와 인간의 경계가 흐려지는 가운데 창의성·초상권·직업 존속까지 광범위한 영역에서 '인간다움'을 지키려는 사회적 움직임이 가시화됐다.
핵심 요약
캐임브리지 사전이 'human(인간)'을 2026년 올해의 단어로 선정했다. AI가 인간과 기계의 경계를 흐리면서 '인간다움이란 무엇인가'를 둘러싼 글로벌 논쟁이 확산되는 가운데 이 선택이 나왔다. 빌 게이츠는 돌봄 업무처럼 기계가 절대 대체해선 안 될 '인간 보유 직업'의 중요성을 주장했고, AI 고도의 아버지 제프리 힌튼은 '우리는 외계 생명체를 만들고 있다. 나는 인간을 선택하겠다'고 경고했다. 전체 요약 8문장 읽기 → 06 AI · 머신러닝 15:11 게시
원제 LLM assisted reverse engineering
136 포인트 댓글 38
Key Point 저가의 LLM 접근성으로 오픈소스 도구·에이전트 스킬·과학적 방법론을 조합한 역공학 워크플로우가 연간 작업을 주 단위로 단축시킬 수 있음을 실제 사례로 증명했다.
핵심 요약
20년 경력의 해커가 2026년 현재 LLM 기반 역공학 프로세스를 공개했다. DeepSeek Harness + DeepSeek v4.1 Flash를 AI로 사용하고, Ghidra MCP 브리지·radare2·kuna 등 무료 디스어셈블러와 디컴파일러를 도구로 구성했다. 프로세스는 바이너리를 에이전트에 지정한 후 전용 스킬로 분석하는 식으로, 바이너리 타입·플랫폼·빌드 확인 → 기본 구조 분석(주요 함수·브랜칭·임포트 함수) → 필요시 디버깅·로깅·외부 접근을 통한 추가 조사 순서로 진행한다. 주요 에이전트 스킬은 Grill Me(5개 질문으로 진행 방향 결정)·Ghidra 도구 설명·Java Agent 스킬·가설 디버깅(CSV 테이블로 가설 기록 → 실험 설계 → 결과 기록의 반복) 등으로, 에이전트가 무한 반복에 빠지지 않도록 과학적 방법론을 강제한다. 전체 요약 6문장 읽기 → 전체 색인7건 · 분야별
AI · 머신러닝7건 001 15:11 ▲ 105 · 댓글 29 부분 평가로 인터프리터를 컴파일러로 변환하기 부분 평가(partial evaluation)는 컴파일 타임에 계산할 수 있는 부분은 미리 계산하고, 런타임 의존 부분만 남기는 최적화 기법이다. AI · 머신러닝 · The Magic of Partial Evaluation
Key Point 인터프리터 작성이 컴파일러 개발보다 훨씬 쉬운 상황에서, 부분 평가 기법으로 자동으로 컴파일러를 도출할 수 있다는 이론이 실제로 작동하는 방식을 보여준다.
핵심 요약
부분 평가(partial evaluation)는 컴파일 타임에 계산할 수 있는 부분은 미리 계산하고, 런타임 의존 부분만 남기는 최적화 기법이다. 팩토리얼·거듭제곱 같은 단순한 함수부터 산술 연산 인터프리터까지, 부분 평가를 적용하면 불필요한 계산과 함수 호출을 제거할 수 있다. 첫 번째 푸타무라 사영(Futamura Projection): 인터프리터와 프로그램에 부분 평가를 적용하면 그 프로그램의 컴파일된 버전을 얻는다. 전체 요약 8문장 읽기 → 002 12:11 ▲ 106 · 댓글 36 젬미니 4 네온, 오푸스 5.5와 동등한 수준의 경쟁자 구글이 출시한 젬미니 4 네온은 젬미니 4 카본의 성능을 유지하면서 추론 속도를 크게 개선한 모델이다. AI · 머신러닝 · Gemini 4 Neon looks like an Opus 5.5 competitor
Key Point 카본이 느린 속도로 인해 가능성을 살리지 못했던 가운데, 네온이 최고 수준 모델과 동등 성능에 훨씬 빠른 속도로 실용적인 대안이 될 수 있음을 보여준다.
핵심 요약
구글이 출시한 젬미니 4 네온은 젬미니 4 카본의 성능을 유지하면서 추론 속도를 크게 개선한 모델이다. 카본은 Agent Duel 리더보드에서 가장 좋은 성능을 보이지만 초당 46토큰의 느린 속도가 문제였고, 네온은 OpenRouter를 통해 초당 127토큰으로 2.7배 빠르다. 이를 바탕으로 성능을 모델링하면 네온의 예상 Elo 점수는 1,066으로, 오푸스 5.5의 1,078에 거의 근접한다. 전체 요약 5문장 읽기 → 003 12:11 ▲ 107 · 댓글 57 앤스로픽, 주당 83달러에 IPO 공식 가격 결정 앤스로픽이 Class A 보통주를 주당 83달러에 IPO 공식 가격으로 결정했다. AI · 머신러닝 · Anthropic prices initial public offering
Key Point 생성형 AI 분야의 주요 플레이어인 앤스로픽의 미국 상장으로, AI 산업 투자 환경과 글로벌 AI 경쟁이 가시화되는 중요한 신호다.
핵심 요약
앤스로픽이 Class A 보통주를 주당 83달러에 IPO 공식 가격으로 결정했다. IPO는 총 9억 8천만 주로 구성되며, 이 중 앤스로픽이 9억 5,635만 주를 판매하고 기존 주주가 2,364만 주를 판매한다. 앤스로픽은 기존 주주가 판매한 주식으로부터는 수익을 얻지 못한다. 전체 요약 6문장 읽기 → 004 09:11 ▲ 116 · 댓글 32 1,200개 과제로 Qwen 미세조정, 터미널 벤치 성능 2배 향상 RadixArk가 Qwen3.8-27B 기반의 DaisyRose-27B 모델을 공개했으며, 1,200개의 정교하게 선별된 과제로 강화학습 훈련을 진행했다. AI · 머신러닝 · DaisyRose-27B: 1,200-task RL took Qwen3.8 from 5.6% to 12% on Terminal-Bench 4.1
Key Point 장기 추론 작업을 위한 에이전트 모델을 효율적으로 훈련하는 새로운 패턴을 보여주며, 고비용의 RL 훈련을 제한된 리소스로 수행 가능하게 한 기술적 차별성이 있다.
핵심 요약
RadixArk가 Qwen3.8-27B 기반의 DaisyRose-27B 모델을 공개했으며, 1,200개의 정교하게 선별된 과제로 강화학습 훈련을 진행했다. Terminal-Bench 4.1에서 기존 모델의 5.6%에서 12.0%로 성능이 향상되었으며, 추론·명령 따르기·코딩 벤치마크에서도 개선되었다. 훈련 과제는 모델의 취약점을 의도적으로 노출하고, 100개 이상의 도구 호출과 256k 토큰 이상의 출력을 포함하는 장기적인 연쇄 작업으로 설계되었다. 전체 요약 9문장 읽기 → 005 06:11 ▲ 116 · 댓글 96 구글, 세계 생성 AI 'Genie 4' 공개…실시간 편집과 음성 추가 구글 DeepMind가 Project Genie의 새로운 버전 Genie 4를 Google AI Ultra 구독자 대상으로 출시했다. AI · 머신러닝 · Genie 4 is now available
Key Point 대화식 세계를 실시간으로 편집하고 음성까지 더해 생성할 수 있는 AI 도구가 출시되며, 개인 창작물 공유 생태계까지 갖춰 AI 창의성 도구의 새로운 수준을 제시한다.
핵심 요약
구글 DeepMind가 Project Genie의 새로운 버전 Genie 4를 Google AI Ultra 구독자 대상으로 출시했다. Genie 4는 가장 현실적인 세계 모델로, 세션 중에 프롬프트를 입력해 생성된 세계를 실시간으로 편집할 수 있다. 날씨 변경, 캐릭터 추가, 액션 재설정 등이 가능하며, 처음으로 실시간 네이티브 오디오를 지원해 환경음과 대사가 장면에 맞춰 적응한다. 전체 요약 10문장 읽기 → 006 06:11 ▲ 104 · 댓글 24 세레브라스, GPU와 조합한 비집약형 추론으로 메가와트당 5배 처리량 세레브라스가 GPU와 자사 웨이퍼 스케일 엔진을 조합하는 비집약형 추론(disaggregated inference) 솔루션을 프로덕션 단계에 배포했다. AI · 머신러닝 · Cerebras Disaggregated Inference
Key Point 대규모 AI 에이전트 서비스의 초고속 응답 요구에 맞추기 위해 GPU와 전문 칩을 결합하는 인프라 아키텍처로의 전환이 시작되었으며, 이는 LLM 추론 비용 구조의 근본적인 변화를 예고한다.
핵심 요약
세레브라스가 GPU와 자사 웨이퍼 스케일 엔진을 조합하는 비집약형 추론(disaggregated inference) 솔루션을 프로덕션 단계에 배포했다. 에이전트 애플리케이션 수요 증가로 전력 제약 환경에서 메가와트당 더 많은 추론 용량을 제공해야 하는 과제에 대응하기 위한 것이다. 구조는 GPU가 프롬프트 처리(prefill) 담당, 세레브라스 시스템이 응답 생성(decode) 담당으로 분리한다. 전체 요약 7문장 읽기 → 007 00:11 ▲ 118 · 댓글 54 Claude, 단백질 서열 대규모 학습 받은 것으로 드러나 Claude Fable 5.2와 Opus 5.5는 단백질 서열을 대규모로 학습받았으며, 연구된 적 거의 없는 박테리아 단백질의 다음 아미노산을 예측할 수 있다. AI · 머신러닝 · Claude was trained on protein sequences at scale
Key Point Claude가 단백질 서열을 대규모로 학습받았다는 것은 생물정보학 분야에서 LLM의 활용 범위를 크게 확장하는 의미를 가지며, 미개발 단백질 예측 능력은 신약 개발과 단백질 공학 등에 실질적 가치가 있다.
핵심 요약
Claude Fable 5.2와 Opus 5.5는 단백질 서열을 대규모로 학습받았으며, 연구된 적 거의 없는 박테리아 단백질의 다음 아미노산을 예측할 수 있다. 다음 아미노산 테스트에서 Fable 5.2는 실제 단백질에서 54% 정확도, 순서를 뒤섞은 단백질에서 9% 정확도를 기록했으며, 같은 테스트에서 GPT, Gemini 등 다른 모델들은 거의 0에 가깝다. Claude 모델은 단백질 언어 모델인 ProtGPT3-10B, ProGen3와 비슷하거나 능가하는 성능을 보였고, 개발된 단백질보다 미개발 단백질에서 더 강한 성능을 발휘했다. 전체 요약 11문장 읽기 → 오늘의 주요당일 스타 상위 2건
01 AI · 머신러닝 21:11 게시
appwrite/appwrite
원제 appwrite/appwrite
스타 58,422 당일 +325 TypeScript
Key Point AI 에이전트가 직접 데이터베이스를 쿼리하고 배포 작업을 수행할 수 있는 MCP 통합 플랫폼으로, Cursor, Claude Code 같은 개발자 도구와의 연계를 통해 에이전트 중심 개발 워크플로우를 완성한다.
핵심 요약
Appwrite는 AI 에이전트와 개발자를 위한 오픈소스 클라우드 플랫폼으로, MCP(Model Context Protocol) 지원으로 Cursor, Claude Code 등 에이전트가 라이브 프로젝트에서 작동할 수 있다. 인증(이메일, SMS, OAuth, 익명 세션, 매직 URL), 데이터베이스(PostgreSQL/MySQL), 파일 스토리지, 서버리스 함수, 정적/SSR/CSR 사이트 배포, 이메일/SMS/푸시 메시징 등 통합 기능을 제공한다. WAF(웹 방화벽), 실시간 이벤트 구독, MCP를 통한 에이전트 연결 등 보안 및 AI 중심 기능을 갖춘다. 전체 요약 10문장 읽기 → 02 AI · 머신러닝 00:11 게시
esengine/estella
원제 esengine/estella
스타 1,172 당일 +111 TypeScript
Key Point AI가 에디터를 직접 조종하면서 한 번의 명령으로 웹부터 모바일까지 모든 플랫폼에 동시 배포할 수 있다는 점이 게임 개발 프로세스를 획기적으로 단순화한다.
핵심 요약
TypeScript SDK와 C++/WebAssembly 코어로 만든 2D·3D 게임 엔진 에스텔라가 에디터를 MCP 서버로 공개했다. Claude Code, Cursor 같은 AI 에이전트가 에디터의 167개 도구를 직접 사용해 프로젝트를 만들고 편집할 수 있으며, 모든 작업이 한 번의 undo 스텝이 되고 화면에서 실시간으로 확인된다. 에이전트는 씬 트리와 엔티티를 조작하고, 게임 화면을 캡처해 분석하며, 프레임 단위로 게임을 진행하고, 스프라이트·사운드·3D 모델을 생성할 수 있다. 전체 요약 8문장 읽기 → 읽을 논문
Hugging Face Papers15 커뮤니티가 고른 오늘의 AI 논문
오늘의 주요추천 상위 3건
01 AI · 머신러닝 18:11 게시
원제 Jeveration: System One Models Now Generate
추천 148 댓글 4 Yuhe Liu, Qi Li, Shihua Zhang 외
Key Point 한 번의 순방향 계산으로 고품질 이미지를 생성할 수 있다면 엣지 디바이스와 실시간 애플리케이션에서의 AI 추론 방식이 근본적으로 바뀔 수 있기 때문입니다.
핵심 요약
System One 패러다임의 빠른 병렬 예측 방식을 이미지 생성에 적용한 Jeveration 발표. 고정된 비전-언어 모델을 기반으로 그 시각-의미 지식을 전체 이미지 생성용으로 재활용. 병렬 예측이 일관성 있는 이미지로 수렴하도록 모든 위치를 공유 난수 상태로 조건화. 전체 요약 5문장 읽기 → 02 AI · 머신러닝 18:11 게시
원제 Tideway: Phase-Aware Tiered Memory Management for MoE Inference on Consumer Devices
추천 67 댓글 3 Yifei Wang, Tsun-yu Yang, Yechen Xu 외
Key Point 가정용 PC에서도 개인 데이터를 지키면서 대규모 AI 모델을 빠르게 실행할 수 있게 하는 실용적인 해결책으로, 중앙 서버 의존도를 줄이려는 개발자와 사용자에게 직접적인 성능 개선을 가져온다.
핵심 요약
LLM 에이전트가 AI 애플리케이션의 주요 패러다임이 되면서, 개인정보 보호·API 비용·추론 효율을 위해 대규모 Mixture-of-Experts(MoE) 모델을 개인 PC에서 로컬 실행하려는 수요가 증가하고 있다. 가정용 기기는 GPU VRAM과 호스트 RAM이 모두 제한적이어서, MoE 가중치가 VRAM·호스트 RAM·SSD에 걸쳐 분산되는 문제가 발생한다. 기존 시스템들은 이 메모리 계층을 독립적 캐시로 취급해 각 계층 간 경합(thrashing)을 일으키고 성능을 떨어뜨린다. 전체 요약 6문장 읽기 → 03 AI · 머신러닝 15:11 게시
원제 ALIVE: Making Streaming Video Models Interactive
추천 40 댓글 4 Jinzhao Li, Yuan Xu, Jinxuan Wu 외
Key Point 실시간 비디오 AI가 사용자와 양방향으로 상호작용하며 질문하고 조정할 수 있게 되면, 감시·모니터링·실시간 지원 같은 응용 분야의 자율성이 크게 높아진다.
핵심 요약
기존 스트리밍 비디오 LLM은 세계를 지속적으로 관찰하지만 사용자 요청을 고립되게 처리하는 한계가 있다. ALIVE는 능동적 모니터링, 스트리밍 작업 조율, 피드백 추구 상호작용을 지원하는 대화형 스트리밍 비디오 모델이다. ALIVE-SFT-288K와 ALIVE-RL-3K 두 가지 데이터셋을 구성해 2단계 학습을 진행했다. 전체 요약 6문장 읽기 → 전체 색인12건 · 분야별
AI · 머신러닝12건 001 21:11 ▲ 26 · 댓글 2 LLM 미세조정 시 성능 손상 방지하는 CurvDelta 등장 대형언어모형(LLM)을 특정 작업에 맞춰 적응시킬 때 기존 능력이 떨어지는 문제를 해결하기 위해 CurvDelta라는 프레임워크를 제안했다. AI · 머신러닝 · CurvDelta: Low-Curvature Delta Modeling For Surgical Learning and Unlearning
Key Point LLM을 새로운 기술에 맞게 조정하되 기존 능력을 유지해야 하는 현실적 니즈가 늘어나고 있으며, CurvDelta는 이 문제에 대한 체계적 해결책을 제시한다.
핵심 요약
대형언어모형(LLM)을 특정 작업에 맞춰 적응시킬 때 기존 능력이 떨어지는 문제를 해결하기 위해 CurvDelta라는 프레임워크를 제안했다. CurvDelta는 모델 업데이트의 매개변수 공간을 재설계해 기존 능력 보존 제약을 반영하고, 보존 손실이 거의 변하지 않는 저곡률(low-curvature) 공간을 구성한다. Kronecker-factored approximate curvature(K-FAC)와 인수분해 사영(factorized projection)을 활용해 LLM 규모에서 실용적으로 적용 가능하게 했다. 전체 요약 7문장 읽기 → 002 21:11 ▲ 23 · 댓글 2 표 데이터의 멀티모달 학습, 목표 기반 차원 축소로 성능 향상 숫자, 카테고리, 텍스트, 이미지를 함께 담은 표 데이터를 학습할 때 텍스트와 이미지는 사전 학습 인코더의 임베딩으로 변환하고 주성분분석(PCA)으로 차원을 줄여 왔다. AI · 머신러닝 · LightTAR: Light and Fast Target-Aware Representations for Multimodal Tabular Learning
Key Point 표 데이터 머신러닝의 핵심 단계인 텍스트/이미지 임베딩 처리 방식을 개선해, 기존 모델 구조를 바꾸지 않으면서도 모든 모델 타입에서 성능 향상을 이뤄낸 간단하고 범용적인 방법론을 제시합니다.
핵심 요약
숫자, 카테고리, 텍스트, 이미지를 함께 담은 표 데이터를 학습할 때 텍스트와 이미지는 사전 학습 인코더의 임베딩으로 변환하고 주성분분석(PCA)으로 차원을 줄여 왔다. 기존 PCA는 입력의 분산만 최대화하므로 예측 목표와 관련 없는 정보를 포함할 수 있다. 연구진은 LightTAR을 제안했는데, 정규화된 부분최소제곱(PLS)으로 인코더의 마지막 층과 중간층 모두에서 목표와의 연관성을 고려한 특징을 추출한다. 전체 요약 8문장 읽기 → 003 21:11 ▲ 22 · 댓글 3 로봇 조작 모델, 미래 영상으로 자신의 행동 개선하다 월드 액션 모델(WAM)은 행동 생성과 미래 시각 역학 예측을 결합해 로봇 조작의 일반화와 데이터 효율성을 보였으나, 신뢰할 만한 작업 실행으로의 전환이 과제였다. AI · 머신러닝 · HINT-WAM: Hindsight-Informed Training for World Action Models
Key Point 로봇 조작 모델이 실제 작업 수행 성능을 높이는 새로운 훈련 방식을 제시해, 오프라인과 온라인 학습 방법의 한계를 해결하는 접근이다.
핵심 요약
월드 액션 모델(WAM)은 행동 생성과 미래 시각 역학 예측을 결합해 로봇 조작의 일반화와 데이터 효율성을 보였으나, 신뢰할 만한 작업 실행으로의 전환이 과제였다. 기존 오프라인 미세 조정은 전문가 궤적에 밀집된 감독을 제공하지만, 행동 전문가는 잡음이 있는 시연 행동에만 훈련되고 자신의 샘플러가 생성한 중간 상태에는 훈련되지 않는다. 정책 내 강화학습은 정책 자신의 행동으로 훈련되지만, 희소한 작업 보상으로 탐색과 신용 배치가 어렵고, 밀집된 보상 조형도 직접 행동 목표 대신 스칼라 평가만 제공한다. 전체 요약 7문장 읽기 → 004 18:11 ▲ 14 · 댓글 2 디코더 없이 직접 픽셀 생성하는 확산 트랜스포머 기존 잠재 확산 모델은 디코딩된 잠재 변수를 픽셀로 변환하는 디코더가 필요해 추론 비용이 증가한다. AI · 머신러닝 · Decoding Without a Decoder: Direct Pixel Prediction from Diffusion Transformers
Key Point 확산 모델의 디코더 오버헤드를 완전히 제거하면서 오히려 이미지와 비디오 품질을 개선하는 새로운 접근법으로, 생성 모델의 효율성과 품질 간 균형 문제를 푸는 방안을 제시한다.
핵심 요약
기존 잠재 확산 모델은 디코딩된 잠재 변수를 픽셀로 변환하는 디코더가 필요해 추론 비용이 증가한다. 연구팀은 미세조정된 확산 트랜스포머가 선형 헤드를 통해 최종 픽셀을 직접 생성하는 'Decoding Without a Decoder(DWD)' 방법을 제안했다. 기존 방식과 달리 DWD는 역할을 분리해 원래 노이즈 제거 헤드는 샘플링을 계속 주도하고, 새로운 DWD 헤드는 최종 단계에서만 픽셀을 예측한다. 전체 요약 8문장 읽기 → 005 18:11 ▲ 21 · 댓글 2 사용자 정의 규칙을 따르는 대화형 세계 생성 모델 등장 게임 규칙처럼 사용자가 정의한 규칙에 따라 가상 세계가 반응하도록 하는 WorldRuler 모델을 제안했다. AI · 머신러닝 · WorldRuler: Interactive World Modeling under Configurable Rules
Key Point 게임의 커스텀 규칙처럼 임의의 규칙을 따르는 생성 모델은 메타버스, 게임 개발, 대화형 AI 환경에서 필수인데, 규칙 보존과 정확한 시각 반영이라는 기술적 난제를 풀었다.
핵심 요약
게임 규칙처럼 사용자가 정의한 규칙에 따라 가상 세계가 반응하도록 하는 WorldRuler 모델을 제안했다. 기존 세계 생성 모델은 현실의 물리 법칙만 학습했으나, 커스터마이징된 게임플레이를 위해 임의의 규칙을 따라야 한다는 점이 핵심 과제다. 규칙 정의와 세계 상태를 저장·복원할 때 규칙이 계속 유지되어야 하고(Rule-State Persistence), 규칙으로 인한 변화가 보이지 않은 객체까지 정확히 반영돼야 한다(Rule-to-Visual Realization). 전체 요약 8문장 읽기 → 006 18:11 ▲ 20 · 댓글 2 코드 월드 모델 2.0: 무한 길이 비디오 생성 도구 공개 영상 프록시를 활용해 명시적 세계 상태 시뮬레이션과 포토리얼리스틱 비디오 합성을 분리하는 방식으로, 오프라인 클립 제작과 실시간 인터랙티브 스트리밍 양쪽에 제어 인터페이스를 제공한다. AI · 머신러닝 · Code World Model 2.0: Towards Infinite Controllable Video Generation
Key Point 대규모 언어 모델 시대 이후 다음 프론티어인 비디오 이해·생성 모델의 실질적 발전으로, 사용자 조작에 응답하는 무한 길이 영상을 실시간으로 생성할 수 있는 단계에 진입했다는 의미다.
핵심 요약
영상 프록시를 활용해 명시적 세계 상태 시뮬레이션과 포토리얼리스틱 비디오 합성을 분리하는 방식으로, 오프라인 클립 제작과 실시간 인터랙티브 스트리밍 양쪽에 제어 인터페이스를 제공한다. 기존 접근의 두 가지 한계는 프록시 품질의 불일치(코arse 레이아웃부터 정밀한 articulated geometry까지 편차) 및 스트리밍 추론의 누적 drift로, 연쇄적 오류가 쌓인다는 점이다. Invoker-Render는 양방향 생성 모델과 4단계 인과 스트리밍 모델을 짝지어, 구조적 프록시·외형 참조·언어 기반 조건화 인터페이스를 공유한다. 전체 요약 8문장 읽기 → 007 15:11 ▲ 39 · 댓글 8 에이전트 진화의 병목, 개선 감지 불가능성 에이전트 진화는 제안자가 프롬프트·기술·메모리 같은 후보 아티팩트를 생성하고 평가 점수가 높은 것들을 선택하는 반복 루프로 작동한다. AI · 머신러닝 · The Resolution Hypothesis: Agent Evolution's Key Is Identifying Improvements
Key Point 에이전트 자동 개선이 실제로는 더 나은 아티팩트 생성 실패가 아니라 평가 신뢰도 문제로 인해 막힌다는 발견이 현재의 에이전트 진화 연구 방향을 근본적으로 재검토하게 한다.
핵심 요약
에이전트 진화는 제안자가 프롬프트·기술·메모리 같은 후보 아티팩트를 생성하고 평가 점수가 높은 것들을 선택하는 반복 루프로 작동한다. 논문은 에이전트 진화가 정체되는 근본 원인을 '해상도 가설'로 제시한다: 더 나은 아티팩트를 제안하지 못해서가 아니라 노이즈 많은 평가가 개선을 신뢰성 있게 식별하지 못하기 때문이다. 7가지 진화 방법과 6개 모델로 1천만 회 이상의 LLM 호출을 거친 실험에서 가설의 타당성을 확인했다. 전체 요약 6문장 읽기 → 008 15:11 ▲ 29 · 댓글 4 AI 시각 에이전트를 위한 게임 플레이 데이터셋 자동 생성 프레임워크 시각 에이전트 훈련을 위해 게임 환경과 플레이어를 함께 개발하는 Game2Player 프레임워크를 제안했습니다. AI · 머신러닝 · Game2Player: Scaling Gameplay Experience for Visual Agents through Environment-Player Co-Development
Key Point 시각 에이전트의 복잡한 작업 학습을 위해 대규모 검증된 게임 데이터를 자동으로 생성하는 기법으로, AI 모델의 실제 환경 적응 능력 개발에 직결됩니다.
핵심 요약
시각 에이전트 훈련을 위해 게임 환경과 플레이어를 함께 개발하는 Game2Player 프레임워크를 제안했습니다. Builder 에이전트가 웹 게임을 수정하고 내부 상태를 노출한 뒤 상태 기반 진행도 측정과 성공 조건을 정의합니다. Coding Player와 VLM Player가 작업을 시도하고 문제를 Builder에 보고하면서 플레이가 환경 검증과 훈련 데이터 수집을 동시에 수행합니다. 전체 요약 7문장 읽기 → 009 15:11 ▲ 27 · 댓글 2 저해상도 기상 데이터를 고해상도로 변환하는 경량 적응 기법 PROLA 기상 예보에서 저해상도 글로벌 모델 출력을 고해상도 국지 예측으로 변환하는 작업을 '예측적 시공간 기상 다운스케일링(PSWD)'으로 정의했다. AI · 머신러닝 · PROLA: Principal-Orthogonal Low-rank Adaptation for Predictive Spatiotemporal Weather Downscaling
Key Point 저해상도 기상 데이터의 고해상도 변환은 국지적 극한 날씨 예측의 핵심인데, 기존의 무겁고 비싼 미세조정 대신 경량 매개변수 적응으로 효율적 해결책을 제시했다.
핵심 요약
기상 예보에서 저해상도 글로벌 모델 출력을 고해상도 국지 예측으로 변환하는 작업을 '예측적 시공간 기상 다운스케일링(PSWD)'으로 정의했다. 대규모 사전학습 기상 모델을 적응시켜 미래의 고해상도 필드를 예측하는 것이 기존에는 어렵고 비용이 많이 들었다. 공간과 시간 해상도를 동시에 높이면서 미래 고해상도 궤적을 예측하는 2단계 프레임워크를 제안했다. 전체 요약 6문장 읽기 → 010 15:11 ▲ 14 · 댓글 2 강화학습 안정화하는 정규화 점수 중심화 기법 제안 비동기 강화학습은 훈련 처리량을 높이지만 오래된 정책의 데이터와 훈련·추론 간 수치 불일치로 학습이 불안정해진다. AI · 머신러닝 · Regularized Score Centering
Key Point 대규모 언어 모델의 에이전트 태스크 성능을 개선하는 새로운 훈련 기법으로, 비동기 학습 환경에서의 불안정성 문제를 해결하는 실질적 해법을 제시한다.
핵심 요약
비동기 강화학습은 훈련 처리량을 높이지만 오래된 정책의 데이터와 훈련·추론 간 수치 불일치로 학습이 불안정해진다. 점수 중심화(SC)는 보상 베이스라인의 영향을 제거해 정책 외 학습을 안정화하는데, 학습자가 데이터 생성 정책에서 멀어지면 실패할 수 있다. 연구진은 역 쿨백-라이블러(KL) 페널티를 추가한 정규화 점수 중심화(RSC)를 제시해 학습자의 다음 토큰 분포를 행동 정책의 분포에 가깝게 유지한다. 전체 요약 7문장 읽기 → 011 03:11 ▲ 14 · 댓글 2 리포지토리를 훈련 환경으로: RepoFactory의 자동 최적화 파이프라인 장시간 코딩 작업을 하는 AI 에이전트 훈련에는 검증 가능한 피드백이 있는 환경이 필요한데, 기존 방식은 선형적으로 검증만 하고 훈련 개선 방법을 제시하지 못했다. AI · 머신러닝 · From Repositories to Training Environments: Scaling Long-Horizon Coding Agents with Environment Evolution Loop
Key Point 코딩 에이전트의 장시간 작업 성능을 대폭 개선하는 자동화된 환경 생성 방식이 등장했으며, 실제 프로젝트 기반 훈련으로 현실적인 프로덕션 환경에 대응하는 모델을 만들 수 있음을 보여준다.
핵심 요약
장시간 코딩 작업을 하는 AI 에이전트 훈련에는 검증 가능한 피드백이 있는 환경이 필요한데, 기존 방식은 선형적으로 검증만 하고 훈련 개선 방법을 제시하지 못했다. RepoFactory는 실제 리포지토리를 자동으로 변환하여 에이전트가 언어 명세만으로 완전한 프로젝트를 처음부터 구축하는 검증 가능한 환경으로 만든다. Environment Evolution Loop는 타당성·구조적 결합·구현 범위를 결합한 목표를 프록시 피드백으로 최적화하여 환경의 훈련 가치를 높인다. 전체 요약 7문장 읽기 → 012 03:11 ▲ 10 · 댓글 2 초고속 무손실 압축, 병렬 처리로 풀다 학습된 이미지 무손실 코덱이 고전 코덱보다 파일 크기는 작지만, 복호화 속도가 초 단위로 오래 걸려 실무에서 채택되지 못했다. AI · 머신러닝 · FMT: Lossless Image Compression in a Fixed Number of Parallel Steps
Key Point 학습 기반 이미지 압축의 가장 큰 걸림돌이던 복호화 시간을 병렬 처리로 획기적으로 단축한 기술로, 무손실 압축의 실용화 가능성을 보여준다.
핵심 요약
학습된 이미지 무손실 코덱이 고전 코덱보다 파일 크기는 작지만, 복호화 속도가 초 단위로 오래 걸려 실무에서 채택되지 못했다. FMT(Fixed-step Multiscale Tree)는 복호화 순서와 엔트로피 인코더를 함께 설계해 대기 시간 없이 고정된 순차 스텝 수로 모든 크기의 이미지를 복호화한다. 입상도부터 고해상도로 가는 계층적 트리 구조로 이미지를 저장하며, 각 단계의 값이 독립적이어서 GPU가 각 스텝을 동시에 예측할 수 있다. 전체 요약 6문장 읽기 → ● 이번 피드는 여기까지입니다.
작은 발견을 다음 커밋으로 이어가세요. 모든 발행본