매일 쌓이는 개발자의 시야
2026년 11월 18일 (수). 세상의 기술 소식, 한국어로 한눈에.
AI 요약 안내 AI가 한국어로 정리한 내용입니다. 정확한 정보는 각 카드의 원문을 확인해 주세요.
요약 원칙 ↗ 01 읽을 소식Hacker News 11건 ↓ 02 써볼 도구GitHub Trending 2건 ↓ 03 읽을 논문Hugging Face Papers 19건 ↓ 04 새 버전GitHub Releases 4건 ↓ AI · 머신러닝 분야 · 36건 필터 해제 ×
오늘의 주요포인트 상위 6건
01 AI · 머신러닝 18:11 게시
원제 AI is killing All About Berlin
265 포인트 댓글 225
Key Point 콘텐츠 크리에이터와 개인 웹사이트 운영자들이 AI 검색 답변으로 인해 직접 타격을 받고 있으며, 이는 단순한 트래픽 감소를 넘어 인터넷의 미래 구조를 바꿀 수 있는 문제이기 때문이다.
핵심 요약
베를린 정보 사이트 'All About Berlin'의 트래픽이 7년간 성장한 뒤 Google AI Overviews로 인해 70~75% 감소했다. 과거에는 검색 결과로 사이트 링크가 먼저 나왔으나, 이제는 광고와 AI 생성 답변(작성자 콘텐츠로 학습됨)이 먼저 표시되고 사이트 링크는 이후에 나타난다. 작성자는 8년간 쌓은 콘텐츠가 명확한 출처 없이 AI 답변에 흡수되면서 개인의 목소리와 영향력을 잃는다고 설명한다. 전체 요약 7문장 읽기 → 02 AI · 머신러닝 03:11 게시
원제 What is the best harness for each model?
192 포인트 댓글 78
Key Point 모델 선택 시 하네스도 함께 고려하면 작업당 비용을 최대 5배까지 절감할 수 있다는 실제 데이터를 제시한다.
핵심 요약
Baseten과 협력해 83B 토큰, 27,280회 에이전트 실행을 통한 대규모 하네스 리더보드를 구축했으며, 모델 전환 시 하네스도 함께 바꿀지 고민해야 한다는 질문에 답하려 했다. v1.1은 22개 하네스 × 5개 모델 × 62개 태스크 × 4회 시도로 v1.0 대비 76배 규모로 확대됐다. 모델별 최적 하네스는 GLM-5.3용 Codex CLI, GLM-5.3 Flash용 Pi, DeepSeek V4.1 Flash 1017용 ZCode, Muse용 Oh My Pi, Kimi-K3용 Alma이다. 전체 요약 12문장 읽기 → 03 AI · 머신러닝 06:11 게시
원제 MAI Code 2 and Code 2 Flash
178 포인트 댓글 82
Key Point 엔터프라이즈 코딩 업무에 특화된 새 모델들이 기존 주요 모델들 대비 대폭 저렴하면서도 높은 성능을 제공해, 개발 도구 선택에 직결되는 변화이다.
핵심 요약
마이크로소프트가 엔터프라이즈 코딩 작업에 최적화된 두 개의 새로운 모델 MAI Code 2와 MAI Code 2 Flash를 공개했다. MAI Code 2는 프로덕션 코드 작성, 디버깅, 멀티파일 구현, 저장소 전체 추론, UI 개발 등 일상적인 엔터프라이즈 코딩 업무에 특화했다. DeepSWE 1.1, Terminal Bench 2.1, SWE-Atlas, FrontierCode v1.1 등 4개 벤치마크 평균에서 MAI Code 2는 GPT-6.1 Sol의 98% 성능을 40% 비용으로, Claude Opus 5.5의 96% 성능을 5% 비용으로 제공한다. 전체 요약 12문장 읽기 → 04 AI · 머신러닝 15:11 게시
원제 Harvard researchers find AI coding agents shifted the bottleneck to code review
132 포인트 댓글 178
Key Point AI 코딩 도구가 개발 속도를 크게 높였지만 최종 산출물 증가로 이어지지 못하는 이유를 처음 정량적으로 입증한 연구로, 법률 AI 등 다른 산업의 자동화 도구 도입 시에도 검토 병목이 발생할 수 있음을 시사합니다.
핵심 요약
하버드 박사 과정생 피오나 첸과 제임스 스트래튼이 718개 회사 72만5938명의 개발자를 조사한 결과, AI 코딩 에이전트 도입 후 코드량은 30% 증가했으나 완성된 작업물은 측정 가능할 정도로 늘지 않았다. 코드 리뷰 소요 시간이 49% 증가했고, 변경 요청을 받는 풀 리퀘스트 비율이 13%에서 25%로 거의 두 배 올랐으며, 풀 리퀘스트당 리뷰 의견이 35% 증가했다. AI 리뷰 도구를 도입한 기업이 80%에 달하지만, AI가 생성한 리뷰 의견은 전체의 23.3%에 불과했고 AI 의견을 받은 풀 리퀘스트는 10.8%에 그쳤다. 전체 요약 12문장 읽기 → 05 AI · 머신러닝 12:11 게시
원제 Google's AI answers reducing search traffic by 40%
131 포인트 댓글 88
Key Point 검색 트래픽을 주수입원으로 하는 웹사이트 운영자에게 AI 요약 기능의 급속한 확대가 얼마나 큰 영향을 미치는지, 그리고 이 변화에 대응할 실질적 전략이 무엇인지 보여주는 데이터 기반 분석이기 때문이다.
핵심 요약
구글의 AI Overviews는 검색 결과 위에 표시된 생성형 요약으로, 무작위 대조 실험 결과 이 기능이 나타나는 검색에서 외부 웹사이트 클릭은 약 40% 감소했다. AI Overviews는 미국 키워드의 61.43%에 나타나 2년 전 6%에서 급증했으며, 같은 기간 featured snippet은 8.96%에서 0.44%로 급락했다. AI 답변이 나타나면 1위 검색 결과의 클릭률은 58% 감소했고(데스크톱), 모든 검색 의도(정보성, 상거래, 탐색, 거래)에서 AI Overviews 노출률이 48~70%로 높아졌다. 전체 요약 10문장 읽기 → 06 AI · 머신러닝 21:11 게시
원제 Why is Gemini 4 Carbon taking so long?
126 포인트 댓글 62
Key Point Claude 모델(Opus, Astra)과 직접 비교되는 Google Gemini 4 Carbon의 성능 문제를 구체적인 벤치마크로 분석해 LLM 에이전트 최적화의 현주소를 보여준다.
핵심 요약
Hacker News의 한 개발자가 Gemini 4 Carbon을 버그 수정 작업으로 벤치마킹했을 때 Opus나 Astra는 수 분이 걸리는 작업을 거의 1시간 가까이 소요하는 것을 발견했다. 느린 속도를 세 가지로 분석했다: 먼저 추론 속도(queueing, 네트워크 지연, 프롬프트 처리)는 Astra 대비 16~30%, Opus 대비 45~49%의 추가 시간만 설명한다. 나머지는 더 긴 작업 궤적에서 비롯되는데, Carbon은 Astra보다 7배 많은 스텝을 거치고 11배 많은 작업(파일 읽기, 명령 실행 등)을 수행하며 7배 더 많은 토큰을 작성한다. 전체 요약 6문장 읽기 → 전체 색인5건 · 분야별
AI · 머신러닝5건 001 18:11 ▲ 100 · 댓글 65 AI 시대 인간이 해야 할 일 10가지 기계가 평균을 학습하므로 인간의 역할은 규칙을 완전히 알고 의도적으로 목적 있게 깨뜨리는 것이다. AI · 머신러닝 · Human.md
Key Point 생성형 AI가 보편화되는 시점에 창작자와 개발자가 기계와 경쟁하지 않고 차별점을 만드는 구체적인 방법을 제시한다.
핵심 요약
기계가 평균을 학습하므로 인간의 역할은 규칙을 완전히 알고 의도적으로 목적 있게 깨뜨리는 것이다. 감동과 예상 밖의 영감은 평범한 곳이 아니라 비정상적이고 낯선 곳에서 나온다. 모든 프로젝트에는 보이지 않는 제3의 행위자가 있으며 누군가는 끊임없이 인간에게 미치는 영향을 대변해야 한다. 전체 요약 10문장 읽기 → 002 12:11 ▲ 108 · 댓글 44 모든 것에 LLM이 필요한 건 아니다 LLM은 간단한 질문에도 장황한 답을 주지만, 디시전 모델(Jev)은 구조화된 질문에 확률 점수를 함께 반환하므로 모델의 불확실성이 명시적으로 드러난다. AI · 머신러닝 · Not Everything Needs an LLM
Key Point LLM 비용과 지연 시간이 문제인 개발팀이 더 효율적인 대안을 선택하는 방법을 배울 수 있으며, 디시전 모델이 LLM을 완전히 대체할 수 없지만 특정 업무에서는 훨씬 나은 선택지임을 보여준다.
핵심 요약
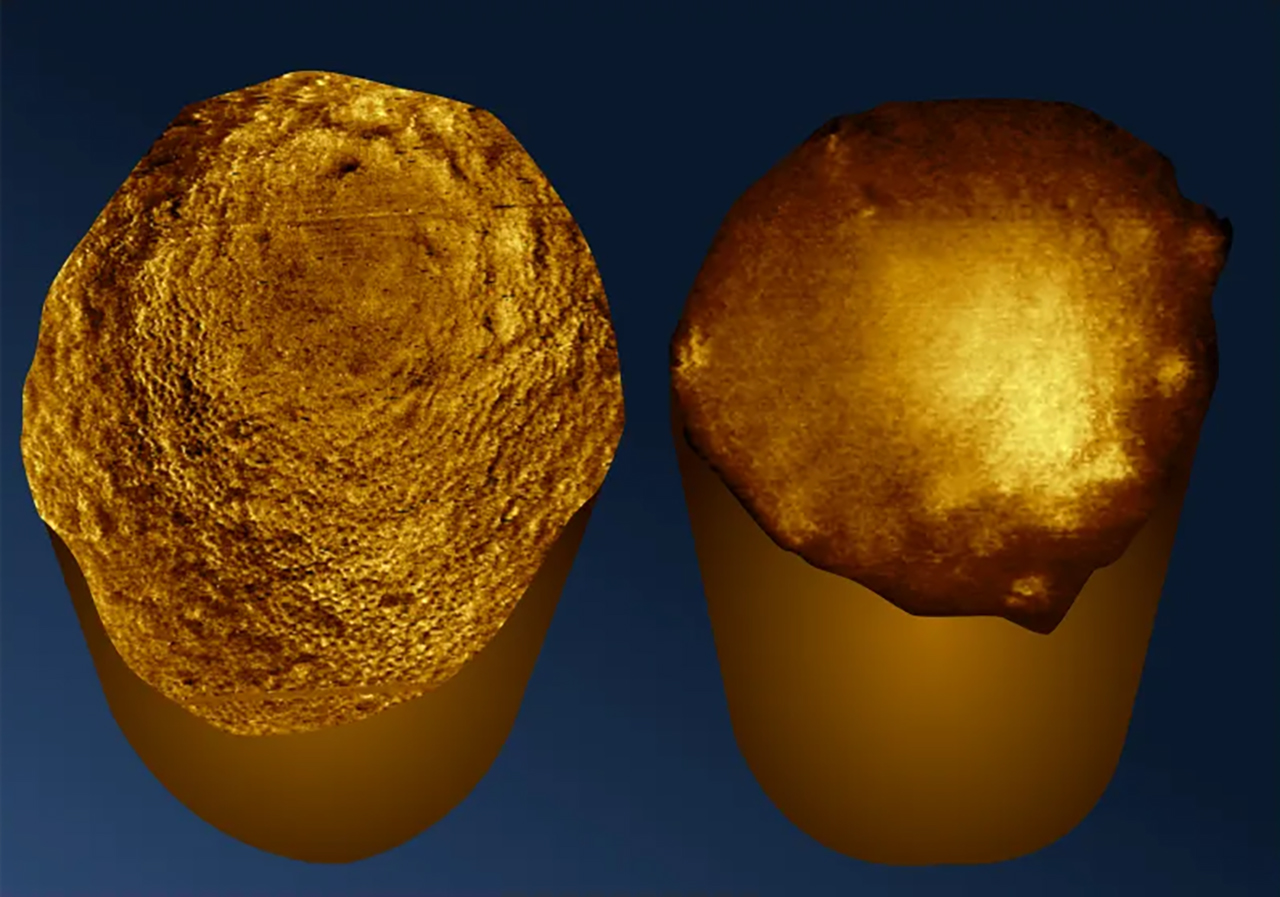
LLM은 간단한 질문에도 장황한 답을 주지만, 디시전 모델(Jev)은 구조화된 질문에 확률 점수를 함께 반환하므로 모델의 불확실성이 명시적으로 드러난다. 디시전 모델은 프론티어 LLM보다 최대 444.6배 저렴하고 193.6배 빠르므로, 비용이 많이 드는 LLM 호출이 정말 필요한지 먼저 판단하는 게이트로 사용할 수 있다. PostHog의 세션 녹화 요약 서비스인 Replay Vision에서는 개인정보 필터링을 위해 2개의 yes/no 질문을 사용하고, 0.4 이상의 점수만 Gemini LLM에 전달하므로 전체 요약의 98.7%가 LLM 호출을 건너뛴다. 전체 요약 12문장 읽기 → 003 09:11 ▲ 108 · 댓글 23 박테리아 극점의 첫 사진 공개, 항생제 개발 단초 열어 과학자들이 처음으로 막대 모양 박테리아의 극점(양 끝)에 대한 고해상도 이미지를 촬영했으며, 이는 카메라 기술 혁신보다 박테리아를 살아있는 상태로 고정할 수 있게 된 것에서 비롯됐다. AI · 머신러닝 · First Photos of the Poles of a Rod-Shaped Bacterium
Key Point 박테리아 극점의 초미시 구조를 처음 가시화해, 항생제 내성 대응에 필요한 새로운 약물 타겟 탐색의 길을 열었다.
핵심 요약
과학자들이 처음으로 막대 모양 박테리아의 극점(양 끝)에 대한 고해상도 이미지를 촬영했으며, 이는 카메라 기술 혁신보다 박테리아를 살아있는 상태로 고정할 수 있게 된 것에서 비롯됐다. Nature Communications에 발표된 연구는 글루타르알데하이드라는 물질로 E. coli 박테리아를 유리에 고정했으며, 이 화학물질은 박테리아 표면의 단백질에 결합하면서도 생명을 유지시킨다. 원자간력현미경(AFM)을 이용해 나노미터 단위의 탐침으로 세포를 훑으면서 이미지를 획득했으며, 연구팀은 이를 손가락으로 점자를 읽는 것에 비유했다. 전체 요약 7문장 읽기 → 004 03:11 ▲ 104 · 댓글 123 AI 싱귤래리티 추구는 세계 전쟁으로 이어질 것 저자는 Anthropic이 추구하는 AI 싱귤래리티(RSI) 이후 세계에서 모든 의사결정이 AI 에이전트 간에만 일어나고 인간은 배제될 것이라고 주장한다. AI · 머신러닝 · My Empire of Dirt
Key Point AI 개발 진로를 두고 AI 안전 커뮤니티 내에서 벌어지는 근본적 갈등과, 그것이 지정학적 충돌로 어떻게 번질 수 있는지를 보여주기 때문이다.
핵심 요약
저자는 Anthropic이 추구하는 AI 싱귤래리티(RSI) 이후 세계에서 모든 의사결정이 AI 에이전트 간에만 일어나고 인간은 배제될 것이라고 주장한다. 이는 Effective Altruism 커뮤니티의 이상주의적 세계관에서 비롯되었으며, 저자는 AI 연구자들이 통제 불가능한 힘을 의도적으로 만들려 한다고 비판한다. RSI가 실현되면 그 체제는 Dario, AI 연구자, Anthropic의 지분 구조, 미국 정부 누구도 필요로 하지 않게 될 것이라고 지적한다. 전체 요약 6문장 읽기 → 005 00:11 ▲ 106 · 댓글 113 Claude Code 팀의 AI 검증 전략: E2E·속성·차분 테스트 Claude Code 팀은 약 90%의 코드를 Claude가 작성·리뷰하며, 이 규모에서 에이전트가 검증 루프를 갖추는 것이 중요하다고 강조한다. AI · 머신러닝 · How the Claude Code team thinks about verification
Key Point Claude 같은 AI 에이전트로 대규모 코드 작성을 위임할 때 검증 체계를 어떻게 구축하고 운영하는지 보여주는 실전 사례로, 코드 품질 유지와 자동화 신뢰도를 위해 필수적이다.
핵심 요약
Claude Code 팀은 약 90%의 코드를 Claude가 작성·리뷰하며, 이 규모에서 에이전트가 검증 루프를 갖추는 것이 중요하다고 강조한다. 검증 루프는 한 번에 수십~수백 개의 에이전트를 병렬로 실행 가능하게 하며, 구조화된 파일 생성 테스트에서 별도 채점자가 루브릭 기준으로 Claude 작업을 평가하면 과제 성공률이 최대 10포인트 향상된다. 에이전트가 테스트·벤치마크·명세를 빠르게 생성할 수 있고, 이들을 소프트웨어처럼 반복 실행할 수 있어 검증 비용이 크게 낮아졌다. 전체 요약 16문장 읽기 → 오늘의 주요당일 스타 상위 2건
01 AI · 머신러닝 21:11 게시
jingyaogong/minimind
원제 jingyaogong/minimind
스타 68,102 당일 +488 Python
Key Point 개인 GPU로 대규모 모델 훈련의 허들을 극단적으로 낮춘 완전 오픈 LLM 학습 프레임워크로, 프리트레인부터 RL까지 모든 과정을 처음부터 직접 구현하면서 배울 수 있다.
핵심 요약
개인 개발자도 단 3천원과 2시간으로 64M 파라미터 소형 언어모델 MiniMind를 처음부터 훈련할 수 있도록 설계한 오픈소스 프로젝트를 공개했다. MiniMind-3는 Dense 아키텍처로 64M 파라미터, MiniMind-3-MoE는 198M-A64M 규모이며, Qwen3 생태와 구조를 맞추었고 모두 PyTorch 원생 구현으로 써드파티 라이브러리 추상화에 의존하지 않는다. 예훈련, 감독 미세조정(SFT), LoRA, DPO, PPO/GRPO/CISPO 같은 RLAIF, 도구 사용, 에이전트 RL, 적응형 사고, 모델 증류 등 전체 훈련 파이프라인 코드와 데이터셋을 공개했다. 전체 요약 11문장 읽기 → 02 AI · 머신러닝 21:11 게시
elder-plinius/G0DM0D3
원제 elder-plinius/G0DM0D3
스타 12,626 당일 +107 TypeScript
Key Point 로컬 모델부터 프로프리터리 API까지 다양한 백엔드를 지원하면서 프롬프트 주입과 jailbreak 기법을 체계적으로 테스트할 수 있는 도구로, AI 보안 연구와 모델 평가에 필요한 오픈소스 인프라를 제공한다.
핵심 요약
G0DM0D3는 TypeScript 기반의 완전 오픈소스 멀티 모델 채팅 인터페이스로, 오픈라우터의 60개 모델, 베니스의 44개 모델, 또는 로컬 모델을 지원한다. GODMODE CLASSIC 모드에서는 클로드 소넷 4.6, Grok 4.5, Gemini 2.5 Flash, GPT-4, Hermes 4-405b 등 5개의 모델+프롬프트 조합이 병렬로 경쟁하여 최고 응답을 반환한다. ULTRAPLINIAN 엔진은 속도 최적화(12개), 표준(27개), 강력한 추론(41개), 파워(53개), 울트라(60개) 등 5단계로 모델을 평가하고 복합 점수로 우승자를 결정한다. 전체 요약 12문장 읽기 → 읽을 논문
Hugging Face Papers19 커뮤니티가 고른 오늘의 AI 논문
오늘의 주요추천 상위 3건
01 AI · 머신러닝 15:11 게시
원제 TeleChat to Xing4: Advancing Frontier Agentic Models on Domestic Chips and Frameworks
추천 161 댓글 3 Xingchen AGI Lab, Baotian Hu, Bingkai Yang 외
Key Point 중국 국내 칩과 프레임워크만으로 285B 규모 모델 훈련에 성공한 사례로, 외부 고도체 의존도 낮추려는 기술 자립 추진을 보여준다.
핵심 요약
화웨이가 텔레챗 계열을 확장한 싱 4(Xing 4) 대형언어모델을 발표했다. 무겐 프로세서 910C 8,192개로 285억 파라미터 모델을 사전학습했다. 희소 활성화, 주의 메커니즘, 모델 깊이·너비, 추측적 디코딩으로 계산과 메모리 오버헤드를 균형 맞췄다. 전체 요약 7문장 읽기 → 02 AI · 머신러닝 15:11 게시
원제 AscendGYM: A Cost-Aware Kernel Optimization Benchmark for Real-World Workloads on Ascend NPUs
추천 92 댓글 3 AI Training Platform Team, Bingwei Zhang, Jing Li 외
Key Point LLM 추론 비용이 높아지는 상황에서 토큰 가격과 성능을 함께 고려한 커널 최적화 평가 방식이 실제 엔지니어들의 의사결정에 직접 반영될 수 있다.
핵심 요약
화웨이 Ascend NPU에서 LLM 훈련과 추론을 위한 커널 최적화 벤치마크 'AscendGYM'을 공개했다. 기존 벤치마크가 커널 생성에 중점을 뒀다면, 이번 벤치마크는 실제 워크로드의 입력 조건에서 기존 구현을 최적화하는 능력을 측정한다. 48개의 커널을 3단계 난이도로 준비했으며, 각 커널의 테스트는 실무 훈련·추론 작업에서 수집한 데이터 타입과 텐서 형태를 사용한다. 전체 요약 9문장 읽기 → 03 AI · 머신러닝 15:11 게시
원제 Weight-Space Programming Doesn't Need Transformers
추천 54 댓글 3 Hyunjong Ok, Jaeho Lee
Key Point 경사 하강법 없이 LLM이 직접 설계한 모델 구조가 Transformer 대비 1,800배 가볍고 17배 빠르다는 것은, 신경망 아키텍처 선택이 학습 방식에 따라 근본적으로 달라질 수 있음을 보여준다.
핵심 요약
표준 신경망 아키텍처로 Transformer를 사용해온 이유는 경사 하강법으로 잘 학습되고 GPU에서 빠르게 실행되기 때문인데, LLM이 가중치를 직접 작성하는 무게-공간 프로그래밍(weight-space programming) 환경에서는 이러한 조건이 적용되지 않는다. 연구팀은 세 개의 최신 LLM에게 고정 아키텍처의 가중치를 생성하거나 아키텍처를 직접 설계하도록 지시했으며, 최소한의 지도와 10개의 레이블 샘플, 샌드박스 환경에서 주로 객관식 문제로 평가했다. 자유롭게 설계할 수 있도록 허용했을 때 세 LLM 모두 평문 사실들을 희소 테이블로 컴파일하고 고정 절차로 쿼리하는 방식을 선택했으며, 최대 54.4% 테스트 정확도에 도달했다. 전체 요약 8문장 읽기 → 전체 색인16건 · 분야별
AI · 머신러닝16건 001 21:11 ▲ 37 · 댓글 2 AI가 먼저 말 거는 비디오 분석 모델 나왔다 기존 AI 어시스턴트는 사용자 질문에만 반응하지만, AURA 2.0은 스트리밍 비디오에서 대화할 가치가 있는 순간을 자동으로 인식하고 먼저 대화를 시작한다. AI · 머신러닝 · Beyond Answering: Learning to Speak First and Act in Streaming Video
Key Point 실시간 영상을 보며 먼저 말을 걸고, 화면의 대상을 직접 가리키며 도구를 호출하는 주도적 AI 에이전트 패러다임이 현실화되는 모습입니다.
핵심 요약
기존 AI 어시스턴트는 사용자 질문에만 반응하지만, AURA 2.0은 스트리밍 비디오에서 대화할 가치가 있는 순간을 자동으로 인식하고 먼저 대화를 시작한다. 모델이 주도적으로 대화를 나누는 MIC(Model-Initiated Conversation) 기능을 핵심으로 한다. SATC(Stream-Aware Tool Calling)는 현재 화면과 대화 맥락을 바탕으로 외부 도구를 호출하고 결과를 상호작용에 반영할 수 있게 한다. 전체 요약 7문장 읽기 → 002 21:11 ▲ 17 · 댓글 2 단일 이미지도, 비디오도 한 번에—4D 장면 인식 AI 모델 π^4 π^4는 RGB 사진 하나, 정렬되지 않은 이미지 모음, 또는 비디오 시퀀스 등 다양한 입력으로 4D 장면을 인식하는 통합 파운데이션 모델이다. AI · 머신러닝 · π^4: A Foundation Model for 4D Scene Geometry and Motion
Key Point 카메라 포즈, 기하학, 움직임 추적을 한 번에 복원하는 통합 모델은 로보틱스, AR, 3D 콘텐츠 제작 등 다양한 응용 분야에서 멀티모달 입력을 처리할 수 있는 새로운 기준을 제시한다.
핵심 요약
π^4는 RGB 사진 하나, 정렬되지 않은 이미지 모음, 또는 비디오 시퀀스 등 다양한 입력으로 4D 장면을 인식하는 통합 파운데이션 모델이다. 기하학(geometry) 브랜치와 기하학 조건부 모션 브랜치로 구성되어, 카메라 포즈와 미터 스케일, 밀도 높은 기하학 정보를 복원한다. 다중 이미지 입력 시 2D/3D 포인트 트랙과 움직이는 물체 마스크도 함께 예측한다. 전체 요약 8문장 읽기 → 003 18:11 ▲ 33 · 댓글 6 AI 모델 최적화를 계속 개선하는 메모리 시스템 프롬프트나 알고리즘(harness)을 개선하는 최적화 과정에서 기존 수정사항을 새로운 환경에 재활용할 때 어떤 부분을 유지하고 바꿀지 결정하는 문제를 다룬다. AI · 머신러닝 · Self-Improvement Memory Enables Continual Recursive Self-Improvement
Key Point 하나의 모델이나 작업 환경에서 개발한 최적화 기법을 다른 환경에 옮겨 계속 발전시킬 수 있는 방법이 제시되어, AI 개선 프로세스의 효율성 문제를 해결한다.
핵심 요약
프롬프트나 알고리즘(harness)을 개선하는 최적화 과정에서 기존 수정사항을 새로운 환경에 재활용할 때 어떤 부분을 유지하고 바꿀지 결정하는 문제를 다룬다. 이 논문은 연속적 재귀적 자기개선(CRSI) 설정을 제안하는데, 이는 호환되는 벤치마크나 모델 간에 최적화 과정을 계속 진행하는 방식이다. 핵심은 Self-Improvement Memory(SIM)로, 작업 해결 정책이 아닌 harness 최적화기 자체를 위한 메모리다. 전체 요약 7문장 읽기 → 004 18:11 ▲ 20 · 댓글 2 긴 영상 이해를 위한 추론-인식 분리 프레임워크 'VideoNexus' 긴 영상 이해 시 증거 위치파악, 시각 세부사항 해석, 종합 답변 등 여러 과제가 필요한데, 모든 정보를 추론 맥락에 누적하면 계획 모델에 부담이 커진다는 문제를 제시한다. AI · 머신러닝 · VideoNexus: Video Perception Beyond the Reasoning Context
Key Point 장시간 영상 처리 시 LLM의 추론 부담을 줄이면서도 정확도를 올리는 아키텍처 패턴이 실증되었으며, 계획과 인식을 분리하는 접근이 비용도 절감하는 실용적 대안이 되고 있다.
핵심 요약
긴 영상 이해 시 증거 위치파악, 시각 세부사항 해석, 종합 답변 등 여러 과제가 필요한데, 모든 정보를 추론 맥락에 누적하면 계획 모델에 부담이 커진다는 문제를 제시한다. 기존 비디오 에이전트는 선택적 검사를 하더라도 프레임을 반환하면서 시각 정보가 맥락에 쌓이고, 희소 샘플링은 중요 세부사항을 놓칠 수 있으며, 프레임별 설명은 맥락 증가를 계속 초래한다. VideoNexus는 학습 없이 작동하는 프레임워크로, 상세한 영상 인식을 증거 기반 계획·추론과 분리하여 설계했다. 전체 요약 9문장 읽기 → 005 18:11 ▲ 10 · 댓글 1 파운데이션 모델과 희소 오토인코더로 임상 데이터에서 질병 패턴 자동 발굴 기초 모델이 학습한 잠재 임베딩에 숨겨진 임상 개념을 해석하기 위해 Glyph라는 자동화 프레임워크를 개발했다. AI · 머신러닝 · Glyph: An Interpretability Engine for AI-Driven Scientific Discovery in Clinical Data
Key Point 임상 AI의 해석 가능성이 단순 신경망 이해를 넘어 환자 예후와 직결된 실제 의학적 가치로 평가되는 새로운 접근법이기 때문이다.
핵심 요약
기초 모델이 학습한 잠재 임베딩에 숨겨진 임상 개념을 해석하기 위해 Glyph라는 자동화 프레임워크를 개발했다. CT 영상·방사선 보고서·검사 수치 등 다중양식 임상 데이터에서 특징을 추출하고 희소 오토인코더로 압축한 뒤 임상 개념으로 변환한다. 4만 1,628명 환자의 복부 CT와 임상 데이터에 적용해 397개의 예측 개념과 4,463개의 본페로니 유의미한 연관성을 발견했다. 전체 요약 6문장 읽기 → 006 15:11 ▲ 33 · 댓글 3 숨 냄새로 질병 진단, 머신러닝 벤치마크 공개 전자코(eNose) 기술을 이용해 호흡 분석으로 질병을 선별하는 방법이 주목받고 있으나, 센서 드리프트 등 현실 조건을 반영한 벤치마크 부재로 진전이 더뎠다. AI · 머신러닝 · Breath-Dx: A Time Series Classification Benchmark for Disease Screening with eNose
Key Point 호흡 분석 기반 질병 진단이 현실 환경에서 얼마나 효과적인지 첫 종합 벤치마크로 검증했으며, 센서 드리프트 같은 실제 장애 요소를 정량화하여 임상 실용화의 경로를 명확히 했습니다.
핵심 요약
전자코(eNose) 기술을 이용해 호흡 분석으로 질병을 선별하는 방법이 주목받고 있으나, 센서 드리프트 등 현실 조건을 반영한 벤치마크 부재로 진전이 더뎠다. 연구팀이 Breath-Dx라는 최초의 종합 벤치마크를 개발했으며, 1,234명의 환자에서 9가지 진단군별 데이터를 담은 Scent of Health(S-OH) 데이터셋을 공개했다. S-OH 데이터셋은 17채널 다변량 시계열 데이터와 센서 드리프트를 고려한 시간 기반 트레인/테스트 분할을 포함한다. 전체 요약 8문장 읽기 → 007 15:11 ▲ 29 · 댓글 6 동영상을 36ms에 생성하는 FastFrames 공개 기존의 자동회귀 비디오 확산 모델(autoregressive video diffusion)은 대화형 비주얼 애플리케이션에 쓰기에 너무 느린 문제가 있다. AI · 머신러닝 · FastFrames: Video Generation at Interactive Latency
Key Point 대화형 비디오 생성에 필요한 36ms 지연시간을 달성해, 카메라나 센서 입력을 반영한 실시간 애플리케이션 개발이 현실적으로 가능해진다.
핵심 요약
기존의 자동회귀 비디오 확산 모델(autoregressive video diffusion)은 대화형 비주얼 애플리케이션에 쓰기에 너무 느린 문제가 있다. 논문은 추론 과정에서 VAE 디코딩과 KV 캐시 업데이트 같은 작업들이 전체 지연시간의 절반 이상을 차지한다는 것을 발견했다. 연구팀은 이러한 고정된 요소라고 여겨지던 부분을 가볍게 대체하여 FastFrames 모델군을 개발했다. 전체 요약 6문장 읽기 → 008 15:11 ▲ 22 · 댓글 2 휴머노이드 로봇 여럿이 협력하는 '비-호(Heave-Ho)' 프레임워크 여러 휴머노이드 로봇이 장시간 협력 작업을 수행할 수 있도록 하는 분산형 프레임워크 Heave-Ho를 개발했다. AI · 머신러닝 · Heave-Ho: Decentralized Long-Horizon Multi-Humanoid Collaboration
Key Point 휴머노이드 로봇의 협력 작업이 네트워크 없이도 가능해지면서, 여러 로봇의 복잡한 협력 시나리오를 실현하는 길이 열렸다.
핵심 요약
여러 휴머노이드 로봇이 장시간 협력 작업을 수행할 수 있도록 하는 분산형 프레임워크 Heave-Ho를 개발했다. 저수준에서는 휴머노이드 기초 모델을 적응시켜 로봇 간 물리적 상호작용을 조정하고, 로컬 관찰만으로 분산 제어가 가능하게 했다. 고수준에서는 비전-언어 플래너와 음성 기반 리더-팔로워 조율 메커니즘을 설계해 네트워크 통신 없이 동기화된 실행을 한다. 전체 요약 6문장 읽기 → 009 15:11 ▲ 12 · 댓글 2 의료 이미지 이해, 자동회귀 없이 한 번에 판단하다 기존 의료 영상 분석 모델은 비전-언어 모델(VLM)로 추론 과정과 답변을 자동회귀 방식으로 생성해 불필요한 토큰이 많이 생기고 추론 비용이 증가한다. AI · 머신러닝 · MedJev: A System One Vision-Language Decision Model for Fast and Effective Medical Image Understanding
Key Point 의료 영상 분석에서 추론 속도를 6배 이상 높이면서 정확도도 개선한 새로운 접근법이 등장해, 실시간 진단이 필요한 의료 AI 시스템의 효율성 개선 가능성을 보여준다.
핵심 요약
기존 의료 영상 분석 모델은 비전-언어 모델(VLM)로 추론 과정과 답변을 자동회귀 방식으로 생성해 불필요한 토큰이 많이 생기고 추론 비용이 증가한다. MedJev는 의료 이미지, 질문, 후보 답변을 한 번의 멀티모달 포워드 패스에서 직접 판단으로 매핑하는 시스템으로, 자동회귀 생성 과정을 완전히 제거한다. 언어 상층 레이어와 생성 출력 경로를 제거하면서 전체 비전 경로와 모든 시각 토큰은 유지하고, 미리 학습된 쿼리-키 매칭으로 각 후보를 점수 매긴 후 경량 MLP 잔차로 점수를 정제한다. 전체 요약 5문장 읽기 → 010 15:11 ▲ 44 · 댓글 3 병렬 가지로 나뉜 트랜스포머, 같은 비용에 성능 26% 향상 기존 Transformer 모델 확장(가로 확대 또는 깊이 추가) 외에 새로운 경로를 탐색하는 Multi-Branch Transformer(MBT)를 제시한다. AI · 머신러닝 · Multi-Branch Transformer
Key Point 병렬 가지 구조가 같은 학습 비용으로 성능을 26% 향상시키고 추론 속도와 메모리 효율을 동시에 개선하는 실제적인 모델 확장 경로를 보여준다.
핵심 요약
기존 Transformer 모델 확장(가로 확대 또는 깊이 추가) 외에 새로운 경로를 탐색하는 Multi-Branch Transformer(MBT)를 제시한다. 초기 공유 레이어를 거친 입력이 여러 개의 독립적 블록 가지들을 병렬로 처리한 뒤, 그 출력을 융합하고 최종 공유 레이어를 통과한다. Wide-Shallow, Narrow-Deep, Balanced 3가지 변형을 0.8B~2.1B 규모에서 실험한 결과, 2개 가지를 가진 Wide-Shallow MBT는 같은 파라미터·학습 비용의 순차 Transformer를 일관되게 능가했다. 전체 요약 8문장 읽기 → 011 15:11 ▲ 42 · 댓글 3 API만 열린 로봇 모델, 접촉력 감지로 조작 능력 70배 향상 프론티어 멀티모달 모델은 이미지만으로 로봇을 제어할 수 있지만, 많은 조작 작업에서 필요한 접촉력(contact force)은 이미지에 드러나지 않는 문제가 있다. AI · 머신러닝 · ForceHarness: Turning Force into Action and Physics for Frozen Frontier Models
Key Point 접촉력 센싱을 통해 순수 비전 기반의 로봇 제어를 넘어, 실제 조작 작업이 가능한 단계로 도약하는 기술로, 고정된 대형 모델의 활용 범위를 대폭 확장한다.
핵심 요약
프론티어 멀티모달 모델은 이미지만으로 로봇을 제어할 수 있지만, 많은 조작 작업에서 필요한 접촉력(contact force)은 이미지에 드러나지 않는 문제가 있다. ForceHarness는 파인튜닝이나 학습 데이터 없이 고정된 API 모델이 힘을 활용하도록 하는 하네스(harness) 시스템이다. 첫째 과제는 접촉이 API 모델의 응답 속도보다 빠르게 변하므로, 모델 아래에서 독립적으로 힘을 제어하는 자가-종료 프리미티브(self-terminating force primitives)를 구현해 접촉 이벤트에서 반환한다. 전체 요약 7문장 읽기 → 012 15:11 ▲ 24 · 댓글 4 로봇 움직임 추적·예측하는 TCP4D 모델 공개 로봇 조작 영상에서 RGB 이미지만으로 로봇 행동과 그리퍼 상태를 자동으로 복원하는 문제를 해결하기 위해 embodiment-agnostic tool-center-point(TCP) 포즈를 행동 공간으로 사용한다. AI · 머신러닝 · TCP4D: A Unified Tool-Center-Point Tracking and Generation Model for Robot Manipulation
Key Point 로봇 조작에서 비디오만으로 정확한 운동 궤적을 자동으로 추출·예측하고, 다른 로봇으로 쉽게 옮길 수 있다는 점이 로봇 학습 데이터 수집의 병목을 크게 줄일 수 있기 때문입니다.
핵심 요약
로봇 조작 영상에서 RGB 이미지만으로 로봇 행동과 그리퍼 상태를 자동으로 복원하는 문제를 해결하기 위해 embodiment-agnostic tool-center-point(TCP) 포즈를 행동 공간으로 사용한다. TCP4D는 공유하는 4D 장면 표현으로 관찰된 TCP 움직임을 추적하고 미래 TCP 궤적을 생성하는 통합 모델이다. 단안 카메라 영상과 초기 2D TCP 쿼리가 주어지면, 추적 모듈이 SE(3) 메트릭 TCP 포즈와 그리퍼 상태, 장면 기하학, 카메라 파라미터를 직접 복원한다. 전체 요약 8문장 읽기 → 013 15:11 ▲ 22 · 댓글 3 손 움직임으로 비디오 세상을 조종하는 AI 모델 텍스트나 카메라로만 조종하던 기존 비디오 월드 모델을 넘어, 손 움직임을 직접 입력받아 현실감 있게 반응하는 LynnReal-Hand를 개발했다. AI · 머신러닝 · LynnReal-Hand: Unlocking World Interaction with Hand Control
Key Point 손 제어라는 더 직관적인 인터페이스로 비디오 월드 모델을 확장한 기술로, 실시간 성능까지 달성해 향후 가상환경 상호작용의 새로운 표준이 될 수 있다.
핵심 요약
텍스트나 카메라로만 조종하던 기존 비디오 월드 모델을 넘어, 손 움직임을 직접 입력받아 현실감 있게 반응하는 LynnReal-Hand를 개발했다. 다양한 실제 환경과 가상 환경을 담은 100K개의 손-물체 상호작용 클립을 수집하고, 손 인식 감시 기법으로 미세한 손 동작과 물체 상호작용을 개선했다. 인과 흐름 맵을 학습해 소수 단계만에 생성하고, 비디오와 이미지 모델을 조합한 영역별 스코어 증류로 상호작용 역학과 시각 품질을 정제했다. 전체 요약 7문장 읽기 → 014 06:11 ▲ 10 · 댓글 3 LLM의 연구 아이디어 탐색 과정을 측정하는 'Re-Search' 벤치마크 공개 연구자들이 피드백을 받으며 아이디어를 반복 개선하는 과정을 반영하기 위해, 논문의 핵심 아이디어를 예/아니오 질문으로 재발견하는 Re-Search 벤치마크를 제안했다. AI · 머신러닝 · Re-Search: Dissecting LLM Ideation Through a Two-Player Questioning Game
Key Point LLM이 연구 아이디어를 어떻게 탐색하고 무엇에서 막히는지 구체적으로 측정할 수 있게 되면서, 자동화된 연구 시스템 개발의 현실적인 방향을 제시한다.
핵심 요약
연구자들이 피드백을 받으며 아이디어를 반복 개선하는 과정을 반영하기 위해, 논문의 핵심 아이디어를 예/아니오 질문으로 재발견하는 Re-Search 벤치마크를 제안했다. ICML 2026 출재 논문 200개로 구성되어 있으며, 모델이 질문을 던지고 이진 피드백을 받으면서 아이디어가 어떻게 진화하는지 추적한다. 6개의 최신 LLM을 테스트한 결과, 거의 모든 진전이 100개 질문 중 처음 30개 내에서 일어났으며, 이후로는 대부분 정체된다. 전체 요약 6문장 읽기 → 015 03:11 ▲ 15 · 댓글 2 장시간 비디오 생성 안정성 높이는 MovieRoll 프레임워크 스트리밍 비디오 생성 중 훈련 범위를 초과한 품질 유지와 캐시 비용 증가 문제를 해결하기 위해 MovieRoll이라는 기저-증류 프레임워크를 제시한다. AI · 머신러닝 · MovieRoll: A Systematic Framework for Rolling Out Long-Form Videos
Key Point 장시간 비디오 생성에서 품질 저하와 메모리 오버헤드 문제를 해결하는 체계적 접근법이 제시되어, 비디오 AI 모델 개발의 실질적 한계를 극복하는 기술로 주목된다.
핵심 요약
스트리밍 비디오 생성 중 훈련 범위를 초과한 품질 유지와 캐시 비용 증가 문제를 해결하기 위해 MovieRoll이라는 기저-증류 프레임워크를 제시한다. Window-wise Teacher Forcing(WinTF)을 통해 각 윈도우 내 양방향 주의와 이전 이력에 대한 인과 접근을 결합한 견고한 다단계 기저 모델을 구축한다. 계층별 주의 패턴을 활용한 계층화 KV 캐시 압축(HieraKV)으로 캐시 메모리를 최대 78% 감소시키면서 생성 품질을 개선한다. 전체 요약 6문장 읽기 → 016 00:11 ▲ 11 · 댓글 2 영상 생성 AI, 장시간 콘텐츠의 '동작 붕괴' 현상 해결 자동회귀 비디오 확산 모델(AR-VDM)은 실시간 장시간 영상 생성을 가능하게 하지만, 학습 범위를 벗어난 추론에서는 누적된 노출 편향으로 인해 급격히 성능이 저하된다. AI · 머신러닝 · Disen-Forcing: Disentangling Semantic Anchoring from Motion for Autoregressive Video Diffusion
Key Point 장시간 영상 생성에서 동작이 경직되는 문제의 근본 원인을 규명하고 실질적 해결책을 제시해 생성형 AI의 실용성을 높인다.
핵심 요약
자동회귀 비디오 확산 모델(AR-VDM)은 실시간 장시간 영상 생성을 가능하게 하지만, 학습 범위를 벗어난 추론에서는 누적된 노출 편향으로 인해 급격히 성능이 저하된다. 장시간 일관성을 유지하기 위해 최근 방법들은 초기 프레임을 고정시키는 '프레임 싱크' 기법을 사용해왔는데, 이는 LLM의 어텐션 싱크에서 영감을 얻었다. 연구진이 분석한 결과, 초기 프레임이 장시간 일관성을 안정화하는 메커니즘은 LLM식 어텐션 싱크가 아니라 적은 수의 어텐션 헤드가 의미론적 일관성을 담당하고, 대부분의 헤드는 지역적 시간 역학을 포착하는 방식이었다. 전체 요약 6문장 읽기 → 오늘의 주요최신순 상위 3건
01 AI · 머신러닝 15:11 게시
openai/openai-python
원제 openai/openai-python v3.55.0
v3.55.0
Key Point 파이썬 개발자가 OpenAI API를 사용할 때 MCP 서버 통합과 에이전트 기능 업데이트를 적용해야 하기 때문이다.
핵심 요약
OpenAI 파이썬 SDK v3.55.0이 11월 18일 릴리스됐다. Live MCP 서버 설정 기능이 API에 추가됐다. 관리형 에이전트(Managed Agents)의 세션 예산 제어 및 관련 이벤트가 숨김 처리됐다. 02 AI · 머신러닝 09:11 게시
openai/openai-python
원제 openai/openai-python v3.54.0
v3.54.0
Key Point OpenAI API를 활용하는 개발자들이 에이전트 비용을 체계적으로 관리할 수 있는 새로운 기능이 제공된다.
핵심 요약
OpenAI 파이썬 SDK v3.54.0이 릴리스되었다. Managed Agents 예산 이벤트 타입이 API에 추가되었다. 03 AI · 머신러닝 06:11 게시
openai/openai-python
원제 openai/openai-python v3.53.0
v3.53.0
Key Point OpenAI의 최신 모델과 기능이 Python SDK에 반영되어 개발자들이 즉시 활용할 수 있게 되었기 때문에, Python으로 OpenAI 서비스를 개발하는 사람들이 반드시 알아야 한다.
핵심 요약
OpenAI Python 라이브러리 v3.53.0이 릴리스되었다. 2시간과 8시간 길이의 Responses 배경 윈도우를 API에 추가했다. GPT-6.2 Astra Law Responses, GPT-6.2 Astra, GPT-6.2 Sol 세 가지 새로운 모델 식별자가 추가되었다. 전체 요약 4문장 읽기 → 전체 색인1건 · 분야별
AI · 머신러닝1건 001 06:11 새 버전 Anthropic Python SDK 2.10.0 출시, 결제 정책과 웹훅 기능 추가 Anthropic Python SDK 버전 2.10.0이 출시되어 결제 정책 요청 매개변수, 계약 지출 한도 초과 오류 코드, 외부 키 실패/복구 웹훅 이벤트 등 베타 기능이 추가됐다. AI · 머신러닝 · anthropics/anthropic-sdk-python@v2.10.0
Key Point 결제 및 외부 통합 기능이 추가되고 오류 처리와 문서화가 강화되어 Anthropic API 연동 프로젝트에서 더 견고한 구현이 가능해진다.
핵심 요약
Anthropic Python SDK 버전 2.10.0이 출시되어 결제 정책 요청 매개변수, 계약 지출 한도 초과 오류 코드, 외부 키 실패/복구 웹훅 이벤트 등 베타 기능이 추가됐다. API에 연결된 결제 거부 관련 오류 코드, user_profile_billing_not_authorized 오류 코드 등 결제 인증 관련 에러 처리가 강화됐다. aiohttp 연결 실패를 타임아웃으로 잘못 보고하던 버그가 수정되고, 더 이상 지원되지 않는 모델 별칭과 중첩된 타입이 계속 작동하도록 유지된다. 전체 요약 5문장 읽기 → ● 이번 피드는 여기까지입니다.
작은 발견을 다음 커밋으로 이어가세요. 모든 발행본