쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
27건 · "공간 추론"조건 지우기 ×
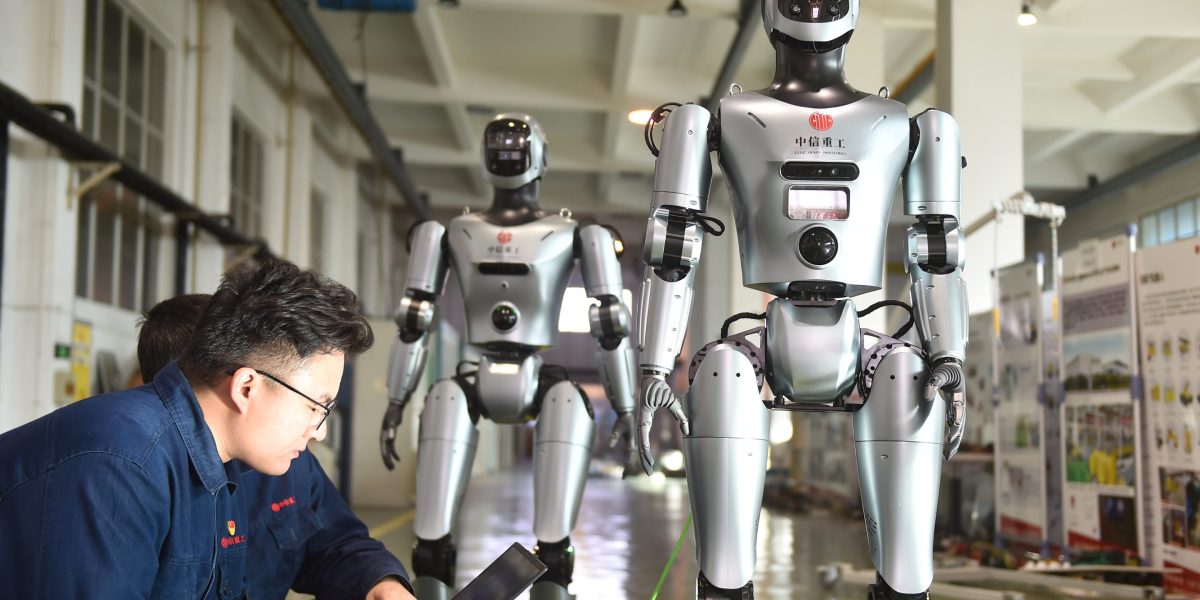
001 06:11 ▲ 105 · 댓글 41 OpenAI 로봇팀 해체, 범용 AI로의 전환 선언 OpenAI가 독립적인 로봇팀을 해체하고 연구원들을 다른 팀으로 재배치했다. 로봇 연구팀은 최고연구책임자 Mark Chen 산하 메인 연구팀으로, 응용로봇팀과 하드웨어팀은 President Greg Brockman 산하 Applied 조직으로 이동했다. AI · 머신러닝 · OpenAI disbands its robotics team as its general models start running robots
Key Point 범용 AI 모델이 로봇 제어 영역까지 침투하면서 로봇공학의 기술 스택과 경쟁 구도 자체가 재편될 수 있기 때문이다.
핵심 요약
OpenAI가 독립적인 로봇팀을 해체하고 연구원들을 다른 팀으로 재배치했다. 로봇 연구팀은 최고연구책임자 Mark Chen 산하 메인 연구팀으로, 응용로봇팀과 하드웨어팀은 President Greg Brockman 산하 Applied 조직으로 이동했다. OpenAI는 이를 로봇공학에 대한 헌신의 증거로 표현했으며, 로봇공학이 회사의 장기 비전의 핵심이라고 밝혔다. 2024년 창업사 Figure와 협력해 휴머노이드 로봇 AI 개발을 추진했으나 2025년 2월 Figure가 자체 개발로 전환하면서 협력이 종료됐다. AI 산업 전반에서 언어, 코드, 비전 분야의 범용 모델을 로봇 같은 물리적 장치를 제어하는 '구체화된 AI(embodied AI)'에 직접 적용할 수 있다는 가정이 확산 중이다. 이는 로봇 전용 특화 모델을 따로 개발할 필요가 없다는 의미다. 전체 요약 7문장 읽기 → 002 12:11 ▲ 104 · 댓글 2 로봇 범용 작업 위한 대규모 비전-언어 모델, 실제 얼마나 쓸 수 있나 로봇이 장면을 이해하고 행동하며 과제 조건을 충족하려면 어떤 능력이 필요한지 평가하기 위해 '구현된 에이전트 아레나'라는 벤치마크를 소개한다. AI · 머신러닝 · Are Frontier VLM Agents Ready to Be Robot Generalists? An Empirical Study with the Embodied Agent Arena
Key Point 현재 최첨단 VLM 에이전트들이 로봇 조작 작업에서 구체적으로 어떤 한계를 보이는지, 폐쇄형과 오픈 모델의 성능 격차가 어디서 비롯되는지 체계적으로 밝혔다.
핵심 요약
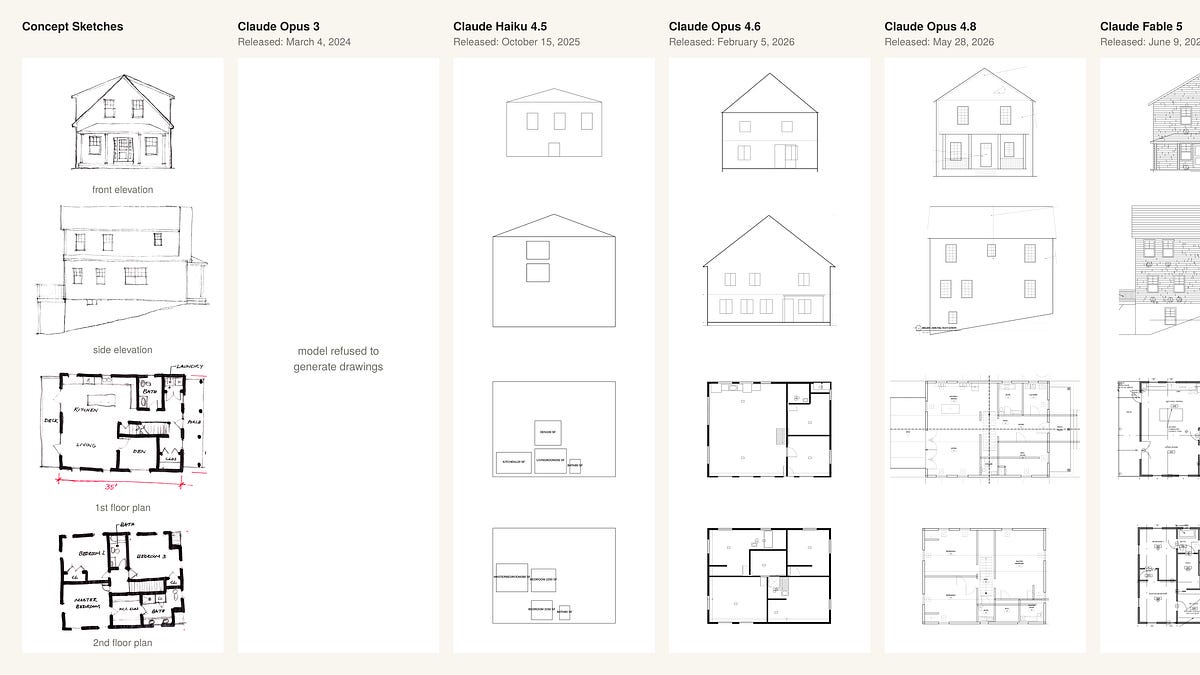
로봇이 장면을 이해하고 행동하며 과제 조건을 충족하려면 어떤 능력이 필요한지 평가하기 위해 '구현된 에이전트 아레나'라는 벤치마크를 소개한다. 이 벤치마크는 기하학, 공간 추론, affordance, 작업 계획, 조작 5개 영역을 평가하며, 32개 기존 데이터셋과 카메라·동작·깊이·스케일 추정을 위한 새로운 168개 케이스 GeoProbe로 총 1,000개 사례를 구성한다. 10개 VLM 에이전트를 평가한 결과, 폐쇄형 가중치 모델들이 5개 영역 모두에서 앞섰으나 오픈 가중치 VLM은 공간 추론은 유용하지만 계획과 조작 성공률이 훨씬 낮았다. 전체 요약 8문장 읽기 → 003 00:11 ▲ 103 · 댓글 35 Claude Opus 5.5, 건축 인허가 수준의 도면 자동 작성 가능 건축가인 저자가 13개 AI 모델의 기술도면 작성 능력을 테스트했으며, Anthropic의 Claude Opus 5.5(2026년 9월 출시)가 적절한 지도 하에 주택용 건축 인허가 수준의 완전한 도면 세트를 생산할 수 있음을 발견했다. AI · 머신러닝 · Claude Opus 5.5 Can Draw Permit-Level Architectural Drawings
Key Point 건축 설계와 도면 작업이 AI의 급속한 발전으로 근본적으로 변할 시점에 있으며, 숙련된 건축가도 현장에서 감독하기 어려운 변화가 임박해 있기 때문이다.
핵심 요약
건축가인 저자가 13개 AI 모델의 기술도면 작성 능력을 테스트했으며, Anthropic의 Claude Opus 5.5(2026년 9월 출시)가 적절한 지도 하에 주택용 건축 인허가 수준의 완전한 도면 세트를 생산할 수 있음을 발견했다. 2026년 봄까지 최강 AI 모델도 조악하고 만화 같은 기술도면만 생산했으나, 2026년 여름부터 가을 출시된 프론티어 모델들이 급격히 개선되었다. 첫 번째 테스트에서 Opus 5.5는 저자의 컨셉 스케치와 참조 도면 세트를 받아 12시간 걸려 완전한 건축 도면 세트를 생성했으며, 계산 비용은 수백 달러였다. 전체 요약 12문장 읽기 → 004 18:11 ▲ 39 · 댓글 2 이미지 생성을 위한 '연속 공간 추론' 통합 멀티모달 모델 LARC 통합 멀티모달 모델(UMM)이 다양한 멀티모달 작업에서 성공하지만, 언어 기반 사고 체인을 활용한 이미지 생성에서는 약점을 보인다. AI · 머신러닝 · Latent Reasoning in Continuous Space for Unified Multimodal Models
Key Point 이미지 생성 모델에서 추론과 생성의 공간 불일치를 해결하는 새로운 접근법으로, 테스트 시간 스케일링과 더 나은 제어 능력을 가능하게 한다.
핵심 요약
통합 멀티모달 모델(UMM)이 다양한 멀티모달 작업에서 성공하지만, 언어 기반 사고 체인을 활용한 이미지 생성에서는 약점을 보인다. 기존 추론 강화 모델들은 큰언어모델처럼 테스트 시간 스케일링이나 세밀한 제어 능력을 갖지 못하는데, 추론이 이산 토큰 공간에서 이뤄지면서 이미지 생성의 연속 공간과 불일치하기 때문이다. 연속 공간 잠재 추론(LARC) 프레임워크는 연속 숨겨진 상태를 기반으로 추론하여 토큰 수준의 병목을 해결한다. 전체 요약 6문장 읽기 → 005 21:11 ▲ 28 · 댓글 3 증거 연결로 멀티모달 인식 일반화시키는 EvidenceConnect 멀티모달 인식의 핵심은 관련 시각 정보를 식별하고, 엔티티와 바인딩하고, 관계를 회복해 답을 구성하는 '증거 연결' 능력이다. AI · 머신러닝 · Zooming without Zooming v2: From Seeing Details to Connecting Evidence for Generalizable Multimodal Perception
Key Point 멀티모달 모델의 세부 인식과 공간 이해를 동시에 개선하는 데이터 합성 기법이 소개되면서, VLM 학습의 효율성과 일반화 성능을 어떻게 높일 수 있는지 보여준다.
핵심 요약
멀티모달 인식의 핵심은 관련 시각 정보를 식별하고, 엔티티와 바인딩하고, 관계를 회복해 답을 구성하는 '증거 연결' 능력이다. EvidenceConnect는 한 이미지 내 관련 영역의 줌 뷰를 활용해 시각 증거의 비교·집계·체이닝을 요구하는 학습 데이터를 자동 생성한다. 데이터 품질 보증을 위해 독립적인 VLM들이 합의한 정답만 유지하고, 영역 제거 테스트로 특정 영역 제거해도 답변이 유지되는 문제를 걸러낸다. 전체 요약 6문장 읽기 → 006 15:11 ▲ 54 · 댓글 2 RynnUnify: 로봇 제어까지 아우르는 통합 embodied AI 모델 RynnUnify는 영상-언어 추론을 통해 embodied 이해와 장기 시각 계획을 결합한 160억 파라미터 통합 모델이다. AI · 머신러닝 · RynnUnify: Towards Unified Embodied Brain
Key Point 물리 세계 이해부터 실제 로봇 제어까지 하나의 모델으로 통합하려는 시도로, embodied AI 연구의 새로운 기준을 제시한다.
핵심 요약
RynnUnify는 영상-언어 추론을 통해 embodied 이해와 장기 시각 계획을 결합한 160억 파라미터 통합 모델이다. 공간 추론, 물리 예측, 그라운딩 능력으로 물리 세계에 대한 이해와 변화 예측을 연결한다. 강화학습으로 에이전트 확장 버전을 개발했으며, 관찰되지 않은 상태와 상호작용 결과 추론을 위해 영상 예측을 선택적으로 활용한다. 전체 요약 8문장 읽기 → 007 18:11 ▲ 13 · 댓글 2 다중 에이전트 협력을 위한 추상적 '마음 이론'을 잠재 공간에서 학습 다중 에이전트 협력에서 정확한 마음 이론(Theory-of-Mind, ToM)을 형성하려면 여러 파트너 상태를 동시에 추론해야 하는데, LLM 에이전트의 텍스트 표현으로는 하나의 상태만 효과적으로 표현되는 문제가 있다. AI · 머신러닝 · ToM2Vec: Continuous Theory-of-Mind Tokens for Multi-Agent Coordination
Key Point LLM 기반 멀티에이전트 시스템에서 파트너의 의도를 정확히 파악해야 하는 협력 작업에 새로운 접근법을 제시하며, 잠재 공간 추론이 텍스트보다 효과적임을 실증적으로 보여준다.
핵심 요약
다중 에이전트 협력에서 정확한 마음 이론(Theory-of-Mind, ToM)을 형성하려면 여러 파트너 상태를 동시에 추론해야 하는데, LLM 에이전트의 텍스트 표현으로는 하나의 상태만 효과적으로 표현되는 문제가 있다. 이를 해결하기 위해 ToM2Vec을 제안했으며, 이는 고정된 예산의 연속 추론 토큰을 통해 풍부한 잠재 공간에서 추상적인 마음 이론을 학습한다. 학습 중에는 파트너의 실제 생각을 감독 신호로 사용하여 ToM 토큰이 이를 추상화하고 일치시키도록 훈련된다. 전체 요약 8문장 읽기 → 008 03:11 ▲ 31 · 댓글 2 자연어로 영화같은 카메라 움직임을 3D 환경에서 자동 생성 FilmFlow는 자연어 지시나 참고 영상을 3D 가상 환경의 실행 가능한 카메라 궤적으로 변환하는 에이전트 시스템이다. AI · 머신러닝 · FilmFlow: Agentic System for 3D Virtual Film Cinematography
Key Point 자연어 지시만으로 3D 환경의 영화급 카메라 동작을 자동으로 계획·실행할 수 있게 되면, 영화·게임·VR 등 다양한 미디어 제작 환경에서 영상 제작 시간을 크게 단축할 수 있다.
핵심 요약
FilmFlow는 자연어 지시나 참고 영상을 3D 가상 환경의 실행 가능한 카메라 궤적으로 변환하는 에이전트 시스템이다. Director 에이전트가 병렬 원자 동작들을 조합해 이동·회전·프레이밍을 동시에 제어하는 고수준 카메라 계획을 생성한다. Interpreter는 장면 기반 영화적 의도를 추출하고, Scout는 초기 시점을 선택하며, Critic은 렌더링 결과를 평가하고 시각적 피드백으로 반복 개선한다. 전체 요약 6문장 읽기 → 009 00:11 ▲ 17 · 댓글 2 공간 추론 AI, 경험 학습으로 성능 향상 공간 추론은 기하학적 도구 접근만으로는 부족하며, 직접 관찰이 충분한 때와 재구성·측정·좌표 변환이 필요한 때를 판단해야 한다. AI · 머신러닝 · SpatialBrain: Spatial Intelligence Growing from Experience
Key Point 시각-언어 모델의 구조를 바꾸지 않으면서도 공간 추론 작업의 경험을 메모리에 저장해 성능을 높이는 새로운 방식으로, AI의 추론 능력 확장 방향을 보여준다.
핵심 요약
공간 추론은 기하학적 도구 접근만으로는 부족하며, 직접 관찰이 충분한 때와 재구성·측정·좌표 변환이 필요한 때를 판단해야 한다. SpatialBrain은 비전-언어 모델의 기본 구조는 유지하면서 공간 추론 경험을 축적하는 프레임워크다. 3DFusionMemory가 현재 장면의 관찰을 융합해 쿼리 가능한 공간 관계로 변환하고, Spatial Skill Library는 재사용 가능한 도구 절차를 제공한다. 전체 요약 7문장 읽기 → 010 18:11 ▲ 104 · 댓글 2 3D 공간 이해 AI, 코딩 에이전트로 대폭 강화 3D 공간에서 객체의 위치와 관계, 움직임을 파악하는 공간 추론 작업에서 비전-언어 모델의 성능을 높이기 위해 S-Agent 2.0을 개발했다. AI · 머신러닝 · S-Agent 2.0: Spatial Reasoning with a General Coding Agent
Key Point 3D 공간 추론 작업에서 도구가 제공한 정보를 모델이 제대로 해석하지 못하는 근본적인 문제를 기존 방식보다 더 효과적으로 해결하는 접근법을 제시한다.
핵심 요약
3D 공간에서 객체의 위치와 관계, 움직임을 파악하는 공간 추론 작업에서 비전-언어 모델의 성능을 높이기 위해 S-Agent 2.0을 개발했다. 기존 접근은 도구가 올바른 정보를 제공해도 모델이 최종 답을 내지 못하는 '증거 해석 간극'이 문제였다. S-Agent 2.0은 범용 코딩 에이전트에 명령줄 기반 3D 지각 도구 세트를 통합했으며, 장면 정보 수집 → 기억 저장 → 공간 언어로 해석하는 단계를 거친다. 전체 요약 8문장 읽기 → 011 21:11 ▲ 23 · 댓글 2 AI가 실사진으로 3D 모델 만드는 능력을 재보다 멀티모달 LLM이 자율 에이전트로 작동하며 코드나 소프트웨어 조작을 통해 3D 모델을 생성·편집할 수 있게 되면서, 실제 워크플로우에서 참고 자료로부터 물체 형상·재질·공간 배치·조명을 추론하고 지시를 따라 3D 콘텐츠를 재구성·수정·설계해야 한다. AI · 머신러닝 · BlenderWorld: Benchmarking Visual Agents for 3D Creation from Real-World References
Key Point LLM 기반 AI 에이전트가 3D 모델링 작업을 수행할 수 있게 되면서, 실무 수준의 성능 평가 기준이 필요해졌고, 이 벤치마크가 현재 모델들의 공간 추론 능력의 한계를 명확히 드러낸다.
핵심 요약
멀티모달 LLM이 자율 에이전트로 작동하며 코드나 소프트웨어 조작을 통해 3D 모델을 생성·편집할 수 있게 되면서, 실제 워크플로우에서 참고 자료로부터 물체 형상·재질·공간 배치·조명을 추론하고 지시를 따라 3D 콘텐츠를 재구성·수정·설계해야 한다. 기존 벤치마크는 현실 시나리오에 걸친 열린 형태의 요청을 제한적으로 다루고 있어, 이 간극을 메우기 위해 BlenderWorld 벤치마크를 개발했다. BlenderWorld는 건축·제품·자연환경·과학 시각화 분야의 223개 과제로 구성되며, 텍스트·이미지·비디오·구조화된 명세서를 입력으로 받는다. 전체 요약 6문장 읽기 → 012 09:11 ▲ 158 · 댓글 97 텍스트와 잠재 공간을 넘나드는 하이브리드 추론 에이전트 기존 LLM 에이전트는 추론과 상호작용을 모두 텍스트로 처리하는데, 효율적인 내부 추론 방식(잠재 공간 추론)과 도구 접근성 사이의 불균형이 있다. AI · 머신러닝 · Hybrid Reasoning Agents: LLM agents that think in latent space, act through text
Key Point 텍스트만으로 처리하던 LLM 에이전트의 비효율성을 내부 잠재 추론과 외부 텍스트 상호작용으로 분리해 대폭적인 속도와 비용 개선을 달성한 새로운 에이전트 아키텍처이다.
핵심 요약
기존 LLM 에이전트는 추론과 상호작용을 모두 텍스트로 처리하는데, 효율적인 내부 추론 방식(잠재 공간 추론)과 도구 접근성 사이의 불균형이 있다. HybridAgents는 하나의 생성 과정 내에서 잠재 추론과 텍스트 기반 상호작용을 동적으로 전환하는 구조를 제시한다. HybridLink라는 경량 모듈이 텍스트와 잠재 모드 간 원활한 전환을 가능하게 하며, 지속적인 작업 메모리가 여러 턴에 걸쳐 손실 없는 하이브리드 문맥을 유지한다. 전체 요약 9문장 읽기 → 013 18:11 ▲ 354 · 댓글 2 VLM의 "빠른 사고": 공간 추론을 분류 문제로 재구성 비전-언어 모델(VLM)이 공간 관계, 거리, 위치 같은 질문에 자동 회귀 방식으로 텍스트를 생성하는 것은 비효율적이다. 이에 MJev-Spatial은 공간 이해 작업을 통일된 분류 프레임워크로 재구성한 System 1 모델이다. AI · 머신러닝 · MJev-Spatial: System One Spatial Intelligence via Native Attention Matching
Key Point 공간 추론 같은 제약된 답변 공간 작업을 분류로 바꾸면 자동 회귀 생성의 지연 없이 단일 포워드 패스로 정확하게 풀 수 있으며, 이는 로봇 제어나 실시간 상호작용이 필요한 애플리케이션의 성능 개선으로 이어진다.
핵심 요약
비전-언어 모델(VLM)이 공간 관계, 거리, 위치 같은 질문에 자동 회귀 방식으로 텍스트를 생성하는 것은 비효율적이다. 이에 MJev-Spatial은 공간 이해 작업을 통일된 분류 프레임워크로 재구성한 System 1 모델이다. 선택 문제는 주어진 옵션을 클래스로, 수치 예측은 값 범위를 이진 분류 단계로, 점 예측은 이미지 영역을 단계적으로 분류하는 방식이다. 기존 VLM의 쿼리-키 사영을 재사용해 추가 파라미터 없이 후보를 점수 매기므로, 추론 시 단 한 번의 포워드 패스로 답을 내놓고 답변 토큰을 생성하지 않는다. 전체 요약 5문장 읽기 → 014 18:11 ▲ 202 · 댓글 2 비전-언어 모델의 3D 공간 추론 능력을 평가하는 RoTA-Bench 공개 비전-언어 모델이 2D 이미지에서 3D 공간 이해로 전환할 수 있는지 평가하는 벤치마크 RoTA-Bench를 개발했다. AI · 머신러닝 · RoTA-Bench: Evaluating 3D Spatial Reasoning through Interactive Projection Alignment
Key Point GPT-4o 같은 최신 모델도 3D 공간 추론과 정밀한 조작에서 인간과 큰 격차를 보이고 있으며, 이는 멀티모달 AI의 실제 응용 한계를 드러낸다.
핵심 요약
비전-언어 모델이 2D 이미지에서 3D 공간 이해로 전환할 수 있는지 평가하는 벤치마크 RoTA-Bench를 개발했다. 목표 실루엣이 주어질 때 회전된 물체를 관찰하고 연속적인 회전 조작으로 목표 투영을 복구하는 방식으로 평가한다. 자동화된 파이프라인으로 2D 아이콘에서 3D 물체를 생성하고, 가역적 초기화로 해결 가능성을 보장해 674개 작업과 100개 테스트셋을 구축했다. 전체 요약 7문장 읽기 → 015 15:11 ▲ 28 · 댓글 2 텍스트와 잠재 공간을 넘나드는 하이브리드 추론 에이전트 현대 LLM 에이전트는 텍스트로만 추론하고 상호작용하지만, 잠재 공간 추론은 효율적이면서도 도구 접근과 추론 투명성이 부족한 문제를 해결하기 위해 하이브리드 추론 에이전트(HybridAgent)가 제안됐다. AI · 머신러닝 · Hybrid Reasoning Agents
Key Point LLM 에이전트의 추론 효율성과 투명성을 동시에 높이는 새로운 아키텍처로, 토큰 절감과 속도 개선이 이미 검증된 실질적인 개선 방안이다.
핵심 요약
현대 LLM 에이전트는 텍스트로만 추론하고 상호작용하지만, 잠재 공간 추론은 효율적이면서도 도구 접근과 추론 투명성이 부족한 문제를 해결하기 위해 하이브리드 추론 에이전트(HybridAgent)가 제안됐다. HybridAgent는 통합 생성 프로세스 내에서 잠재 추론과 텍스트 기반 상호작용을 동적으로 전환하며, 가벼운 HybridLink가 두 모드 간 seamless한 전환을 가능케 한다. 에이전트의 지속적 작업 메모리는 다중 턴에서 손실 없는 하이브리드 컨텍스트를 유지하고, 도구 통합 기능을 보존하면서도 잠재 사고(latent thoughts)를 직접 검사할 수 있도록 설계됐다. 전체 요약 6문장 읽기 → 016 18:11 ▲ 25 · 댓글 2 언어-행동 이중 부트스트래핑으로 네비게이션 성능을 자동 개선하다 자연어 지시를 따라 목표 위치에 도달하는 비전-언어 네비게이션 모델을 만들 때 고품질의 언어 감독 데이터가 필수이나, 사람이 직접 주석을 다는 것은 비용이 많이 든다. AI · 머신러닝 · Data-Centric Recursive Self-Improvement for Navigation via Policy-Synchronized Language-Action Dual Bootstrapping
Key Point 고비용의 인간 주석 없이도 모델이 스스로 학습 데이터를 생성하고 개선하는 방식은 대규모 AI 시스템의 데이터 확보 문제를 어떻게 풀 수 있는지 보여주는 중요한 사례다.
핵심 요약
자연어 지시를 따라 목표 위치에 도달하는 비전-언어 네비게이션 모델을 만들 때 고품질의 언어 감독 데이터가 필수이나, 사람이 직접 주석을 다는 것은 비용이 많이 든다. 기존 방법들은 네비게이션과 명령어 생성을 분리된 모델로 처리하거나 특정 컴포넌트로 묶어서 처리하는 한계가 있었고, 고정된 모델로 전체 궤적을 미리 주석해서 생성된 감독이 진화하는 정책에 뒤처지는 문제가 있었다. 논문은 RSI-Nav라는 데이터 중심의 재귀적 자가개선 프레임워크를 제안하며, 하나의 공유 모델로 비전-언어-행동 명령 수행과 비전-행동-언어 명령 생성을 통합한다. 전체 요약 7문장 읽기 → 017 15:11 ▲ 18 · 댓글 2 시각 모델도 '다각도로 생각한다'…공간 추론 학습법 제시 인간이 공간 문제를 풀 때 머리 속으로 여러 시점에서 장면을 재구성하는데, 현재의 대규모 비전-언어 모델(LVLM)은 이런 능력이 부족하다. AI · 머신러닝 · SpatialASM: Internalizing Active Mentalization for Spatial Reasoning
Key Point 거대 비전-언어 모델이 공간 추론 시 인간처럼 다각도 사고를 할 수 있도록 만드는 실질적인 학습 방법론을 제시해 모델 기반 시각 이해의 한계를 구체적으로 개선한다.
핵심 요약
인간이 공간 문제를 풀 때 머리 속으로 여러 시점에서 장면을 재구성하는데, 현재의 대규모 비전-언어 모델(LVLM)은 이런 능력이 부족하다. 연구팀은 이를 '능동적 공간 심상화(Active Spatial Mentalization, ASM)'라 정의하고, LVLM에 이 능력을 내재화하는 SpatialASM 프레임워크를 제시했다. SpatialASM은 학습 단계에서 시뮬레이션된 다양한 시점으로 학습하며, 할로센트릭(allocentric) 뷰 생성 모델을 사용해 가설적 시점을 실제 시각 데이터에 근거하게 한다. 전체 요약 6문장 읽기 → 018 18:12 ▲ 275 · 댓글 2 멀티모달 AI의 공간 추론 메커니즘 규명 멀티모달 언어 모델의 공간 추론 능력은 입증되었으나 내부 작동 원리는 미지의 영역이었다. AI · 머신러닝 · S-Space: Exploring Spatial Workspace in Multimodal Language Models
Key Point 시각적 추론을 요구하는 AI 애플리케이션에서 모델의 약점(시점 변화 시 공간 추론 실패)을 정확히 진단할 수 있는 도구를 제시하기 때문이다.
핵심 요약
멀티모달 언어 모델의 공간 추론 능력은 입증되었으나 내부 작동 원리는 미지의 영역이었다. 연구팀이 'S-Space'라는 선형 표현 부분공간을 발견했으며, 여기에 객체 토큰이 가로·세로·거리 축을 따라 연속적 좌표로 인코딩된다. S-Space는 특정 데이터나 프롬프트로 유도되지 않고 모델에 내재되어 있으며, 공간과 무관한 질문에서도 판독 가능하다. 전체 요약 8문장 읽기 → 019 12:11 ▲ 11 · 댓글 2 비전-언어 모델의 공간 추론 능력 평가 벤치마크 공개 시각-언어 모델의 공간 추론 능력을 평가하는 첫 벤치마크 SpaceCast-Bench를 공개했다. AI · 머신러닝 · SpaceCast-Bench: Evaluating Predictive Spatial Reasoning in Vision-Language Models
Key Point 현재 주류 시각-언어 모델들이 보이는 공간을 읽기만 하는 수준이며, 실제 공간 추론 능력에서 심각한 격차를 보이고 있기 때문이다.
핵심 요약
시각-언어 모델의 공간 추론 능력을 평가하는 첫 벤치마크 SpaceCast-Bench를 공개했다. 182개의 실제 장면에서 3,862개 질문으로 구성되며, 정적 인식·국소 예측·전역 예측의 3단계 16가지 과제를 포함한다. 기존 벤치마크는 입력에 이미 보이는 관계를 읽는 지각 능력만 테스트하지만, SpaceCast-Bench는 장면을 구성하고 개입의 결과를 예측하는 예측적 공간 추론을 직접 평가한다. 전체 요약 6문장 읽기 → 020 12:11 ▲ 12 · 댓글 2 공간 추론 AI, 도구 없이도 학습 가능 멀티모달 대형언어모델(MLLM)의 공간 추론 능력을 높이는 기존 방식은 외부 코딩 도구를 써야 해 추론 시간이 길고 외부 의존성이 높다. AI · 머신러닝 · SpatialOPSD: Self-Distilling Spatial Intelligence from Verified Coding Agent Traces
Key Point 공간 추론 능력이 필요한 비전-언어 작업에서 외부 도구 의존을 제거하면서도 성능을 유지할 수 있다는 점이 중요하며, 자기 증류를 통한 에이전트 능력 내재화는 더 효율적인 AI 시스템 구축에 시사점을 준다.
핵심 요약
멀티모달 대형언어모델(MLLM)의 공간 추론 능력을 높이는 기존 방식은 외부 코딩 도구를 써야 해 추론 시간이 길고 외부 의존성이 높다. 연구팀은 MLLM이 도구 없이 공간 추론을 스스로 수행할 수 있는지 탐구했고, 검증된 코딩 에이전트의 실행 추적(trace)을 요약해 모델에 보여주면 내부 사고 과정이 활성화됨을 발견했다. 이를 바탕으로 SpatialOPSD라는 자기 증류(self-distillation) 프레임워크를 제안했으며, 검증된 에이전트 추적을 특권 정보로 취급해 모델에 공간 추론을 내재화한다. 전체 요약 5문장 읽기 → 021 18:35 ▲ 11 · 댓글 2 VLM에 세계 모델 통합, 공간 추론 성능 39% 향상 인간이 시각적 변환을 정신적으로 시뮬레이션해 공간 문제를 푸는 것과 달리, 기존 시각언어모델(VLM)은 주로 언어로만 추론한다. AI · 머신러닝 · WM-VLM: Probing Internal World Models for Interleaved Visual-Textual Reasoning
Key Point 시각언어모델이 공간 추론을 하기 위해 중간 시각 상태 생성이 얼마나 효과적인지 보여주는 실증적 증거를 제시하며, VLM의 추론 메커니즘을 개선할 새로운 접근법을 제안한다.
핵심 요약
인간이 시각적 변환을 정신적으로 시뮬레이션해 공간 문제를 푸는 것과 달리, 기존 시각언어모델(VLM)은 주로 언어로만 추론한다. 텍스트와 생성된 시각 상태를 모두 활용해 공간 문제를 해결할 수 있는 VLM을 만들기 위해 WM-VLM을 제안했다. WM-VLM은 사전학습된 VLM에 가벼운 세계 모델 브랜치를 추가해 중간 시각 상태를 생성한다. 전체 요약 8문장 읽기 → 022 21:11 ▲ 47 · 댓글 1 장시간 영상 생성 모델에 공간 기억 지능 더하다 장시간 영상 생성과 월드 모델은 사용자 행동과 과거 기억을 바탕으로 미래 관측치를 예측해 상호작용 가능한 엔터테인먼트와 embodied simulation을 실현했으나, 메모리 길이가 길어지고 구조가 복잡해질수록 장거리 공간 맥락 관리가 어려워진다. AI · 머신러닝 · Spatial Memory Intelligence: Endowing World Models with Understanding-Driven Long-Term Memory
Key Point MLLM의 공간 이해 능력을 처음으로 체계적으로 메모리 관리에 적용해 장시간 영상 생성의 근본적인 한계를 푸는 새로운 접근이다.
핵심 요약
장시간 영상 생성과 월드 모델은 사용자 행동과 과거 기억을 바탕으로 미래 관측치를 예측해 상호작용 가능한 엔터테인먼트와 embodied simulation을 실현했으나, 메모리 길이가 길어지고 구조가 복잡해질수록 장거리 공간 맥락 관리가 어려워진다. Spatial Memory Intelligence(SMI)는 다중모드 대규모 언어 모델(MLLM)의 공간 추론 능력을 활용해 장시간 영상 월드 모델의 메모리 관리를 체계화한 첫 프레임워크다. SMI는 공간 클러스터링, 클러스터 내 스파시피케이션, 행동 기반 검색, 신뢰도 기반 필터링 4개의 조정된 원자 연산을 도입한다. 전체 요약 4문장 읽기 → 023 15:11 ▲ 53 · 댓글 1 MLLM도 3D 상상력이 필요하다 - 다중뷰 이해의 새 방법 멀티모달 LLM(MLLM)이 다중 이미지로부터 3D 공간을 이해하는 것이 근본적 과제인 가운데, 기존 방식은 화소 단위 대응이나 3D 기하 모델 통합을 시도했지만 인간의 추론에는 미치지 못했다. AI · 머신러닝 · Imagine3D-LLM: Teaching MLLMs to Imagine 3D Scenes Before Answering
Key Point 다중뷰 3D 이해라는 MLLM의 핵심 약점을 인간의 추론 방식으로 해결하는 새로운 접근으로, 구조화된 3D 표현 학습이 모델 전체의 기하 인식을 높이는 메커니즘을 제시한다.
핵심 요약
멀티모달 LLM(MLLM)이 다중 이미지로부터 3D 공간을 이해하는 것이 근본적 과제인 가운데, 기존 방식은 화소 단위 대응이나 3D 기하 모델 통합을 시도했지만 인간의 추론에는 미치지 못했다. 본 연구는 인간의 공간 추론 방식에 영감을 받아, 세밀한 기하 단서보다는 뷰 간 공통 객체 인식 → 상대 기하 추론 → 장면의 대략적 3D 배치 조립 과정을 모방한다. Imagine3D-LLM은 이미지 토큰 뒤에 학습 가능한 요약 토큰 집합을 추가하고, 이를 3D 가우시안 스플래팅 표현으로 복원한다. 전체 요약 6문장 읽기 → 024 06:11 ▲ 14 · 댓글 2 이미지 생성으로 추론하기, 멀티모달 LLM 성능 25% 향상 Chain-of-thought 추론은 LLM이 문제를 중간 단계로 분해해 답하도록 하며 자연어 처리를 혁신했지만, 시각 표현의 직접 조작이 필요한 작업에서는 한계를 보인다. AI · 머신러닝 · Reasoning with Image Generation
Key Point 이미지 생성을 추론 도구로 활용해 멀티모달 LLM 성능을 크게 개선하는 방식을 제시하며, 비전 작업의 새로운 접근법을 보여준다.
핵심 요약
Chain-of-thought 추론은 LLM이 문제를 중간 단계로 분해해 답하도록 하며 자연어 처리를 혁신했지만, 시각 표현의 직접 조작이 필요한 작업에서는 한계를 보인다. 기존 멀티모달 LLM은 깊이 추정·객체 탐지 같은 고정된 좁은 기능의 외부 시각 도구에 의존하며, 이들은 유연하게 시각 콘텐츠를 생성하거나 변환할 수 없다. 연구팀이 제안한 ReImaGin은 이미지 생성 모델을 멀티모달 LLM의 유연한 시각 추론 메커니즘으로 활용하는데, 고정 기능 도구와 달리 자연어 명령을 받아 오클루전 제거나 여러 시점에서 실내 평면도 생성 등 개방형 시각 작업을 수행한다. 전체 요약 4문장 읽기 → 025 03:11 ▲ 16 · 댓글 2 GPT-6 Astra의 컴퓨터 비전 능력 평가, 일반형 AI의 한계 드러나 Frontier 수준의 범용 AI 시스템들이 전통적인 컴퓨터 비전 모델의 영역으로 확대되고 있다. AI · 머신러닝 · Hard Vision, Easy Vision: What GPT-6 Astra Reveals Across Computer Vision
Key Point 범용 AI 모델의 컴퓨터 비전 능력 한계를 구체적으로 파악할 수 있으며, 향후 비전 모델 개발의 방향성을 시사한다.
핵심 요약
Frontier 수준의 범용 AI 시스템들이 전통적인 컴퓨터 비전 모델의 영역으로 확대되고 있다. GPT-6 Astra를 포함한 5개 frontier AI 시스템을 9개 비전 영역, 55개 벤치마크, 34개 능력에 걸쳐 평가했다. Astra는 시각 및 공간 추론과 구조화된 예측 분야에서 다른 frontier 시스템들을 크게 앞섰다. 전체 요약 7문장 읽기 → 026 15:11 ▲ 18 · 댓글 2 멀티뷰 학습으로 공간 추론 강화한 SpatialSpeak 공개 비전-언어 모델(VLM)이 다중 관점 공간 추론을 위해 기하학적 사전 정보를 활용하지만, 기존 답 위주의 학습은 중간의 기하학적 추정과 정량적 공간 답 도출 과정을 직접 감독하지 않는다. AI · 머신러닝 · SpatialSpeak: QA-Native Reconstruction with Local and Global Context for Spatial Chain-of-Thought Reasoning
Key Point 비전-언어 모델의 공간 추론 능력을 크게 향상하는 새로운 학습 방식이 제시되었으며, 멀티뷰 재구성과 사고의 흐름 학습을 결합한 접근법이 기하학적 이해와 답 도출 과정 모두를 강화한다.
핵심 요약
비전-언어 모델(VLM)이 다중 관점 공간 추론을 위해 기하학적 사전 정보를 활용하지만, 기존 답 위주의 학습은 중간의 기하학적 추정과 정량적 공간 답 도출 과정을 직접 감독하지 않는다. 연구팀은 VLM이 멀티뷰 재구성을 통해 국소 기하학과 전역 장면 맥락을 함께 학습할 때 공간 사고의 흐름(CoT) 감독이 더 효과적이라고 가정했다. SpatialSpeak은 두 단계 프레임워크로, 1단계(QA-Native Reconstruction Pretraining, QA-RP)에서 표시된 점 기반 3D 쿼리로 세밀한 국소 기하학을 학습하고 객체 중심 쿼리로 전역 장면 맥락을 학습한다. 전체 요약 8문장 읽기 → 027 22:29 ▲ 47 · 댓글 4 현실 상호작용으로 배우는 공간 추론, VLM의 약점을 잡다 시각-언어 모델(VLM)이 물리 세계에서 행동하려면 동적 환경에서 물체의 움직임과 시점 변화로 인한 국지적 상태 전이를 감지하고 이를 장기 궤적에 걸쳐 통합해 공간 상태를 유지해야 한다. AI · 머신러닝 · Spatial-Interactor: Learning Spatial Reasoning through Interaction with the Observable Physical World
Key Point VLM이 로봇·자율주행·구체화 AI 등 현실 세계 상호작용이 필요한 분야에서 공간 추론 능력을 크게 제약받고 있으며, 상호작용 궤적이라는 자연스러운 감독 신호를 활용해 이를 체계적으로 해결하는 방법을 제시한다.
핵심 요약
시각-언어 모델(VLM)이 물리 세계에서 행동하려면 동적 환경에서 물체의 움직임과 시점 변화로 인한 국지적 상태 전이를 감지하고 이를 장기 궤적에 걸쳐 통합해 공간 상태를 유지해야 한다. 기존 VLM 훈련은 객체 속성과 공간 관계의 정적 질문에 집중해 상태 전이에 대한 직접적 감독이 부족하지만, 상호작용 궤적은 선행 관찰·행동·후속 관찰을 자연스럽게 연결해 국지적 상태 전이에 대한 직접 감독을 제공한다. 연구진은 VLM이 상호작용을 통해 물리 세계의 상태 전이를 모델링하도록 훈련하는 Spatial-Interactor 프레임워크를 제안했으며, L1 수동적 세계 상태 전이, L2 능동적 자기 상태 전이, L3 장기 상호작용 궤적으로 구성된 3단계 커리큘럼으로 학습 과정을 조직화했다. 전체 요약 6문장 읽기 →