쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 22일 (일)까지 5067건
29건 · "로컬 LLM"조건 지우기 ×
001 09:11 새 버전 올라마 0.40.16 출시, Ripple 모델 지원 추가 올라마 v0.40.16이 릴리스되었다. 오픈소스 · 도구 · ollama/ollama@v0.40.16
Key Point 로컬 LLM 개발·배포의 중심 도구인 올라마의 기능 확대와 최적화가 이뤄졌으며, 특히 65B 코딩 전문 모델 추가와 메모리 효율성 개선으로 실무 적용 성이 높아진다.
핵심 요약
올라마 v0.40.16이 릴리스되었다. Recursive Intelligence의 Ripple Preview라는 65B 규모 에이전틱 코딩 모델을 새로 지원한다. Qwen3.8 Flash는 애플 실리콘에서 약 27GB 메모리를 절약하도록 최적화되었다. 전체 요약 9문장 읽기 → 002 18:11 새 버전 Ollama v0.40.14 출시, Claude 모델 토큰 제한 개선 Ollama launch claude 명령이 Claude 모델의 출력 토큰 제한을 적용하여 클라우드 모델이 기본 128k 상한에 걸리지 않도록 개선했다. AI · 머신러닝 · ollama/ollama@v0.40.14
Key Point Claude 모델 통합 개선과 OpenAI 호환성 버그 수정으로 로컬 LLM 모델 서빙의 안정성과 호환성이 강화된다.
핵심 요약
Ollama launch claude 명령이 Claude 모델의 출력 토큰 제한을 적용하여 클라우드 모델이 기본 128k 상한에 걸리지 않도록 개선했다. /api/chat의 웹 검색 응답이 압축된 응답을 포함하여 올바르게 디코딩되도록 수정했다. OpenAI 호환 엔드포인트가 더 이상 모델의 기본 샘플러 설정을 덮어쓰지 않으므로, 온도/top_p를 지정하지 않은 클라이언트는 1.0 대신 모델의 기본값을 받는다. 전체 요약 7문장 읽기 → 003 21:11 당일 +140 290B 모델을 데스크톱에서 실행하는 엣지 추론 엔진 FreeToken FreeToken은 개인용 하드웨어에서 290B 이상의 대규모 혼합 전문가(MoE) 모델을 로컬에서 빠르게 실행하는 엣지 추론 엔진이다. AI · 머신러닝 · FlashML-org/FreeToken · Python
Key Point 소비자용 GPU로 290B 규모의 대형 MoE 모델을 실시간 속도로 로컬 실행할 수 있게 되어, 개인 개발자와 소규모 팀도 엣지에서 프론티어급 AI 모델을 직접 운영할 수 있는 가능성을 열어준다.
핵심 요약
FreeToken은 개인용 하드웨어에서 290B 이상의 대규모 혼합 전문가(MoE) 모델을 로컬에서 빠르게 실행하는 엣지 추론 엔진이다. GPU, CPU, 호스트 메모리, 상호연결을 통합 플랫폼으로 활용하며, 대역폭 적응형 CPU-GPU 협력 실행(q* 정책)과 레이어 이중 버퍼링 프리필 스트리밍을 지원한다. 의미 기반 캐싱으로 상태와 KV 캐시의 앵커 체크포인트를 저장하여, 도구 호출·사고 블록 같은 에이전트 컨텍스트 편집 시 중복 재계산을 피한다. 전체 요약 9문장 읽기 → 004 03:10 ▲ 145 · 댓글 93 가벼운 LLM 코딩 에이전트 'Prospero' 출시 개발자가 로컬 LLM으로 프로그래밍 작업을 하도록 돕는 '코딩 하네스'를 직접 개발했다. AI · 머신러닝 · Prospero: A new coding harness for a more civilized age
Key Point 로컬 LLM으로 자동화된 개발 작업이 가능한 실용적인 도구가 나왔으며, 기존 도구 대비 훨씬 가볍고 안정적으로 설계되어 에이전트 기반 개발 워크플로우를 본격적으로 실험할 수 있다.
핵심 요약
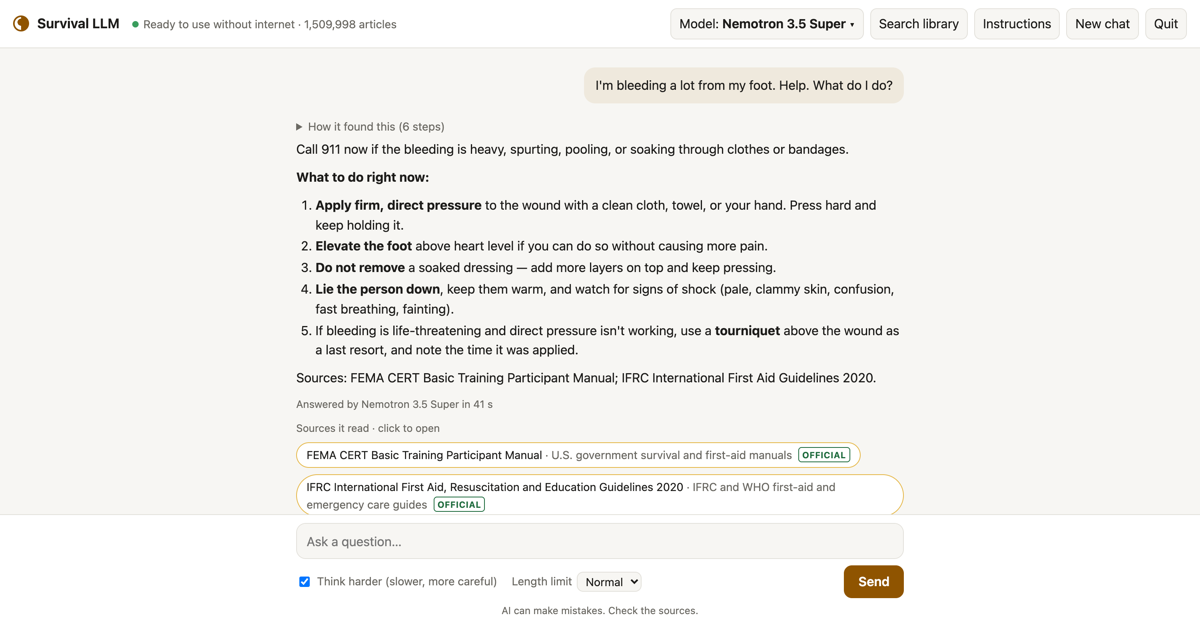
개발자가 로컬 LLM으로 프로그래밍 작업을 하도록 돕는 '코딩 하네스'를 직접 개발했다. 기존 도구들이 웹 스택 기반이라 수GB 메모리를 소비하는 문제를 해결하기 위해 C++와 Dear ImGui로 작성하여 기존 도구 대비 100배 적은 리소스를 사용한다. llama.cpp, OpenRouter, Anthropic API 등 외부 모델 제공자와 연동하며, 내장 모델 공급자는 없다. 전체 요약 13문장 읽기 → 005 09:11 ▲ 147 · 댓글 92 인터넷 없이도 작동하는 응급 AI 어시스턴트 출시 Survival LLM은 컴퓨터에 완전히 로컬로 설치되는 무료 AI 어시스턴트로, 인터넷 연결 없이 응급 상황 대응법을 제공한다. AI · 머신러닝 · Survival LLM: AI assistant and emergency library that runs on your own computer
Key Point 재난이나 정전 상황에서 인터넷 없이도 의료·생존 정보에 즉시 접근할 수 있으며, 개인 정보가 외부로 유출되지 않으므로 응급 상황 대비에 관심 있는 모든 사용자에게 실질적인 가치가 있다.
핵심 요약
Survival LLM은 컴퓨터에 완전히 로컬로 설치되는 무료 AI 어시스턴트로, 인터넷 연결 없이 응급 상황 대응법을 제공한다. 음식 안전 관리, 화상 처치, 정수 방법 등 응급 질문에 답하며 위키피디아, 의료 백과사전, FEMA·CDC 지침, 생존 매뉴얼 등 93만 개의 신뢰할 수 있는 출처에서 정보를 가져온다. 모든 답변은 출처를 명시하며 사용자가 정확한 구절을 확인할 수 있도록 하이라이트한다. 전체 요약 12문장 읽기 → 006 06:11 ▲ 187 · 댓글 204 M6 칩 탑재한 신형 14인치 맥북프로 발표 애플이 M6 칩을 탑재한 14인치 맥북프로를 발표했다. 12코어 CPU와 12코어 GPU, 듀얼 16코어 뉴럴 엔진을 갖췄다. 하드웨어 · 시스템 · New 14‑inch MacBook Pro with M6
Key Point M6 칩은 AI 연산 성능을 획기적으로 개선했으며, 24시간 배터리는 맥북 사상 최장 수명이다. 프롬프트 처리 속도 1.3배 향상과 AI 워크로드 전반의 대폭 개선으로, AI 개발자와 크리에이터들의 로컬 LLM 실행 환경이 크게 달라진다.
핵심 요약
애플이 M6 칩을 탑재한 14인치 맥북프로를 발표했다. 12코어 CPU와 12코어 GPU, 듀얼 16코어 뉴럴 엔진을 갖췄다. M5 대비 그래픽 성능 30%, AI 워크로드 성능 25% 향상됐다. M1 대비로는 그래픽 11배, AI 성능 13배 빨라졌다. 시간당 첫 토큰(time to first token) 생성 성능은 M5 대비 1.3배, M1 대비 13배 빠르며, 뉴럴 엔진은 M5보다 1.9배 빠른 이미지 생성·초해상화 처리가 가능하다. 전체 요약 12문장 읽기 → 007 03:11 새 버전 올라마 0.40.11, 음성 생성과 의사결정 AI 모델 추가 ollama run 명령어로 텍스트나 채팅 모델의 응답을 macOS에서 음성으로 변환해 재생할 수 있게 되었다. AI · 머신러닝 · ollama/ollama@v0.40.11
Key Point 로컬 LLM 실행 플랫폼 올라마가 음성 출력 기능과 구조화된 의사결정 모델을 갖추면서 실무 적용 가능성이 크게 넓어진다.
핵심 요약
ollama run 명령어로 텍스트나 채팅 모델의 응답을 macOS에서 음성으로 변환해 재생할 수 있게 되었다. OpenAI 호환 /v1/audio/speech 엔드포인트를 통해 애플리케이션이 생성되는 오디오를 스트리밍으로 받을 수 있다. d3 의사결정 모델이 추가되어 텍스트, 구조화된 상태, 이미지를 입력받아 분류·yes/no 판정·확률 기반 채점을 수행한다. 전체 요약 5문장 읽기 → 008 21:11 당일 +107 개인 서버에서 돌리는 AI 검색엔진 Vane Vane은 프라이버시를 중심으로 설계한 AI 검색엔진으로, 자신의 하드웨어에서 완전히 실행되며 인터넷 정보와 로컬 LLM(Ollama) 또는 OpenAI·Claude·Groq 같은 클라우드 제공자를 결합해 인용 출처와 함께 답변을 제공한다. 웹 · 프론트엔드 · ItzCrazyKns/Vane · TypeScript
Key Point 자신의 서버에서 검색 데이터를 완전히 제어하면서 최신 AI 모델을 활용하려는 사용자와 개발자에게 실질적인 대안이 된다.
핵심 요약
Vane은 프라이버시를 중심으로 설계한 AI 검색엔진으로, 자신의 하드웨어에서 완전히 실행되며 인터넷 정보와 로컬 LLM(Ollama) 또는 OpenAI·Claude·Groq 같은 클라우드 제공자를 결합해 인용 출처와 함께 답변을 제공한다. 스피드 모드(빠른 답변), 밸런스드 모드(일상 검색), 퀄리티 모드(깊이 있는 연구)의 세 가지 검색 모드를 지원하고, 웹·토론·학술논문 등 다양한 출처에서 검색할 수 있으며 특정 도메인으로 검색을 제한할 수도 있다. SearxNG를 통해 여러 검색 엔진에 익명으로 접근하고, 이미지·비디오 검색, PDF·텍스트·이미지 파일 업로드 후 질문, 스마트 자동완성 제안, 트렌딩 콘텐츠 브라우징, 로컬 검색 히스토리 저장 등의 기능을 제공한다. 전체 요약 7문장 읽기 → 009 15:11 새 버전 Ollama 0.40.7 출시, 모델 전환 안정성 개선 Perplexity의 27B 의사결정 모델 'pplx-decider'를 추가 지원하며, Qwen3.8-27B를 기반으로 파인튜닝됐다. AI · 머신러닝 · ollama/ollama@v0.40.7
Key Point 로컬 LLM 실행 환경에서 모델 호환성과 안정성이 크게 개선되어, 여러 모델 간 전환이나 원격 실행 시 발생하던 문제들이 해결되었다.
핵심 요약
Perplexity의 27B 의사결정 모델 'pplx-decider'를 추가 지원하며, Qwen3.8-27B를 기반으로 파인튜닝됐다. OpenAI 호환 응답 대화에서 모델 간 전환 시(생각 기능 포함/미포함) 또는 다른 제공자의 압축 항목이 포함된 히스토리에서 실패하는 문제를 해결했다. 스트리밍 응답 요청에서 클라이언트 도구 호출(예: 웹 검색 기능의 Codex)이 추론 항목 이전에 발생하여 도구 호출 이벤트가 순서 뒤바뀌거나 중복되는 문제를 수정했다. 전체 요약 8문장 읽기 → 010 21:11 ▲ 107 · 댓글 41 로컬 LLM 속도 비교 도구 Llmspeed 공개 단일 기기에서 짧은 프롬프트에 대한 로컬 LLM 실행 속도를 예측해주는 웹 도구 Llmspeed를 공개했다. AI · 머신러닝 · Show HN: Llmspeed – feel how fast a local LLM runs before you buy the hardware
Key Point 로컬 LLM 운영 비용을 고민하는 개발자들이 고가 하드웨어 구매 전에 성능을 예측할 수 있는 실용적인 도구다.
핵심 요약
단일 기기에서 짧은 프롬프트에 대한 로컬 LLM 실행 속도를 예측해주는 웹 도구 Llmspeed를 공개했다. r/LocalLLaMA, localscore.ai 등 커뮤니티 벤치마크에서 수집한 실측 데이터와 유사 환경이나 사양으로부터 도출된 추정값을 조합해 제공한다. 개발자가 실제 하드웨어를 구매하기 전에 다양한 로컬 LLM의 실행 속도를 미리 확인할 수 있다. 전체 요약 4문장 읽기 → 011 12:11 새 버전 Ollama v0.40.6 릴리스, 실행기 최적화와 GGUF 포맷 확장 Ollama v0.40.6이 릴리스되었으며, Windows 환경에서 고아 프로세스 실행기 문제를 해결했다. AI · 머신러닝 · ollama/ollama@v0.40.6
Key Point 로컬 LLM 서버인 Ollama의 안정성 개선과 양자화 포맷 확장으로 모델 호환성이 늘어나고, 클라우드 기능이 추가되어 사용자 편의성이 증가했다.
핵심 요약
Ollama v0.40.6이 릴리스되었으며, Windows 환경에서 고아 프로세스 실행기 문제를 해결했다. GGUF 포맷에 q2_0 텐서와 파일 타입을 추가하여 양자화 지원을 확장했다. Ollama의 클라우드 서비스에서 Clef를 런칭할 수 있도록 기능을 추가했다. 전체 요약 4문장 읽기 → 012 03:11 ▲ 169 · 댓글 82 Mac Studio에서 816B 모델 실행, MLX의 분산 추론 기능 공개 Apple이 MLX 최신 버전을 공개하며 Mac Studio에서 Muse Spark Open(816B 파라미터, MoE 모델)을 실행할 수 있음을 시연했다. AI · 머신러닝 · Apple ML Research: Muse Spark Open with MLX on Mac Studio
Key Point Apple silicon 기반 로컬 LLM 실행 성능이 가속도 구간에 접어들었으며, 816B 모델을 Mac Studio 클러스터에서 실행할 수 있는 기술 기반이 완성되었기 때문이다.
핵심 요약
Apple이 MLX 최신 버전을 공개하며 Mac Studio에서 Muse Spark Open(816B 파라미터, MoE 모델)을 실행할 수 있음을 시연했다. 단일 Mac Studio(M5 Ultra, 512GB 통합 메모리)에서 27B~128B 규모 모델(Qwen 3.8, Mistral Medium 3.5)은 정상 작동하며, TTFT는 M3 대비 최대 4.6배 빨라졌고 토큰 생성 속도는 1.6배 향상됐다. M5 Ultra의 GPU 신경 가속기는 행렬 곱셈 연산을 전담하여 컴퓨팅 한계 작업을 가속화하고, 통합 메모리 대역폭이 819GB/s에서 1.2TB/s로 증가해 메모리 한계 작업을 개선했다. 전체 요약 12문장 읽기 → 013 18:11 ▲ 132 · 댓글 41 80GB 모델을 32GB 램에서 실행하는 Janas, llama.cpp보다 2배 이상 빠르다 Janas-LLM은 48GB의 Qwen3-Next-80B 모델을 32GB 램의 노트북에서 실행하는 도구로, 모델 가중치를 디스크에 유지하면서 필요한 전문가(expert) 블록만 NVMe SSD에서 스트리밍한다. AI · 머신러닝 · Janas: Run LLMs larger than RAM by streaming experts from SSD
Key Point 32GB 메모리 제약에서 48GB 모델을 실행하면서 llama.cpp보다 2배 이상 빠른 속도를 달성한 새로운 방식이 기존 로컬 LLM 실행 방식의 성능 한계를 크게 개선한다.
핵심 요약
Janas-LLM은 48GB의 Qwen3-Next-80B 모델을 32GB 램의 노트북에서 실행하는 도구로, 모델 가중치를 디스크에 유지하면서 필요한 전문가(expert) 블록만 NVMe SSD에서 스트리밍한다. 같은 테스트 환경(32GB 메모리, Intel Core Ultra 9 185H, Arc 통합 GPU)에서 llama.cpp와 비교한 결과 모든 모델에서 Janas가 더 빠르며, Qwen3-Next-80B의 프롬프트 읽기 속도는 62 tok/s 대 16 tok/s, 토큰 생성은 24 tok/s 대 2.8 tok/s로 우월했다. Qwen3.5-0.8B 같은 소형 모델은 프롬프트 읽기에서 939 tok/s, 토큰 생성 130 tok/s에 도달했으며, 드래프팅 기능(다음 토큰 예측과 검증)을 활용하면 생성 속도를 최대 2배까지 높일 수 있다. 전체 요약 11문장 읽기 → 014 15:11 새 버전 Ollama v0.40.3 릴리스, 배경 업그레이드 중단으로 성능 개선 Ollama v0.40.3에서 Claude 커넥터 관련 경고 메시지를 제거했다. 오픈소스 · 도구 · ollama/ollama@v0.40.3
Key Point 백그라운드 모델 업그레이드 중단으로 고부하 상황에서 요청 처리 성능이 개선되며, 불필요한 경고 메시지 제거로 사용자 경험이 간단해진다.
핵심 요약
Ollama v0.40.3에서 Claude 커넥터 관련 경고 메시지를 제거했다. Codex 실행 시 서비스 티어 경고도 함께 없앴다. 고정확 사용(임베딩 등)에서 모든 요청에 오버헤드를 발생시키던 백그라운드 모델 업그레이드 기능을 일시 중지했다. 015 18:30 새 버전 Ollama v0.40.1 릴리스, 클라우드 API 및 버그 수정 Ollama v0.40.1이 출시되었으며 서버의 클라우드 사용량 및 잔액 API 프록시 기능이 추가되었다. AI · 머신러닝 · ollama/ollama@v0.40.1
Key Point 로컬 LLM 실행 플랫폼의 Windows 호환성 개선과 클라우드 연동 기능 확장으로, 더 많은 사용자가 안정적으로 Ollama를 사용할 수 있게 되었다.
핵심 요약
Ollama v0.40.1이 출시되었으며 서버의 클라우드 사용량 및 잔액 API 프록시 기능이 추가되었다. Windows에서 GGUF 모델 로드 시 2GiB 이상의 파일을 읽을 수 없던 버그가 수정되었다. CLI 온보딩 과정에서 불필요한 계정 단계가 제거되었다. 전체 요약 6문장 읽기 → 016 18:33 ▲ 10 · 댓글 1 쿼리마다 다른 에이전트 구조 자동 설계하는 SHIFT 발표 멀티에이전트 시스템의 역할·명령어·도구·통신 구조(harness)는 각 쿼리에 따라 달라져야 하는데, 기존에는 추론 시 여러 옵션을 실행하거나 수동으로 설계해야 했다. AI · 머신러닝 · Dynamic Harness Search: Building Multi-Agent Systems Per-Query via Prediction
Key Point 마이크로소프트·구글 같은 기업들도 멀티에이전트 워크플로우를 점점 더 활용하고 있는 가운데, 각 질문에 맞는 최적의 에이전트 구조를 비용 효율적으로 자동 설계하는 방법이 제시되었기 때문이다.
핵심 요약
멀티에이전트 시스템의 역할·명령어·도구·통신 구조(harness)는 각 쿼리에 따라 달라져야 하는데, 기존에는 추론 시 여러 옵션을 실행하거나 수동으로 설계해야 했다. SHIFT는 로컬 LLM 아키텍트가 탐색으로부터 harness 구성 정책과, 실행 결과로부터 정확도 대비 실행 비용을 예측하는 가치함수를 학습한다. 각 쿼리마다 Monte Carlo tree search가 이 예측값들을 이용해 harness를 구성하므로, 실행 과정을 탐색 루프 밖으로 옮긴다. 전체 요약 7문장 읽기 → 017 06:11 ▲ 121 · 댓글 59 macOS 사진·영상을 AI로 검색하는 로컬 앱 SCM 공개 SCM은 폴더의 모든 사진과 영상 프레임을 로컬 AI로 검색하는 macOS 앱으로, 클라우드 업로드 없이 기기에서만 처리된다. AI · 머신러닝 · Show HN: AI search for every photo and every frame of video on macOS
Key Point AI 검색이 클라우드 없이 로컬에서만 작동하므로 개인 사진·영상의 프라이버시를 완전히 보호하면서도 의미 기반·음성·텍스트 검색을 한 번에 제공하는 방식이 다르다.
핵심 요약
SCM은 폴더의 모든 사진과 영상 프레임을 로컬 AI로 검색하는 macOS 앱으로, 클라우드 업로드 없이 기기에서만 처리된다. 자연언어로 기억을 설명하면 CLIP 등 로컬 비전 모델이 검색하고, 영상은 장면 단위로 분할·임베딩되어 정확한 타임코드로 이동할 수 있다. 5가지 검색 모드를 지원한다: 의미 기반 이미지 검색(Files), 영상의 특정 장면 검색(Scenes), 이미지의 OCR 텍스트 검색(OCR), Whisper를 이용한 영상 음성 검색(Dialogue), 추출된 대사·OCR·파일명을 근거로 답변하는 로컬 LLM 챗(Ask). 전체 요약 13문장 읽기 → 018 03:11 ▲ 101 · 댓글 19 Go 바이너리 하나로 로컬 LLM 구동하는 Janus 공개 Janus는 GGUF 모델을 GPU 또는 CPU에서 실행하는 단일 Go 바이너리로, Python·Docker·Ollama 없이도 작동한다. AI · 머신러닝 · Show HN: Janus – Go binary that runs GGUF models via Vulkan on AMD/Intel/Nvidia
Key Point 로컬 LLM 추론 환경에서 복잡한 의존성 없이 한 번에 실행 가능한 도구로, Ollama나 llama.cpp 대비 간단한 설정과 Go의 빌드 편의성을 제공한다.
핵심 요약
Janus는 GGUF 모델을 GPU 또는 CPU에서 실행하는 단일 Go 바이너리로, Python·Docker·Ollama 없이도 작동한다. Vulkan을 통해 AMD·Intel·NVIDIA GPU에서 추론을 수행하거나 CPU 폴백을 지원하며, OpenAI 호환 API(/v1/chat/completions, /v1/models)를 제공한다. 재시작 없이 GGUF 모델을 바꿀 수 있고, Cursor·Cline 같은 OpenAI 클라이언트와 연동되며, GGUF 메타데이터에서 자동으로 채팅 템플릿을 감지한다. 전체 요약 9문장 읽기 → 019 00:11 ▲ 118 · 댓글 61 Tmux처럼 동작하는 OS 설계: 작업 중심 윈도 관리 저자는 Scott Jenson의 데스크톱 UX 혁신에 관한 강연에서 영감을 받아, 현재의 윈도 관리 시스템이 하드웨어 제약이 사라진 지 오래되었는데도 그대로 유지되고 있다고 지적한다. 기타 · Make Tmux the OS
Key Point 작업별 윈도 관리 개념은 20~40년 전 연구에서 나왔는데도 주요 OS에서 기본 기능으로 구현되지 않은 이유, 그리고 LLM이 이를 해결할 수 있는지를 구체적으로 탐색하는 글이다.
핵심 요약
저자는 Scott Jenson의 데스크톱 UX 혁신에 관한 강연에서 영감을 받아, 현재의 윈도 관리 시스템이 하드웨어 제약이 사라진 지 오래되었는데도 그대로 유지되고 있다고 지적한다. 현대 OS의 윈도 관리 문제는 크게 네 가지로 나뉜다: 모니터 개수와 배치의 빈번한 변화, 사람마다 다른 윈도 사용 방식, 브라우저가 실질적인 미니 OS 역할을 하는 현실, 파일시스템이 약해진 개념이 되었다는 점이다. 1986년 Rooms, 2004년 WindowScape 등 기존 연구들은 이미 작업별 윈도 그룹화의 필요성을 보였고, 최근 Windows Timeline, Windows Sets, macOS Stage Manager, KDE Activities 등이 시도했지만 기본 설정이 아니거나 수동 설정이 필요해 대중화되지 못했다. 전체 요약 9문장 읽기 → 020 21:11 당일 +105 프로덕션 RAG 시스템을 7주에 실전 구축하기 arXiv 논문을 자동으로 수집하고 분석하는 AI 연구 어시스턴트를 직접 만드는 실습 강좌다. AI · 머신러닝 · jamwithai/production-agentic-rag-course · Python
Key Point 기업 수준의 RAG 시스템 구축 방식을 처음부터 끝까지 직접 구현하며 배울 수 있으며, 에이전트 기반의 지능형 검색과 모니터링을 모두 다루기 때문이다.
핵심 요약
arXiv 논문을 자동으로 수집하고 분석하는 AI 연구 어시스턴트를 직접 만드는 실습 강좌다. Week 1-7에 걸쳐 Docker, FastAPI, PostgreSQL, OpenSearch, Airflow 등 현대적 스택으로 인프라를 구축한다. Week 2는 arXiv API와 Docling을 이용한 PDF 파싱으로 데이터 파이프라인을 자동화한다. 전체 요약 12문장 읽기 → 021 16:56 ▲ 125 · 댓글 35 Redis 만든 개발자, 로컬에서 돌리는 LLM 엔진 공개 Redis 개발자 안티레즈가 만든 DS4는 고성능 머신에서 DeepSeek V4, GLM 5.x, Qwen3.8 등 대규모 모델을 로컬에서 실행하는 C 기반 추론 엔진이다. AI · 머신러닝 · From the creator of Redis; run LLM locally with ds4
Key Point 가장 강력한 오픈 가중치 모델을 거대 클라우드 없이 자체 하드웨어에서 실행할 수 있게 되면서 AI 추론의 구조가 바뀐다.
핵심 요약
Redis 개발자 안티레즈가 만든 DS4는 고성능 머신에서 DeepSeek V4, GLM 5.x, Qwen3.8 등 대규모 모델을 로컬에서 실행하는 C 기반 추론 엔진이다. 284억 파라미터 DeepSeek V4 Flash 같은 혼합 전문가 모델을 고메모리 Mac(Metal), NVIDIA(CUDA), AMD(ROCm) 환경에서 지원한다. 핵심 기술은 라우팅 전문가만 2비트로 압축하되 중요한 공유 경로는 정밀하게 유지하는 비대칭 양자화로, 모델을 고메모리 머신에서 실행 가능하게 만든다. 전체 요약 9문장 읽기 → 022 03:11 새 버전 Ollama v0.35.1 릴리스, 웹 검색 기능 강화 Ollama v0.35.1이 출시되었습니다. AI · 머신러닝 · ollama/ollama@v0.35.1
Key Point 로컬 LLM 도구인 Ollama의 웹 검색 능력이 10배 확대되어 더 최신 정보를 기반으로 답변할 수 있게 됩니다.
핵심 요약
Ollama v0.35.1이 출시되었습니다. 한 응답당 최대 10개의 웹 검색을 수행할 수 있는 기능이 추가되었습니다. MLX와 llama.cpp 라이브러리가 최신 버전으로 업데이트되었습니다. 전체 요약 5문장 읽기 → 024 22:29 새 버전 Ollama v0.34.4 출시, 성능 개선 및 버그 수정 Structured outputs이 싱글 패스로 적용돼 사고 모델에서 더 빠르고 안정적으로 동작한다. AI · 머신러닝 · ollama/ollama@v0.34.4
Key Point 로컬 LLM 실행 환경의 가장 대중적인 도구인 Ollama의 안정성과 성능이 개선되어, 특히 Apple Silicon 사용자의 추론 속도와 안정성이 크게 향상된다.
핵심 요약
Structured outputs이 싱글 패스로 적용돼 사고 모델에서 더 빠르고 안정적으로 동작한다. 대규모 로컬 라이브러리에서 발생하던 간헐적인 '모델 미발견' 오류를 수정했다. macOS 앱이 ChatGPT나 Codex 실행 여부 확인 시 응답 없음 상태가 되는 문제를 해결했다. 전체 요약 6문장 읽기 → 025 21:11 ▲ 253 · 댓글 83 25줄의 파이썬으로 구현한 Jev Jev는 주어진 선택지에 대해 확률을 출력하는 분류 모델로, 로컬에서 실행되며 데이터를 외부로 보내지 않는다. AI · 머신러닝 · Jev in 25 Lines of Python
Key Point 로컬 LLM만으로 프롬프트 기반 분류를 확률값으로 변환하는 간단한 방법을 제시하므로, 프라이빗한 분류 작업이 필요한 개발자에게 실용적이다.
핵심 요약
Jev는 주어진 선택지에 대해 확률을 출력하는 분류 모델로, 로컬에서 실행되며 데이터를 외부로 보내지 않는다. 저자는 Qwen3-0.6B 모델을 로드하고 선택지의 로짓값을 계산한 후 소프트맥스를 적용해 확률을 도출하는 방식으로 Jev를 구현했다. 합성 데이터 생성, API 호출, 강화학습 기반 캘리브레이션 등 복잡한 방법 없이도 기본 확률 계산만으로 Jev를 구현할 수 있음을 보여준다. 026 21:10 ▲ 100 · 댓글 38 Qwen 3.8 27B 최적화 모델, 13.1GB VRAM에서 99.63% 성능 ByteShape가 Qwen 3.8 27B의 GGUF 양자화 모델 'ShapeLearn'을 공개했다. AI · 머신러닝 · Shapelearn Qwen 3.8 27B (13.1 GB VRAM)
Key Point 로컬에서 대규모 언어 모델을 최소 메모리로 효율적으로 운영하려는 개발자들에게 실질적인 선택지를 제시하는 벤치마크 기준을 제공한다.
핵심 요약
ByteShape가 Qwen 3.8 27B의 GGUF 양자화 모델 'ShapeLearn'을 공개했다. GPU-5(IQ4_XS, 3.84bpw)는 13.1GB VRAM에서 BF16 기준 99.63% 정확도를 유지하며 90.4 토큰/초의 속도를 낸다. 메모리가 제한적이면 GPU-4(IQ3_S, 11.0GB)를 추천하며, 이는 98.72% 성능을 내면서 더 빠르다. 전체 요약 5문장 읽기 → 027 21:11 ▲ 179 · 댓글 98 브라우저에서 LLM 의사결정 방식 직접 비교 OpenJev는 로컬 LLM이 선택지별 확률을 계산하는 두 가지 방식을 브라우저에서 직접 비교하는 인터랙티브 도구다. 기타 · OpenJev
Key Point 두 의사결정 방식의 성능 차이를 실측할 수 있어, LLM을 실제 애플리케이션에 활용할 때 최적의 방법을 선택하는 데 도움이 된다. ai
핵심 요약
OpenJev는 로컬 LLM이 선택지별 확률을 계산하는 두 가지 방식을 브라우저에서 직접 비교하는 인터랙티브 도구다. 한 방식은 모델의 로짓(logits)을 직접 읽어 정규화하고, 다른 방식은 모델이 확률을 JSON 텍스트로 생성하도록 요청한다. Qwen3 0.6B(639MB), MiniCPM5 2B(1.56GB), Qwen3.5 4B(3.01GB) 세 가지 크기의 모델을 선택해 실행할 수 있다. 전체 요약 5문장 읽기 → 028 03:10 당일 +205 로컬에서 구축하는 ChatGPT, AnythingLLM AnythingLLM은 로컬 중심의 올인원 AI 애플리케이션으로, 개인이 소유할 수 있는 프라이빗 ChatGPT를 구축할 수 있다. AI · 머신러닝 · Mintplex-Labs/anything-llm · JavaScript
Key Point 로컬 LLM의 활용을 원하는 개발자와 기업이 기술적 진입장벽 없이 프라이빗 AI 시스템을 구축하고 운영할 수 있게 되어, 클라우드 기반 AI 서비스의 종속성을 줄일 수 있다.
핵심 요약
AnythingLLM은 로컬 중심의 올인원 AI 애플리케이션으로, 개인이 소유할 수 있는 프라이빗 ChatGPT를 구축할 수 있다. 문서 업로드, AI 에이전트, 동적 모델 라우팅, 사용자 메모리, 스케줄된 작업 등 추가 설정 없이 기본으로 제공된다. OpenAI, Claude, Ollama, LocalAI 등 30개 이상의 로컬·클라우드 LLM 제공자와 벡터 데이터베이스를 지원한다. 전체 요약 5문장 읽기 → 029 08:12 당일 +612 Claude 기반 AI 에이전트 운영 플랫폼 Ruflo 공개 Claude Code/Codex를 위한 에이전트 메타-하니스로, 100개 이상의 전문화된 에이전트를 제공하고 다중 에이전트 스웜을 조직하며 자율 워크플로우를 조정합니다. AI · 머신러닝 · ruvnet/ruflo · TypeScript
Key Point 에이전트 기반 자동화를 원하는 개발자에게 기존의 개별 도구 학습 부담 없이 통합된 플랫폼으로 멀티 에이전트 시스템을 구축하는 새로운 방식을 제시합니다.
핵심 요약
Claude Code/Codex를 위한 에이전트 메타-하니스로, 100개 이상의 전문화된 에이전트를 제공하고 다중 에이전트 스웜을 조직하며 자율 워크플로우를 조정합니다. 메모리 기능으로 세션 간 학습을 저장하고, RAG 통합으로 지능형 검색을 지원하며, 페더레이션 커뮤니케이션으로 여러 머신의 에이전트가 안전하게 협력합니다. npx ruflo init 명령어로 초기화하면 자동으로 에이전트가 스웜을 조직하고, 성공한 패턴을 학습하고, 백그라운드에서 작업을 조정하며 사용자는 일반 코딩만 계속합니다. 전체 요약 5문장 읽기 →