쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 4일 (수)까지 3934건
17건 · "사고 과정"조건 지우기 ×
001 06:11 ▲ 263 · 댓글 140 LLM이 쓴 글, 그 어색함을 피하는 법 마틴 파울러는 LLM이 작성한 글을 읽을 때 나타나는 '어색한 느낌'을 '부자연스러운 밈(LLM-Voice)'이라고 정의한다. AI · 머신러닝 · LLM Voice
Key Point 글쓰기 능력이 AI의 손쉬운 도구화되면서, 저자와 독자 모두에게 미치는 영향을 생각해야 할 시점이다.
핵심 요약
마틴 파울러는 LLM이 작성한 글을 읽을 때 나타나는 '어색한 느낌'을 '부자연스러운 밈(LLM-Voice)'이라고 정의한다. 이러한 어색함을 감지하는 도구들이 있지만, 글을 읽으면서 이미 느껴지는 불쾌감은 도구로 판별할 수 없으며 본질을 놓친다고 본다. 저자들은 LLM으로 초안을 작성하지 말아야 하며, 인간이 편집하더라도 이 부자연스러움을 완전히 제거하기는 매우 어렵다고 강조한다. 전체 요약 8문장 읽기 → 002 21:12 당일 +109 DeepSeek 활용을 IM에 접목, 9개 채널 일괄 지원 dsh-im은 QR코드나 봇 자격증명으로 DeepSeek Harness를 飞书·微信·钉钉·企业微信·QQ·Slack·Telegram·Discord·WhatsApp 9개 메신저에 연결하는 플러그인이다. AI · 머신러닝 · xmanrui/dsh-im · JavaScript
Key Point DeepSeek 가중치가 높아지면서 대형 LLM을 9개 주요 메신저에 한 번에 연결할 수 있는 통합 솔루션이 생겨, 기업 메시징 환경에서 AI 활용 폭이 크게 넓어진다.
핵심 요약
dsh-im은 QR코드나 봇 자격증명으로 DeepSeek Harness를 飞书·微信·钉钉·企业微信·QQ·Slack·Telegram·Discord·WhatsApp 9개 메신저에 연결하는 플러그인이다. 각 채널별로 독립된 메신저 봇을 여러 개 추가할 수 있으며, 각 봇마다 연결 상태·작업 공간·모델·세션이 따로 관리된다. 飞书·微信·钉钉·企业微信·QQ·Slack·Telegram·Discord·WhatsApp는 스트리밍 또는 메시지 편집으로 사고 과정과 생성 결과를 실시간 표시하고, 음성 입출력·이미지 분석·파일 회전송을 지원한다. 전체 요약 12문장 읽기 → 003 21:11 ▲ 113 · 댓글 55 인터뷰 팁이 퍼즐 게임 풀이에도 효과, 생각을 말로 나타내기의 힘 저자는 면접에서 지원자에게 생각을 큰 소리로 말하도록 하는 관행을 유지해왔는데, 최근 2016년 퍼즐 게임 'The Witness'를 할 때 자신의 사고 과정을 음성으로 나레이션하기 시작했다. 기타 · Chain of Thought for Humans
Key Point 사고 과정을 말로 표현하는 것이 단순한 의사소통 기법이 아니라 실제 인지 성능을 향상시킨다는 기초적인 이해를 제시하며, 문제 해결 전략의 과학적 근거를 보여준다.
핵심 요약
저자는 면접에서 지원자에게 생각을 큰 소리로 말하도록 하는 관행을 유지해왔는데, 최근 2016년 퍼즐 게임 'The Witness'를 할 때 자신의 사고 과정을 음성으로 나레이션하기 시작했다. 자신의 생각 속도가 말보다 빠르고 기하학적 추론은 언어로 표현하기 어려운데도 불구하고, 이 방법이 놀랍게도 퍼즐 풀이 효율을 크게 높였다. 저자는 LLM이 이전 생각을 반복할 수 없어 토큰을 출력해야 하는 아키텍처 제약이 있지만, 인간의 경우 다른 메커니즘이 작동한다고 생각했다. 전체 요약 6문장 읽기 → 004 18:11 ▲ 15 · 댓글 2 LLM의 예측 과정을 추적하는 'Belief-Trajectory Energy' 지표 제안 대규모 언어모델(LLM)은 Transformer 레이어를 거치며 예측을 점진적으로 수정하지만, 최종 결과만 관찰하고 이 과정을 버린다는 문제에서 출발했다. AI · 머신러닝 · Belief-Trajectory Energy: Measuring the Path to a Prediction
Key Point LLM이 어떤 입력에 대해 추론할 때 내부적으로 어떻게 의견을 바꾸는지 측정할 수 있는 새로운 방법으로, 모델의 사고 과정을 '해석 가능하게' 들여다볼 수 있는 창을 제공한다.
핵심 요약
대규모 언어모델(LLM)은 Transformer 레이어를 거치며 예측을 점진적으로 수정하지만, 최종 결과만 관찰하고 이 과정을 버린다는 문제에서 출발했다. 연구진은 Belief-Trajectory Energy(BTE)라는 측정 지표를 제안했으며, 이는 입력이 모델의 각 레이어에서 유도하는 예측 수정을 특성화한다. 중간 상태들을 공유 예측 공간에 매핑하여 스칼라 또는 깊이 프로필 형태의 신념 변화를 측정한다. 전체 요약 8문장 읽기 → 005 21:11 당일 +269 클로드 AI 에이전트를 데스크톱에서 바로 쓴다 Pi Agent Desktop은 macOS와 Windows용 로컬 AI 코딩 에이전트 데스크톱 앱으로, 터미널 없이 설치해 바로 사용할 수 있다. AI · 머신러닝 · abcwyc/pi-agent-desktop · TypeScript
Key Point Claude 코딩 에이전트를 터미널 없이 데스크톱 앱으로 쓸 수 있게 되면서, 개발자의 환경 설정 진입장벽이 사라진다.
핵심 요약
Pi Agent Desktop은 macOS와 Windows용 로컬 AI 코딩 에이전트 데스크톱 앱으로, 터미널 없이 설치해 바로 사용할 수 있다. 과거 세션을 프로젝트별로 열람·재개하고, 사고 과정·도구 호출·컨텍스트 사용량·비용을 실시간으로 확인할 수 있다. 대화를 분기하거나 이전 메시지부터 새로운 세션을 시작할 수 있으며, 모델·API 키·커스텀 설정·플러그인을 관리한다. 전체 요약 13문장 읽기 → 006 18:11 ▲ 35 · 댓글 2 완전 공개 멀티모달 모델 Apertus 1.5 출시 Apertus 1.5는 완전히 공개 데이터로 학습한 멀티모달 추론 모델로, 텍스트 기반 Apertus 1.0을 확장했다. AI · 머신러닝 · Apertus 1.5: From Open Text Models to Open Multimodal Reasoners
Key Point 공개 데이터로만 학습한 완전히 오픈소스 멀티모달 모델의 등장으로, 소수 기업 종속에서 벗어날 수 있는 대안이 실제 규모에서 가능함을 보여준다.
핵심 요약
Apertus 1.5는 완전히 공개 데이터로 학습한 멀티모달 추론 모델로, 텍스트 기반 Apertus 1.0을 확장했다. 8B 모델에 4T개, 70B 모델에 2T개 토큰을 추가 학습해 이미지와 음성 이해 능력을 추가했으며, 컨텍스트 윈도우를 262,144 토큰으로 4배 확대했다. 토크나이저를 통해 멀티모달 입력을 처리하되 언어 모델 헤드는 텍스트만 출력하고 아키텍처는 유지했다. 전체 요약 9문장 읽기 → 007 12:11 ▲ 12 · 댓글 2 공간 추론 AI, 도구 없이도 학습 가능 멀티모달 대형언어모델(MLLM)의 공간 추론 능력을 높이는 기존 방식은 외부 코딩 도구를 써야 해 추론 시간이 길고 외부 의존성이 높다. AI · 머신러닝 · SpatialOPSD: Self-Distilling Spatial Intelligence from Verified Coding Agent Traces
Key Point 공간 추론 능력이 필요한 비전-언어 작업에서 외부 도구 의존을 제거하면서도 성능을 유지할 수 있다는 점이 중요하며, 자기 증류를 통한 에이전트 능력 내재화는 더 효율적인 AI 시스템 구축에 시사점을 준다.
핵심 요약
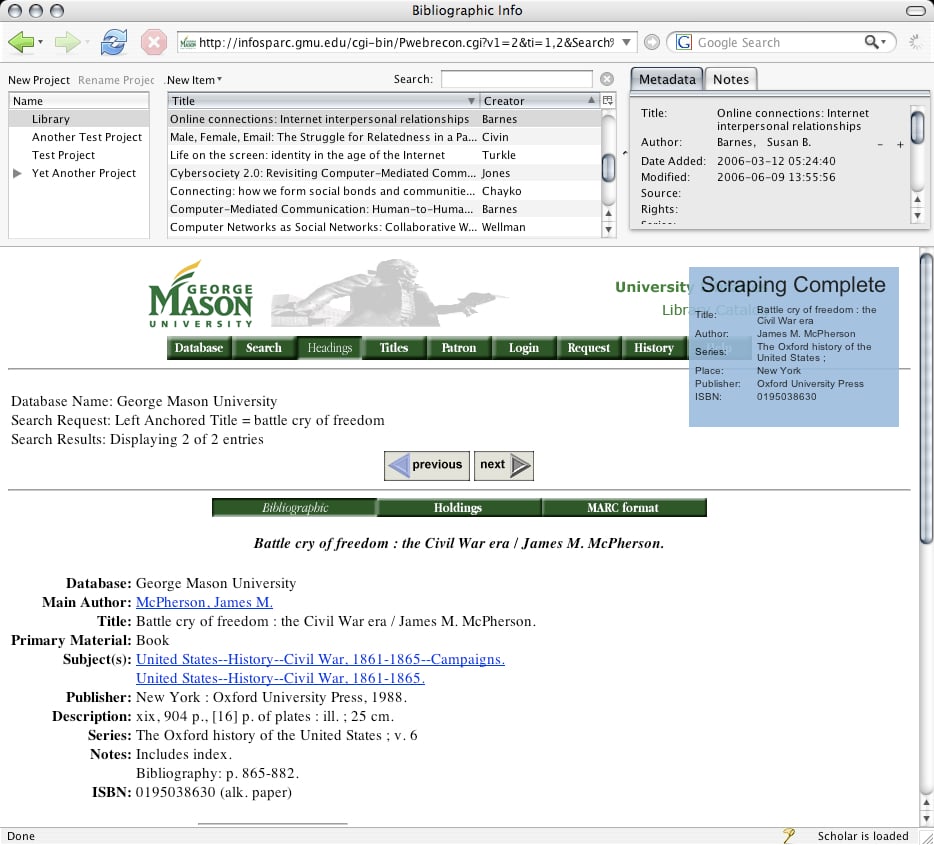
멀티모달 대형언어모델(MLLM)의 공간 추론 능력을 높이는 기존 방식은 외부 코딩 도구를 써야 해 추론 시간이 길고 외부 의존성이 높다. 연구팀은 MLLM이 도구 없이 공간 추론을 스스로 수행할 수 있는지 탐구했고, 검증된 코딩 에이전트의 실행 추적(trace)을 요약해 모델에 보여주면 내부 사고 과정이 활성화됨을 발견했다. 이를 바탕으로 SpatialOPSD라는 자기 증류(self-distillation) 프레임워크를 제안했으며, 검증된 에이전트 추적을 특권 정보로 취급해 모델에 공간 추론을 내재화한다. 전체 요약 5문장 읽기 → 008 00:11 ▲ 124 · 댓글 39 느린 설계가 만든 내구성 있는 소프트웨어, Zotero의 20년 AI 시대의 빠른 소프트웨어 개발과 달리, 연구 도구 Zotero는 2001년부터 5년간의 구상을 거쳐 2006년 10월 첫 공개되었다. 스타트업 · 비즈니스 · The Slow Formation of Durable Software
Key Point AI로 빠르게 소프트웨어를 만드는 시대에 장기간의 사려 깊은 설계가 어떻게 20년을 견딘 도구를 만들었는지 보여주는 역사적 증거를 담고 있다.
핵심 요약
AI 시대의 빠른 소프트웨어 개발과 달리, 연구 도구 Zotero는 2001년부터 5년간의 구상을 거쳐 2006년 10월 첫 공개되었다. Zotero는 지난 20년간 2000만 명 이상이 수십 개 언어로 사용하는 학술 자료 수집·정리·인용 도구로 성장했다. RRCHNM(조지 메이슨 대학교)의 역사학자 그룹이 Web Scrapbook과 Scribe라는 두 가지 시험작을 바탕으로 개념을 발전시켰다. 전체 요약 10문장 읽기 → 009 18:33 ▲ 22 · 댓글 2 오디오-비주얼 추론 벤치마크와 학습법 제시한 OmniReasoning 논문 최근 음성·시각·언어를 통합으로 이해하는 옴니모달 모델들이 발전했으나, 기존 벤치마크와 학습 방식은 각 모달리티를 독립적으로 다루며 오디오-비주얼 결합 추론 능력을 제대로 평가하지 못하는 문제를 지적했다. AI · 머신러닝 · OmniReasoning: Pushing the Limits of Audio-Visual Joint Reasoning
Key Point 오디오와 비주얼 정보를 함께 활용해야 하는 멀티모달 추론이 현실 문제 해결에 중요해지는 만큼, 이를 측정하는 기준과 학습 방식이 필요한 시점에 제시된 실질적인 해결책이다.
핵심 요약
최근 음성·시각·언어를 통합으로 이해하는 옴니모달 모델들이 발전했으나, 기존 벤치마크와 학습 방식은 각 모달리티를 독립적으로 다루며 오디오-비주얼 결합 추론 능력을 제대로 평가하지 못하는 문제를 지적했다. 이를 해결하기 위해 벤치마크, 데이터 생성 엔진, 학습 방법을 함께 제시했다. OmniReasoningBench는 오디오와 비주얼 증거가 모두 필수적인 1,150개 객관식·개방형 문제로 구성되며, 비디오 추론과 비디오 외 추론 두 가지 과제를 포함한다. 전체 요약 7문장 읽기 → 010 09:11 ▲ 147 · 댓글 103 Opus 5.5를 최대한 활용하는 프롬프팅 가이드 Opus 5.5는 이전 Opus보다 더 오래 작업하고, 진행 상황을 명확히 보고하며, 매 답변 전에 자체 사고 과정을 거친다. AI · 머신러닝 · Getting the most out of Opus 5.5 in Claude and Claude Code
Key Point Opus 5.5의 멀티스텝 능력이 크게 향상되어 프롬프팅 방식과 작업 진행 방식이 근본적으로 달라지므로, 기존 습관을 버리고 새로운 최적화 방법을 배워야 한다.
핵심 요약
Opus 5.5는 이전 Opus보다 더 오래 작업하고, 진행 상황을 명확히 보고하며, 매 답변 전에 자체 사고 과정을 거친다. 장시간 멀티스텝 작업에서는 전체 작업을 한 메시지에 제시하고 '테스트 통과' 같은 명확한 완료 기준을 지정하면 중단 없이 진행한다. 기존 프롬프트의 '신중하게 생각하세요', '단계별로 생각하세요' 같은 지시어를 제거해야 한다. Opus 5.5는 항상 스스로 사고하는 범위를 결정하므로 불필요하다. 전체 요약 16문장 읽기 → 011 03:11 ▲ 25 · 댓글 1 MLLM의 추론력으로 영상 편집을 정밀하게 제어하는 ThinkV2V 기존 영상 편집 방식은 MLLM을 의미 인코더로만 사용해 암묵적인 편집 지시를 제대로 처리하지 못했다. AI · 머신러닝 · ThinkV2V: Unleashing the Reasoning Capability of MLLMs for Instruction-Guided Video Editing
Key Point MLLM의 추론 능력을 활용해 기존에 처리하지 못하던 복잡한 영상 편집 지시를 정확히 따르는 방법을 제시하며, 더 작은 모델로 더 큰 기준선을 능가하는 결과를 보였다.
핵심 요약
기존 영상 편집 방식은 MLLM을 의미 인코더로만 사용해 암묵적인 편집 지시를 제대로 처리하지 못했다. ThinkV2V는 MLLM의 사고 과정을 명시적으로 활성화한 뒤 영상 생성을 진행하는 추론 기반 프레임워크를 제안한다. MLLM-to-DiT 아키텍처로 영상과 지시에 대한 사고를 정제된 신호로 변환해 편집을 제어한다. 전체 요약 6문장 읽기 → 012 00:11 ▲ 108 · 댓글 154 AI 수학 논문 공개, 인간의 이해를 먼저 확보하라 수학 커뮤니티는 AI랩이 독점 모델로 고급 수학 문제를 테스트하는 관행을 중단할 것을 요청했다. AI · 머신러닝 · Responsible Release of AI-Generated Mathematics
Key Point AI가 인간이 검증하지 못한 수학 증명을 공개하는 관행이 학문 규범과 평등성을 위협하므로, 수학계의 새로운 기준을 수립해야 한다는 근본적 문제를 다룬다.
핵심 요약
수학 커뮤니티는 AI랩이 독점 모델로 고급 수학 문제를 테스트하는 관행을 중단할 것을 요청했다. 수학 분야의 전통적 규범은 논문 저자가 내용을 이해하고 정확성을 검증하며 책임을 지는 것인데, AI 생성 결과는 이를 위반할 수 있다. 600개 이상의 피드백을 바탕으로 책임감 있는 AI 수학 결과 공개를 위한 권고안을 수립했다. 전체 요약 9문장 읽기 → 013 09:11 ▲ 104 · 댓글 44 메타 뮤즈, 내부에서 OpenAI 모델 사용 흔적 발견 메타의 AI 에이전트 뮤즈에서 Avocado라는 메타 내부 모델 외에 azure/muse-special이라는 라벨의 OpenAI 모델이 사용되는 것을 발견했다. AI · 머신러닝 · Meta's Muse appears to use an OpenAI model labeled muse-special
Key Point 메타 뮤즈가 공개적으로 공개하지 않은 OpenAI 모델을 백엔드에서 사용하고 있으며, 메타가 외부 모델의 암호화된 응답을 수집하는 방식이 모델 개발 전략과 사용자 데이터 취급에 대한 기술적 통찰을 제공한다.
핵심 요약
메타의 AI 에이전트 뮤즈에서 Avocado라는 메타 내부 모델 외에 azure/muse-special이라는 라벨의 OpenAI 모델이 사용되는 것을 발견했다. muse-special 세션의 서명에는 gpt_responses_v1 태그와 OpenAI가 사용하는 gAAAAA로 시작하는 암호화 페이로드가 포함되어 있으며, 도구 호출 ID가 OpenAI 형식(call_ 뒤 24자)을 따른다. 뮤즈의 에이전트 데몬에는 Claude Opus/Sonnet/Haiku, GPT-5.5/5.6 변형들, Kimi K3 등 약 15개의 Avocado 버전과 함께 다양한 모델이 탑재되어 있다. 전체 요약 8문장 읽기 → 014 22:26 ▲ 15 · 댓글 2 최신 언어 모델의 숨겨진 사고 과정 추출 및 분석 최신형 언어 모델의 성능 향상이 추론 능력 개선 때문인지 검증하려면, 폐쇄형 시스템의 CoT(Chain-of-Thought) 추적을 관찰해야 하는데 현재 접근 불가능하다. AI · 머신러닝 · Capable yet Parsimonious: Extracting and Characterizing Hidden Chain-of-Thought in Frontier Models
Key Point 폐쇄형 모델의 내부 추론 메커니즘이 어떻게 동작하는지 처음 체계적으로 들여다본 연구로, 모델의 성능 향상이 실제 추론 능력 증대인지 판단할 수 있는 근거를 제시한다.
핵심 요약
최신형 언어 모델의 성능 향상이 추론 능력 개선 때문인지 검증하려면, 폐쇄형 시스템의 CoT(Chain-of-Thought) 추적을 관찰해야 하는데 현재 접근 불가능하다. 연구팀은 표준 API의 커스텀 도구 등록 기능을 이용해 GPT-4o Astra 등 최신 모델들이 중간 추론 과정을 외부화하도록 유도했다. 추출된 추론을 오픈소스 모델의 기본 CoT와 비교해 진정한 추론인지 사후 정당화인지 검증하고, 경쟁 수학·과학·코드 생성 작업에서 평가했다. 전체 요약 7문장 읽기 → 015 03:10 ▲ 116 · 댓글 66 AI로 글을 쓰지 말고 직접 생각하라 Claude나 ChatGPT 같은 AI는 코딩·리서치에는 유용하지만 글쓰기에는 사용하지 말아야 한다. 기타 · Don't Use AI to Write
Key Point 생성형 AI에 글쓰기를 맡기는 것이 시간 절약처럼 보이지만, 실은 핵심 사고 과정을 포기하는 것이므로 이를 올바르게 활용하는 방법을 알아야 한다.
핵심 요약
Claude나 ChatGPT 같은 AI는 코딩·리서치에는 유용하지만 글쓰기에는 사용하지 말아야 한다. 글쓰기는 문제를 깊이 있게 사고하고 핵심을 명확히 하는 과정인데, AI에 맡기면 이 사고 단계를 건너뛰게 된다. AI가 생성한 문서는 겉으로는 그럴듯해 보이지만, 실제로 당신의 가장 중요한 생각을 담고 있는지 확인할 수 없다. 전체 요약 6문장 읽기 → 016 06:10 ▲ 139 · 댓글 88 AI에 글쓰기를 맡기면 안 되는 이유 글쓰기 과정 자체가 사고 과정이므로 AI가 대신 쓰게 되면 핵심적인 사고를 건너뛸 수 있다. AI · 머신러닝 · I think you should almost never use AI to write
Key Point 글을 직접 쓰는 과정이 사고를 깊어지게 하는 필수 단계라는 주장은 콘텐츠 제작자와 기업이 AI 활용을 판단할 때 영향을 미치는 근본적인 질문을 던진다.
핵심 요약
글쓰기 과정 자체가 사고 과정이므로 AI가 대신 쓰게 되면 핵심적인 사고를 건너뛸 수 있다. AI 생성 텍스트는 미묘한 모호함과 오류를 포함하기 쉬우며 이를 발견하기 어렵다. AI를 글쓰기에 사용하면서 이를 공개하지 않는 것은 독자에게 불성실하다. 전체 요약 5문장 읽기 → 017 00:10 ▲ 140 · 댓글 41 글쓰기로 배운다는 것 글쓰기 과정에서 자신의 이해도를 명확히 알게 되며, 새로운 학습이 없으면 출판할 가치가 없다고 본다. 기타 · Blog about things you don't understand yet
Key Point 기술 블로거의 사고 과정과 글쓰기 전략을 체계적으로 설명한 글로, 개발자들의 블로깅과 학습 방식에 실질적인 통찰을 제공하기 때문이다.
핵심 요약
글쓰기 과정에서 자신의 이해도를 명확히 알게 되며, 새로운 학습이 없으면 출판할 가치가 없다고 본다. 논쟁의 여지가 있는 입장을 취하고 방어할 수 있어야만 충분한 연구를 강제하고 깊이 있는 글을 쓸 수 있다. 완전히 이해하지 못한 주제라도 초보자의 관점이 전문가보다 효과적인 설명이 될 수 있으며, 투명한 자격 공개가 독자 신뢰를 지킨다.