쌓인 기록에서 찾기
무엇을 찾으세요?
날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위부터 2026년 10월 30일 (금)까지3636건
8건 · "실시간 처리"조건 지우기 ×
001▲ 19 · 댓글 2동영상 손톱 따기를 7배 빠르게, 4K에서도 실시간 처리고해상도 동영상에서 머리카락 같은 미세한 디테일과 투명도를 보존하면서 프레임 간 일관성을 유지하는 비디오 매팅(영상 배경 분리) 문제를 다룬다.AI · 머신러닝 · MatAnyone-E: Sparse Memory Propagation for Efficient High-Resolution Video Matting

Key Point4K 동영상도 실시간 처리가 가능한 수준으로 효율을 개선한 기술이며, 헤어 디테일 보존이 중요한 영상 편집·라이브 스트리밍 용도에 실용적 영향을 미친다.
핵심 요약
- 고해상도 동영상에서 머리카락 같은 미세한 디테일과 투명도를 보존하면서 프레임 간 일관성을 유지하는 비디오 매팅(영상 배경 분리) 문제를 다룬다.
- 기존 메모리 기반 방식은 이전 프레임의 정보와 현재 프레임을 매칭하지만 해상도가 높아질수록 비용이 급증한다.
- MatAnyone-E는 저해상도에서 먼저 불확실한 영역과 관련 메모리를 파악한 뒤, 해당 부분만 고해상도로 정밀 매칭하고 나머지는 저해상도 결과를 재사용한다.
전체 요약 6문장 읽기 →AI · 머신러닝 · DirCast: Live Esports Directing and Commentary with a Single Streaming Video-Language Model

Key Point실시간 영상 생성 능력을 갖춘 대규모 언어 모델이 단순 해석을 넘어 실시간 의사결정(카메라 선택)이 필요한 프로덕션 수준의 작업을 수행할 수 있다는 점을 실증한 첫 사례입니다.
핵심 요약
- e스포츠 실시간 방송은 초 단위로 어느 카메라를 송출할지 결정하고 해설하는 연출자와 해설자가 필요하며, 미래를 알 수 없는 상황에서 진행된다.
- 기존 스트리밍 비디오 언어 모델은 인간 연출자가 이미 제작한 방송을 보고 해설만 했으나, 이 논문은 모든 선수 카메라의 원본 영상을 받아 직접 연출과 해설을 동시에 수행하는 라이브 방송 제작을 다룬다.
- DirCast는 매초 모든 카메라를 저해상도로 스캔하고, 홀드-또는-스위치 연출자로 컷 여부와 위치를 결정한 뒤, 선택된 카메라를 고해상도로 읽고 해설을 생성한다.
전체 요약 7문장 읽기 →AI · 머신러닝 · FlashVSR+: Efficient Video Super-Resolution via Hybrid Attention and Reward-Yield Distribution Matching

Key Point동영상 초고화질화가 실용적인 수준의 속도와 메모리 효율로 4K 고해상도 처리가 가능해지면서, 콘텐츠 제작자와 개발자들이 일반 사양 GPU에서도 고품질 영상 생성을 구현할 수 있게 되었다.
핵심 요약
- 기존 동영상 초고화질화(VSR) 모델이 확산 증류를 통해 한 단계 생성으로 효율성을 높였으나, 고해상도 추론 비용이 크고 생성 결과가 사용자 선호와 맞추기 어려운 문제가 있었다.
- FlashVSR+는 하이브리드 어텐션 메커니즘을 도입해 사전학습된 VSR 모델의 강한 지역성(locality)을 활용하면서 장거리 일관성을 위해 희소 전역 상호작용을 유지한다.
- 이를 통해 DiT 속도를 최대 2배 높이고 피크 메모리를 45% 감소시켜, RTX 4090 24GB 단일 GPU에서 타일 분할 없이 4K 영상 초고화질화를 가능하게 했다.
전체 요약 7문장 읽기 →AI · 머신러닝 · We turned EmbeddingGemma 2 into a speech-to-text model
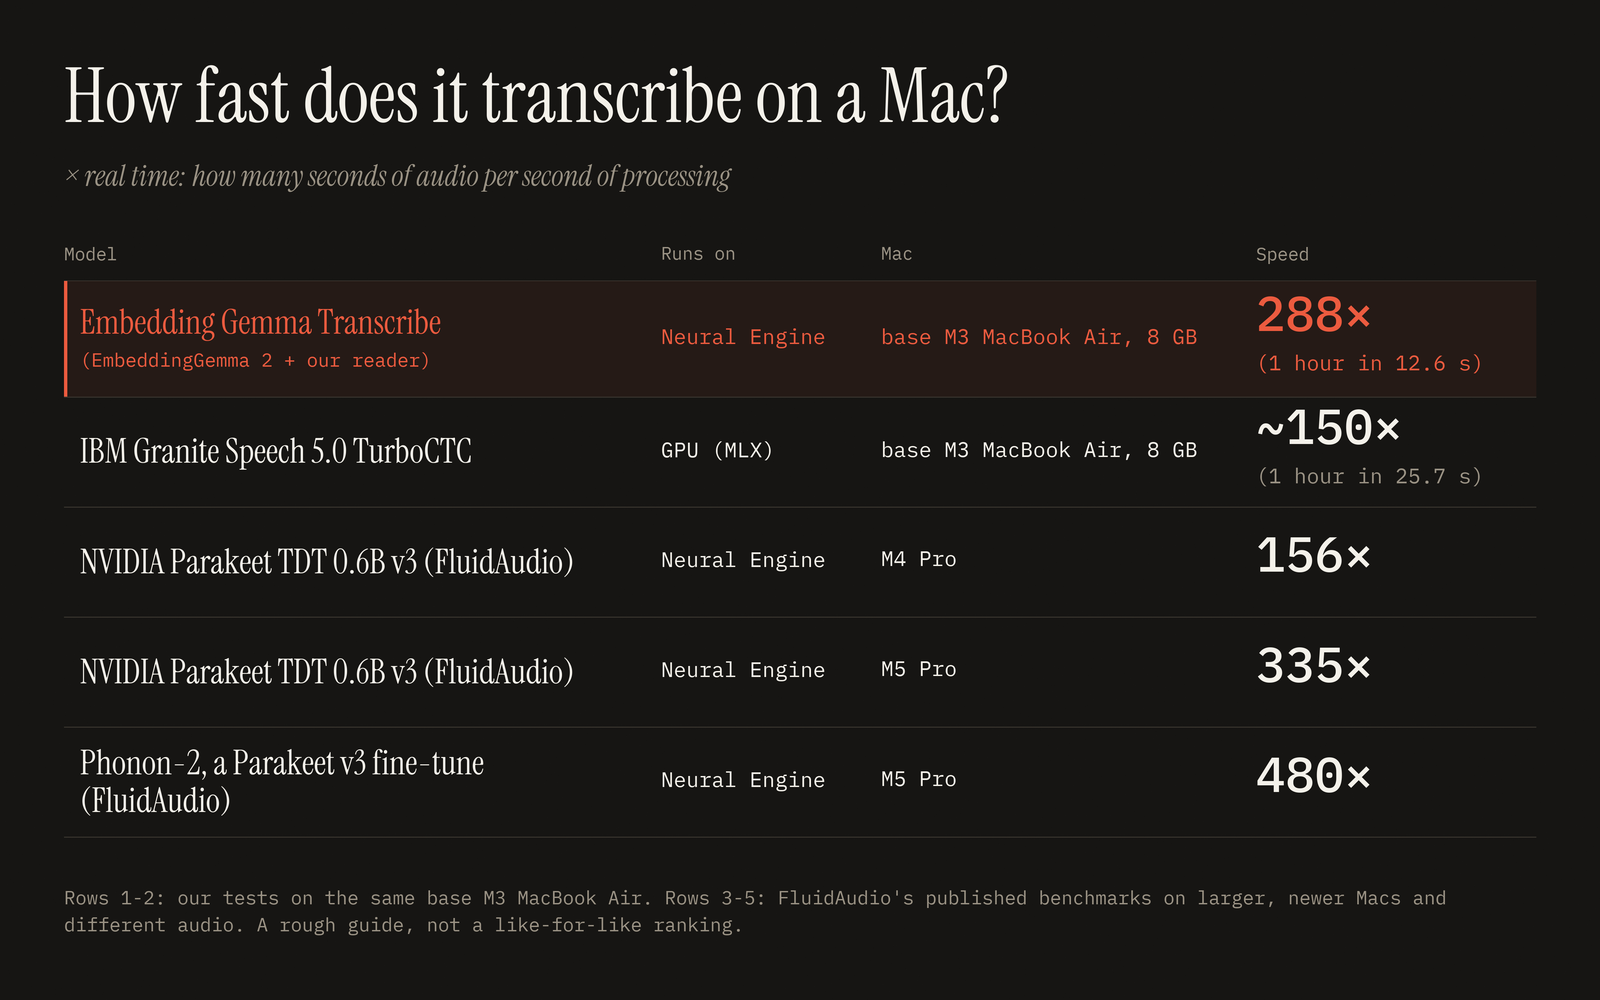
Key Point다중모달 임베딩 모델을 음성 인식으로 새롭게 활용한 창의적 접근과 Apple Silicon에서의 빠른 실시간 처리 성능이 주목할 만하다.
핵심 요약
- Google의 다중 모달 임베딩 모델 EmbeddingGemma 2를 음성-텍스트 변환 모델로 개조했다.
- 텍스트, 이미지, 오디오, 비디오를 같은 벡터 공간에 매핑하는 특성을 활용해 음성을 약 22만 9천 개 영어 단어 중 가장 가까운 단어로 매칭하는 방식으로 작동한다.
- 오디오 인코더는 원래 그대로 두고, 새로운 작은 리더 모델만 학습시켜 음성 슬라이스를 텍스트 공간으로 변환하며, 별도 모델이 구두점과 대문자를 추가한다.
전체 요약 7문장 읽기 →AI · 머신러닝 · OneStreamer: Unifying Perception, Memory, and Proactive Response in Streaming Video Interaction

Key Point스트리밍 비디오 이해 작업에서 실시간 처리와 장기 기억 사이의 균형을 새롭게 푸는 방식을 제시하며, 8개 벤치마크에서 우수한 성능을 입증한 대규모 데이터셋과 모델을 공개합니다.
핵심 요약
- 스트리밍 비디오 LLM은 미래 작업의 중요성이 결정되기 전에 증거를 기억하고, 충분한 증거가 모였을 때 응답해야 한다.
- OneStreamer는 쿼리-독립적 증거 기록과 작업 응답을 공동으로 학습하되, 공유된 능동형 생성 과정을 통해 이룬다.
- Proactive Hierarchical Caption Memory(PHCM)는 시간-정박된 세부 사항 캡션과 완료된 이벤트의 요약을 생성하며, 훈련 중 관찰된 비디오 시작 부분의 해석을 감독한다.
전체 요약 10문장 읽기 →하드웨어 · 시스템 · The top secret URSALA, RAQUEL, and FARRAH satellites (2025)
Key Point40년 이상 비밀로 유지되다 최근 공개된 미국 저궤도 전자정보 위성들의 발전사는, 전략정보 수집 체계가 어떻게 전술부대 실시간 지원 시스템으로 재설계되었는지를 보여주는 냉전 우주 감시 기술의 구체적 사례다.
핵심 요약
- 1963년부터 시작된 미국 저궤도 전자정보(ELINT) 위성 프로그램이 최근 2개월 내에 URSALA, RAQUEL, FARRAH 등 위성 이름과 함께 부분 해제됐다.
- 초기 'P-11 위성'들은 여행 가방 크기에 안테나를 달고 빠르게 회전하며 레이더와 통신 신호를 수집했으며, 1960년대에는 수개월만 궤도에 머물렀다.
- 1970년대 국방정보국(NRO)은 이 위성들을 표준화하고 육·해·공군 작전부대에 실시간 전술정보를 지원하는 방향으로 전환했다.
전체 요약 9문장 읽기 →하드웨어 · 시스템 · Guitar amp and effects pedal built on the Waveshare ESP32-S3-Touch-AMOLED-2.06

Key PointESP32 임베디드 기기에서 Neural Amp Modeler 같은 복잡한 ML 모델을 실시간 처리하고 웹에서도 재현하는 기술 구현이 핵심인데, 풀스택 오픈소스 프로젝트의 완성도와 확장 가능성을 보여주는 사례다.
핵심 요약
- Waveshare ESP32-S3-Touch-AMOLED-2.06 보드 위에 구축한 스탠드얼론 기타 앰프이자 이펙터 페달 CoyoPedal을 공개했다.
- ESP32-S3에서 Neural Amp Modeler A2 캡처를 실시간 처리하고, USB 호스트로 클래스 준수 오디오 인터페이스를 구동하며, TSX로 작성하고 C++로 컴파일한 터치스크린 UI를 갖춘다.
- 동일 펌웨어가 화면이 없는 bare ESP32-S3에서도 구동되며, BOOT 버튼이 풋스위치로 작동한다.
전체 요약 15문장 읽기 →인프라 · 데브옵스 · Writing Efficient C++ Code (2013)
Key Point메모리 캐시와 데이터 구조 선택이 성능에 미치는 영향과 구체적 최적화 방법을 배워야 하는 개발자, 특히 게임·시스템 프로그래밍을 다루는 인원에게 실제 적용 가능한 가이드를 제공한다.
핵심 요약
- C++는 고수준 기능(OOP, STL)과 저수준 제어(메모리 관리, 하드웨어 접근)를 모두 제공하는 유일한 언어로, 게임·실시간 처리처럼 성능이 중요한 분야에서 자주 선택된다.
- 많은 프로그래머가 OOP를 개념적으로만 생각하지만, 메모리 계층·캐시·포인터 앨리어싱 같은 저수준 이해 없으면 비효율적인 코드가 나온다.
- Data-Oriented Design(DOD)은 OOP와 다르지 않게, 데이터 레이아웃을 먼저 설계하고 그에 맞춘 알고리즘을 짜는 방식으로, 수많은 작은 객체의 포인터 호핑보다 배열의 순차 처리가 병렬화하기 쉽고 캐시 효율이 높다.
전체 요약 12문장 읽기 →