001 18:11 ▲ 100 · 댓글 73 webOS TV를 로컬 기반 스마트 TV로 재개발하는 프로젝트 리눅스 컴퓨터에서 Chromium을 실행하고 TV는 디스플레이로만 사용하는 방식으로 webOS TV의 기본 홈 화면, 브라우저, 음성 어시스턴트를 교체하는 프로젝트다. 하드웨어 · 시스템 · Show HN: Making a smart TV dumb and then smart
Key Point webOS TV 펌웨어 수정을 통해 로컬 제어 기반의 스마트 TV를 만드는 구체적인 기술 구조와 제약·위험 요소를 보여준다.
핵심 요약
리눅스 컴퓨터에서 Chromium을 실행하고 TV는 디스플레이로만 사용하는 방식으로 webOS TV의 기본 홈 화면, 브라우저, 음성 어시스턴트를 교체하는 프로젝트다. TV 펌웨어의 특정 빌드 버전을 대상으로 루트 권한으로 벤더 시스템 서비스를 수정하므로 보증 소실 위험이 있으며, 재부팅이나 초기화 전까지 TV를 사용할 수 없을 수 있다. 원격 컨트롤러의 음성 입력, 홈 화면 라우팅, 네이티브 음성 캡처 등이 벤더 서비스를 후킹하며, 펌웨어 SHA-256 핀과 코드 오프셋이 특정 빌드에만 유효하다. 전체 요약 12문장 읽기 → 002 21:11 ▲ 12 · 댓글 2 합창 오디오를 성부별로 자동 기록하는 AI 모델 등장 기존 합창 자동 악보 기록(AMT) 시스템은 소프라노·알토·테너·베이스(SATB) 성부를 구분하지 못하고 하나의 음표 트랙으로 병합했는데, 이는 악보 복원과 성악 교육을 어렵게 만들었다. AI · 머신러닝 · Toward Part-Aware Choral Transcription with singing voice assignment
Key Point 합창 악보를 성부별로 정확히 기록할 수 있게 되면 학생 악단 연습, 악보 출판, 원곡 복원 등이 더 효율적으로 가능해진다.
핵심 요약
기존 합창 자동 악보 기록(AMT) 시스템은 소프라노·알토·테너·베이스(SATB) 성부를 구분하지 못하고 하나의 음표 트랙으로 병합했는데, 이는 악보 복원과 성악 교육을 어렵게 만들었다. 새로운 'PawCT' 모델은 합창 오디오를 입력받아 활성화된 SATB 성부를 먼저 식별한 뒤, 각 성부를 별도의 음표 레벨 트랙으로 자동 기록한다. 성부별 음의 시작·종료·유지 시점 예측과 성부 포함 여부 추정을 함께 진행하며, SATB 음역대 사전 정보(RP)와 성부 내 선율 연속성·성부 간 음정 순서를 반영하는 확장 기법(OC)을 적용한다. 전체 요약 6문장 읽기 → 003 00:11 ▲ 31 · 댓글 1 알리바바 Qwen-Audio-3.1-ASR, 화자 식별과 음성 분석 강화 알리바바의 Qwen-Audio-3.1-ASR은 이전 버전의 음성 인식을 개선하고 화자 분리 전사, 일반 오디오 이해 기능을 추가한 오디오-언어 모델 제품군이다. AI · 머신러닝 · Qwen-Audio-3.1-ASR Technical Report
Key Point 음성 인식이 단순 전사를 넘어 화자 식별, 음악·음성 분석까지 통합하는 추세를 보여주며, 다양한 배포 환경을 지원하는 확장성이 실무 적용의 핵심이다.
핵심 요약
알리바바의 Qwen-Audio-3.1-ASR은 이전 버전의 음성 인식을 개선하고 화자 분리 전사, 일반 오디오 이해 기능을 추가한 오디오-언어 모델 제품군이다. 30개 언어와 16개 중국 방언을 지원하며, 이전 발화 맥락 반영, 계층형 핫워드 커스터마이징, 자동 전사 보정 등 명령 제어 기능을 제공한다. 화자 분리 ASR은 화자 레이블, 타임스탐프, 인식된 텍스트를 포함한 구조화된 출력을 생성하며, 턴 전체에 걸쳐 일관된 화자 레이블을 유지하고 겹치는 음성을 표현한다. 전체 요약 6문장 읽기 → 005 21:11 당일 +126 LocalAI: 고사양 GPU 없이 모든 AI 모델을 로컬에서 실행 LocalAI는 GPU 없이도 LLM, 비전, 음성, 이미지, 비디오 모델을 어떤 하드웨어에서든 실행할 수 있는 오픈소스 AI 엔진이다. AI · 머신러닝 · mudler/LocalAI · Go
Key Point 로컬 환경에서 고가의 GPU 없이도 다양한 AI 모델을 실행할 수 있는 완전한 플랫폼으로, 마이크로서비스 아키텍처, 멀티유저 지원, 분산 모드를 갖춘 프로덕션 레벨의 솔루션이 필요한 조직과 개발자들에게 실질적인 선택지를 제공한다.
핵심 요약
LocalAI는 GPU 없이도 LLM, 비전, 음성, 이미지, 비디오 모델을 어떤 하드웨어에서든 실행할 수 있는 오픈소스 AI 엔진이다. 작은 코어 구조로 설계되어, 필요한 백엔드(llama.cpp, vLLM, whisper.cpp, Stable Diffusion, MLX 등)만 개별 컨테이너로 받아 필요 없는 것은 설치하지 않는다. OpenAI, Anthropic, ElevenLabs API와 호환되며 하나의 API 뒤에서 모든 모달리티를 지원한다. 전체 요약 11문장 읽기 → 006 16:56 당일 +211 중국 초등학교 전과목 무료 학습 플랫폼 오픈소스 중국 소학 1~6학년 전과목 통합 학습 플랫폼 '聪聪学堂'을 MIT 라이선스로 오픈소스 공개했다. 오픈소스 · 도구 · wuwangzhang1216/ChinaTextbookStudyFree · Swift
Key Point 교육 자원 불균형 해소를 목표로 무료 학습 플랫폼을 완전 공개하는 사례로, 중국 교육 기술 생태와 게임화 학습 경험 설계를 한눈에 볼 수 있다.
핵심 요약
중국 소학 1~6학년 전과목 통합 학습 플랫폼 '聪聪学堂'을 MIT 라이선스로 오픈소스 공개했다. 수학(인교판), 국어(통편판), 영어(인교판 PEP), 과학(교과판) 44권 교재, 2,166개 단원, 6,545도 연습 문제를 수록했다. AI 생성 단원 소테스트, 지식 설명, 279편 원본 교과서 음성 낭독(TTS), 284편 레벨별 이야기 + 이해 문제를 제공한다. 전체 요약 10문장 읽기 → 007 18:11 ▲ 35 · 댓글 2 완전 공개 멀티모달 모델 Apertus 1.5 출시 Apertus 1.5는 완전히 공개 데이터로 학습한 멀티모달 추론 모델로, 텍스트 기반 Apertus 1.0을 확장했다. AI · 머신러닝 · Apertus 1.5: From Open Text Models to Open Multimodal Reasoners
Key Point 공개 데이터로만 학습한 완전히 오픈소스 멀티모달 모델의 등장으로, 소수 기업 종속에서 벗어날 수 있는 대안이 실제 규모에서 가능함을 보여준다.
핵심 요약
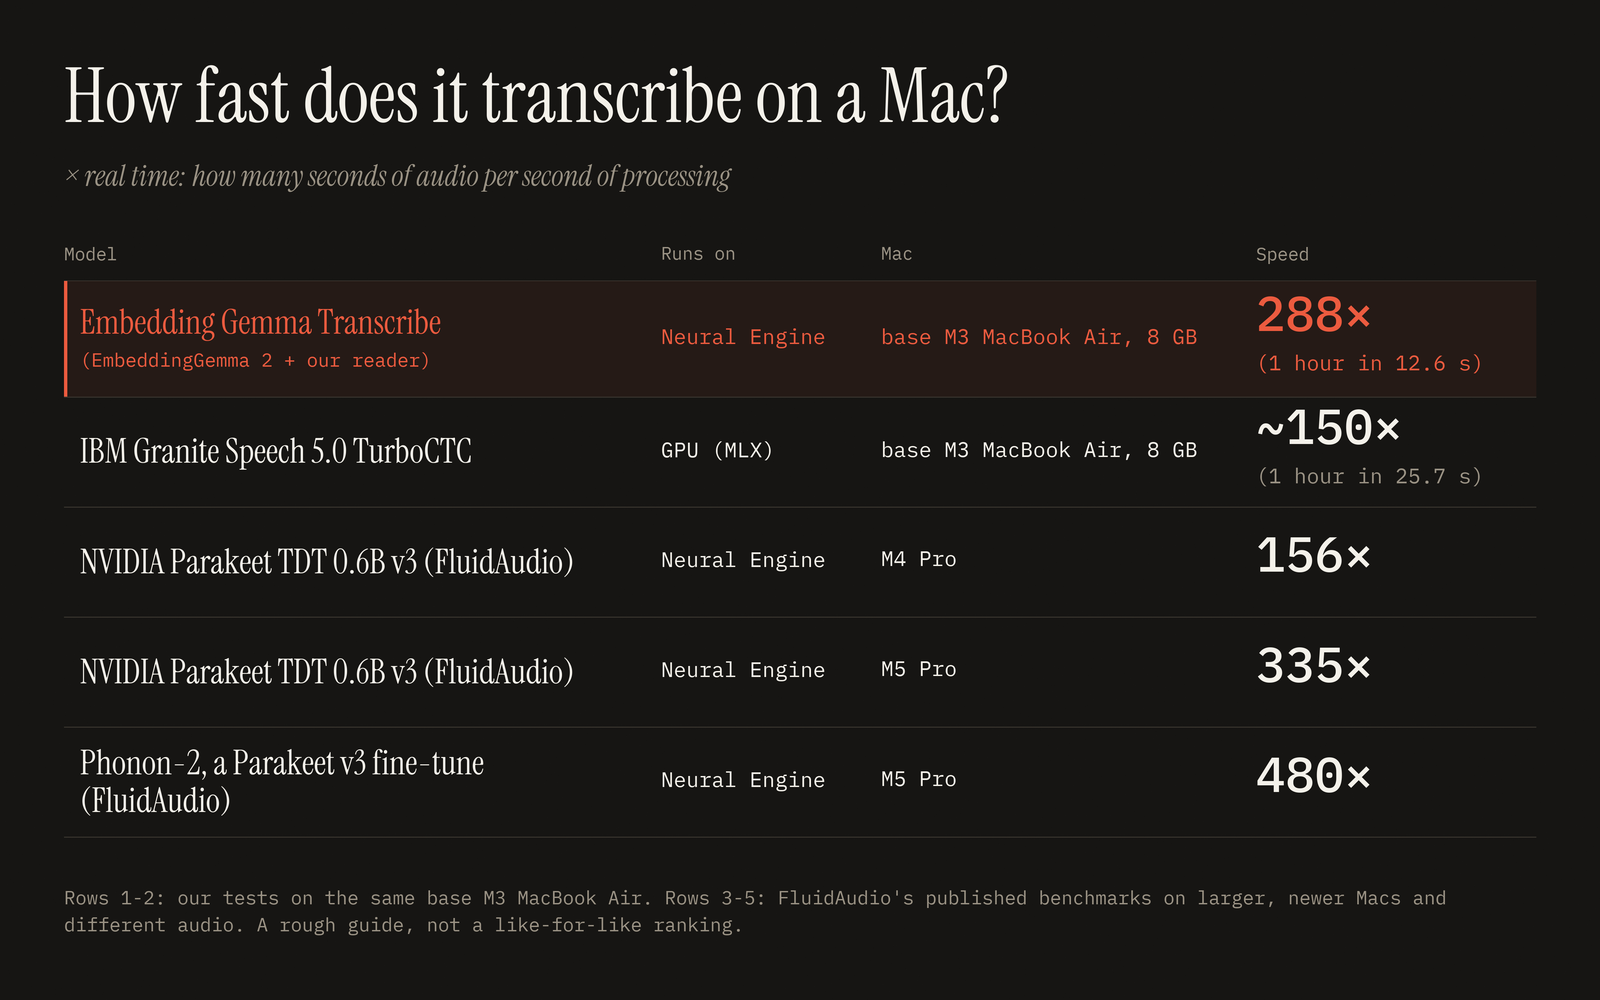
Apertus 1.5는 완전히 공개 데이터로 학습한 멀티모달 추론 모델로, 텍스트 기반 Apertus 1.0을 확장했다. 8B 모델에 4T개, 70B 모델에 2T개 토큰을 추가 학습해 이미지와 음성 이해 능력을 추가했으며, 컨텍스트 윈도우를 262,144 토큰으로 4배 확대했다. 토크나이저를 통해 멀티모달 입력을 처리하되 언어 모델 헤드는 텍스트만 출력하고 아키텍처는 유지했다. 전체 요약 9문장 읽기 → 008 00:11 ▲ 238 · 댓글 57 EmbeddingGemma 2를 음성 인식 모델로 개조한 실험 Google의 다중 모달 임베딩 모델 EmbeddingGemma 2를 음성-텍스트 변환 모델로 개조했다. AI · 머신러닝 · We turned EmbeddingGemma 2 into a speech-to-text model
Key Point 다중모달 임베딩 모델을 음성 인식으로 새롭게 활용한 창의적 접근과 Apple Silicon에서의 빠른 실시간 처리 성능이 주목할 만하다.
핵심 요약
Google의 다중 모달 임베딩 모델 EmbeddingGemma 2를 음성-텍스트 변환 모델로 개조했다. 텍스트, 이미지, 오디오, 비디오를 같은 벡터 공간에 매핑하는 특성을 활용해 음성을 약 22만 9천 개 영어 단어 중 가장 가까운 단어로 매칭하는 방식으로 작동한다. 오디오 인코더는 원래 그대로 두고, 새로운 작은 리더 모델만 학습시켜 음성 슬라이스를 텍스트 공간으로 변환하며, 별도 모델이 구두점과 대문자를 추가한다. 전체 요약 7문장 읽기 → 009 18:11 ▲ 103 · 댓글 19 macOS 음성 어시스턴트 Atticus, Claude 연동으로 무료 공개 Control+Option+Space를 누르고 말하면 윈도우 정렬, 파일 검색, 화면 읽기 등을 수행하는 macOS용 음성 어시스턴트 Atticus를 오픈소스로 공개했다. AI · 머신러닝 · Show HN: Atticus – Hold-to-talk voice assistant for macOS that runs on Claude -p
Key Point 기존 음성 어시스턴트는 API 키 등록과 지속적 비용이 필요하지만, Atticus는 이미 보유한 Claude 플랜으로 무료로 사용 가능하며 온디바이스 처리로 프라이버시를 보장한다.
핵심 요약
Control+Option+Space를 누르고 말하면 윈도우 정렬, 파일 검색, 화면 읽기 등을 수행하는 macOS용 음성 어시스턴트 Atticus를 오픈소스로 공개했다. API 키가 필요 없으며 이미 보유 중인 Claude Pro/Max 플랜과 Claude Code를 통해 실행되므로 별도 가입이나 추가 비용이 없다. 자주 사용하는 명령은 학습되어 다음부터는 AI를 거치지 않고 실행되며, '기억해줘'라고 말하면 사용자 정보를 저장해 이후 요청에 반영된다. 전체 요약 13문장 읽기 → 010 06:11 ▲ 121 · 댓글 59 macOS 사진·영상을 AI로 검색하는 로컬 앱 SCM 공개 SCM은 폴더의 모든 사진과 영상 프레임을 로컬 AI로 검색하는 macOS 앱으로, 클라우드 업로드 없이 기기에서만 처리된다. AI · 머신러닝 · Show HN: AI search for every photo and every frame of video on macOS
Key Point AI 검색이 클라우드 없이 로컬에서만 작동하므로 개인 사진·영상의 프라이버시를 완전히 보호하면서도 의미 기반·음성·텍스트 검색을 한 번에 제공하는 방식이 다르다.
핵심 요약
SCM은 폴더의 모든 사진과 영상 프레임을 로컬 AI로 검색하는 macOS 앱으로, 클라우드 업로드 없이 기기에서만 처리된다. 자연언어로 기억을 설명하면 CLIP 등 로컬 비전 모델이 검색하고, 영상은 장면 단위로 분할·임베딩되어 정확한 타임코드로 이동할 수 있다. 5가지 검색 모드를 지원한다: 의미 기반 이미지 검색(Files), 영상의 특정 장면 검색(Scenes), 이미지의 OCR 텍스트 검색(OCR), Whisper를 이용한 영상 음성 검색(Dialogue), 추출된 대사·OCR·파일명을 근거로 답변하는 로컬 LLM 챗(Ask). 전체 요약 13문장 읽기 → 011 00:11 ▲ 17 · 댓글 2 입모양으로 더빙 품질 검증...음성 없이 영상만으로 판단 더빙 품질 관리를 위해 음성 없이 무음 영상과 텍스트만으로 화자의 입술 움직임과 후보 텍스트가 내용·타이밍 모두 일치하는지 판단하는 참조 모델 없는 검증기가 필요하다. AI · 머신러닝 · Align Then Reason: A Multimodal Lip-Sync Judge for Dubbing
Key Point 더빙 품질을 자동으로 검증하는 기술이 높은 정확도로 개발되면 다국어 콘텐츠 제작의 품질 관리 비용과 시간을 크게 줄일 수 있기 때문이다.
핵심 요약
더빙 품질 관리를 위해 음성 없이 무음 영상과 텍스트만으로 화자의 입술 움직임과 후보 텍스트가 내용·타이밍 모두 일치하는지 판단하는 참조 모델 없는 검증기가 필요하다. 기존 시각적 음성 인식기와 영상-언어 모델은 입술 움직임에서 음성 내용은 복구하지만 시간 오차에는 민감하지 않아 이 작업에 부적합하다. 연구팀이 'Align Then Reason(ATR)'이라는 다국어 입모양 동기화 검증기를 개발했으며, 프레임 수준 입술 표현과 후보 텍스트의 음소 단위 사이에 단조 정렬을 먼저 확립한다. 전체 요약 7문장 읽기 → 012 21:11 당일 +140 완전 오프라인 음성 인식, 오픈소스 Handy 공개 OpenAI의 Whisper 모델을 기반으로 완전 로컬에서 동작하는 크로스플랫폼 음성-텍스트 변환 애플리케이션 Handy를 오픈소스로 공개했다. 오픈소스 · 도구 · cjpais/Handy · Rust
Key Point 클라우드 전송 없이 완전히 로컬에서 동작하는 오픈소스 음성 인식 도구로, 개인정보 보호를 중시하거나 오프라인 환경에서 음성 입력이 필요한 개발자와 사용자에게 실질적인 선택지가 된다.
핵심 요약
OpenAI의 Whisper 모델을 기반으로 완전 로컬에서 동작하는 크로스플랫폼 음성-텍스트 변환 애플리케이션 Handy를 오픈소스로 공개했다. 단축키를 누르고 말하면 음성이 텍스트로 변환되어 현재 활성 창의 텍스트 필드에 자동으로 입력되며, 음성 데이터가 외부로 전송되지 않는다. Whisper(Small/Medium/Turbo/Large) 또는 CPU 최적화된 Parakeet V3 모델 중 선택 가능하며, GPU 가속을 지원한다. 전체 요약 12문장 읽기 → 013 03:11 ▲ 198 · 댓글 91 홈어시스턴트, '클라우드' 서비스 이름을 '링크'로 변경 Nabu Casa가 Home Assistant Cloud를 Home Assistant Link로 개명하며, 빅테크가 훼손한 클라우드 이미지에서 벗어나고자 함을 밝혔다. 오픈소스 · 도구 · Big Tech ruined the cloud, so we're renaming ours
Key Point 홈어시스턴트의 구독 서비스 재정의를 통해, 데이터 프라이버시와 선택권을 우선하는 오픈소스 생태계의 대안이 어떻게 구체화되는지 보여준다.
핵심 요약
Nabu Casa가 Home Assistant Cloud를 Home Assistant Link로 개명하며, 빅테크가 훼손한 클라우드 이미지에서 벗어나고자 함을 밝혔다. 2018년 설립된 Nabu Casa는 오픈소스 프로젝트의 지속성 확보와 개발자 소진 방지를 위해 클라우드 서비스를 만들었으며, 구독료의 대부분을 오픈홈 재단에 기부하고 있다. Link는 선택적이므로 없어도 스마트홈이 작동하고, 잠금 현상이 없으며, 사용자 데이터는 암호화되어 기업이 접근하거나 광고·AI 학습에 쓸 수 없다. 전체 요약 6문장 읽기 → 014 21:11 ▲ 65 · 댓글 1 LLM이 진정한 비동기 에이전트로 거듭난다 현재 LLM 기반 에이전트는 순차적 상호작용만 지원한다: 읽기 → 생각 → 응답 또는 도구 호출 → 반복. AI · 머신러닝 · LLMs are General Asynchronous Agents
Key Point LLM을 단순 음성 인식기나 로봇 제어기로만 쓰던 시대에서 벗어나, 진정으로 동시다중 작업을 처리하는 에이전트로 만드는 기술이 등장했다는 뜻이다. 이는 실시간 응답과 백그라운드 작업을 함께 해야 하는 음성 어시스턴트, 자율 로봇, 모니터링 시스템 등의 실용성을 크게 높일 수 있다.
핵심 요약
현재 LLM 기반 에이전트는 순차적 상호작용만 지원한다: 읽기 → 생각 → 응답 또는 도구 호출 → 반복. 실제 응용(음성 어시스턴트, 로봇 제어, 모니터링)은 비순차적이다. 에이전트가 생각하거나 작업을 수행하는 도중 새로운 입력이 들어온다. 현재는 음성·영상 처리, 로봇 제어(VLA), 비동기 도구 호출 등 용도별로 서로 다른 아키텍처를 구축해야 한다. 전체 요약 5문장 읽기 → 015 21:11 당일 +124 Neuro-sama 같은 AI 캐릭터를 직접 만드는 오픈소스 프로젝트 AIRI Neuro-sama 같은 자체호스팅 가능한 AI 동반자를 만드는 오픈소스 프로젝트로, TypeScript 기반 웹 기술과 네이티브 기술을 함께 사용한다. AI · 머신러닝 · moeru-ai/airi · TypeScript
Key Point Neuro-sama 같은 AI 가상 캐릭터를 누구나 직접 구축할 수 있는 완전한 오픈소스 플랫폼이 나왔고, 게임 플레이부터 음성 채팅까지 놀라운 수준의 기능을 갖추고 있다.
핵심 요약
Neuro-sama 같은 자체호스팅 가능한 AI 동반자를 만드는 오픈소스 프로젝트로, TypeScript 기반 웹 기술과 네이티브 기술을 함께 사용한다. 브라우저, macOS, Windows 데스크톱, 모바일 PWA 등 다양한 플랫폼에서 실시간 음성 채팅이 가능하며, Minecraft, Factorio, Kerbal Space Program 등 여러 게임을 플레이할 수 있다. WebGPU, WebAssembly, Web Workers 등 웹 기술로 그래픽과 레이아웃을 처리하면서도, NVIDIA CUDA와 Apple Metal을 통한 네이티브 추론으로 성능을 확보하는 하이브리드 아키텍처를 채택했다. 전체 요약 12문장 읽기 → 016 21:11 당일 +120 Claude로 영상 편집, 코딩 에이전트 video-use 공개 Claude Code를 활용해 폴더의 영상을 자동 편집하고 최종본을 받는 완전 오픈소스 도구를 공개했다. AI · 머신러닝 · browser-use/video-use · Python
Key Point LLM의 토큰 효율성을 극적으로 높인 영상 처리 방식과, 프레임 단위 분석 대신 구조화된 텍스트 읽기로 영상 자동화의 스케일을 바꿀 수 있는 설계 원칙이 주목된다.
핵심 요약
Claude Code를 활용해 폴더의 영상을 자동 편집하고 최종본을 받는 완전 오픈소스 도구를 공개했다. 음성 인식으로 필러 단어(umm, uh)와 긴 묵음을 제거하고, 자동 색보정과 30ms 오디오 페이드를 적용하며, 자막은 스타일을 커스텀할 수 있다. HyperFrames, Remotion, Manim, PIL을 통해 애니메이션 오버레이를 병렬로 생성할 수 있다. 전체 요약 6문장 읽기 → 017 16:18 ▲ 47 · 댓글 4 AI 음성·영상 대화 학습 데이터 자동 생성 기술 오디오와 영상을 직접 입력받아 텍스트로 답하는 '오므니비챗' 태스크를 정의하고, 별도 음성 인식이나 캡션 없이 사용자의 질문을 이해한다. AI · 머신러닝 · OmniVChat: Synthesizing, Benchmarking, and Training for Native Audio-Visual Dialogue
Key Point 음성-영상 기반 AI 모델의 학습 데이터가 부족한 가운데, 합성 데이터로 모델을 학습하고 평가하는 새로운 방식이 실제 성능 개선으로 검증되었기 때문입니다.
핵심 요약
오디오와 영상을 직접 입력받아 텍스트로 답하는 '오므니비챗' 태스크를 정의하고, 별도 음성 인식이나 캡션 없이 사용자의 질문을 이해한다. 에이전트와 비디오 생성 기술을 활용해 합성된 대화 데이터를 만드는 '오므니비챗-스튜디오' 엔진을 개발했다. 합성 데이터로 오므니비챗 모델의 기본 대화 능력을 5개 카테고리로 평가하는 벤치마크를 구축했다. 전체 요약 5문장 읽기 → 018 09:10 당일 +130 생성형 AI용 문서 처리 플랫폼 Docling, 비디오·이메일 지원 Docling은 PDF, DOCX, PPTX, XLSX, HTML, EPUB, 이미지, 오디오, 비디오 등 40여 가지 문서 형식을 파싱하고 생성형 AI와 연계하는 오픈소스 도구다. AI · 머신러닝 · docling-project/docling · Python
Key Point 생성형 AI 개발에 필수적인 문서 전처리 도구로, 최근 비디오·이메일·XBRL 등 엔터프라이즈 형식 지원을 확대했으므로 데이터 파이프라인 구축에 직접 활용할 수 있다.
핵심 요약
Docling은 PDF, DOCX, PPTX, XLSX, HTML, EPUB, 이미지, 오디오, 비디오 등 40여 가지 문서 형식을 파싱하고 생성형 AI와 연계하는 오픈소스 도구다. 페이지 레이아웃, 표 구조, 수식, 이미지 분류 등 고급 PDF 이해 기능을 제공하며, 마크다운·HTML·JSON 등 여러 형식으로 내보낼 수 있다. LangChain, LlamaIndex, Crew AI 등 주요 AI 프레임워크와 통합되며, MCP 서버와 API 서버로 구동할 수 있고 로컬 실행으로 민감한 데이터 보호를 지원한다. 전체 요약 6문장 읽기 → 019 21:10 당일 +869 1800개 사이트 지원하는 올인원 다운로더 OmniGet Udemy, Hotmart 강좌부터 YouTube, Instagram, X, TikTok 등 1,800개 이상의 사이트에서 영상과 음악, 전자책을 다운로드하는 무료 데스크톱 앱이다. 오픈소스 · 도구 · tonhowtf/omniget · Rust
Key Point yt-dlp를 여러 사이트별로 계속 찾아다니거나 강좌 플랫폼 폐지 전 자료를 백업해야 하는 사용자들이 하나의 앱으로 통일할 수 있고, 터미널과 설정 없이 즉시 사용할 수 있다는 점이 기존 방식과의 가장 큰 차이다.
핵심 요약
Udemy, Hotmart 강좌부터 YouTube, Instagram, X, TikTok 등 1,800개 이상의 사이트에서 영상과 음악, 전자책을 다운로드하는 무료 데스크톱 앱이다. 터미널 없이 GUI에서 링크를 붙여 미리보기를 본 후 화질을 선택해 다운로드할 수 있으며, yt-dlp와 FFmpeg가 자동으로 설치되고 업데이트된다. 브라우저 확장 프로그램으로 쿠키를 가져와 로그인이 필요한 콘텐츠도 받을 수 있고, 다운로드 대기열 관리와 재시도 기능을 지원한다. 전체 요약 6문장 읽기 → 020 21:11 당일 +400 무료로 Claude Code와 다양한 AI 코딩 에이전트 사용하기 50개 이상 프로바이더에서 월 13억 개 이상의 무료 토큰으로 Claude Code, Codex, Pi, OpenCode 등 10개 코딩 에이전트를 단일 UI에서 통합 관리할 수 있다. AI · 머신러닝 · Alishahryar1/free-claude-code · Python
Key Point 무료 토큰 한도와 프로바이더 제약 속에서 여러 AI 코딩 에이전트를 프로덕션 수준으로 사용할 수 있는 구체적인 방법을 제시한다.
핵심 요약
50개 이상 프로바이더에서 월 13억 개 이상의 무료 토큰으로 Claude Code, Codex, Pi, OpenCode 등 10개 코딩 에이전트를 단일 UI에서 통합 관리할 수 있다. 터미널, VS Code, JetBrains IDE, Discord, Telegram 등 다양한 클라이언트에서 접근 가능하며, 로컬 Whisper나 NVIDIA NIM 음성 인식을 활용한 음성 입력도 지원한다. 프로바이더 장애 발생 시 자동으로 다음 모델로 전환되고, RTK 필터와 5가지 최적화로 터미널 출력 토큰을 최대 90% 감소시킨다. 전체 요약 5문장 읽기 → 021 11:10 당일 +117 프라이버시 우선 음성 받아쓰기 앱 OpenWhispr 공개 WisprFlow와 Granola의 오픈소스 대안으로, 핫키 입력 후 음성을 텍스트로 변환해 커서 위치에 자동 붙여넣기한다. 오픈소스 · 도구 · OpenWhispr/openwhispr · JavaScript
Key Point 로컬 처리로 프라이버시를 보장하면서 클라우드 속도도 선택 가능한 음성 받아쓰기 도구로, 업무 자동화와 회의 기록이 필요한 개발자와 사용자들에게 실질적인 대안이 될 수 있다.
핵심 요약
WisprFlow와 Granola의 오픈소스 대안으로, 핫키 입력 후 음성을 텍스트로 변환해 커서 위치에 자동 붙여넣기한다. 로컬 모델(Whisper, NVIDIA Parakeet)과 클라우드 모델을 선택 가능하며, 로컬 모드에서는 음성이 기기를 떠나지 않는다. Zoom·Teams·FaceTime 통화 자동 감지, 화자 구분 및 음성 지문인식, 의미 검색이 가능한 노트 기능을 제공한다. 전체 요약 6문장 읽기 →