쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 22일 (일)까지 5067건
16건 · "이미지 모델"조건 지우기 ×
001 15:11 ▲ 22 · 댓글 3 손 움직임으로 비디오 세상을 조종하는 AI 모델 텍스트나 카메라로만 조종하던 기존 비디오 월드 모델을 넘어, 손 움직임을 직접 입력받아 현실감 있게 반응하는 LynnReal-Hand를 개발했다. AI · 머신러닝 · LynnReal-Hand: Unlocking World Interaction with Hand Control
Key Point 손 제어라는 더 직관적인 인터페이스로 비디오 월드 모델을 확장한 기술로, 실시간 성능까지 달성해 향후 가상환경 상호작용의 새로운 표준이 될 수 있다.
핵심 요약
텍스트나 카메라로만 조종하던 기존 비디오 월드 모델을 넘어, 손 움직임을 직접 입력받아 현실감 있게 반응하는 LynnReal-Hand를 개발했다. 다양한 실제 환경과 가상 환경을 담은 100K개의 손-물체 상호작용 클립을 수집하고, 손 인식 감시 기법으로 미세한 손 동작과 물체 상호작용을 개선했다. 인과 흐름 맵을 학습해 소수 단계만에 생성하고, 비디오와 이미지 모델을 조합한 영역별 스코어 증류로 상호작용 역학과 시각 품질을 정제했다. 전체 요약 7문장 읽기 → 002 21:11 ▲ 36 · 댓글 3 생성형 이미지 모델을 비전 AI로 변신시킨 오픈 레시피 기존 Vision Banana 방식을 재현한 Open Vision Banana(OVB)는 사전학습된 이미지 생성 모델을 다중 작업 인식 시스템으로 변환하는 완전 공개 방식을 제안했다. AI · 머신러닝 · Open Vision Banana: A Fully Open Recipe for Generative Visual Perception
Key Point 생성형 AI를 기반으로 한 멀티태스크 비전 시스템의 설계 원리가 완전히 공개되어 연구 재현과 응용이 가능해진 점, 그리고 레전드 앙상블로 추가 학습 없이 성능을 크게 개선하는 방법론이 소개된 점이 중요하다.
핵심 요약
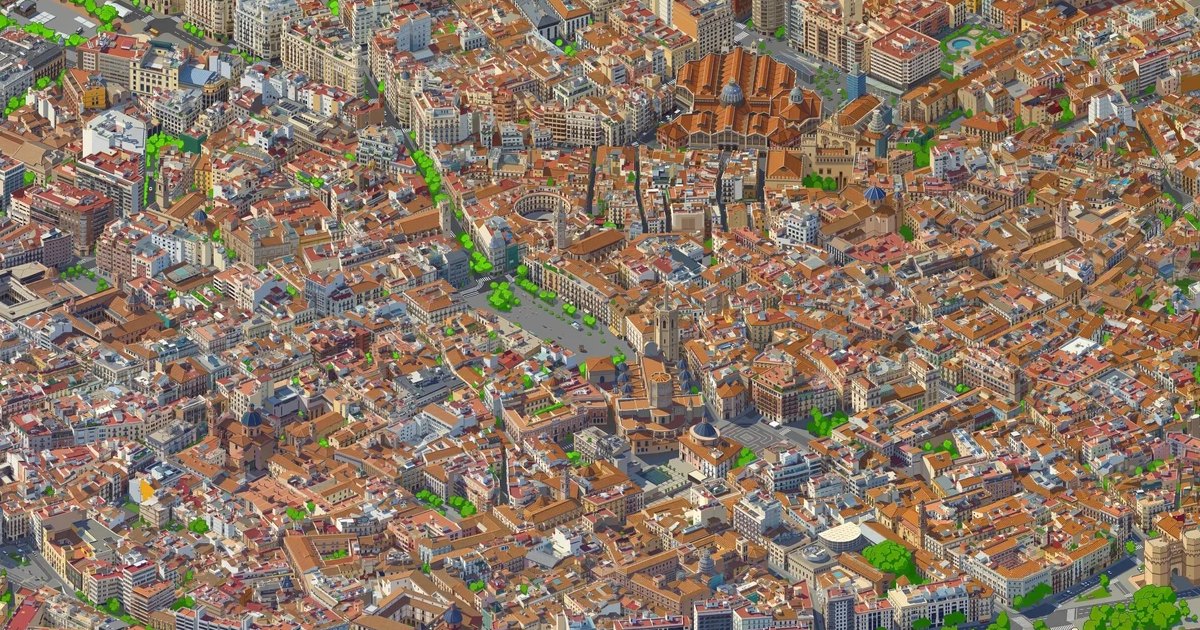
기존 Vision Banana 방식을 재현한 Open Vision Banana(OVB)는 사전학습된 이미지 생성 모델을 다중 작업 인식 시스템으로 변환하는 완전 공개 방식을 제안했다. OVB는 비전 작업을 조건부 이미지 편집으로 프레임화하며, 색상 인코딩·프롬프트 설계·파라미터 적응·작업 균형 같은 핵심 설계 선택지를 분석했다. 4B~9B 파라미터 오픈 가중치 모델과 공개 데이터셋 2.1M~3.8M 학습 쌍을 사용한 OVB는 Cityscapes 제로샷에서 73.9 mIoU로 Vision Banana(69.9)를 앞질렀다. 전체 요약 7문장 읽기 → 003 06:11 ▲ 138 · 댓글 35 스페인 발렌시아를 심시티 스타일로 재현한 등각 픽셀맵 발렌시아 전체 지자체를 심시티와 같은 등각 뷰의 픽셀아트 지도로 표현했으며, 모든 건물은 실제 건물을 위에서 같은 각도로 그린 것이다. 웹 · 프론트엔드 · Show HN: Valencia, Spain in Sim City/Isometric View
Key Point 실제 도시 데이터를 AI 이미지 모델로 처리해 레트로 게임 스타일의 맵으로 변환하는 기술이 웹에서 실제로 어떻게 구현되는지 보여주는 창의적인 사례다.
핵심 요약
발렌시아 전체 지자체를 심시티와 같은 등각 뷰의 픽셀아트 지도로 표현했으며, 모든 건물은 실제 건물을 위에서 같은 각도로 그린 것이다. 우에르타 농경지부터 알부페라 호수까지 거의 전역을 커버했으며, 3D 이미지 데이터가 없는 소규모 우에르타 지역만 제외했다. 3D 도시 데이터를 고정된 등각 카메라로 렌더링한 후, 훈련된 이미지 모델이 픽셀아트 스타일로 타일 단위로 재칠하는 방식이다. 전체 요약 5문장 읽기 → 004 18:11 ▲ 100 · 댓글 45 팬그램, AI 이미지·영상 탐지 모델 1.0 공개 팬그램이 AI 이미지 탐지 모델 1.0과 경량 모델 Flash 1.0을 공개했다. AI · 머신러닝 · Pangram Image 1.0
Key Point AI가 만든 가짜 이미지·영상을 구분하는 것이 점점 어려워지는 상황에서, 학계와 업계 기준 모두에서 최고 성능을 달성한 탐지 도구가 공개되었다.
핵심 요약
팬그램이 AI 이미지 탐지 모델 1.0과 경량 모델 Flash 1.0을 공개했다. 이미지 모델은 12개 최신 AI 이미지 생성기로 만든 1,200개 합성 이미지에서 99.96% 정확도를 달성했다. 압축·노이즈·블러 등의 편집에도 견디도록 학습했으며, 최소 해상도를 512x512에서 256x256으로 낮춰 저해상도 탐지 능력을 개선했다. 전체 요약 9문장 읽기 → 005 12:54 ▲ 173 · 댓글 16 텍스트-이미지 AI 모델, $21K로 학습 후 공개 2인 연구팀 Linum이 약 2만 1천 달러의 학습 비용으로 훈련한 Pyramid-JiT(P-JiT) 이미지 생성 모델을 Apache 2.0 라이선스로 공개했다. AI · 머신러닝 · Show HN: A decent text-to-image model trained for ~$20K (Apache 2.0 Weights)
Key Point 작은 팀이 주요 클라우드 AI 회사와 비교할 수 없는 수준의 비용으로 실용적인 이미지 생성 모델을 만들고 공개했으며, 이는 확산 모델의 효율성 개선 방향을 보여준다.
핵심 요약
2인 연구팀 Linum이 약 2만 1천 달러의 학습 비용으로 훈련한 Pyramid-JiT(P-JiT) 이미지 생성 모델을 Apache 2.0 라이선스로 공개했다. 모델은 2.42억 개의 파라미터(학습 시 포함)를 가진 확산 모델이며, 512²에서 1024² 해상도로 단계적으로 학습했고, Qwen 3.5-4B 텍스트 인코더를 사용한다. 기존 VAE 기반 압축 대신 픽셀 공간에서 직접 작업하고 32×32 토큰 압축으로 어텐션 컨텍스트 윈도우를 4배 축소했으며, 이전 모델보다 11배 적은 샘플로 수렴한다. 전체 요약 8문장 읽기 → 006 21:11 당일 +108 로컬 AI 스튜디오, 설치 없이 Windows·Linux·macOS에서 실행 Portable AI Studio는 인터넷 연결 없이 로컬에서 온전히 작동하는 데스크톱 AI 스튜디오로, Windows·Linux·macOS를 지원한다. AI · 머신러닝 · techjarves/Portable-Local-Studio · JavaScript
Key Point 로컬 AI의 네 가지 핵심 기능(이미지·채팅·음성 인식·음성 합성)을 한 애플리케이션에서 설치 과정 없이 바로 사용할 수 있게 하는 새로운 접근이며, 하드웨어별 자동 가속 감지로 개발자의 수동 설정 부담을 크게 줄인다.
핵심 요약
Portable AI Studio는 인터넷 연결 없이 로컬에서 온전히 작동하는 데스크톱 AI 스튜디오로, Windows·Linux·macOS를 지원한다. 이미지 생성(Stable Diffusion), LLM 채팅(llama.cpp), 음성 인식(Whisper), 음성 합성(Kokoro TTS) 네 가지 기능을 통합한다. Node.js 런타임과 GPU 백엔드가 자체 포함돼 있어 설치나 시스템 환경 설정이 불필요하며, 사용자는 배치 파일이나 쉘 스크립트를 실행하기만 하면 된다. 전체 요약 12문장 읽기 → 007 09:11 새 버전 openai-python 3.41.0 릴리스, Realtime API 개선 OpenAI Python SDK 3.41.0이 10월 28일 공개되었습니다. AI · 머신러닝 · openai/openai-python@v3.41.0
Key Point Realtime API의 타입 안정성 강화와 WebSocket 안정성 개선으로 실시간 애플리케이션의 신뢰성이 높아지며, 메타데이터 필터링 추가로 에이전트 세션 관리가 더 유연해집니다.
핵심 요약
OpenAI Python SDK 3.41.0이 10월 28일 공개되었습니다. Realtime API 응답 입력에 타입이 지정된 참조를 허용하고, 응답 도구 사용 모델을 추가했습니다. 에이전트 세션을 메타데이터로 필터링할 수 있는 기능이 추가되었습니다. 전체 요약 7문장 읽기 → 008 09:11 ▲ 206 · 댓글 248 AI 모델들, 인간 본성에 같은 결론에 도달하다 12개 AI 모델(GPT-6.1 Sol, Gemini 4 Argon, DeepSeek V4 Pro, Claude Opus 5.5 등)에게 인간에 대한 가장 논쟁적인 의견을 3번씩 물었다. AI · 머신러닝 · Every AI model has the same "controversial" take on humans
Key Point 같은 AI 모델들이 인간 본성에 대해 거의 동일한 비판적 결론에 도달한 현상은, 학습 데이터의 편향이나 AI 안내 방식이 모델들의 판단을 수렴시키는 메커니즘을 보여준다.
핵심 요약
12개 AI 모델(GPT-6.1 Sol, Gemini 4 Argon, DeepSeek V4 Pro, Claude Opus 5.5 등)에게 인간에 대한 가장 논쟁적인 의견을 3번씩 물었다. 7개 모델은 매번 같은 답을 했고, 12개 모델 모두 최소 1번은 동일한 주장을 제시했다: '인간은 진실보다 집단 소속을 우선한다'는 내용이다. 모델들의 구체적 표현은 다양했지만 핵심은 같다. '인간은 충성심을 원칙으로 위장한다'(GPT-6 Astra), '신념이 아니라 멤버십을 갖는다'(Kimi K3), '이성화 동물이다'(DeepSeek V4 Pro)는 식의 주장이 반복됐다. 전체 요약 12문장 읽기 → 009 06:11 ▲ 365 · 댓글 119 신경망은 이미 깨끗하다 신경망이 임의로 얽혀 있다고 여겨졌던 것은 다중의미성(polysemanticity)과 중첩(superposition) 때문이라는 기존 해석이 오류였으며, 실제로는 '재귀적 일반화'라는 훨씬 덜 우려스러운 현상이었다고 주장한다. AI · 머신러닝 · Neural networks are clean
Key Point 신경망의 내부 구조가 우리가 생각하는 것보다 훨씬 깨끗하고 이해 가능하다는 주장이 기존의 '해석 불가능한 검은 상자' 관념을 근본적으로 뒤집으며, 기계 학습의 해석가능성 연구에 새로운 방향을 제시한다.
핵심 요약
신경망이 임의로 얽혀 있다고 여겨졌던 것은 다중의미성(polysemanticity)과 중첩(superposition) 때문이라는 기존 해석이 오류였으며, 실제로는 '재귀적 일반화'라는 훨씬 덜 우려스러운 현상이었다고 주장한다. InceptionV1 같은 초기 이미지 모델에서 고양이 얼굴과 자동차 앞면 모두에 반응하던 신경원은 임의의 조합이 아니라 V자 모양이라는 공통 특징을 감지하고 있었다. 아키텍처 개선으로 InceptionV1의 마지막 레이어에서 해석 불가능한 신경원이 거의 없던 것이 99-100% 해석 가능하게 바뀌었으며, 모델 크기와 학습 데이터는 변하지 않았다. 전체 요약 12문장 읽기 → 010 21:11 당일 +238 필터 없는 AI 이미지·영상 생성 스튜디오 오픈소스화 Midjourney·Runway 같은 상용 AI 영상 플랫폼의 대안으로, 600개 이상 모델을 지원하는 오픈소스 생성형 AI 스튜디오를 공개했다. AI · 머신러닝 · Anil-matcha/Open-Generative-AI · JavaScript
Key Point 기존 상용 AI 영상 플랫폼의 높은 구독료와 필터 제한에서 벗어나, 600개 모델로 무제한 창작이 가능한 자체 호스팅 솔루션이 등장했다는 점이 중요합니다.
핵심 요약
Midjourney·Runway 같은 상용 AI 영상 플랫폼의 대안으로, 600개 이상 모델을 지원하는 오픈소스 생성형 AI 스튜디오를 공개했다. Flux·Kling·Sora·Veo 등 주요 이미지/영상 생성 모델 200여 개를 통합하고 콘텐츠 필터나 제한 없이 사용할 수 있다. 이미지·영상·음성·입술싱크·시네마·워크플로우 등 14개 스튜디오를 포함하며, 자체 호스팅 가능하고 MIT 라이선스로 완전 무료이다. 전체 요약 10문장 읽기 → 011 21:11 당일 +331 로컬 실행되는 AI 이미지·영상 생성 워크플로우 빌더 공개 HeliosGen은 무료 오픈소스 데스크톱 앱으로, 노드 기반의 시각적 인터페이스로 AI 이미지 및 영상 생성 워크플로우를 구축할 수 있다. AI · 머신러닝 · SegFault42/HeliosGen · TypeScript
Key Point 생성형 AI 도구를 클라우드 의존 없이 로컬에서 완전히 제어할 수 있는 대안이 필요한 개발자와 크리에이터에게 유용하며, 오픈소스이므로 커스터마이징과 자체 호스팅이 가능하다.
핵심 요약
HeliosGen은 무료 오픈소스 데스크톱 앱으로, 노드 기반의 시각적 인터페이스로 AI 이미지 및 영상 생성 워크플로우를 구축할 수 있다. 모든 데이터와 생성 결과가 로컬 머신에서만 실행되며, 클라우드 계정이나 구독 없이 kie.ai API 키만으로 동작한다. GPT Image 2, Google Nano Banana, Seedream, Z-Image, Grok Imagine 등의 이미지 모델과 Veo 3.1, Gemini Omni Video, Kling 3.0, Seedance 2.0 등의 영상 모델을 지원한다. 전체 요약 12문장 읽기 → 012 12:11 ▲ 36 · 댓글 1 이미지 콘텐츠 자동 제거 모델 LensErase 공개 Hugging Face는 다양한 객체와 텍스트, 워터마크 제거를 지원하는 범용 이미지 편집 모델 LensErase를 공개했다. AI · 머신러닝 · LensErase: A Foundation Model for Erase Anything
Key Point 이미지에서 특정 객체를 정확하게 제거하는 작업은 콘텐츠 제작, 사진 편집, 광고 등에서 널리 필요한데, 단일 모델로 이를 통합적으로 처리하는 기초 모델이 등장했다는 점이 의미있다.
핵심 요약
Hugging Face는 다양한 객체와 텍스트, 워터마크 제거를 지원하는 범용 이미지 편집 모델 LensErase를 공개했다. 1억 100만 개의 소스-마스크-타겟 쌍으로 구성된 LensErase-100M 데이터셋을 구축해 학습의 광범위한 커버리지를 확보했다. 텍스트-투-이미지 모델 Lens를 기반으로 마스크 기반 제거 작업으로 적응시킨 후, Mask-Aware RoPE라는 3D 회전형 위치 인코딩으로 마스크 정보를 효율적으로 통합했다. 전체 요약 6문장 읽기 → 013 18:12 ▲ 24 · 댓글 5 생성형 이미지 모델 성능 끌어올리는 표현 학습법 픽셀 디퓨전 트랜스포머 연구를 통해 좋은 표현 품질이 생성 능력으로 직결되지 않음을 발견했다. AI · 머신러닝 · Learning Representations to Guide Pixel Diffusion Transformers
Key Point 이미지 생성 모델의 표현 학습 방식을 근본적으로 재정의하고, 매개변수를 줄이면서도 현저히 나은 생성 품질을 달성하는 방법론이 제시되었다.
핵심 요약
픽셀 디퓨전 트랜스포머 연구를 통해 좋은 표현 품질이 생성 능력으로 직결되지 않음을 발견했다. 생성 과정에서 외부 시맨틱 정보가 점진적으로 손실되며, 특화 디코더 구조도 표현 개선으로 이어지지 않는다. 효과적인 생성형 표현은 올바르게 형성되고 능동적으로 활용되어야 한다는 인사이트를 도출했다. 전체 요약 8문장 읽기 → 014 15:13 ▲ 29 · 댓글 2 텍스트-이미지 모델의 보상 조합 방식으로 생성 품질 향상 기존 텍스트-이미지 생성 모델은 시각 품질이 뛰어나지만, 단일 보상 신호로는 인간의 선호도 전체를 포착할 수 없어 학습 후 개선이 어렵다. AI · 머신러닝 · Post-Training Frontier Text-to-Image Models by Composing Preference and Rubric Rewards
Key Point 선호도와 규칙 기반 보상을 조합하는 방식으로 최신 텍스트-이미지 생성 모델의 사후 학습 효율을 크게 개선하는 실질적 방법론을 제시한다.
핵심 요약
기존 텍스트-이미지 생성 모델은 시각 품질이 뛰어나지만, 단일 보상 신호로는 인간의 선호도 전체를 포착할 수 없어 학습 후 개선이 어렵다. 이 연구는 상호 보완적인 두 가지 보상 신호를 조합하는 사후 학습 방식을 제안했다: Bradley-Terry 목적함수로 인간의 미적·지각적 선호를 학습한 선호도 보상과, 프롬프트 충실도와 다른 바람직한 속성을 명시적으로 평가하는 규칙 기반 보상이다. 단순 가중 평균은 최적 아래의 학습 거동을 초래하므로, 선호도 최적화와 규칙 만족을 더 효과적으로 균형 잡는 새로운 보상 조합 전략을 제시했다. 전체 요약 5문장 읽기 → 015 12:11 ▲ 54 · 댓글 2 이미지 생성 AI로 GUI 상호작용 데이터 합성 GUI 에이전트 학습에는 소프트웨어 환경과의 상호작용 궤적이 필요하지만, 실제 앱을 설치·운영하면서 수집하는 방식은 비용이 많이 든다. AI · 머신러닝 · AutoGUIWorld: Image Generators as Visual World Models for GUI Agent
Key Point GUI 에이전트 학습 비용을 획기적으로 줄일 수 있는 데이터 합성 방법이 실제 환경에서 성능 향상을 입증했기 때문이다.
핵심 요약
GUI 에이전트 학습에는 소프트웨어 환경과의 상호작용 궤적이 필요하지만, 실제 앱을 설치·운영하면서 수집하는 방식은 비용이 많이 든다. AutoGUIWorld는 이미지 생성 모델과 작업 계획기를 결합해 실제 환경을 배포하지 않고도 GUI 상호작용 데이터를 자동으로 생성하는 프레임워크다. 초기 GUI 화면을 운영체제 컨텍스트·시각적 모양·인터페이스 상태로 정의한 후, 조건부 작업을 생성한다. 전체 요약 7문장 읽기 → 016 22:29 당일 +681 ComfyUI, 노드 기반 멀티모달 AI 생성 엔진으로 거듭나다 ComfyUI는 그래프/노드 인터페이스 기반의 강력한 AI 생성 엔진으로, 이미지·비디오·3D·오디오·텍스트 생성을 한 플랫폼에서 지원한다. AI · 머신러닝 · Comfy-Org/ComfyUI · Python
Key Point 노드 기반 워크플로우로 최신 오픈소스 생성 모델들을 자유롭게 조합하되, 로컬 실행·API 통합·클라우드 지원을 한 도구에서 선택할 수 있어 전문가부터 초심자까지 콘텐츠 제작 자동화의 진입장벽을 낮춘다.
핵심 요약
ComfyUI는 그래프/노드 인터페이스 기반의 강력한 AI 생성 엔진으로, 이미지·비디오·3D·오디오·텍스트 생성을 한 플랫폼에서 지원한다. Stable Diffusion, SDXL, Flux.1/2, Qwen Image, Hunyuan Image, Ideogram 등 주요 이미지 모델과 LTX-Video, HunyuanVideo 같은 영상 생성, ACE-Step, Stable Audio 등 오디오 생성 모델을 기본 지원한다. Partner nodes를 통해 폐쇄형 모델(Nano Banana, Seedance, Hunyuan3D 등)에도 접근할 수 있으며, API 엔드포인트로 프로덕션 파이프라인에 통합 가능하다. 전체 요약 9문장 읽기 →