쌓인 기록에서 찾기
무엇을 찾으세요?
날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위부터 2026년 11월 16일 (월)까지4683건
6건 · "제곱근"조건 지우기 ×
001▲ 133 · 댓글 324개의 2로 모든 정수를 만드는 수학 트릭4개의 2와 수학 연산만으로 임의의 자연수를 만드는 고전 수학 퍼즐이 있다.기타 · Making any integer with four 2s (2025)
Key PointDirac이 발견한 일반 해법으로 인해 수십 년간 수학자들을 사로잡았던 이 퍼즐이 어떻게 완전히 '깨졌는지' 보여주는 흥미로운 이야기다.
핵심 요약
- 4개의 2와 수학 연산만으로 임의의 자연수를 만드는 고전 수학 퍼즐이 있다.
- 초등학교 수준에서는 사칙연산으로 1부터 6까지 만들 수 있고, 중학교에서 배우는 지수·팩토리얼로 범위가 크게 넓어진다.
- 22처럼 2를 나열하는 방식, 복소수, 적분 등 고급 수학 도구를 더하면 더 많은 수를 만들 수 있다.
전체 요약 8문장 읽기 →AI · 머신러닝 · Lexical Reference Frames: Interpreting LM Residual Streams in Native Semantics

Key Point기존 해석 기법과 달리 모델이 실제로 상태를 처리하는 방식을 따라 언어모델의 중간 계산을 읽을 수 있게 되어, 투명성·효율성·제어성이 모두 향상된다.
핵심 요약
- 언어모델의 어휘는 임베딩과 언임베딩에서 고정되지만, 중간의 잔여스트림 상태는 기존 방법으로는 모델의 처리 방식을 제대로 반영하지 못한다고 지적한다.
- 연구팀은 각 은닉 상태가 다음 층들의 읽기 방식과 맥락에 맞춰진 '네이티브 참조틀'을 가진다고 주장한다.
- 렉시컬 참조틀은 모델의 남은 층들을 통해 상태를 읽되, 정해진 횟수의 위치 간 어텐션과 나머지는 전형적인 어텐션 출력으로 근사한다.
전체 요약 7문장 읽기 →AI · 머신러닝 · A Visual Intro to Complex Numbers
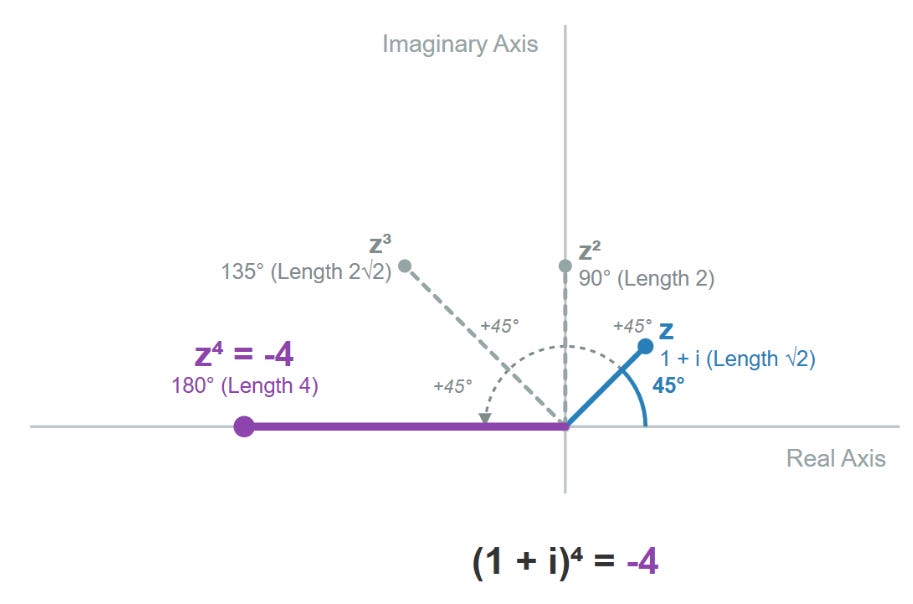
Key Point음수의 제곱근이라는 불가능한 계산에서 출발해 현대 통신, 제어, 물리학을 움직이는 핵심 도구가 된 복소수의 진화 과정과 실제 응용을 한눈에 이해할 수 있다.
핵심 요약
- 실수만으로는 풀 수 없는 연립방정식을 시도하며 음수의 제곱근이라는 불가능한 문제에 직면하게 된다.
- 16세기 이탈리아 수학자 카르다노는 음수의 제곱근을 계산 과정에서 다루면 불가능한 항들이 소거되어 실제 답에 도달할 수 있음을 발견했지만, 이를 의미 없는 '편의적 속임수'로 간주했다.
- 데카르트는 이런 수들을 '허수'라고 부르며 조롱했으나, 18세기 오일러는 음수의 제곱근을 i로 표기하며 체계적인 기초를 마련했다.
전체 요약 15문장 읽기 →AI · 머신러닝 · Make Sparse Rewards Count: Density-Aware Reward Aggregation for Multi-Reward RL

Key Point다중 보상 학습에서 일부 목표만 우선 학습되는 문제를 밀도 기반의 수학적 분석으로 해결하고, 훈련 효율을 크게 개선한 방법론이다.
핵심 요약
- 다중 보상 강화학습은 LLM이 여러 행동 목표를 동시에 만족하도록 훈련하는데, GDPO의 보상별 정규화 방식도 목표마다 학습 진도가 불균형하다는 문제가 있다.
- 연구팀은 '장점 에너지(advantage energy)'—배치 내 보상의 제곱된 장점의 합—를 분석하여, 이 에너지가 '활동 밀도'(보상이 0이 아닌 상대적 장점을 제공하는 롤아웃 그룹의 비율)에 비례함을 증명했다.
- 이는 배치 단위의 신호 불균형을 드러내고, 보상 기여도 보정의 근거를 제공한다.
전체 요약 7문장 읽기 →AI · 머신러닝 · Scaling Properties of Same-Family On-Policy Distillation

Key Point작은 모델의 강화학습 능력이 훨씬 큰 모델로 효과적으로 전이될 수 있음을 보여주므로, 효율적인 LLM 훈련 방식을 모색하는 개발자와 연구자들에게 실질적인 지침을 제공한다.
핵심 요약
- 강화학습이 대규모언어모델에 추론 능력을 부여할 수 있지만, 모델 크기가 다를 때 이 능력이 얼마나 전이되는지는 미명확했다.
- 연구팀은 정책 증류(on-policy distillation, OPD)의 스케일링 특성을 약한 선생-강한 학생, 같은 기반-다른 크기, 강한 선생-약한 학생 구조에서 분석했다.
- 초기 OPD 훈련 과정에서 일관되게 '유용한 전이(useful-transfer)' 단계가 나타나며, 이 구간에서 성능(gold score)은 학생의 KL 발산의 제곱근에 거의 선형으로 증가한다.
전체 요약 7문장 읽기 →기타 · The Test

Key Point부자 리더들의 황당한 발언 앞에서 침묵하거나 동조하는 것이 집단 복종의 신호가 되고, 이를 거부하고 명확히 지적하는 것만이 그들의 이상한 가치관이 사회를 지배하는 것을 막을 수 있다는 중요한 주장이다.
핵심 요약
- Jensen Huang (NVIDIA CEO)는 Ezra Klein 팟캐스트에서 아이들이 장제법·구구단·제곱근을 배울 필요가 없다며 '그것이 중요한가?'라고 반문했다.
- Huang은 자신이 주소와 전화번호를 모른다고 자랑스럽게 말했는데, 이는 '자신이 인간이 아니라 돈으로 모든 것을 대리인에게 맡기는 존재'임을 드러낸다.
- Marc Andreessen, Sam Altman, Satya Nadella 등 다른 테크 거물들도 유사한 황당한 발언을 공개적으로 내놓고 있다.
전체 요약 8문장 읽기 →