쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
19건 · "라이딩"조건 지우기 ×
001 09:11 ▲ 110 · 댓글 40 리퀴드 AI, 멀티모달 소형 모델 LFM3 공개 리퀴드 AI가 2B 파라미터 규모의 멀티모달 파운데이션 모델 LFM3를 출시했다. 텍스트, 비전, 오디오, 옴니(멀티모달), 의사결정 모델을 하나의 백본에서 제공한다. AI · 머신러닝 · Introducing LFM3: Every Modality for Specialized Intelligence
Key Point 클라우드 없이 로컬 기기에서 텍스트·비전·오디오를 모두 처리할 수 있는 2B급 모델이 나왔으며, 에이전트 작업에서 훨씬 큰 모델들과 경쟁한다는 점이 온디바이스 AI 실용화의 진전을 의미한다.
핵심 요약
리퀴드 AI가 2B 파라미터 규모의 멀티모달 파운데이션 모델 LFM3를 출시했다. 텍스트, 비전, 오디오, 옴니(멀티모달), 의사결정 모델을 하나의 백본에서 제공한다. LFM3는 새로운 하이브리드 아키텍처와 22T 토큰 사전학습으로 LFM2보다 표현력이 뛰어나면서도 효율성을 유지한다. 로컬 파인튜닝, 모든 기기에서 실행, 전문 작업 최적화가 가능하다. 아키텍처는 13개 계층의 게이트 단락 컨볼루션, 5개 계층의 슬라이딩-윈도우 어텐션(256 토큰 윈도우), 6개 계층의 글로벌 어텐션을 조합한다. 커널 크기를 3에서 7로 확대했다. 전체 요약 10문장 읽기 → 002 06:11 새 버전 Hugging Face Transformers v5.21 릴리스, 5개 신규 모델 추가 Transformers 라이브러리가 v5.21.0을 릴리스했으며, 문서 인식부터 음성 합성까지 5개 모델을 새로 지원한다. AI · 머신러닝 · huggingface/transformers@v5.21
Key Point 문서 이해, 음성 합성 등 신규 모델 5개가 추가되고 병렬 처리·양자화·캐시 처리가 크게 개선되어 LLM과 멀티모달 모델 개발자들에게 직접적인 영향이 있다.
핵심 요약
Transformers 라이브러리가 v5.21.0을 릴리스했으며, 문서 인식부터 음성 합성까지 5개 모델을 새로 지원한다. MiniCPM-OCR은 OpenBMB의 모델로 SigLIP 비전 인코더와 Qwen3.5 언어 모델을 결합해 스캔 페이지, 스크린샷, 영수증 등 텍스트 밀집 이미지를 읽는다. Flint는 Recursive의 혼합 전문가 모델로 슬라이딩 윈도우 주의(512개 토큰 범위)와 완전 주의를 결합하며, 각 희소 계층이 256개 전문가 중 6개를 라우팅한다. 전체 요약 12문장 읽기 → 003 15:11 ▲ 235 · 댓글 3 뇌 신경 신호 예측, 104B 대규모 모델로 풀다 뇌 인코딩 모델은 자극에 대한 신경 반응을 예측하는데, 기존엔 동결된 사전학습 모델의 출력층만 학습했으나 신경 데이터가 비싸고 제한적이라 큰 모델 학습이 어려웠다. AI · 머신러닝 · Scaling Parameter-Efficient Fine-Tuning for Brain Encoding
Key Point 매개변수 효율적 미세조정 기법으로 뇌 신경 신호 예측 분야에서 100B대 대규모 모델 활용이 처음 가능해졌고, 기존 접근법 대비 계산 효율을 획기적으로 개선했다.
핵심 요약
뇌 인코딩 모델은 자극에 대한 신경 반응을 예측하는데, 기존엔 동결된 사전학습 모델의 출력층만 학습했으나 신경 데이터가 비싸고 제한적이라 큰 모델 학습이 어려웠다. 연구진은 매개변수 효율적 미세조정(PEFT)을 적용해 최대 104B 파라미터 규모의 멀티모달 백본을 적응시켰으며, 이는 뇌 인코딩에 적용된 최대 규모 모델이다. 슬라이딩 윈도우 대신 백본의 인과 구조를 활용해 한 번에 여러 시점을 예측함으로써 특징 추출 비용을 획기적으로 줄였다. 전체 요약 6문장 읽기 → 004 03:11 ▲ 11 · 댓글 2 선형 시간 희소 어텐션으로 컨텍스트 길이 확장하기 선형 시간 시퀀스 모델들은 고정된 크기의 상태에 정보를 저장하기 때문에 장문맥 처리에 제약이 있고, 전체 어텐션을 추가하면 이차 비용이 발생한다. AI · 머신러닝 · FreeSolo: Linear-time Sparse Attention with Zero-Shot Length Extrapolation
Key Point 트랜스포머의 근본적 한계인 이차 복잡도 문제를 해결하면서도 학습 데이터보다 긴 입력에서도 작동하는 새로운 어텐션 메커니즘의 제안으로, LLM의 컨텍스트 길이 확장이 시급한 현실에서 실질적 개선을 제시한다.
핵심 요약
선형 시간 시퀀스 모델들은 고정된 크기의 상태에 정보를 저장하기 때문에 장문맥 처리에 제약이 있고, 전체 어텐션을 추가하면 이차 비용이 발생한다. 지속적 사전학습(CPT)을 통한 희소 어텐션은 컨텍스트 길이를 늘릴 수 있지만 학습된 길이를 넘어 일반화하기 어렵고 비용이 크다. FreeSolo는 단거리 슬라이딩 윈도우 분기와 키포인트 셀을 선택하는 장거리 분기로 구성된 네이티브 희소 어텐션 메커니즘이다. 전체 요약 6문장 읽기 → 005 03:11 ▲ 120 · 댓글 22 역함수 없는 데이터에도 쓰는 슬라이딩 윈도우 집계 알고리즘 슬라이딩 윈도우에서 합계·최댓값 같은 집계를 유지하려면, 합계처럼 역함수가 있는 연산은 deque로 쉽게 구현할 수 있지만 최솟값·최댓값·분위수·근삿값 중복 제거 등 대부분의 실용적인 연산은 역함수가 없어 다른 방식이 필요하다. 오픈소스 · 도구 · Two-Stack Sliding-Window Aggregation
Key Point 역함수가 없는 최솟값·분위수·근삿값 중복 제거 같은 연산을 슬라이딩 윈도우에서 효율적으로 계산해야 하는 상황(실시간 모니터링, 시계열 데이터 분석)에서 amortized O(1) 시간에 구현하는 보편적인 알고리즘을 제시하기 때문입니다.
핵심 요약
슬라이딩 윈도우에서 합계·최댓값 같은 집계를 유지하려면, 합계처럼 역함수가 있는 연산은 deque로 쉽게 구현할 수 있지만 최솟값·최댓값·분위수·근삿값 중복 제거 등 대부분의 실용적인 연산은 역함수가 없어 다른 방식이 필요하다. 두 개의 스택과 하나의 집계값을 이용한 '투 스택' 알고리즘은 2001년의 FIFO 큐 구현 논문에서 영감을 받았으며, 이후 Tangwongsan et al.의 2011년 논문에서 더 일반화되었고, 이론적으로는 수십 년 전부터 알려진 간단하지만 강력한 기법이다. 알고리즘은 values(현재 스택)와 cum_aggs(이전 원소들의 누적 집계 역순)라는 두 스택을 유지하며, 새 값은 values에 추가하고, pop할 때 values가 비면 그 원소들의 누적 집계를 계산해 cum_aggs에 쌓는다. 전체 요약 7문장 읽기 → 006 12:11 ▲ 12 · 댓글 2 토큰 수준의 선택 정확도와 실행 효율을 동시에 해결한 희소 어텐션 긴 문맥에서 LLM 추론 시 KV-캐시 통신량을 줄이는 희소 어텐션 기법들은 주로 높은 단위의 선택만 가능하던 한계가 있었다. AI · 머신러닝 · Joint Subspace Sparse Attention for Efficient Long-Context Decoding
Key Point 토큰 단위 선택의 정확도와 실행 속도 사이의 오래된 트레이드오프를 동시에 해결해 실용적인 장문맥 추론 가속이 가능해진다.
핵심 요약
긴 문맥에서 LLM 추론 시 KV-캐시 통신량을 줄이는 희소 어텐션 기법들은 주로 높은 단위의 선택만 가능하던 한계가 있었다. 저해상도 점수 부여로는 쿼리-키 구조 정보가 손실되어 정확한 랭킹이 어렵고, 선택된 토큰들을 모으는 과정에서 레이턴시 이득이 상쇄되는 문제가 있었다. Joint Subspace Sparse Attention (JSSA)은 공유 저차원 쿼리-키 부분공간을 학습해 토큰 점수 보존 오차를 최소화함으로써 선택 품질을 개선한다. 전체 요약 8문장 읽기 → 007 03:12 새 버전 트랜스포머 5.20.0: 메타 뮤즈 스파크 오픈 등 6개 신규 모델 지원 메타의 멀티모달 혼합 전문가 모델 뮤즈 스파크 오픈(Muse Spark Open)을 추가했다. 총 816B 파라미터(토큰당 활성 42B)이며 최대 1,048,576 토큰의 맥락 창을 지원하고 다중 파일 편집·디버깅·도구 사용 등 에이전틱 코딩 작업을 위해 학습됐다. AI · 머신러닝 · huggingface/transformers@v5.20.0
Key Point 메타·알렉스 알파·바이두 등 주요 기업의 첨단 멀티모달·OCR·오디오 모델 6개가 한 번에 지원되고, 분산 학습·추론·양자화 내보내기 등 프로덕션 기능이 대폭 개선되어 트랜스포머 사용자에게 즉시 영향을 미친다.
핵심 요약
메타의 멀티모달 혼합 전문가 모델 뮤즈 스파크 오픈(Muse Spark Open)을 추가했다. 총 816B 파라미터(토큰당 활성 42B)이며 최대 1,048,576 토큰의 맥락 창을 지원하고 다중 파일 편집·디버깅·도구 사용 등 에이전틱 코딩 작업을 위해 학습됐다. InclusionAI의 Ling 3.0 Flash는 5개 KDA 레이어와 1개 MLA 레이어를 결합한 혼합 전문가 모델로 BailingHybridForCausalLM으로 네이티브 지원되어 trust_remote_code=True 없이 로드된다. 알렉스 알파의 Kolibri 1은 독일어·영어 중심 추론 모델로, 50개 레이어가 384명의 전문가 중 6명에게 각 토큰을 시그모이드 라우팅으로 라우팅하고 슬라이딩 윈도우와 전체 어텐션 레이어를 번갈아 사용한다. 전체 요약 13문장 읽기 → 008 18:30 ▲ 30 · 댓글 2 장문맥 하이브리드 모델의 동작 원리 분석 LLM의 아키텍처가 전체 어텐션만 사용하던 기존 방식에서 슬라이딩 윈도우 어텐션(SWA)과 선형 어텐션(LA) 등을 결합한 하이브리드 모델로 전환되고 있다. AI · 머신러닝 · Mechanics of Long-Context Hybrid Models Part 1.1: From Hybrid Attention to Hybrid Position
Key Point 하이브리드 어텐션이 장문맥 처리에서 어떤 메커니즘으로 작동하는지, 슬라이딩 윈도우와 선형 어텐션 중 어느 것을 선택할지 결정하는 기준이 명확히 제시되었기 때문이다.
핵심 요약
LLM의 아키텍처가 전체 어텐션만 사용하던 기존 방식에서 슬라이딩 윈도우 어텐션(SWA)과 선형 어텐션(LA) 등을 결합한 하이브리드 모델로 전환되고 있다. 본 논문은 하이브리드 모델이 작동하는 이유를 규명하고 더 효과적으로 설계하기 위해 '장문맥 하이브리드 모델의 역학'을 제안한다. 전체 어텐션과 SWA, 또는 GLA·GDN 같은 게이팅 선형 어텐션을 결합한 하이브리드에서 씨소 효과(Seesaw Effect)를 관찰했다: LA 하이브리드는 장문맥 지속 학습에서 더 유리하고 SWA 하이브리드는 길이 외삽에서 더 잘 작동한다. 전체 요약 6문장 읽기 → 009 18:33 새 버전 Transformers 5.19.0, 멀티모달 임베딩과 분산학습 기능 강화 Gemma 2의 멀티모달 임베딩 모델 EmbeddingGemma2를 새로 추가했으며, 텍스트·이미지·오디오·비디오를 768차원 벡터 공간에 인코딩하고 512/256/128차원으로 축소 가능하다. AI · 머신러닝 · huggingface/transformers@v5.19.0
Key Point 멀티모달 모델 지원 확대와 분산학습 병렬화 개선으로 LLM 추론 효율이 향상되며, 주요 API 변경으로 기존 코드 마이그레이션이 필요해진다.
핵심 요약
Gemma 2의 멀티모달 임베딩 모델 EmbeddingGemma2를 새로 추가했으며, 텍스트·이미지·오디오·비디오를 768차원 벡터 공간에 인코딩하고 512/256/128차원으로 축소 가능하다. MoE(Mixture of Experts) 모델이 output_router_logits=True일 때 라우터 로짓을 반환하도록 변경되었으며, 기존 코드는 새 출력 클래스에서 로짓을 읽어야 한다. OWLv2 이미지 쿼리 선택 방식이 객체 신뢰도 점수 기준으로 변경되어 기존 기능과 결과가 달라질 수 있다. 전체 요약 7문장 읽기 → 010 18:35 ▲ 11 · 댓글 2 에이전트 간 통신 75% 압축, 캐시 공유 방식 제안 다중 에이전트 시스템에서 에이전트 간 KV 캐시를 직접 전송하는 방식이 텍스트 통신보다 정확도와 지연시간이 우수하지만, 전체 캐시 크기가 각 에이전트 처리 컨텍스트와 에이전트 수에 따라 선형으로 증가해 GPU 메모리와 컨텍스트 윈도우를 초과하는 문제가 발생한다. AI · 머신러닝 · Receiver-Conditioned Latent Communication gives 94% CacheBack
Key Point KV 캐시 직접 전송으로 다중 에이전트 시스템의 성능을 높이되, 메모리 증폭 문제를 receiver conditioning으로 대폭 해결할 수 있는 실용적 방법을 제시한다.
핵심 요약
다중 에이전트 시스템에서 에이전트 간 KV 캐시를 직접 전송하는 방식이 텍스트 통신보다 정확도와 지연시간이 우수하지만, 전체 캐시 크기가 각 에이전트 처리 컨텍스트와 에이전트 수에 따라 선형으로 증가해 GPU 메모리와 컨텍스트 윈도우를 초과하는 문제가 발생한다. Receiver-Conditioned Latent Communication이라는 아이디어는 수신 에이전트가 자신의 정보 필요사항을 기술해 송신 에이전트에게 전달하면, 송신 에이전트가 이를 바탕으로 KV 캐시를 필터링·압축해서 보내는 방식이다. CacheBack은 송신 에이전트의 어텐션 가중치를 기반으로 receiver conditioning을 구현한 훈련 없는 방식이다. 전체 요약 5문장 읽기 → 011 18:35 ▲ 35 · 댓글 2 장시간 영상 생성 시 표현 붕괴 문제 해결 기법 제시 자동회귀형 비디오 확산 모델은 단시간 영상 생성에는 뛰어나지만, 색상·텍스처 변화와 동작 역학 감소로 인한 드리프팅 현상으로 장시간 영상 생성이 어렵다. AI · 머신러닝 · In-Distribution Forcing for Long Video Generation at Test Time
Key Point 자동회귀 비디오 생성 모델의 장시간 생성에서 흔히 발생하는 표현 붕괴 문제를 근본적으로 해결하는 방식을 제시하며, 분당 단위 길이의 영상 생성을 가능하게 한다.
핵심 요약
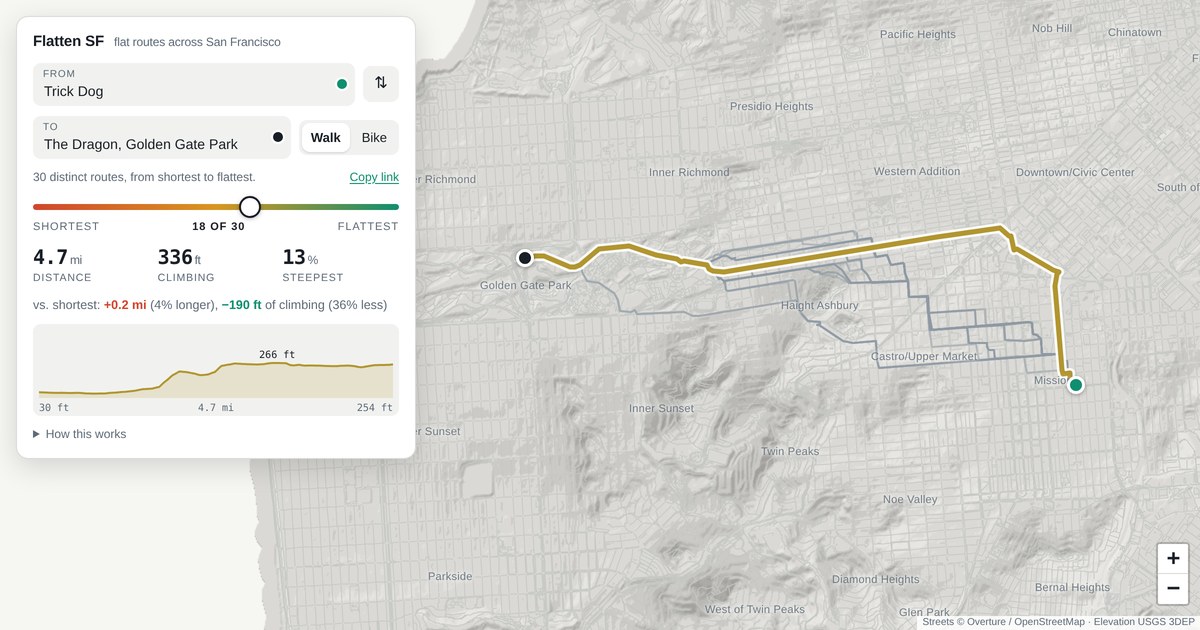
자동회귀형 비디오 확산 모델은 단시간 영상 생성에는 뛰어나지만, 색상·텍스처 변화와 동작 역학 감소로 인한 드리프팅 현상으로 장시간 영상 생성이 어렵다. 기존 방식은 KV 조건화(캐시된 키-밸류 항목 선택·수정)로 드리프팅을 완화하려 했으나, 훈련 범위를 초과하면 캐시 항목 자체가 분포 외(OOD)가 되는 KV-provenance 문제가 발생한다. 이를 해결하기 위해 In-Distribution Forcing(ID-Forcing)을 제시하는데, 이는 KV 캐싱과 조건화를 훈련 설정과 정렬시키는 테스트타임 프레임워크다. 전체 요약 6문장 읽기 → 012 18:35 ▲ 310 · 댓글 115 샌프란시스코에서 가장 평탄한 경로를 찾아주는 웹앱 브라우저에서 USGS 1m 라이다 고도 데이터와 OpenStreetMap 거리 네트워크를 활용해 샌프란시스코의 160,000개 도로 구간을 분석합니다. 웹 · 프론트엔드 · Find the flattest route between any two points in SF
Key Point 운동과 자전거 라이딩 시 오르막을 최소화해야 하는 사람들에게, 실제 고도 데이터 기반의 경로 최적화 도구가 제공됩니다.
핵심 요약
브라우저에서 USGS 1m 라이다 고도 데이터와 OpenStreetMap 거리 네트워크를 활용해 샌프란시스코의 160,000개 도로 구간을 분석합니다. 슬라이더를 조정해 거리와 오르막의 트레이드오프를 제어하며, 단축할 수 없는 최적 경로들만 제시됩니다. 오르막은 총 고도 상승량으로 계산되며, 자전거 모드에서는 보호 차로와 자전거 경로를 실제보다 짧게, 번잡한 대로는 길게 평가합니다. 전체 요약 6문장 읽기 → 013 00:11 ▲ 11 · 댓글 2 월드 모델이 컨텍스트 창 제약을 넘다 스트리밍 월드 모델이 같은 장소를 반복 방문할 때 일관되게 렌더링하려면 두 번의 방문을 모두 담은 학습 샘플이 필요한데, 이는 종종 수분에 걸쳐 있어 전체 구간에 대한 조밀한 어텐션 계산이 이차 비용을 초래한다. AI · 머신러닝 · Memorizon: Training World Models Beyond Their Context Window
Key Point 컨텍스트 윈도우 제약으로 인한 월드 모델의 장기 기억 문제를 검색 기반 메모리 뱅크로 해결하는 기법으로, 계산 효율을 유지하면서 재방문 일관성을 크게 개선한다.
핵심 요약
스트리밍 월드 모델이 같은 장소를 반복 방문할 때 일관되게 렌더링하려면 두 번의 방문을 모두 담은 학습 샘플이 필요한데, 이는 종종 수분에 걸쳐 있어 전체 구간에 대한 조밀한 어텐션 계산이 이차 비용을 초래한다. Memorizon은 이 문제를 해결하기 위해 장기 감독과 어텐션을 분리했다: 긴 시간 폭은 감독에는 필요하지만 어텐션에는 불필요하며, 두 방문이 그 사이의 모든 프레임 없이 순전파를 공유할 수 있다. 학습 샘플은 임의의 길이의 시간 폭을 다루지만 마지막 k개 청크에서만 점수를 매기며, 각 청크는 카메라 공시성(camera co-visibility)으로 상위 K개 잠재변수를 검색한다. 전체 요약 7문장 읽기 → 014 00:11 ▲ 160 · 댓글 91 독일의 주권형 AI, 78억 파라미터 콜리브리 공개 Aleph Alpha가 독일·영국 대상의 혼합 전문가(MoE) 모델 '콜리브리'를 2026년 10월 3일 Apache 2.0 라이선스로 공개했다. AI · 머신러닝 · Show HN: Germany's new sovereign AI model Kolibri
Key Point EU AI 규정 준수, 데이터 독립성, 독일어 추론을 통합한 오픈웨이트 모델로 유럽 규제권 내 AI 자립이 기술적으로 가능함을 보여주며, 금융·공공·항공우주 등 데이터 민감 산업에 기존 대규모 모델 의존도를 낮힐 선택지를 제공한다.
핵심 요약
Aleph Alpha가 독일·영국 대상의 혼합 전문가(MoE) 모델 '콜리브리'를 2026년 10월 3일 Apache 2.0 라이선스로 공개했다. 78.1억 개 파라미터 중 토큰당 3.46억 개(4.4%)만 활성화되며, 262,144 토큰 기본 문맥에서 최대 104만 8576 토큰까지 검증됐다. 독일 및 핀란드 인프라에서 768개 NVIDIA B200 GPU로 24조 토큰을 학습했으며, 독일 법률에 따라 구축돼 조직이 자체 서버에서 완전히 제어 가능하다. 전체 요약 12문장 읽기 → 015 06:11 ▲ 12 · 댓글 2 동영상 스트림으로 자기지도학습하는 StreamMAE 제시 자기지도학습은 영아 시각 발달을 모방하지만 현재 학습은 이미지를 무작위로 섞어 쓰는데, 이 논문은 연속 동영상 스트림으로부터의 학습을 연구했다. AI · 머신러닝 · I Have a Stream: Making Self-Supervised Learning Work on Continuous Video
Key Point 영아가 학습하는 방식과 유사한 연속 동영상 스트림에서 자기지도학습이 왜 어려운지, 그리고 이를 극복하는 기술적 방법을 제시하는 논문으로, 현실 세계의 실시간 영상 데이터 활용에 영향을 미칠 수 있다.
핵심 요약
자기지도학습은 영아 시각 발달을 모방하지만 현재 학습은 이미지를 무작위로 섞어 쓰는데, 이 논문은 연속 동영상 스트림으로부터의 학습을 연구했다. 95시간 도시 산책 동영상으로 만든 WT++ 데이터셋에서 시간 순서대로 슬라이딩 윈도우 배치로 프레임을 처리하되, 전역 셔플이나 멀티에포크 재생 없이 학습했다. 대조 학습과 증류 기반 방법은 이 설정에서 성능이 떨어졌고, MAE도 기준 i.i.d. 사전학습에 못 미쳤다. 전체 요약 6문장 읽기 → 016 15:11 ▲ 20 · 댓글 1 영상 세계 모델의 긴 문맥 처리, 효율적 어텐션으로 해결 텍스트 조건부 대화형 비디오 세계 모델은 텍스트 지시에 따라 시간적으로 일관된 환경을 시뮬레이션한다. AI · 머신러닝 · WorldAttention: An Efficient Attention Architecture for Interactive Video World Models
Key Point 대화형 비디오 생성에서 긴 문맥을 유지하면서 계산 효율을 동시에 확보하려는 세계 모델 연구의 핵심 기술 개선이다.
핵심 요약
텍스트 조건부 대화형 비디오 세계 모델은 텍스트 지시에 따라 시간적으로 일관된 환경을 시뮬레이션한다. 기존 프레임워크는 슬라이딩 윈도우로 계산 복잡도를 제한하면서도 과거 문맥을 잃어 장기 상호작용 능력이 떨어진다. 전체 히스토리 캐시는 어텐션의 이차 복잡도와 KV 캐시의 선형 증가로 인해 계산 및 메모리 과부하가 심하다. 전체 요약 7문장 읽기 → 017 18:11 ▲ 109 · 댓글 37 gzip으로 텍스트를 생성할 수 있다 정보 이론에서 압축은 예측과 동치이므로, 신경망 없이 OS의 gzip 압축기만으로 언어 모델처럼 동작할 수 있다. AI · 머신러닝 · Can gzip be a language model?
Key Point 기존의 대규모 학습된 신경망 없이 순수 표준 라이브러리만으로 언어 모델이 동작하는 방식을 보여주며, 압축과 예측의 수학적 동치성을 실제로 구현한 흥미로운 증명이다.
핵심 요약
정보 이론에서 압축은 예측과 동치이므로, 신경망 없이 OS의 gzip 압축기만으로 언어 모델처럼 동작할 수 있다. gzip은 최근 텍스트의 32KiB 슬라이딩 윈도우에서 매칭을 찾아 압축하는데, 이를 확률 점수로 변환할 수 있다. 코퍼스를 gzip의 윈도우에 포함시켜 프라임한 후, 후보 텍스트를 덧붙여 압축했을 때의 길이를 측정해 점수를 매긴다. 전체 요약 6문장 읽기 → 018 16:56 ▲ 114 · 댓글 8 DeepSeek, KV 캐시 압축으로 추론 속도 420 토큰/초 달성 DeepSeek-v4.1 Flash는 552B 매개변수 멀티모달 모델로, 에이전트 워크플로우에서 증가하는 컨텍스트와 도구 호출로 인한 프리필 계산 부담을 해결하기 위해 설계됐다. AI · 머신러닝 · DeepSeek-v4.1 Flash: Pushing the Limits of KV Cache Compression
Key Point 에이전트 워크플로우에서 일반적인 병목인 장문맥 프리필 계산과 KV 캐시 저장 비용을 획기적으로 줄인 새로운 모델 아키텍처 설계가 장기 맥락 처리와 배포 비용 절감에 어떻게 영향을 미치는지 보여준다.
핵심 요약
DeepSeek-v4.1 Flash는 552B 매개변수 멀티모달 모델로, 에이전트 워크플로우에서 증가하는 컨텍스트와 도구 호출로 인한 프리필 계산 부담을 해결하기 위해 설계됐다. KV 캐시 압축을 위해 채널·시퀀스·레이어 세 차원에서 최적화를 진행했으며, 같은 시퀀스 길이에서 런타임 KV 캐시는 v4-Flash의 1/4, 영구 저장소는 1/8 수준으로 줄었다. Causal Encoder-Decoder(CED) 아키텍처를 도입해 프리필 단계에서 8B, 디코딩 단계에서 16B 매개변수만 활성화되도록 설계했으며, 이는 입력 중심의 에이전트 시나리오에 특히 효율적이다. 전체 요약 12문장 읽기 → 019 03:10 ▲ 120 · 댓글 14 애니메이션 발 미끄러짐 해결하기: 역운동학과 풋 로킹 애니메이션에서 발이 바닥을 헛디는 '풋 슬라이딩'을 해결하는 방법을 설명하는 블로그 글이다. 하드웨어 · 시스템 · Inverse Kinematics and Foot Locking
Key Point 게임 및 애니메이션 엔진에서 발 미끄러짐은 시각 품질에 큰 영향을 미치는데, 실무자마다 다른 방식을 사용해온 만큼 체계적인 구현 방법을 배울 수 있다.
핵심 요약
애니메이션에서 발이 바닥을 헛디는 '풋 슬라이딩'을 해결하는 방법을 설명하는 블로그 글이다. 발의 특정 위치에 발가락을 배치하기 위해 역운동학(IK)으로 다리 체인의 로컬 회전을 계산하되, 팔다리 과신전을 방지하는 소프트 클램핑과 무릎 관절의 사이드 벡터를 활용한 안정적인 회전축 선택을 사용한다. 지면과의 충돌을 방지하기 위해 바인드 포즈에서 발꿈치와 발가락의 높이를 계산한 후 해당 높이로 타깃을 클램핑한다. 전체 요약 5문장 읽기 →