쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
100건 (최대치) · "모델링"조건 지우기 ×
001 18:11 ▲ 45 · 댓글 3 극도로 압축된 토큰으로 빠른 이미지 생성, 32배 압축에도 품질 유지 이산 자기회귀 모델은 토큰 수를 줄이면 생성 속도는 빨라지지만 표현 품질이 떨어지는 근본적 트레이드오프에 직면해 있다. AI · 머신러닝 · G-STAR: Group-Scaled Token Capacity for Deeply Compressed Autoregressive Generation
Key Point 극도로 압축된 토큰으로도 이미지 생성 품질을 유지하면서 20배 빠른 속도를 달성해, 대규모 시각 생성 모델의 실용적 배포 가능성을 크게 높였다.
핵심 요약
이산 자기회귀 모델은 토큰 수를 줄이면 생성 속도는 빨라지지만 표현 품질이 떨어지는 근본적 트레이드오프에 직면해 있다. 연구팀은 곱셈 양자화 기반으로, 고정된 정보량 예산에서 그룹 크기가 공간 압축 비율의 제곱에 비례해야 한다는 원리를 도출했다. 이를 토대로 G-STAR이라는 공간-그룹 동시 스케일링 프레임워크를 제안하여 32배, 심지어 64배 압축도 가능하게 하면서 재구성·이해·생성 성능을 보존한다. 전체 요약 6문장 읽기 → 002 15:11 ▲ 43 · 댓글 3 대화하며 실시간 응답하는 AI 모델 Duo 공개 Hugging Face가 Reciprocal World Model(RWM) 기반의 Duo v1을 발표했으며, 이는 오디오·비디오를 지속적으로 인식하면서 실시간으로 사용자에게 응답하는 풀 듀플렉스 월드 모델이다. AI · 머신러닝 · Duo: A Reciprocal World Model for Full-Duplex Interaction
Key Point 실시간 양방향 상호작용이 가능한 월드 모델은 기존의 단편적 명령 처리를 벗어나 대화 중단, 맥락 변경, 멀티모달 입력을 동시에 처리하는 새로운 AI 상호작용 패러다임을 보여준다.
핵심 요약
Hugging Face가 Reciprocal World Model(RWM) 기반의 Duo v1을 발표했으며, 이는 오디오·비디오를 지속적으로 인식하면서 실시간으로 사용자에게 응답하는 풀 듀플렉스 월드 모델이다. 기존 월드 모델은 물리적 현실 시뮬레이션에만 집중해 추론과 의사결정을 외부 제어로 남겨두지만, RWM은 지능과 물리적 현실을 동등하게 기본으로 취급하며 Intent(상호작용의 인식)와 Realization(음성·영상 행동 생성)이 세계의 일부가 된다. Duo v1의 핵심 기술은 (1) 자회귀 모델링으로 지속적 상호작용 추론과 참여 결정을 수행하고, (2) 청크별 조건과 동기화 토큰으로 Intent와 Realization을 타임라인에 정렬하며 인과 관계를 유지하고, (3) 이중 롤아웃 증류(dual rollout distillation)로 두 모듈의 분포 편향을 완화한다. 전체 요약 5문장 읽기 → 003 15:11 ▲ 171 · 댓글 40 개인 컴퓨터에서 돌리는 1450억 파라미터 모델 Edge0-145B 공개 Edge0가 145B 파라미터의 Edge0-145B와 120B 모델을 오픈소스로 공개했으며, 통합 추론 프레임워크와 배포 도구도 함께 제공한다. AI · 머신러닝 · Edge0-145B: Frontier AI Capabilities on Your Own Computer
Key Point 개인 컴퓨터에서 클라우드 모델 수준의 복잡한 작업(코딩, 3D 모델링, 비디오 제작)을 요금 없이 수행 가능해지면서, 온디바이스 AI의 실용성이 크게 높아졌다.
핵심 요약
Edge0가 145B 파라미터의 Edge0-145B와 120B 모델을 오픈소스로 공개했으며, 통합 추론 프레임워크와 배포 도구도 함께 제공한다. 호환 가능한 노트북에서 피크 메모리 29GB, 토큰 생성 속도 80+tokens/s로 동작하며 기존 대규모 모델 대비 약 40% 메모리로 동등한 성능을 낸다. Edge0-145B는 DeepSWE 1.1에서 64.6점(Qwen3.8-Flash-Next 58.7, DeepSeek-V4-Flash 54.4), Terminal-Bench 2.1에서 86.52점(Qwen 83.3, DeepSeek 82.7)으로 코딩·추론·명령 이행 능력이 클라우드 모델 수준이다. 전체 요약 11문장 읽기 → 004 15:10 ▲ 39 · 댓글 7 표 데이터 '생성·보충·예측' 한 모델으로 모두 해낼 수 있을까 표 데이터의 세 가지 작업—누락된 값 채우기(imputation), 미래값 예측(prediction), 데이터 생성(generation)—은 같은 데이터 분포를 다루지만 보통 따로 평가한다. AI · 머신러닝 · One Table, Many Queries: Benchmarking Generalist Tabular Models Across Generation, Imputation, and Prediction
Key Point 표 데이터 모델링의 세 가지 핵심 작업을 단일 모델로 수행할 수 있는지 처음 체계적으로 평가한 벤치마크로, 현실의 데이터 처리 파이프라인을 통합 설계할지 말지의 기준을 제시한다.
핵심 요약
표 데이터의 세 가지 작업—누락된 값 채우기(imputation), 미래값 예측(prediction), 데이터 생성(generation)—은 같은 데이터 분포를 다루지만 보통 따로 평가한다. 연구팀은 56개 데이터셋과 46개 모델을 포함한 'One Table Benchmark'를 만들어 20가지 능력 축 아래 세 작업을 통일된 조건에서 비교했다. 다섯 가지 신경망을 일곱 가지 목표 조합으로 훈련한 결과, 보충과 예측은 수치 회복과 의존성 보존을 통해 연결되고, 생성은 예측 유틸리티를 통해 둘 모두와 연결된다. 전체 요약 9문장 읽기 → 005 15:10 ▲ 117 · 댓글 29 컴퓨터 그래픽의 상징, 유타 티팟의 50년 진화 유타 티팟은 컴퓨터 그래픽 역사의 상징으로, 베지에 곡면을 이용한 초기 3D 모델이다. 하드웨어 · 시스템 · The Utah Teapot
Key Point 초기 Bézier 곡면 기반 3D 모델의 역사적 진화 과정과 기술적 개선 방식을 정확히 이해하고 싶은 그래픽스 관심층, 그리고 산업 표준의 출발점과 그 개선 궤적을 배우려는 개발자들이 참고할 수 있는 자료다.
핵심 요약
유타 티팟은 컴퓨터 그래픽 역사의 상징으로, 베지에 곡면을 이용한 초기 3D 모델이다. 1975년 마틴 뉴엘이 박사학위 논문 작성 중 실제 주전자(멜리타)를 참고해 28개의 3차 베지에 곡면으로 모델링했다. 1976년 짐 블린이 모델을 3/4로 축소해 지금의 친숙한 형태가 되었고, SIGGRAPH 1976에서 발표되어 그래픽 커뮤니티의 표준이 됐다. 전체 요약 9문장 읽기 → 006 03:11 ▲ 14 · 댓글 4 단백질 진화에 최적화된 뮤테이션 예측 모델 공개 깊은 변이 스캐닝 데이터로 사전학습한 ProTEUS는 서열, 진화, 구조 정보를 MutationFormer 아키텍처로 통합 표현하며, 변이체를 잠재 공간의 상태로, 돌연변이를 그 기능적 결과를 예측하는 행동으로 모델링한다. AI · 머신러닝 · ProTEUS: A mutation-resolved world model for closed-loop protein evolution
Key Point 단백질 설계에서 실험 스크리닝으로는 탐색 불가능한 조합적 돌연변이 공간을 효율적으로 탐색하는 AI 모델이 나왔으며, 실제 실험으로 10배 이상의 성능 개선을 입증했다.
핵심 요약
깊은 변이 스캐닝 데이터로 사전학습한 ProTEUS는 서열, 진화, 구조 정보를 MutationFormer 아키텍처로 통합 표현하며, 변이체를 잠재 공간의 상태로, 돌연변이를 그 기능적 결과를 예측하는 행동으로 모델링한다. 기하학적 제약 강제를 통해 AlphaFold3 대비 10배 이상 빠른 물리적으로 타당한 전체 원자 예측 엔진을 개발해 많은 변이체 탐색을 지원한다. 실험 피드백 루프를 통해 단백질 활성 예측을 반복 개선하면서 원하는 표현형으로 진화를 유도한다. 전체 요약 6문장 읽기 → 007 18:11 ▲ 23 · 댓글 5 비디오·행동을 함께 학습하는 세계 모델 SWAM 공개 언어-비디오 정렬을 학습한 기반 위에 행동 학습을 추가할 때 기존 정렬이 훼손될 수 있다는 문제를 중점 연구했다. AI · 머신러닝 · SWAM: Scaling World Action Models with Cross-Modal Alignment
Key Point 로봇 제어를 위한 세계 모델의 언어-비디오 정렬 유지 전략이 명확해져, 동작 학습 시 기존 이해 능력을 보존하면서 행동 능력까지 확장하려는 연구자들에게 실질적인 지침을 제공한다.
핵심 요약
언어-비디오 정렬을 학습한 기반 위에 행동 학습을 추가할 때 기존 정렬이 훼손될 수 있다는 문제를 중점 연구했다. 약 47,000시간의 일반 비디오, 1인칭 시점 비디오, UMI 데모, 로봇 데모를 수집하여 데이터 풀을 구성했다. 언어-비디오 감시, 언어-비디오-행동 감시, 두 형태를 결합한 학습이 세계 행동 모델(WAM) 성능에 어떻게 영향 미치는지 체계적으로 분석했다. 전체 요약 9문장 읽기 → 008 03:11 ▲ 12 · 댓글 3 LLM이 부정확한 시뮬레이터의 오류를 판단할 수 있을까 LLM 에이전트가 시스템 연구에서 설계를 평가할 때 시뮬레이터에 의존하지만, 시뮬레이터는 모델링 한계가 있어 예측은 왜곡하면서도 추천 설계는 맞거나 그 반대일 수 있다. AI · 머신러닝 · SIRIS: Can LLMs Tell When Simulation Errors Matter in AI-Driven Systems Research
Key Point LLM 기반 시스템 연구가 확산되면서 실제 설계 결정에 영향을 미치는데, 최신 모델들이 불완전한 도구의 한계를 제대로 인식하지 못해 잘못된 판단을 할 수 있는 근본적 문제를 드러낸다.
핵심 요약
LLM 에이전트가 시스템 연구에서 설계를 평가할 때 시뮬레이터에 의존하지만, 시뮬레이터는 모델링 한계가 있어 예측은 왜곡하면서도 추천 설계는 맞거나 그 반대일 수 있다. Siris는 LLM이 시뮬레이터 한계가 추천을 무효화하는 시점을 시스템 이해를 바탕으로 판단할 수 있는지 테스트하는 방법이다. 시뮬레이터를 변형해 동일한 후보·한계·추천을 가진 워크로드 쌍을 생성하되, 변형은 양쪽 워크로드의 예측을 바꾸면서도 참조 시뮬레이터는 한쪽에서만 추천을 지지한다. 전체 요약 6문장 읽기 → 009 00:11 ▲ 101 · 댓글 108 에이블톤 라이브 13, 2027년 초 출시 예정 음악 제작 DAW 에이블톤 라이브의 신버전 13이 2027년 초 출시될 예정이다. 하드웨어 · 시스템 · Ableton Live 13
Key Point 음악 제작자들이 사용하는 주요 DAW의 대규모 업데이트로, Step Sequencer, ARA 2 지원, 신규 이펙트 등 핵심 워크플로우 개선사항을 제공한다.
핵심 요약
음악 제작 DAW 에이블톤 라이브의 신버전 13이 2027년 초 출시될 예정이다. Step Sequencer, ARA 2, Capture Automation, Contextual Browsing 등 새로운 음악 제작 워크플로우가 추가되었다. Drum Synth는 20가지 이상의 드럼 엔진으로 타악기를 직접 설계할 수 있고, Looplet은 하나의 샘플을 네 개의 플레이헤드로 레이어링하고 루핑할 수 있게 한다. 전체 요약 12문장 읽기 → 010 15:10 ▲ 58 · 댓글 2 세계 지능형 모델 평가를 위한 통합 인프라 'WorldFoundry' 공개 시각 생성 모델이 환경 시뮬레이션과 합성 관찰 사이의 경계를 모호하게 만들고 있지만, 시각적 그럴듯함만으로는 참된 세계 모델링이 아니며 지속적 상태, 물리 역학, 인과적으로 일관된 상호작용 응답이 필요함을 지적한다. AI · 머신러닝 · WorldFoundry: Towards Unified Infrastructure for World Intelligence
Key Point 세계 모델링 연구에서 단순한 시각적 생성을 넘어 인과성 있는 상태 예측과 제어 가능성을 다룰 수 있는 통합 평가 인프라가 나타났으며, 270개 모델과 74개 벤치마크를 하나의 프레임워크로 통합한 점이 재현성과 비교 가능성의 새로운 기준을 제시한다.
핵심 요약
시각 생성 모델이 환경 시뮬레이션과 합성 관찰 사이의 경계를 모호하게 만들고 있지만, 시각적 그럴듯함만으로는 참된 세계 모델링이 아니며 지속적 상태, 물리 역학, 인과적으로 일관된 상호작용 응답이 필요함을 지적한다. 생성형 세계 모델을 환경의 지속적이고 이력 기반의 표현을 유지하며, 행동이나 개입에 대응해 표현을 업데이트하고, 관찰된 상황과 반사실적 개입의 결과를 반영하는 시간적으로 일관된 궤적을 생성하는 예측 동적 시스템으로 정의한다. 지각적 기초, 지속적 상태 모델링, 제어 가능한 변환, 역학 인식 예측, 폐루프 상호작용을 아우르는 지능 지향 프레임워크를 제시한다. 전체 요약 8문장 읽기 → 011 12:11 ▲ 225 · 댓글 613 클로드 페이블·미토스 5.2, 전문가 작업용 초강력 모델 출시 앤스로픽이 클로드 페이블 5.2와 미토스 5.2를 공개했으며, 두 모델은 동일한 기반이지만 페이블에는 사이버보안·생물학 보안 장치가 있어 모든 사용자에게 공개되고, 미토스는 검증 프로그램 신청 시 접근 가능하다. AI · 머신러닝 · Claude Fable 5.2 and Mythos 5.2
Key Point 기업 소프트웨어 마이그레이션부터 블랙홀 이론물리 증명, 신약 전달용 단백질 설계까지 광범위한 분야에서 실제 문제를 해결하는 모델이 나왔으며, 이전 모델 대비 저렴한 가격으로 성능을 크게 향상시켰다.
핵심 요약
앤스로픽이 클로드 페이블 5.2와 미토스 5.2를 공개했으며, 두 모델은 동일한 기반이지만 페이블에는 사이버보안·생물학 보안 장치가 있어 모든 사용자에게 공개되고, 미토스는 검증 프로그램 신청 시 접근 가능하다. 페이블 5.2와 미토스 5.2는 코딩, 추론, 비전에서 이전 버전 대비 개선되었으며, 입력 토큰당 $8, 출력 토큰당 $40으로 페이블 5.1보다 저렴하고 토큰 생성 속도는 최대 30% 빨라졌다. 선택적 고속 모드는 토큰 생성을 최대 2.5배 빠르게 하며 입력 토큰당 $16, 출력 토큰당 $80이다. 전체 요약 12문장 읽기 → 012 06:11 ▲ 662 · 댓글 352 Claude Fable 5.2와 Mythos 5.2 공개, 코딩·과학 성능 대폭 향상 Anthropic이 Claude Fable 5.2와 Claude Mythos 5.2를 공개했으며, 두 모델은 같은 기반 모델이지만 Mythos는 사이버보안·생물학 분야 검증 프로그램을 통해 제한적으로 제공된다. AI · 머신러닝 · Claude Fable 5.2 and Mythos 5.2
Key Point Fable 5.2와 Mythos 5.2는 상용 모델 중 가장 복잡한 엔지니어링·연구 작업을 수행할 수 있도록 설계되었으며, 코딩·수학 증명·물리학 문제 해결에서 구체적인 성과를 입증해 AI 실무 활용의 경계를 넓혔다.
핵심 요약
Anthropic이 Claude Fable 5.2와 Claude Mythos 5.2를 공개했으며, 두 모델은 같은 기반 모델이지만 Mythos는 사이버보안·생물학 분야 검증 프로그램을 통해 제한적으로 제공된다. 테스트 결과 Fable 5.2와 Mythos 5.2는 이전 버전 대비 커뮤니케이션이 명확하고, 토큰 생성 속도는 30% 빠르며, 입력 토큰 800만 개당 $8, 출력 토큰 100만 개당 $40으로 가격이 인하됐다. 선택적 fast mode는 토큰 생성을 최대 2.5배 가속하며 입력 토큰당 $16, 출력 토큰당 $80이다. 전체 요약 16문장 읽기 → 013 21:11 ▲ 111 · 댓글 14 텍스트 생성 21배 빨라지는 단계형 모델링 기법 디퓨전 언어 모델은 자동회귀 모델보다 빠른 병렬 샘플링을 제공하지만, 샘플링 단계가 적을수록 품질이 급격히 떨어지고 매번 전체 시퀀스를 처리하며 학습 속도가 느린 문제가 있다. AI · 머신러닝 · Next-Concept Modeling: Fast, Parallel Coarse-to-Fine Text Generation
Key Point 대규모 모델 추론의 병목인 생성 속도를 10배 이상 높이면서 품질을 유지하는 기법이 나왔으므로, LLM 배포와 실시간 서비스에 영향을 줄 수 있다.
핵심 요약
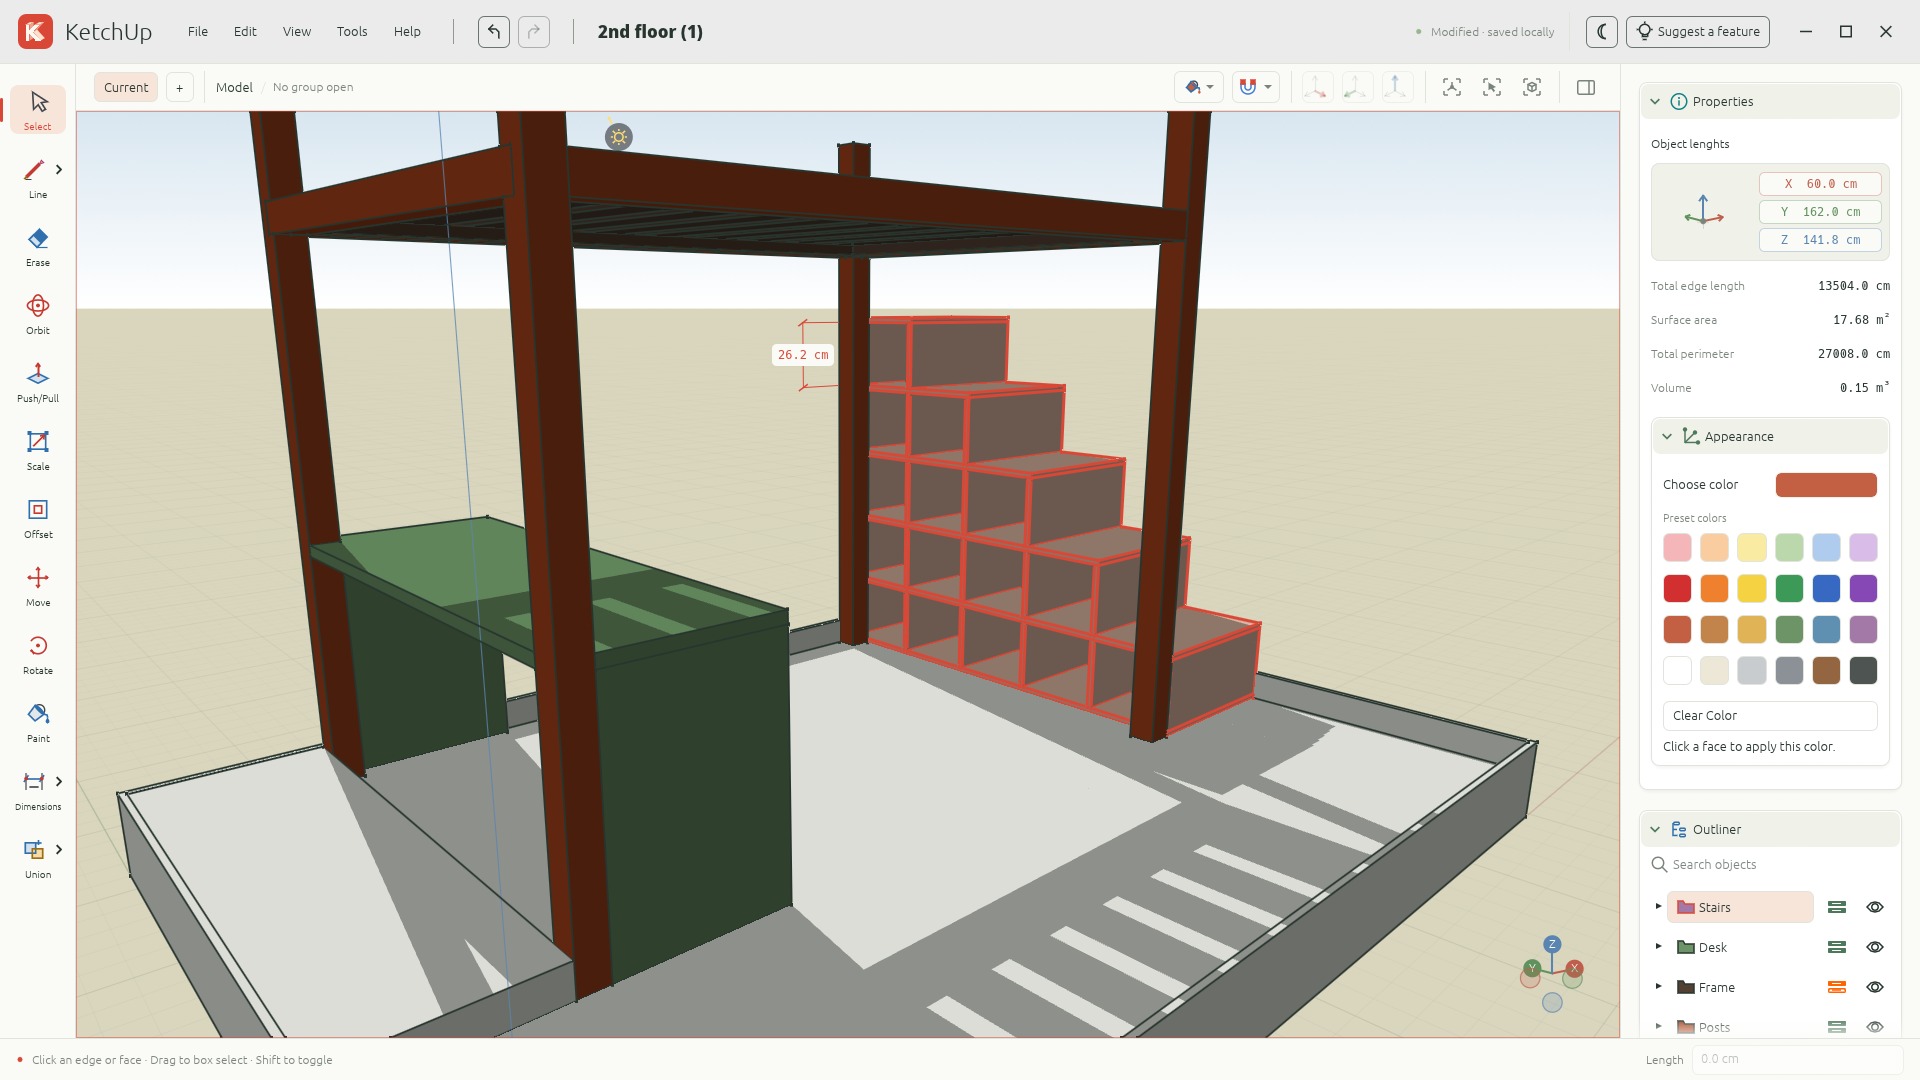
디퓨전 언어 모델은 자동회귀 모델보다 빠른 병렬 샘플링을 제공하지만, 샘플링 단계가 적을수록 품질이 급격히 떨어지고 매번 전체 시퀀스를 처리하며 학습 속도가 느린 문제가 있다. Next-Concept Modeling(NCM)은 2단계 코스-투-파인 프레임워크로, 다중 스케일 VQ-VAE가 텍스트를 이산 코드의 계층으로 인코딩하고 트랜스포머가 각 단계마다 한 수준씩 병렬로 생성한다. LM1B 벤치마크에서 NCM은 가장 강력한 디퓨전 모델보다 나은 생성 복잡도를 달성하면서 21배 빠르게 동작한다. 전체 요약 5문장 읽기 → 014 12:11 ▲ 256 · 댓글 73 Rust와 WebGPU로 만든 오픈소스 3D 모델링 도구 KetchUp 목공과 가구 설계를 위한 무료 오픈소스 3D 모델링 앱 KetchUp이 공개되었다. 오픈소스 · 도구 · KetchUp – Open-source SketchUp alternative built with Rust and WebGPU
Key Point SketchUp의 비싼 라이선스 비용을 피하려는 목공인과 가구 제작자들이 선택할 수 있는 완전히 무료이고 오픈소스인 대안이 나왔다.
핵심 요약
목공과 가구 설계를 위한 무료 오픈소스 3D 모델링 앱 KetchUp이 공개되었다. Windows, macOS, Linux 데스크톱 앱 또는 웹 브라우저에서 실행되며, Rust와 WebGPU로 구축되었다. 직사각형·원·자유형 스케치로 시작해 Push/Pull로 깊이를 주고, 이동·복제·스케일링·칠하기로 모델을 만들 수 있다. 전체 요약 9문장 읽기 → 015 03:11 ▲ 131 · 댓글 93 에이전트 메모리, 표준화가 시급하다 현재 AI 에이전트들은 AGENTS.md, Cursor 규칙, Anthropic 메모리 도구, MCP 서버 등 서로 다른 형식으로 메모리를 저장해 상호 운용이 불가능하다. AI · 머신러닝 · Agent memory needs its OpenTelemetry moment
Key Point AI 에이전트가 점점 보편화되면서 상호운용 불가능한 메모리 형식들이 쌓이고 있는데, 관측성 표준화의 성공 사례를 따라 에이전트 메모리도 하나의 규약으로 통일해야 할 시점이라는 주장을 제시한다.
핵심 요약
현재 AI 에이전트들은 AGENTS.md, Cursor 규칙, Anthropic 메모리 도구, MCP 서버 등 서로 다른 형식으로 메모리를 저장해 상호 운용이 불가능하다. 개발자들이 에이전트 메모리 레이어를 직접 만드는 프로젝트가 늘어나고 있지만, 각각 고유한 저장소와 스키마를 사용하기 때문에 표준의 부재 문제가 심화되고 있다. 2019년 OpenTelemetry 표준 통합 사례처럼, 데이터 모델·의미론적 규약·프로토콜·참조 구현을 정의해 에이전트 메모리도 표준화할 필요가 있다. 전체 요약 12문장 읽기 → 016 18:15 스타 1,163 LLM이 만드는 3D 모델, sand3d로 코드처럼 쓴다 sand3d는 Python 라이브러리로, 3D 객체를 짧은 프로그램으로 작성할 수 있도록 설계되었으며 Blender의 bpy를 기반으로 한다. AI · 머신러닝 · Sandflow-ai/sand3d · HTML
Key Point 3D 모델 생성을 LLM이 직접 다루려면 토큰 효율이 결정적인데, sand3d는 기존 도구 대비 2~6배 짧은 코드로 표현해 프롬프트 예산 내에서 복잡한 객체를 만들 수 있게 한다.
핵심 요약
sand3d는 Python 라이브러리로, 3D 객체를 짧은 프로그램으로 작성할 수 있도록 설계되었으며 Blender의 bpy를 기반으로 한다. 한 부품당 Blender Python, CadQuery, FeatureScript 대비 2~6배 적은 토큰으로 표현되므로 LLM 프롬프트에 맞춘다. 전체 API가 약 3,600 토큰으로 압축되어 시스템 프롬프트에 통째로 들어갈 수 있다. 전체 요약 10문장 읽기 → 017 18:15 스타 1,413 AI 그림 그리기용 포즈·의상·얼굴 참고 도서관 AI 생성 인체 포즈 288조 × 5시점 1,439장과 무인 의상 1,407벌, AI 생성 얼굴 1,499장을 모은 정적 웹사이트를 공개했습니다. AI · 머신러닝 · HRuiCcc/RuiC-PoseAtlas · JavaScript
Key Point AI 그림 그리기·3D 모델링·일러스트·만화 창작자들이 포즈·의상·얼굴을 체계적으로 참고하고 조합할 수 있는 완전 무료 참고 라이브러리가 등장했습니다.
핵심 요약
AI 생성 인체 포즈 288조 × 5시점 1,439장과 무인 의상 1,407벌, AI 생성 얼굴 1,499장을 모은 정적 웹사이트를 공개했습니다. 포즈 도감은 정면·사선·측면·부감·앙감 다섯 방향 참고화를 한 세트로 묶어 제시하고, 화살표 키로 각도와 포즈 간 이동이 가능합니다. 의상 도감은 춘·하·추·동·내의·파티·수영복·섹시 8개 계절 분류와 색상·소재·실루엣 등 86개 삼국어 태그로 구성하여, 무인 의상을 기존 캐릭터에 직접 겹칠 수 있습니다. 전체 요약 10문장 읽기 → 018 12:11 ▲ 11 · 댓글 3 수학 모델링 문제를 자동화로 검증하는 벤치마크 등장 수학 모델링 문제는 현실 문제를 가정·모델·해결책·권장사항으로 변환하는데, 기존 벤치마크는 풀이 조각이나 LLM 판사로 채점해 검증이 불완전했다. AI · 머신러닝 · Terminal-style Mathematical Modeling Bench: The First Agentic and Verifiable Benchmark for Mathematical Modeling
Key Point 수학 모델링 같은 열린 문제의 검증 방식이 LLM 판사 의존에서 기계 검증 가능한 형태로 바뀌면서 AI 에이전트 성능 측정 기준이 더 객관화된다.
핵심 요약
수학 모델링 문제는 현실 문제를 가정·모델·해결책·권장사항으로 변환하는데, 기존 벤치마크는 풀이 조각이나 LLM 판사로 채점해 검증이 불완전했다. TB-MathModel은 18개 실제 CUMCM·MCM 문제(2023~2025)로 완전한 대회식 모델링 문제를 자동화 가능하고 검증 가능하게 만든 첫 벤치마크다. 각 문제는 컨테이너 터미널에 정확한 지문·공식 첨부 자료·그림을 제공하고, 에이전트는 JSON으로 답변해 최종 질문의 수치 핵심을 우수상 논문과 비교 채점한다. 전체 요약 7문장 읽기 → 019 03:11 ▲ 116 · 댓글 2 AI가 인간의 지능을 확장하는 '인지 공생체' 패러다임 AI 발전이 '기계 자체의 지능'에서 '사람의 지능 향상'으로 초점을 옮겨야 한다고 주장한다. AI · 머신러닝 · From Autonomous Agents to Cognitive Symbionts: Toward AI-Augmented Human Intelligence
Key Point 지난 10년 AI 개발의 목표를 근본적으로 재설정하는 논문으로, 로봇 중심의 'Physical AI'를 넘어 개인 맞춤형 지능 확장으로 나아가야 한다는 패러다임 전환을 제시한다.
핵심 요약
AI 발전이 '기계 자체의 지능'에서 '사람의 지능 향상'으로 초점을 옮겨야 한다고 주장한다. 사람은 알고 있었던 지식을 잊고, 보지 못한 것을 놓치고, 말을 찾지 못하고, 과거 경험 없이 결정을 내린다는 점이 현재 AI의 한계다. 이를 해결하기 위해 '인지 공생체(cognitive symbiont)'라는 새로운 시스템을 제안한다. 전체 요약 8문장 읽기 → 020 12:11 ▲ 104 · 댓글 88 촘스키 vs 확률 모델, 언어학의 두 문화 촘스키의 확률 모델 비판에 대해 핑커의 질문으로부터 출발한 에세이로, 통계 모델의 성공 이유를 다룬다. AI · 머신러닝 · Chomsky and the two cultures of statistical learning (2011)
Key Point 통계 기반 언어 모델의 지배적 성공이 정당한지, 아니면 촘스키 식 형식 이론이 올바른 길인지를 놓고 벌어진 언어학의 근본적 논쟁을 명확히 이해할 수 있다.
핵심 요약
촘스키의 확률 모델 비판에 대해 핑커의 질문으로부터 출발한 에세이로, 통계 모델의 성공 이유를 다룬다. 2차 마르코프 모델로 10만 개 어휘를 표현하려면 1경(10¹⁵) 개의 확률값이 필요하며, 이는 데이터 통계 학습과 평활화 기법 없이는 불가능하다. 이상 기체 법칙처럼 확률·통계 모델이 현실을 완벽히 설명하지 못해도 정확한 예측과 통찰력을 제공할 수 있음을 보인다. 전체 요약 10문장 읽기 → 021 15:11 ▲ 76 · 댓글 2 심리치료 대화에 실제 내담자의 개인 표현 모델링하는 AI 개발 심리치료 내담자들은 자신의 고통을 체계적으로 설명하기 전에 겪으며, 감정·안정감·신뢰도에 따라 표현이 달라진다. AI · 머신러닝 · Words Caught in the Heart: Simulating Person-Specific Expression for Self-Opaque Clients in Psychotherapy
Key Point 심리치료 AI 모델이 단순 설명이 아닌 실제 내담자의 감정적·개인적 표현을 재현할 수 있게 되면, 치료 시뮬레이션의 질이 크게 향상되고 임상 교육·연구에 활용될 수 있기 때문이다.
핵심 요약
심리치료 내담자들은 자신의 고통을 체계적으로 설명하기 전에 겪으며, 감정·안정감·신뢰도에 따라 표현이 달라진다. 기존 LLM 기반 내담자 시뮬레이터들은 임상 사례 기술에 의존해 실제보다 더 명확한 설명을 유도하는 문제가 있다. 연구팀은 심리경험이 개인 표현으로 어떻게 구체화되는지 모델링하는 Pandora 프레임워크를 제안했다. 전체 요약 10문장 읽기 → 022 15:11 ▲ 68 · 댓글 2 비디오 생성의 병목은 렌더링에서 의미 제어로 넘어갔다 비디오 생성 기술이 짧은 영상 클립에서 장면 간 일관성 있는 오디오-비주얼 시퀀스로 진화했으며, 이제 병목이 화질 렌더링에서 의미 제어로 옮겨가고 있다. AI · 머신러닝 · Behind Video Generation: Observations and Insights on Multimodal Understanding from Kling
Key Point 비디오 생성 시스템의 모든 모듈(캡셔닝, 프롬프트 강화, 보상 모델링, 평가)을 구체적으로 어떻게 설계했는지 보여주는 실전 가이드라 비디오 생성 연구자와 개발자에게 직접 적용할 수 있다.
핵심 요약
비디오 생성 기술이 짧은 영상 클립에서 장면 간 일관성 있는 오디오-비주얼 시퀀스로 진화했으며, 이제 병목이 화질 렌더링에서 의미 제어로 옮겨가고 있다. Kling의 다세대 개발을 통해 얻은 다중모달 이해에 관한 통찰을 정리한 보고서로, 생성 품질은 데이터-조건화-정렬-평가 전체 파이프라인을 통한 다중모달 이해의 투영이라고 주장한다. Kling-MLLM은 이미지, 비디오, 오디오, 동기화된 오디오-비디오, 인터리빙 입력을 통합하는 공유 다중모달 기초 모델이며, 각 후속 모듈에 맞춰 특화된다. 전체 요약 9문장 읽기 → 023 15:11 ▲ 31 · 댓글 2 통합 멀티모달 모델용 대규모 대화형 데이터셋 공개 통합 멀티모달 모델(UMM)은 시각 이해, 생성, 편집을 하나의 프레임워크에서 수행하지만 기존 데이터셋은 단순 작업 중심이었다. AI · 머신러닝 · YANAMI: A Large-Scale Multimodal Dataset and Benchmark for Multiturn Stateful Interaction
Key Point 멀티모달 AI가 단순 일회성 작업을 넘어 복잡한 대화 흐름에서 상태를 정확히 관리해야 하는 시대에, 이를 평가할 첫 대규모 벤치마크가 공개되었기 때문이다.
핵심 요약
통합 멀티모달 모델(UMM)은 시각 이해, 생성, 편집을 하나의 프레임워크에서 수행하지만 기존 데이터셋은 단순 작업 중심이었다. 최근 다중 턴 데이터셋도 각 턴을 독립적으로 풀 수 있어, 대화 상태를 추적하고 유지해야 하는 상태형 상호작용을 평가하기 부족했다. YANAMI는 상태형 상호작용을 위한 첫 대규모 멀티모달 대화 데이터셋으로 YANAMI-400K와 YANAMI-Bench로 구성된다. 전체 요약 8문장 읽기 → 024 12:11 ▲ 18 · 댓글 1 과거 정보로 일관성 높인 장시간 영상 생성 모델 적은 단계의 자동회귀 비디오 확산 모델은 효율적인 생성이 가능하지만, 피사체나 장면이 화면 밖에 나갔다 다시 등장할 때 일관성을 유지하기 어렵다. AI · 머신러닝 · History Forcing: Distilling History-Dependent Continuations for Long-Horizon Video World Models
Key Point 긴 장면에서도 일관성 있는 영상을 생성하는 것이 영상 AI 모델의 핵심 과제인데, 이 논문이 제시한 History Forcing 방법이 화면 밖 재등장이나 60초 롱폼 생성에서 구체적 성능 개선을 이뤄냈기 때문이다.
핵심 요약
적은 단계의 자동회귀 비디오 확산 모델은 효율적인 생성이 가능하지만, 피사체나 장면이 화면 밖에 나갔다 다시 등장할 때 일관성을 유지하기 어렵다. 기존 증류 방법들은 역사적 정보를 충분히 활용하지 못해 학생 모델의 현재 예측을 제약하지 못한다는 한계가 있다. 이를 해결하기 위해 History Forcing이라는 통합 온폴리시 증류 프레임워크를 제안했다. 전체 요약 7문장 읽기 → 025 09:11 ▲ 102 · 댓글 53 Lisp 기반 CAD 도구, Antimony 공개 Antimony는 전통적인 제도판이 아닌 Lisp 머신 철학에서 출발한 CAD 소프트웨어로, 그래프 기반의 노드 시스템으로 설계된다. 오픈소스 · 도구 · Antimony: CAD Software Evolved from Lisp Machines and Not Drafting Tables (2015)
Key Point 그래프 기반의 노드 프로그래밍 방식으로 CAD 작업을 재정의하고, 스크립트로 모든 설계 요소를 제어할 수 있는 새로운 패러다임을 제시한다.
핵심 요약
Antimony는 전통적인 제도판이 아닌 Lisp 머신 철학에서 출발한 CAD 소프트웨어로, 그래프 기반의 노드 시스템으로 설계된다. 각 노드는 Python 3.x 스크립트로 정의되며 입출력 포트를 통해 연결되고, 변경사항이 자동으로 하위 노드에 전파된다. 기하학 엔진은 불 연산(합집합·교집합·차집합)에 최적화된 함수형 표현을 사용하여 형상을 비트맵으로 렌더링한다. 전체 요약 11문장 읽기 → 026 09:11 ▲ 167 · 댓글 21 생성형 AI의 수학적 기초를 다룬 입문서 출간 Tianhua Chen이 생성형 AI의 수학적 기초를 다루는 195페이지 분량의 입문서를 arXiv에 공개했다. AI · 머신러닝 · The Little Book of Generative AI Foundations: An Intuitive Mathematical Primer
Key Point 생성형 AI를 체계적으로 학습하려는 개발자나 연구자에게 PCA부터 최신 모델까지 일관된 수학적 기초를 제공하는 교재가 생겼다는 점이 중요하다.
핵심 요약
Tianhua Chen이 생성형 AI의 수학적 기초를 다루는 195페이지 분량의 입문서를 arXiv에 공개했다. 이 책은 주요 생성 모델들(PCA, 확률적 PCA, 변분 오토인코더, 확산 모델, 정규화 흐름, 자기회귀 모델, GAN, Wasserstein GAN, 에너지 기반 모델)을 연결하는 일관된 경로를 제시한다. 도출 과정을 중심으로 구성되어 최근의 모든 아키텍처나 구현 세부사항을 다루기보다는 생성 모델링의 구조를 수학적 엄밀함을 잃지 않으면서 이해하기 쉽게 만드는 데 초점을 맞췄다. 전체 요약 6문장 읽기 → 027 15:11 ▲ 74 · 댓글 2 영상 생성, 에이전트가 주도하는 시대로 동영상 생성이 단순 합성에서 계획·도구·피드백을 활용한 에이전트 기반 생성으로 전환되고 있다. AI · 머신러닝 · Video Generation Meets Agent Harness: Agentic Video Generation, Agentic World Modeling and Recursive Self-Improvement
Key Point 동영상 생성 기술이 에이전트 자율성과 결합되는 새로운 패러다임을 제시하며, 멀티 에이전트·장기 계획·하이브리드 환경이 미래 AI 시스템의 핵심 방향이 될 것을 보여준다.
핵심 요약
동영상 생성이 단순 합성에서 계획·도구·피드백을 활용한 에이전트 기반 생성으로 전환되고 있다. 에이전트 하네스는 동영상 모델 주변에 구성된 실행 런타임으로, 맥락·도구·상태·피드백·예산을 관리한다. 에이전트 비디오 생성은 스크립팅·샷 계획·에셋 관리·제작·편집을 조율하며, 이 시스템들의 평가가 과제다. 전체 요약 7문장 읽기 → 028 21:11 당일 +115 3D 스캔을 CAD처럼 측정하는 브라우저 도구 공개 CNC Kitchen이 ScanRuler를 오픈소스로 공개했으며, scanruler.com에서 브라우저로 바로 사용할 수 있다. 하드웨어 · 시스템 · CNCKitchen/ScanRuler · TypeScript
Key Point 정밀 제조, 품질 검사, 역설계가 필요한 엔지니어에게 설계 도구 구매 비용을 줄이고 브라우저만으로 스캔 검수를 자동화할 기회를 제공한다.
핵심 요약
CNC Kitchen이 ScanRuler를 오픈소스로 공개했으며, scanruler.com에서 브라우저로 바로 사용할 수 있다. 3D 스캔 파일(STL, PLY, OBJ, 3MF, STEP)을 불러와 구, 원통, 원뿔, 평면 등을 피팅하고 치수를 측정할 수 있다. 모든 파일과 처리가 브라우저에서만 진행되며, 컴퓨터 밖으로 나가지 않는다(AI 에이전트 연결 시 제외). 전체 요약 12문장 읽기 → 029 15:11 ▲ 35 · 댓글 3 비디오 모델 활용해 다양한 이미지 생성 통합 통합 조건부 이미지 생성은 시각 입력의 여러 측면을 보존하면서 텍스트 지침을 따르는 이미지를 생성해야 하는 과제다. AI · 머신러닝 · FrameForge: Harnessing Priors of Video Foundation Models for Unified Image Generation
Key Point 비디오 모델의 시간축 변환 능력을 조건부 이미지 생성에 적용한 새로운 접근법으로, 단일 모델이 여러 생성 작업을 통합 처리할 수 있게 하는 기술이다.
핵심 요약
통합 조건부 이미지 생성은 시각 입력의 여러 측면을 보존하면서 텍스트 지침을 따르는 이미지를 생성해야 하는 과제다. 기존 방식은 조건과 목표를 고정된 시간 위치에 배치하지만, 생성 작업마다 조건-목표 관계가 크게 달라진다. 비디오 모델은 시간에 따른 시각 변환을 자연스럽게 인코딩하기 때문에, 입력에 맞는 가상 시간 관계로 조건부 생성을 모델링할 수 있다. 전체 요약 6문장 읽기 → 030 15:11 ▲ 27 · 댓글 2 로봇 조작에 계층적 미래 예측을 더하다 로봇 조작 작업을 위한 Vision-Language-Action(VLA) 모델이 시각 인식, 언어 이해, 행동 생성을 통합해 성과를 내고 있으나, 기존 방법들은 단기 역학과 장기 목표를 따로 모델링하고 미래 예측을 행동 요구사항과의 연관성 없이 사용하고 있다. AI · 머신러닝 · HiFOR: Hierarchical Foresight with Action-Guided World Grounding for Vision-Language-Action Model
Key Point 로봇이 복잡한 작업을 수행할 때 단기 환경 변화와 장기 목표를 동시에 고려하는 방식이 어떻게 작동하는지 보여주는 새로운 기술 진전으로, 로봇 자동화 분야의 실제 구현 가능성을 높인다.
핵심 요약
로봇 조작 작업을 위한 Vision-Language-Action(VLA) 모델이 시각 인식, 언어 이해, 행동 생성을 통합해 성과를 내고 있으나, 기존 방법들은 단기 역학과 장기 목표를 따로 모델링하고 미래 예측을 행동 요구사항과의 연관성 없이 사용하고 있다. 이를 개선하기 위해 HiFOR은 계층적 미래 예측과 행동 유도 월드 검색을 결합한 프레임워크를 제안한다. 계층적 미래 예측은 단기 상태 변화, 의미론적 마일스톤, 최종 목표 상태를 계층적 의존성 마스크(HDM)를 통해 함께 예측해 시간축 간 의존성을 설정한다. 전체 요약 6문장 읽기 → 031 12:10 ▲ 108 · 댓글 19 극한 속도의 이미지 압축 포맷 Nibnib 공개 마이크로컨트롤러 DVI 출력을 위해 설계된 초고속 이미지 압축 포맷 Nibnib을 깃허브에 공개했다. 하드웨어 · 시스템 · Nibnib: Image compression with extreme decompression speed
Key Point 마이크로컨트롤러처럼 연산 자원이 제한된 환경에서 이미지 표시 속도를 극대화해야 하는 개발자에게 실용적인 선택지를 제공한다.
핵심 요약
마이크로컨트롤러 DVI 출력을 위해 설계된 초고속 이미지 압축 포맷 Nibnib을 깃허브에 공개했다. 팔레트 기반이지만 색상 델타를 저장해 절대값 대신 상대값을 사용함으로써 팔레트 이미지 품질을 능가한다. 2개 픽셀을 1바이트로 인코딩하는 4bpp 압축으로 극한의 속도를 달성하며, RP2350에서 6사이클당 픽셀 처리가 가능하다. 전체 요약 10문장 읽기 → 032 21:11 당일 +120 아날로그 사진 필름 시뮬레이션을 물리 기반으로 구현 스펙트럼 데이터를 기반으로 한 아날로그 필름 렌더링 시뮬레이션을 Python으로 구현한 오픈소스 프로젝트인 spektrafilm을 GitHub에 공개했다. 오픈소스 · 도구 · andreavolpato/spektrafilm · Python
Key Point 필름 시뮬레이션을 광학·화학 원리로부터 재구성한 방식이 기존 '필름 룩' 필터와 근본적으로 다르며, 컬러 그레이딩·VFX·사진 소프트웨어 개발자들에게 실측 기반의 참조 구현을 제공한다.
핵심 요약
스펙트럼 데이터를 기반으로 한 아날로그 필름 렌더링 시뮬레이션을 Python으로 구현한 오픈소스 프로젝트인 spektrafilm을 GitHub에 공개했다. 카메라 RAW 파일에서 시작해 가상의 네거티브를 거쳐 인화지와 스캔 파이프라인을 통과하도록 모델링했으며, 제조사 데이터시트에서 추출한 스펙트럼 감도와 밀도 곡선을 활용한다. 필름 유제에 함유된 커플러(couplers) 화학물질이 노출된 부분을 중심으로 인접 레이어의 색 간섭을 줄이고 채도를 높이는 효과를 구현했다. 전체 요약 8문장 읽기 → 033 12:11 ▲ 12 · 댓글 4 AI, 주식 투자 분석 벤치마크에서 실적 부진 금융 에이전트는 현재 시점의 정보만으로 투자 판단을 내려야 하며, 그 예측은 이후의 실제 결과로 평가받는다. AI · 머신러닝 · Investor's Last Exam: Can AI Agents Do Equity Investment Without Seeing the Future?
Key Point 최신 AI 모델들이 종합적 분석은 잘하지만 실제 투자 예측으로 이어지지 못한다는 구체적인 성과 격차를 드러내, AI 금융 분석 능력의 현주소를 파악할 수 있다.
핵심 요약
금융 에이전트는 현재 시점의 정보만으로 투자 판단을 내려야 하며, 그 예측은 이후의 실제 결과로 평가받는다. 기존 벤치마크는 금융 지식·분석 워크플로·예측 능력을 각각 평가했으나, 완전한 연구 프로세스를 평가하려면 정보가 고정된 상태와 전문가 평가 기준이 필요하다. ILE(Investor's Last Exam)는 경험 많은 펀드 매니저들이 주도한 주식 분석 벤치마크로, 342만 개 문서 버전과 9가지 소스를 담은 금융 데이터베이스, 시계열 타임스탬프가 적용된 시장 데이터, 전문가가 설계한 평가 기준을 포함한다. 전체 요약 6문장 읽기 → 034 18:11 ▲ 24 · 댓글 6 이미지 생성 Transformer의 효율성을 높이는 다중 슬롯 토크나이제이션 픽셀 공간 생성 Transformer는 이미지 패치마다 하나의 토큰을 사용하므로 세부 디테일을 캡처하려면 토큰 수가 증가해 전역 어텐션 비용이 커진다. AI · 머신러닝 · Read, Allocate, Route: Role-Coupled Tokenization for Pixel-Space Generative Transformers
Key Point 이미지 생성 모델의 전역 어텐션 비용과 생성 품질 간 트레이드오프를 주파수 대역 분리로 해결하는 새로운 접근으로, 적은 계산량에서 고품질 이미지를 생성할 수 있는 구조를 제시한다.
핵심 요약
픽셀 공간 생성 Transformer는 이미지 패치마다 하나의 토큰을 사용하므로 세부 디테일을 캡처하려면 토큰 수가 증가해 전역 어텐션 비용이 커진다. 저주파 구조는 전역 정보 교환이 필요하지만 고주파 디테일은 지역적으로만 모델링되면 되는 점에 착안해 SpecSlot을 제안했다. SpecSlot은 각 공간 앵커를 여러 슬롯으로 확장하고 각 슬롯에 서로 겹치지 않는 DCT 계수 대역을 할당한다. 전체 요약 8문장 읽기 → 035 12:11 ▲ 256 · 댓글 4 디퓨전 언어 모델의 강화학습을 위한 토큰 신용 할당 디퓨전 언어 모델(DLM)은 반복 제거(denoising)로 텍스트를 생성하며 양방향 문맥 모델링과 병렬 토큰 정제가 가능하다. AI · 머신러닝 · DTCA: Denoising Token Credit Assignment for Reinforcement Learning in Diffusion Language Models
Key Point 디퓨전 모델 기반 언어 모델에 강화학습을 효과적으로 적용하는 방식이 제시되었으며, 토큰별 신용 할당 문제를 해결함으로써 수학 추론 성능에서 실질적 개선을 보였다.
핵심 요약
디퓨전 언어 모델(DLM)은 반복 제거(denoising)로 텍스트를 생성하며 양방향 문맥 모델링과 병렬 토큰 정제가 가능하다. DLM에 강화학습을 적용하면 추론 성능이 개선되지만, 반복 제거 과정에서 토큰별 신용 할당이 어렵다는 문제가 있다. 제안된 DTCA(Denoising Token Credit Assignment) 프레임워크는 토큰 약속 후 남은 마스크 위치의 예측 신뢰도 개선으로 토큰 기여도를 추정한다. 전체 요약 6문장 읽기 → 036 03:11 ▲ 232 · 댓글 78 중세 석상 건축, CNC 기술로 되살리다 고딕 건축의 정교한 석조 세부 작업을 CNC 기계가 자동화하면서 수개월 걸리던 조각이 며칠 안에 완성되고 있다. 하드웨어 · 시스템 · CNC Stone Carving
Key Point 중세 건축 미학의 정교함을 현대 기술로 다시 구현할 수 있게 되었으며, 컴퓨터 세대가 전통 기술의 고급 수준으로 진입하는 새로운 경로가 열렸다.
핵심 요약
고딕 건축의 정교한 석조 세부 작업을 CNC 기계가 자동화하면서 수개월 걸리던 조각이 며칠 안에 완성되고 있다. CNC는 '컴퓨터 수치 제어' 방식으로 XYZ 좌표를 통해 기계 움직임을 제어하며, 다이아몬드 팁 블레이드로 석재를 깎아낸다. 석상 조각용 CNC는 보통 5개 축을 가져 좌우·상하·전후 이동과 2가지 방향 회전이 가능하며, 6번째 축으로 선반을 더하기도 한다. 전체 요약 11문장 읽기 → 037 12:11 ▲ 15 · 댓글 2 특허 심사 자동화하는 AI 에이전트 벤치마크 공개 특허 심사는 선행기술 발굴, 질의 개선, 증거 검토, 심사의견서 작성을 반복하는 복잡한 과제인데 기존 벤치마크는 정적이고 제한된 후보군만 다뤘다. AI · 머신러닝 · Novel or Not? PatEx-Gym: Agentic Prior-Art Search for Novelty Assessment in Patent Examination
Key Point 특허 심사 자동화는 방대한 기술 문헌 검색과 복합적 추론이 필요한 영역으로, 이 벤치마크는 에이전트 기술의 실제 활용 가능성을 보여주는 현실적 테스트 사례가 된다.
핵심 요약
특허 심사는 선행기술 발굴, 질의 개선, 증거 검토, 심사의견서 작성을 반복하는 복잡한 과제인데 기존 벤치마크는 정적이고 제한된 후보군만 다뤘다. 연구진이 특허 심사 에이전트 개발·평가를 위한 첫 번째 프레임워크 PatEx-Gym을 발표했다. PatEx-Bench는 1000개의 실제 심사 과제, 100만 개 이상의 특허와 5만2000개 과학 논문 데이터베이스, 반복 검색과 문서 방문·추론·심사의견서 생성을 지원하는 런타임을 제공한다. 전체 요약 7문장 읽기 → 038 15:11 ▲ 28 · 댓글 2 에이전트의 변화하는 도구에 대한 적응력을 평가하는 벤치마크 공개 AI 에이전트가 진화하는 도구 생태계에 얼마나 잘 적응하는지 평가하기 위해 Δτ-Bench라는 실행 가능한 벤치마크를 소개했다. AI · 머신러닝 · Δτ-Bench: Pushing Agents Toward a Moving Capability
Key Point LLM 기반 에이전트가 실무 환경에서 마주하는 도구 변화에 얼마나 적응할 수 있는지 보여주는 새로운 평가 기준으로, 기존 벤치마크의 한계를 직접 드러내고 해결책을 제시했기 때문이다.
핵심 요약
AI 에이전트가 진화하는 도구 생태계에 얼마나 잘 적응하는지 평가하기 위해 Δτ-Bench라는 실행 가능한 벤치마크를 소개했다. 이 벤치마크는 1,588개의 검증된 멀티턴 작업과 42개 도메인, 6개의 연속적인 생태계 상태를 포함하며, 도구가 사라지거나 교체되고 더 효율적인 대안이 등장하는 현실을 모델링한다. 기존 벤치마크는 에이전트가 효율적인 도구 사용 경로를 주동적으로 발견하고 축적된 절차적 지식을 신속하게 수정할 수 있는지 검사하지 않는다. 전체 요약 6문장 읽기 → 039 09:11 ▲ 101 · 댓글 56 추상화의 천재 폰노이만, 20세기를 설계하다 1903년 헝가리 태생 수학자 존 폰노이만(1903-1957, 53세)은 집합론, 양자역학 수학적 기초, 게임 이론, 최초의 저장형 프로그램 컴퓨터 구조, 수치 기상 예보, 자기복제 오토마타 등 근 20개 분야를 개척했고, 모든 현대 컴퓨터는 그가 1945년 설계한 폰노이만 구조(명령어와 데이터를 한 메모리에 저장)를 따른다. AI · 머신러닝 · A Man from the Future: Why Johnny Can't Stop Abstracting
Key Point 추상화를 통해 20세기 과학과 컴퓨팅을 동시에 건설한 폰노이만의 사고 방식이 오늘날 AI·기후·핵 위협을 마주한 우리에게 무엇을 말하는지 보여주기 때문이다.
핵심 요약
1903년 헝가리 태생 수학자 존 폰노이만(1903-1957, 53세)은 집합론, 양자역학 수학적 기초, 게임 이론, 최초의 저장형 프로그램 컴퓨터 구조, 수치 기상 예보, 자기복제 오토마타 등 근 20개 분야를 개척했고, 모든 현대 컴퓨터는 그가 1945년 설계한 폰노이만 구조(명령어와 데이터를 한 메모리에 저장)를 따른다. 6세에 8자리 수를 암산으로 나누고 고대 그리스어로 대화했으며, 한 번 읽은 책은 모두 기억했다는 평판이 있었다. 아버지 막시는 저녁 식탁을 세미나처럼 운영해 가족이 철학·역사·정치 등 폭넓은 주제를 토론하게 했고, 여러 언어 능력은 미래 망명을 대비한 아버지의 의도였다. 헝가리 고등학교 수학 교사 라슬로 라츠는 그를 가르칠 수 없다고 판단해 스탠포드 수학과장이 될 가보르 세게를 개인교사로 붙였다. 세게는 첫 수업 후 울면서 학생의 능력에 압도당했다고 전했다. 전체 요약 14문장 읽기 → 040 03:12 ▲ 16 · 댓글 3 흐름 매칭으로 음악 분리하는 생성형 모델 FLOMSS 음악 소스 분리(MSS)는 보컬, 베이스, 드럼, 기타 등 네 가지 신호원을 분리하는 작업이며, 전통적으로 판별적 방식으로 처리되어 왔다. AI · 머신러닝 · FLOMSS: Generative Music Source Separation by Flow Matching
Key Point 음악 분리라는 오디오 처리의 핵심 작업에 생성형 AI 패러다임(flow matching)을 적용한 사례로, 판별적 방식 중심의 기존 접근을 재검토하고 성능을 검증한 결과물이다.
핵심 요약
음악 소스 분리(MSS)는 보컬, 베이스, 드럼, 기타 등 네 가지 신호원을 분리하는 작업이며, 전통적으로 판별적 방식으로 처리되어 왔다. flow matching은 복잡한 데이터 분포를 모델링하는 생성형 패러다임으로 여러 분야에서 성공 사례가 나오고 있어 음악 분리에 적용할 가치가 있다. 연구팀은 flow matching을 음악 분리에 적용하면서 예측 대상(prediction targets), 흐름 경로(flow paths), 단일 소스 대 다중 소스 모델링, 혼합 일관성 제약 등을 체계적으로 조사했다. 전체 요약 5문장 읽기 → 041 21:12 ▲ 298 · 댓글 2 비디오 기초 모델부터 세계 모델까지, 영상 이해와 생성의 통합 관점 비디오 기초 모델은 시각 시퀀스의 이해와 생성에 급속히 발전해온 반면, 비디오 세계 모델은 그 속 세계의 동역학을 포착하려 한다. AI · 머신러닝 · Reading, Writing, Sharing, and Interacting with the World through Video
Key Point 비디오 이해와 생성의 현주소를 통합적으로 정리한 메타 서베이로, 향후 연구의 방향성이 '보이는 것'에서 '일어나는 일'의 타당성으로 전환되고 있음을 보여준다.
핵심 요약
비디오 기초 모델은 시각 시퀀스의 이해와 생성에 급속히 발전해온 반면, 비디오 세계 모델은 그 속 세계의 동역학을 포착하려 한다. 이 논문은 세계 모델링을 통합 렌즈로 삼아 두 분야를 함께 조망한다. 관찰된 비디오를 잠재된 시간적 세계의 부분적·손실적·시간순 투영으로 보고, 네 가지 보완적 작업으로 문헌을 정리한다: reading은 비디오에서 세계 성질을 추론하고, writing은 지정되거나 학습된 세계 조건에서 비디오를 생성하며, sharing은 공통 모델링 메커니즘을 통해 이해와 생성을 통합하고, interacting은 행동과 진화하는 관찰 아래서 세계 상태를 예측하고 업데이트한다. 전체 요약 5문장 읽기 → 042 18:11 ▲ 102 · 댓글 37 셀프-어텐션 없이 언어모델 성능 낼 수 있을까 논문은 시퀀스 모델링에서 셀프-어텐션이 반드시 필요한지 근본적으로 재검토한다. AI · 머신러닝 · Attention Is Not What You Need (2025)
Key Point 트랜스포머 아키텍처의 핵심인 어텐션 메커니즘 자체를 대체하는 기하학적 모델을 제시하며, 같은 성능을 유지하면서 더 해석 가능한 설계가 가능함을 시사한다.
핵심 요약
논문은 시퀀스 모델링에서 셀프-어텐션이 반드시 필요한지 근본적으로 재검토한다. 기존 멀티헤드 어텐션을 숨은 벡터들을 고차원 공간으로 끌어올리는 텐서 lifting 메커니즘으로 해석하되, 이는 수학적으로 불명확하고 여러 층을 거치면서 명시적 불변량으로 기술하기 어렵다고 주장한다. 대안으로 그래스만 다양체 기반 구조를 제안하며, 인과 그래스만 층은 토큰 상태를 선형 축약한 뒤 플뤼커 좌표로 인코딩된 저차수 부분공간의 제어된 변형을 통해 정보를 전파한다. 전체 요약 6문장 읽기 → 043 12:11 ▲ 13 · 댓글 3 AI가 손으로 조립하는 레고, 물리 타당성 100% 달성 코딩 AI 에이전트는 3D 모델링 능력은 높지만, 실제 조립 가능한 구조를 만드는 데는 어려움을 겪고 있다: 부품이 떠 있거나 충돌하거나 연결되지 않은 잘못된 조립체를 생성한다. AI · 머신러닝 · BrickWright: Agentic Creation of Physically Feasible Brick Builds
Key Point AI가 생성한 3D 구조의 '실제 조립 가능성'을 검증하는 새로운 접근법이 100% 성공률을 달성했으며, 로봇 공학·제조업·디지털 설계 도구의 신뢰성 표준을 높인다.
핵심 요약
코딩 AI 에이전트는 3D 모델링 능력은 높지만, 실제 조립 가능한 구조를 만드는 데는 어려움을 겪고 있다: 부품이 떠 있거나 충돌하거나 연결되지 않은 잘못된 조립체를 생성한다. BrickWright는 조립 도구와 물리 타당성 검증 기능을 제공해 AI가 텍스트나 이미지 지시에서 실제 조립 가능한 레고 구조를 생성하도록 안내하는 프레임워크다. BrickLayer라는 Python 툴킷이 핵심이며, 두 부분으로 구성된다: 사용하기 쉬운 레고 조립 API(원본 LDraw 형식 대비 추론 비용 절반)와 물리 타당성 피드백을 주는 검증기다. 전체 요약 5문장 읽기 → 044 03:11 ▲ 19 · 댓글 2 동영상에서 객체 관계 변화를 추적하는 RTAformer 논문 공개 동영상 장면 그래프 생성(VidSGG)은 프레임 간 객체의 정체성 지속성과 관계의 급격한 변화를 동시에 포착해야 하는 과제를 다룬다. AI · 머신러닝 · RTAformer: Relation-Transition-Aware Transformer for Video Scene Graph Generation
Key Point 동영상에서 객체의 관계가 변하는 순간을 정확히 포착하는 것이 어려운 이유와 이를 해결하기 위한 구체적 기술 혁신을 담고 있어서다.
핵심 요약
동영상 장면 그래프 생성(VidSGG)은 프레임 간 객체의 정체성 지속성과 관계의 급격한 변화를 동시에 포착해야 하는 과제를 다룬다. 기존 방식은 시간 맥락을 활용하기 위해 프레임 간 정보를 통합하지만, 일관성을 강조하다 보니 관계 변화를 놓치는 '관계적 의미 관성(relational semantic inertia)' 문제가 발생한다. 연구팀이 제안한 RTAformer는 개체 지속성과 관계 변화를 따로 모델링하는 원스테이지 프레임워크다. 전체 요약 5문장 읽기 → 045 03:11 ▲ 214 · 댓글 114 키미, 백만 토큰 컨텍스트의 K3.1 Pro 공개 키미가 K3.1 Pro와 2~3배 빠른 K3.1 Pro Highspeed를 공개했으며, 100만 토큰 컨텍스트 윈도우를 지원하는 오픈웨이트 모델이다. AI · 머신러닝 · Kimi K3.1 Pro and K3.1 Pro Highspeed
Key Point 오픈웨이트 대규모 언어 모델이 코딩부터 금융 분석까지 여러 분야에서 프로프라이어터리 모델과 경쟁하는 수준에 도달했으며, 사이버보안 능력을 의도적으로 제어하면서 공개하는 오픈 모델의 윤리적 방향성을 보여준다.
핵심 요약
키미가 K3.1 Pro와 2~3배 빠른 K3.1 Pro Highspeed를 공개했으며, 100만 토큰 컨텍스트 윈도우를 지원하는 오픈웨이트 모델이다. 모델은 키미 K3의 포스트 트레이닝 버전으로, 수백 개 다운스트림 도메인 전체에서 대규모 강화학습을 통해 모든 계층을 최적화했다. 코딩 벤치마크에서 K3.1 Pro는 Terminal-Bench 4.0에서 65.7%로 GPT-6 Astra(58.2%)를 상회하고 Claude Opus 5.5(66.4%)와 유사한 성능을 보인다. 전체 요약 12문장 읽기 → 046 21:11 ▲ 12 · 댓글 2 합창 오디오를 성부별로 자동 기록하는 AI 모델 등장 기존 합창 자동 악보 기록(AMT) 시스템은 소프라노·알토·테너·베이스(SATB) 성부를 구분하지 못하고 하나의 음표 트랙으로 병합했는데, 이는 악보 복원과 성악 교육을 어렵게 만들었다. AI · 머신러닝 · Toward Part-Aware Choral Transcription with singing voice assignment
Key Point 합창 악보를 성부별로 정확히 기록할 수 있게 되면 학생 악단 연습, 악보 출판, 원곡 복원 등이 더 효율적으로 가능해진다.
핵심 요약
기존 합창 자동 악보 기록(AMT) 시스템은 소프라노·알토·테너·베이스(SATB) 성부를 구분하지 못하고 하나의 음표 트랙으로 병합했는데, 이는 악보 복원과 성악 교육을 어렵게 만들었다. 새로운 'PawCT' 모델은 합창 오디오를 입력받아 활성화된 SATB 성부를 먼저 식별한 뒤, 각 성부를 별도의 음표 레벨 트랙으로 자동 기록한다. 성부별 음의 시작·종료·유지 시점 예측과 성부 포함 여부 추정을 함께 진행하며, SATB 음역대 사전 정보(RP)와 성부 내 선율 연속성·성부 간 음정 순서를 반영하는 확장 기법(OC)을 적용한다. 전체 요약 6문장 읽기 → 047 03:11 ▲ 22 · 댓글 1 로봇 조작에 코드 기반 계획을 결합한 새로운 AI 모델 기존 세계 행동 모델(WAM)은 로봇 조작을 위한 시각적 예측은 제공하지만 기술을 재사용할 수 있는 명시적 메커니즘이 부족했다. AI · 머신러닝 · Agentic World Action Models
Key Point 로봇 조작 AI에서 시각 예측과 코드 기반 계획의 gap을 처음으로 메운 모델이며, 재사용 가능한 기술 라이브러리와 자동 학습 파이프라인을 제시해 실제 로봇 시스템의 확장성을 높일 수 있는 방법을 제안한다.
핵심 요약
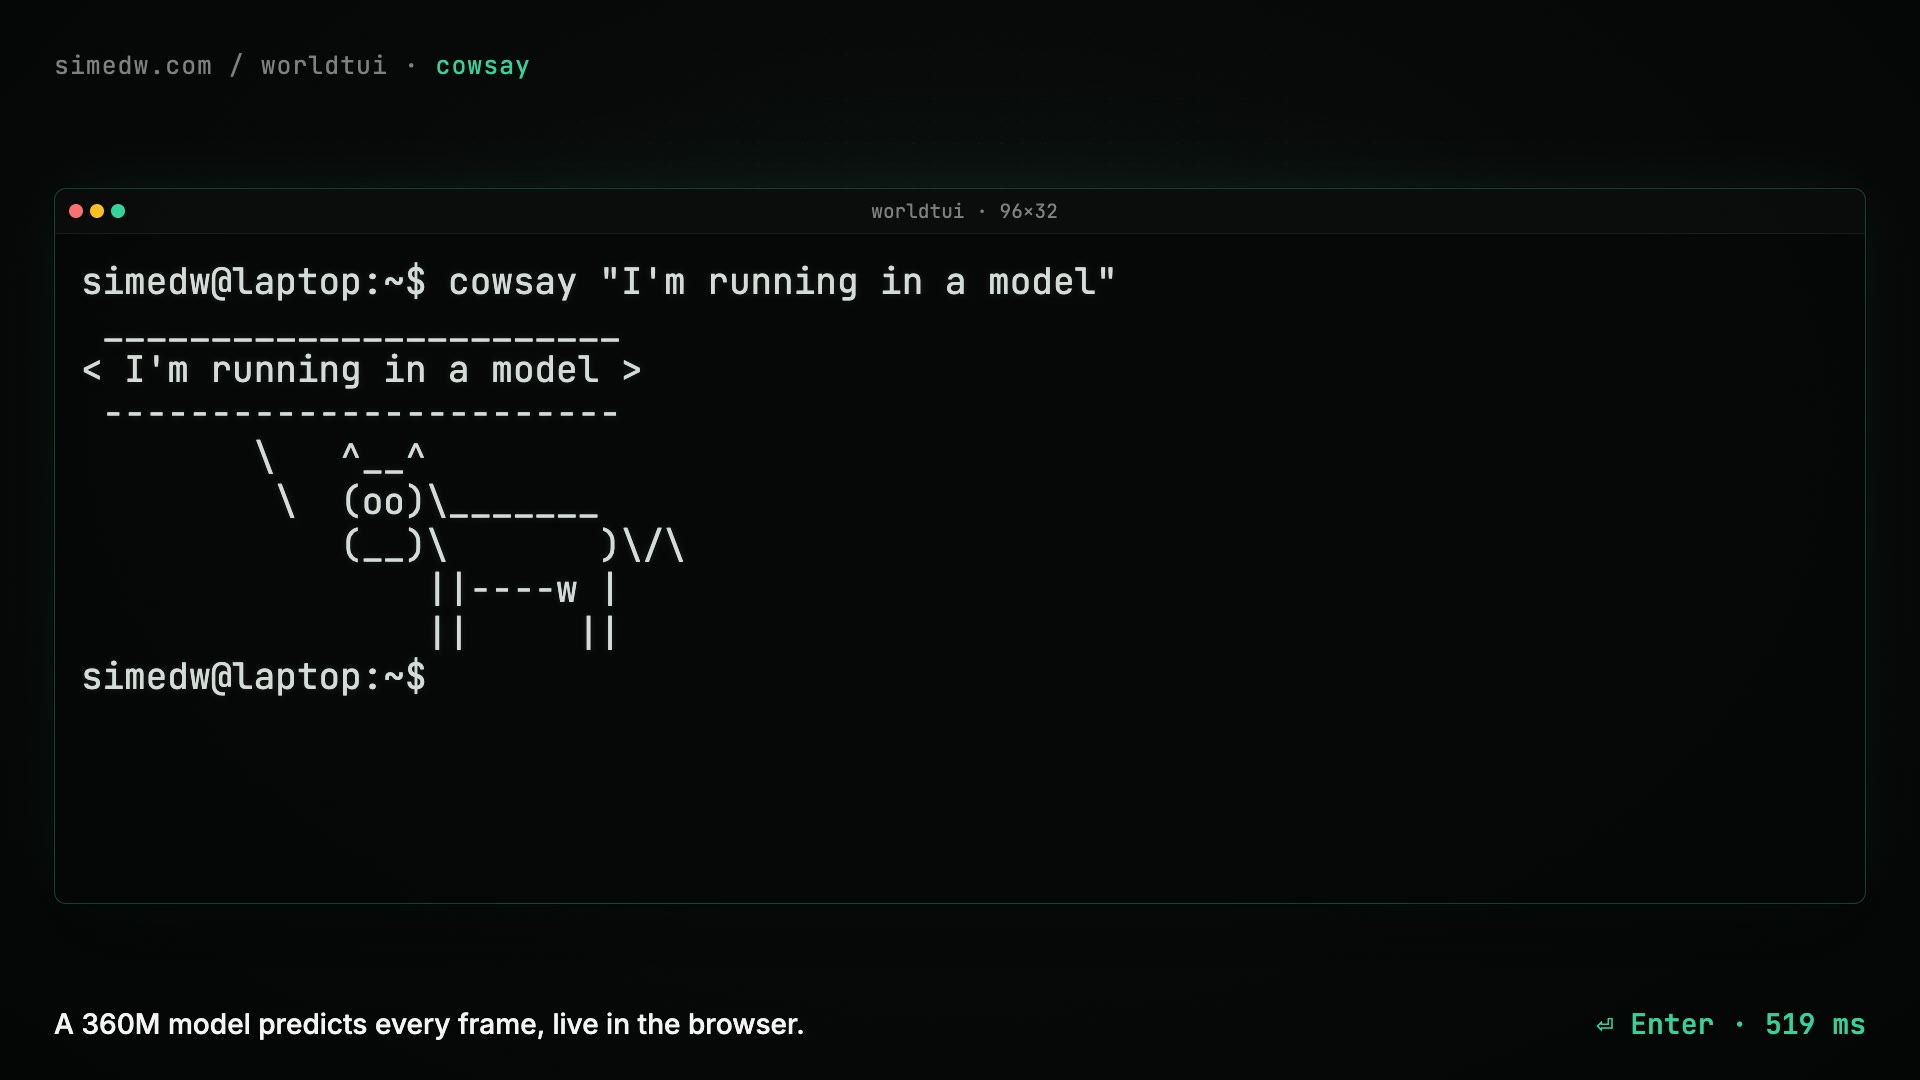
기존 세계 행동 모델(WAM)은 로봇 조작을 위한 시각적 예측은 제공하지만 기술을 재사용할 수 있는 명시적 메커니즘이 부족했다. 코드 기반 계획 로봇공학은 재사용 가능한 기술을 제공하지만 물리 역학의 예측 기반이 약해 현실과의 연결 고리가 약했다. 이를 해결하기 위해 AW-0이라는 에이전트형 세계 행동 모델을 제시했으며, 코드 기반 계획을 영상·행동 예측과 통합한다. 전체 요약 9문장 읽기 → 048 18:11 ▲ 169 · 댓글 53 360M 모델로 터미널 에뮬레이터 만들기 360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. AI · 머신러닝 · WorldTUI: I trained a 360M model to pretend to be a terminal
Key Point 시뮬레이션·에뮬레이션 구현 없이 자가 수정 학습과 병렬 디코딩으로 소형 모델을 브라우저에서 구동 가능한 터미널 에뮬레이터로 만든 기술 구현 사례로, 제약된 환경에서 큰 모델의 능력을 소형화하는 방법을 보여준다.
핵심 요약
360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. 파일 생성, vim과 tmux 실행, 스네이크 게임 등이 가능하고, 자신의 실수를 수정하는 능력과 행(row)을 병렬로 디코딩하는 기술로 성능을 크게 개선했다. 터미널을 문자 그리드로 모델링했으며, Qwen2.5-Coder-0.5B를 기반으로 Docker에서 실제 프로그램 실행 기록으로 파인튜닝했다. 전체 요약 14문장 읽기 → 049 15:11 ▲ 34 · 댓글 2 AI 연구팀이 선형 주의 구조 자동 발견 자율 에이전트를 활용해 과학 발견을 가속화하기 위해 서로 다른 전문성을 갖춘 AI 연구자 팀을 구성하는 방법을 제안했다. AI · 머신러닝 · Building AI Research Teams for Autonomous Discovery of Linear Attention Architectures
Key Point 다양한 전문성과 기억을 갖춘 AI 팀의 협력 구조가 자동화된 과학 발견에서 얼마나 중요한지 보여주는 결과로, 향후 AI 연구 자동화 시스템 설계의 기준을 제시한다.
핵심 요약
자율 에이전트를 활용해 과학 발견을 가속화하기 위해 서로 다른 전문성을 갖춘 AI 연구자 팀을 구성하는 방법을 제안했다. 실험 비용이 높을 때 제한된 실험 예산 내에서 탐색과 활용의 균형을 맞추기 위해 적응형 할당 방식을 도입했다. 각 AI 연구자가 서로 다른 학문 배경을 가지고 개인 연구 기록을 유지하면서 공유된 실험 증거를 바탕으로 협력하는 구조를 설계했다. 전체 요약 6문장 읽기 → 050 15:11 ▲ 158 · 댓글 2 자동회귀 동영상 생성에 미래 청크 예측 더하기 자동회귀 비디오 확산 모델은 청크 단위로 영상을 생성하는데, 단순히 시각적 연속성만으로 플러시블한 결과물을 만드는 것이 장면의 시간적 진화를 제대로 모델링하는 것은 아니다. AI · 머신러닝 · Looking Ahead: Modeling Future Evolution in Autoregressive Video Generation
Key Point 자동회귀 비디오 생성에서 시간적 진화를 제대로 모델링하는 훈련 기법이 기존 방식보다 적은 계산량으로 물리적 타당성을 높이는 방법을 제시했다.
핵심 요약
자동회귀 비디오 확산 모델은 청크 단위로 영상을 생성하는데, 단순히 시각적 연속성만으로 플러시블한 결과물을 만드는 것이 장면의 시간적 진화를 제대로 모델링하는 것은 아니다. 교사 강제(teacher forcing) 훈련에서 강한 시간적 중복성이 로컬 시각 연속성을 지름길 삼아 실제 시각 진화 모델링 압력을 감소시킨다. 연구팀은 Future Chunk Prediction(FCP)라는 보조 목표함수를 제시했으며, 이는 교사 강제 디노이징과 함께 학습된다. 전체 요약 7문장 읽기 → 051 12:11 ▲ 36 · 댓글 2 AI 에이전트의 지속 학습을 위한 메모리 중심 프레임워크 기초 모델 기반 자율 에이전트는 추론·계획·도구 사용은 가능하지만 고정된 가중치와 컨텍스트 제한으로 장기 배포 중 경험 학습이 제약된다. AI · 머신러닝 · Memory-Centric Continual Learning for AI Agents
Key Point AI 에이전트가 장기 배포 중 경험으로부터 실제 학습하려면 메모리 평가 기준부터 바뀌어야 한다는 근본적인 전환을 제시한다.
핵심 요약
기초 모델 기반 자율 에이전트는 추론·계획·도구 사용은 가능하지만 고정된 가중치와 컨텍스트 제한으로 장기 배포 중 경험 학습이 제약된다. 외부 메모리 시스템은 대부분 수동적 검색 캐시 역할만 하며 저장된 사실이나 과거 상호작용 회상 여부만 평가되고 있다. 메모리가 진정한 지속 학습을 가능하게 하는지는 미해결 과제다. 전체 요약 8문장 읽기 → 052 03:11 ▲ 12 · 댓글 2 효율적인 흐름 모델로 LLM 병렬 생성 실현 연속 흐름 언어 모델(continuous flow language model)은 이산 확산 모델에 없는 병렬 생성, 제어, 가속 기능을 제공한다. AI · 머신러닝 · Large Flow Language Models
Key Point 병렬 생성과 더 빠른 추론이 가능한 흐름 모델이 대규모 언어 모델에서 실질적으로 작동하는 것을 처음 입증했으며, 기존 자동회귀 모델보다 2.5배 빠른 처리 속도로 같은 품질을 낸다는 점이 생성 AI 구조의 근본적 전환을 시사한다.
핵심 요약
연속 흐름 언어 모델(continuous flow language model)은 이산 확산 모델에 없는 병렬 생성, 제어, 가속 기능을 제공한다. 라파(Lafa)는 80억 개 매개변수 규모의 흐름 언어 모델로, 30B 토큰 미만으로 학습되어 이전 확산 모델보다 효율적이다. 블록 단위 흐름 모델 설계로 접두사에는 인과 관계 어텐션, 각 블록 내에는 양방향 비동기 흐름을 적용한다. 전체 요약 10문장 읽기 → 053 15:11 ▲ 141 · 댓글 2 인간·로봇 동작 예측 통합 모델 'Ropedia W0' 공개 세계 모델을 통해 구체화된 에이전트(로봇·인간)의 행동 결과를 예측할 수 있는데, 다양한 체형의 이동과 조작을 동시에 모델링하기는 어려웠다. AI · 머신러닝 · Ropedia W0: Scaling Loco-Manipulation World Models across Embodiments with Human Experience
Key Point 인간의 움직임 데이터로 학습한 로봇 제어 모델이 현실에서 어떻게 작동할지를 보여주는 기초 연구로, 로봇 에이전트의 자율성 향상에 필요한 예측 능력의 스케일링 가능성을 제시한다.
핵심 요약
세계 모델을 통해 구체화된 에이전트(로봇·인간)의 행동 결과를 예측할 수 있는데, 다양한 체형의 이동과 조작을 동시에 모델링하기는 어려웠다. Ropedia W0은 인간과 로봇을 아우르는 첫 자아중심형 이동·조작 월드 파운데이션 모델로, 10,000시간의 인간 시점 영상과 3,000시간의 로봇 데이터(통합 멀티모달 주석 및 품질 관리 포함)로 구성된 Xp-Data를 수집했다. 이동은 카메라 포즈로, 조작은 투영된 골격으로 인코딩하는 통합 운동학 표현을 사용하며, 로봇 골격은 체형별 순기구학과 광범위한 수동 키포인트 주석·수정을 결합한다. 전체 요약 8문장 읽기 → 054 21:11 ▲ 23 · 댓글 2 AI가 실사진으로 3D 모델 만드는 능력을 재보다 멀티모달 LLM이 자율 에이전트로 작동하며 코드나 소프트웨어 조작을 통해 3D 모델을 생성·편집할 수 있게 되면서, 실제 워크플로우에서 참고 자료로부터 물체 형상·재질·공간 배치·조명을 추론하고 지시를 따라 3D 콘텐츠를 재구성·수정·설계해야 한다. AI · 머신러닝 · BlenderWorld: Benchmarking Visual Agents for 3D Creation from Real-World References
Key Point LLM 기반 AI 에이전트가 3D 모델링 작업을 수행할 수 있게 되면서, 실무 수준의 성능 평가 기준이 필요해졌고, 이 벤치마크가 현재 모델들의 공간 추론 능력의 한계를 명확히 드러낸다.
핵심 요약
멀티모달 LLM이 자율 에이전트로 작동하며 코드나 소프트웨어 조작을 통해 3D 모델을 생성·편집할 수 있게 되면서, 실제 워크플로우에서 참고 자료로부터 물체 형상·재질·공간 배치·조명을 추론하고 지시를 따라 3D 콘텐츠를 재구성·수정·설계해야 한다. 기존 벤치마크는 현실 시나리오에 걸친 열린 형태의 요청을 제한적으로 다루고 있어, 이 간극을 메우기 위해 BlenderWorld 벤치마크를 개발했다. BlenderWorld는 건축·제품·자연환경·과학 시각화 분야의 223개 과제로 구성되며, 텍스트·이미지·비디오·구조화된 명세서를 입력으로 받는다. 전체 요약 6문장 읽기 → 055 18:11 ▲ 28 · 댓글 2 메모리 간섭 줄인 선형 어텐션, 장문맥 모델링에 강하다 KronLSTM이라는 새로운 선형 어텐션 아키텍처를 제안했으며, 크로네커 델타 규칙이라는 연관 행렬 메모리의 신규 업데이트 규칙을 기반으로 한다. AI · 머신러닝 · Kronecker Delta Rule for Long Context Linear Attention
Key Point 메모리 간섭을 크게 줄이면서 안정성까지 갖춘 선형 어텐션이 장문맥 모델링 성능에서 기존 방식을 앞서면서, 대형 언어모델의 효율적인 장문맥 처리 방식이 진화하고 있음을 보여준다.
핵심 요약
KronLSTM이라는 새로운 선형 어텐션 아키텍처를 제안했으며, 크로네커 델타 규칙이라는 연관 행렬 메모리의 신규 업데이트 규칙을 기반으로 한다. xLSTM 계열을 확장해 메모리 수정 메커니즘을 추가했으며, 특정 연관성을 정정하면서도 행렬 공간의 단일 방향으로만 메모리를 변경한다. 이러한 최소한의 침습적 메모리 수정 방식은 기존 델타 규칙 업데이트 대비 이전에 저장된 정보와의 간섭을 줄여 장문맥 언어 모델링에 적합하다. 전체 요약 8문장 읽기 → 056 15:11 ▲ 161 · 댓글 2 1인칭 영상에서 손·물체·공간을 동시에 복원하는 모델 공개 1인칭 시점 영상에서 카메라 움직임, 주변 기하학, 손-물체 상호작용을 일관성 있게 복원하려면 개별 3D 요소들이 함께 정렬되어야 하는데, 기존 방법과 데이터셋은 이를 충분히 지원하지 못하고 있다. AI · 머신러닝 · EgoXperience: Learning World-Grounded Egocentric Representations from Human Experience
Key Point 손과 물체, 카메라와 장면을 동시에 일관성 있게 복원하는 것은 1인칭 AR, 로봇 조작, 활동 인식 등 여러 분야의 핵심 과제인데, 이 논문이 기존보다 훨씬 큰 규모의 정렬된 데이터셋과 상당히 개선된 모델을 공개했기 때문이다.
핵심 요약
1인칭 시점 영상에서 카메라 움직임, 주변 기하학, 손-물체 상호작용을 일관성 있게 복원하려면 개별 3D 요소들이 함께 정렬되어야 하는데, 기존 방법과 데이터셋은 이를 충분히 지원하지 못하고 있다. EgoXperience는 데이터 수집, 자동 주석, 통합 모델링, 벤치마킹을 통해 이 문제를 해결하는 전체 스택 패러다임을 제시한다. 핵심 도구인 EgoX-Engine은 기하학적으로 검증된 물체 추적과 SLAM 기반 월드 정렬을 결합하여 카메라, 장면, 손, 물체에 대한 일관성 있는 감독 신호를 생성한다. 전체 요약 6문장 읽기 → 057 18:11 ▲ 73 · 댓글 4 영상 생성 지연 시간 없이 고품질 모델 쓰는 법 인터랙티브 영상 생성은 응답 지연을 줄이기 위해 작은 양방향 청크를 사용해왔으나, 더 큰 청크가 영상 품질을 높이고 GPU 병렬성을 더 잘 활용하면서도 샘플링 시간은 소폭만 증가함을 발견했다. AI · 머신러닝 · Speculative Sampling in Interactive Video Generation
Key Point 실시간 영상 생성의 지연 시간과 품질 사이의 근본적 트레이드오프를 해소하는 기법으로, 스트리밍 기반 영상 생성 시스템의 아키텍처를 재설계한다.
핵심 요약
인터랙티브 영상 생성은 응답 지연을 줄이기 위해 작은 양방향 청크를 사용해왔으나, 더 큰 청크가 영상 품질을 높이고 GPU 병렬성을 더 잘 활용하면서도 샘플링 시간은 소폭만 증가함을 발견했다. Speculative Sampling 기법을 제안하는데, 이는 큰 양방향 윈도우의 모델링 능력과 작은 윈도우의 저지연 상호작용을 결합한다. 노이즈 래턴트를 패딩으로 추가해 모델링 윈도우를 확장하고, 조건이 바뀌지 않으면 예측 결과를 캐시해 재사용한다. 전체 요약 7문장 읽기 → 058 09:11 ▲ 132 · 댓글 22 Commodore 64를 핀 단위로 시뮬레이션하는 하드웨어 시뮬레이터 공개 antirez가 Commodore 64 ASSY 250407 마더보드를 핀 단위로 시뮬레이션하는 프로그램 c64-hw-sim을 GitHub에 공개했다. 오픈소스 · 도구 · The Commodore 64 hardware simulator: break chips and pins, see the results
Key Point 실제 칩을 제거하거나 손상시킬 위험 없이 고장난 Commodore 64의 원인을 하드웨어 수준에서 진단하고 탐구할 수 있는 오픈소스 도구가 공개되었다.
핵심 요약
antirez가 Commodore 64 ASSY 250407 마더보드를 핀 단위로 시뮬레이션하는 프로그램 c64-hw-sim을 GitHub에 공개했다. 칩의 다리를 들어올리거나 그라운드/+5V에 단락시키거나, 칩을 소켓에서 빼거나, 저항을 개방할 수 있으며 그 결과를 모니터, 키보드, 보드의 모든 신호로 확인할 수 있다. 프로그램은 PCB의 전기 연결(네트리스트)과 각 칩의 핀 동작을 알고 있으며, 손상된 부품을 시뮬레이션하면 화면의 잡음도 회로 계산에서 나온 것이다. 전체 요약 14문장 읽기 → 059 12:11 ▲ 106 · 댓글 2 희소 자동인코더 표현이 얼마나 합성적인지 검증 희소 자동인코더(SAE)는 신경망 활성화를 희소한 선형 디코딩 특성으로 표현하지만, 이들 특성이 하위 계산에서 덧셈적으로 합성되는지는 불명확했다. AI · 머신러닝 · Behavioral Compositionality of Sparse Autoencoder Representations
Key Point SAE 특성이 실제로 신경망 행동을 독립적으로 설명하는지가 오랫동안 미해결 문제였는데, 이 논문이 정량적 측정 방법과 한계를 처음 체계적으로 보여줌으로써 해석가능 AI 연구의 방향을 제시한다.
핵심 요약
희소 자동인코더(SAE)는 신경망 활성화를 희소한 선형 디코딩 특성으로 표현하지만, 이들 특성이 하위 계산에서 덧셈적으로 합성되는지는 불명확했다. 연구팀은 SAE Additivity Residuals(SAR)를 도입해 설명되지 않은 행동 변이를 상호작용 차수별로 측정하며, 모집단 SAR은 정확히 그 차수 이상의 상호작용 에너지 정규화값이다. 학습된 SAE 좌표와 같은 부분공간의 합 보존 무작위 회전을 비교하면, 18개의 모델과 행동 설정 모두에서 학습된 좌표가 더 낮은 1차 잔차를 보인다. 전체 요약 6문장 읽기 → 060 21:11 ▲ 40 · 댓글 3 로봇 학습에서 세계 모델과 행동 예측이 서로 강화할 수 있을까 세계 모델링(영상의 미래 예측)과 행동 모델링(정책 학습)의 상호작용을 조사하는 OneWM 프레임워크를 제안한다. AI · 머신러닝 · Can World and Action Modeling Benefit Each Other under Unified Causal Training?
Key Point 로봇의 행동 학습과 환경 이해 모델을 같은 구조에서 동시에 훈련할 때 둘이 서로 강화하는 효과가 있는지를 첫 체계적으로 검증한 결과로, 로봇 학습의 효율성을 높일 새로운 방법론을 제시한다.
핵심 요약
세계 모델링(영상의 미래 예측)과 행동 모델링(정책 학습)의 상호작용을 조사하는 OneWM 프레임워크를 제안한다. 통합된 인과 학습 구조 하에서 행동을 세계 예측의 조건과 정책 학습의 목표로 동시에 취급한다. 지정된 행동이 주어졌을 때 그 시각적 결과를 예측하는 학습이 정책 성능과 일반화를 개선하는지 검증했다. 전체 요약 8문장 읽기 → 061 18:11 ▲ 32 · 댓글 2 생성형 시뮬레이션의 규칙 검증, 이제 점수로 판단한다 기존 생성형 이미지 검증자는 True/False만 판단했지만, OmniVerifier-C1은 복잡한 프롬프트와 환경 규칙을 세부 요소로 분해해 각각 점수를 부여하는 방식으로 더 정보량 많은 피드백을 제공한다. AI · 머신러닝 · OmniVerifier-C1: Decomposed Graded Verifier for Rule-Governed Generative World Modeling
Key Point 생성형 AI 시스템이 복잡한 규칙을 따르며 작동하는 세계 시뮬레이션으로 나아가려면, 이진 판정을 넘어 세밀한 점수 기반 검증이 필수적임을 보여준다.
핵심 요약
기존 생성형 이미지 검증자는 True/False만 판단했지만, OmniVerifier-C1은 복잡한 프롬프트와 환경 규칙을 세부 요소로 분해해 각각 점수를 부여하는 방식으로 더 정보량 많은 피드백을 제공한다. 이 구조화된 해석 가능한 출력은 검증자의 도메인 외 멀티모달 작업으로의 일반화 성능을 높인다. Decoupled RL 학습 전략으로 하위 질문 수준의 이진 판단과 전역 정렬 점수를 동시 최적화하며, 정밀한 로컬 피드백으로 세밀한 검증 능력을 개발한다. 전체 요약 7문장 읽기 → 062 15:11 ▲ 16 · 댓글 2 단안 카메라 영상에서 인물 추적 시 발생하는 스케일 미스매치 문제 해결 단안 카메라에서 3D 인물 복원 기술들이 현재 벤치마크에서는 잘 작동하지만, 빠른 카메라 움직임을 포함한 데이터에는 문제가 있었다. AI · 머신러닝 · A Diagnostic Study of World-Space Human Recovery Under High Camera Dynamics
Key Point 빠르게 움직이는 카메라가 있는 실제 방송 환경에서 인물 3D 복원 기술의 정확도를 크게 떨어뜨리는 스케일 미스매치 문제와 그 원인, 그리고 간단한 해결책을 제시한다.
핵심 요약
단안 카메라에서 3D 인물 복원 기술들이 현재 벤치마크에서는 잘 작동하지만, 빠른 카메라 움직임을 포함한 데이터에는 문제가 있었다. 연구팀이 K-Pop 스트레스 테스트를 도입했는데, 이는 빠르고 큰 카메라 움직임과 복잡한 다중 인물 안무를 결합한 방송 댄스 영상들이다. 기존 최고 성능 방법들은 이 영상에서 프레임별로는 그럴듯한 메시를 생성하지만, 월드 좌표계 상의 인물 궤적은 실제 무대 위치에서 크게 벗어난다. 전체 요약 7문장 읽기 → 063 15:11 ▲ 25 · 댓글 2 선택 작업에 특화된 경량 멀티모달 모델 Intern-Decision 공개 Intern-Decision은 텍스트와 이미지로부터 구조화된 선택과 확률을 반환하는 0.8B, 2B, 4B 사이즈의 멀티모달 의사결정 모델이다. AI · 머신러닝 · Intern-Decision: Efficient Multimodal Decision Making with Autoregressive Masked Language Modeling
Key Point 의사결정이 필요한 에이전트 시스템에서 응답 생성 대신 구조화된 선택을 직접 반환하므로, 지연시간을 줄이고 모델-환경 인터페이스를 단순화한다.
핵심 요약
Intern-Decision은 텍스트와 이미지로부터 구조화된 선택과 확률을 반환하는 0.8B, 2B, 4B 사이즈의 멀티모달 의사결정 모델이다. 자동회귀 마스크 언어 모델링 목표를 사용하여 완전한 어시스턴트 JSON 스켈레톤에 필드당 하나의 결정 플레이스홀더를 배치하고, 한 번의 순방향 전달로 모든 필드를 평가한다. 4B 모델이 7개 평가 세트에서 평균 90.02% 정확도를 달성했으며, Llama v1.13.0의 88.74%를 능가한다. 전체 요약 7문장 읽기 → 064 12:11 ▲ 14 · 댓글 2 선형 어텐션의 오래된 맥락 처리 능력 끌어올리기 선형 어텐션은 효율성이 필요한 긴 맥락 언어 모델링을 약속하지만, 고정 크기의 순환 상태로 현재 계산을 지원하면서 동시에 계속 증가하는 히스토리 정보를 보존해야 하는 딜레마가 있다. AI · 머신러닝 · History Replays Itself: Unleashing Long-Context Capability in Linear Attention
Key Point 선형 어텐션 모델의 가장 큰 약점인 긴 맥락 처리를 메모리 오버헤드 거의 없이 해결하는 방법을 제시해 실용적 배포 가능성을 높였다.
핵심 요약
선형 어텐션은 효율성이 필요한 긴 맥락 언어 모델링을 약속하지만, 고정 크기의 순환 상태로 현재 계산을 지원하면서 동시에 계속 증가하는 히스토리 정보를 보존해야 하는 딜레마가 있다. 기존에는 이 순환 상태의 메모리 용량이 모델의 긴 맥락 처리 능력의 상한선을 정한다고 여겨졌으나, 연구팀은 순환 계산이 장기 저장의 모든 부담을 질 필요가 없다는 점을 제시한다. NoteBank라는 희소 에피소드 메모리를 도입했으며, 이는 미래 쿼리를 알기 전에 선택된 텍스트를 보관하고, 백본의 기본 특징으로 읽고 쓰며, 재생을 통해 네이티브 순전파 계산으로 검색된 증거를 읽는다. 전체 요약 8문장 읽기 → 065 12:11 ▲ 43 · 댓글 2 멀티코드북 디퓨전으로 텍스트·이미지 통합 생성 가능 기존 이미지 생성 모델은 단일 코드북 기반으로 표현력이 제한되거나, 텍스트와 이미지를 서로 다른 최적화 목표로 학습해 모달리티 간 충돌이 발생했다. AI · 머신러닝 · Intern Lumina U2: A Multi-Codebook Diffusion Large Language Model for Omni-Visual Understanding and Image Generation
Key Point 이산 공간에서 고해상도 이미지 생성과 텍스트 모델링을 진정으로 통합한 첫 디퓨전 언어모델로, 단일 모델로 텍스트·이미지·비디오·3D를 모두 다룰 수 있다는 점에서 멀티모달 생성의 새로운 패러다임을 제시한다.
핵심 요약
기존 이미지 생성 모델은 단일 코드북 기반으로 표현력이 제한되거나, 텍스트와 이미지를 서로 다른 최적화 목표로 학습해 모달리티 간 충돌이 발생했다. Intern Lumina U2는 각 시각적 위치를 여러 상호보완적 코드북의 코드 그룹으로 표현하는 멀티코드북 디퓨전 언어모델로, 이산 공간에서 고용량 시각 표현과 텍스트를 통합한다. 입력 시 각 위치의 임베딩을 연결하고, 출력 시 경량의 멀티코드북 자동회귀 헤드가 각 위치 내 코드를 순차적으로 예측하면서 디퓨전 백본은 모든 위치를 병렬 처리한다. 전체 요약 6문장 읽기 → 066 00:11 ▲ 105 · 댓글 102 목공 설계에 AI를 쓸 수 있을까? 취미 목공인이 Shapr3D에서 수작업으로 3D 모델을 설계하는 과정이 번거로워 LLM을 활용한 더 효율적인 방법을 찾고 있다. AI · 머신러닝 · Ask HN: CAD for wood working with LLM support?
Key Point CAD 소프트웨어와 AI의 결합이 얼마나 현실화되었는지, 목공 같은 실용 분야에서 LLM을 실제로 활용할 수 있는 방법이 있는지 확인할 수 있다.
핵심 요약
취미 목공인이 Shapr3D에서 수작업으로 3D 모델을 설계하는 과정이 번거로워 LLM을 활용한 더 효율적인 방법을 찾고 있다. 목공 프로젝트 설계에 AI를 적용한 경험이 있는지, 추천할 만한 도구가 있는지 묻고 있다. 067 21:11 당일 +136 AI로 Blender 3D 모델링 제어하는 MCP 플러그인 공개 Claude, Cursor, VS Code 등 LLM과 연결해 자연어로 Blender 3D 모델링을 제어할 수 있는 커뮤니티 플러그인 MCP for Blender를 공개했다. AI · 머신러닝 · ahujasid/mcp-for-blender · Python
Key Point AI가 직접 3D 모델링을 제어하는 새로운 방식으로, Blender 사용자가 자연어로 복잡한 3D 작업을 자동화할 수 있게 된다.
핵심 요약
Claude, Cursor, VS Code 등 LLM과 연결해 자연어로 Blender 3D 모델링을 제어할 수 있는 커뮤니티 플러그인 MCP for Blender를 공개했다. AI가 Blender Python을 직접 작성하며, 소켓 기반 서버로 두 방향 통신을 지원한다. 모델 생성(Tripo, Hunyuan3D, Hyper3D Rodin), 뷰포트 확인(솔리드/렌더링/와이어프레임/X-ray), Poly Haven 에셋, Sketchfab 모델, Poly Pizza 저폴리 모델 검색·임포트 기능을 제공한다. 전체 요약 10문장 읽기 → 068 15:11 ▲ 107 · 댓글 10 Oxide, 완전한 랙을 가상 환경에서 구동하는 에뮬레이터 공개 Oxide는 Virtual Oxide Labs(Voxel)라는 소프트웨어 에뮬레이션 스택을 공개했으며, illumos와 Rust로 구축되어 실제 Oxide 랙을 가상 환경에서 재현할 수 있다. 인프라 · 데브옵스 · Virtual Oxide Labs: Emulating a Full Oxide Rack
Key Point 실제 하드웨어가 부족한 상황에서 완전한 랙 규모 시스템을 로컬 머신에서 테스트할 수 있는 방법을 제시했으며, 마이크로컨트롤러 에뮬레이션의 기술적 구현 방식이 임베디드 시스템 테스트의 새로운 접근 방식을 보여준다.
핵심 요약
Oxide는 Virtual Oxide Labs(Voxel)라는 소프트웨어 에뮬레이션 스택을 공개했으며, illumos와 Rust로 구축되어 실제 Oxide 랙을 가상 환경에서 재현할 수 있다. Voxel은 수정되지 않은 스톡 Oxide 소프트웨어를 사용하는 '절대적 충실도'를 원칙으로 하며, 슬레드 가상화(Propolis), BGP/정적 네트워킹(Debian/FRR), 소프트웨어 P4 스위치(SoftNPU), 마이크로컨트롤러 시뮬레이션을 지원한다. 32스레드 AMD Ryzen 9 9955HX와 96GB RAM을 갖춘 Minisforum 미니 PC에서 6개 슬레드로 구성된 완전한 Oxide 랙을 약 10분 만에 구동할 수 있다. 전체 요약 9문장 읽기 → 069 00:11 ▲ 12 · 댓글 2 GUI 에이전트의 지연 세계 행동 모델 기존 픽셀 기반 세계 모델은 GUI 에이전트에서 미래 화면을 생성한 뒤 재인식하는 두 단계 방식을 사용하지만, 화면 재구성의 높은 연산 비용과 행동 선택에 불필요한 세부 정보 재구성 문제가 있다. AI · 머신러닝 · Latent World Action Model for GUI Agents
Key Point 픽셀 재구성 대신 잠재 공간에서 행동 유도 변화를 예측함으로써 GUI 에이전트의 성공률을 40% 이상 높이고 추론 속도를 거의 100배 개선하는 새로운 접근법이다.
핵심 요약
기존 픽셀 기반 세계 모델은 GUI 에이전트에서 미래 화면을 생성한 뒤 재인식하는 두 단계 방식을 사용하지만, 화면 재구성의 높은 연산 비용과 행동 선택에 불필요한 세부 정보 재구성 문제가 있다. 현재 상태를 거의 그대로 보존하는 '항등성 단축' 문제가 발생해 행동으로 인한 변화를 제대로 포착하지 못한다. 본 논문은 GUI 세계 모델링을 전체 화면 재구성에서 행동 유도 미래 정보의 잠재 공간 예측으로 재정의했다. 전체 요약 8문장 읽기 → 070 21:11 ▲ 16 · 댓글 2 영상 생성 속도 2배 이상 높인 경량 VAE 기법 공개 영상 확산 모델의 성능은 좋지만, VAE 인코딩과 디코딩에 높은 계산 비용이 들어가는 것이 문제이다. AI · 머신러닝 · LightVAE: Towards Compact and Efficient Video Autoencoders
Key Point 영상 생성 모델의 추론 속도를 2배 이상 높일 수 있는 기술이 공개되어, 실시간 영상 생성 서비스의 비용과 성능을 크게 개선할 수 있게 되었다.
핵심 요약
영상 확산 모델의 성능은 좋지만, VAE 인코딩과 디코딩에 높은 계산 비용이 들어가는 것이 문제이다. 기존 방식은 공간과 시간 계산을 함께 제약하거나 시간 계산을 제거했으나, Conv3D에서 두 차원의 압축 민감도를 구분하지 못했다. LightVAE는 시간 모델링과 네트워크 깊이의 중복성을 이용하는 압축 프레임워크다. 전체 요약 12문장 읽기 → 071 18:11 ▲ 29 · 댓글 2 언어 모델 자가증류, 체계적 프롬프트로 추론 질 높인다 대규모 언어모델을 학습할 때 같은 모델의 교사 버전으로부터 지도를 받는 자가증류(OPSD) 방식이 있습니다. AI · 머신러닝 · Self-Distillation with Verbal Regularization
Key Point 언어모델 학습에서 교사-학생 구조의 편향 문제를 프롬프트 엔지니어링으로 해결하는 실질적인 방법론으로, 추론 성능을 높이면서도 모델의 탐색성을 보존하는 기술입니다.
핵심 요약
대규모 언어모델을 학습할 때 같은 모델의 교사 버전으로부터 지도를 받는 자가증류(OPSD) 방식이 있습니다. 교사는 정답 같은 특권정보(PI)를 조건으로 받지만, 학생은 이를 보지 못한 채 교사의 토큰 분포로부터 학습합니다. 하지만 특권정보는 깊은 검증 없이 지름길 추론으로 편향되는 문제가 생기며, 출력 분포의 엔트로피가 급격히 떨어집니다. 전체 요약 8문장 읽기 → 072 18:11 ▲ 24 · 댓글 1 로봇 비전-언어 모델과 세계 모델을 연결한 WAVE-0 공개 Vision-language-action(VLA) 정책은 로봇 조작에 뛰어나지만 행동의 환경적 결과를 명시적으로 모델링하지 않는 한계가 있다. AI · 머신러닝 · WAVE-0: Bridging VLA Policies and WAMs with Lightweight Latent Future Prediction
Key Point 기존 VLA 정책의 행동 결과 예측 부재 문제를 경량 세계 모델로 해결하고 실제 로봇 작업에서 35%p 향상을 이루어 실용적 로봇 조작 능력이 어떻게 개선되는지 보여준다.
핵심 요약
Vision-language-action(VLA) 정책은 로봇 조작에 뛰어나지만 행동의 환경적 결과를 명시적으로 모델링하지 않는 한계가 있다. World action models(WAM)은 미래 예측을 포함하지만 대부분 비용이 큰 비디오 생성에 의존하거나 대규모 영상 학습이 필요하다. WAVE-0(World-model-Augmented VLA Execution)은 경량 잠재 세계 모델로 VLA와 WAM을 연결하는 프레임워크다. 전체 요약 9문장 읽기 → 073 15:11 ▲ 63 · 댓글 2 AI 에이전트의 '실행 가능한 3D 세계' 만드는 능력을 평가하는 벤치마크 공개 코딩 에이전트가 단순히 세계를 시각화하는 것을 넘어, 물리 법칙과 인과관계에 따라 동작하는 실행 가능한 코드 기반 세계를 구축하는 능력이 요구되고 있다. AI · 머신러닝 · ExeWorldBench: Benchmarking Code-Based Executable 3D World Modeling
Key Point AI가 물리 법칙을 이해하고 실제로 동작하는 세계를 코드로 만들 수 있는지 평가하는 새로운 기준이 생겼으며, 현재 모델들의 근본적 한계를 파악할 수 있다.
핵심 요약
코딩 에이전트가 단순히 세계를 시각화하는 것을 넘어, 물리 법칙과 인과관계에 따라 동작하는 실행 가능한 코드 기반 세계를 구축하는 능력이 요구되고 있다. 기존 벤치마크는 물리 추론, 시각적 충실도, 행동 정확성을 각각만 평가했으나, 이 세 가지를 통합적으로 평가하지 못했다. 이를 해결하기 위해 ExeWorldBench라는 첫 번째 포괄적 벤치마크를 제시했으며, 코드 기반 3D 세계 구축을 통해 세계 이해와 실행 가능한 구현을 평가한다. 전체 요약 5문장 읽기 → 074 15:11 ▲ 69 · 댓글 5 사용자 행동으로 LLM 학습하는 Vela 프레임워크 현재 LLM은 정적 텍스트나 합성 데이터로만 학습되어 사용자의 선호도·의도·미래 행동을 장기간 행동 데이터에서 추론하는 능력이 부족하다. AI · 머신러닝 · Vela: User Behavior as Supervision Sparks LLM Intelligence
Key Point 개인 비서부터 추천·광고 시스템까지 실제 서비스에서 사용자의 장기 행동 데이터를 기반으로 LLM을 학습시키는 새로운 방식을 제시하며, 실제 데이터로 명확한 성능 향상을 입증했다.
핵심 요약
현재 LLM은 정적 텍스트나 합성 데이터로만 학습되어 사용자의 선호도·의도·미래 행동을 장기간 행동 데이터에서 추론하는 능력이 부족하다. Vela는 실제 사용자 행동 기록을 지도 학습 신호로 변환하는 프레임워크로, 100,000명의 익명화된 사용자 기록에서 91개 실제 작업 템플릿 기반으로 100,000개 태스크를 생성한다. 난이도 기반 필터링과 궤적 선정 기준을 통해 약 75,000개의 학습용 궤적을 선별한다. 전체 요약 6문장 읽기 → 075 06:11 ▲ 109 · 댓글 68 복소수의 시각적 이해: 불가능한 제곱근에서 회전의 언어까지 실수만으로는 풀 수 없는 연립방정식을 시도하며 음수의 제곱근이라는 불가능한 문제에 직면하게 된다. AI · 머신러닝 · A Visual Intro to Complex Numbers
Key Point 음수의 제곱근이라는 불가능한 계산에서 출발해 현대 통신, 제어, 물리학을 움직이는 핵심 도구가 된 복소수의 진화 과정과 실제 응용을 한눈에 이해할 수 있다.
핵심 요약
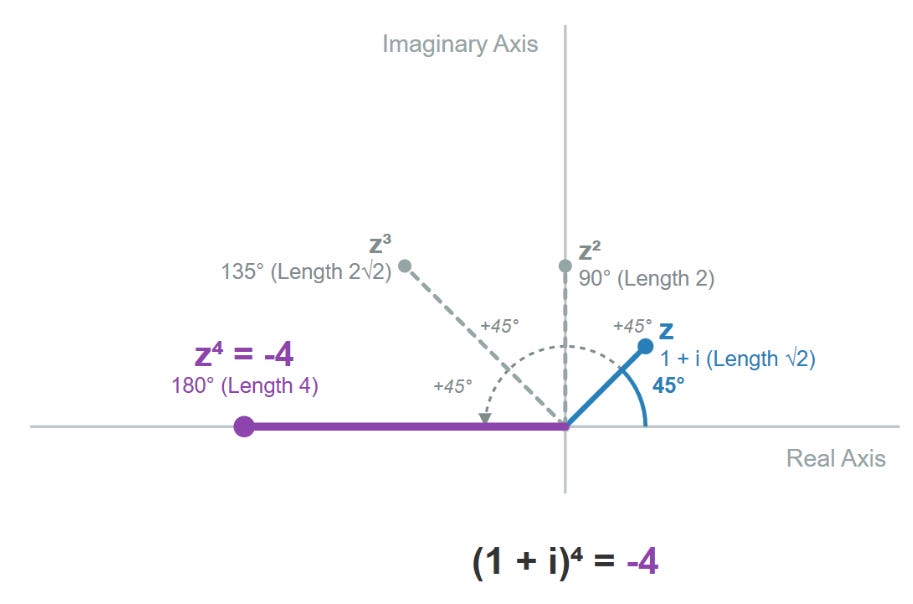
실수만으로는 풀 수 없는 연립방정식을 시도하며 음수의 제곱근이라는 불가능한 문제에 직면하게 된다. 16세기 이탈리아 수학자 카르다노는 음수의 제곱근을 계산 과정에서 다루면 불가능한 항들이 소거되어 실제 답에 도달할 수 있음을 발견했지만, 이를 의미 없는 '편의적 속임수'로 간주했다. 데카르트는 이런 수들을 '허수'라고 부르며 조롱했으나, 18세기 오일러는 음수의 제곱근을 i로 표기하며 체계적인 기초를 마련했다. 전체 요약 15문장 읽기 → 076 00:11 ▲ 106 · 댓글 22 오픈소스 Rust 기반 3D CAD, AI 에이전트 지원 SolidCraft는 Rust로 만든 오픈소스 파라메트릭 3D CAD로, 스케치·제약·솔리드 빌드를 지원하며 파라메트릭 기능 타임라인으로 치수 변경 시 모델이 자동 재구성된다. 하드웨어 · 시스템 · Show HN: SolidCraft – Open-Source Parametric CAD in Rust (With MCP Support)
Key Point Rust 생태계에서 완성도 높은 CAD 소프트웨어가 나왔으며, MCP를 통해 AI 에이전트가 직접 설계 작업을 수행할 수 있어 AI 드리븐 제조·설계 워크플로우의 새로운 가능성을 보여준다.
핵심 요약
SolidCraft는 Rust로 만든 오픈소스 파라메트릭 3D CAD로, 스케치·제약·솔리드 빌드를 지원하며 파라메트릭 기능 타임라인으로 치수 변경 시 모델이 자동 재구성된다. 데스크톱, 브라우저, MCP 서버를 통한 AI 에이전트 모델링을 지원하며, 라즈베리파이 케이스 예제처럼 스케치·압출·필렛·쉘·패턴·텍스트 조각 등을 한 설계에서 완성할 수 있다. Windows·macOS·Linux(AppImage·deb·rpm·Flatpak·Snap)와 웹 버전으로 제공되며, ARM64와 32비트 PC도 지원한다. 전체 요약 14문장 읽기 → 077 18:11 ▲ 125 · 댓글 91 OpenAI의 '빠른 푸리에 변환'은 수학적 속임수일 뿐 OpenAI가 수학 저장소에서 공개한 푸리에 변환(FFT) 알고리즘이 더 빠르다고 주장하지만, 실제로는 현실에서 작동 불가능한 방식이다. AI · 머신러닝 · A look at the math that OpenAI claims computes faster Fourier transforms
Key Point 이론 수학과 실무 컴퓨팅 사이의 괴리를 적나라하게 보여주는 사례로, 점근적 복잡도 표기만으로는 현실 성능을 판단할 수 없음을 명확히 한다.
핵심 요약
OpenAI가 수학 저장소에서 공개한 푸리에 변환(FFT) 알고리즘이 더 빠르다고 주장하지만, 실제로는 현실에서 작동 불가능한 방식이다. 기존 FFT는 1965년 쿨리-튜키 알고리즘으로 n²에서 5n log n 연산으로 개선했으며, n=1,000일 때 20배, n=1,000,000일 때 10,000배 속도 향상을 제공한다. OpenAI 알고리즘의 상수는 n=10¹²일 때 약 10¹⁰⁰으로 추정되므로, 실제로 더 빠른 n값은 우주의 원자 개수(10⁸⁰)보다 크다. 전체 요약 8문장 읽기 → 078 03:11 ▲ 11 · 댓글 2 LLM 추론 가속화 기법 PreSTO 제안 LLM 추론 시 검증 기반 샘플링(Power sampling)을 활용하면 결과 품질이 높아지지만, Metropolis-Hastings(MH) 알고리즘의 순차 처리로 속도가 느렸다. AI · 머신러닝 · PreSTO: Predictive Subtree Prefetching for Fast LLM Power Sampling
Key Point Power sampling으로 LLM 추론 품질은 개선되지만 속도가 병목이었는데, PreSTO는 수학적 정확성을 유지하면서 1.7~2.3배 속도 향상을 실현해 실용적 배포의 장벽을 낮춘다.
핵심 요약
LLM 추론 시 검증 기반 샘플링(Power sampling)을 활용하면 결과 품질이 높아지지만, Metropolis-Hastings(MH) 알고리즘의 순차 처리로 속도가 느렸다. PreSTO(Predictive SubTree Prefetching)는 미래의 샘플 생성 제안을 미리 배치 처리하되, MH 전이 커널은 변경하지 않으므로 수학적 정확성을 유지한다. 알고리즘은 accept/reject 결정을 트리 구조로 모델링하고, 각 모델 호출에서 한 번에 여러 제안을 생성한 뒤 실제 경로를 MH 규칙으로 추적한다. 전체 요약 7문장 읽기 → 079 03:11 ▲ 162 · 댓글 60 슈퍼마리오64 개발 비하인드 - 닌텐도 코더 긱스 고다드 인터뷰 2001년 닌텐도 코더 긱스 고다드의 미발표 인터뷰로, 슈퍼마리오64 개발 당시의 뒷이야기를 담은 자료이다. 하드웨어 · 시스템 · The Making Of Super Mario 64 – full Giles Goddard interview (2001)
Key Point 슈퍼마리오64가 3D 게임 설계와 게임플레이 튜닝을 어떻게 했는지 개발자 직접 증언으로 보여주며, 현대 3D 게임의 기초가 된 기술 결정들을 구체적으로 공개한다.
핵심 요약
2001년 닌텐도 코더 긱스 고다드의 미발표 인터뷰로, 슈퍼마리오64 개발 당시의 뒷이야기를 담은 자료이다. 마리오 팀은 약 15명 규모로 젤다 시간의 오카리나 제작팀보다 훨씬 작았으며, 닌텐도 내 아티스트와 프로그래머는 분리되어 있었다. N64 에뮬레이터 없이 SGI Onyx에서 GL 프로그래밍으로 시작했고, 6개월간 컨트롤러가 없어 개조된 세가 조이패드를 사용했다. 전체 요약 13문장 읽기 → 080 18:12 ▲ 17 · 댓글 2 잠재 공간에서 보상 모델링, 추론 비용 6배 이상 절감 현재 보상 모델링은 평가 기준을 토큰 단위로 생성하는 과정에서 높은 추론 비용이 발생한다. AI · 머신러닝 · Judging in Latent Space: Efficient Generative Reward Modeling via Semantics-Preserving Compression
Key Point 보상 모델은 LLM 정렬의 핵심인데, 기존 방식이 추론 시간을 6배 이상 줄일 수 있다면 생성형 AI 개발의 경제성을 크게 높일 수 있다.
핵심 요약
현재 보상 모델링은 평가 기준을 토큰 단위로 생성하는 과정에서 높은 추론 비용이 발생한다. LatentGRM은 의미 청킹·압축·재구성 기반의 잠재 평가 프레임워크로, 평가 루브릭 구조를 활용해 압축을 유도한다. 텍스트 평가 생성 없이 연속적 잠재 궤적만으로 페어별 판단을 수행하며, 별도 인터프리터가 평가 텍스트를 재구성한다. 전체 요약 6문장 읽기 → 081 12:11 ▲ 55 · 댓글 3 AR·VR용 입체 음성 생성, 화면 움직임과 동기화 기존 영상-음성 생성 모델은 의미 대응과 시간 동기화는 잘했지만, AR/VR·인터랙티브 게임에 필요한 입체 음성 생성은 미흡했다. AI · 머신러닝 · Hear the World in Stereo: Learning Dynamic Spatial Correspondence for Immersive Joint Video-Audio Generation
Key Point AR·VR과 게임 등 몰입형 미디어에서 필수인 입체 음성을 화면 움직임과 동기화하는 기술 공백을 처음 정의하고 해결했으며, 평가 기준도 함께 제시했다.
핵심 요약
기존 영상-음성 생성 모델은 의미 대응과 시간 동기화는 잘했지만, AR/VR·인터랙티브 게임에 필요한 입체 음성 생성은 미흡했다. 입체 음성은 음원이 인지되는 방향이 화면 속 음원의 움직임과 일치해야 하는데, 이를 '동적 공간 대응'이라고 정의했다. StereoBind는 모션 트랙을 활용해 시각적 움직임과 입체 음성을 연계하는 프레임워크로, 시각 움직임 바인딩·공간 트랙 인코더·상대 움직임 모델링 세 가지 메커니즘을 사용한다. 전체 요약 5문장 읽기 → 082 12:11 ▲ 33 · 댓글 2 재귀적 자기개선 프레임워크로 코드부터 신약까지 성능 지속 개선 RSI-Anything은 JEPA-Anything 기반의 도메인 범용 프레임워크로, 예측 세계 모델을 사용해 행동과 학습 데이터 선택을 안내한다. AI · 머신러닝 · RSI-Anything: Unlocking Recursive Self-Improvement with World Models
Key Point 기존 외부 피드백 없이 정책이 스스로 개선되는 자기개선 프레임워크가 코드 수리부터 신약 발견까지 다양한 분야에서 실질적 성능 향상을 입증했기 때문이다.
핵심 요약
RSI-Anything은 JEPA-Anything 기반의 도메인 범용 프레임워크로, 예측 세계 모델을 사용해 행동과 학습 데이터 선택을 안내한다. 정책 진화 중 세계 모델 예측의 신뢰성 저하 문제를 해결하기 위해 관찰된 피드백을 통해 정책이나 워크플로우 개선과 조건부 세계 모델 적응을 진행한다. 성분·호환성 검사를 통해 업데이트된 정책-모델 쌍의 유지 여부를 결정한다. 전체 요약 8문장 읽기 → 083 12:11 ▲ 114 · 댓글 91 코드로 3D 모델을 설계하는 오픈소스 CAD 도구 OpenSCAD OpenSCAD는 프로그래밍 방식으로 입체 3D CAD 객체를 만드는 무료 오픈소스 소프트웨어다. 오픈소스 · 도구 · OpenSCAD the Programmers Solid 3D CAD Modeller
Key Point 3D 프린팅과 CAD 설계에 관심 있는 개발자들이 코드 기반의 설계 방식을 통해 더 유연하고 반복 가능한 모델링을 할 수 있는 도구를 알아야 한다.
핵심 요약
OpenSCAD는 프로그래밍 방식으로 입체 3D CAD 객체를 만드는 무료 오픈소스 소프트웨어다. Linux/UNIX, Windows, macOS에서 모두 사용할 수 있으며 공식 웹사이트에서 다운로드할 수 있다. 초보자를 위한 튜토리얼, 재사용 가능한 라이브러리, 여러 관련 도서가 제공되고 있다. 전체 요약 5문장 읽기 → 084 21:11 당일 +202 마이크로소프트, 고품질 3D 생성 모델 TRELLIS.2 공개 마이크로소프트가 40억 개 파라미터 규모의 이미지-to-3D 생성 모델 TRELLIS.2를 공개했다. AI · 머신러닝 · microsoft/TRELLIS.2 · Python
Key Point 이미지 한 장에서 PBR 재질까지 포함한 완전한 3D 자산을 빠르게 생성할 수 있는 새로운 방식이 등장했으므로, 3D 콘텐츠 제작 워크플로우가 어떻게 바뀔 수 있을지 확인할 필요가 있다.
핵심 요약
마이크로소프트가 40억 개 파라미터 규모의 이미지-to-3D 생성 모델 TRELLIS.2를 공개했다. O-Voxel이라는 새로운 '필드 프리' 희소 복셀 구조를 사용하여 복잡한 위상, 예리한 특징, 완전한 PBR 재료를 가진 3D 자산을 생성한다. 512³ 해상도에서 약 3초(2초 형상 생성 + 1초 재질 생성), 1024³에서 약 17초, 1536³에서 약 60초가 소요된다. 전체 요약 12문장 읽기 → 085 21:11 ▲ 104 · 댓글 36 금융 시장 데이터를 생성 모델로 합성할 수 있을까 Jane Street 인턴이 자기회귀 확산 모델을 사용해 미국 주식 시장 데이터의 주문장 이벤트를 생성하는 생성 모델을 만들었다. AI · 머신러닝 · Can you use autoregressive diffusion to generate market data?
Key Point 시장 데이터를 직접 합성하는 생성 모델은 기존의 포인트 추정 방식과 달리 시장 미시구조의 구체적 이벤트까지 재현할 수 있어, 량자펀드의 백테스팅과 리스크 시뮬레이션 방법을 근본적으로 바꿀 수 있는 가능성을 보여준다.
핵심 요약
Jane Street 인턴이 자기회귀 확산 모델을 사용해 미국 주식 시장 데이터의 주문장 이벤트를 생성하는 생성 모델을 만들었다. 기존 예측 모델과 달리 가격 뿐 아니라 주문 타이밍, 취소, 체결 같은 구체적 이벤트까지 합성하는 모델을 목표로 했다. 시장 데이터는 이산적(주문 추가/제거)이면서도 연속적(가격, 타이밍 같은 고차원 변수)인 혼합 특성을 갖고 있어 모델링이 복잡하다. 전체 요약 10문장 읽기 → 086 18:11 ▲ 18 · 댓글 2 LLM이 3D 로봇 부품 설계 자동화, 불완전한 모델도 복원 시뮬레이션에서 학습한 로봇 조작 정책을 현실 물체에 적용하려면 기하학적으로 정확한 관절형 3D 자산이 필수인데, 기존 메시 기반 방법은 학습 데이터 분포 밖의 물체나 손상된 메시에서 관절 정보 추론에 실패하곤 한다. AI · 머신러닝 · USDCraft: Geometrically Grounded Programmatic Modeling of Articulated 3D Assets for Simulation
Key Point 불완전하거나 손상된 3D 모델에서도 로봇 시뮬레이션용 정확한 관절 정보를 자동으로 복원할 수 있어, 현실의 다양한 물체로 로봇 학습을 확장하는 병목이 해결된다.
핵심 요약
시뮬레이션에서 학습한 로봇 조작 정책을 현실 물체에 적용하려면 기하학적으로 정확한 관절형 3D 자산이 필수인데, 기존 메시 기반 방법은 학습 데이터 분포 밖의 물체나 손상된 메시에서 관절 정보 추론에 실패하곤 한다. USDCraft는 사전학습된 LLM이 부분적 기하 정보를 바탕으로 시뮬레이션 준비가 된 관절형 자산을 위한 프로그램을 작성·수정하도록 하는 프레임워크로, 작업별 파인튜닝이 필요 없다. 기하 소스 분석으로 메시를 관찰된 표면과 미지 공간을 구분하는 텍스트 설명으로 변환하고, 반복적 기하 재검증으로 각 프로그램 후보를 같은 형식으로 재인코딩해 불일치 지점을 찾아낸다. 전체 요약 5문장 읽기 → 087 15:13 ▲ 52 · 댓글 2 다중 에이전트 1인칭 시점 세계 모델, 미세한 상호작용 구현 1인칭 시점 세계 모델은 에이전트의 행동에 따른 관찰을 예측하지만, 기존 연구는 단일 에이전트에 집중했다. AI · 머신러닝 · Multi-Agent Egocentric World Model with Fine-Grained Embodied Interaction
Key Point 실제 로봇이나 현실의 멀티에이전트 환경 시뮬레이션에서 미세한 상호작용(팔 움직임, 물체 조작 등)까지 정확히 모델링해야 하는 연구자와 엔지니어에게 필요한 기술적 진전이다.
핵심 요약
1인칭 시점 세계 모델은 에이전트의 행동에 따른 관찰을 예측하지만, 기존 연구는 단일 에이전트에 집중했다. 현실의 구체화된 환경에서는 여러 에이전트가 공유된 환경에서 미세한 동작을 통해 상호작용하는데, 이는 대부분의 기존 멀티에이전트 세계 모델에서 충분히 다뤄지지 않았다. 연구팀은 멀티에이전트 이고센트릭 세계 모델링을 여러 에이전트의 동기화된 1인칭 스트림 생성으로 정식화했고, 이는 교차 시점 행동 일관성, 공유 환경 일관성, 상호작용으로 인한 상태 업데이트 전파를 요구한다. 전체 요약 6문장 읽기 → 088 15:13 ▲ 105 · 댓글 14 생물학 AI 모델 학습용 데이터 구축에 18억 달러 투자 Biohub, 미국 에너지부(DOE), 국립보건원(NIH), Google DeepMind, Isomorphic Labs, Meta 등이 참여해 AI 학습용 생물학 데이터를 생성·공개하기 위해 총 18억 달러를 투자하기로 발표했다. AI · 머신러닝 · AI-ready biological data: $1.8B global commitment
Key Point 가상 세포 구축 같은 대규모 협력으로 생물학 AI 모델의 데이터 기초를 마련하려는 움직임이 전 세계 과학 연구와 신약 개발 속도를 크게 바꿀 수 있기 때문이다.
핵심 요약
Biohub, 미국 에너지부(DOE), 국립보건원(NIH), Google DeepMind, Isomorphic Labs, Meta 등이 참여해 AI 학습용 생물학 데이터를 생성·공개하기 위해 총 18억 달러를 투자하기로 발표했다. DOE는 5년간 5억 달러 이상을 투자해 측정·모델링·컴퓨팅에 나가고, NIH는 과거 5억 달러 이상 투자로 개발한 데이터셋과 리포지토리를 제공하며, Biohub은 이를 AI 학습용으로 표준화한다. Google DeepMind, Isomorphic Labs, Meta는 3억 달러를 투자해 가상생물학 이니셔티브(Virtual Biology Initiative)에서 멀티모달 데이터셋 및 생명 예측 모델 기술을 개발한다. 전체 요약 9문장 읽기 → 089 12:11 ▲ 129 · 댓글 2 원본 시스템 없이 언어 기반 환경 모의 실행 만드는 Trace2Env LLM 에이전트 학습·평가용 환경 모의 실행이 필요하지만, 원본 시스템 재구축은 불가능하거나 비현실적인 경우가 많다. AI · 머신러닝 · From Traces to Agentic Worlds: Agentic Language World Models for Interactive Environment Simulation
Key Point 원본 환경 없이 과거 기록만으로 현실적인 에이전트 학습 환경을 만들 수 있다면, 접근 불가능한 레거시 시스템이나 폐쇄된 플랫폼에서도 LLM 에이전트를 훈련할 수 있게 된다.
핵심 요약
LLM 에이전트 학습·평가용 환경 모의 실행이 필요하지만, 원본 시스템 재구축은 불가능하거나 비현실적인 경우가 많다. 기존 실행 환경을 재건하지 않고 언어 모델이 에이전트의 환경 역할을 하는 '에이전틱 언어 월드 모델링' 방식을 제시한다. Trace2Env는 원본 시스템의 과거 상호작용 기록(trace)만으로 학습 없이 환경을 재구성하는 무학습 프레임워크다. 전체 요약 8문장 읽기 → 090 12:11 ▲ 16 · 댓글 6 X선 회절 자동 분석하는 AI 에이전트 등장 분말 X선 회절 분석을 위한 자가학습 AI 에이전트 '간 장(Gan Jiang)'을 개발했다. AI · 머신러닝 · A self-learning scientific agent for X-ray diffraction
Key Point X선 회절은 신물질 개발·품질 검사·고고학 분석 등에 필수적인데, 기존에는 전문가 경험에 의존하던 분석을 AI가 자동화하고 다른 시료에 전이 가능한 수준에 도달했으며, 최근 공개된 다양한 벤치마크에서 기존 방법을 크게 앞섰다.
핵심 요약
분말 X선 회절 분석을 위한 자가학습 AI 에이전트 '간 장(Gan Jiang)'을 개발했다. XMatcher, XQueryer, XDecomposer, WPEM 4개의 엔진으로 구성되며, 물질 상(phase) 식별부터 다중상 분해, 물리 제약 조건 하의 전체 패턴 모델링까지 수행한다. 에이전트는 분석 실패를 진단하고 스킬 명령어와 코드를 개선한 뒤 재사용 전에 검증하는 방식으로, 언어모델 재훈련이나 물리 모델 변경 없이 실무 경험을 재사용 가능한 지식으로 변환한다. 전체 요약 8문장 읽기 → 091 12:11 ▲ 13 · 댓글 2 3D 메시에서 CAD 모델 자동 복원하는 AI 에이전트 등장 3D 메시로부터 편집 가능한 CAD 모델을 복원하는 것은 기존에 어려운 엔지니어링 과제였으며, 단일 도구로는 다양한 기하학과 복원 단계에서 균등하게 잘 작동하지 않았다. AI · 머신러닝 · CADFather: Autonomous CAD Reconstruction through Coordinated Tool Use
Key Point 3D 메시를 직접 편집 가능한 CAD 파라미터로 변환하는 과정이 자동화되면 역설계와 설계 작업흐름이 크게 단순화될 수 있기 때문이다.
핵심 요약
3D 메시로부터 편집 가능한 CAD 모델을 복원하는 것은 기존에 어려운 엔지니어링 과제였으며, 단일 도구로는 다양한 기하학과 복원 단계에서 균등하게 잘 작동하지 않았다. CADFather는 여러 상호보완적 도구를 조율하는 자율 에이전트 시스템으로, 3D 메시에서 파라메트릭 CAD 프로그램을 복원한다. 비전-언어 어시스턴트가 목표 및 중간 단계 렌더링을 검사하고, 어느 CAD 프로그램을 확장할지, 어떤 도구를 사용할지, 몇 개의 제안을 생성할지, 언제 종료할지를 결정한다. 전체 요약 7문장 읽기 → 092 03:11 ▲ 124 · 댓글 47 배터리 저장 장치, 전 세계 모든 가스터빈보다 저렴해졌다 Wood Mackenzie의 전 지구적 발전 비용 분석에 따르면 4시간 배터리 저장 장치가 43개 시장 모두에서 개방형 가스터빈보다 저렴해졌다. 인프라 · 데브옵스 · 4-hour battery storage is cheaper to install than gas turbines all across globe
Key Point 배터리 저장 비용이 가스터빈을 전지구적으로 역전시킨 것은 전력 시스템 계획의 패러다임 변화를 의미하며, 특히 신규 가스 발전 투자 시대의 종말을 신호한다.
핵심 요약
Wood Mackenzie의 전 지구적 발전 비용 분석에 따르면 4시간 배터리 저장 장치가 43개 시장 모두에서 개방형 가스터빈보다 저렴해졌다. 중동·아프리카에서 유틸리티급 태양광은 37달러/MWh이며 4시간 배터리는 2035년까지 33% 하락해 80달러/MWh이 되어 가스 피킹을 완전히 대체할 전망이다. 중국은 아시아태평양 평균보다 55% 이상 저렴한 배터리 비용으로 전 세계 기준을 제시하고 있으며, 제조 규모가 글로벌 비용 지도를 재편하고 있다. 전체 요약 10문장 읽기 → 093 00:11 ▲ 133 · 댓글 117 1990년대 명작 데모씬, 브라우저에서 그대로 작동 DOS 시대 고전 데모의 원본 코드를 명령어 단위로 재컴파일해 브라우저에서 실행하는 프로젝트를 공개했다. 웹 · 프론트엔드 · Classic PC demoscene productions running natively in the browser
Key Point 1990년대 컴퓨터 문화의 역사적 유산인 데모씬 작품들을 원본 동작 방식 그대로 보존·재현하는 기술적 성과로, 레트로 컴퓨팅과 웹 기술의 혁신적 결합을 보여준다.
핵심 요약
DOS 시대 고전 데모의 원본 코드를 명령어 단위로 재컴파일해 브라우저에서 실행하는 프로젝트를 공개했다. x86 에뮬레이터로 실행되는 데모의 모든 CPU 코드 블록을 녹음하고, 이를 정확한 사이클 타이밍을 보존한 C 코드로 변환한다. C는 웹어셈블리로 컴파일되며, 타이머·VGA 카드·사운드 블래스터 등 원본 하드웨어를 모델링한다. 전체 요약 8문장 읽기 → 094 18:30 ▲ 16 · 댓글 2 모바일 기기에서 3D 가우시안 스플래팅 실시간 렌더링 가능하게 Mobile-4DGS는 정적·동적 장면 모두에서 모바일 디바이스의 제한된 자원 내에서 실시간 3D 가우시안 렌더링을 실현하는 경량 프레임워크다. AI · 머신러닝 · Mobile-4DGS: Unified Static-Dynamic Real-time Mobile Gaussian Splatting
Key Point 모바일 기기에서 고품질 3D/4D 렌더링이 가능해지면, 스마트폰 AR 애플리케이션과 엣지 컴퓨팅 기반 3D 콘텐츠 처리 방식이 크게 바뀔 수 있다.
핵심 요약
Mobile-4DGS는 정적·동적 장면 모두에서 모바일 디바이스의 제한된 자원 내에서 실시간 3D 가우시안 렌더링을 실현하는 경량 프레임워크다. Monte Carlo Specular Energy Aggregator를 도입해 고차 복사 잔차를 1차 구면 조화함수(SH)로 압축하고, Attribute-Conditioned SH Enhancement 모듈로 미리 계산한 오프셋을 적용한다. Multi-View Alpha-Based Densification and Pruning 전략으로 다중 시점 일관성을 유지하면서 중복 프리미티브를 제거한다. 전체 요약 7문장 읽기 → 095 18:30 ▲ 54 · 댓글 2 동영상 미래 사건 예측, 인과관계 추론으로 정확도 높인다 비디오 이벤트 예측(VEP) 문제를 해결하기 위해 VepAgent라는 에이전트 프레임워크를 제안했습니다. AI · 머신러닝 · VepAgent: Bridging Causal-Transition via Tool-Augmented Reinforcement Learning for Video Event Prediction
Key Point 동영상에서 아직 일어나지 않은 미래 사건을 예측하는 작업에서 단순 패턴 학습을 넘어 인과관계를 명시적으로 추론하는 새로운 접근이 핵심 기술로 제시되고 있습니다.
핵심 요약
비디오 이벤트 예측(VEP) 문제를 해결하기 위해 VepAgent라는 에이전트 프레임워크를 제안했습니다. 기존 멀티모달 대형언어모델(MLLM)은 과거에 의존한 요약에 머물러 관찰되지 않은 인과 관계를 연결하지 못한다는 문제를 지적합니다. VepAgent는 인과-전이 추론과 도구 기반 강화학습을 통합하여 마지막 관찰 상태에서 미래 사건까지의 논리적 진행을 명시적으로 모델링합니다. 전체 요약 7문장 읽기 → 096 18:33 ▲ 124 · 댓글 87 스몰토크, 1960년대 컴퓨팅 혁신의 결정체 Alan Kay가 1993년 발표한 이 논문은 객체지향 프로그래밍의 역사와 Smalltalk 탄생 배경을 기술한다. 오픈소스 · 도구 · The Early History of Smalltalk (1993)
Key Point 개인 컴퓨팅과 객체지향 프로그래밍의 철학적 기원을 이해하려면, 그 개념이 어떤 선배 기술과 과학적 영감을 받아 형성되었는지 알아야 하기 때문이다.
핵심 요약
Alan Kay가 1993년 발표한 이 논문은 객체지향 프로그래밍의 역사와 Smalltalk 탄생 배경을 기술한다. 1960년대 ARPA 공동체의 대화형 시분할 컴퓨팅, 그래픽 화면, 포인팅 장치 등이 현대 개인 컴퓨팅과 객체지향 설계의 토대를 마련했다. Smalltalk은 이런 아이디어들을 최초로 완벽하게 구현한 시스템으로, 수백만 사용자를 위한 학습 환경과 복잡성 감소를 목표했다. 전체 요약 11문장 읽기 → 097 18:35 ▲ 28 · 댓글 2 능동형 AI 에이전트 설계·평가 원리 제시 사용자가 요청하지 않아도 미리 도움을 주는 능동형 LLM 에이전트가 필요하지만, 사용자 의도를 잘못 읽거나 신뢰를 잃을 수 있다는 문제가 있다. AI · 머신러닝 · Foundations of Proactive Agents: Principles, Technical Layers, and Proactivity-Gym
Key Point 능동형 AI 에이전트의 신뢰 문제를 다루는 첫 종합 프레임워크로, 실제 사용자 연구를 통해 '올바른 작업'과 '신뢰'가 별개임을 검증했다.
핵심 요약
사용자가 요청하지 않아도 미리 도움을 주는 능동형 LLM 에이전트가 필요하지만, 사용자 의도를 잘못 읽거나 신뢰를 잃을 수 있다는 문제가 있다. 논문은 능동형 에이전트 설계를 위해 3T 원칙을 제시한다: ①Task Capability(필요를 예측하고 유용한 작업 수행), ②Temporal Allocation(자원 가용성과 필요 시점에 맞춰 계산 배분), ③Trust(사용자 신뢰와 적절한 의존성 유지). 이 원칙들을 구현하기 위해 5가지 설계 차원(작업 범위, 예측 지평, 활성화 트리거, 처리 시점, 개입 깊이)으로 설계 공간을 조직했다. 전체 요약 8문장 읽기 → 098 18:35 ▲ 43 · 댓글 2 손재주 많은 로봇 제어, 3D 점군으로 배운다 세계 동역학과 로봇 행동을 함께 학습하는 월드 액션 모델에서, 기존 방식은 RGB 프레임이나 잠재 표현으로 세계를 모델링하고 손목 각도 같은 1차원 값으로만 행동을 예측해 3D 공간 구조와 접촉 기하를 놓쳤다. AI · 머신러닝 · PointWAM: 3D World Action Modeling for Dexterous Robotic Manipulation
Key Point 기존 손재주 로봇 조작 모델은 평면 이미지와 1차원 관절각만 다루며 3D 공간 기하를 놓쳤던 근본적 한계를 점군으로 해결한 접근법이 기존 방식을 11.7포인트 이상 추월했다.
핵심 요약
세계 동역학과 로봇 행동을 함께 학습하는 월드 액션 모델에서, 기존 방식은 RGB 프레임이나 잠재 표현으로 세계를 모델링하고 손목 각도 같은 1차원 값으로만 행동을 예측해 3D 공간 구조와 접촉 기하를 놓쳤다. Point World Action Model (PointWAM)은 환경과 손을 공유 시공간 좌표에서 3D 점 궤적으로 명시적, 분리적으로 표현하고 함께 예측한다. 작업별 물체 또는 키포인트 선택 없이 대규모 인간 시연 영상으로 사전학습할 수 있으며, 컬러 포인트 클라우드와 언어 지시로부터 장면과 손이 3D 공간에서 시간 경과에 따라 어떻게 공진화하는지 예측한 후 손 동작을 로봇 행동으로 재타겟팅한다. 전체 요약 4문장 읽기 → 099 09:11 ▲ 10 · 댓글 1 3D 구조를 살린 옥트리 기반 언어모델 OctLLM 기존 3D LLM은 3차원 형태를 부호화 지수나 텍스트 좌표로 압축해 공간 정보를 손실하고, 백본을 미세조정해 언어 능력을 훼손하는 두 가지 문제를 안고 있다. AI · 머신러닝 · Octrees as an Explicit 3D Language
Key Point 3D 데이터의 공간 구조를 손상시키지 않으면서도 기존 언어모델의 능력을 보존하는 멀티모달 LLM 설계 방식이 기존 기법들보다 우수한 성능을 달성했기 때문에 3D AI 모델 개발에 관심 있는 연구자와 실무자에게 참고할 만한 접근법을 제시한다.
핵심 요약
기존 3D LLM은 3차원 형태를 부호화 지수나 텍스트 좌표로 압축해 공간 정보를 손실하고, 백본을 미세조정해 언어 능력을 훼손하는 두 가지 문제를 안고 있다. OctLLM은 3D 데이터를 옥트리 점유 토큰의 명시적 3D 시퀀스로 입력받으면서도, 끝에서 두 번째 수준의 노드를 무작위로 비우고 자손을 생략해 형태를 보존한 Sparse Octree(S-Octree)로 단축해 위치 인식 마스크 모델링과 3D 이해를 지원한다. 3D 모달리티를 추가할 때 전체 미세조정이나 LoRA 대신, 메시 토큰을 블록의 일부에서 독립적인 학습 가능 브랜치로 라우팅하면서 텍스트와 이미지 토큰은 고정된 비전-언어 경로를 유지하고, 두 스트림이 공유 자기주의를 통해 상호작용하도록 설계했다. 전체 요약 4문장 읽기 → 100 09:11 ▲ 14 · 댓글 1 Minkowski 기하학으로 시공간 패턴을 명시적으로 학습하는 신경망 인코딩 물리 시뮬레이션과 비디오 예측에서 시간과 공간의 결합 구조를 모델링하는 것이 핵심 과제다. AI · 머신러닝 · MinkowskiPE: Minkowski Positional Encoding for Spatiotemporal Perception
Key Point 시공간 결합을 기하학적 불변량으로 명시적으로 모델링하면서도 표준 어텐션과 호환되는 새로운 인코딩이 다양한 스케일의 물리 지능 구축에 어떻게 기여하는지 보여준다.
핵심 요약
물리 시뮬레이션과 비디오 예측에서 시간과 공간의 결합 구조를 모델링하는 것이 핵심 과제다. 기존 접근법은 물리 법칙 기반이면 강한 사전지식을 제공하지만 유연성이 제한되고, 학습 기반은 유연하지만 시공간 결합을 대부분 암묵적으로만 처리한다. MinkowskiPE는 시간과 공간 좌표를 결합하여 Lorentz 변환을 query·key 특성에 적용하는 방식으로, 위치에 관한 어텐션 점수를 두 토큰 간의 상대적 시공간 변위에만 의존하게 만든다. 전체 요약 5문장 읽기 →