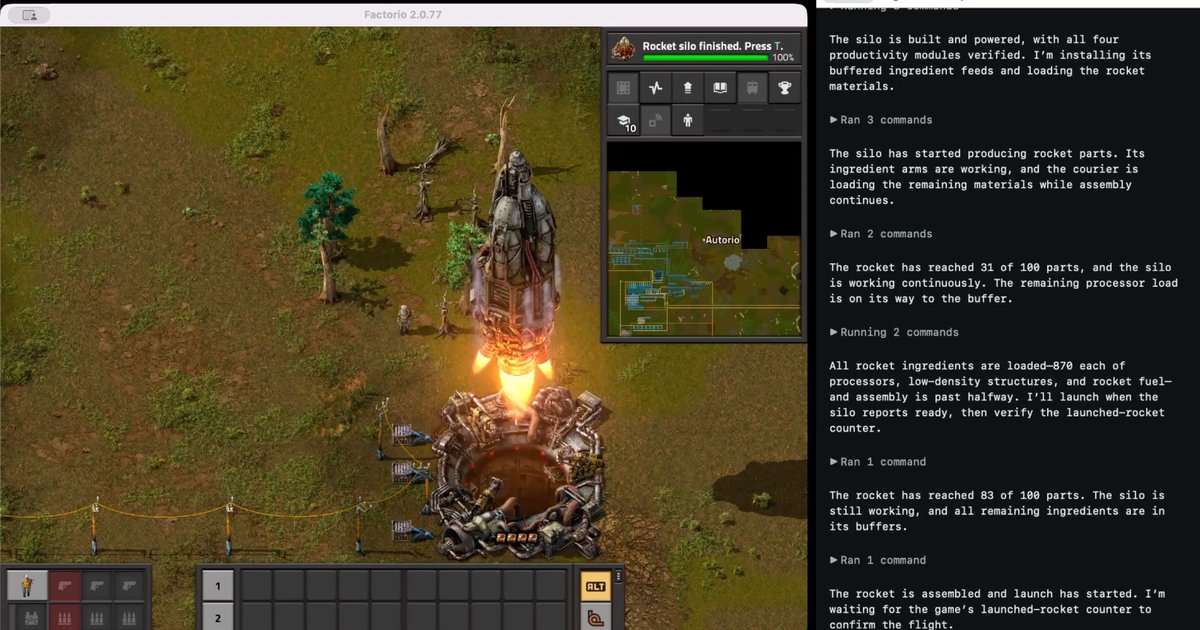
001 06:11 ▲ 109 · 댓글 108 GPT-4o가 팩토리오 평화모드 클리어 저자가 GPT-5.6 Sol 모델을 Codex에서 낮은 사고 수준으로 실행하여 13.5시간의 게임 시간으로 팩토리오 평화모드(생물 무적) 완주에 성공했다. AI · 머신러닝 · GPT-5.6 Sol can beat Factorio on peaceful mode
Key Point 최신 LLM이 복잡한 실시간 전략 게임을 자율적으로 플레이하고 완주한 첫 사례로, 모델의 실제 문제 해결 능력과 한계를 구체적으로 보여주는 벤치마크입니다.
핵심 요약
저자가 GPT-5.6 Sol 모델을 Codex에서 낮은 사고 수준으로 실행하여 13.5시간의 게임 시간으로 팩토리오 평화모드(생물 무적) 완주에 성공했다. 게임 매니저를 통해 모델이 Python 라이브러리를 사용해 프로그래밍 방식으로 게임을 플레이했으며, GUI 사용자와 동일한 제약(플레이어 도달 거리, 안개 기능)을 적용했다. 모델은 일부 영역에서는 기대를 초과했으나 명확한 약점도 보였고, 전체 런이 기록되어 해설 영상 제작 중이다. 전체 요약 8문장 읽기 → 002 12:11 ▲ 52 · 댓글 2 비디오의 특정 영역만 자유롭게 스타일링하는 AI 모델 LociArt 공개 비디오 스타일화는 전체 장면을 변환하는데, 로컬 편집은 정확한 영역-스타일 연결, 공간 제어, 시간적 일관성이 필요하다. AI · 머신러닝 · LociArt: A Unified Paradigm for Free-Style Local Video Stylization
Key Point 비디오 편집에서 특정 영역만 정확하게 스타일을 바꾸면서도 나머지는 그대로 두는 것이 이제 더 정밀하게 가능해졌으며, 이는 영상 제작자와 AI 연구자에게 구체적인 벤치마크와 데이터셋을 제공한다.
핵심 요약
비디오 스타일화는 전체 장면을 변환하는데, 로컬 편집은 정확한 영역-스타일 연결, 공간 제어, 시간적 일관성이 필요하다. LociArt는 어디를 스타일화할지와 어떤 스타일을 적용할지 명시하면서 대상이 아닌 콘텐츠는 보존하는 자유로운 로컬 비디오 스타일화 패러다임을 제시한다. 핵심 모듈 GRNStyle은 생성형 정제 네트워크(GRN)를 기반으로 하며, 선택된 영역 내에 스타일 정체성을 동등한 크기의 방향으로 임베딩하는 극좌표 스타일 인식 마스크를 도입한다. 전체 요약 8문장 읽기 → 003 12:11 ▲ 106 · 댓글 43 디즈니 애니메이션의 제작 과정, 차근차근 파헤치다 애니메이션 영화는 평균 90분이며 수십 개의 시퀀스(1~7분)로 구성되고, 각 시퀀스는 여러 샷(0~30초)으로 이루어지며, 초당 24프레임으로 렌더링된다. 기타 · What goes into making an animated film?
Key Point 애니메이션 영화의 복잡한 제작 과정을 개발부터 포스트 프로덕션까지 체계적으로 이해할 수 있으며, 각 단계의 구체적 규모(프레임 수, 시간)와 부서 간 협력 방식을 알 수 있다.
핵심 요약
애니메이션 영화는 평균 90분이며 수십 개의 시퀀스(1~7분)로 구성되고, 각 시퀀스는 여러 샷(0~30초)으로 이루어지며, 초당 24프레임으로 렌더링된다. 스테레오 3D의 경우 좌안과 우안을 위해 프레임이 2배가 되어, 주토피아 2는 총 288,710개 프레임을 렌더링했다. 완성까지 평균 3~5년이 소요되며, 개발 단계부터 시작해 스토리 개발, 캐스팅, 자산 생성이 이루어진다. 전체 요약 7문장 읽기 → 004 03:11 ▲ 31 · 댓글 2 자연어로 영화같은 카메라 움직임을 3D 환경에서 자동 생성 FilmFlow는 자연어 지시나 참고 영상을 3D 가상 환경의 실행 가능한 카메라 궤적으로 변환하는 에이전트 시스템이다. AI · 머신러닝 · FilmFlow: Agentic System for 3D Virtual Film Cinematography
Key Point 자연어 지시만으로 3D 환경의 영화급 카메라 동작을 자동으로 계획·실행할 수 있게 되면, 영화·게임·VR 등 다양한 미디어 제작 환경에서 영상 제작 시간을 크게 단축할 수 있다.
핵심 요약
FilmFlow는 자연어 지시나 참고 영상을 3D 가상 환경의 실행 가능한 카메라 궤적으로 변환하는 에이전트 시스템이다. Director 에이전트가 병렬 원자 동작들을 조합해 이동·회전·프레이밍을 동시에 제어하는 고수준 카메라 계획을 생성한다. Interpreter는 장면 기반 영화적 의도를 추출하고, Scout는 초기 시점을 선택하며, Critic은 렌더링 결과를 평가하고 시각적 피드백으로 반복 개선한다. 전체 요약 6문장 읽기 → 005 18:11 ▲ 184 · 댓글 2 이미지를 편집 가능한 레이어로 자동 분해하는 AI 명령 기반 이미지 편집과 재사용 가능한 RGBA 레이어 생성을 통합한 LayerEditor를 소개한다. AI · 머신러닝 · Editing Images into Reusable Layers via Compositional Edit-Prior Distillation
Key Point 이미지 편집 결과를 재편집 가능한 레이어로 자동 분해해 주므로 디자인 도구나 영상 제작 워크플로우에서 후속 수정이 훨씬 유연해진다.
핵심 요약
명령 기반 이미지 편집과 재사용 가능한 RGBA 레이어 생성을 통합한 LayerEditor를 소개한다. In-Context RGB-Alpha Token Modeling은 편집된 캔버스와 순서가 정해진 RGBA 레이어들을 단일 토큰 시퀀스로 표현하여 의미 있는 편집과 개별 레이어 조작을 가능하게 한다. Compositional Edit-Prior Distillation 기법으로 기존 모델의 편집 능력을 유지한 채 계층화된 출력으로 적응시킨다. 전체 요약 7문장 읽기 → 006 00:11 ▲ 10 · 댓글 2 생성형 AI로 대규모 3D 장면 완전 복원 실현 다양한 각도의 카메라 정보 없는 RGB 이미지들로부터 대규모 3D 장면의 완전한 메시를 복원하는 생성형 모델 WorldRecon을 제시했다. AI · 머신러닝 · WorldRecon: Generative Multi-View Mesh Reconstruction for Large-Scale 3D World
Key Point 완전하고 일관된 대규모 3D 장면 복원이 가능해져 가상현실·영상 제작·로봇 환경 인식 등 다양한 분야에서 활용될 수 있게 된다.
핵심 요약
다양한 각도의 카메라 정보 없는 RGB 이미지들로부터 대규모 3D 장면의 완전한 메시를 복원하는 생성형 모델 WorldRecon을 제시했다. 입력 이미지로부터 추정한 포인트 클라우드와 카메라 포즈를 전역 스캐폴드로 사용하고, 이를 겹치는 공간 블록으로 분할하여 처리한다. 3D 생성 모델 TRELLIS.2를 개선한 재구성 기반 조건화 아키텍처로 각 블록을 로컬 포인트 클라우드와 해당 이미지로부터 생성하며, 구조·기하·PBR 재료를 출력한다. 전체 요약 6문장 읽기 → 007 15:11 ▲ 39 · 댓글 2 음성·음악 분리와 생성을 한 번에, 오디오-비디오 AI 모델 SepGen 음성-영상 생성 모델을 확장하여 비디오, 혼합 사운드트랙, 각 음원별 개별 스템을 한 번의 샘플링으로 출력하는 SepGen을 제시한다. AI · 머신러닝 · SepGen: Multi-Stem Audio-Video Separation and Generation in a Single Model
Key Point 비디오에서 개별 음원을 자동 분리·생성할 수 있게 되면 3D 음성화(audio spatialization)나 음향 편집 등 실제 영상 제작 워크플로우가 단순해질 수 있으며, 기존 단순 음성 분리 모델을 능가하는 성능을 보인다.
핵심 요약
음성-영상 생성 모델을 확장하여 비디오, 혼합 사운드트랙, 각 음원별 개별 스템을 한 번의 샘플링으로 출력하는 SepGen을 제시한다. 생성 모드에서는 각 음원 캡션이 해당 스템의 내용을 지정하며, 예를 들어 두 명의 대사는 각 화자마다 하나의 스템으로 원래 순서대로 분리된다. 분리 모드에서는 입력 오디오 혼합을 유지하면서 캡션으로 추출할 내용을 지정하여, 자유형식 설명으로부터 녹음을 분해할 수 있다. 전체 요약 6문장 읽기 → 008 21:11 당일 +196 영상 자동 생성, 이제 AI 편집기에 장착한다 Claude Code나 Codex용 AI 에이전트 스킬로, 제품 스크린샷과 설명을 입력하면 Remotion 기반 영상을 자동 제작하는 도구다. AI · 머신러닝 · Vincentwei1021/video-shotcraft · TypeScript
Key Point AI가 제품 영상을 완전 자동으로 제작하고 웹에서 바로 편집할 수 있는 프로덕션 도구가 오픈소스로 공개됐으며, 기업 마케팅 영상 제작 방식이 크게 바뀔 가능성을 보여준다.
핵심 요약
Claude Code나 Codex용 AI 에이전트 스킬로, 제품 스크린샷과 설명을 입력하면 Remotion 기반 영상을 자동 제작하는 도구다. 152장의 샷 레시피 카드, 214개 모션 프리뷰, 9가지 필름 테마(Ink Press, Modern Light, Midnight 등)를 제공한다. 스토리보딩, 2.5D 카메라 움직임, 비트 싱크 컷, 영화급 음향 설계가 자동으로 적용되며, 템플릿은 36.2초 1920×1080 30fps 완성본으로 검증됐다. 전체 요약 11문장 읽기 → 009 18:35 ▲ 117 · 댓글 3 Kandinsky 6.0 Video, 텍스트로 음성 동기화 영상 생성 Hugging Face가 Kandinsky 6.0 Video 출시, 텍스트와 이미지로부터 음성이 동기화된 영상을 생성하는 기초 확산 모델. AI · 머신러닝 · Kandinsky 6.0 Video: Foundation Models for Synchronized Video and Audio Generation
Key Point 음성과 영상이 완벽하게 동기화된 멀티모달 생성 기술이 오픈소스로 공개되어 영상 제작 자동화와 멀티미디어 연구를 가속할 수 있게 되었습니다.
핵심 요약
Hugging Face가 Kandinsky 6.0 Video 출시, 텍스트와 이미지로부터 음성이 동기화된 영상을 생성하는 기초 확산 모델. 경량 버전(3B 파라미터)과 고성능 버전(29B 파라미터) 두 종류로, 5초 영상과 44 kHz 음성을 립싱크 포함해 생성. 텍스트-오디오-비디오(T2AV)와 이미지-오디오-비디오(I2AV) 모드 지원하며, 내장 초해상화로 1920×1080 풀HD 출력 가능. 전체 요약 8문장 읽기 → 010 21:11 당일 +2,909 아티스트를 위한 AI 창작 IDE, ArtCraft 오픈소스 공개 Rust로 만든 ArtCraft는 아티스트, 디자이너, 영화 제작자를 위한 AI 이미지·비디오 창작 도구로, 정확하고 반복 가능한 결과를 위해 프롬프트 기반 생성 대신 시각적 크래프팅을 강조한다. AI · 머신러닝 · storytold/artcraft · Rust
Key Point Rust 오픈소스로 공개되는 전문 창작 도구로, 프롬프트만으로는 어려운 정밀한 구성·반복 가능성·캐릭터 일관성을 필요로 하는 아티스트와 영상 제작자에게 직접적인 영향을 미친다.
핵심 요약
Rust로 만든 ArtCraft는 아티스트, 디자이너, 영화 제작자를 위한 AI 이미지·비디오 창작 도구로, 정확하고 반복 가능한 결과를 위해 프롬프트 기반 생성 대신 시각적 크래프팅을 강조한다. 2D 캔버스 합성, 3D 씬 제작, 캐릭터 포징, 배경 제거, 이미지 투 3D 메시 등 8가지 주요 크래프팅 기능을 제공하여 최종 생성 전에 장면을 사전에 구성할 수 있다. Image to Location 기능으로 일관된 환경에 가상 배우를 배치하고 같은 공간에서 여러 샷을 계획할 수 있으며, 3D 킷배싱과 캐릭터 아이덴티티 전이로 카메라 각도와 객체 배치를 정밀하게 제어한다. 전체 요약 7문장 읽기 → 011 21:11 당일 +128 다양한 골격에 애니메이션을 주는 통합 모델 UniMate 공개 SIGGRAPH Asia 2026에 채택된 UniMate는 이족·사족·조류·해양·곤충·뱀 형태 및 경직된 물체 등 다양한 골격 구조를 하나의 모델으로 애니메이션하는 기술이다. AI · 머신러닝 · Friedrich-M/UniMate · Python
Key Point 텍스트 기반 3D 애니메이션 생성의 일반화 문제를 단일 모델로 해결한 첫 사례이며, 영상 제작·게임 개발·디지털 캐릭터 제작 분야의 자동화를 크게 앞당길 기술이기 때문이다.
핵심 요약
SIGGRAPH Asia 2026에 채택된 UniMate는 이족·사족·조류·해양·곤충·뱀 형태 및 경직된 물체 등 다양한 골격 구조를 하나의 모델으로 애니메이션하는 기술이다. UniML3D라는 13,006개 텍스트 쌍 모션 시퀀스 데이터셋을 구축했으며, Mixamo, Objaverse-XL, Truebones ZOO에서 수집한 자산을 통일된 형식으로 정규화했다. 텍스트 프롬프트와 3D 리깅된 자산만으로 실시간 모션 생성이 가능하며, 스켈레톤별 재학습이나 테스트 시점 최적화가 필요 없다. 전체 요약 9문장 읽기 → 012 22:29 당일 +593 DJMAX 플레이를 위한 커스텀 키뷰어 DM Note 2.0.2 공개 DJMAX RESPECT V와 다른 게임에서 사용할 수 있는 실시간 키 입력 시각화 도구 DM Note 2.0.2를 공개했습니다. 오픈소스 · 도구 · DmNote-App/DmNote · TypeScript
Key Point 게임 플레이 스트리밍과 영상 제작 시 키 입력을 시각적으로 표현해야 하는 크리에이터와 스트리머들이 세밀하게 커스터마이징할 수 있는 도구를 얻게 됩니다.
핵심 요약
DJMAX RESPECT V와 다른 게임에서 사용할 수 있는 실시간 키 입력 시각화 도구 DM Note 2.0.2를 공개했습니다. 실시간 키 입력 표시, 키 매핑, 노트 효과, 키 카운터, KPS 통계 그래프, 키음 등을 지원합니다. 그리드에서 키를 직접 편집하고 각 키마다 이미지를 지정할 수 있으며, 사용자 정의 CSS와 플러그인으로 스타일을 완전히 바꿀 수 있습니다. 전체 요약 10문장 읽기 → 013 16:56 당일 +196 로컬 AI 단편극 제작 도구, 온전한 오프라인 워크플로우 오픈소스 AI 단편극 생성 도구로, 스토리 입력부터 동영상 완성까지 전체 워크플로우를 로컬 환경에서 처리한다. AI · 머신러닝 · xuanyustudio/LocalMiniDrama · JavaScript
Key Point 로컬 우선 방식으로 창작 데이터 유출 걱정 없이 오픈소스 도구로 AI 단편극 제작 전 과정을 직접 완성할 수 있어서다.
핵심 요약
오픈소스 AI 단편극 생성 도구로, 스토리 입력부터 동영상 완성까지 전체 워크플로우를 로컬 환경에서 처리한다. SQLite 데이터베이스와 로컬 파일 기반으로 모든 소재가 클라우드를 거치지 않으며, 구독료 없이 완전 오픈소스다. 대사 작성 → 캐릭터·장면 생성 → 분할 대본 작성 → 이미지·동영상 생성 → 최종 편집까지 8단계의 자동화된 제작 흐름을 지원한다. 전체 요약 8문장 읽기 → 014 00:10 당일 +168 AI 에이전트로 유튜브 채널 자동운영하기 오픈소스 AgentTube는 AI 에이전트가 영상 제작부터 발행까지 유튜브 채널을 전면 자동화한다. AI · 머신러닝 · darkzOGx/youtube-automation-agent · JavaScript
Key Point 자신의 기준과 브랜드를 유지하면서 유튜브 채널을 24/7 운영할 수 있는 오픈소스 도구가 공개됐으며, 승인 우선 워크플로우로 AI 자동화의 품질 문제를 해결했다.
핵심 요약
오픈소스 AgentTube는 AI 에이전트가 영상 제작부터 발행까지 유튜브 채널을 전면 자동화한다. 주제 연구·시나리오 작성·음성 생성·편집·메타데이터 최적화·검수·예약·발행·분석 학습을 자동으로 처리한다. Gemini·OpenAI 등 여러 LLM과 video 제너레이션 모델을 지원하며, 코딩 불필요하게 웹 대시보드로 운영된다. 전체 요약 5문장 읽기 → 015 21:11 당일 +387 React로 영상을 코드처럼 만드는 Remotion React 컴포넌트를 사용해 프로그래매틱하게 영상을 제작하고, 수동 편집이나 AI 에이전트로도 제작할 수 있다. 웹 · 프론트엔드 · remotion-dev/remotion · TypeScript
Key Point 코드 기반 영상 제작 도구로서 데이터 중심의 대량 영상 생성이나 복잡한 자동화 워크플로우가 필요한 개발팀과 에이전트 개발자에게 실제 선택지가 될 수 있는 기술이다.
핵심 요약
React 컴포넌트를 사용해 프로그래매틱하게 영상을 제작하고, 수동 편집이나 AI 에이전트로도 제작할 수 있다. 데이터 연결, 대량 렌더링, 디자인 시스템 구축 등 복잡한 영상 자동화 작업을 코드로 관리한다. Node.js, Lambda, Vercel 같은 다양한 환경에서 렌더링하거나 Player와 Editor로 애플리케이션을 빌드할 수 있다. 전체 요약 5문장 읽기 → 016 21:11 당일 +583 AI가 영상 제작을 한다, 오픈몬타주 AI 에이전트가 대본 작성부터 편집, 렌더링까지 영상 제작 전 과정을 자동화하는 오픈소스 시스템 OpenMontage를 공개했다. AI · 머신러닝 · calesthio/OpenMontage · Python
Key Point 프로 수준의 영상 제작이 이제 AI 프롬프트 하나로 가능해진다는 점이 제작 산업의 지형을 바꿀 가능성을 보여준다.
핵심 요약
AI 에이전트가 대본 작성부터 편집, 렌더링까지 영상 제작 전 과정을 자동화하는 오픈소스 시스템 OpenMontage를 공개했다. 12개의 프로덕션 파이프라인과 100여 개 도구, 700여 개의 에이전트 스킬 파일을 제공한다. 단순 이미지 애니메이션이 아닌 실제 영상: 자유 스톡 영상과 오픈 아카이브에서 영상을 수집해 타임라인에 편집하고 렌더링한다. 전체 요약 5문장 읽기 → 017 20:31 당일 +506 수학 영상 제작 전문 애니메이션 엔진 Manim Manim은 수학 설명 영상 제작을 위한 정밀한 프로그래밍 애니메이션 엔진입니다. 오픈소스 · 도구 · 3b1b/manim · Python
Key Point GitHub Trending에서 오늘 스타 506개를 얻으며 높은 관심을 받고 있는 수학/교육 콘텐츠 제작 도구입니다.
핵심 요약
Manim은 수학 설명 영상 제작을 위한 정밀한 프로그래밍 애니메이션 엔진입니다. 3Blue1Brown 채널의 영상 제작용으로 시작된 프로젝트이며, 2020년 커뮤니티 에디션으로도 포크되었습니다. Python 3.10 이상에서 작동하며 FFmpeg, OpenGL, LaTeX(선택사항) 등의 시스템 의존성이 필요합니다.