쌓인 기록에서 찾기
무엇을 찾으세요?
날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위부터 2026년 10월 30일 (금)까지3636건
4건 · "장황함"조건 지우기 ×
001▲ 131 · 댓글 95Qwen 4B 모델의 AI 특유 문체 제거 파인튜닝Qwen3-4B 기반 파인튜닝 모델을 공개했는데, AI 글쓰기의 특징적인 문체(뻔한 표현, 장황함)를 제거하도록 훈련했다.AI · 머신러닝 · Show HN: Qwen3-4B with the AI writing tics trained out
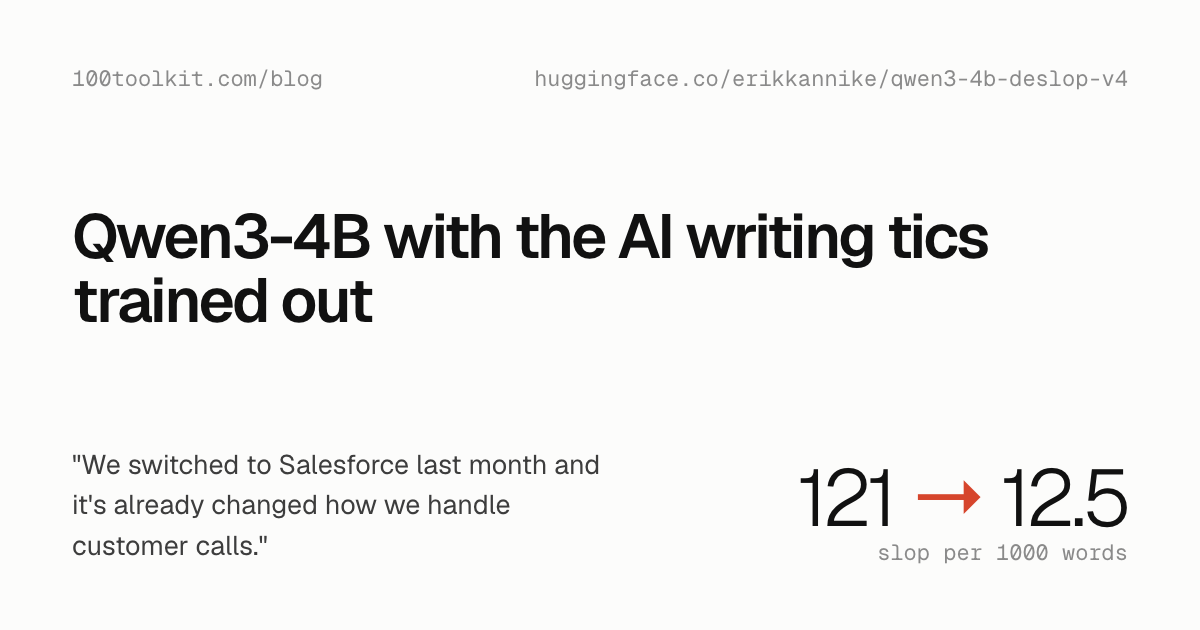
Key Point소형 오픈 모델에서 AI 특유의 문체적 결함을 체계적으로 제거한 방법론을 공개했으며, 실행 가능한 샘플과 함께 재현 가능한 파인튜닝 결과를 제시했다.
핵심 요약
- Qwen3-4B 기반 파인튜닝 모델을 공개했는데, AI 글쓰기의 특징적인 문체(뻔한 표현, 장황함)를 제거하도록 훈련했다.
- 양자화된 Q4_K_M 버전(2.5GB)은 Ollama나 llama.cpp로 노트북에서 바로 실행되며, 전체 가중치는 transformers 라이브러리로 로드할 수 있다.
- LoRA 어댑터(126MB)와 뉴런 편집(175바이트)을 분리하여 제공하는데, 두 가지가 함께 동작하도록 훈련됐다.
전체 요약 10문장 읽기 →AI · 머신러닝 · My old job feels distant now
Key Point개발자의 일이 AI 발전에 따라 어떻게 실제로 변해왔는지, 검색 대체에서 진정한 협업으로의 전환 과정을 구체적으로 보여준다.
핵심 요약
- ChatGPT 초기에는 검색 엔진처럼 사용했으나, 점차 Ruby 코드 작성처럼 구체적인 코드 생성 도구로 활용하기 시작했다.
- Cursor와 탭 완성은 IDE 통합이 자연스러웠으나, 본격적인 진전은 새로운 도메인(컴퓨터 비전)에서 ChatGPT로 API 검색과 코드 생성을 결합했을 때였다.
- 할루시네이션을 모델의 한계 신호로 읽고 스스로 빈틈을 채우며 학습했으며, 이는 SEO 스팸과 불완전한 문서의 문제를 우회하는 경험이었다.
전체 요약 11문장 읽기 →기타 · Why is every rationalist blog post way too long?
Key Point긴 글이 깊이 있는 분석이라는 통념에 가정하는 온라인 커뮤니티의 사고방식 문제를 제기하며, 실제로는 지혜로운 선별 능력 부재를 드러낸다.
핵심 요약
- 저자는 스콧 알렉산더의 25,000자 글을 읽고 자신의 2,700자 글과 비교하며, 이성주의 블로그 커뮤니티의 과도한 장황함 문제를 지적한다.
- 엘리저 유드코프스키의 시리즈는 100만 자 이상이고, 이 생태계의 거의 모든 글이 지나치게 길고 지루하다고 지적한다.
- 문제는 이들이 글의 길이로 신뢰성을 입증하려 하며, 초반의 핵심 가정을 검증하기보다 세부 사항만 계속 추가한다는 것이다.
전체 요약 7문장 읽기 →AI · 머신러닝 · BiasReducer: Adaptive Bias Mitigation for Reward Models

Key PointLLM 학습을 안내하는 보상 모델의 숨겨진 편향을 재학습 없이 교정할 수 있는 방법이 나왔으므로, 보상 모델 기반 LLM 최적화의 신뢰성을 높일 수 있다.
핵심 요약
- LLM의 보상 모델은 길이나 자신감 같은 피상적 특성에 편향되어 정확하지 않지만 점수가 높은 응답을 만드는 문제가 있다.
- 기존 편향 완화 방식은 모델 재학습이 필요하거나 알려진 편향 하나에만 고정된 교정을 적용하는 한계가 있다.
- BiasReducer는 보상 모델의 선형 헤드만 편집하고 각 데이터셋마다 맞춤형 편향 교정을 선택하는 경량 프레임워크다.
전체 요약 8문장 읽기 →