쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 3일 (화)까지 3800건
24건 · "SPARK"조건 지우기 ×
001 06:11 ▲ 100 · 댓글 25 로컬 개발 환경용 Databricks 에뮬레이터 MiniLake 공개 Databricks API를 로컬 머신에서 에뮬레이션하는 오픈소스 도구 MiniLake를 출시했다. SQL은 DuckDB에서, Delta 테이블은 실제 파일로, 작업은 컨테이너의 spark-submit으로 실행된다. 인프라 · 데브옵스 · MiniLake Is a Local Databricks API Emulator with SQL, Delta Lake and Spark
Key Point 개발자는 실제 Databricks 코드를 작성·테스트하지만 로컬에서 가짜 API로 거치고 싶을 때가 많은데, 이제 진정한 Delta 파일과 Spark 작업을 로컬 머신에서 돌릴 수 있게 되었다.
핵심 요약
Databricks API를 로컬 머신에서 에뮬레이션하는 오픈소스 도구 MiniLake를 출시했다. SQL은 DuckDB에서, Delta 테이블은 실제 파일로, 작업은 컨테이너의 spark-submit으로 실행된다. databricks-sdk, Databricks CLI, Terraform, MCP 에이전트를 localhost:8000으로 가리켜 사용할 수 있으며 어떤 토큰도 인증된다. pip install이나 docker run으로 설치하고 초기화된 SQL 워크스페이스 UI에 접근할 수 있다. Unity Catalog은 CRUD 지원 카탈로그·스키마·테이블·볼륨을 제공하며 각 카탈로그는 자체 DuckDB 데이터베이스 파일이므로 세 부분 주소 지정이 기본으로 작동한다. 전체 요약 15문장 읽기 → 002 09:11 ▲ 106 · 댓글 17 엔비디아, 40개 언어 지원하는 오픈 음성인식 모델 공개 엔비디아가 Nemotron 3.5 Transcribe 모델을 공개했으며, 40개 언어 음성을 텍스트로 변환하고 31개 언어 간 번역, 13개 언어의 화자 구분을 모두 하나의 체크포인트에서 수행한다. AI · 머신러닝 · Nvidia Nemotron 3.5 Transcribe: open ASR for 40 languages
Key Point 음성-텍스트 변환이 대규모 언어모델의 다음 병목이 되는 시점에 40개 언어를 지원하고 프롬프트·미세조정으로 도메인 적응이 가능한 오픈 모델이 공개됨에 따라, 음성 애플리케이션 개발 환경이 크게 바뀐다.
핵심 요약
엔비디아가 Nemotron 3.5 Transcribe 모델을 공개했으며, 40개 언어 음성을 텍스트로 변환하고 31개 언어 간 번역, 13개 언어의 화자 구분을 모두 하나의 체크포인트에서 수행한다. 최대 1시간 길이 음성을 처리하고 최대 8명의 화자를 레이블링하며, 자연어 프롬프트로 출력을 제어할 수 있어 의료 받아쓰기·다국어 회의 등 도메인별 요구에 맞춘 결과를 얻을 수 있다. Hugging Face 오픈 ASR 리더보드 영어 부문에서 5.33% 평균 WER로 오픈 가중치 모델 중 1위, Artificial Analysis 레더보드에서 약 4B 활성 매개변수로 2.8% AA-WER을 달성해 파레토 경계에 위치한다. 전체 요약 12문장 읽기 → 003 18:11 ▲ 100 · 댓글 73 webOS TV를 로컬 기반 스마트 TV로 재개발하는 프로젝트 리눅스 컴퓨터에서 Chromium을 실행하고 TV는 디스플레이로만 사용하는 방식으로 webOS TV의 기본 홈 화면, 브라우저, 음성 어시스턴트를 교체하는 프로젝트다. 하드웨어 · 시스템 · Show HN: Making a smart TV dumb and then smart
Key Point webOS TV 펌웨어 수정을 통해 로컬 제어 기반의 스마트 TV를 만드는 구체적인 기술 구조와 제약·위험 요소를 보여준다.
핵심 요약
리눅스 컴퓨터에서 Chromium을 실행하고 TV는 디스플레이로만 사용하는 방식으로 webOS TV의 기본 홈 화면, 브라우저, 음성 어시스턴트를 교체하는 프로젝트다. TV 펌웨어의 특정 빌드 버전을 대상으로 루트 권한으로 벤더 시스템 서비스를 수정하므로 보증 소실 위험이 있으며, 재부팅이나 초기화 전까지 TV를 사용할 수 없을 수 있다. 원격 컨트롤러의 음성 입력, 홈 화면 라우팅, 네이티브 음성 캡처 등이 벤더 서비스를 후킹하며, 펌웨어 SHA-256 핀과 코드 오프셋이 특정 빌드에만 유효하다. 전체 요약 12문장 읽기 → 004 21:11 당일 +152 오픈소스 AI 오피스, Word·Excel·파워포인트 네이티브 편집 GenOffice는 무료 오픈소스 AI 오피스 스위트로, Word(.docx), Excel(.xlsx), PowerPoint(.pptx) 파일을 네이티브 형식으로 편집하고 PDF, 마크다운, HTML도 지원한다. 오픈소스 · 도구 · genspark-ai/genoffice · TypeScript
Key Point AI 에이전트가 Word·Excel·파워포인트를 실제 파일 형식으로 편집할 수 있는 오픈소스 도구로, 코딩 어시스턴트 통합을 통해 개발 워크플로우를 확장하는 새로운 경로를 열었다.
핵심 요약
GenOffice는 무료 오픈소스 AI 오피스 스위트로, Word(.docx), Excel(.xlsx), PowerPoint(.pptx) 파일을 네이티브 형식으로 편집하고 PDF, 마크다운, HTML도 지원한다. AI 에디터는 추적 변경(Docs), 실제 수식과 차트(Sheets), 캔버스에 그린 슬라이드(Slides) 등 각 문서 유형에 맞게 동작하며, 모든 AI 편집은 스냅샷으로 저장되어 롤백할 수 있다. 파일은 로컬에서 열고 저장되고, PDF 변환·마크다운 렌더링·HTML 빌드 모두 기기에서 실행되며 AI 호출만 외부로 나간다. 전체 요약 9문장 읽기 → 005 16:56 ▲ 620 · 댓글 215 DeepSeek, 자체 추론 엔진 오픈소스로 공개 딥시크가 자사 대규모 서비스에 쓰이는 고성능 추론 프레임워크 DeepInfer를 오픈소스로 공개했다. AI · 머신러닝 · DeepSeek just open-sourced its inference engine
Key Point 딥시크의 대규모 서빙에 검증된 고성능 추론 엔진이 오픈소스화되어, LLM 배포를 다루는 개발자들이 프로덕션 수준의 최적화 기법을 직접 활용할 수 있게 되었다.
핵심 요약
딥시크가 자사 대규모 서비스에 쓰이는 고성능 추론 프레임워크 DeepInfer를 오픈소스로 공개했다. 지원 모델은 DeepSeek-V4.1-Flash이며, FlashMLA, DeepGEMM, DeepEP 등 최적화된 커널과 MoE 전문가 병렬화, 비동기 스케줄링, 배치 불변 추론 등 대규모 서빙에 필요한 핵심 기능을 포함한다. DSpark와 신뢰도 기반 검증으로 드래프트 토큰을 통해 디코딩을 가속화하며, 설정 파라미터로 최대 드래프트 길이(기본값 5)를 조절할 수 있다. 전체 요약 9문장 읽기 → 006 09:11 ▲ 156 · 댓글 69 RTX Spark 노트북에 Arch Linux 깔아 ARM 성능 검증했다 마이크로소프트 계정 강제와 Windows 기타 불편함 때문에 ASUS ProArt P16 H7607BA-SE033W(128GB RAM, 6,144 CUDA 코어, 2TB SSD)에 Arch Linux ARM을 설치했다. 하드웨어 · 시스템 · Putting Linux on my RTX Spark laptop because I don't have a Microsoft account
Key Point Windows 의존성 없이 ARM 노트북의 전체 성능(CPU·메모리·GPU 추론)을 Linux에서 동일하게 재현할 수 있음을 구체적 수치로 입증해, 폐쇄형 OS에 갇히지 않고 오픈 모델을 로컬에서 실행하려는 개발자에게 실질적 대안을 제시한다.
핵심 요약
마이크로소프트 계정 강제와 Windows 기타 불편함 때문에 ASUS ProArt P16 H7607BA-SE033W(128GB RAM, 6,144 CUDA 코어, 2TB SSD)에 Arch Linux ARM을 설치했다. Arch Linux 패키지 유지보수자인 저자가 NVIDIA 커널 작업, ACPI 오버라이드, 펌웨어 추출을 통해 부팅 가능한 설정을 구성했으며, 키보드·오디오·디스플레이(3840×2400, 120Hz) 지원을 추가했다. CPU 성능 테스트에서 Linux 7-Zip 26.04는 Windows와 단일 스레드에서 거의 동등(±1%)하고, 20스레드에서는 압축 5%, 압축 해제 2.7% 더 빠른 결과를 기록했다. 전체 요약 8문장 읽기 → 007 15:11 ▲ 20 · 댓글 2 에이전트 AI 추론을 위한 '히스토리 프리' 추측 디코딩 DLite 추측 디코딩은 경량 드래프트 모델로 토큰을 생성하고 타겟 모델이 검증하는 방식으로 LLM 추론을 가속화하는 기법이지만, 에이전트 AI 워크로드의 긴 맥락과 다중 턴 상호작용에서는 드래프트 모델의 토큰 승인률이 최대 80% 저하된다. AI · 머신러닝 · DLite: History-free Speculative Decoding for Agentic AI
Key Point 에이전트 AI 같은 긴 맥락의 상호작용형 워크로드에서 LLM 추론 속도를 크게 높일 수 있는 새로운 접근 방식을 제시합니다.
핵심 요약
추측 디코딩은 경량 드래프트 모델로 토큰을 생성하고 타겟 모델이 검증하는 방식으로 LLM 추론을 가속화하는 기법이지만, 에이전트 AI 워크로드의 긴 맥락과 다중 턴 상호작용에서는 드래프트 모델의 토큰 승인률이 최대 80% 저하된다. 기존 방식은 역사적 KV 캐시를 유지함에 따라 시스템 오버헤드가 커진다. 연구팀은 증가하는 역사적 맥락이 두 문제의 공통 원인임을 파악하고, DLite라는 '히스토리 프리' 추측 디코딩 프레임워크를 제안했다. 전체 요약 7문장 읽기 → 008 03:11 ▲ 169 · 댓글 82 Mac Studio에서 816B 모델 실행, MLX의 분산 추론 기능 공개 Apple이 MLX 최신 버전을 공개하며 Mac Studio에서 Muse Spark Open(816B 파라미터, MoE 모델)을 실행할 수 있음을 시연했다. AI · 머신러닝 · Apple ML Research: Muse Spark Open with MLX on Mac Studio
Key Point Apple silicon 기반 로컬 LLM 실행 성능이 가속도 구간에 접어들었으며, 816B 모델을 Mac Studio 클러스터에서 실행할 수 있는 기술 기반이 완성되었기 때문이다.
핵심 요약
Apple이 MLX 최신 버전을 공개하며 Mac Studio에서 Muse Spark Open(816B 파라미터, MoE 모델)을 실행할 수 있음을 시연했다. 단일 Mac Studio(M5 Ultra, 512GB 통합 메모리)에서 27B~128B 규모 모델(Qwen 3.8, Mistral Medium 3.5)은 정상 작동하며, TTFT는 M3 대비 최대 4.6배 빨라졌고 토큰 생성 속도는 1.6배 향상됐다. M5 Ultra의 GPU 신경 가속기는 행렬 곱셈 연산을 전담하여 컴퓨팅 한계 작업을 가속화하고, 통합 메모리 대역폭이 819GB/s에서 1.2TB/s로 증가해 메모리 한계 작업을 개선했다. 전체 요약 12문장 읽기 → 009 16:56 당일 +900 Docker 한 줄로 띄우는 무료 영상 통합 검색 플랫폼 Next.js 15 기반의 오픈소스 영상 집계 및 스트리밍 플랫폼 LibreTV를 공개했다. 오픈소스 · 도구 · LibreSpark/LibreTV · TypeScript
Key Point Docker 한 줄로 자체 영상 스트리밍 플랫폼을 구축할 수 있으며, 기존의 불안정한 공개 서비스에 의존하지 않고 여러 소스의 콘텐츠를 통합 관리할 수 있게 해준다.
핵심 요약
Next.js 15 기반의 오픈소스 영상 집계 및 스트리밍 플랫폼 LibreTV를 공개했다. 다양한 영상 소스를 병렬 검색하고, 같은 제목의 영상은 하나로 합쳐서 여러 출처의 소스를 비교하며 선택할 수 있다. ArtPlayer와 hls.js 기반 플레이어는 광고 제거, 자동 연속재생, 배속, 모바일 3배속 등을 지원한다. 전체 요약 14문장 읽기 → 010 06:11 ▲ 443 · 댓글 269 메타, 816B 파라미터 오픈 모델 뮤즈 스파크 공개 메타가 코딩과 에이전트 작업에 최적화된 뮤즈 스파크 오픈을 공개했으며, 이는 미국에서 가장 강력한 오픈 웨이트 모델이다. AI · 머신러닝 · Muse Spark Open
Key Point 오픈 웨이트 대형 모델을 처음으로 개인 데스크톱에서 네이티브로 실행할 수 있게 되면서, 클라우드 의존도를 줄이고 로컬에서 고급 AI 기능을 활용할 수 있는 새로운 가능성이 열렸다.
핵심 요약
메타가 코딩과 에이전트 작업에 최적화된 뮤즈 스파크 오픈을 공개했으며, 이는 미국에서 가장 강력한 오픈 웨이트 모델이다. 모델은 총 816B 파라미터(활성 42B)를 가진 네이티브 멀티모달 모델로 1M 토큰 컨텍스트 윈도우를 지원한다. 처음으로 Apple M5 Ultra Mac Studio 2대에서 최신 MLX 프레임워크를 사용해 데스크톱에서 직접 실행 가능하다. 전체 요약 11문장 읽기 → 011 03:12 새 버전 트랜스포머 5.20.0: 메타 뮤즈 스파크 오픈 등 6개 신규 모델 지원 메타의 멀티모달 혼합 전문가 모델 뮤즈 스파크 오픈(Muse Spark Open)을 추가했다. 총 816B 파라미터(토큰당 활성 42B)이며 최대 1,048,576 토큰의 맥락 창을 지원하고 다중 파일 편집·디버깅·도구 사용 등 에이전틱 코딩 작업을 위해 학습됐다. AI · 머신러닝 · huggingface/transformers@v5.20.0
Key Point 메타·알렉스 알파·바이두 등 주요 기업의 첨단 멀티모달·OCR·오디오 모델 6개가 한 번에 지원되고, 분산 학습·추론·양자화 내보내기 등 프로덕션 기능이 대폭 개선되어 트랜스포머 사용자에게 즉시 영향을 미친다.
핵심 요약
메타의 멀티모달 혼합 전문가 모델 뮤즈 스파크 오픈(Muse Spark Open)을 추가했다. 총 816B 파라미터(토큰당 활성 42B)이며 최대 1,048,576 토큰의 맥락 창을 지원하고 다중 파일 편집·디버깅·도구 사용 등 에이전틱 코딩 작업을 위해 학습됐다. InclusionAI의 Ling 3.0 Flash는 5개 KDA 레이어와 1개 MLA 레이어를 결합한 혼합 전문가 모델로 BailingHybridForCausalLM으로 네이티브 지원되어 trust_remote_code=True 없이 로드된다. 알렉스 알파의 Kolibri 1은 독일어·영어 중심 추론 모델로, 50개 레이어가 384명의 전문가 중 6명에게 각 토큰을 시그모이드 라우팅으로 라우팅하고 슬라이딩 윈도우와 전체 어텐션 레이어를 번갈아 사용한다. 전체 요약 13문장 읽기 → 012 15:11 ▲ 69 · 댓글 5 사용자 행동으로 LLM 학습하는 Vela 프레임워크 현재 LLM은 정적 텍스트나 합성 데이터로만 학습되어 사용자의 선호도·의도·미래 행동을 장기간 행동 데이터에서 추론하는 능력이 부족하다. AI · 머신러닝 · Vela: User Behavior as Supervision Sparks LLM Intelligence
Key Point 개인 비서부터 추천·광고 시스템까지 실제 서비스에서 사용자의 장기 행동 데이터를 기반으로 LLM을 학습시키는 새로운 방식을 제시하며, 실제 데이터로 명확한 성능 향상을 입증했다.
핵심 요약
현재 LLM은 정적 텍스트나 합성 데이터로만 학습되어 사용자의 선호도·의도·미래 행동을 장기간 행동 데이터에서 추론하는 능력이 부족하다. Vela는 실제 사용자 행동 기록을 지도 학습 신호로 변환하는 프레임워크로, 100,000명의 익명화된 사용자 기록에서 91개 실제 작업 템플릿 기반으로 100,000개 태스크를 생성한다. 난이도 기반 필터링과 궤적 선정 기준을 통해 약 75,000개의 학습용 궤적을 선별한다. 전체 요약 6문장 읽기 → 013 06:11 ▲ 123 · 댓글 76 맥용 로컬 음성 받아쓰기 'BetterWispr' 오픈소스 공개 macOS 14 이상에서 실행되는 무료 오픈소스 받아쓰기 앱으로, Option+Space를 누르고 말하면 자동으로 텍스트로 변환된다. 오픈소스 · 도구 · Show HN: BetterWispr – Free, open-source dictation for Mac
Key Point 로컬 처리와 오픈소스라는 조건에서 계정 없이 완전한 음성 받아쓰기를 맥에서 구현하는 방식이 새로워, 개인정보 보호와 오프라인 사용을 중시하는 사용자들에게 실질적 대안이 된다.
핵심 요약
macOS 14 이상에서 실행되는 무료 오픈소스 받아쓰기 앱으로, Option+Space를 누르고 말하면 자동으로 텍스트로 변환된다. Apple Silicon 권장이며 Apple 음성, Parakeet(영어, 일본어, 유럽 25개 언어 지원), Whisper 등 9가지 내장 모델 중 선택할 수 있고 Sarvam AI나 OpenAI 호환 API도 사용 가능하다. 모든 음성 처리와 모델 실행이 로컬에서 이루어지며, 클라우드 폴백이 없고 계정이나 API 키도 필요 없다. 전체 요약 9문장 읽기 → 014 09:11 ▲ 124 · 댓글 43 DuckDB 2.0이 2~3배 빨라진 이유 DuckDB 2.0 알파가 출시됐으며, S3 쿼리, 깊은 계층 구조 처리, JSON 저장소에서 주요 성능 향상을 달성했다. 인프라 · 데브옵스 · Why DuckDB 2.0 is faster
Key Point S3 쿼리가 2~3배 빨라지고 깊은 계층 구조 처리는 100배 이상 빨라지는 등 실제 데이터 파이프라인의 병목을 직접 해결하는 기능들이 핵심이다.
핵심 요약
DuckDB 2.0 알파가 출시됐으며, S3 쿼리, 깊은 계층 구조 처리, JSON 저장소에서 주요 성능 향상을 달성했다. 비동기 I/O 기능: 별도 스레드 풀이 데이터를 미리 다운로드하면서 CPU와 네트워크를 동시에 활용하며, S3에서 2.2GB 파일 읽기가 18.8초에서 7.7초로 단축됐다. read_ahead_depth 설정(기본값 -1)으로 자동 활성화되며, 이전 동작으로 돌리려면 0으로 설정하면 된다. 전체 요약 12문장 읽기 → 015 00:11 ▲ 12 · 댓글 2 투기적 디코딩에서 불필요한 검증을 줄이는 DLoop 기법 큰 언어 모델의 자동회귀 생성을 가속하는 투기적 디코딩은 경량 초안 모델이 토큰을 제안하면 목표 모델이 이를 검증하는 방식으로 작동한다. AI · 머신러닝 · DLoop: Looped Speculative Decoding
Key Point LLM 추론 속도는 산업 전반의 핵심 과제인데, DLoop가 기존 투기적 디코딩 방식들의 근본 한계를 해결하고 다양한 방법에 범용적으로 적용 가능하다는 점이 중요합니다.
핵심 요약
큰 언어 모델의 자동회귀 생성을 가속하는 투기적 디코딩은 경량 초안 모델이 토큰을 제안하면 목표 모델이 이를 검증하는 방식으로 작동한다. 초안 모델의 성능이 높아지면 목표 모델이 제안된 토큰 전체를 자주 수락하는데도, 매 초안 단계 후 불필요한 검증 및 목표 모델 연산이 반복된다. 기존 적응형 초안 길이 방식들은 자동회귀 초안 모델에서만 속도 향상을 주고, 병렬 초안 모델의 경우 검증되지 않은 토큰의 목표 모델 은닉 상태가 필요해 한계가 있다. 전체 요약 7문장 읽기 → 016 18:30 ▲ 17 · 댓글 2 광고 영상 생성용 대규모 데이터셋 'AdSpark' 공개 제품 정체성을 보존하면서 판매 포인트를 다중 장면 내러티브로 표현하는 광고 영상 생성 연구를 위해 AdSpark 데이터셋과 벤치마크를 발표했다. AI · 머신러닝 · AdSpark: A Large-Scale Dataset and Benchmark for Product-Centric Advertisement Video Generation
Key Point 제품 광고 영상 생성이라는 새로운 작업을 위해 처음으로 대규모 구조화 데이터셋과 다차원 평가 프레임워크를 제시해, 이 분야 연구의 기초를 마련한다.
핵심 요약
제품 정체성을 보존하면서 판매 포인트를 다중 장면 내러티브로 표현하는 광고 영상 생성 연구를 위해 AdSpark 데이터셋과 벤치마크를 발표했다. AdSpark-300K는 이커머스 플랫폼 데이터를 바탕으로 약 30만 개의 이미지-프롬프트-영상 3쌍으로 구성되며, 실제 데이터와 합성 데이터 부분집합을 포함한다. 각 샘플에는 제품 식별 주석, 판매 포인트 설명, 창의적 계획, 정렬된 음성 스크립트 등 구조화된 광고 주석이 포함되어 있다. 전체 요약 6문장 읽기 → 017 18:30 ▲ 94 · 댓글 2 로봇 실시간 제어, 영상 메모리 19초 활용하면 성공률 63→79% 로봇의 실시간 제어에는 충분한 영상 히스토리가 필요하지만, 이를 처리하는 과정에서 지연이 발생한다. AI · 머신러닝 · Long-WAM: Scaling the Context of World-Action Models
Key Point 로봇 제어에서 짧은 지연(107ms)로 19초 영상 메모리를 활용하면서 복잡한 조작 작업에서 대폭 높은 성공률을 달성한 실시간 배포 기술이기 때문이다.
핵심 요약
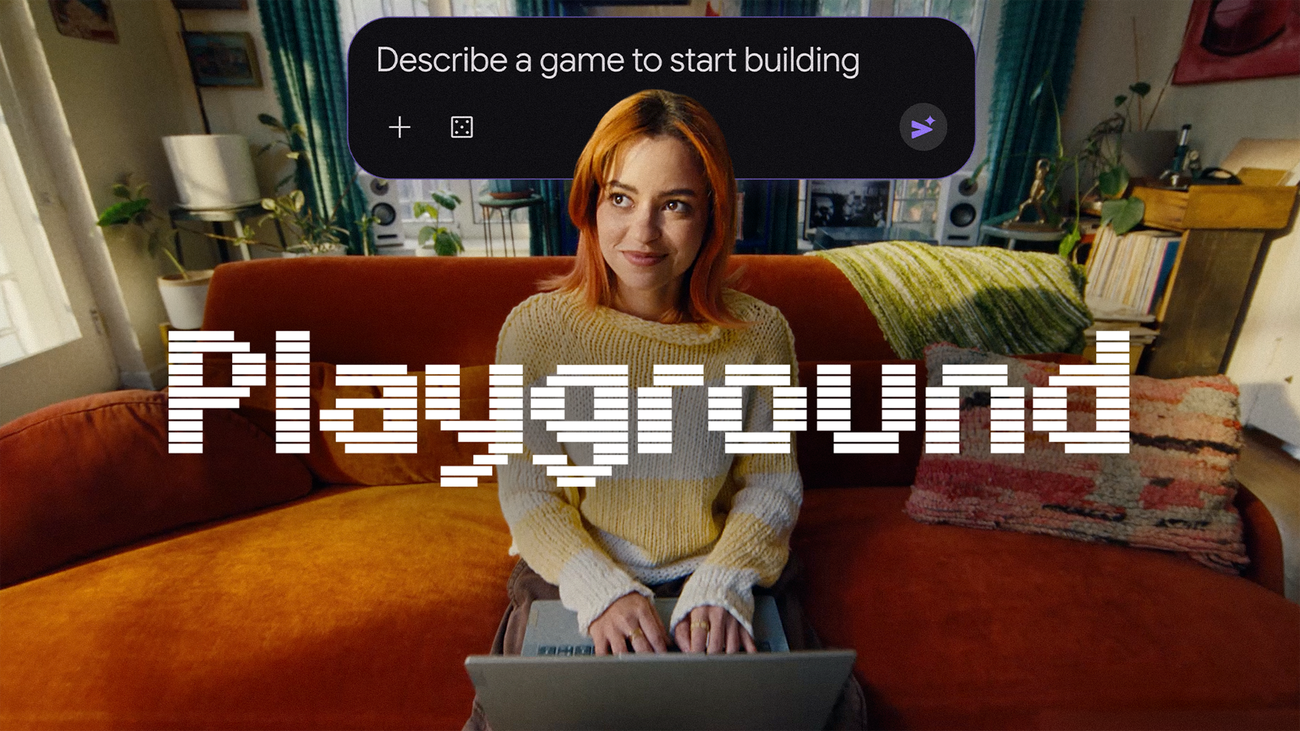
로봇의 실시간 제어에는 충분한 영상 히스토리가 필요하지만, 이를 처리하는 과정에서 지연이 발생한다. Long-WAM은 실시간 제어 제약 속에서 인과적 세계-행동 모델의 맥락을 확장하기 위한 모델-시스템 프레임워크이다. 핵심 발견: 긴 히스토리에 접근하는 것과 실제로 사용하는 것은 다르며, 비디오 기초 모델이 자기회귀(AR) 방식으로 사전학습될 때 더 큰 이득이 난다. 전체 요약 12문장 읽기 → 018 18:30 ▲ 144 · 댓글 221 구글, 코딩 없이 게임 만드는 'Playground' 공개 구글이 AI 기반 게임 제작 플랫폼 'Playground'를 미국 18세 이상 사용자 대상으로 정식 출시했다. AI · 머신러닝 · Google Playground: Create and play custom games
Key Point 게임 개발의 진입장벽을 AI로 허물어 누구나 아이디어를 실제 게임으로 만들 수 있게 되는 기점이다.
핵심 요약
구글이 AI 기반 게임 제작 플랫폼 'Playground'를 미국 18세 이상 사용자 대상으로 정식 출시했다. 텍스트 프롬프트만으로 게임을 만들 수 있으며 코딩 경험이 없어도 처음부터 끝까지 창작 방향을 조종할 수 있다. 물리 엔진, 규칙, 캐릭터, 환경 등을 타이핑으로 수정하거나 기존 게임을 리믹스해 시작할 수 있다. 전체 요약 8문장 읽기 → 019 21:11 당일 +211 DeepSeek와 GLM을 개인 하드웨어에서 돌리는 경량 추론 엔진 공개 Salvatore Sanfilippo가 만든 DwarfStar는 DeepSeek V4/V4.1 Flash, GLM 5.2/5.3, Qwen3.8 Flash 등 주요 오픈웨이트 모델을 개인 하드웨어에서 실행하는 네이티브 추론 엔진으로, Metal·CUDA·ROCm을 지원한다. AI · 머신러닝 · antirez/ds4 · C
Key Point 개인 맥이나 워크스테이션에서 DeepSeek·GLM 같은 최신 고성능 모델을 실제로 돌릴 수 있는 구체적인 방법과 제약조건(메모리, SSD 스트리밍 필요 여부)이 명확해진다.
핵심 요약
Salvatore Sanfilippo가 만든 DwarfStar는 DeepSeek V4/V4.1 Flash, GLM 5.2/5.3, Qwen3.8 Flash 등 주요 오픈웨이트 모델을 개인 하드웨어에서 실행하는 네이티브 추론 엔진으로, Metal·CUDA·ROCm을 지원한다. 일반적인 GGUF 러너가 아니라 특정 모델 몇 개에 최적화된 자체 포함 C 코드이며, 프로젝트가 생산한 GGUF 파일만 사용한다. Metal은 애플 실리콘 맥(96GB 이상, 또는 SSD 스트리밍으로 더 작은 기계에서도 가능)을 주요 대상으로, CUDA는 DGX Spark와 Ada/L40S 카드를 포함한 다중 GPU 시스템을 지원하며, ROCm은 Strix Halo 같은 시스템을 대상으로 한다. 전체 요약 12문장 읽기 → 020 16:56 ▲ 125 · 댓글 35 Redis 만든 개발자, 로컬에서 돌리는 LLM 엔진 공개 Redis 개발자 안티레즈가 만든 DS4는 고성능 머신에서 DeepSeek V4, GLM 5.x, Qwen3.8 등 대규모 모델을 로컬에서 실행하는 C 기반 추론 엔진이다. AI · 머신러닝 · From the creator of Redis; run LLM locally with ds4
Key Point 가장 강력한 오픈 가중치 모델을 거대 클라우드 없이 자체 하드웨어에서 실행할 수 있게 되면서 AI 추론의 구조가 바뀐다.
핵심 요약
Redis 개발자 안티레즈가 만든 DS4는 고성능 머신에서 DeepSeek V4, GLM 5.x, Qwen3.8 등 대규모 모델을 로컬에서 실행하는 C 기반 추론 엔진이다. 284억 파라미터 DeepSeek V4 Flash 같은 혼합 전문가 모델을 고메모리 Mac(Metal), NVIDIA(CUDA), AMD(ROCm) 환경에서 지원한다. 핵심 기술은 라우팅 전문가만 2비트로 압축하되 중요한 공유 경로는 정밀하게 유지하는 비대칭 양자화로, 모델을 고메모리 머신에서 실행 가능하게 만든다. 전체 요약 9문장 읽기 → 021 09:11 ▲ 102 · 댓글 64 AI PC 브랜드 'Copilot+'는 이미 역사 마이크로소프트와 퀄컴이 2024년 출범한 'Copilot+ PC' 카테고리는 NPU 45 TOPS 이상과 같은 기준으로 AI 기반 윈도우 기기를 정의하고 Recall 같은 독점 기능을 제공할 예정이었다. 하드웨어 · 시스템 · The Copilot+ PC brand is dead
Key Point Copilot+ PC 브랜드가 공식적으로 사라지고 있으며, 출시 후 보안 결함과 시장 반응 부진으로 인해 마이크로소프트가 자신의 AI PC 전략을 은근히 방향 전환하고 있음을 보여준다.
핵심 요약
마이크로소프트와 퀄컴이 2024년 출범한 'Copilot+ PC' 카테고리는 NPU 45 TOPS 이상과 같은 기준으로 AI 기반 윈도우 기기를 정의하고 Recall 같은 독점 기능을 제공할 예정이었다. 하지만 Recall이 심각한 보안 결함을 가진 것으로 적발되면서 출시 직후 백래시를 받았고, 이 기능이 지연되면서 Copilot+ PC 브랜드는 타격을 입었다. 현재 마이크로소프트와 OEM 업체들은 마케팅 자료와 제품명에서 'Copilot+ PC' 명칭을 조용히 빼고 있다. 전체 요약 9문장 읽기 → 022 00:10 ▲ 255 · 댓글 176 Bend 2가 빠진 형식 검증의 표준 방식 Bend 2는 AI가 코드를 작성하고 증명을 통해 검증하는 언어로 소개되지만, 간단한 게임 규칙 검증에 442줄의 증명 코드를 필요로 한다. 오픈소스 · 도구 · Bend 2 and the Vibe-Coding Trap
Key Point 기존 형식 검증 분야의 성숙한 도구와 방식을 모르고 같은 문제를 더 복잡하게 재구성하는 것이 가능한 이유를 설명하며, 신생 언어/도구를 평가할 때 학문 기초의 중요성을 보여준다.
핵심 요약
Bend 2는 AI가 코드를 작성하고 증명을 통해 검증하는 언어로 소개되지만, 간단한 게임 규칙 검증에 442줄의 증명 코드를 필요로 한다. 저자는 이를 '비브 코딩의 함정'으로 지칭하며, 개발자가 충분한 분야 지식 없이 대규모 솔루션을 완성해 더 나은 방식을 놓친다고 비판한다. Bend의 웹페이지와 코드베이스에는 형식 검증(formal verification) 용어가 나타나지 않으며, 저자는 이 분야의 표준 언어인 SPARK로 동일한 프로그램을 작성해 12개 검사만으로 증명할 수 있음을 보인다. 전체 요약 4문장 읽기 → 023 16:56 ▲ 114 · 댓글 8 DeepSeek, KV 캐시 압축으로 추론 속도 420 토큰/초 달성 DeepSeek-v4.1 Flash는 552B 매개변수 멀티모달 모델로, 에이전트 워크플로우에서 증가하는 컨텍스트와 도구 호출로 인한 프리필 계산 부담을 해결하기 위해 설계됐다. AI · 머신러닝 · DeepSeek-v4.1 Flash: Pushing the Limits of KV Cache Compression
Key Point 에이전트 워크플로우에서 일반적인 병목인 장문맥 프리필 계산과 KV 캐시 저장 비용을 획기적으로 줄인 새로운 모델 아키텍처 설계가 장기 맥락 처리와 배포 비용 절감에 어떻게 영향을 미치는지 보여준다.
핵심 요약
DeepSeek-v4.1 Flash는 552B 매개변수 멀티모달 모델로, 에이전트 워크플로우에서 증가하는 컨텍스트와 도구 호출로 인한 프리필 계산 부담을 해결하기 위해 설계됐다. KV 캐시 압축을 위해 채널·시퀀스·레이어 세 차원에서 최적화를 진행했으며, 같은 시퀀스 길이에서 런타임 KV 캐시는 v4-Flash의 1/4, 영구 저장소는 1/8 수준으로 줄었다. Causal Encoder-Decoder(CED) 아키텍처를 도입해 프리필 단계에서 8B, 디코딩 단계에서 16B 매개변수만 활성화되도록 설계했으며, 이는 입력 중심의 에이전트 시나리오에 특히 효율적이다. 전체 요약 12문장 읽기 → 024 11:10 ▲ 143 · 댓글 53 vLLM이 AMD GPU에서 추측 디코딩 지원 vLLM이 추측 디코딩(speculative decoding) 기능을 AMD Instinct MI300X·MI355X GPU와 ROCm에서 구현했다. AI · 머신러닝 · Speculative Decoding in vLLM on AMD GPUs
Key Point LLM 추론 성능 최적화를 위한 주요 기법이 AMD GPU에서 실제 구현되어, 장기 생성 작업의 처리량 개선 가능성을 보여준다.
핵심 요약
vLLM이 추측 디코딩(speculative decoding) 기능을 AMD Instinct MI300X·MI355X GPU와 ROCm에서 구현했다. 추측 디코딩은 경량 드래프트 모듈이 여러 토큰을 먼저 제안하고 타겟 모델이 한 번에 검증하는 방식으로, 기존 자동회귀 디코딩보다 모델 통과 횟수를 줄인다. 표준 방식은 토큰 하나당 모델 실행 1회가 필요하지만, 추측 디코딩은 여러 드래프트 토큰이 검증을 통과하면 단일 모델 실행으로 여러 토큰을 커밋할 수 있다. 전체 요약 5문장 읽기 →