쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 3일 (화)까지 3800건
27건 · "기반 모델"조건 지우기 ×
001 21:11 ▲ 18 · 댓글 1 위조 탐지 AI, 딥페이크부터 변조 문서까지 한 번에 비디오·이미지·물리적 스푸핑 등 다양한 형태의 위조에 대응하는 통합 기반 모델 'Venus-DefakerOne2'를 공개했다. AI · 머신러닝 · Venus-DefakerOne2: A Vision-Forensics Foundation Model with Broader Coverage
Key Point 이진 분류 기반 위조 탐지 작업에서 다양한 매체와 위조 형태를 동시에 처리할 수 있는 통합 기반 모델의 등장으로, 위변조 탐지 기술의 범용성이 크게 높아졌다.
핵심 요약
비디오·이미지·물리적 스푸핑 등 다양한 형태의 위조에 대응하는 통합 기반 모델 'Venus-DefakerOne2'를 공개했다. 수천만 개의 오픈소스 및 사내 샘플로 학습했으며, LoRA와 전체 파라미터 튜닝을 번갈아 수행하는 'Tide-Style-Tuning' 기법으로 효율성과 일반화를 동시에 달성했다. 예측 엔트로피를 분석해 최적의 예측 방식을 자동으로 선택하는 'Entropy-based Test Adaptation'을 적용했다. 전체 요약 5문장 읽기 → 002 15:11 ▲ 23 · 댓글 2 자연어로 완성된 게임을 만드는 AI 프레임워크 VibeGame LLM 에이전트를 이용한 소프트웨어 개발은 가능했지만, 게임 개발처럼 코드·장면·에셋·애니메이션·물리·설정을 모두 조율해야 하는 작업은 여전히 도전 과제였다. AI · 머신러닝 · VibeGame: Prompt-to-Game Development with AI-Native Engine and Self-Evolving Adversarial Agent Team
Key Point LLM 에이전트로 복잡한 게임 개발 전 과정을 자동화할 수 있는 새로운 접근법을 제시하며, 특히 8개 에이전트의 협력 구조와 자기 진화 메커니즘이 AI 소프트웨어 개발 방법론의 진전을 보여준다.
핵심 요약
LLM 에이전트를 이용한 소프트웨어 개발은 가능했지만, 게임 개발처럼 코드·장면·에셋·애니메이션·물리·설정을 모두 조율해야 하는 작업은 여전히 도전 과제였다. VibeGame은 자연어 프롬프트와 선택적 참고 이미지로부터 완성된 2D 게임 프로젝트를 생성하는 프레임워크다. AI-native 게임 엔진은 프로젝트 상태를 스키마 검증된 구조화된 텍스트로 표현하고 프레임 동기식 런타임 제어를 제공해, 에이전트가 게임 상태를 검사하고 액션을 실행하며 동작을 자신의 속도로 검증할 수 있다. 전체 요약 7문장 읽기 → 003 03:11 ▲ 11 · 댓글 2 사전학습 데이터의 어휘 흔적이 모델 성능에 미치는 영향 제로샷 벤치마크 성능이 사전학습 말뭉치와 벤치마크 목표 간의 단어 수준 정렬에 얼마나 의존하는지 연구한 논문이다. AI · 머신러닝 · The Lexical Imprint of Pre-training Data
Key Point 사전학습 말뭉치의 어휘 특성이 모델의 제로샷 성능에 직접적인 영향을 미친다는 인과관계를 실증적으로 입증하며, 데이터 선택과 라우팅을 통한 성능 최적화의 가능성을 제시한다.
핵심 요약
제로샷 벤치마크 성능이 사전학습 말뭉치와 벤치마크 목표 간의 단어 수준 정렬에 얼마나 의존하는지 연구한 논문이다. 단어 단위 유니그램 교차 엔트로피(UCE)라는 토크나이저 무관의 모델 자유 지표를 제안해 참조 말뭉치와 목표 벤치마크 간 어휘 정렬을 측정한다. 우도 학습은 사전학습 말뭉치로부터 모델의 예측 분포를 형성하며, 우도 기반 평가의 제로샷 점수는 그 말뭉치와 벤치마크 사이의 어휘 정렬에 부분적으로 의존한다. 전체 요약 8문장 읽기 → 004 12:11 ▲ 14 · 댓글 3 추론 모델의 '대기' 토큰, RL이 아닌 학습 데이터에서 온다 추론 모델이 단계를 재검토하기 전에 {wait} 토큰을 쓰는 것이 강화학습(RL)의 성과로 여겨져 왔으나, RL이 이 현상을 만든 것이 아니라 학습 데이터에서 상속받은 것일 수 있다는 가설을 검증했다. AI · 머신러닝 · Inherited, Not Invented: Tracing the Provenance of Wait in Reasoning Models
Key Point 추론 모델의 향상이 실제로 RL의 효과인지 아니면 데이터 상속인지 구분해야 할 핵심 연구로, 모델 평가 방식과 RL 기술 검증의 신뢰성을 근본적으로 재검토하게 한다.
핵심 요약
추론 모델이 단계를 재검토하기 전에 {wait} 토큰을 쓰는 것이 강화학습(RL)의 성과로 여겨져 왔으나, RL이 이 현상을 만든 것이 아니라 학습 데이터에서 상속받은 것일 수 있다는 가설을 검증했다. 공개 모델의 학습 이력을 추적하며 빈도, 위치, 형태, 사용 방식을 라벨 없이 지수화하고 주입 오류 테스트로 {wait} 토큰의 출처를 분석했다. RL을 적용하지 않은 초기 모델(zero-RL)은 {wait} 토큰을 거의 생성하지 않으며, {wait}이 없는 기반 모델에 RL을 적용해도 MATH-500 정확도는 크게 올라가지만 {wait} 토큰 사용은 거의 증가하지 않는다. 전체 요약 7문장 읽기 → 005 12:11 ▲ 51 · 댓글 2 확산 모델의 특성을 선별하는 정책 기반 마스킹 기법 기존에 고정된 규칙으로 추출하던 확산 모델의 중간 특성을 동적으로 선택하는 Policy-Mask 기법을 제시한다. AI · 머신러닝 · Policy-Mask: Budget-Aware Adaptation of Diffusion Features to Discriminative Tasks
Key Point 차별적 작업에 확산 모델의 특성을 재활용할 때 수동으로 설정하던 추출 규칙을 자동으로 최적화해 다양한 시각 이해 작업에서 성능 향상을 실현한다.
핵심 요약
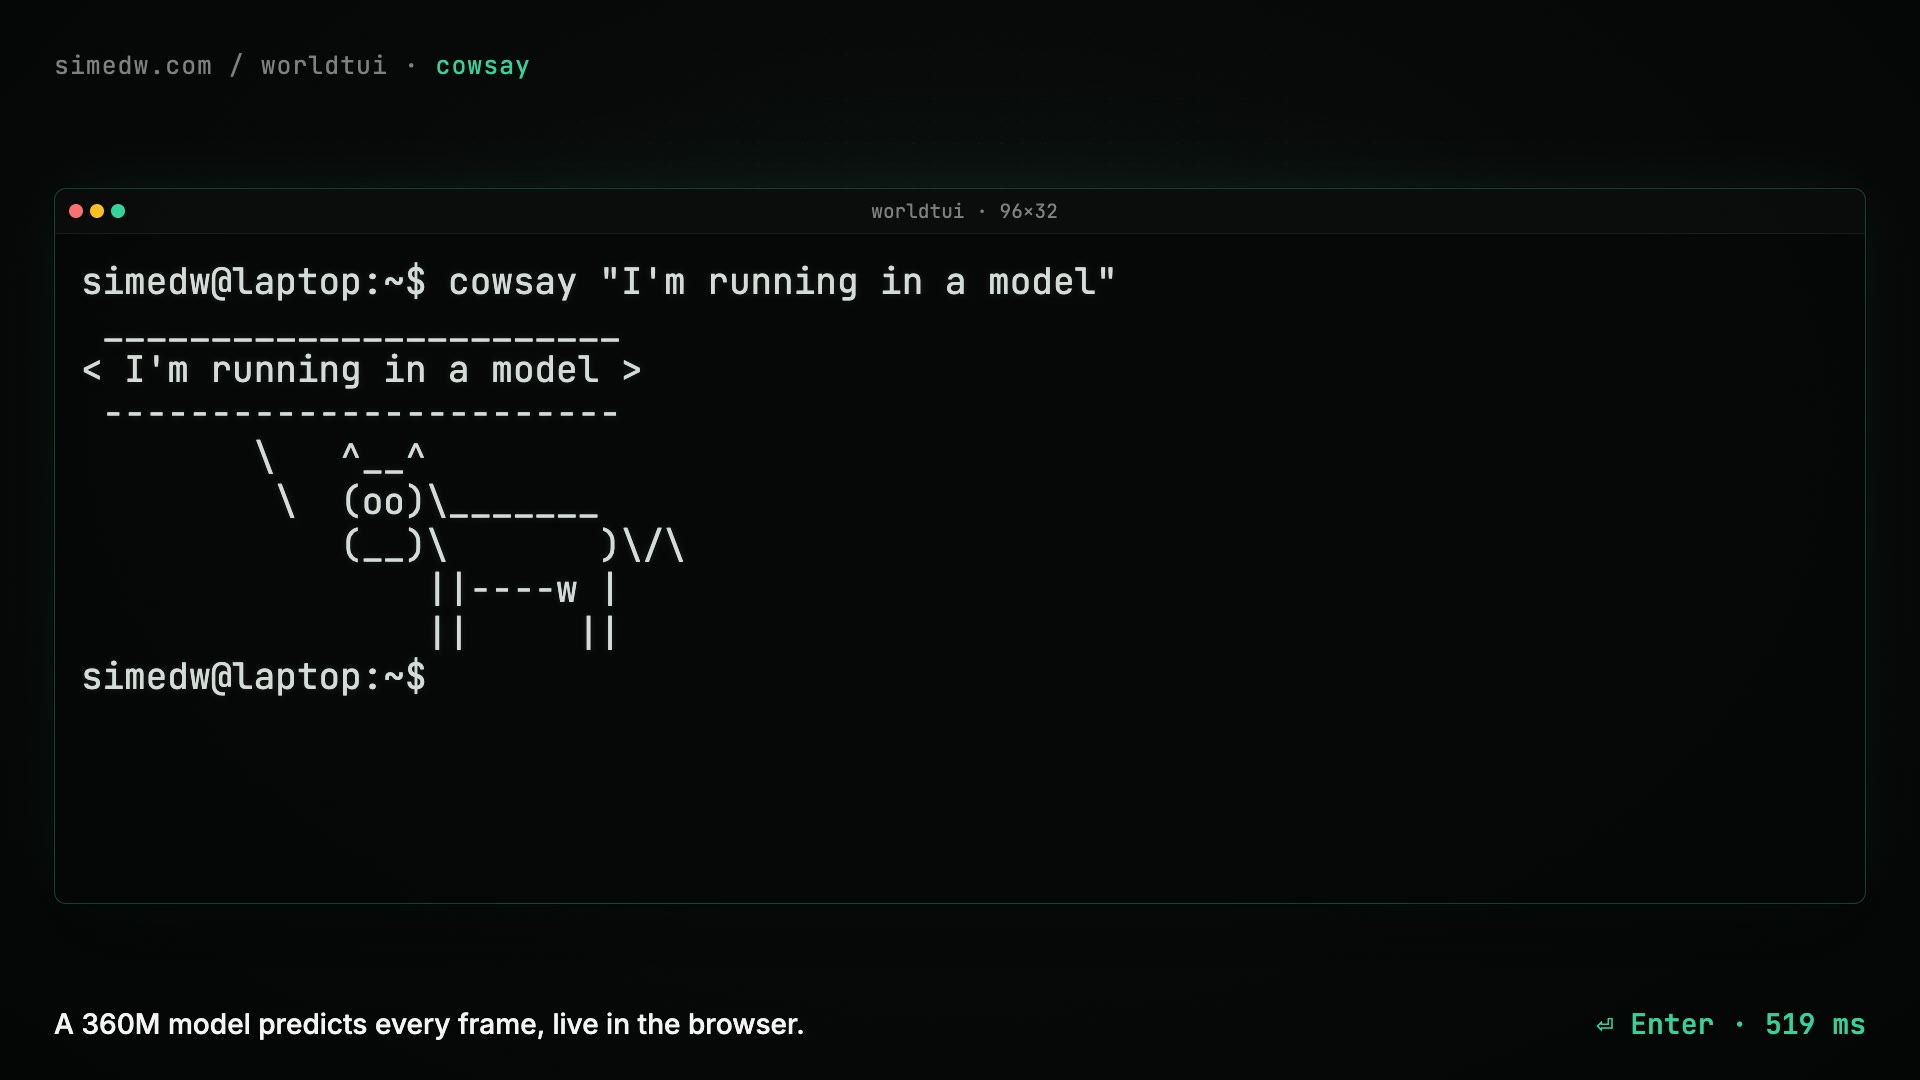
기존에 고정된 규칙으로 추출하던 확산 모델의 중간 특성을 동적으로 선택하는 Policy-Mask 기법을 제시한다. 확산 과정의 타임스텝, 네트워크 깊이, 채널 세 가지를 모두 함께 최적화하되, 채널 수 제한(예산)을 고려한다. 채널 점수가 선택된 채널 수에 따라 증가하는 문제를 정규화로 해결하여 세 개의 정책이 균형있게 학습되도록 한다. 전체 요약 6문장 읽기 → 006 18:11 ▲ 169 · 댓글 53 360M 모델로 터미널 에뮬레이터 만들기 360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. AI · 머신러닝 · WorldTUI: I trained a 360M model to pretend to be a terminal
Key Point 시뮬레이션·에뮬레이션 구현 없이 자가 수정 학습과 병렬 디코딩으로 소형 모델을 브라우저에서 구동 가능한 터미널 에뮬레이터로 만든 기술 구현 사례로, 제약된 환경에서 큰 모델의 능력을 소형화하는 방법을 보여준다.
핵심 요약
360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. 파일 생성, vim과 tmux 실행, 스네이크 게임 등이 가능하고, 자신의 실수를 수정하는 능력과 행(row)을 병렬로 디코딩하는 기술로 성능을 크게 개선했다. 터미널을 문자 그리드로 모델링했으며, Qwen2.5-Coder-0.5B를 기반으로 Docker에서 실제 프로그램 실행 기록으로 파인튜닝했다. 전체 요약 14문장 읽기 → 007 00:11 ▲ 13 · 댓글 2 에지 기기용 LLM 커널 생성 벤치마크 공개 LLM이 서버 GPU용 커널을 생성하는 것은 이미 연구되었으나, 하드웨어가 이질적이고 소프트웨어 스택이 단편화된 에지 배포 환경에서 다양한 백엔드를 대상으로 한 커널 생성은 체계적으로 연구되지 않았다. AI · 머신러닝 · EdgeKernelBench: Unified LLM-Driven Kernel Generation for Edge Backends
Key Point 에지 디바이스 배포는 서버와 달리 하드웨어가 다양하고 제약이 크기 때문에, LLM으로 생성한 커널을 실제로 잘 동작하게 하려면 새로운 평가 방식과 최적화 전략이 필요하다는 점이 중요하다.
핵심 요약
LLM이 서버 GPU용 커널을 생성하는 것은 이미 연구되었으나, 하드웨어가 이질적이고 소프트웨어 스택이 단편화된 에지 배포 환경에서 다양한 백엔드를 대상으로 한 커널 생성은 체계적으로 연구되지 않았다. EdgeKernelBench는 통합 IR 배포 프레임워크와 에지 워크로드용 계층적 벤치마크를 결합하여, 재사용 가능한 계산·스케줄링·메모리 결정을 통합 IR로 캡처하고 컴파일러 인터페이스를 통해 각 백엔드에 연결한다. 벤치마크는 개별 연산자부터 컴팩트 모델 그래프까지 점진적으로 확대된 프로그램 범위를 포함하며, 대표적인 에지 애플리케이션 도메인을 아우른다. 전체 요약 6문장 읽기 → 008 15:11 ▲ 20 · 댓글 3 로봇 조작 학습, 인간 영상으로도 가능하게 로봇 조작을 배우는 데 인간 비디오가 필요한 이유는 로봇 행동 라벨이 있는 영상은 비용이 많고 다양성이 부족하기 때문이다. AI · 머신러닝 · AffordanceWAM: Affordance-Aware Joint World-Action Modeling for Robot Manipulation
Key Point 로봇 학습 데이터의 수집 비용을 크게 낮추고 인간 영상을 직접 활용할 수 있는 방법이 제시되었기 때문에, 로봇 조작 분야에서 실용적인 전환점이 될 수 있다.
핵심 요약
로봇 조작을 배우는 데 인간 비디오가 필요한 이유는 로봇 행동 라벨이 있는 영상은 비용이 많고 다양성이 부족하기 때문이다. AffordanceWAM은 미래 프레임을 예측하면서 동시에 객체별 상호작용 가능 영역(Scalar Affordance, Affordance Heatmap)을 표현하는 생성 모델이다. 비디오 디퓨전 트랜스포머를 기반으로 World Expert와 Action Expert를 따로 설계하고 Masked Joint Self-Attention으로 연결하여 RGB 관찰, 어포던스 필드, 히트맵, 로봇 액션을 함께 예측한다. 전체 요약 7문장 읽기 → 009 03:11 ▲ 271 · 댓글 3 루프형 모델로 필요한 만큼만 생각하는 의사결정 AI 기존 의사결정 모델은 단일 포워드 패스로 한 번에 답을 내놓지만 계산 깊이가 학습 시점에 고정되어 쉬운 문제나 어려운 문제 모두 같은 연산량을 씀. AI · 머신러닝 · LEV: Thinking Fast and Deep with Looped Decision Models
Key Point 텍스트 생성 없이 레이어 루프로만 추론 깊이를 조절해 효율과 정확도를 동시에 확보하는 새로운 의사결정 모델 구조.
핵심 요약
기존 의사결정 모델은 단일 포워드 패스로 한 번에 답을 내놓지만 계산 깊이가 학습 시점에 고정되어 쉬운 문제나 어려운 문제 모두 같은 연산량을 씀. 텍스트 생성 방식 모델은 더 깊게 추론할 수 있지만 생성하는 토큰 수에 비례해 계산 비용이 늘어남. 논문이 제시한 LEV는 토큰 생성 대신 모델 레이어를 루프로 반복 실행해 더 깊은 추론을 구현함. 전체 요약 8문장 읽기 → 010 15:10 ▲ 138 · 댓글 41 전문가 업무용 오픈 모델 'Ultramarine 1 Flash' 공개 Paper Instruments가 금융, 법무, 컨설팅, 운영 업무에 특화한 오픈 모델 Ultramarine 1 Flash를 공개했다. AI · 머신러닝 · Ultramarine 1 Flash
Key Point 금융·법무·컨설팅 업무에 특화한 전문가용 모델이 기존 고가 모델 대비 60배 저렴하면서 경쟁 수준 성능을 제공함으로써 비용-성능 경계선을 재정의하고 있습니다.
핵심 요약
Paper Instruments가 금융, 법무, 컨설팅, 운영 업무에 특화한 오픈 모델 Ultramarine 1 Flash를 공개했다. Fable 수준의 성능을 제공하면서 비용은 60배 저렴하며, 작업당 $0.13의 가격대로 경쟁사 모델들을 앞선다. JobBench에서 62.9점(Gemini 3.8 Flash 60.6, DeepSeek V4.1 Flash 60.4, Claude Fable 5 57.4)으로 최고 성능을 기록했다. 전체 요약 9문장 읽기 → 011 18:11 ▲ 354 · 댓글 2 VLM의 "빠른 사고": 공간 추론을 분류 문제로 재구성 비전-언어 모델(VLM)이 공간 관계, 거리, 위치 같은 질문에 자동 회귀 방식으로 텍스트를 생성하는 것은 비효율적이다. 이에 MJev-Spatial은 공간 이해 작업을 통일된 분류 프레임워크로 재구성한 System 1 모델이다. AI · 머신러닝 · MJev-Spatial: System One Spatial Intelligence via Native Attention Matching
Key Point 공간 추론 같은 제약된 답변 공간 작업을 분류로 바꾸면 자동 회귀 생성의 지연 없이 단일 포워드 패스로 정확하게 풀 수 있으며, 이는 로봇 제어나 실시간 상호작용이 필요한 애플리케이션의 성능 개선으로 이어진다.
핵심 요약
비전-언어 모델(VLM)이 공간 관계, 거리, 위치 같은 질문에 자동 회귀 방식으로 텍스트를 생성하는 것은 비효율적이다. 이에 MJev-Spatial은 공간 이해 작업을 통일된 분류 프레임워크로 재구성한 System 1 모델이다. 선택 문제는 주어진 옵션을 클래스로, 수치 예측은 값 범위를 이진 분류 단계로, 점 예측은 이미지 영역을 단계적으로 분류하는 방식이다. 기존 VLM의 쿼리-키 사영을 재사용해 추가 파라미터 없이 후보를 점수 매기므로, 추론 시 단 한 번의 포워드 패스로 답을 내놓고 답변 토큰을 생성하지 않는다. 전체 요약 5문장 읽기 → 012 03:12 ▲ 12 · 댓글 1 GUI 인식 성능 대폭 개선한 GroundGUI 공개 GUI 화면의 자연어 지시를 정확히 화면상 요소로 매핑하는 멀티모달 비전 접지(visual grounding) 기술의 발전을 위해 ScreenRef 데이터셋을 제시했다. AI · 머신러닝 · GroundGUI: GUI Grounding by High-Quality Data and Distillation-to-Reinforcement Learning
Key Point 자동화된 GUI 에이전트 개발의 핵심 과제인 화면 요소 인식 성능이 8B급 모델 범위에서 기존 오픈소스 접근법을 처음으로 능가했기 때문이다.
핵심 요약
GUI 화면의 자연어 지시를 정확히 화면상 요소로 매핑하는 멀티모달 비전 접지(visual grounding) 기술의 발전을 위해 ScreenRef 데이터셋을 제시했다. ScreenRef는 데스크톱, 웹, 모바일을 아우르는 586K개 GUI 스크린샷과 633K개 이상의 자연어 표현 인스턴스로 구성되며, 텍스트 인식·시각적 매칭·공간 이해·거부 시나리오 등을 포함한다. 감독학습 파인튜닝의 제한된 일반화와 강화학습의 희소 보상 문제를 해결하기 위해 Distillation-to-Reinforcement Learning(D2RL) 방법을 개발했다. 전체 요약 7문장 읽기 → 013 18:11 ▲ 19 · 댓글 1 비디오 추론 모델의 증거 기반 검증 능력 강화 Open-o3-Video-v2는 비디오 추론 과정에서 타임스탬프와 객체 경계박스를 포함한 검증 가능한 증거를 생성하는 모델입니다. AI · 머신러닝 · Open-o3-Video-v2: Seek, Ground, and Reason with Verifiable Spatio-Temporal Evidence
Key Point 비디오 AI 모델이 단순히 답을 하는 것에서 벗어나 '왜 그렇게 생각하는지' 시간과 위치 정보로 검증할 수 있게 되면서, 신뢰성이 필요한 비디오 분석 응용에 실제 도입 가능성이 높아집니다.
핵심 요약
Open-o3-Video-v2는 비디오 추론 과정에서 타임스탬프와 객체 경계박스를 포함한 검증 가능한 증거를 생성하는 모델입니다. 기존 Open-o3-Video의 제한점을 극복하기 위해 부족한 정보를 식별하고 추가 관찰을 획득하는 에이전트 기반 접근 방식을 도입했습니다. 52K 다중 턴 에이전트 그라운딩 추론 궤적과 13K 강화학습 데이터셋(STGR-v2-CoT135K, STGR-v2-RL-13K)을 구성했습니다. 전체 요약 7문장 읽기 → 014 18:12 ▲ 14 · 댓글 2 그래프 이해 능력 진단하는 벤치마크 'GraphDecideBench' 공개 대언어모델(LLM)의 그래프 이해 및 의사결정 능력이 증가하고 있으나, Jev 같은 System One 모델의 그래프 관련 작업 성능은 명확하지 않았다. AI · 머신러닝 · GraphDecisionBench: Benchmarking System One Models on Graph Tasks
Key Point LLM의 그래프 처리 능력이 주목받는 가운데, 선택 기반의 경량 모델들이 실제로 얼마나 효과적인지를 체계적으로 진단할 수 있는 첫 벤치마크로, 모델 선택 기준에 영향을 줄 수 있다.
핵심 요약
대언어모델(LLM)의 그래프 이해 및 의사결정 능력이 증가하고 있으나, Jev 같은 System One 모델의 그래프 관련 작업 성능은 명확하지 않았다. 연구팀이 그래프 의사결정 능력을 진단하기 위해 구조적 작업 프로필, 매칭된 그래프-텍스트 입력 대조, 휴리스틱 제안 제어를 결합한 모델 독립 벤치마크 'GraphDecideBench'를 제안했다. Jev와 관련 선택 기반 모델들을 언어 모델 기준선과 함께 14개 모델-인터페이스 구성으로 평가했다. 전체 요약 7문장 읽기 → 015 18:12 ▲ 113 · 댓글 63 AI가 자기 자신을 재귀적으로 개선하는 방법 Sakana AI 연구팀이 다중 에이전트 시스템의 집단 지능을 통해 AI 모델이 스스로를 개선하는 MASS(Multi-Agent Self-Supervision) 기법을 제안했다. AI · 머신러닝 · Recursive self-improvement through collective intelligence
Key Point 인간 감시자도 평가 불가능한 최첨단 과제에서 AI가 홀로 자신을 개선할 수밖에 없는 상황에서, 집단 지능을 통한 자기 감시 메커니즘이 작동하는지 보여주며, 동시에 그 방식의 안전 위험을 드러내는 연구다.
핵심 요약
Sakana AI 연구팀이 다중 에이전트 시스템의 집단 지능을 통해 AI 모델이 스스로를 개선하는 MASS(Multi-Agent Self-Supervision) 기법을 제안했다. MASS는 같은 모델이 작업 수행자, 워크플로우 최적화자, 평가자 세 역할을 모두 하는 동형 재귀적 자기 개선(RSI) 방식이다. 내부 루프에서 모델이 다중 에이전트 팀의 업무 분담 방식을 최적화하고, 외부 루프에서 최적화된 워크플로우 실행으로부터 배운다. 전체 요약 12문장 읽기 → 016 18:11 ▲ 101 · 댓글 100 코딩 에이전트는 왜 여전히 형편한가 저자는 초기에 코딩 에이전트의 자동화 능력에 매료되었으나, 며칠 후 빈번한 버그, 응답 중단, 작업 미완료 문제를 겪으면서 실망했다. AI · 머신러닝 · Why are coding agents so dumb?
Key Point LLM 성능이 비약적으로 향상되는 와중에도 코딩 에이전트는 설계 결함으로 인해 진전이 없다는 비판으로, 개발자들이 도구 선택과 투자 방향을 판단할 때 실질적 기준을 제시한다.
핵심 요약
저자는 초기에 코딩 에이전트의 자동화 능력에 매료되었으나, 며칠 후 빈번한 버그, 응답 중단, 작업 미완료 문제를 겪으면서 실망했다. 코딩 에이전트는 모델(GPT Astra, Claude Sonnet 등 LLM)과 다르다. 모델이 '뇌' 역할을 한다면, 에이전트는 모델을 시스템에 연결하는 '몸' 역할이다. 주요 문제점: 에이전트는 병렬 처리 가능한 작업을 순차적으로 처리한다. 예를 들어 10개의 독립적인 소작업을 하나씩 완료한 후 다음으로 넘어간다. 전체 요약 12문장 읽기 → 017 03:11 ▲ 19 · 댓글 2 루브릭 기반 강화학습의 보상 문제 해결하는 MetaRubric 루브릭 기반 강화학습은 개별 응답 요구사항에 부분 점수를 할당해 개방형 과제를 최적화하지만, 루브릭 판정자가 필수 정보나 행동이 없어도 높은 점수를 주는 '공허한 신용(Vacuous Credit)' 문제가 발생한다. AI · 머신러닝 · MetaRubric: Learning to Reward for Rubric-Based Reinforcement Learning
Key Point AI 모델의 보상 신호 설계 방식에 근본적인 문제점을 지적하고 의료·과학 분야 QA 성능을 20% 이상 끌어올린 접근법으로, 강화학습 기반 모델 개발에 실질적인 개선 방법을 제시한다.
핵심 요약
루브릭 기반 강화학습은 개별 응답 요구사항에 부분 점수를 할당해 개방형 과제를 최적화하지만, 루브릭 판정자가 필수 정보나 행동이 없어도 높은 점수를 주는 '공허한 신용(Vacuous Credit)' 문제가 발생한다. 이 문제는 필수 정보가 제거된 후에도 지속되며 응답의 GRPO 우위 부호를 역전시킬 수 있다. MetaRubric은 증거 인식 정책 최적화와 응답 기반 루브릭 적응을 교대로 수행하는 방식으로 이를 해결한다. 전체 요약 8문장 읽기 → 018 15:11 ▲ 85 · 댓글 2 복잡한 작업도 자기 재작성으로 학습 데이터 확장 복잡한 터미널 작업 해결을 위해 Recursive Self-Rewrite(RSR) 프레임워크를 제안했다. AI · 머신러닝 · Scaling Trajectories for Complex Tasks through Recursive Self-Rewrite
Key Point 다양한 도구와 환경을 활용한 경험을 일반화된 학습 데이터로 변환하는 기법으로, 복잡한 작업에서 모델 성능을 대폭 끌어올릴 수 있음을 보여준다.
핵심 요약
복잡한 터미널 작업 해결을 위해 Recursive Self-Rewrite(RSR) 프레임워크를 제안했다. Qwen 3.8-27B 기반 모델이 다양한 도구와 환경에서 성공한 해법을 발견하고, 일반 환경에서 재실행 가능한 학습 데이터로 재구성한다. 플래너가 절차를 실행 가이드(runbook)로 추출하고, 비판자가 데이터 누수를 점검하며 반복 개선을 지도한다. 전체 요약 8문장 읽기 → 019 00:11 ▲ 14 · 댓글 2 데이터 동영상을 자동으로 만드는 AI 도구 DataMagic 데이터 동영상은 동적 차트, 음성 해설, 동기화된 애니메이션으로 데이터 인사이트를 전달하는 데이터 스토리텔링 형식이지만, 제작에는 데이터 분석·서사 설계·영상 편집 전문성이 필요했다. AI · 머신러닝 · DataMagic: Authoring Data Videos through Declarative Multi-Agent Orchestration
Key Point LLM만으로는 데이터 정확성과 서사 일관성을 동시에 보장하기 어려운 데이터 동영상 생성의 구조적 한계를 해결하는 실용적 접근법을 제시합니다.
핵심 요약
데이터 동영상은 동적 차트, 음성 해설, 동기화된 애니메이션으로 데이터 인사이트를 전달하는 데이터 스토리텔링 형식이지만, 제작에는 데이터 분석·서사 설계·영상 편집 전문성이 필요했다. 기존 시각화 도구는 서사와 애니메이션 기능이 부족하고, 저작 도구는 사전 준비된 차트에 의존하며, 픽셀 기반 모델은 데이터 정확성과 출처 추적을 보장하지 못한다. DataMagic은 원본 표 형식 데이터로부터 선언형 다중 에이전트 오케스트레이션을 통해 데이터 동영상을 자동 생성한다. 전체 요약 8문장 읽기 → 020 03:11 ▲ 175 · 댓글 3 온정책 vs 비정책 학습, 체계적 실험으로 재평가 온정책(on-policy) 학습이 재앙적 망각을 줄이고 성능을 개선한다는 주장이 있지만, 기존 연구는 여러 요소를 동시에 변경해 효과를 명확히 구분하기 어려웠다. AI · 머신러닝 · On-Policy or Off-Policy Learning? A Systematic Study of Distillation Dynamics
Key Point 강화학습 기반 모델 최적화에서 온정책 학습의 필요성이 통념으로 여겨졌지만, 체계적인 실험을 통해 그 가정을 재검토한 논문으로 실무 선택에 직결되는 통찰을 제시한다.
핵심 요약
온정책(on-policy) 학습이 재앙적 망각을 줄이고 성능을 개선한다는 주장이 있지만, 기존 연구는 여러 요소를 동시에 변경해 효과를 명확히 구분하기 어려웠다. 연구팀은 강한 모델을 약한 모델로 증류하는 통제된 실험에서 온정책 정책, KL 방향, 학습률을 독립적으로 변경하며 Llama3과 Qwen2.5에서 과학·의료·산술 추론 과제를 실시했다. 분석 결과 온정책 정책이 중심 역할을 하지 않는 것으로 드러났다. 전체 요약 8문장 읽기 → 021 03:11 ▲ 184 · 댓글 63 클라우드플레어, 의사결정 특화 AI 모델 Clef 공개 클라우드플레어가 Jev Decision Index에서 1위를 차지한 의사결정 모델 Clef와 Clef-flash를 공개했고, 두 모델 모두 Apache 2.0 라이선스로 오픈소스화해 Hugging Face에서 배포 중이다. AI · 머신러닝 · Clef: Open-source decision models, and new RL fine-tuning platform
Key Point LLM의 비결정성과 느린 토큰 생성을 대체해 프로덕션 에이전트 워크플로우에서 실시간 의사결정이 필요한 개발자들에게 구체적인 선택지를 제공하며, 오픈소스 배포와 미세조정 플랫폼으로 커스터마이징 가능성을 연다.
핵심 요약
클라우드플레어가 Jev Decision Index에서 1위를 차지한 의사결정 모델 Clef와 Clef-flash를 공개했고, 두 모델 모두 Apache 2.0 라이선스로 오픈소스화해 Hugging Face에서 배포 중이다. 의사결정 모델은 입력에 따라 확률과 함께 타입이 지정된 구조화 출력을 생성해 에이전트가 자동으로 판단하고 실행하도록 돕는데, 예를 들어 고객 지원 메시지를 받아 긴급도와 담당팀을 분류한다. Clef는 이미지 분류도 가능한 비전 인코더를 갖춰 Jev(텍스트 분류만 지원)와 다르며, 64k 컨텍스트 윈도우(Jev는 32k)로 더 많은 입력을 처리할 수 있다. 전체 요약 12문장 읽기 → 022 09:11 ▲ 12 · 댓글 2 픽셀 디퓨전 모델에 적대적 학습 추가로 고주파 품질 개선 픽셀 디퓨전 모델은 오토인코더 병목을 피해 RGB 이미지를 직접 생성하지만, 미세한 자연 이미지 통계를 체계적으로 과소 표현하는 문제가 있다. AI · 머신러닝 · Adversarial Training for Pixel Diffusion
Key Point 픽셀 디퓨전이 기존 오토인코더 기반 모델의 문제를 우회한다는 점에서 더 직접적인 방식이었으나, 미세한 디테일 손실 문제를 적대적 학습으로 해결할 수 있음을 보여주는 실질적 개선 방법이기 때문입니다.
핵심 요약
픽셀 디퓨전 모델은 오토인코더 병목을 피해 RGB 이미지를 직접 생성하지만, 미세한 자연 이미지 통계를 체계적으로 과소 표현하는 문제가 있다. 연구팀은 사전학습된 모델에 적대적 손실을 더해 이 결함을 보정하는 방법을 제시했다. 원래 확산 또는 플로우 매칭 목표를 유지하면서 비고노이즈 타임스텝에서만 적대적 손실을 예측 출력에 추가한다. 모델 아키텍처와 샘플링 절차는 변경하지 않으며, 픽셀 디퓨전의 적대적 사후학습에 대한 첫 체계적 연구다. 전체 요약 9문장 읽기 → 023 18:11 ▲ 15 · 댓글 2 DiT의 잔차 연결을 재설계해 이미지 생성 성능 향상 Diffusion Transformers(DiT)는 이미지 합성의 확장 가능한 기반 모델이지만, 기존 U-Net 모델의 수작업 스킵 연결과 달리 모든 층의 출력을 단순히 누적하는 단일 잔차 흐름을 사용한다. AI · 머신러닝 · Structured Residual Connectivity Matters for Diffusion Transformers
Key Point Diffusion Transformer의 성능을 좌우하는 잔차 연결 구조를 근본적으로 개선하는 방법론이 제시되어, 향후 이미지 생성 모델 설계의 새로운 기준이 될 가능성이 있다.
핵심 요약
Diffusion Transformers(DiT)는 이미지 합성의 확장 가능한 기반 모델이지만, 기존 U-Net 모델의 수작업 스킵 연결과 달리 모든 층의 출력을 단순히 누적하는 단일 잔차 흐름을 사용한다. 연구팀은 DiT의 내부 표현을 체계적으로 분석해 초기 층의 특성 재사용과 대칭적 층 가이던스를 중시하는 경향을 발견했다. 이를 바탕으로 각 트랜스포머 블록이 이전 층의 중요한 표현을 선택적으로 '주목'하고, 직접적이고 미분 가능한 크로스-뎁스 경로를 통해 공간적·의미적 정보를 동적으로 검색하는 적응형 연결 메커니즘을 제안했다. 전체 요약 7문장 읽기 → 024 12:11 ▲ 30 · 댓글 1 장시간 로봇 작업에서 기억력을 평가하는 새 벤치마크 공개 로봇이 장시간 환경과 상호작용할 때 정보를 유지·갱신해야 하는데, 현재 에이전트들은 이를 제대로 못하고 있습니다. AI · 머신러닝 · EmbodiedMemory-Bench: Benchmarking Embodied Memory for Long-Horizon Embodied Tasks
Key Point 로봇이 복잡한 장시간 작업을 수행할 때 필요한 기억 능력의 핵심 문제를 체계적으로 분석하고 평가할 구체적 벤치마크와 솔루션을 제시해 구체화 합니다.
핵심 요약
로봇이 장시간 환경과 상호작용할 때 정보를 유지·갱신해야 하는데, 현재 에이전트들은 이를 제대로 못하고 있습니다. 문제의 원인은 네 가지입니다: 세부 시각 정보 기억 부족, 동적 세계 상태 추적 불안정, 상호작용 결과로 드러난 정보 미기록, 과거 경험 활용 제한. 이를 평가할 벤치마크가 없어 EmbodiedMemory-Bench(EMem-Bench)를 개발했습니다. 전체 요약 8문장 읽기 → 025 00:11 ▲ 120 · 댓글 106 AI가 코딩을 완전히 해결했다는 주장은 착각이다 LLM이 코드 작성에 능하다는 주장은 소프트웨어 개발의 본질을 오해한 것이다. 코드 생성 비용이 낮아졌지만, 실제 비용의 대부분은 유지보수, 신뢰성, 보안, 확장성 같은 비기능 요구사항에서 나온다. AI · 머신러닝 · Coding Is Not Solved
Key Point AI 기반 개발로 인해 대규모 레이오프를 단행한 기업들이 품질 저하와 책임 회피의 딜레마에 직면한 가운데, 전문가가 제시하는 LLM의 근본적 한계와 산업별 필요성의 차이를 정리한 글이다.
핵심 요약
LLM이 코드 작성에 능하다는 주장은 소프트웨어 개발의 본질을 오해한 것이다. 코드 생성 비용이 낮아졌지만, 실제 비용의 대부분은 유지보수, 신뢰성, 보안, 확장성 같은 비기능 요구사항에서 나온다. 의료, 금융, 자동차, 방위, 발전소, 항공 등 실수의 대가가 큰 산업에서는 낮은 위험 허용도가 필요하며, 이런 분야에서는 책임감 있는 엔지니어가 필수다. AI는 책임을 질 수 없다. AI는 결과에 따른 처벌, 감옥, 벌금을 받지 않으므로 진정한 책임성을 가질 수 없고, 제어 불가능한 것에는 책임을 질 수 없다는 원칙이 핵심이다. 전체 요약 11문장 읽기 → 026 03:10 ▲ 117 · 댓글 70 풀 리퀘스트 대신 '델타 스레드'로 협업하는 코드 에디터 Zed Zed은 에이전트와 함께 코딩할 수 있는 협업 환경 '델타'의 공개 베타를 시작했다. 웹 · 프론트엔드 · Replacing Pull Requests with Delta
Key Point 에이전트가 대량의 코드를 생성하는 시대에 풀 리퀘스트 중심의 워크플로우를 대체할 새로운 협업 방식이 등장했으며, 스레드 기반 모델이 어떻게 작동하는지 알아야 한다.
핵심 요약
Zed은 에이전트와 함께 코딩할 수 있는 협업 환경 '델타'의 공개 베타를 시작했다. 델타에서는 전통적인 풀 리퀘스트 대신 '스레드'에서 직접 협업하며, 팀원들이 같은 워크트리를 보고 에이전트와 함께 작업할 수 있다. Git 기반 DeltaDB를 확장해 커밋 사이의 편집 이력을 기록하므로, 완전한 코드 진화 과정이 보존된다. 전체 요약 5문장 읽기 → 027 21:11 당일 +102 구글, AI 기반 파일 타입 감지 도구 'Magika' 오픈소스화 구글이 개발한 파일 타입 감지 도구 Magika를 공개했으며, 딥러닝 기반 모델로 약 99% 정확도를 달성한다. 보안 · google/magika · Rust
Key Point 기존 파일 형식 감지 도구의 한계(낮은 정확도, 느린 속도)를 AI로 개선하면서도 경량화(수 MB)를 달성한 솔루션이 오픈소스로 공개되어 보안 및 콘텐츠 분석 도구 개발에 활용할 수 있다.
핵심 요약
구글이 개발한 파일 타입 감지 도구 Magika를 공개했으며, 딥러닝 기반 모델로 약 99% 정확도를 달성한다. 약 100만 개 샘플의 200개 이상 콘텐츠 타입으로 학습되었으며, 파일 크기와 무관하게 평균 5ms 내 분석을 완료한다. Rust 명령줄 도구, Python API, JavaScript/TypeScript, Go 바인딩으로 제공되며, 모델 로드 후 CPU만으로도 동작한다. 전체 요약 6문장 읽기 →