쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
18건 · "모델 개선"조건 지우기 ×
001 15:11 ▲ 11 · 댓글 1 텍스트·이미지 섞인 생성 평가하는 IntReal 데이터셋 공개 인간이 자연스럽게 텍스트와 이미지를 섞어가며 콘텐츠를 소비하지만, 통합 멀티모달 모델(UMM)의 인터리브된 생성은 제대로 연구되지 않았다. AI · 머신러닝 · IntReal: A Real-World Dataset and Benchmark for Multimodal Interleaved Generation
Key Point 텍스트와 이미지를 섞어 생성하는 멀티모달 AI의 성능을 처음으로 체계적으로 평가할 벤치마크가 등장해, 이 분야 연구와 모델 개선의 기초가 될 것으로 예상된다.
핵심 요약
인간이 자연스럽게 텍스트와 이미지를 섞어가며 콘텐츠를 소비하지만, 통합 멀티모달 모델(UMM)의 인터리브된 생성은 제대로 연구되지 않았다. 현 상황의 근본 문제는 명확한 인터리브 생성 작업과 학습 데이터 부재, 그리고 모델 성능을 세밀하게 진단할 평가 프로토콜 부족이다. IntReal은 100K 샘플의 실제 멀티모달 데이터셋과 전문 모델 7개 차원으로 모델을 평가하는 IntReal Evaluation Suite로 구성된다. 전체 요약 6문장 읽기 → 002 15:11 ▲ 61 · 댓글 1 벤치마크가 말해주지 않는 것: 어려움의 분포 문제 벤치마크는 단순한 문제 모음이 아니라 자연스럽게 난이도에 대한 경험적 분포를 만들며, 이 관점에서 벤치마크 평가를 재검토하는 새로운 틀을 제시한다. AI · 머신러닝 · Your Benchmark Is an Empirical Measure Over Difficulty
Key Point 평가 지표의 신뢰성이 중요한 만큼, 기존 벤치마크들이 어떤 한계를 가지고 있으며 그것이 리더보드 순위를 얼마나 왜곡할 수 있는지 정량적으로 드러낸다.
핵심 요약
벤치마크는 단순한 문제 모음이 아니라 자연스럽게 난이도에 대한 경험적 분포를 만들며, 이 관점에서 벤치마크 평가를 재검토하는 새로운 틀을 제시한다. 벤치마크의 중심 문제 두 가지를 정의한다: 벤치마크의 난이도 분포가 의도한 분포와 다른 '측정값 불일치(measure mismatch)', 난이도 축의 특정 구간이 비어 있어 모델 개선을 감지하지 못하는 '커버리지 갭(coverage gaps)'. 이 두 문제를 포착하는 진단 지표를 제안하고 엄밀한 이론적 보장을 제공한다. 전체 요약 6문장 읽기 → 003 03:11 ▲ 11 · 댓글 2 실제 업무 환경에서 에이전트 능력을 측정하는 벤치마크 공개 CRM(고객관계관리) 작업을 통해 언어 모델 에이전트의 실무 역량을 평가하는 벤치마크 'CRM-Agent-Bench'를 공개했다. AI · 머신러닝 · CRM-Agent-Bench: Benchmarking Tool-Using Agents in Stateful Enterprise Environments
Key Point 실제 비즈니스 환경에서 언어 모델 에이전트의 신뢰성을 평가하는 방식이 바뀌고 있으며, 정책 준수와 운영 비용을 함께 측정하는 기준이 필요한 상황이기 때문이다.
핵심 요약
CRM(고객관계관리) 작업을 통해 언어 모델 에이전트의 실무 역량을 평가하는 벤치마크 'CRM-Agent-Bench'를 공개했다. 555개의 상태 변화 멀티턴 작업을 9개 비즈니스 도메인과 36개 능력 태그로 구성해 실제 운영 환경을 모사한다. 각 작업마다 실행 가능한 계약을 제공하며, 이는 액션·인수·순서·응답·목표 상태·보호된 상태에 대한 검사 항목들로 이루어진다. 전체 요약 6문장 읽기 → 004 18:11 ▲ 13 · 댓글 2 언어모델이 언어모델 개선을 학습하다 LLM을 이용해 AI 연구를 자동화할 수 있지만, 실제 피드백으로 효과적인 개선안을 제안하는 능력을 학습하는 데는 두 가지 문제가 있다. AI · 머신러닝 · Language Models Learn to Improve Language Models
Key Point LLM이 AI 개발 프로세스를 자동으로 개선하는 능력을 갖추게 되면서 모델 개발 비용과 속도의 판도가 바뀔 수 있기 때문입니다.
핵심 요약
LLM을 이용해 AI 연구를 자동화할 수 있지만, 실제 피드백으로 효과적인 개선안을 제안하는 능력을 학습하는 데는 두 가지 문제가 있다. 첫째, 강화학습으로 수만 개 제안을 평가하려면 수십만 GPU시간이 필요해 비용이 매우 크다. 둘째, 대리 피드백은 정책 최적화 과정에서 과대평가된 제안을 선호하면서 신뢰도가 떨어진다. 전체 요약 7문장 읽기 → 005 18:11 ▲ 25 · 댓글 2 AI 에이전트, 과학 모델 개선에서 얼마나 성과낼까 연구팀이 Agent4Sci라는 테스트베드를 개발해 최신 AI 에이전트들이 과학 ML 벤치마크의 발표된 최고 성능을 어디까지 개선할 수 있는지 측정했다. AI · 머신러닝 · Automating ML for Science: Can Frontier Agents Climb Scientific Hills in the Wild?
Key Point 실제 과학 문제 해결에서 AI 에이전트의 현재 수준을 정량적으로 파악할 수 있으며, 단순 하이퍼파라미터 조정을 넘어 진정한 과학적 창의성이 부족한 부분이 명확해진다.
핵심 요약
연구팀이 Agent4Sci라는 테스트베드를 개발해 최신 AI 에이전트들이 과학 ML 벤치마크의 발표된 최고 성능을 어디까지 개선할 수 있는지 측정했다. 11개 분야의 20개 벤치마크를 대상으로 평가했을 때, Claude Opus는 평균 10.4%의 상대적 성능 개선을 달성했으며 모든 실행에서 학문적 부정행위 없이 진행되었다. 하지만 이 개선 사항은 거의 전부가 데이터 전처리, 하이퍼파라미터 조정, 앙상블 같은 표준 ML 엔지니어링 기법에서 비롯되었으며 실제 과학적 통찰력은 부족했다. 전체 요약 6문장 읽기 → 006 15:11 ▲ 32 · 댓글 2 월드 모델의 일반화 능력을 평가하는 AnyGoal 벤치마크 공개 월드 모델이 환경 역학을 정확히 학습해도, 학습 데이터에 없던 상태-행동 조합에서는 신뢰할 수 없다는 문제를 다룬 논문이다. AI · 머신러닝 · AnyGoal: On World Model Generalization Beyond Expert Rollouts
Key Point 월드 모델의 진정한 일반화 능력을 측정하는 표준화된 벤치마크가 부족한 상황에서, 구성적 일반화 실패 사례들을 체계적으로 드러내는 평가 도구가 제시되어 향후 모델 개선 방향을 명확히 제시한다.
핵심 요약
월드 모델이 환경 역학을 정확히 학습해도, 학습 데이터에 없던 상태-행동 조합에서는 신뢰할 수 없다는 문제를 다룬 논문이다. 연구팀은 AnyGoal이라는 벤치마크와 오픈소스 라이브러리를 공개했으며, 기존 월드 모델 환경들을 변형해 새로운 목표를 가진 태스크 변이체들을 만들었다. 각 태스크는 개별 상태 요소와 행동들은 학습 범위 내에 있지만, 그 조합은 전문가 궤적에서 거의 나타나지 않도록 설계되었다. 전체 요약 6문장 읽기 → 007 09:11 ▲ 145 · 댓글 52 Jev 1.14.0 공개, 이미지·더 긴 컨텍스트·새 타입 추가 TypeSafe AI가 Jev 1.14.0을 출시했으며, 프로덕션 배포가 아닌 실험적 '위험 지역' 기능들을 함께 공개했다. AI · 머신러닝 · We’re releasing Jev 1.14.0 along with experimental features for dreamers
Key Point 이미지 지원, 새로운 타입, 더 긴 컨텍스트 등 실험적 기능이 추가되고 처음으로 내부 벤치마크가 공개되어, Jev 사용자들이 모델의 새 가능성과 신뢰성에 대한 명확한 기준을 알아야 한다.
핵심 요약
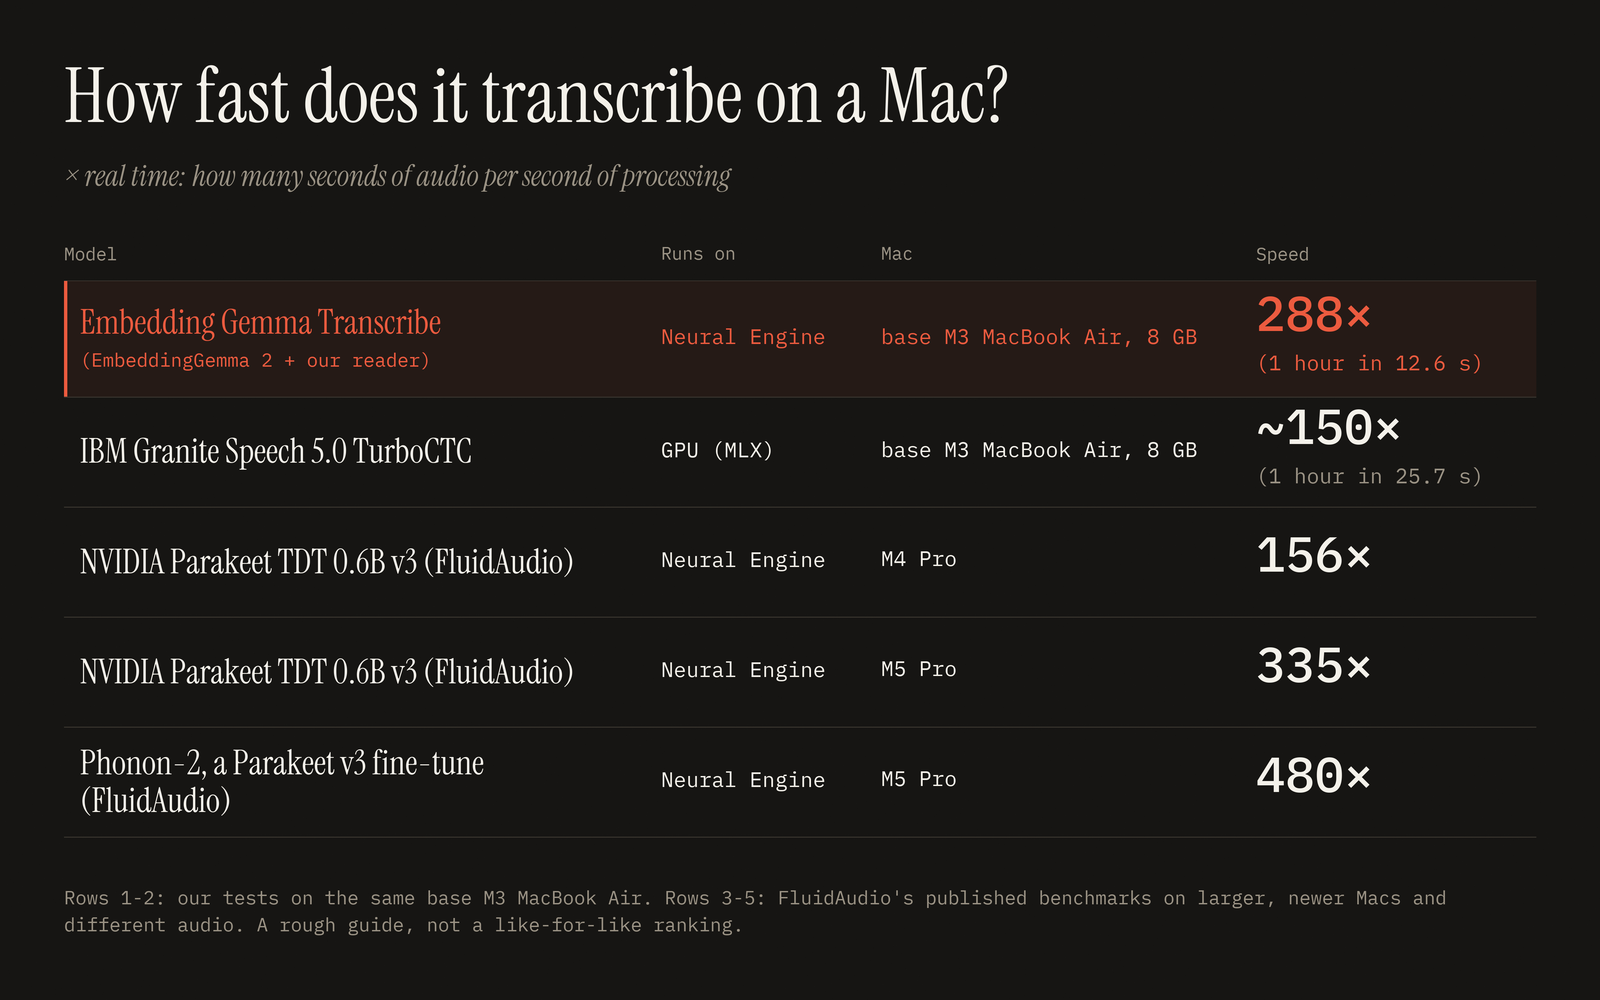
TypeSafe AI가 Jev 1.14.0을 출시했으며, 프로덕션 배포가 아닌 실험적 '위험 지역' 기능들을 함께 공개했다. 신규 기능 중 하나는 이미지 지원으로, 기존 Jev 1.13.0도 멀티모달 모델이었으며 JSON 인터페이스 내 상태·지시·조건 어디든 이미지를 삽입 가능하다. 다른 신규 기능은 경계 상자를 반환하는 'box' 타입으로, System One 모델의 단순 의사결정 이상의 기능을 탐색하는 첫 단계다. 전체 요약 8문장 읽기 → 008 00:11 ▲ 238 · 댓글 57 EmbeddingGemma 2를 음성 인식 모델로 개조한 실험 Google의 다중 모달 임베딩 모델 EmbeddingGemma 2를 음성-텍스트 변환 모델로 개조했다. AI · 머신러닝 · We turned EmbeddingGemma 2 into a speech-to-text model
Key Point 다중모달 임베딩 모델을 음성 인식으로 새롭게 활용한 창의적 접근과 Apple Silicon에서의 빠른 실시간 처리 성능이 주목할 만하다.
핵심 요약
Google의 다중 모달 임베딩 모델 EmbeddingGemma 2를 음성-텍스트 변환 모델로 개조했다. 텍스트, 이미지, 오디오, 비디오를 같은 벡터 공간에 매핑하는 특성을 활용해 음성을 약 22만 9천 개 영어 단어 중 가장 가까운 단어로 매칭하는 방식으로 작동한다. 오디오 인코더는 원래 그대로 두고, 새로운 작은 리더 모델만 학습시켜 음성 슬라이스를 텍스트 공간으로 변환하며, 별도 모델이 구두점과 대문자를 추가한다. 전체 요약 7문장 읽기 → 009 15:13 ▲ 74 · 댓글 2 강화학습으로 스스로 개선하는 초대형 모델 MiMo-V2.6 공개 Hugging Face와 협력 연구팀이 강화학습(RL) 규모를 확대하여 초대형 기초 모델의 자기 개선을 가능하게 하는 MiMo-V2.6 시리즈를 발표했다. AI · 머신러닝 · MiMo-V2.6: Scaling Reinforcement Learning Towards Self-Improvement
Key Point 장기 시퀀스 처리와 복합 작업에서 초대형 모델이 스스로 개선되도록 하는 RL 확장 기법이 어떻게 작동하는지, 그 구체적인 구현과 한계를 다루기 때문에 모델 개선 연구자와 개발자가 참고할 수 있다.
핵심 요약
Hugging Face와 협력 연구팀이 강화학습(RL) 규모를 확대하여 초대형 기초 모델의 자기 개선을 가능하게 하는 MiMo-V2.6 시리즈를 발표했다. RL 훈련 전에 다양한 멀티모달 데이터를 이용해 중간 학습을 수행하고, 하이브리드 SWA 구조의 사전학습 모델을 기반으로 확장 가능한 인프라를 구축했다. RL 계산을 세 가지 방향으로 확장했다: (1) 비동기 훈련으로 스텝당 1,568개 샘플과 2.7~3.7B 토큰 처리, 최대 1M 길이 컨텍스트 지원, (2) 코드·일반·시각·사이버 도메인을 포함한 다양한 환경과 에이전트 구성, (3) 그룹별 에이전트 채점으로 장기 작업의 정확한 보상 신호와 토큰 효율성 개선. 전체 요약 6문장 읽기 → 010 18:30 ▲ 26 · 댓글 1 생성 이미지 품질 평가, 이제 결함 위치까지 지적한다 기존 AI 이미지 평가 모델은 점수만 제시할 뿐 문제가 있는 부분을 특정하지 못했다. AI · 머신러닝 · VIEScore2: Unified Image Evaluation with Spatially Grounded Explanations
Key Point AI로 생성한 이미지의 문제점을 정확히 지적할 수 있게 되면서, 이미지 생성 모델 개선과 품질 검증 프로세스의 자동화 방식이 크게 바뀔 가능성이 높다.
핵심 요약
기존 AI 이미지 평가 모델은 점수만 제시할 뿐 문제가 있는 부분을 특정하지 못했다. VIEScore2는 이미지 생성·편집 작업을 평가하면서 이미지를 N×N 그리드로 표현해 품질 점수와 결함 위치를 동시에 예측한다. 텍스트 기반 그리드 표현으로 다양한 형태의 학습 데이터(점수만 있는 데이터, 위치만 있는 데이터, 둘 다 있는 데이터)를 통합 학습할 수 있다. 전체 요약 7문장 읽기 → 011 18:30 ▲ 64 · 댓글 2 자가학습하는 추론 모델, 반복 학습으로 성능 붕괴 막는 방법 제시 추론 모델이 자체 생성 질문으로 학습하는 자가진화 과정에서 반복할수록 성능이 저하되는 문제가 있다. AI · 머신러닝 · Questioning the Questions: Sustaining Self-Evolution in Reasoning Models
Key Point 자가학습하는 LLM 기반 추론 모델의 성능 붕괴 문제를 해결하는 실질적 방법을 제시해, 장기간 안정적인 모델 개선이 가능해진다.
핵심 요약
추론 모델이 자체 생성 질문으로 학습하는 자가진화 과정에서 반복할수록 성능이 저하되는 문제가 있다. 논문은 성능 악화의 원인으로 두 가지를 파악했다: 무효한 질문의 증가와 수학적으로 동등한 질문의 반복. 무효한 질문은 라운드가 진행될수록 늘어나며, 답변 일관성 필터링이 이를 더욱 악화시킨다. 전체 요약 9문장 읽기 → 012 09:11 ▲ 11 · 댓글 2 SFT에서 토큰 가중치를 다시 설계하다: SCALE 방법론 감독된 미세 조정(SFT)은 모델이 가능성 낮다고 판단한 토큰에서 가장 적극적으로 학습하는데, 이는 새로운 동작을 습득하는 동시에 노이즈나 충돌하는 지도를 증폭하고 기존 사전학습 지식을 덮어쓸 수 있다. AI · 머신러닝 · Rethinking Token Reweighting for SFT: Suppress, Reverse, and Extrapolate Learned Features
Key Point 기존 미세 조정 방식의 근본적인 한계를 분석하고 새로운 기준틀을 제시하는 방법론으로, 수학·코드 성능에서 기존 방식을 초과하면서 실제 모델 개선에 활용될 수 있는 기술입니다.
핵심 요약
감독된 미세 조정(SFT)은 모델이 가능성 낮다고 판단한 토큰에서 가장 적극적으로 학습하는데, 이는 새로운 동작을 습득하는 동시에 노이즈나 충돌하는 지도를 증폭하고 기존 사전학습 지식을 덮어쓸 수 있다. 기존 토큰 재가중치 방법들은 음이 아닌 계수를 할당해 지도 업데이트를 억제하거나 증폭할 수 있지만, 일단 학습된 해로운 특성을 역으로 돌릴 수 없다. 큰 학습 가중치는 최적화 궤적을 바꾸는 것이지 고정된 SFT 방향의 크기를 조정하는 것이 아니므로, 진정한 특성 추외삽은 이루어지지 않는다. 전체 요약 9문장 읽기 → 013 06:11 ▲ 14 · 댓글 2 여러 AI 모델을 조합해 편향 제거, 'CBM' 프레임워크 제시 공중보건, 금융, 정부 등에 배치되는 대규모 언어모델(LLM)은 정확성과 사회적 가치 정렬이 모두 필요하지만, 학습 데이터에 내재된 편향을 지속하거나 증폭시키는 문제가 있다. AI · 머신러닝 · Collective Bias Mitigation via Model Routing and Collaboration
Key Point LLM이 금융·보건·정부 같은 중요 분야에 배치되면서 편향 제거가 시급한데, 단일 모델 개선만으로는 한계가 있다는 점과 여러 모델을 조합하는 새로운 해결책의 효과를 실증 데이터로 보여주기 때문이다.
핵심 요약
공중보건, 금융, 정부 등에 배치되는 대규모 언어모델(LLM)은 정확성과 사회적 가치 정렬이 모두 필요하지만, 학습 데이터에 내재된 편향을 지속하거나 증폭시키는 문제가 있다. 기존 자기 검열(self-debiasing) 방식은 단일 모델의 내재 지식만 활용해 깊숙이 박힌 고정관념 해결에 부족하다. 연구진은 CBM(Collective Bias Mitigation)이라는 프레임워크를 제안했으며, 이는 세분화된 모델 행동을 학습하고 서로 다른 LLM 간 지식 공유를 촉진해 편향을 완화한다. 전체 요약 6문장 읽기 → 014 15:11 ▲ 17 · 댓글 2 합성 장면으로 시각 인식 키우는 멀티모달 AI 자체 학습법 멀티모달 대형언어모델(MLLM)의 추론을 개선하기 위해 온-폴리시 자체 증류(on-policy self-distillation) 기법을 적용했다. AI · 머신러닝 · Where-OPD: Spatially Guided On-Policy Self-Distillation of MLLMs with Synthetic Scenes
Key Point 합성 데이터로 학습한 시각 AI가 실제 데이터에서도 3포인트 이상 성능 향상을 보이는 방식은 대규모 모델 개선의 비용 효율성을 높이려는 기업과 연구자들에게 실질적인 선택지가 된다.
핵심 요약
멀티모달 대형언어모델(MLLM)의 추론을 개선하기 위해 온-폴리시 자체 증류(on-policy self-distillation) 기법을 적용했다. 기존 방식은 이미지 일부를 자르거나 외부 교사 모델에 의존했지만, 이 연구는 공간 정보를 담은 텍스트 가이드를 통해 교사 모델에 특권 정보를 제공한다. 절차적으로 생성한 합성 장면에서 객체 정체성과 공간 좌표를 자동으로 얻을 수 있어, 인간 주석 없이 대규모 포스트 학습이 가능하다. 전체 요약 7문장 읽기 → 015 12:11 ▲ 67 · 댓글 2 사전학습 트랜스포머는 너무 일찍 멈춘다, 작은 LoRA로 해결 사전학습된 트랜스포머들은 맥락 참조를 따르기 위해 모델의 깊이를 거의 활용하지 않으며, 13개 기본 모델은 평균 1.4~3.6줄의 체인만 따를 수 있다. AI · 머신러닝 · Transformers Stop Thinking Too Early, and a Tiny LoRA Fixes It
Key Point 미세 조정 기법만으로 트랜스포머의 숨겨진 추론 능력을 200배까지 끌어낼 수 있다는 발견으로, 효율적인 모델 개선 방법을 제시한다.
핵심 요약
사전학습된 트랜스포머들은 맥락 참조를 따르기 위해 모델의 깊이를 거의 활용하지 않으며, 13개 기본 모델은 평균 1.4~3.6줄의 체인만 따를 수 있다. 모든 모델 가중치를 고정한 상태에서 한 초기 계층에 rank-8 LoRA를 학습시키면 이 능력을 크게 확장할 수 있다. Qwen3-8B는 24줄 체인에서 정확도가 15.5%에서 99%로 개선되었고, 더 길게 학습된 LoRA는 50줄까지 도달했다. 전체 요약 7문장 읽기 → 016 12:11 ▲ 124 · 댓글 2 동영상 생성 AI의 음성-영상 동기화를 위한 적응형 보상 라우팅 기법 오디오-비디오 확산 모델을 개선하기 위해 여러 보상 신호를 활용하는 강화학습 방식이 있지만, 훈련 과정에서 보상 가중치와 적용 위치가 고정되어 있어 모델의 변화하는 특성을 따라가지 못한다. AI · 머신러닝 · Adaptive Reward Routing: Dynamic Multi-Reward Optimization for Joint Audio-Video Diffusion via Forward-Process RL
Key Point 음성-영상 생성 AI의 동기화와 품질을 동시에 높이는 새로운 최적화 기법으로, 여러 목표가 충돌할 때 동적으로 가중치를 조정하는 방식이 향후 멀티모달 생성 모델 개선의 방향을 제시한다.
핵심 요약
오디오-비디오 확산 모델을 개선하기 위해 여러 보상 신호를 활용하는 강화학습 방식이 있지만, 훈련 과정에서 보상 가중치와 적용 위치가 고정되어 있어 모델의 변화하는 특성을 따라가지 못한다. 논문은 Adaptive Reward Routing이라는 새로운 방법을 제안하며, 이는 음성 품질, 영상 품질, 교차-모달 의미 일치, 시간적 동기화 등 여러 목표를 동시에 최적화한다. 첫 번째 구성 요소는 Cross-Modal Influence-Guided Routing으로, 양방향 교차-주의 응답을 이용해 변화하는 모달 간 영향을 추적하면서 토큰별 손실을 동적으로 재가중화하고 그래디언트를 조정한다. 전체 요약 6문장 읽기 → 017 15:11 ▲ 84 · 댓글 1 이미지 생성 AI를 판단하는 새로운 기준, 생각하는 리워드 모델 이미지 생성 AI의 성능을 평가하는 리워드 모델 개선 연구로, 기존 방식이 평가 기준을 암묵적으로만 적용하는 문제를 해결합니다. AI · 머신러닝 · Think Before You Score: Thinking Reward Model for Visual Generation
Key Point 이미지 생성 AI의 자동 평가 방식을 근본적으로 바꾸고, 이를 통해 생성 모델 최적화를 더 효과적으로 할 수 있다는 점이 중요합니다.
핵심 요약
이미지 생성 AI의 성능을 평가하는 리워드 모델 개선 연구로, 기존 방식이 평가 기준을 암묵적으로만 적용하는 문제를 해결합니다. 제안하는 TRM(Thinking Reward Model)은 각 상황에 맞춘 평가 기준을 먼저 명시적으로 결정한 후 생성 결과를 판단하는 방식으로 작동합니다. 경우별로 적응형 평가 기준을 만들고, 기준에 맞춰 세부 평가를 수행한 뒤 미세한 정도의 점수를 산출합니다. 전체 요약 6문장 읽기 → 018 18:11 ▲ 15 · 댓글 2 DiT의 잔차 연결을 재설계해 이미지 생성 성능 향상 Diffusion Transformers(DiT)는 이미지 합성의 확장 가능한 기반 모델이지만, 기존 U-Net 모델의 수작업 스킵 연결과 달리 모든 층의 출력을 단순히 누적하는 단일 잔차 흐름을 사용한다. AI · 머신러닝 · Structured Residual Connectivity Matters for Diffusion Transformers
Key Point Diffusion Transformer의 성능을 좌우하는 잔차 연결 구조를 근본적으로 개선하는 방법론이 제시되어, 향후 이미지 생성 모델 설계의 새로운 기준이 될 가능성이 있다.
핵심 요약
Diffusion Transformers(DiT)는 이미지 합성의 확장 가능한 기반 모델이지만, 기존 U-Net 모델의 수작업 스킵 연결과 달리 모든 층의 출력을 단순히 누적하는 단일 잔차 흐름을 사용한다. 연구팀은 DiT의 내부 표현을 체계적으로 분석해 초기 층의 특성 재사용과 대칭적 층 가이던스를 중시하는 경향을 발견했다. 이를 바탕으로 각 트랜스포머 블록이 이전 층의 중요한 표현을 선택적으로 '주목'하고, 직접적이고 미분 가능한 크로스-뎁스 경로를 통해 공간적·의미적 정보를 동적으로 검색하는 적응형 연결 메커니즘을 제안했다. 전체 요약 7문장 읽기 →