쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
28건 · "정밀도"조건 지우기 ×
001 12:11 ▲ 23 · 댓글 3 장편 비디오 생성, 과거 참조가 항상 도움이 될까 장편 비디오 생성 모델이 과거 프레임을 참조해 캐릭터 일관성을 유지하려는 시도가 늘고 있지만, 과거 정보가 반드시 더 나은 결과를 만드는지 체계적으로 검증한 논문이다. AI · 머신러닝 · More Memory, Better Videos? A Controlled Study of Visual Memory in Long-Video Generation
Key Point 과거 정보 활용이 비디오 생성의 필수 요소로 여겨지지만, 실제 측정을 통해 정확성 하락과 부작용을 드러낸 점이 산업의 관행에 의문을 제기한다.
핵심 요약
장편 비디오 생성 모델이 과거 프레임을 참조해 캐릭터 일관성을 유지하려는 시도가 늘고 있지만, 과거 정보가 반드시 더 나은 결과를 만드는지 체계적으로 검증한 논문이다. 연구팀은 92개 영화의 16,548개 세그먼트와 30개 생성된 스토리(2,824개 세그먼트)를 대상으로 VMem-Bench라는 2단계 진단 시스템을 구축했다. 메모리 검색이 없는 경우 엔티티 재현율은 0.559였으나, 검색 사용 시 0.628~0.693으로 개선되고 과거 외형과의 유사도도 높아졌다. 전체 요약 6문장 읽기 → 002 15:11 ▲ 50 · 댓글 2 보상 해킹을 막는 정밀도 기반 강화학습 루브릭 기반 강화학습은 검증 불가능한 작업에서 효과적이지만, 루브릭 커버리지의 가중치로만 보상을 정의해 재현율만 최대화하는 문제가 있다. AI · 머신러닝 · Eat Your Precision: Precision Objective Mitigates Reward Hacking in Rubric-based RL
Key Point 강화학습 보상 함수 설계의 핵심 문제인 목적 왜곡(reward hacking)을 정밀도 메트릭으로 체계적으로 해결하는 방법이 의료·건강 등 신뢰도가 중요한 분야에서 큰 성능 개선을 보여주고 있다.
핵심 요약
루브릭 기반 강화학습은 검증 불가능한 작업에서 효과적이지만, 루브릭 커버리지의 가중치로만 보상을 정의해 재현율만 최대화하는 문제가 있다. 이로 인해 RL 학습 모델은 내용이 길고 불필요하거나 사실적으로 틀린 부분이 많아져 기본 모델보다 선호도가 낮아진다. 이를 해결하기 위해 FORK 보상을 제시하는데, 이는 재현율과 함께 정밀도 목적을 동시에 최적화한다. 전체 요약 7문장 읽기 → 003 21:11 ▲ 23 · 댓글 2 확산 모델의 단계별·작업별 양자화로 정확도 6.7%p 향상 확산 언어 모델(DLM)은 반복 노이즈 제거 과정의 특성상 기존 모델과 다른 양자화 도전 과제를 갖는다. AI · 머신러닝 · Different Tasks, Different Timesteps: Temporal Task-Aware Quantization for Diffusion Language Models
Key Point 확산 모델의 양자화 시 노이즈 제거 과정의 어느 단계에서 어느 정도의 정밀도가 필요한지를 체계적으로 파악할 수 있게 되어, 모델 압축 효율과 정확도 사이의 균형을 개선할 수 있다.
핵심 요약
확산 언어 모델(DLM)은 반복 노이즈 제거 과정의 특성상 기존 모델과 다른 양자화 도전 과제를 갖는다. 연구팀은 양자화 민감도가 작업과 타이밍 두 가지에 의존하며, 각 작업마다 노이즈 제거 단계별로 필요한 정밀도가 다름을 밝혔다. 이러한 패턴은 정답 레이블이나 작업별 평가 지표 없이도 예측 가능함을 보였다. 전체 요약 5문장 읽기 → 004 06:11 ▲ 11 · 댓글 3 로컬에서 돌리는 에이전트 모델 Muse Glimmer 30B 공개 Hugging Face가 Muse Glimmer 30B라는 오픈소스 언어모델을 공개했습니다. AI · 머신러닝 · Muse Glimmer 30B: An On-Device Agentic Model
Key Point GPU 한 개면 충분한 수준의 에이전트 능력을 로컬에서 운영할 수 있어, 개발자들이 클라우드 비용 없이 독립적인 AI 시스템을 구축하는 방식을 바꿀 수 있습니다.
핵심 요약
Hugging Face가 Muse Glimmer 30B라는 오픈소스 언어모델을 공개했습니다. 일반 PC에서 클라우드 없이 독립적으로 동작하는 에이전트 모델로, 텍스트와 이미지를 입력받고 텍스트를 출력합니다. 다단계 추론, 도구 사용, 실패 복구 능력을 통합했으며 100개 이상의 언어로 학습되었습니다. 전체 요약 6문장 읽기 → 005 00:11 ▲ 173 · 댓글 59 녹음음악, 기계의 완벽함에 잠식되다 1975년 빌보드 1위곡 '러브 윌 킵 어스 투게더'는 킥과 베이스가 정확히 정렬되지 않고 비규칙적인 리듬 패턴, 템포 변화를 담고 있으며 평균 130.5 BPM에서 표준편차 2.79 BPM, ±1 BPM 범위 내 32.1%의 특성을 보인다. 기타 · What Is Gridifcation
Key Point 음악 제작 방식이 지난 25년간 근본적으로 변했으며, 인간의 살아있는 시간과 개별성이 기계적 완벽함으로 지워지는 문제를 역사적 데이터로 처음 명확히 제시했다.
핵심 요약
1975년 빌보드 1위곡 '러브 윌 킵 어스 투게더'는 킥과 베이스가 정확히 정렬되지 않고 비규칙적인 리듬 패턴, 템포 변화를 담고 있으며 평균 130.5 BPM에서 표준편차 2.79 BPM, ±1 BPM 범위 내 32.1%의 특성을 보인다. 2025년 빌보드 1위곡 '다이 위드 어 스마일'은 평균 79 BPM에서 표준편차 0.00 BPM, 템포 변화 0회, 100% 정확도로 거의 완벽한 기계적 정밀도를 유지하고 있다. 이 현상을 '그리디피케이션'이라 하며, 인간의 공연을 사후 처리 과정에서 알고리즘 기반 양자화 도구로 보정하여 기계 같은 완벽함으로 변환하는 것을 의미한다. 전체 요약 9문장 읽기 → 006 21:11 ▲ 22 · 댓글 7 4비트 재귀 상태 양자화로 LLM 배치 처리 메모리 절감 선형 어텐션 언어 모델은 고정 크기의 재귀 상태로 문맥을 유지하며, 추론 시스템은 동시에 복호화되는 각 시퀀스마다 상태 복사본을 저장해야 한다. AI · 머신러닝 · PACE: Periodic and Channel-Aligned Encoding of Four-Bit Recurrent States
Key Point LLM 추론 시 배치 크기를 제약하는 상태 메모리를 4비트로 양자화할 수 있다면, 같은 GPU 메모리로 더 많은 요청을 동시 처리할 수 있기 때문이다.
핵심 요약
선형 어텐션 언어 모델은 고정 크기의 재귀 상태로 문맥을 유지하며, 추론 시스템은 동시에 복호화되는 각 시퀀스마다 상태 복사본을 저장해야 한다. 상태를 낮은 정밀도로 저장하면 더 많은 시퀀스가 가속기를 공유할 수 있지만, 기존 양자화 방식은 매 토큰 생성 후 반올림하므로 4비트에서 정확도 손실이 크다. PACE는 사후 4비트 상태 양자화 기법으로, 매 토큰마다가 아니라 여러 토큰 생성 후에만 한 번 상태를 반올림하고, 그 사이 생성된 토큰을 작은 버퍼에 보관한다. 전체 요약 8문장 읽기 → 007 21:11 ▲ 102 · 댓글 19 LLM 에이전트로 시스템 모니터링 혁신하다 Anthropic은 Claude를 이용해 특정 시스템 컴포넌트 건강도를 전담하는 '슈퍼팬' 에이전트를 도입했으며, 이들은 기존 알림보다 미묘하고 새로운 문제를 더 잘 감지한다. AI · 머신러닝 · Agentic Monitoring
Key Point 시스템 규모 확대로 인한 운영 복잡도 증가 속에서 에이전트 기반 모니터링이 낮은 비용으로 정밀한 장애 감지와 대응을 가능하게 하며, 1년 이내 업계 표준이 될 가능성이 높기 때문이다.
핵심 요약
Anthropic은 Claude를 이용해 특정 시스템 컴포넌트 건강도를 전담하는 '슈퍼팬' 에이전트를 도입했으며, 이들은 기존 알림보다 미묘하고 새로운 문제를 더 잘 감지한다. 현대 소프트웨어 시스템은 설계된 것보다 성장하는 경향이 강해지고 있으며, 시스템 규모 증가로 운영자의 코드 이해도는 감소하고 있다. 기존 모니터링은 어렵고 비용이 많이 들며 숙련된 인력과 경험이 필요한데, 에이전트가 이 분야을 근본적으로 바꿀 수 있다. 전체 요약 14문장 읽기 → 008 03:11 ▲ 130 · 댓글 10 마이크로 단위 3D 정밀 제어, 오픈소스로 누구나 만든다 오픈소스 마이크로 매니퓰레이터 프로젝트는 저가의 3축 XYZ 모션 제어 플랫폼으로 50nm 단위 정밀도를 달성하며 광학 정렬, 전자 부품 검사, 현미경 응용에 사용된다. 하드웨어 · 시스템 · Open MicroManipulator – A sub-micrometer 3D motion control plattform
Key Point 저비용으로 마이크로미터 단위 정밀도를 필요로 하는 광학, 전자공학, 미세 조작 작업을 독립적으로 구축할 수 있는 완전 오픈소스 솔루션이며, 세부 설계, 펌웨어, 제어 소프트웨어가 모두 공개되어 커스터마이징과 학습에 활용할 수 있다.
핵심 요약
오픈소스 마이크로 매니퓰레이터 프로젝트는 저가의 3축 XYZ 모션 제어 플랫폼으로 50nm 단위 정밀도를 달성하며 광학 정렬, 전자 부품 검사, 현미경 응용에 사용된다. 평행 운동학 구조와 미니어처 볼 조인트로 기계적 강성을 확보하고, 30kHz 폐루프 제어 스테핑 모터와 자성 기어링을 통해 저가 로터리 인코더 해상도를 30배 향상시킨다. USB 시리얼 인터페이스로 G-Code 명령을 지원하며 모션 플래닝 스택과 선형보간으로 부드럽고 정확한 경로 추종을 구현한다. 전체 요약 12문장 읽기 → 009 03:11 ▲ 219 · 댓글 34 마이크론 정밀도를 갖춘 DIY 3D프린터 RepRapMicron 공개 RepRapMicron(μRepRap)은 일반 재료로 1마이크론(1/1000mm) 정밀도의 미세 3D 제조가 가능한 오픈소스 3D프린터다. 하드웨어 · 시스템 · RepRapMicron
Key Point 일반 가정용 재료만으로 마이크론 정밀도의 미세 제조가 가능해지면, 고가의 반도체·의료기기 제조 장비를 대체할 수 있어 기술 민주화의 새로운 장을 열 수 있다.
핵심 요약
RepRapMicron(μRepRap)은 일반 재료로 1마이크론(1/1000mm) 정밀도의 미세 3D 제조가 가능한 오픈소스 3D프린터다. 현재 PIKA V0.02 버전은 약 8mm 입방체 범위에서 1마이크론 반복 위치 결정과 10마이크론 이상의 신뢰성 있는 정밀도를 달성했다. UV수지 4마이크론 크기의 액적을 증착했으며, 광섬유 프로브로는 9마이크론 두께의 수지 선을 경화시켰다. 전체 요약 9문장 읽기 → 010 12:11 ▲ 14 · 댓글 2 선형 어텐션의 오래된 맥락 처리 능력 끌어올리기 선형 어텐션은 효율성이 필요한 긴 맥락 언어 모델링을 약속하지만, 고정 크기의 순환 상태로 현재 계산을 지원하면서 동시에 계속 증가하는 히스토리 정보를 보존해야 하는 딜레마가 있다. AI · 머신러닝 · History Replays Itself: Unleashing Long-Context Capability in Linear Attention
Key Point 선형 어텐션 모델의 가장 큰 약점인 긴 맥락 처리를 메모리 오버헤드 거의 없이 해결하는 방법을 제시해 실용적 배포 가능성을 높였다.
핵심 요약
선형 어텐션은 효율성이 필요한 긴 맥락 언어 모델링을 약속하지만, 고정 크기의 순환 상태로 현재 계산을 지원하면서 동시에 계속 증가하는 히스토리 정보를 보존해야 하는 딜레마가 있다. 기존에는 이 순환 상태의 메모리 용량이 모델의 긴 맥락 처리 능력의 상한선을 정한다고 여겨졌으나, 연구팀은 순환 계산이 장기 저장의 모든 부담을 질 필요가 없다는 점을 제시한다. NoteBank라는 희소 에피소드 메모리를 도입했으며, 이는 미래 쿼리를 알기 전에 선택된 텍스트를 보관하고, 백본의 기본 특징으로 읽고 쓰며, 재생을 통해 네이티브 순전파 계산으로 검색된 증거를 읽는다. 전체 요약 8문장 읽기 → 011 03:11 ▲ 148 · 댓글 42 pgvector 능가하는 벡터 검색 인덱스 등장 Timescale이 PostgreSQL용 고성능 근사 최근접 이웃(ANN) 검색 확장 pg_vectorsearch를 공개했으며, 현재 알파 상태로 프로덕션 용도는 권장하지 않는다. 인프라 · 데브옵스 · Pg_vectorsearch: An index that is faster than pgvector's IVFFlat and HNSW
Key Point pgvector를 대체할 더 빠르고 효율적인 벡터 검색 솔루션을 찾는 개발자들에게 실제 선택지가 생겼으며, 기존 pgvector 테이블과의 호환성 덕분에 마이그레이션 진입장벽이 낮다.
핵심 요약
Timescale이 PostgreSQL용 고성능 근사 최근접 이웃(ANN) 검색 확장 pg_vectorsearch를 공개했으며, 현재 알파 상태로 프로덕션 용도는 권장하지 않는다. PRISM 인덱스는 IVFFlat과 유사한 개념이지만 계층적 라우팅, RaBitQ 양자화, SIMD 최적화를 사용해 pgvector의 IVFFlat과 HNSW보다 쿼리와 인덱스 구축 모두에서 더 빠르다. 100백만 개 벡터 데이터셋에서 HNSW 대비 동등한 재현율(recall)을 달성하면서 1/4 메모리만 사용한다. 전체 요약 11문장 읽기 → 012 18:11 ▲ 125 · 댓글 91 OpenAI의 '빠른 푸리에 변환'은 수학적 속임수일 뿐 OpenAI가 수학 저장소에서 공개한 푸리에 변환(FFT) 알고리즘이 더 빠르다고 주장하지만, 실제로는 현실에서 작동 불가능한 방식이다. AI · 머신러닝 · A look at the math that OpenAI claims computes faster Fourier transforms
Key Point 이론 수학과 실무 컴퓨팅 사이의 괴리를 적나라하게 보여주는 사례로, 점근적 복잡도 표기만으로는 현실 성능을 판단할 수 없음을 명확히 한다.
핵심 요약
OpenAI가 수학 저장소에서 공개한 푸리에 변환(FFT) 알고리즘이 더 빠르다고 주장하지만, 실제로는 현실에서 작동 불가능한 방식이다. 기존 FFT는 1965년 쿨리-튜키 알고리즘으로 n²에서 5n log n 연산으로 개선했으며, n=1,000일 때 20배, n=1,000,000일 때 10,000배 속도 향상을 제공한다. OpenAI 알고리즘의 상수는 n=10¹²일 때 약 10¹⁰⁰으로 추정되므로, 실제로 더 빠른 n값은 우주의 원자 개수(10⁸⁰)보다 크다. 전체 요약 8문장 읽기 → 013 03:11 ▲ 11 · 댓글 2 LLM 평가 비용 줄이는 중요도 가중 샘플링 기법 AMLworld 데이터셋에서 백만 개 이상의 거래를 평가하려면 각각 별도의 그래프 프롬프트가 필요해 높은 비용이 든다. AI · 머신러닝 · AMLworld-Compact: Importance-Weighted Downsampling for Cost-Effective LLM Evaluation and Error Diagnosis
Key Point 대규모 LLM 평가 비용 문제를 해결하면서도 편향 없는 성능 추정을 가능하게 하는 실용적 기법으로, 금융 부정 탐지 같은 불균형 데이터셋 평가에 직접 적용할 수 있다.
핵심 요약
AMLworld 데이터셋에서 백만 개 이상의 거래를 평가하려면 각각 별도의 그래프 프롬프트가 필요해 높은 비용이 든다. AMLworld-Compact는 모든 불법 거래는 유지하되 감독된 점수 계층에서 정상 거래를 샘플링한 평가 세트다. HT-Coreset 프로토콜을 사용해 HI-Small과 LI-Small에서 평가 대상을 각각 271배, 611배 감소시킨다. 전체 요약 8문장 읽기 → 014 18:30 ▲ 19 · 댓글 2 RAG 에이전트 평가 예산을 어떻게 배분할까 생성형 AI 모델이 정보를 찾아 답변하는 RAG 에이전트의 평가 비용을 효율적으로 배분하는 문제를 다룬 논문이다. AI · 머신러닝 · Agentic RAG Evaluation: Budget Allocation Across Questions, Trajectories, and Reads
Key Point RAG 시스템 평가에 투입할 제한된 예산을 질문, 탐색 경로, 반복 읽기 중 어디에 쓸지 결정하는 실증적 기준을 제시하므로, 대규모 언어모델 평가를 설계하는 연구자들이 의사결정할 때 직접 참고할 수 있다.
핵심 요약
생성형 AI 모델이 정보를 찾아 답변하는 RAG 에이전트의 평가 비용을 효율적으로 배분하는 문제를 다룬 논문이다. HotpotQA와 MuSiQue 데이터셋에서 회수 피드백 비교를 통해 3.4천만 토큰 예산에서 질문 커버리지를 넓히는 것이 다섯 번 반복 읽기보다 표준 오차를 33% 낮추고, 세 가지 탐색 경로보다 12.6% 낮춘다는 것을 측정했다. 저장된 예측 모델이 최적 배분을 4.0%(중첩 경로) 및 3.5%(질문만 사용) 범위 내에서 예측할 수 있음을 보였다. 전체 요약 6문장 읽기 → 015 18:30 ▲ 29 · 댓글 2 저정밀 강화학습의 수치 오차 해결, TRIAGE 방법 제안 NVFP4 저정밀 실행을 통해 대형언어모델의 강화학습을 가속할 수 있지만, 학습기와 샘플러 간 실행 불일치가 정책 최적화를 불안정하게 만드는 문제가 있다. AI · 머신러닝 · TRIAGE: Direction-Aware Mismatch Stabilization of Native NVFP4 Reinforcement Learning
Key Point 저정밀 연산으로 LLM 강화학습 속도를 크게 높일 수 있지만 수치 오차로 인한 불안정성이 문제인데, 이 논문이 그 원인을 정확히 분석하고 실질적인 해결책을 제시했기 때문에 LLM 최적화에 관심 있는 개발자와 연구자가 봐야 한다.
핵심 요약
NVFP4 저정밀 실행을 통해 대형언어모델의 강화학습을 가속할 수 있지만, 학습기와 샘플러 간 실행 불일치가 정책 최적화를 불안정하게 만드는 문제가 있다. 연구팀은 불일치가 정책 기울기 방향과 상호작용하는 방식을 분석해, 크기만으로는 식별할 수 없는 국소 증폭 및 감소 영역을 구분했다. NVFP4 실행에서 초기 불균형으로 인해 음수 이점·음수 간극 업데이트가 우세하고, 이러한 토큰들이 불일치가 전역적으로 확산되기 전에 응답 세그먼트의 소수 부분에 집중된다는 패턴을 발견했다. 전체 요약 7문장 읽기 → 016 18:30 ▲ 106 · 댓글 2 선택적 정밀도로 선형 어텐션 상태 압축하는 STEPQuant Linear attention은 KV 캐시 대신 고정 크기의 재현 상태를 사용하지만, 이 상태들이 메모리 병목이 되고 있다. AI · 머신러닝 · STEPQuant: When and Where Errors Matter in Delta-Rule Recurrent State Quantization
Key Point 선형 어텐션 모델의 메모리 병목인 재현 상태 양자화에서 시간과 공간 차원의 오류 영향을 고려한 첫 접근으로, 실제 배포 환경에서 메모리 사용량을 획기적으로 줄일 수 있다.
핵심 요약
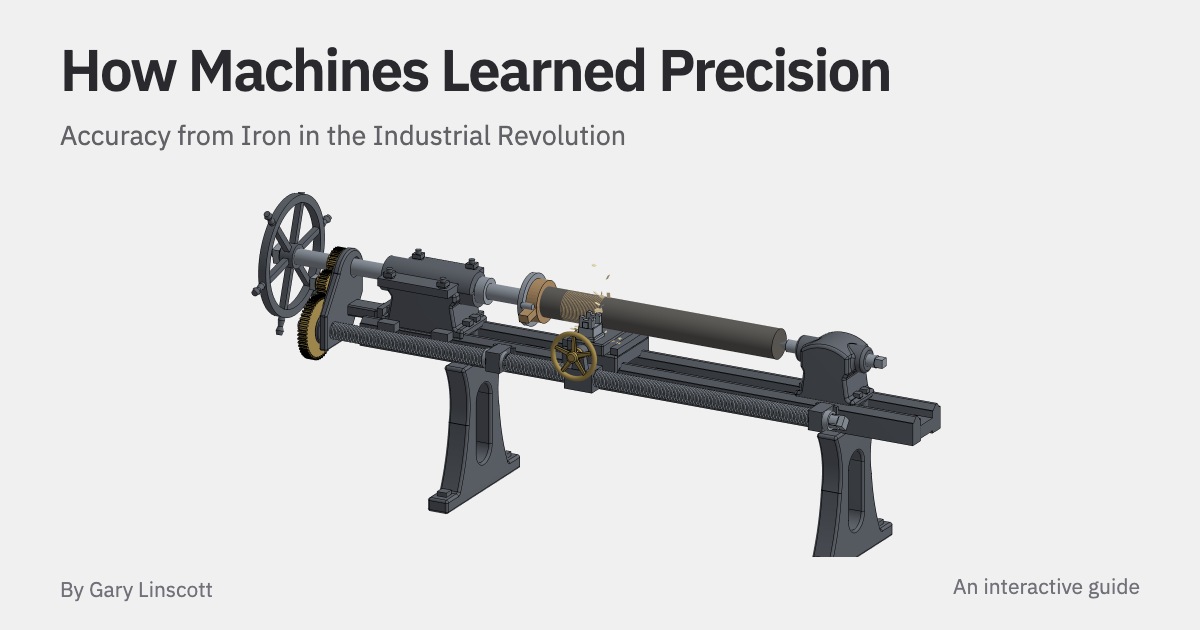
Linear attention은 KV 캐시 대신 고정 크기의 재현 상태를 사용하지만, 이 상태들이 메모리 병목이 되고 있다. 재현 상태를 저정밀도로 양자화하면 양자화 오류가 상태 업데이트 과정에서 누적되어 정확도가 크게 떨어진다. 연구진은 오류 영향이 두 가지 차원에 따라 달라짐을 발견했다: 시간적으로 오래된 메모리의 오류는 여러 디코딩 스텝에 걸쳐 지속되고, 공간적으로 서로 다른 키 행의 오류는 모델 출력에 미치는 영향이 다르며 상태 크기도 행과 열에 따라 변한다. 전체 요약 7문장 읽기 → 017 18:30 ▲ 163 · 댓글 63 정밀 기계의 탄생, 17개 구간으로 보는 산업 정밀도 혁명 1770년대 산업 혁명 초기, 실린더나 나선을 정밀하게 깎을 수 없어 피스톤이 새고 축이 흔들리는 문제가 심각했다. 하드웨어 · 시스템 · How machines learned precision
Key Point 산업 혁명 초반 기계 정밀도의 치명적 부족에서 시작해, 평면 기준 만들기·나선 가공·정밀 측정 등 각 단계별 혁신이 어떻게 상호작용하며 진보했는지 추적하는 글로, 현대 정밀 공학의 기초가 기계적 창의와 반복 개선의 결과임을 보여준다.
핵심 요약
1770년대 산업 혁명 초기, 실린더나 나선을 정밀하게 깎을 수 없어 피스톤이 새고 축이 흔들리는 문제가 심각했다. 존 윌킨슨(John Wilkinson)은 1775년경 양쪽 끝에서 지지하는 보링 밀(boring mill)을 고안해 구부러진 주조품을 곧게 뚫 수 있었으며, 1776년에는 반인치 실린더를 동전 두께(약 1mm) 정도의 정확도로 가공했다. 헨리 모즐리(Henry Maudslay)는 1790년대 주조 철을 견디는 견고한 슬라이드 레스트를 만들어 선반 진동을 없애고, 손으로 깎는 방식을 기계로 대체했다. 전체 요약 12문장 읽기 → 018 18:33 ▲ 92 · 댓글 2 MoE 언어모델 강화학습, FP4 저정밀도로 5배 빠르게 대규모 언어모델의 강화학습 훈련에서 롤아웃(rollout) 생성 과정이 계산과 메모리 오버헤드를 많이 차지하는 문제가 있어, 저정밀도 롤아웃을 통한 효율화가 필요하다. AI · 머신러닝 · TRACE: Rollout-Guided Quantization-Aware Training for FP4 Reinforcement Learning of MoE Language Models
Key Point MoE 모델의 강화학습 훈련에서 롤아웃 단계의 메모리와 속도 병목을 저정밀도 양자화로 5배 이상 해결할 수 있게 되어, 대규모 모델 학습의 실용성이 크게 향상된다.
핵심 요약
대규모 언어모델의 강화학습 훈련에서 롤아웃(rollout) 생성 과정이 계산과 메모리 오버헤드를 많이 차지하는 문제가 있어, 저정밀도 롤아웃을 통한 효율화가 필요하다. 기존 FP4 강화학습 방법들은 훈련과 롤아웃 경로의 양자화를 독립적으로 최적화하기 때문에 두 경로 간 불일치(discrepancy)가 발생하는 한계가 있다. 연구팀은 TRACE(Train-Rollout Quantization Alignment via Compact GuidancE)라는 FP4 양자화 프레임워크를 제안했으며, 이는 롤아웃 측의 양자화 결과를 훈련 측 반올림 결정에 직접 반영하여 불일치를 줄인다. 전체 요약 7문장 읽기 → 019 09:11 ▲ 13 · 댓글 2 여러 RL 교사 모델의 신호가 학생 파라미터에 미치는 영향 분석 Qwen3-1.7B 학생 모델과 같은 초기화에서 훈련한 4개 도메인 RL 교사들로부터의 다중 교사 온폴리시 증류(MOPD) 과정에서 그래디언트, 옵티마이저 업데이트, 태스크 학습 곡선을 비교 분석했다. AI · 머신러닝 · From Gradients to Capabilities: Understanding Multi-Teacher On-Policy Distillation
Key Point 여러 교사 신호를 결합할 때 손실 평균화, 옵티마이저 동작, 정밀도가 최종 성능에 미치는 구체적인 영향을 분석한 결과로, LLM 증류 설계의 의사결정 근거를 제시한다.
핵심 요약
Qwen3-1.7B 학생 모델과 같은 초기화에서 훈련한 4개 도메인 RL 교사들로부터의 다중 교사 온폴리시 증류(MOPD) 과정에서 그래디언트, 옵티마이저 업데이트, 태스크 학습 곡선을 비교 분석했다. 손실 평균화는 응답 길이를 기반으로 암묵적 가중치를 부여하는데, 토큰 평균화는 긴 응답을 선호하고 도메인 기여도 균등화도 도메인 내에서 이 가중치를 유지한다. Adam 옵티마이저의 1차 모멘트는 파라미터 업데이트의 차이를 감소시켜, 원본 그래디언트에는 차이가 있지만 교사 간 코사인 유사도 0.83, 평균화 규칙 간 0.96을 보인다. 전체 요약 6문장 읽기 → 020 06:11 ▲ 17 · 댓글 2 감정 음성 생성, 재학습 없이 정밀도 높이는 기법 감정 조건부 음성합성(TTS) 모델이 요청한 감정을 제대로 표현하지 못하는 문제를 해결하기 위해 재학습 없이 내부 표현을 수정하는 벡터 스티어링 기법을 연구했다. AI · 머신러닝 · EmoRES-TTS: Residual-Enhanced Vector Steering for Emotional Speech Generation
Key Point 감정 음성합성에서 모델을 재학습하지 않고도 감정 표현 정확도를 최대 35% 향상시킬 수 있는 새 방법으로, 리소스가 제한된 음성 AI 개발에 실질적 이점을 제공한다.
핵심 요약
감정 조건부 음성합성(TTS) 모델이 요청한 감정을 제대로 표현하지 못하는 문제를 해결하기 위해 재학습 없이 내부 표현을 수정하는 벡터 스티어링 기법을 연구했다. 기존 CoCoEmo 방식은 감정 벡터를 하나의 단일 강도로 제어하는 방향으로만 보아 감정 정확도가 제한적이었다. 연구팀은 감정 벡터가 음성을 중립 표현에서 벗어나게 하는 공유 성분과 요청한 감정으로 생성을 유도하는 잔여 성분으로 분해될 수 있음을 발견했다. 전체 요약 8문장 읽기 → 021 03:11 ▲ 16 · 댓글 2 GPT-6 Astra의 컴퓨터 비전 능력 평가, 일반형 AI의 한계 드러나 Frontier 수준의 범용 AI 시스템들이 전통적인 컴퓨터 비전 모델의 영역으로 확대되고 있다. AI · 머신러닝 · Hard Vision, Easy Vision: What GPT-6 Astra Reveals Across Computer Vision
Key Point 범용 AI 모델의 컴퓨터 비전 능력 한계를 구체적으로 파악할 수 있으며, 향후 비전 모델 개발의 방향성을 시사한다.
핵심 요약
Frontier 수준의 범용 AI 시스템들이 전통적인 컴퓨터 비전 모델의 영역으로 확대되고 있다. GPT-6 Astra를 포함한 5개 frontier AI 시스템을 9개 비전 영역, 55개 벤치마크, 34개 능력에 걸쳐 평가했다. Astra는 시각 및 공간 추론과 구조화된 예측 분야에서 다른 frontier 시스템들을 크게 앞섰다. 전체 요약 7문장 읽기 → 022 00:11 ▲ 13 · 댓글 2 로봇 촉각센서, 자체학습으로 표현력 높인다 로봇의 접촉 기반 섬세한 조작에 쓰이는 촉각센서는 시각에 가려진 환경에서 필수적인데, 기존에는 사전학습된 이미지 인코더와 달리 촉각 인코더는 주로 원본 신호로부터 처음 학습되어 표현력이 제한된다. AI · 머신러닝 · Tactile-JEPA: Topology-Aware Self-Supervised Representation Learning for Distributed Tactile Sensors
Key Point 로봇이 손으로 물체를 조작할 때 촉각센서 데이터를 얼마나 잘 해석하느냐에 따라 정밀도가 크게 달라지는데, 기존에 없던 효율적인 사전학습 방법이 나왔다.
핵심 요약
로봇의 접촉 기반 섬세한 조작에 쓰이는 촉각센서는 시각에 가려진 환경에서 필수적인데, 기존에는 사전학습된 이미지 인코더와 달리 촉각 인코더는 주로 원본 신호로부터 처음 학습되어 표현력이 제한된다. 분산 전자피부처럼 불규칙하게 배치된 촉각센서는 시각 기반 센서와 다르게 희소하고 불규칙한 구조를 가져, 기존 시각학습 방식을 직접 적용하기 어렵다. Tactile-JEPA는 센서의 공간적 배치와 연결 관계를 활용해 토폴로지 인식형 표현을 학습하는 자체지도학습 사전학습 방법이다. 전체 요약 8문장 읽기 → 023 22:26 ▲ 132 · 댓글 233 구글, 우주 궤도에 AI 컴퓨팅 인프라 구축하려 한다 구글이 Project Suncatcher를 통해 우주에서 AI 인프라를 구축할 수 있는지 탐험하는 장기 연구 프로젝트를 진행 중이며, 다음 주에 SpaceX의 Transporter-18 미션을 통해 첫 시험 위성을 발사한다. AI · 머신러닝 · Google’s Project Suncatcher to put ML infrastructure in space
Key Point 우주에서 AI 컴퓨팅을 구축하는 것이 현실적으로 가능한지 검증하는 단계이며, 지구의 태양전력 한계를 초월한 새로운 AI 인프라 방식을 제시한다.
핵심 요약
구글이 Project Suncatcher를 통해 우주에서 AI 인프라를 구축할 수 있는지 탐험하는 장기 연구 프로젝트를 진행 중이며, 다음 주에 SpaceX의 Transporter-18 미션을 통해 첫 시험 위성을 발사한다. 저궤도 위성은 거의 지속적인 태양광에 접근할 수 있어 지구 대비 최대 8배 많은 태양전력을 생성할 수 있으며, 향후 여러 위성을 연결해 더 큰 AI 작업을 처리할 수 있다. 첫 시험 미션은 구글 Tensor Processing Unit(TPU)이 우주 비행의 물리적 스트레스와 방사선, 온도 극한을 얼마나 견딜 수 있는지 측정하기 위해 설계되었다. 전체 요약 9문장 읽기 → 024 16:18 ▲ 47 · 댓글 4 AI 이미지 생성·편집에 16진수 색상값으로 정확한 색상 제어 가능하게 Paint-Anything은 생성과 편집 모두에서 24비트 16진수 값으로 객체의 정확한 색상을 지정할 수 있는 통합 인터페이스를 개발했다. AI · 머신러닝 · Paint-Anything: Unified Any-Color Control for Image Generation and Editing
Key Point 이미지 생성·편집에서 실무 디자이너 수준의 색상 제어가 가능해짐으로써 AI 콘텐츠 제작의 정밀도가 대폭 높아진다.
핵심 요약
Paint-Anything은 생성과 편집 모두에서 24비트 16진수 값으로 객체의 정확한 색상을 지정할 수 있는 통합 인터페이스를 개발했다. 실제 이미지의 객체 그라운딩과 지각적 색상 레이블링을 통해 Paint-500K 데이터셋을 구축하고, 그림자로 인한 오류를 보정하기 위해 순수 색상 앵커(정확히 일치하는 픽셀)를 고노이즈 단계에서만 학습에 사용했다. Any Color Benchmark(ACBench)를 새로 만들어 text-to-image와 편집 작업 모두에서 객체별 색상 충실도를 측정한다. 전체 요약 4문장 읽기 → 025 09:10 ▲ 150 · 댓글 49 27B 모델을 5.9GB로 압축, 98% 성능 유지 Qwen 3.8 27B 기반의 Ternary Bonsai 2 27B를 출시했으며, 삼진법 가중치와 FP16 그룹 스케일링으로 5.9GB 용량에 압축했다. AI · 머신러닝 · Bonsai 2 27B: Near-Lossless Compression in a 9x Smaller Footprint
Key Point 로컬 기기에서 대형 모델을 실용적으로 실행할 수 있는 경계가 넓어지며, 에너지 효율과 배포 가능성의 균형이 어디까지 갈 수 있는지를 보여주기 때문입니다.
핵심 요약
Qwen 3.8 27B 기반의 Ternary Bonsai 2 27B를 출시했으며, 삼진법 가중치와 FP16 그룹 스케일링으로 5.9GB 용량에 압축했다. 전체 정밀도 모델 대비 9배 이상 작으면서 98.2% 성능을 유지하며, 262K 토큰 컨텍스트 윈도우와 멀티모달 기능을 지원한다. 추론, 코딩, 비전, 에이전트 도구 사용 등에서 성능 저하를 최소화해 장시간 작업이나 다단계 처리에 유리하다. 전체 요약 6문장 읽기 → 026 16:56 ▲ 114 · 댓글 8 DeepSeek, KV 캐시 압축으로 추론 속도 420 토큰/초 달성 DeepSeek-v4.1 Flash는 552B 매개변수 멀티모달 모델로, 에이전트 워크플로우에서 증가하는 컨텍스트와 도구 호출로 인한 프리필 계산 부담을 해결하기 위해 설계됐다. AI · 머신러닝 · DeepSeek-v4.1 Flash: Pushing the Limits of KV Cache Compression
Key Point 에이전트 워크플로우에서 일반적인 병목인 장문맥 프리필 계산과 KV 캐시 저장 비용을 획기적으로 줄인 새로운 모델 아키텍처 설계가 장기 맥락 처리와 배포 비용 절감에 어떻게 영향을 미치는지 보여준다.
핵심 요약
DeepSeek-v4.1 Flash는 552B 매개변수 멀티모달 모델로, 에이전트 워크플로우에서 증가하는 컨텍스트와 도구 호출로 인한 프리필 계산 부담을 해결하기 위해 설계됐다. KV 캐시 압축을 위해 채널·시퀀스·레이어 세 차원에서 최적화를 진행했으며, 같은 시퀀스 길이에서 런타임 KV 캐시는 v4-Flash의 1/4, 영구 저장소는 1/8 수준으로 줄었다. Causal Encoder-Decoder(CED) 아키텍처를 도입해 프리필 단계에서 8B, 디코딩 단계에서 16B 매개변수만 활성화되도록 설계했으며, 이는 입력 중심의 에이전트 시나리오에 특히 효율적이다. 전체 요약 12문장 읽기 → 027 21:10 당일 +310 알리바바가 공개한 AI 코드 리뷰 도구, 정밀성 높이고 비용은 1/9로 알리바바의 내부 코드 리뷰 시스템을 오픈소스화한 OpenCodeReview는 Git diff를 읽어 LLM에 보낸 뒤 라인 단위 정밀한 피드백을 생성한다. AI · 머신러닝 · alibaba/open-code-review · Go
Key Point 자체 검증 벤치마크에서 일반 LLM 대비 정밀도는 높이면서 API 비용을 획기적으로 줄인 실용적 코드 리뷰 솔루션이 공개되었기 때문입니다.
핵심 요약
알리바바의 내부 코드 리뷰 시스템을 오픈소스화한 OpenCodeReview는 Git diff를 읽어 LLM에 보낸 뒤 라인 단위 정밀한 피드백을 생성한다. deterministic 파이프라인과 LLM Agent를 결합한 하이브리드 구조로, 파일 선택·번들링·규칙 매칭을 엔지니어링 로직으로 보장하면서 동적 판단은 Agent에 맡긴다. NPE, 스레드 안전성, XSS, SQL 인젝션 등 다국어 룰셋을 내장하고 OpenAI와 Anthropic 모델을 모두 지원한다. 전체 요약 5문장 읽기 → 028 21:11 ▲ 218 · 댓글 31 OpenRouter 사용할 때 마주칠 9가지 함정 OpenRouter를 통해 같은 모델을 호스팅하는 20개 제공자들이 벤치마크에서 크게 달라지는데, 예를 들어 DeepSeek V4 Flash의 도구 호출 성능이 제공자별로 58~81%까지 20포인트 이상 차이난다. AI · 머신러닝 · So you want to use OpenRouter?
Key Point 같은 모델의 가중치를 사용해도 제공자별로 성능, 기능 호환성, 에러 처리가 크게 달라서 OpenRouter를 사용하는 개발자는 제공자 선택과 에러 대응 코드를 신중하게 고려해야 한다.
핵심 요약
OpenRouter를 통해 같은 모델을 호스팅하는 20개 제공자들이 벤치마크에서 크게 달라지는데, 예를 들어 DeepSeek V4 Flash의 도구 호출 성능이 제공자별로 58~81%까지 20포인트 이상 차이난다. 일부 비전 모델은 같은 모델 가중치를 쓰는데도 특정 제공자에서는 이미지를 인식하지 못하거나 오류를 반환하면서도 200 OK를 보내는 문제가 발생한다. reasoning.effort 파라미터가 모든 제공자에서 작동하지 않으며, 동일한 프롬프트에 대해 제공자별로 추론 토큰 생성이 일관되지 않다. 전체 요약 6문장 읽기 →