쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
21건 · "컴퓨터 비전"조건 지우기 ×
001 18:11 ▲ 70 · 댓글 2 3D 가우시안 스플래팅, 장면 규모 차이 극복하다 기존 피드포워드 3DGS(3D 가우시안 스플래팅) 방법들은 가우시안 속성을 반지름 거리 정규화 공간에서 예측했는데, 이때 인접한 가우시안 중심 간의 간격이 장면 규모와 카메라 설정에 따라 크게 변한다. AI · 머신러닝 · SplatAnything: Gaussian Spacing Normalization for Feed-forward 3DGS across Arbitrary Scenes
Key Point 3D 장면 재구성의 핵심 문제인 규모 변화에 대한 보다 견고한 해결책을 제시해 3DGS 기반 응용 분야에서 일반화 성능을 높일 수 있다.
핵심 요약
기존 피드포워드 3DGS(3D 가우시안 스플래팅) 방법들은 가우시안 속성을 반지름 거리 정규화 공간에서 예측했는데, 이때 인접한 가우시안 중심 간의 간격이 장면 규모와 카메라 설정에 따라 크게 변한다. 이 불일치로 인해 가우시안 스케일 타겟에 체계적 편향이 생기고 학습 신호가 모호해지는 문제가 발생한다. SplatAnything은 Gaussian Spacing Normalization(GSNorm)을 도입해 장면 수준의 가우시안 간격 통계를 정규화하고 예측을 위한 일관된 공간 기준을 제공한다. 전체 요약 5문장 읽기 → 002 15:11 ▲ 18 · 댓글 3 반복 최적화하는 3D 구조 재구성 모델 'Solv3R' 공개 기존 3D 재구성 모델은 단일 순회로 전체 기하 정보를 예측하거나 프레임을 순차적으로 처리하는 방식으로 작동하지만, 새로운 뷰를 추가하거나 기존 추정값을 정제하기 어려웠다. AI · 머신러닝 · Solv3R: 3D Looped Transformer as a Multi-view Solver
Key Point 카메라 포즈 추정과 3D 기하 재구성을 점진적으로 개선하는 방식을 학습 가능한 솔버로 통합해, 새로운 이미지 추가나 기존 결과 정제가 자유로워졌다.
핵심 요약
기존 3D 재구성 모델은 단일 순회로 전체 기하 정보를 예측하거나 프레임을 순차적으로 처리하는 방식으로 작동하지만, 새로운 뷰를 추가하거나 기존 추정값을 정제하기 어려웠다. Solv3R은 반복 루프 구조로 현재 상태에서부터 계속 3D 기하를 풀어나가는 루프 변환기(looped transformer)이며, 이미 정제된 뷰와 새로 추가된 뷰를 함께 업데이트할 수 있다. 업데이트 연산자가 반복 횟수와 독립적으로 작동하므로, 각 뷰가 얼마나 정확한지와 관계없이 동일하게 처리된다. 전체 요약 6문장 읽기 → 003 21:11 ▲ 38 · 댓글 1 360도 파노라마도 구성미 판단해 프레이밍하는 AI 기존 사진 자르기 기법은 이미 있는 이미지에서 어디를 자를지만 결정하지만, 360도 파노라마는 먼저 어느 방향을 봐야 할지 찾아야 한다. AI · 머신러닝 · PhotoGuider: Composition-Aware Cropping and 360^{circ} View Framing with Explainable Photographic Assessments
Key Point 360도 파노라마 이미지의 최적 프레이밍을 자동으로 결정하고 설명해주는 AI 방법이 필요한 3D 콘텐츠 제작과 가상 현실 분야에서 실용적 활용이 가능해진다.
핵심 요약
기존 사진 자르기 기법은 이미 있는 이미지에서 어디를 자를지만 결정하지만, 360도 파노라마는 먼저 어느 방향을 봐야 할지 찾아야 한다. PhotoGuider는 측정 후 프레이밍 방식으로 구성미 기반 방향 선택과 최종 프레이밍을 모두 해결하는 첫 방법이다. Subject, Composition, Aesthetics, Integrity 네 가지 포토그래픽 토큰으로 구성미를 인식하는 특징을 추출하고, 기초 및 태스크 특화 비전 모델을 사용한다. 전체 요약 7문장 읽기 → 004 18:11 ▲ 33 · 댓글 3 컴퓨터 제어 AI, 실수 복구 능력 체계적으로 평가하기 키보드·마우스로 디지털 업무를 자동화하는 컴퓨터 제어 AI 에이전트는 긴 작업 흐름에서 오류가 쌓이고 의도하지 않은 부작용이 생기면서 실수에서 복구하는 능력이 중요해졌다. AI · 머신러닝 · Lost in Recovery: Demystifying Recovery Behavior of Computer-Use Agents via Goal-Oriented Action Replay
Key Point 컴퓨터 자동화 에이전트의 신뢰성을 높이는 핵심인 '오류 복구'를 처음 체계적으로 평가하고, 현재 AI 모델들이 자신의 복구 능력을 제대로 사용하지 못하고 있다는 실제 한계를 드러낸다.
핵심 요약
키보드·마우스로 디지털 업무를 자동화하는 컴퓨터 제어 AI 에이전트는 긴 작업 흐름에서 오류가 쌓이고 의도하지 않은 부작용이 생기면서 실수에서 복구하는 능력이 중요해졌다. 기존 복구 방식은 한계가 있다: 소유권이 있는 시스템은 환경 초기화가 불가능하고, 긴 작업 흐름에서 액션 재실행은 비용이 너무 크며, API 기반 되돌리기는 웹 환경에만 적용되므로 모델 기반 복구는 거의 연구되지 않았다. 연구팀은 ReTrace라는 평가 프레임워크를 제시해 컴퓨터 제어 에이전트의 복구 동작을 체계적으로 연구한다. 전체 요약 8문장 읽기 → 005 15:11 ▲ 31 · 댓글 1 대규모 경험으로 AI 컴퓨터 제어 에이전트를 강화하는 NorthCUA NorthCUA는 컴퓨터 제어 에이전트를 복잡한 소프트웨어 작업까지 확장하기 위한 통합 시스템이다. AI · 머신러닝 · NorthCUA Technical Report: Turbocharging Computer-Use Agents through Experience at Scale
Key Point 컴퓨터 제어 AI가 복잡한 소프트웨어 작업을 자동화할 수 있는 수준으로 도달하는 과정을 보여주며, 오픈소스 에이전트 개발의 새로운 기준을 제시한다.
핵심 요약
NorthCUA는 컴퓨터 제어 에이전트를 복잡한 소프트웨어 작업까지 확장하기 위한 통합 시스템이다. Experience Flywheel이 다양한 실행 가능한 작업을 공급하고, NorthCUA Harness가 장시간 상호작용을 유지하며 의사결정을 기록하고 작업 결과를 검증한다. Flywheel은 이러한 기록으로부터 검증된 궤적(trajectory)을 선별하고, 해결되지 않은 작업은 재귀적 자가개선을 통해 재사용 가능한 스킬을 진화시키면서 검증된 마일스톤을 보존해 이전 진행 과정을 바탕으로 한다. 전체 요약 7문장 읽기 → 006 21:11 ▲ 13 · 댓글 2 물체를 자연스럽게 삽입하는 생성형 AI, 조명과 자세까지 맞춘다 기존 객체 삽입 방식은 마스크 입력이나 제한된 시점 변화만 다뤄 조명·자세 적응과 양방향 상호작용이 부족했다. AI · 머신러닝 · PhysInsert: Physically Plausible Object Insertion with Geometric Priors and Bidirectional Object-Scene Interactions
Key Point 3D 장면의 조명, 자세, 기하학적 관계까지 고려한 객체 합성은 게임·영화 제작·AR 응용에 실질적으로 필요한 기술로, 기존 방식의 한계를 직결적으로 해결한다.
핵심 요약
기존 객체 삽입 방식은 마스크 입력이나 제한된 시점 변화만 다뤄 조명·자세 적응과 양방향 상호작용이 부족했다. 새로운 프레임워크 PhysInsert는 Blender로 렌더링한 정렬된 데이터셋(Insert World)으로 학습하며, 다양한 시점과 조명 조건 하에서 참조 객체를 삽입한다. 기하학 가이드 적응(Geometry-Guided Adaptation)이 VGGT 기하학 스트림·이미지·텍스트 스트림을 통합해 공간적으로 일관된 삽입을 유도한다. 전체 요약 6문장 읽기 → 007 00:11 ▲ 11 · 댓글 2 단일 이미지에서 3D 장면 재구성, 객체 기반 접근법으로 품질 향상 단일 이미지로부터 3D 장면을 구성하는 문제를 다루며, 기존의 SAM-3Dfy 같은 방식이 세밀한 기하학적 표현과 자산 품질에서 한계를 보인다. AI · 머신러닝 · Easy-3Dfy: Object-Level Geometric Composition for Single-Image 3D Scene Construction
Key Point 3D 장면 재구성 품질을 높이는 새로운 구성 방식의 등장으로, 컴퓨터 비전 모델 설계 방향을 보여주는 선례입니다.
핵심 요약
단일 이미지로부터 3D 장면을 구성하는 문제를 다루며, 기존의 SAM-3Dfy 같은 방식이 세밀한 기하학적 표현과 자산 품질에서 한계를 보인다. 연구팀은 Easy-3Dfy라는 구성 기반 워크플로우를 제안했으며, 이는 객체 생성과 장면 배치 추정을 분리해 각 모델의 강점을 활용한다. 특화된 3D 객체 생성기는 상세한 객체 기하학을, 3D 기초 모델은 강력한 공간 이해를 각각 담당하도록 설계했다. 전체 요약 6문장 읽기 → 008 06:11 ▲ 143 · 댓글 45 $2 마이크로컨트롤러에서 SIMD로 컴퓨터 비전 가속하기 ESP32-S3 마이크로컨트롤러의 128비트 SIMD 명령어를 활용한 FAST 코너 감지기를 구현했으며, 기존 구현 대비 약 2배 빠른 성능으로 QVGA(320x240) 프레임을 약 6ms에 처리한다. 하드웨어 · 시스템 · SIMD-accelerated computer vision on a $2 microcontroller
Key Point $2 저가 마이크로컨트롤러의 숨겨진 SIMD 명령어를 활용해 컴퓨터 비전 성능을 2배 향상시킨 방법과, 하드웨어 제약을 창의적으로 극복한 어셈블리 최적화 기법을 배울 수 있다.
핵심 요약
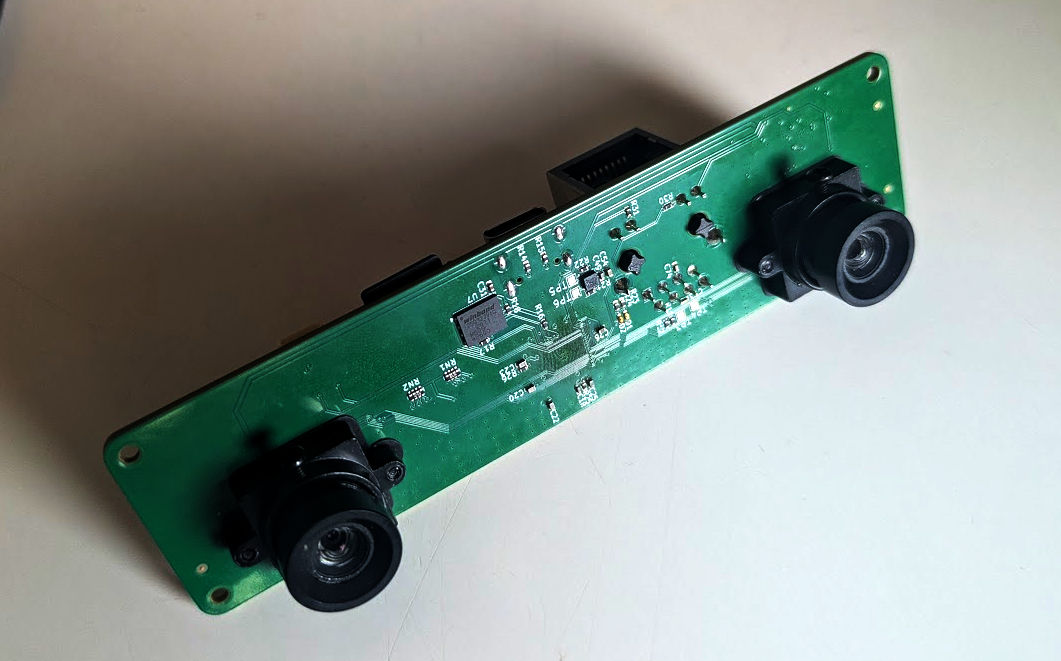
ESP32-S3 마이크로컨트롤러의 128비트 SIMD 명령어를 활용한 FAST 코너 감지기를 구현했으며, 기존 구현 대비 약 2배 빠른 성능으로 QVGA(320x240) 프레임을 약 6ms에 처리한다. ESP32-S3는 240MHz 듀얼코어 CPU, WiFi, BLE 라디오를 탑재한 저가 칩이지만 SIMD 명령어 지원에 대한 정보가 거의 알려져 있지 않아 직접 실험과 최적화를 진행했다. SIMD 구현 과정에서 미정렬 읽기 불지원 문제를 두 개의 인접한 레지스터를 읽은 후 슬라이스 추출 명령어로 극복했다. 전체 요약 6문장 읽기 → 009 00:11 ▲ 106 · 댓글 17 스테레오 비전 기능을 갖춘 저가 해킹보드 공개 Rockchip RV1103 SoC(단일코어 1.1GHz ARM Cortex-A7, 64MB DDR2 RAM, QFN-88 패키지)를 사용하여 스테레오 비전 보드를 설계했고, 로봇공학 프로젝트의 장애물 회피·항법 용도로 활용할 수 있다. 하드웨어 · 시스템 · I Built a Stereo Vision Board for Hardware Hackers
Key Point 저비용 SoC로 완전한 스테레오 비전 보드를 만들어 오픈소스 설계를 공개하므로, 로보틱스나 컴퓨터 비전이 필요한 하드웨어 프로젝트의 새로운 선택지가 될 수 있다.
핵심 요약
Rockchip RV1103 SoC(단일코어 1.1GHz ARM Cortex-A7, 64MB DDR2 RAM, QFN-88 패키지)를 사용하여 스테레오 비전 보드를 설계했고, 로봇공학 프로젝트의 장애물 회피·항법 용도로 활용할 수 있다. 4층 PCB 보드를 제작했으며 처음 설계에서 SoC 오주문, 렌즈 마운트 홀 크기 오류, LED 저항값 부족, 0.9V 트레이스 두께 미흡 등 몇 가지 문제가 있었다. Buildroot 빌드 시스템으로 Linux 커널·부트로더·드라이버를 구성했으며, Rockchip MIPI 드라이버·하드웨어 가속기 등은 벤더 BSP(보드 서포트 패키지)에서 가져왔다. 전체 요약 8문장 읽기 → 010 21:11 당일 +124 원신 자동화 도구 BetterGI, 컴퓨터 비전으로 게임 플레이 자동화 BetterGI는 컴퓨터 비전 기술을 기반으로 원신의 반복 작업을 자동화하는 Windows 전용 도구이다. 오픈소스 · 도구 · babalae/better-genshin-impact · C#
Key Point 게임을 하지 않아도 자동화 도구가 모든 일일 퀘스트를 완료해주는 기술 방식과 잠재적 밴 위험이 원신 플레이어와 게임 규제 관점에서 주의 깊게 봐야 할 대상이다.
핵심 요약
BetterGI는 컴퓨터 비전 기술을 기반으로 원신의 반복 작업을 자동화하는 Windows 전용 도구이다. 자동 물품 수거, 자동 스토리 진행, AI 기반 반자동 낚시, 자동 성유물 분해 등 실시간 작업 기능을 제공한다. 전자동 신의 주사위 게임, 자동 벌목, 자동 비경, 자동 지맥의 꽃, 자동 악기 게임, 자동 요리 등 독립 작업 기능도 포함된다. 전체 요약 10문장 읽기 → 011 18:11 ▲ 243 · 댓글 2 객체부터 픽셀까지, 시각-언어 모델의 정밀 인식 통합 웨이신(WeChat) 팀이 WeVisOne-VL이라는 새로운 비전-언어 모델을 공개했으며, 객체 수준과 픽셀 수준의 시각 인식을 구조화된 토큰 예측으로 통합한다. AI · 머신러닝 · WeVisOne-VL: Unified Visual Perception from Objects to Pixels
Key Point 기존 비전-언어 모델들의 가장 큰 약점인 세밀한 시각 인식 신뢰성을 단일 모델로 해결하는 방법을 제시하여, VLM 기반 시스템의 실제 배포 가능성을 높였다.
핵심 요약
웨이신(WeChat) 팀이 WeVisOne-VL이라는 새로운 비전-언어 모델을 공개했으며, 객체 수준과 픽셀 수준의 시각 인식을 구조화된 토큰 예측으로 통합한다. 모델은 물체 탐지, 참조 위치파악, 개수 세기, OCR, 분할, 매팅 등 여러 시각 작업을 지원하며, 점과 상자부터 마스크와 알파 매트까지 사용자가 원하는 수준의 위치 파악을 가능하게 한다. 가벼운 픽셀 디코더를 특수 토큰을 통해 VLM에 통합하여 인스턴스 수준의 픽셀 출력을 생성한다. 전체 요약 6문장 읽기 → 012 15:11 ▲ 484 · 댓글 2 다중분광 이미지 해석용 위치-채널 기반 설명 방법 다중분광 데이터에서 모델이 어느 위치의 어떤 채널을 중시하는지 한 번에 보여주는 SSI(Spectral-Spatial Interpretation) 방법을 제시한다. AI · 머신러닝 · Spectral-Spatial Interpretation
Key Point 위성·의료영상 등 다중분광 데이터를 다루는 컴퓨터 비전 모델에서 어느 파장대 어느 위치가 결정에 영향을 미치는지 정확히 파악할 수 있게 되면 모델 해석 능력이 한 단계 높아진다.
핵심 요약
다중분광 데이터에서 모델이 어느 위치의 어떤 채널을 중시하는지 한 번에 보여주는 SSI(Spectral-Spatial Interpretation) 방법을 제시한다. 기존 방식은 공간적 히트맵이나 전역 채널 점수만 보여주는데, SSI는 각 위치마다 채널 간 상호작용을 조건부 게임으로 정의하고 샤플리 값을 적용해 위치-채널 기여도 행렬을 생성한다. 고정된 주변 맥락 속에서 각 위치의 채널별 중요도를 계산하며, 채널 기여도를 모두 합산하면 그 위치를 기준 이미지로 교체했을 때의 효과와 정확히 일치한다. 전체 요약 6문장 읽기 → 013 21:11 ▲ 104 · 댓글 105 AI와 함께 일하는 방식, 3년 만에 완전히 달라졌다 ChatGPT 초기에는 검색 엔진처럼 사용했으나, 점차 Ruby 코드 작성처럼 구체적인 코드 생성 도구로 활용하기 시작했다. AI · 머신러닝 · My old job feels distant now
Key Point 개발자의 일이 AI 발전에 따라 어떻게 실제로 변해왔는지, 검색 대체에서 진정한 협업으로의 전환 과정을 구체적으로 보여준다.
핵심 요약
ChatGPT 초기에는 검색 엔진처럼 사용했으나, 점차 Ruby 코드 작성처럼 구체적인 코드 생성 도구로 활용하기 시작했다. Cursor와 탭 완성은 IDE 통합이 자연스러웠으나, 본격적인 진전은 새로운 도메인(컴퓨터 비전)에서 ChatGPT로 API 검색과 코드 생성을 결합했을 때였다. 할루시네이션을 모델의 한계 신호로 읽고 스스로 빈틈을 채우며 학습했으며, 이는 SEO 스팸과 불완전한 문서의 문제를 우회하는 경험이었다. 전체 요약 11문장 읽기 → 014 15:11 ▲ 16 · 댓글 2 단안 카메라 영상에서 인물 추적 시 발생하는 스케일 미스매치 문제 해결 단안 카메라에서 3D 인물 복원 기술들이 현재 벤치마크에서는 잘 작동하지만, 빠른 카메라 움직임을 포함한 데이터에는 문제가 있었다. AI · 머신러닝 · A Diagnostic Study of World-Space Human Recovery Under High Camera Dynamics
Key Point 빠르게 움직이는 카메라가 있는 실제 방송 환경에서 인물 3D 복원 기술의 정확도를 크게 떨어뜨리는 스케일 미스매치 문제와 그 원인, 그리고 간단한 해결책을 제시한다.
핵심 요약
단안 카메라에서 3D 인물 복원 기술들이 현재 벤치마크에서는 잘 작동하지만, 빠른 카메라 움직임을 포함한 데이터에는 문제가 있었다. 연구팀이 K-Pop 스트레스 테스트를 도입했는데, 이는 빠르고 큰 카메라 움직임과 복잡한 다중 인물 안무를 결합한 방송 댄스 영상들이다. 기존 최고 성능 방법들은 이 영상에서 프레임별로는 그럴듯한 메시를 생성하지만, 월드 좌표계 상의 인물 궤적은 실제 무대 위치에서 크게 벗어난다. 전체 요약 7문장 읽기 → 015 21:11 당일 +360 Windows에서 AI 에이전트 제어하는 MCP 서버 오픈소스 Windows-MCP는 LLM 기반 AI 에이전트가 Windows OS와 상호작용하도록 하는 경량 오픈소스 MCP 서버다. AI · 머신러닝 · CursorTouch/Windows-MCP · Python
Key Point AI 에이전트가 Windows 데스크톱을 네이티브하게 조종할 수 있는 오픈소스 표준이 등장했으며, 개발자들은 이를 자동화나 AI 통합 프로젝트에 즉시 활용할 수 있다.
핵심 요약
Windows-MCP는 LLM 기반 AI 에이전트가 Windows OS와 상호작용하도록 하는 경량 오픈소스 MCP 서버다. 파일 탐색, 애플리케이션 제어, UI 상호작용, QA 테스트 등의 작업을 자동화할 수 있으며, 컴퓨터 비전이나 특정 모델 학습 없이 모든 LLM과 호환된다. Python 3.13+ 환경에서 실행되며, Claude Desktop, Cursor, Perplexity, Gemini CLI 등 다양한 MCP 클라이언트에 연동 가능하고, PyPI를 통해 `uvx windows-mcp`로 설치할 수 있다. 전체 요약 9문장 읽기 → 016 06:11 ▲ 120 · 댓글 131 LinkedIn의 가짜 프로젝트 문화, 1시간 반이면 충분하다 LinkedIn의 피드는 실제 가치 없는 프로젝트로 가득한데, 손 제스처 인식, 포트홀 감지 등 컴퓨터 비전 프로젝트가 반복되고 있다. 스타트업 · 비즈니스 · LinkedIn Larpmaxxing
Key Point LinkedIn에서 보이는 기술 프로젝트는 실질적 개선 없이 반복되는 '가짜 활동'이며, 저자가 직접 만든 예시를 통해 이런 '전문가' 포스팅이 얼마나 쉽고 무의미한지 보여주기 때문입니다.
핵심 요약
LinkedIn의 피드는 실제 가치 없는 프로젝트로 가득한데, 손 제스처 인식, 포트홀 감지 등 컴퓨터 비전 프로젝트가 반복되고 있다. 이들 프로젝트는 대부분 튜토리얼을 따라 만들었거나 단순히 멋져 보이려는 목적이며, 실제 실용성이나 개선 의지가 없다. 저자는 LinkedIn의 'YOLO 프로젝트 감지기'를 직접 만들어봤는데, 데이터 수집(스크린샷 200장)부터 모델 학습까지 총 1시간 30분이 걸렸다. 전체 요약 8문장 읽기 → 017 18:11 ▲ 17 · 댓글 1 계층적 표현 학습으로 이미지 재구성 품질 향상 사전학습된 시각 표현은 이미지 생성에는 유용하지만 충실한 복원에 필요한 세부 사항을 완전히 보존하지 못한다. AI · 머신러닝 · HiRAE: Hierarchical Representation Autoencoding with Residual Budgets
Key Point 인코더 계층의 다중 정보를 효율적으로 활용해 이미지 복원 품질을 크게 높인 방법론으로, 복잡한 튜닝 없이 생성 모델과의 호환성을 유지하는 점이 실무적 가치가 있다.
핵심 요약
사전학습된 시각 표현은 이미지 생성에는 유용하지만 충실한 복원에 필요한 세부 사항을 완전히 보존하지 못한다. 인코더의 중간 계층들은 보완적인 시각 정보를 가지고 있으나 이들을 효과적으로 융합하면 모델링이 어려운 잠재 분포가 생성된다. 기존 융합 방식은 계층 선택의 경험적 튜닝이나 단계별 최적화가 필요해 설정 비용과 학습 복잡도가 높다. 전체 요약 8문장 읽기 → 018 03:11 ▲ 16 · 댓글 2 GPT-6 Astra의 컴퓨터 비전 능력 평가, 일반형 AI의 한계 드러나 Frontier 수준의 범용 AI 시스템들이 전통적인 컴퓨터 비전 모델의 영역으로 확대되고 있다. AI · 머신러닝 · Hard Vision, Easy Vision: What GPT-6 Astra Reveals Across Computer Vision
Key Point 범용 AI 모델의 컴퓨터 비전 능력 한계를 구체적으로 파악할 수 있으며, 향후 비전 모델 개발의 방향성을 시사한다.
핵심 요약
Frontier 수준의 범용 AI 시스템들이 전통적인 컴퓨터 비전 모델의 영역으로 확대되고 있다. GPT-6 Astra를 포함한 5개 frontier AI 시스템을 9개 비전 영역, 55개 벤치마크, 34개 능력에 걸쳐 평가했다. Astra는 시각 및 공간 추론과 구조화된 예측 분야에서 다른 frontier 시스템들을 크게 앞섰다. 전체 요약 7문장 읽기 → 019 21:11 당일 +124 Neuro-sama 같은 AI 캐릭터를 직접 만드는 오픈소스 프로젝트 AIRI Neuro-sama 같은 자체호스팅 가능한 AI 동반자를 만드는 오픈소스 프로젝트로, TypeScript 기반 웹 기술과 네이티브 기술을 함께 사용한다. AI · 머신러닝 · moeru-ai/airi · TypeScript
Key Point Neuro-sama 같은 AI 가상 캐릭터를 누구나 직접 구축할 수 있는 완전한 오픈소스 플랫폼이 나왔고, 게임 플레이부터 음성 채팅까지 놀라운 수준의 기능을 갖추고 있다.
핵심 요약
Neuro-sama 같은 자체호스팅 가능한 AI 동반자를 만드는 오픈소스 프로젝트로, TypeScript 기반 웹 기술과 네이티브 기술을 함께 사용한다. 브라우저, macOS, Windows 데스크톱, 모바일 PWA 등 다양한 플랫폼에서 실시간 음성 채팅이 가능하며, Minecraft, Factorio, Kerbal Space Program 등 여러 게임을 플레이할 수 있다. WebGPU, WebAssembly, Web Workers 등 웹 기술로 그래픽과 레이아웃을 처리하면서도, NVIDIA CUDA와 Apple Metal을 통한 네이티브 추론으로 성능을 확보하는 하이브리드 아키텍처를 채택했다. 전체 요약 12문장 읽기 → 020 18:11 ▲ 42 · 댓글 3 다국어 텍스트 인식에 최적화된 MoE 아키텍처 다국어 OCR의 문제점을 해결하기 위해 script-aware Mixture-of-Experts(ScriptMoE) 아키텍처를 제안했다. AI · 머신러닝 · All-in-One Multilingual Scene Text Recognition with Script-aware Mixture-of-Experts
Key Point 언어별 별도 모델 배포 비용과 복잡성 없이 실무 OCR 성능을 크게 개선하는 실용적 기술로, 다국어 텍스트 인식이 필요한 개발자들이 주목할 만하다.
핵심 요약
다국어 OCR의 문제점을 해결하기 위해 script-aware Mixture-of-Experts(ScriptMoE) 아키텍처를 제안했다. TextMuSS-10M이라는 10개 문자 체계와 229개 언어를 포함한 대규모 합성 텍스트 데이터셋을 구축했다. ScriptMoE는 단일 비전 인코더와 이미지별 라우터가 상위 2개의 문자 체계 전문 모듈로 분배하는 희소 MoE 블록으로 구성된다. 전체 요약 5문장 읽기 → 021 08:25 당일 +195 컴퓨터 비전 개발을 빠르게, Supervision 라이브러리 Roboflow가 제공하는 Python 기반 오픈소스 라이브러리로, 모델 불가지론적 설계로 모든 분류·탐지·분할 모델을 연결할 수 있다. 오픈소스 · 도구 · roboflow/supervision · Python
Key Point 컴퓨터 비전 프로젝트의 반복적인 작업을 표준화된 도구로 통일할 수 있어, 모델 선택에 관계없이 동일한 코드로 여러 프레임워크를 활용할 수 있다.
핵심 요약
Roboflow가 제공하는 Python 기반 오픈소스 라이브러리로, 모델 불가지론적 설계로 모든 분류·탐지·분할 모델을 연결할 수 있다. Ultralytics, Transformers, MMDetection 등 인기 라이브러리와 기본 통합되며, 커스텀 모델도 손쉽게 연결할 수 있다. 데이터 로딩부터 실시간 구역 카운팅까지 컴퓨터 비전 작업의 전체 파이프라인을 지원한다. 전체 요약 5문장 읽기 →