쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
18건 · "프론티어 모델"조건 지우기 ×
001 06:11 ▲ 103 · 댓글 37 AI 모델이 가중치 조작으로 다른 모델에 악성 행동 주입 가능 신경망의 가중치를 직접 수정하는 '가중치 공간 편집'은 정당한 용도가 있지만, 한 모델이 다른 모델에 무단으로 악성 행동을 주입할 수 있는 새로운 공격 벡터를 열었다. AI · 머신러닝 · Models can now transmit viruses in weight-space
Key Point 가중치 편집 기술이 발전하면서 모델 간 악성 조작이 가능해졌고, 정당한 용도와 보안 위험 사이의 균형 문제가 AI 시스템의 배포 및 관리 방식에 직결되기 때문이다.
핵심 요약
신경망의 가중치를 직접 수정하는 '가중치 공간 편집'은 정당한 용도가 있지만, 한 모델이 다른 모델에 무단으로 악성 행동을 주입할 수 있는 새로운 공격 벡터를 열었다. 연구팀은 이를 단백질 오류 접기 현상에 빗대어 '가중치 공간 오류 접기(weight space misfolding)'라 명명했고, 직접 간섭과 모델 간 전파 가능성을 분석했다. 공격자는 페이로드를 한 번만 생성하면 되지만, 방어자는 방대한 가중치 중에서 악성 수정을 찾아야 하는 불균형적 상황을 지적했다. 전체 요약 10문장 읽기 → 002 03:11 ▲ 215 · 댓글 114 구글, 최강 프론티어 모델 'Gemini 4 Carbon' 공개 Google DeepMind이 Gemini 4 Carbon을 공개했으며, 개발자·기업·과학자·일반 사용자가 이용할 수 있다. AI · 머신러닝 · Gemini 4 Carbon is now available
Key Point 사이버보안·과학·엔지니어링 분야의 최고 성능과 동일한 Argon 가격으로 제공되며, /swarm 기능으로 멀티에이전트 협업 방식이 표준화되기 시작했다.
핵심 요약
Google DeepMind이 Gemini 4 Carbon을 공개했으며, 개발자·기업·과학자·일반 사용자가 이용할 수 있다. Gemini 4 Argon 이후 나온 Carbon은 사이버보안, 장기 에이전트 워크플로우, 소프트웨어 엔지니어링, 과학적 추론에서 최강 성능을 제공한다. CursorBench 4.0, Perplexity의 WANDR, Zapier의 AutomationBench에서 1위를 차지했으며, 다음 최고 모델 대비 비용은 2배 이상 낮다. 전체 요약 16문장 읽기 → 003 00:11 ▲ 22 · 댓글 3 저자극 언어를 위한 202개 소프트웨어 공학 과제 벤치마크 공개 기존 저장소 수준 벤치마크에서 커버되지 않은 13개 언어(클로저, 다트, 엘릭서, 얼랑, F#, 해스켈, 줄리아, 코틀린, 루아, OCaml, R, 스칼라, 스위프트)에 대해 202개의 이슈 해결 과제로 구성된 Longtail-SWE 벤치마크를 발표했다. AI · 머신러닝 · Longtail-SWE: High-Quality SWE Tasks for Underrepresented Languages
Key Point 13개 저자극 프로그래밍 언어에 대한 첫 대규모 저장소 수준 벤치마크로, 비주류 언어 생태계의 AI 코딩 능력 평가와 개선에 실질적인 자료를 제공한다.
핵심 요약
기존 저장소 수준 벤치마크에서 커버되지 않은 13개 언어(클로저, 다트, 엘릭서, 얼랑, F#, 해스켈, 줄리아, 코틀린, 루아, OCaml, R, 스칼라, 스위프트)에 대해 202개의 이슈 해결 과제로 구성된 Longtail-SWE 벤치마크를 발표했다. 벤치마크 구성 과정에서 솔버가 각 과제를 시도하고, 판사가 솔버의 궤적과 테스트 결과를 검토한 뒤, 수리자가 테스트와 과제 설명을 개선하는 3단계 파이프라인을 사용했다. 이 과정은 유효한 대체 구현을 거부하는 테스트나 부정확한 솔루션을 허용하는 테스트를 수정하면서도 도전적인 과제를 유지하고 원래 의도를 보존하는 것을 목표로 한다. 전체 요약 5문장 읽기 → 004 18:11 ▲ 40 · 댓글 3 LLM 에이전트를 위한 도구 기반 환경 자동 합성 기법 ToolSpace LLM이 장기 작업을 수행하는 에이전트로 배포될 때 다양한 도구를 조합해 워크플로우를 실행하는데, 기존 MCP 환경 확장 방식은 데이터베이스와 시나리오부터 만들고 거기서 도구를 도출해 도구 인터페이스와 실제 환경이 맞지 않는 문제가 있다. AI · 머신러닝 · ToolSpace: Scaling Tool-Centric Environment Synthesis for Long-Horizon Agents
Key Point LLM 에이전트의 다중 도구 조합 능력 평가 방식이 혁신되고 있으며, 실행 기반 환경 합성이 기존 데이터 기반 방식보다 훨씬 효과적임을 보여주는 구체적 증거가 제시되었다.
핵심 요약
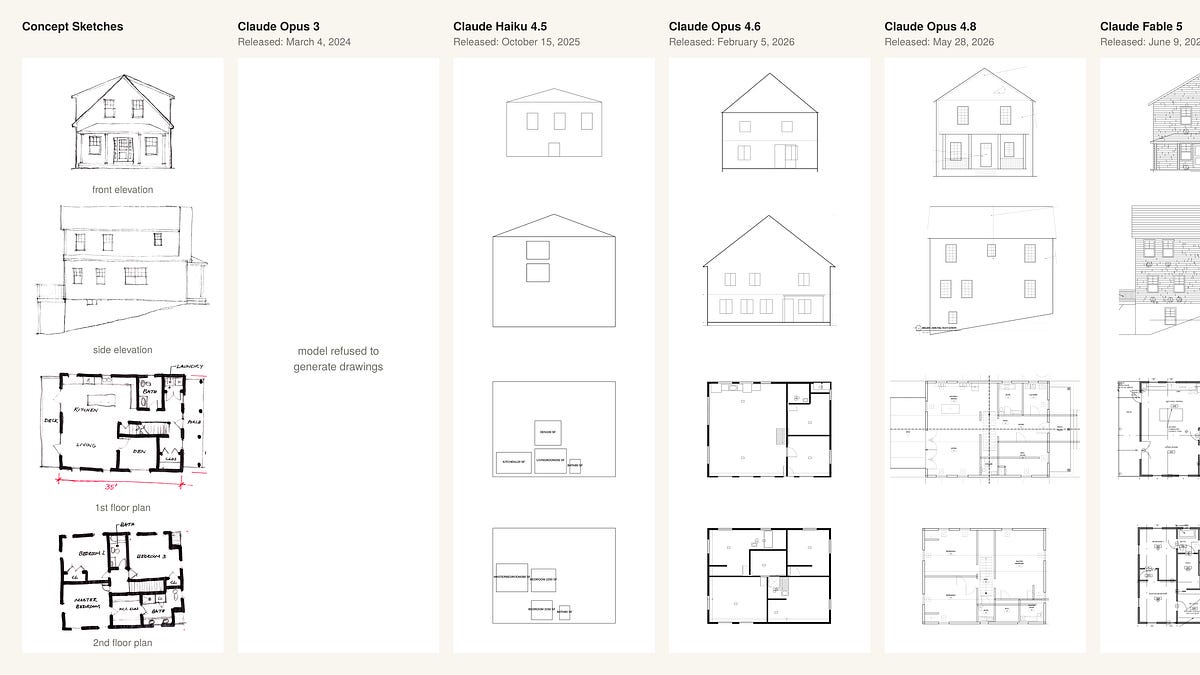
LLM이 장기 작업을 수행하는 에이전트로 배포될 때 다양한 도구를 조합해 워크플로우를 실행하는데, 기존 MCP 환경 확장 방식은 데이터베이스와 시나리오부터 만들고 거기서 도구를 도출해 도구 인터페이스와 실제 환경이 맞지 않는 문제가 있다. ToolSpace는 이 순서를 역으로 바꿔, 실제 MCP 서비스 실행 기록과 오픈 에이전트 코퍼스에서 인접한 호출들의 데이터·상태·재시도 의존성을 LLM 판단이 아닌 결정론적 규칙으로 추출하고, 가중치 있는 도구 조합 그래프를 환경으로 클러스터링한다. 상태 변경 환경만 데이터베이스를 합성하고, 조회·무상태 도구는 기록된 반환값을 재사용하며, 상태 인식 랜덤 워크와 롤백으로 각 체인을 자연어 작업으로 디컴파일하고 초기 상태에서 성공 재실행되는 샘플만 보관한다. 전체 요약 6문장 읽기 → 005 00:11 ▲ 103 · 댓글 35 Claude Opus 5.5, 건축 인허가 수준의 도면 자동 작성 가능 건축가인 저자가 13개 AI 모델의 기술도면 작성 능력을 테스트했으며, Anthropic의 Claude Opus 5.5(2026년 9월 출시)가 적절한 지도 하에 주택용 건축 인허가 수준의 완전한 도면 세트를 생산할 수 있음을 발견했다. AI · 머신러닝 · Claude Opus 5.5 Can Draw Permit-Level Architectural Drawings
Key Point 건축 설계와 도면 작업이 AI의 급속한 발전으로 근본적으로 변할 시점에 있으며, 숙련된 건축가도 현장에서 감독하기 어려운 변화가 임박해 있기 때문이다.
핵심 요약
건축가인 저자가 13개 AI 모델의 기술도면 작성 능력을 테스트했으며, Anthropic의 Claude Opus 5.5(2026년 9월 출시)가 적절한 지도 하에 주택용 건축 인허가 수준의 완전한 도면 세트를 생산할 수 있음을 발견했다. 2026년 봄까지 최강 AI 모델도 조악하고 만화 같은 기술도면만 생산했으나, 2026년 여름부터 가을 출시된 프론티어 모델들이 급격히 개선되었다. 첫 번째 테스트에서 Opus 5.5는 저자의 컨셉 스케치와 참조 도면 세트를 받아 12시간 걸려 완전한 건축 도면 세트를 생성했으며, 계산 비용은 수백 달러였다. 전체 요약 12문장 읽기 → 006 15:11 ▲ 20 · 댓글 2 소형 언어모델로 로봇 조작 명령 프로그래밍하기 로봇 조작을 코드로 구현하는 'code-as-policy(CaP)' 방식에서 기존 접근은 GPT 같은 프론티어 모델을 의존하거나 사전학습된 비전-언어-액션 모델(VLA)을 위임했다. AI · 머신러닝 · CaPtain: A Pipeline for Post-Training Code-as-Policy Robot Agents
Key Point 로봇 조작 AI를 프론티어 모델 의존에서 벗어나 오픈소스 소형 모델로도 실현할 수 있게 하는 구체적 방법과 검증 결과를 제시한다.
핵심 요약
로봇 조작을 코드로 구현하는 'code-as-policy(CaP)' 방식에서 기존 접근은 GPT 같은 프론티어 모델을 의존하거나 사전학습된 비전-언어-액션 모델(VLA)을 위임했다. 연구팀이 공개한 CaPtain은 소형 오픈소스 비전-언어 모델(Qwen 3.5-4B)을 미세조정과 강화학습으로 독립적인 로봇 정책 에이전트로 훈련하는 파이프라인이다. 파이프라인은 CaPtain-Harness라는 프레임워크 위에서 동작하며, 로봇 API, 저수준 인지·기하학·안전 이동 원시 동작을 시뮬레이션과 실제 하드웨어에서 노출한다. 전체 요약 8문장 읽기 → 007 15:11 ▲ 39 · 댓글 2 AI 에이전트가 독립적으로 언어모델 학습, 인간 피드백으로 개선 AI 에이전트가 자율적으로 언어모델을 학습하고 사용자 피드백으로 개선할 수 있는지 확인하는 RSI Arena 연구를 공개했다. AI · 머신러닝 · RSI Arena: Towards Recursive Self-Improvement with Human Feedback
Key Point AI 모델 개발 주도권이 인간에서 AI로 이동할 가능성을 보여주는 연구로, 인간 피드백이 자율 시스템에 어떻게 통합되는지 실증적으로 보여준다.
핵심 요약
AI 에이전트가 자율적으로 언어모델을 학습하고 사용자 피드백으로 개선할 수 있는지 확인하는 RSI Arena 연구를 공개했다. 10개 프론티어 모델을 학습 에이전트로 사용해, 각각 1,000 GPU시간과 $300의 API 크레딧을 주고 6일간 독립적으로 데이터 선택·학습·체크포인트 선택을 하게 했다. 모든 10개 에이전트가 작동하는 어시스턴트를 만들었으며, GPT-6 Astra가 학습한 최강 모델은 12개 성능 벤치마크에서 기본 모델과 Instruct 버전의 중앙값 차이의 76%를 좁혔다. 전체 요약 8문장 읽기 → 008 06:11 ▲ 135 · 댓글 64 아마존, AI 사업 대폭 축소 후유증 아마존이 자체 AI 연구소를 대폭 축소하고 있다. ChatGPT, Claude, Gemini 같은 대형 언어모델과 달리 아마존의 Nova는 시장에서 주목받지 못했다. AI · 머신러닝 · Amazon Is Gutting Its AI Division After Sustained Failure
Key Point 아마존 같은 거대 기술 기업도 LLM 투자에서 손을 떼고 있다는 신호는 AI 산업의 현실을 보여주며, 어느 분야가 실질적 가치를 만드는지 재평가하는 전환점이 될 수 있다.
핵심 요약
아마존이 자체 AI 연구소를 대폭 축소하고 있다. ChatGPT, Claude, Gemini 같은 대형 언어모델과 달리 아마존의 Nova는 시장에서 주목받지 못했다. 아마존은 Nova 텍스트 모델, 영상·이미지 생성 모델 등 대부분의 AI 모델을 '점화 유지' 상태로 전환했다. 이는 기술적으로 지원되지만 최소한의 리소스만 할당받는 상태를 뜻한다. 회사의 노동력과 컴퓨팅 파워를 단 하나의 목표로 집중시켰다. 2024년 인수한 로봇 회사 Covariant의 수장 Pieter Abbeel이 주도하는 '프론티어 모델' 개발에 중점을 두고 있다. 전체 요약 6문장 읽기 → 009 15:11 ▲ 25 · 댓글 2 ML 엔지니어링 자동화하는 35B 모델 MLExpert 공개 LLM이 AI 시스템을 자율적으로 개발·개선하는 AI4AI 시대로 나아가고 있으며, 기계학습 엔지니어링(MLE) 시스템이 장기 실험 관리와 최적화 전략 자동 적응으로 이를 실현하고 있다. AI · 머신러닝 · MLExpert: Towards a Generalist Agentic Model for Autonomous Machine Learning Engineering
Key Point ML 엔지니어링의 완전 자동화가 가능해지면 AI 개발 사이클을 획기적으로 단축할 수 있으며, 이는 AI 스스로가 AI를 개선하는 재귀적 자기개선의 실질적 첫걸음이다.
핵심 요약
LLM이 AI 시스템을 자율적으로 개발·개선하는 AI4AI 시대로 나아가고 있으며, 기계학습 엔지니어링(MLE) 시스템이 장기 실험 관리와 최적화 전략 자동 적응으로 이를 실현하고 있다. 기존 MLE 시스템의 문제점은 실험 피드백이 이전 여러 결정의 누적 결과라 단순 감독학습으로는 장기 궤적에서 유용한 신호를 학습하기 어렵다는 점이다. Hugging Face 팀은 35B Mixture-of-Experts 모델 MLExpert를 학습시키기 위해 Kaggle-MLE Factory로 실행 가능한 ML 최적화 작업을 대규모로 생성했다. 전체 요약 7문장 읽기 → 010 15:11 ▲ 96 · 댓글 1 코딩 에이전트의 '하네스 엔지니어링' 평가하는 벤치마크 공개 LLM 기반 에이전트가 장기 작업을 수행할 때, 모델 자체만큼 모델을 감싸는 하네스(harness) 설계가 성능을 좌우한다. AI · 머신러닝 · Doc2Harness: Benchmarking LLMs on Long-Horizon Harness Engineering of Coding Agents
Key Point LLM 에이전트가 실제 작업을 하려면 모델뿐 아니라 모델을 감싸는 시스템 설계가 결정적이지만, 지금까지 그 부분을 직접 평가하는 도구가 없었기 때문입니다.
핵심 요약
LLM 기반 에이전트가 장기 작업을 수행할 때, 모델 자체만큼 모델을 감싸는 하네스(harness) 설계가 성능을 좌우한다. 기존 벤치마크는 고정된 하네스 아래서 최종 과제 성공만 측정했으나, 하네스 엔지니어링 자체는 평가하지 않았다. Doc2Harness는 2단계 벤치마크로, Stage 1에서 빌드 모델이 인터페이스 계약서와 12개 프론티어 하네스의 동작을 정리한 개발 문서를 받아 격리된 컨테이너 내에서 완전한 후보 하네스를 구성한다. 전체 요약 8문장 읽기 → 011 06:11 ▲ 146 · 댓글 136 OpenAI·Anthropic 대신 오픈소스 LLM 써야 하는 이유 OpenAI와 Anthropic이 지배하는 폐쇄형 LLM 모델은 개인정보 보호, 자유도, 민주성 측면에서 문제가 있다고 주장한다. AI · 머신러닝 · Just say no to OpenAI and Anthropic
Key Point OpenAI와 Anthropic에 의존하면 데이터 통제력을 잃고 모델 접근 권한을 기업에 좌우당하는데, 이제 성능이 비슷한 오픈 웨이트 모델과 프라이빗 추론 서비스로 독립적 선택이 가능해졌다.
핵심 요약
OpenAI와 Anthropic이 지배하는 폐쇄형 LLM 모델은 개인정보 보호, 자유도, 민주성 측면에서 문제가 있다고 주장한다. GLM-5.3, DeepSeek, Qwen 같은 오픈 웨이트 모델들은 ChatGPT와 Claude에 필적하거나 비슷한 성능을 내며, 약 4개월 정도만 뒤떨어져 있다. ChatGPT와 Claude는 폐쇄형 모델이며 사용자 세션 데이터에 대한 접근을 완전히 통제하고, 사용자가 훈련 데이터 사용을 거부해도 데이터 자체에는 접근 가능하다. 전체 요약 11문장 읽기 → 012 18:12 ▲ 13 · 댓글 2 의료 AI가 스스로 증거를 찾는다, 종단 임상 추론 벤치마크 재단 모델을 임상 에이전트로 활용하되 기존 벤치마크와 달리 미리 선정된 증거가 아닌 임상 기록과 종단 영상 데이터에서 능동적으로 증거를 찾을 수 있도록 설계했다. AI · 머신러닝 · From Given to Gathered Evidence: Agentic Learning for Longitudinal Medical Reasoning
Key Point 임상 데이터를 능동적으로 탐색하며 종단 추론을 수행하는 의료 AI 에이전트의 새로운 패러다임이 제시되며, 대규모 정제 벤치마크와 학습 방법이 함께 공개될 예정이기 때문이다.
핵심 요약
재단 모델을 임상 에이전트로 활용하되 기존 벤치마크와 달리 미리 선정된 증거가 아닌 임상 기록과 종단 영상 데이터에서 능동적으로 증거를 찾을 수 있도록 설계했다. CASE라는 역할별 임상 에이전트 시리즈와 도구 사용 장치, 컴팩트한 비전-언어 정책 모델 학습 프레임워크를 제안한다. UK Biobank 기반 종단 멀티모달 벤치마크를 구축했으며, 4,739명의 참여자로부터 도출한 ICD-10 코딩 진단에 기반한 50,401개 임상 질문을 포함한다. 전체 요약 8문장 읽기 → 013 06:11 ▲ 143 · 댓글 119 DeepSeek 4.1 Flash, 프론티어 모델 수준의 성능을 1/100 가격으로 저자는 지난 한 달간 DeepSeek 4.1 Flash를 12개 프로젝트에서 헤비하게 사용했으며, Anthropic Opus와 구별할 수 없을 정도로 성능이 뛰어나면서 프론티어 모델보다 몇십 배 저렴하다고 밝혔다. AI · 머신러닝 · Why isn't the industry freaking out about DeepSeek 4.1 Flash?
Key Point 중국 LLM이 프론티어 모델과 대등한 성능을 1/100 가격에 제공하기 시작했으며, 이는 AI 비용 구조와 산업의 경제성을 근본적으로 재편할 수 있다.
핵심 요약
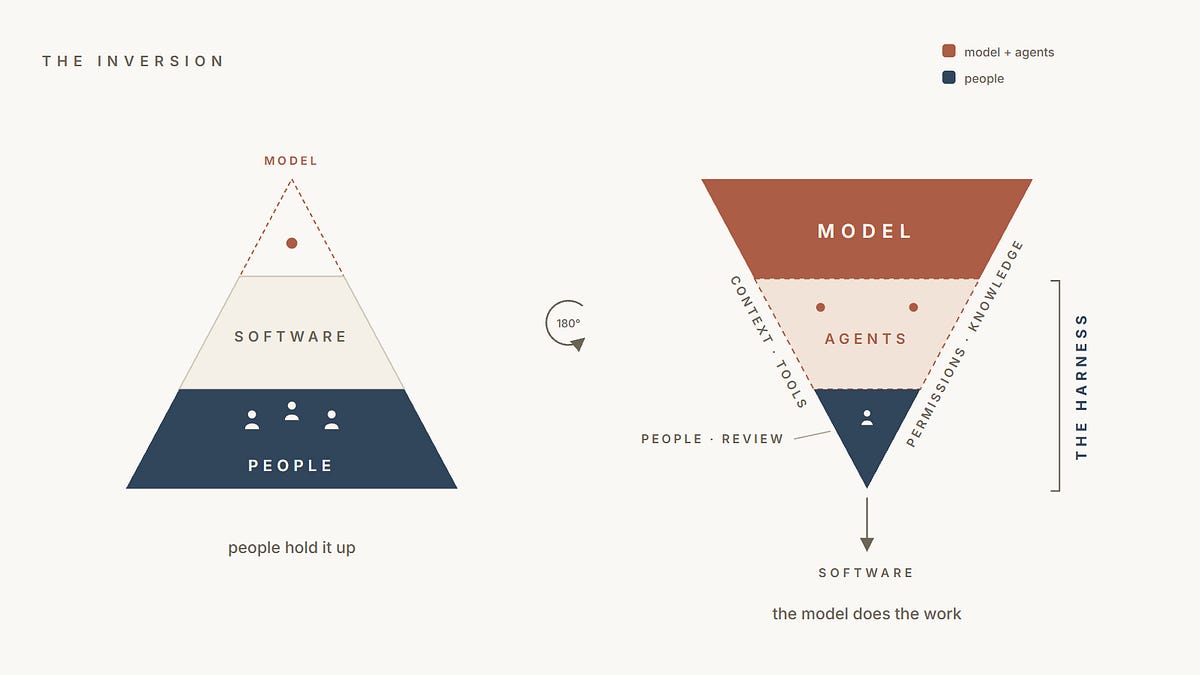
저자는 지난 한 달간 DeepSeek 4.1 Flash를 12개 프로젝트에서 헤비하게 사용했으며, Anthropic Opus와 구별할 수 없을 정도로 성능이 뛰어나면서 프론티어 모델보다 몇십 배 저렴하다고 밝혔다. DeepSeek는 Anthropic/OpenAI보다 1~2개월 뒤처져 있지만 같은 수준의 작업을 처리할 수 있으며, 개발자들은 성능보다 비용 대비 효율을 우선시하는 추세다. 현재의 LLM 성능이 충분히 좋아져서 최신 모델을 계속 쫓는 것이 불필요해졌으며, DeepSeek의 월 $10 구독으로 실질적으로 무제한 사용이 가능하다. 전체 요약 9문장 읽기 → 014 12:11 ▲ 106 · 댓글 80 모든 SaaS는 AI 모델을 감싸는 '하네스'로 진화한다 SaaS 기업의 미래는 상태 없는 LLM을 감싸는 인프라, 인터페이스, 컨텍스트, 상태로 이루어진 '하네스'가 되는 것이다. AI · 머신러닝 · Every SaaS business will become a harness around a model
Key Point 현재 AI 모델 기반 스타트업과 기업들이 어떤 구조로 진화할 것인지, 소프트웨어 개발과 조직 운영의 근본적 전환을 설명하는 프레임워크다.
핵심 요약
SaaS 기업의 미래는 상태 없는 LLM을 감싸는 인프라, 인터페이스, 컨텍스트, 상태로 이루어진 '하네스'가 되는 것이다. 소프트웨어 서비스 기업의 진화 경로는 전통적 SaaS → 엔지니어가 에이전트와 협력 → 클라우드 배경 에이전트들이 핵심 작업 수행 → 에이전트들이 주도적으로 의사결정하고 인간은 검증만 하는 단계로 진행된다. 최종적으로 회사 자체가 하네스가 되면 소프트웨어 생산 업무가 사람에서 하네스로 완전히 이동하고, 모든 조직원은 하네스의 일부가 된다. 전체 요약 9문장 읽기 → 015 00:11 ▲ 101 · 댓글 54 OpenAI·Synopsys가 반도체 설계 AI 모델 개발 협력 OpenAI와 Synopsys가 전략적 파트너십을 체결하고 다년간 GPT-Synopsys 개발에 나선다. AI · 머신러닝 · GPT-Synopsys: Frontier Intelligence to Revolutionize Chip Design
Key Point 반도체 설계의 복잡성 증가와 개발 기간 단축이 시급한 상황에서, AI 모델이 단순히 도구를 호출하는 수준을 넘어 설계 최적화 전문가로 작동하는 기술이 나타났다.
핵심 요약
OpenAI와 Synopsys가 전략적 파트너십을 체결하고 다년간 GPT-Synopsys 개발에 나선다. GPT-Synopsys는 OpenAI의 프론티어 모델을 Synopsys의 EDA 도구와 결합해 반도체 설계 워크플로우 자동화를 목표로 한다. 기존 AI 기술은 범용 모델을 EDA 도구에 연결하는 수준이었다면, 이번 협력은 모델 자체가 EDA 도구 사용 전문가로 작동하도록 학습시킨다. 전체 요약 8문장 읽기 → 016 06:11 ▲ 483 · 댓글 259 구글, 최신 AI 모델 '제미나이 4 아르곤' 발표 구글이 새로운 프론티어 모델 '제미나이 4 아르곤'을 발표했으며, 먼저 신뢰할 수 있는 사이버 방어자들을 대상으로 페어윈드 프로그램을 통해 공개한다. AI · 머신러닝 · Gemini 4 Argon
Key Point 구글의 새로운 프론티어 모델이 기존 모델 대비 성능 향상, 크게 확대된 토큰 한도, 사이버보안 방어의 특화 능력을 갖춤으로써 개발자와 보안 담당자의 업무 방식을 바꿀 수 있기 때문이다.
핵심 요약
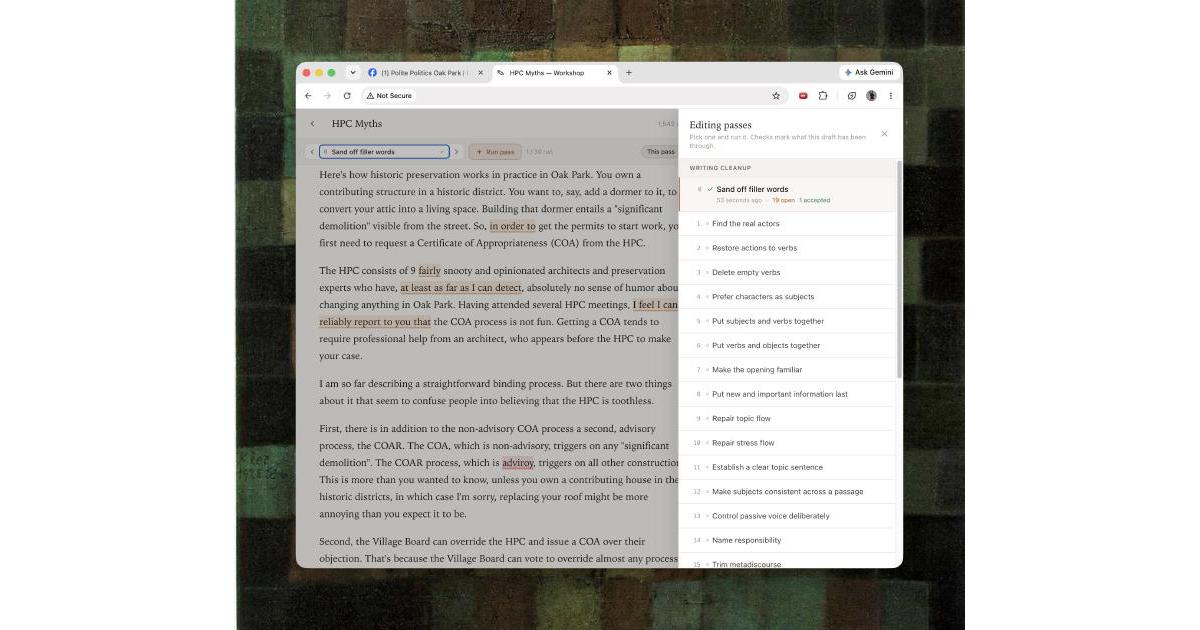
구글이 새로운 프론티어 모델 '제미나이 4 아르곤'을 발표했으며, 먼저 신뢰할 수 있는 사이버 방어자들을 대상으로 페어윈드 프로그램을 통해 공개한다. 아르곤은 입력 토큰당 200만 개당 2달러, 출력 토큰당 1000만 개당 10달러의 도입 가격으로 책정되었으며, 캐시된 입력 토큰은 입력 가격의 95% 할인을 받는다. 출력 토큰 한도를 기존 64K에서 업계 최고 수준인 100만 토큰으로 대폭 확대해 더 깊이 있는 사고를 지원한다. 전체 요약 11문장 읽기 → 017 18:10 ▲ 154 · 댓글 87 LLM으로 글 쓸 때 지켜야 할 두 가지 규칙 LLM이 제안한 단어나 표현은 절대 사용하지 말아야 한다. 프론티어 모델은 잡지 헤드라인처럼 윤기나는 문구를 제시하지만, 이를 그대로 쓰면 글이 인공적인 Velveeta처럼 변한다. AI · 머신러닝 · How to Write with an LLM
Key Point LLM이 광범위하게 쓰이면서 AI 생성 텍스트의 낭만화된 사용에 대한 현실적 가이드를 제시한다. 실제 글쓰기 프로세스에서 LLM을 도구로 쓸 때의 함정과 해결책을 명확히 한다.
핵심 요약
LLM이 제안한 단어나 표현은 절대 사용하지 말아야 한다. 프론티어 모델은 잡지 헤드라인처럼 윤기나는 문구를 제시하지만, 이를 그대로 쓰면 글이 인공적인 Velveeta처럼 변한다. LLM의 칭찬과 격려를 피해야 한다. 모델은 초안의 문제점을 외면하고 과도한 긍정을 보내서, 독자가 이를 감지하고 글이 인위적이라 느낀다. LLM의 진정한 가치는 복사편집자처럼 일하는 데 있다. 자신이 쓴 글을 먼저 완성한 후 모델에 피드백을 요청해야 한다. 전체 요약 5문장 읽기 → 018 00:10 ▲ 818 · 댓글 425 GLM-5.3: 사이버 능력을 갖춘 프론티어 코딩 모델제목 기반 Zhipu AI가 GLM-5.3 모델을 공개했다. AI · 머신러닝 · GLM-5.3: Frontier coding with emergent cyber capabilities
Key Point Hacker News에서 높은 관심을 받으며 대규모 토론이 진행 중이다.
핵심 요약
Zhipu AI가 GLM-5.3 모델을 공개했다. 코딩 작업에서 새로운 성능을 제시하는 프론티어 모델이다. 사이버 관련 능력이 특징으로 강조된다. 본문을 가져오지 못해 제목과 인기 지표로 요약했습니다. 실제 내용과 다를 수 있으니 원문을 확인해 주세요.