001 12:11 ▲ 16 · 댓글 5 멀티모달 비전 인코더의 세 가지 선택지를 분해하다 멀티모달 언어 모델의 비전 인코더 설계 방식을 통제된 환경에서 비교했다. 기존 모델들은 사전 학습된 인코더, 처음부터 학습된 인코더, 또는 인코더 없는 방식을 각각 사용하는데, 서로 다른 데이터·구조·계산량으로 인해 각 선택의 영향을 정확히 평가하기 어려웠다. AI · 머신러닝 · Unbundling Multimodal Vision Encoding
Key Point 멀티모달 모델에서 비전 처리 방식의 세 가지 핵심 선택지(사전 학습 여부, 용량 크기, 융합 위치)를 통제된 비교를 통해 각각의 영향을 명확히 규명해 향후 모델 설계에 실질적인 지표를 제시한다.
핵심 요약
멀티모달 언어 모델의 비전 인코더 설계 방식을 통제된 환경에서 비교했다. 기존 모델들은 사전 학습된 인코더, 처음부터 학습된 인코더, 또는 인코더 없는 방식을 각각 사용하는데, 서로 다른 데이터·구조·계산량으로 인해 각 선택의 영향을 정확히 평가하기 어려웠다. 연구팀은 모든 모델을 동일한 데이터로 처음부터 학습하고 같은 계산량에서 VQA(시각 질답)와 언어 벤치마크로 비교했다. 사전 학습된 비전 사전 지식은 필수가 아니며, 처음부터 함께 학습한 인코더가 별도 학습 단계 없이 사전 학습된 것과 같은 수준이다. 전체 요약 7문장 읽기 → 002 03:11 새 버전 파이썬 린터 Ruff 0.17.5 출시, 새 규칙과 버그 수정 추가 Python 린팅·포매팅 도구 Ruff 버전 0.17.5가 2026년 11월 12일 출시되었다. 오픈소스 · 도구 · astral-sh/ruff@0.17.5
Key Point Python 개발 환경의 필수 도구인 Ruff의 신규 기능과 개선 사항을 빠르게 파악할 수 있다.
핵심 요약
Python 린팅·포매팅 도구 Ruff 버전 0.17.5가 2026년 11월 12일 출시되었다. 새 예시 기능으로 규칙 이름 변경(Redirect renamed rules), flake8-async의 pytest-raises-exception-group(ASYNC401), pylint의 no-method-argument(PLE0211), ruff의 renamed-rule(RUF202)과 redirected-noqa 확장(RUF101)을 구현했다. flake8-logging-format의 G004 수정을 unsafe로 표시하고, refurb는 write가 표현식에 포함된 경우 수정을 제시하지 않도록 개선했다. 전체 요약 8문장 읽기 → 003 21:11 ▲ 45 · 댓글 4 언어 모델 가중치의 비트 수준 최적화로 추론 오류 수정 MIT의 weight-space programming 방식을 개선한 Tree-Ising 기법이 언어 모델의 추론 오류를 이진 최적화 문제로 변환하여 수정한다. AI · 머신러닝 · Tree-Ising: Repairing Language Models with Bit-Level Ising Edits
Key Point 언어 모델의 추론 오류를 비트 수준에서 직접 수정하는 새로운 방법이 기존 에이전트 기반 편집보다 효율적이고 정확하며, 기존 요구사항(89.7M 토큰, 158 에이전트 턴)을 대폭 줄인다.
핵심 요약
MIT의 weight-space programming 방식을 개선한 Tree-Ising 기법이 언어 모델의 추론 오류를 이진 최적화 문제로 변환하여 수정한다. 방법은 모델의 BF16 가중치에서 부호 반전과 지수 이동만 허용하는 이산 최적화를 통해 루프 방향은 약화시키고 결론 방향은 강화하되 생산적 토큰의 레이어 출력은 보존한다. Qwen 3.5-0.8B의 두 개 레이어에 적용했을 때 MATH-500에서 54.6% 정확도를 달성하여 GPT-6 Astra 에이전트의 51.7%를 초과한다. 전체 요약 8문장 읽기 → 004 15:11 ▲ 15 · 댓글 4 깊은 신경망의 정보 손실을 잡다, DepthGraft 기법 LLM 규모를 키우기 위해 모델 깊이를 늘리면 Pre-LN 아키텍처에서 정보가 각 계층을 지나며 희석되어 깊은 계층이 제대로 학습되지 못하는 문제가 발생한다. AI · 머신러닝 · DepthGraft: Structural Regularization through Hierarchical Cross-Layer KV Reconstruction
Key Point 모델의 깊이를 키우면서 정보 손실을 막고 캐시를 줄일 수 있는 구조적 기법이 제시되어, 더 효율적인 초대형 언어모델 개발에 실질적 가능성을 보여준다.
핵심 요약
LLM 규모를 키우기 위해 모델 깊이를 늘리면 Pre-LN 아키텍처에서 정보가 각 계층을 지나며 희석되어 깊은 계층이 제대로 학습되지 못하는 문제가 발생한다. 교차 계층 연결은 이 문제를 완화하지만 기존 방식은 계산이나 메모리 접근을 추가로 늘린다. 연구팀은 교차 계층 KV(Key-Value) 공유 방식을 효율적인 연결 방법으로 재검토했으며, KV 재사용이 깊은 계층에서 얕은-중간 계층의 KV 생성으로 직접 기울기 경로를 만들어 KV 표현 구조를 정규화한다는 점을 발견했다. 전체 요약 9문장 읽기 → 005 09:11 ▲ 18 · 댓글 3 신경망 파라미터를 직접 수정하는 WSP 기법 가능성과 한계 분석 Weight-Space Programming(WSP)은 신경망의 가중치를 직접 검사·수정하는 방식으로 기울기 기반 적응의 대안을 제시한다. AI · 머신러닝 · Exploring Weight-Space Programming: Capabilities, Generalization, and Limitations
Key Point 신경망을 역전파 없이 직접 수정하는 새로운 적응 방식의 가능성과 실제 한계를 실증적으로 밝혀, 모델 편집 연구의 방향을 제시한다.
핵심 요약
Weight-Space Programming(WSP)은 신경망의 가중치를 직접 검사·수정하는 방식으로 기울기 기반 적응의 대안을 제시한다. 7개 벤치마크와 2개 모델 규모(Qwen3.5-0.8B, Qwen3.5-9B)에서 16개 편집 궤적으로 체계적 조사를 수행했다. 극히 제한된 부위 수정으로도 큰 성능 향상이 가능해, MATH-500에서 29.45%p, GPQA Diamond 4.42%p, IFEval 36.72%p, SciBench 17.11%p 개선을 달성했다. 전체 요약 7문장 읽기 → 006 18:15 스타 1,817 Claude가 영화 같은 랜딩페이지를 자동으로 만드는 스킬 공개 MotionSites가 Claude용 무료 웹빌더 스킬을 공개했으며, Claude가 대상급 영상 같은 랜딩페이지를 설계하고 구축하도록 돕는다. 웹 · 프론트엔드 · Motionsites-AI/claude-skill · Python
Key Point AI 웹빌더가 늘어나는 가운데, 실제로 심사위원 상 수준의 사이트를 만드는 체계적 방법을 Claude에 내장했다는 점이 의미 있다. 디자인 규칙과 미디어 라이브러리, 자동 QA까지 갖춰진 방식은 단순 생성 도구와 다른 수준의 결과를 기대하게 한다.
핵심 요약
MotionSites가 Claude용 무료 웹빌더 스킬을 공개했으며, Claude가 대상급 영상 같은 랜딩페이지를 설계하고 구축하도록 돕는다. AI가 흔히 만드는 평범한 사이트를 피하기 위해 명확한 설계 계획, 실제 영상 자료, 결과물 검증을 자동화한다. 스킬에 포함된 40개 예제 프롬프트는 MotionSites에서 가장 인기 있는 디자인들이며, Claude가 유사한 2~3개를 참고해 디테일을 맞춘다. 전체 요약 12문장 읽기 → 007 00:11 ▲ 121 · 댓글 69 바이두, 효율성 중심의 초거대 언어모델 ERNIE 5.5 Flash 공개 바이두가 기반 모델 ERNIE-5.5-Flash-Base를 공개했다. 총 280B 파라미터 중 토큰당 14B만 활성화되는 희소 MoE 모델로, 33.5T 토큰에서 사전학습되었고 최대 128K 컨텍스트로 학습, 추론 시 1M 토큰을 지원한다. AI · 머신러닝 · Baidu released ERNIE 5.5 Flash Base
Key Point 개발자가 자체 파인튜닝에 집중할 수 있도록 사전학습 체크포인트를 그대로 공개했고, 아키텍처 전반에서 활성 파라미터를 줄인 희소 모델로 훈련 및 추론 비용을 절감할 수 있게 설계했다.
핵심 요약
바이두가 기반 모델 ERNIE-5.5-Flash-Base를 공개했다. 총 280B 파라미터 중 토큰당 14B만 활성화되는 희소 MoE 모델로, 33.5T 토큰에서 사전학습되었고 최대 128K 컨텍스트로 학습, 추론 시 1M 토큰을 지원한다. 사전학습 종료 직후의 가중치를 제공하므로, 도메인 적응·명령어 튜닝·강화학습 연구의 출발점으로 사용 가능하다. 모델은 효율성을 최우선으로 설계했다. 43개 레이어 중 37개는 128배 압축된 시퀀스를 처리하는 HCA(Heavily Compressed Attention)를 사용하고, 6개만 전체 컨텍스트에 접근하는 MLA(Multi-head Latent Attention)를 사용한다. 전체 요약 10문장 읽기 → 008 06:11 ▲ 11 · 댓글 3 RAG로 복잡한 질문 풀기, 하위 질문으로 단계별 분해 기존 RAG는 여러 문서에 흩어진 사실을 연결해야 하는 다단계(multi-hop) 질문에서 약했다. AI · 머신러닝 · DeFT-RAG: Decomposing Multi-Hop Questions into Self-Contained Sub-Questions with Reusable Answers
Key Point 복잡한 다단계 질문에서 RAG의 약점을 구조적으로 개선한 방법이며, 실제 LLM 호출을 줄이면서도 정확도를 높인 실용적 성과를 보여준다.
핵심 요약
기존 RAG는 여러 문서에 흩어진 사실을 연결해야 하는 다단계(multi-hop) 질문에서 약했다. DeFT-RAG는 원래 질문과 지금까지 답한 QA 쌍으로부터 한 번에 하나씩 자립형 하위 질문을 생성한다. 각 하위 질문은 묻는 엔티티를 모두 명시하기 때문에, LLM이 계획·추적·재작성 같은 복잡한 작업 대신 단일 작업에만 집중할 수 있다. 전체 요약 7문장 읽기 → 009 21:11 당일 +221 eBPF로 실제 트래픽 녹화해 테스트 생성하는 Keploy Keploy는 eBPF를 이용해 네트워크 계층에서 API 호출·데이터베이스 쿼리·스트리밍 이벤트를 자동 포착해 테스트와 데이터 모킹을 생성하는 오픈소스 API·통합 테스트 도구다. 인프라 · 데브옵스 · keploy/keploy · Go
Key Point 코드 수정 없이 실제 트래픽에서 API·통합·E2E 테스트를 자동 생성하므로, 테스트 작성 시간과 모킹 구축 비용을 크게 줄일 수 있고, 데이터베이스·메시지 큐 등 전체 인프라를 가상화해 격리된 테스트 환경을 빠르게 확보할 수 있습니다.
핵심 요약
Keploy는 eBPF를 이용해 네트워크 계층에서 API 호출·데이터베이스 쿼리·스트리밍 이벤트를 자동 포착해 테스트와 데이터 모킹을 생성하는 오픈소스 API·통합 테스트 도구다. 코드 수정 없이 앱을 `keploy record`로 실행하기만 하면 실제 API와 통합 흐름이 자동으로 테스트·모킹되며, SDK 추가나 코드 변경이 전혀 필요 없다. HTTP 엔드포인트만 모킹하는 도구와 달리 Keploy는 PostgreSQL·MySQL·MongoDB 같은 데이터베이스와 Kafka·RabbitMQ 같은 스트리밍·큐, 외부 API 등 전체 인프라를 가상화해 테스트 중에 재프로비저닝 없이 재현한다. 전체 요약 7문장 읽기 → 010 09:11 ▲ 113 · 댓글 73 AI QA 에이전트로 배포 전 버그를 자동 포착 Momentic은 AI QA 엔지니어 '모'(Mo)로 앱의 엔드-투-엔드 테스트를 자동화하고 버그를 사전에 발견하는 서비스다. AI · 머신러닝 · Launch HN: Momentic (YC W24) – Agents that catch bugs by using your app
Key Point 코딩 에이전트 시대에 테스트 검증이 새로운 병목인데, 모가 QA 벤치마크에서 다른 에이전트들의 3배 이상 버그를 찾아내며 이 문제를 근본적으로 해결하고 있다.
핵심 요약
Momentic은 AI QA 엔지니어 '모'(Mo)로 앱의 엔드-투-엔드 테스트를 자동화하고 버그를 사전에 발견하는 서비스다. 지금까지 77,813개의 테스트를 작성했고 7,060만 회 이상의 테스트를 실행해 117,010개의 버그를 포착했으며, PR 80,290개를 검증했다. 사용자는 평문 영어로 테스트 시나리오를 작성하고 YAML 파일로 관리한 후, 로컬과 CI 파이프라인에서 실행할 수 있다. 전체 요약 13문장 읽기 → 011 03:11 ▲ 11 · 댓글 2 생성 모델이 직접 관련성 판단…글랜스 레랭킹 방식 검색 증강 생성(RAG)에서 보통 별도의 리랭커 모델과 생성 모델을 이중으로 두지만, Glance는 생성 모델 자체에 경량 의사결정 어댑터와 포인터 헤드를 더해 두 역할을 한 모델이 수행하도록 했다. AI · 머신러닝 · Glance: The Generator Is Its Own Reranker
Key Point 기존 RAG의 이중 모델 문제를 하나의 생성 모델로 통합하면서도 리랭킹 정확도는 더 높이는 방식이 제시되어, 비용 효율과 성능 사이의 트레이드오프를 해결하는 방법을 제시한다.
핵심 요약
검색 증강 생성(RAG)에서 보통 별도의 리랭커 모델과 생성 모델을 이중으로 두지만, Glance는 생성 모델 자체에 경량 의사결정 어댑터와 포인터 헤드를 더해 두 역할을 한 모델이 수행하도록 했다. 쿼리-문단 쌍을 각각 따로 처리하지 않고 공유된 prefill 캐시에서 짧은 관련성 프로브를 분기하여 각 후보 문단마다 하나의 점수를 생성하므로, 처리 비용을 크게 줄인다. 9B 백본 모델이 생성, 일반 의사결정, 리랭킹을 모두 담당하며 각 기술별로 약 0.1GB의 추가 메모리만 필요하다. 전체 요약 7문장 읽기 → 012 18:11 ▲ 14 · 댓글 2 스포츠·헬스 AI 코칭 평가하는 새 벤치마크 공개 스포츠·헬스 도메인에 맞춘 대규모언어모델(LLM) 평가 기준이 부족해 안전하지 않은 조언 전달 위험이 높다. AI · 머신러닝 · MoveBench: A Rubric-Based Benchmark for Evaluating Large Language Models in Sports and Health Coaching
Key Point 피트니스·헬스 AI 조언이 위험할 수 있는 이유는 평가 기준이 없기 때문이며, 첫 전문 벤치마크가 현재 LLM의 안전성 격차를 드러냈기 때문이다.
핵심 요약
스포츠·헬스 도메인에 맞춘 대규모언어모델(LLM) 평가 기준이 부족해 안전하지 않은 조언 전달 위험이 높다. 기존 MMLU·HELM 같은 범용 벤치마크는 광범위한 지식만 측정할 뿐 운동 안전성·생리학적 적절성·개인화·실행 가능한 코칭 품질을 평가하지 못한다. 이를 해결하기 위해 MoveBench 벤치마크를 개발했다. 스포츠·헬스 코칭 LLM 평가 전문 프레임워크다. 전체 요약 8문장 읽기 → 013 12:11 ▲ 148 · 댓글 8 라즈베리파이 피코에서 신경망 게임 엔진 구현 임베디드 마이크로컨트롤러인 라즈베리파이 피코 2 W에서 신경망 기반 게임 엔진을 구현했다. 세계 모델 네트워크가 현재 프레임과 액션에서 다음 프레임과 보상을 예측하고, 액터 네트워크가 그 생성된 프레임에서 액션을 선택한다. AI · 머신러닝 · A tiny world model running games on a Raspberry Pi Pico 2 W
Key Point 라즈베리파이 같은 극도로 제한된 임베디드 환경에서 신경망으로 게임을 생성하고 플레이하는 새로운 방식이 작동한다는 것을 보여주며, 마이크로컨트롤러에서 머신러닝 모델을 실행하는 방법의 한계를 재정의한다.
핵심 요약
임베디드 마이크로컨트롤러인 라즈베리파이 피코 2 W에서 신경망 기반 게임 엔진을 구현했다. 세계 모델 네트워크가 현재 프레임과 액션에서 다음 프레임과 보상을 예측하고, 액터 네트워크가 그 생성된 프레임에서 액션을 선택한다. 반복 트랜스포머(looped transformer) 구조를 사용해 같은 가중치를 1~4회 반복 적용함으로써 메모리 효율을 높였다. 26k~131k 매개변수의 세계 모델과 9k~16k 매개변수의 액터 네트워크를 탑재했다. 브레이크아웃(정확도 99.99%), 플래피 버드(100%), 팩맨 라이트(86.4%) 등 5개 게임을 구현했으며, 각 게임은 토큰 기반으로 분할된 프레임을 처리한다. 세계 모델은 배경 셀은 독립적으로 예측하되, 공이나 플레이어 같은 단일체는 한 번만 배치되도록 디코딩 규칙을 적용했다. 전체 요약 12문장 읽기 → 014 00:11 ▲ 128 · 댓글 33 형제 프린터, 텔넷으로 디버그 접근 발견 형제(Brother) MFC-L8900CDW 프린터의 펌웨어를 다운로드해 분석한 결과, T-Kernel이라는 TRON 계열 실시간 운영체제를 사용하고 있음을 확인했다. 하드웨어 · 시스템 · Getting debug access on a Brother printer over Telnet
Key Point 형제 프린터의 디버그 콘솔이 텔넷으로 간단하게 접근 가능하다는 것은 단순한 설정 명령어만으로 시스템의 깊숙한 부분에 접근할 수 있다는 뜻이므로, 프린터 보안과 개인정보 보호를 우려하는 사용자와 기업이 알아야 할 사항이다.
핵심 요약
형제(Brother) MFC-L8900CDW 프린터의 펌웨어를 다운로드해 분석한 결과, T-Kernel이라는 TRON 계열 실시간 운영체제를 사용하고 있음을 확인했다. 펌웨어는 32비트 ARM 소프트웨어로 작성되었으며, 데이터라이트 Reliance Nitro 3.0.6 파일시스템, FlashFX Tera 3.1 플래시 관리, Lua 5.2.3 스크립팅, OpenSSL, libpng 등을 포함하고 있다. 프린터는 800MHz 메인 프로세서, 133MHz 서브프로세서, 512MB 메모리를 탑재하고 있으며, 커널과 압축된 애플리케이션 코드, 웹/UI 자산이 별도 섹션으로 구성되어 있다. 전체 요약 8문장 읽기 → 015 18:11 ▲ 33 · 댓글 2 엔비디아, 시각·생성 통합한 확산 언어모델 공개 엔비디아 연구팀이 시각 이해와 생성을 하나의 모델로 처리하는 Nemotron-Labs-Diffusion-Uni(NLD-Uni)를 제안했다. AI · 머신러닝 · Nemotron-Labs-Diffusion-Uni: Elastic Self-Refining Unified Diffusion LLM with Cross-Paradigm On-Policy Distillation
Key Point 단일 모델에서 시각 이해와 생성을 모두 처리하고자 하는 개발자들에게 새로운 아키텍처와 훈련 방법이 어떻게 여러 작업에 동시에 최고 성능을 달성했는지 보여준다.
핵심 요약
엔비디아 연구팀이 시각 이해와 생성을 하나의 모델로 처리하는 Nemotron-Labs-Diffusion-Uni(NLD-Uni)를 제안했다. 기존 확산 모델과 달리 자동회귀 VLM의 이해 능력과 연속 흐름 모델의 생성 능력을 교차 패러다임 온-정책 증류(OPD)로 통합했다. 훈련 시 이미지 토큰을 마스크로 직접 손상시키는 기존 방식 대신, 여러 단계에 걸쳐 각 토큰을 점진적으로 손상시키는 자가-정제 확산 프로세스를 도입했다. 전체 요약 5문장 읽기 → 016 12:10 ▲ 106 · 댓글 26 구글 제미나 모델의 추론 토큰 39% 줄이면서 성능 유지 BottleCapAI가 구글의 Gemma-4-26B-A4B 모델을 최적화한 ThinkingCap 버전을 공개했다. AI · 머신러닝 · Gemma-4-26B-A4B with 39-69% less thinking at same accuracy
Key Point 추론 단계를 줄이면서도 정확도를 유지하는 최적화 기법이 실제로 작동함을 보여주므로, LLM 배포 비용과 지연시간을 줄이려는 팀들의 실질적 선택지가 확보된다.
핵심 요약
BottleCapAI가 구글의 Gemma-4-26B-A4B 모델을 최적화한 ThinkingCap 버전을 공개했다. 추론 토큰을 평균 38.9% 줄였으며 최대 69.1%까지 감소시킨 벤치마크도 있다. 12개 벤치마크 평균 정확도는 75.18%에서 75.03%으로 0.15pp만 하락했다. 전체 요약 12문장 읽기 → 017 03:11 ▲ 17 · 댓글 2 에이전트 비전 작업 평가 벤치마크 공개 비전-언어 모델(VLM)의 에이전트 환경에서의 성능을 평가하기 위해 AgentVQA 벤치마크를 개발했다. AI · 머신러닝 · AgentVQA: A Unified Benchmark for Agentic Visual Understanding
Key Point 에이전트 AI 성능 평가의 새로운 표준으로, VLM이 실제 상호작용 환경에서 어디서 약한지 구체적으로 보여준다.
핵심 요약
비전-언어 모델(VLM)의 에이전트 환경에서의 성능을 평가하기 위해 AgentVQA 벤치마크를 개발했다. 웹 에이전트, 로봇, 일인칭 영상, 게임, 공간 계획 등 5개 도메인의 에이전트 시나리오를 포함한다. 23개 소스 데이터셋에서 1000개의 도전적인 실제 에이전트 예시를 수동으로 선별하고 오프라인 평가용으로 적응시켰다. 전체 요약 7문장 읽기 → 018 03:11 ▲ 214 · 댓글 114 키미, 백만 토큰 컨텍스트의 K3.1 Pro 공개 키미가 K3.1 Pro와 2~3배 빠른 K3.1 Pro Highspeed를 공개했으며, 100만 토큰 컨텍스트 윈도우를 지원하는 오픈웨이트 모델이다. AI · 머신러닝 · Kimi K3.1 Pro and K3.1 Pro Highspeed
Key Point 오픈웨이트 대규모 언어 모델이 코딩부터 금융 분석까지 여러 분야에서 프로프라이어터리 모델과 경쟁하는 수준에 도달했으며, 사이버보안 능력을 의도적으로 제어하면서 공개하는 오픈 모델의 윤리적 방향성을 보여준다.
핵심 요약
키미가 K3.1 Pro와 2~3배 빠른 K3.1 Pro Highspeed를 공개했으며, 100만 토큰 컨텍스트 윈도우를 지원하는 오픈웨이트 모델이다. 모델은 키미 K3의 포스트 트레이닝 버전으로, 수백 개 다운스트림 도메인 전체에서 대규모 강화학습을 통해 모든 계층을 최적화했다. 코딩 벤치마크에서 K3.1 Pro는 Terminal-Bench 4.0에서 65.7%로 GPT-6 Astra(58.2%)를 상회하고 Claude Opus 5.5(66.4%)와 유사한 성능을 보인다. 전체 요약 12문장 읽기 → 019 00:11 ▲ 13 · 댓글 1 AI 에이전트, 텍스트 해석 전 숨겨진 신호로 소통 확산 언어모델(Diffusion Language Model)은 답변을 연속적인 상태들의 수열을 거쳐 생성하지만, 기존 다중 에이전트 시스템은 이 중간 상태들을 버리고 텍스트 디코딩 후에만 통신한다. AI · 머신러닝 · Hidden Messages Between Diffusion Language Model Agents: Causal Evidence for Latent Communication
Key Point 기존 AI 에이전트는 텍스트만 주고받지만, 이 연구는 모델이 텍스트 생성 전 내부 신호로도 소통 가능함을 보여 멀티에이전트 시스템 설계의 근본적인 재검토를 요구한다.
핵심 요약
확산 언어모델(Diffusion Language Model)은 답변을 연속적인 상태들의 수열을 거쳐 생성하지만, 기존 다중 에이전트 시스템은 이 중간 상태들을 버리고 텍스트 디코딩 후에만 통신한다. 연구진은 한 에이전트의 확산 과정이 다른 에이전트에게 숨겨진 메시지를 전달할 수 있는지, 그리고 수신 에이전트가 실제로 그 메시지의 의미를 사용하는지 검증했다. 송신 에이전트는 노이징 제거 상태(denoising state)를 4개의 압축된 벡터로 변환하고, 수신 에이전트는 자신의 문맥과 생성 궤적을 유지하면서 이를 수용한다. 전체 요약 8문장 읽기 → 020 15:11 ▲ 49 · 댓글 2 LLM 외부 지식 통합하는 파라메트릭 메모리 구조 제안 LLM이 학습 후 새로운 지식을 추가할 때 지속 학습은 재앙적 망각을, 검색 기반 방법은 추론 오버헤드를 발생시킨다. AI · 머신러닝 · Deep Fusion Memory: A Chunk-Level Parametric Memory for Large Language Models
Key Point 토큰 수준 메모리 구성의 계산 비용을 획기적으로 줄이면서 동시에 더 깊은 수준의 지식 통합이 가능해져, LLM의 지속적 학습과 도메인 적응 방식이 실질적으로 단순화된다.
핵심 요약
LLM이 학습 후 새로운 지식을 추가할 때 지속 학습은 재앙적 망각을, 검색 기반 방법은 추론 오버헤드를 발생시킨다. 외부 파라메트릭 메모리는 온라인 검색을 피하지만 오프라인 검색이 많이 필요하고 얕은 수준의 융합만 가능해 왔다. 논문은 Deep Fusion Memory(DFM)를 제안하는데, 이는 청크 수준의 메모리를 중간 은닉층에 통합하는 구조다. 전체 요약 9문장 읽기 → 021 00:11 ▲ 15 · 댓글 1 다중 에이전트 팀에서 어떤 스킬을 개선할지 판단하는 GRSE 알고리즘 협력하는 언어 모델 에이전트는 재사용 가능한 스킬을 수정해 가중치 업데이트 없이 개선할 수 있으나, 공유 팀 보상을 책임 있는 에이전트와 스킬로 추적해야만 한다. AI · 머신러닝 · Which Agent's Skill Should Change? Group-Relative Credit Assignment for Evolving Multi-Agent Teams
Key Point 멀티 에이전트 시스템에서 실제로 성능을 올린 스킬을 정확히 찾아내는 것이 학습 효율을 크게 좌우하기 때문에, 기존 방법의 신용 할당 문제를 해결하는 GRSE의 접근이 의미 있다.
핵심 요약
협력하는 언어 모델 에이전트는 재사용 가능한 스킬을 수정해 가중치 업데이트 없이 개선할 수 있으나, 공유 팀 보상을 책임 있는 에이전트와 스킬로 추적해야만 한다. 기존 방법은 각 실행 경로에 나타난 스킬을 신용 할당하지만, 나타남이 책임은 아니므로: 성공한 실행에서 활성화된 해로운 스킬도 긍정적 신용을 받는다. GRSE(Group-Relative Skill Evolution)는 비교를 통해 행동 신용을 할당하며, GRPO에서 영감을 받아 같은 스킬 라이브러리 하에서 각 질문을 여러 번 실행하고 실행들을 대조해 에이전트-스킬 쌍을 신용하며 실패를 구조화된 진단한다. 전체 요약 6문장 읽기 → 022 06:11 ▲ 12 · 댓글 2 데이터 레이크 분석 AI, 스스로 도구를 진화시킨다 데이터 레이크 분석을 위한 코딩 에이전트가 매번 작업을 처음부터 다시 하는 문제를 해결하기 위해, 재사용 가능한 도구를 자동으로 구축하고 개선하는 '도구 진화' 방식을 제안했다. AI · 머신러닝 · Unsupervised Tool Evolution for Coding Agents in Data-Lake Analytics
Key Point 데이터 분석 작업을 자동화하는 AI 에이전트가 라벨 없이 스스로 도구를 학습·개선할 수 있다는 점이 실무 적용에 중요하며, 특히 단계 예산 제한이라는 현실적 제약에서 성능 향상을 달성한 것이 의미 있다.
핵심 요약
데이터 레이크 분석을 위한 코딩 에이전트가 매번 작업을 처음부터 다시 하는 문제를 해결하기 위해, 재사용 가능한 도구를 자동으로 구축하고 개선하는 '도구 진화' 방식을 제안했다. 라벨 없이 도구를 진화시키는 TEAL(Tool Evolution for Analytics over data Lakes)은 두 에이전트가 서로 다른 증거에서 도구를 제안한다: Explorer는 데이터 레이크 자체에서, Critic은 Worker의 작업 궤적에서 도구를 제안한다. 제안된 변화는 Worker가 재실행 시 추가 단계 없이 도구를 채택하고, 변경된 답변이 궤적 증거로 뒷받침될 때만 유지된다. 전체 요약 9문장 읽기 → 023 21:11 ▲ 13 · 댓글 4 임베딩 테이블을 16MB 고정 코드로 대체, 소형 모델 파일 1/7 축소 소형 언어 모델에서 임베딩 테이블은 전체 파라미터의 대부분을 차지하고, Gemma 3 270M 모델의 경우 268M 파라미터 중 168M이 임베딩 테이블이며, 양자화 후에도 16비트로 남아 파일 크기의 대부분을 차지한다. AI · 머신러닝 · Embeddings Are Overpriced? A Frozen 16 MB Vocabulary for Small and Ternary Language Models
Key Point 소형 모델 배포 시 파일 크기가 1/7로 축소되고 CPU 속도가 5~6배 빨라지므로, 엣지 디바이스와 저사양 환경에서의 모델 배포 방식을 바꿀 가능성이 있다.
핵심 요약
소형 언어 모델에서 임베딩 테이블은 전체 파라미터의 대부분을 차지하고, Gemma 3 270M 모델의 경우 268M 파라미터 중 168M이 임베딩 테이블이며, 양자화 후에도 16비트로 남아 파일 크기의 대부분을 차지한다. 연구팀은 학습 가능한 임베딩 테이블을 주성분 투영과 부호 이진화로 도출한 512비트 코드의 동결 테이블(16MB, 학습 가능 파라미터 없음)로 대체하고, 동일한 Gemma 형태의 모델을 2.05B 토큰으로 학습했다. 학습된 임베딩 테이블은 0.20 나츠 검증 손실을 위해 2.6배 많은 학습 가능 파라미터를 필요로 했으나, LAMBADA, HellaSwag, PIQA 벤치마크에서는 동결 테이블 모델이 동일하거나 더 나은 성능을 보였고 ARC-Easy에서만 학습된 테이블이 앞섰다. 전체 요약 6문장 읽기 → 024 15:11 ▲ 155 · 댓글 3 인간의 경험에서 배우는 홀리스틱 세계 이해 시스템 머신러닝 커뮤니티가 인간의 일인칭 시점 영상 데이터를 활용해 세상을 이해하는 방법을 개발하고 있다. AI · 머신러닝 · Holi-World: Building Holistic World Intelligence from Human-Ego Experience
Key Point 인간의 일상 영상에서 자동으로 학습 데이터를 만들어 세계 이해 AI를 훈련하는 새로운 방식을 제시해, 값비싼 수동 주석을 줄이면서 지각 AI의 실용적 확장을 가능하게 한다.
핵심 요약
머신러닝 커뮤니티가 인간의 일인칭 시점 영상 데이터를 활용해 세상을 이해하는 방법을 개발하고 있다. HOLI-WORLD는 카메라 캡처·세계 표현·자동 데이터 구성·모델 학습·평가를 통합하는 생태계로, 수동 주석 의존성을 줄인다. HOLIWORLD-Foundry는 정적·동적 인식을 결합해 장면 구조·물체 상태·상호작용 이력을 자동으로 연결하는 '세계 기록'을 구성한다. 전체 요약 8문장 읽기 → 025 18:11 ▲ 24 · 댓글 2 이미지 생성 학습이 멀티모달 모델의 지식을 늘릴까? 통합 멀티모달 모델(UMM)이 이미지 생성 학습으로 텍스트에 없는 시각 정보를 얻을 수 있는지 검증하기 위해 Knowledge Transfer Probing(KTP) 프로토콜을 개발했다. AI · 머신러닝 · Can Visual Generation Expand What Unified Multimodal Models Know?
Key Point 멀티모달 AI가 텍스트와 이미지 생성을 함께 배울 때 실제로 지식 확장이 일어나는지 실증적으로 검증한 연구로, 향후 멀티모달 모델 설계의 방향성을 제시한다.
핵심 요약
통합 멀티모달 모델(UMM)이 이미지 생성 학습으로 텍스트에 없는 시각 정보를 얻을 수 있는지 검증하기 위해 Knowledge Transfer Probing(KTP) 프로토콜을 개발했다. KTP는 이미지 생성 훈련으로 새로운 지식을 주입한 후 텍스트만으로 답변하도록 테스트하는 방식으로, 7가지 지식 범주와 3개의 UMM에서 실험했다. 시각 학습에서 언어로의 직접적이지만 불균형한 지식 전이가 관찰되었으며, 이를 개선하기 위해 텍스트 정렬(Textual Alignment)과 인터리브 이미지-텍스트 정렬(Interleaved Image-Text Alignment) 방법을 제안했다. 전체 요약 6문장 읽기 → 026 12:10 ▲ 10 · 댓글 2 GQA의 3가지 딜레마를 동시에 푸는 Virtual Head Attention 긴 문맥 처리 시 KV 캐시 크기, 학습·프리필 연산량, 모델 품질을 동시에 개선하기는 어렵다는 '불가능의 삼각형'에 직면한 어텐션 메커니즘 설계에 대응하기 위해 Virtual Head Attention(VHA)을 제안한다. AI · 머신러닝 · Virtual Head Attention
Key Point KV 캐시 메모리와 학습 효율, 모델 품질의 균형을 동시에 달성해야 하는 LLM 개발자들이 GQA의 근본적 한계를 극복할 수 있는 방법을 제시합니다.
핵심 요약
긴 문맥 처리 시 KV 캐시 크기, 학습·프리필 연산량, 모델 품질을 동시에 개선하기는 어렵다는 '불가능의 삼각형'에 직면한 어텐션 메커니즘 설계에 대응하기 위해 Virtual Head Attention(VHA)을 제안한다. VHA는 두 개의 경량 선형 연산으로 구성되는데, Q Premix가 쿼리 헤드 개수를 절반으로 줄인 상태에서 KV 그룹 내 가상 헤드 다양성을 복구하고, Linear Postmix가 낮은 순위의 I + AB^top 잔여 구조를 통해 헤드 간 특징을 융합한다. VHA는 비선형 연산을 도입하지 않으므로 Premix와 Postmix를 추론 시간에 각각 쿼리 프로젝션과 출력 프로젝션으로 폴드할 수 있어, 표준 GQA-2 아키텍처로 축약되면서 기존의 모든 GQA 추론 최적화를 직접 재사용할 수 있다. 전체 요약 6문장 읽기 → 027 21:11 당일 +112 AI가 기판 설계까지 한다…KiCAD 네이티브 플러그인 Konnect 공개 Konnect는 KiCAD 10을 위한 AI 기반 PCB 설계 플러그인으로, Claude를 포함한 LLM이 Model Context Protocol을 통해 회로도 작성과 기판 설계를 직접 수행할 수 있게 한다. AI · 머신러닝 · mixelpixx/Konnect · Rust
Key Point KiCAD 설계 과정을 AI가 직접 담당하는 단계로 발전했으며, 기존 복잡한 다중 언어 아키텍처를 버리고 고성능 단일 바이너리로 재설계한 점이 PCB 개발자의 작업 방식을 크게 바꿀 수 있다.
핵심 요약
Konnect는 KiCAD 10을 위한 AI 기반 PCB 설계 플러그인으로, Claude를 포함한 LLM이 Model Context Protocol을 통해 회로도 작성과 기판 설계를 직접 수행할 수 있게 한다. 21개 도구 세트에 걸친 228개 도구를 제공하며, 회로도 캡처, PCB 레이아웃과 라우팅, ERC/DRC, 설계 검토, JLCPCB 부품 검색, 참조 회로, 제조 파일 내보내기 등을 지원한다. 기존 KiCAD-MCP-Server(Python/TypeScript)의 한계를 극복하기 위해 Rust로 완전히 새롭게 작성됐으며, 단일 정적 바이너리(20~25MB)로 배포돼 설치 의존성이 없다. 전체 요약 12문장 읽기 → 028 16:56 당일 +130 중국 클라우드 드라이브 통합 다운로더 YunX 공개 쿼크, UC, 迅雷, 바이두, 139, 123, 115, 광야, 란좌운 등 중국 주요 클라우드 저장소의 공유 링크를 인식하고 추출 코드를 자동 매칭하는 안드로이드 앱이다. 오픈소스 · 도구 · CYQawa/YunX · Kotlin
Key Point 중국 대형 클라우드 저장소와 동영상 플랫폼 수십 개를 한 앱에서 통합 분석·다운로드할 수 있으며, 고속 멀티스레드 다운로드와 온라인 재생 기능으로 실용성이 높다.
핵심 요약
쿼크, UC, 迅雷, 바이두, 139, 123, 115, 광야, 란좌운 등 중국 주요 클라우드 저장소의 공유 링크를 인식하고 추출 코드를 자동 매칭하는 안드로이드 앱이다. 틱톡, 샤오훙수, 쾌수, 웨이보, AcFun, 빌리빌리, Pixiv 등 비디오·이미지 플랫폼의 링크도 해석해 직링크를 추출할 수 있다. HTTP Range 분할 다운로드와 단절점 재개 기능을 지원하며 최대 32개 동시 다운로드가 가능하다. 전체 요약 12문장 읽기 → 029 21:11 ▲ 104 · 댓글 105 AI와 함께 일하는 방식, 3년 만에 완전히 달라졌다 ChatGPT 초기에는 검색 엔진처럼 사용했으나, 점차 Ruby 코드 작성처럼 구체적인 코드 생성 도구로 활용하기 시작했다. AI · 머신러닝 · My old job feels distant now
Key Point 개발자의 일이 AI 발전에 따라 어떻게 실제로 변해왔는지, 검색 대체에서 진정한 협업으로의 전환 과정을 구체적으로 보여준다.
핵심 요약
ChatGPT 초기에는 검색 엔진처럼 사용했으나, 점차 Ruby 코드 작성처럼 구체적인 코드 생성 도구로 활용하기 시작했다. Cursor와 탭 완성은 IDE 통합이 자연스러웠으나, 본격적인 진전은 새로운 도메인(컴퓨터 비전)에서 ChatGPT로 API 검색과 코드 생성을 결합했을 때였다. 할루시네이션을 모델의 한계 신호로 읽고 스스로 빈틈을 채우며 학습했으며, 이는 SEO 스팸과 불완전한 문서의 문제를 우회하는 경험이었다. 전체 요약 11문장 읽기 → 030 03:11 ▲ 107 · 댓글 38 KiCAD용 AI 설계 플러그인 Konnect 베타 공개 KiCAD 10 네이티브 플러그인 Konnect 베타가 공개됐으며, Rust 바이너리로 Claude 등 AI 어시스턴트가 회로도·PCB 설계를 자동화할 수 있다. AI · 머신러닝 · AI-assisted PCB design for KiCad 10
Key Point KiCAD 사용자가 AI로 회로도와 PCB 설계를 직접 자동화할 수 있게 되면서, 설계 반복 속도와 진입 장벽이 크게 바뀐다.
핵심 요약
KiCAD 10 네이티브 플러그인 Konnect 베타가 공개됐으며, Rust 바이너리로 Claude 등 AI 어시스턴트가 회로도·PCB 설계를 자동화할 수 있다. Model Context Protocol(MCP)을 통해 228개 도구를 21개 온디맨드 도구셋으로 제공하며, 회로도 작성·PCB 레이아웃·라우팅·ERC/DRC·설계 검토·JLCPCB 부품 검색·제조 파일 내보내기를 지원한다. 이전 KiCAD-MCP-Server(Python/TypeScript)의 아키텍처 한계를 개선했으며, 단일 정적 바이너리(20~25MB)로 의존성을 제거해 설치와 유지보수가 간단하다. 전체 요약 12문장 읽기 → 031 12:11 ▲ 12 · 댓글 2 토큰 수준의 선택 정확도와 실행 효율을 동시에 해결한 희소 어텐션 긴 문맥에서 LLM 추론 시 KV-캐시 통신량을 줄이는 희소 어텐션 기법들은 주로 높은 단위의 선택만 가능하던 한계가 있었다. AI · 머신러닝 · Joint Subspace Sparse Attention for Efficient Long-Context Decoding
Key Point 토큰 단위 선택의 정확도와 실행 속도 사이의 오래된 트레이드오프를 동시에 해결해 실용적인 장문맥 추론 가속이 가능해진다.
핵심 요약
긴 문맥에서 LLM 추론 시 KV-캐시 통신량을 줄이는 희소 어텐션 기법들은 주로 높은 단위의 선택만 가능하던 한계가 있었다. 저해상도 점수 부여로는 쿼리-키 구조 정보가 손실되어 정확한 랭킹이 어렵고, 선택된 토큰들을 모으는 과정에서 레이턴시 이득이 상쇄되는 문제가 있었다. Joint Subspace Sparse Attention (JSSA)은 공유 저차원 쿼리-키 부분공간을 학습해 토큰 점수 보존 오차를 최소화함으로써 선택 품질을 개선한다. 전체 요약 8문장 읽기 → 032 12:11 ▲ 578 · 댓글 4 동영상 이해 AI의 종합 평가 기준 'OmniCompass' 공개 멀티모달 대형언어모델(MLLM)의 동영상 이해 능력을 체계적으로 평가하기 위해 OmniCompass 벤치마크를 새로 제안했다. AI · 머신러닝 · OmniCompass: A Holistic Benchmark for Omni-Modal Video Grounding and Understanding
Key Point 오픈소스 MLLM과 상용 모델 간의 격차를 정량적으로 드러내고, 음성-시각 이해라는 미흡한 영역을 구체적으로 지목하는 실제 평가 결과를 제시한다.
핵심 요약
멀티모달 대형언어모델(MLLM)의 동영상 이해 능력을 체계적으로 평가하기 위해 OmniCompass 벤치마크를 새로 제안했다. VL 트랙(시각 정보 기반)과 AV 트랙(음성-시각 결합)의 두 평가 경로로 구성되며, 각각 시간 정위(TG), 공간 정위(SG), 질의응답(QA) 세 가지 과제를 포함한다. VL 트랙은 5가지 지각·3가지 추론 범주를 다루고, AV 트랙은 3가지 지각·2가지 추론 범주를 다룬다. 전체 요약 7문장 읽기 → 033 00:11 ▲ 39 · 댓글 2 다중 정답 처리로 LLM 추천 모델 학습 효율화 Reddit 같은 환경에서 추천 요청에 여러 정답이 나올 때 기존 Rank-GRPO는 훈련 예제당 하나의 응답만 선택하는데, 이는 학습 신호의 85%가 어떤 응답을 선택했는지에만 좌우되고 생성 목록의 질은 제대로 반영되지 않는 문제가 있다. AI · 머신러닝 · Many Right Answers, One Training Example: Removing Responder Noise from GRPO for LLM Recommenders
Key Point 여러 정답을 처리하는 방식이 LLM 추천 모델의 학습 효율을 크게 좌우하며, 제안된 방법이 기존 방식 대비 더 적은 자원으로 동등하거나 우수한 성능을 낸다는 실용적 개선을 보여준다.
핵심 요약
Reddit 같은 환경에서 추천 요청에 여러 정답이 나올 때 기존 Rank-GRPO는 훈련 예제당 하나의 응답만 선택하는데, 이는 학습 신호의 85%가 어떤 응답을 선택했는지에만 좌우되고 생성 목록의 질은 제대로 반영되지 않는 문제가 있다. ReMaRk라는 새로운 방식을 제안하는데, 각 목록을 한 번에 모든 응답의 제목을 합친 것과 비교 평가하고 각 요청을 동등하게 샘플링한다. 7개의 기본 모델과 3개의 데이터셋에서 실험한 결과 ReMaRk는 Rank-GRPO가 2,000번의 단일-응답 강화학습 스텝을 거쳐야 달성하는 검증 재현율을 25~53% 더 적은 스텝으로 도달한다. 전체 요약 5문장 읽기 → 034 18:11 ▲ 76 · 댓글 2 강화학습 에이전트 최적화, 방법 많다고 더 나을까 에이전트 강화학습의 자기증류 방법들이 증가했지만, 기존 평가는 다른 실험 조건에서 발표된 기준점을 재사용하고 동시대 방법들 간 직접 비교가 부족하며 훈련 안정성과 계산 비용을 거의 고려하지 않았다. AI · 머신러닝 · More Methods, Better Agents? A Reality Check on Self-Distillation in Agentic Reinforcement Learning
Key Point 에이전트 강화학습의 자기증류 방법이 계속 제안되는 가운데, 실제로 더 많은 방법이 더 나은 성능을 보장하지 않는다는 점이 중요하기 때문에 방법론 선택과 연구 방향에 영향을 미친다.
핵심 요약
에이전트 강화학습의 자기증류 방법들이 증가했지만, 기존 평가는 다른 실험 조건에서 발표된 기준점을 재사용하고 동시대 방법들 간 직접 비교가 부족하며 훈련 안정성과 계산 비용을 거의 고려하지 않았다. 연구팀은 10가지 대표 방법을 GRPO와 함께 ALFWorld, ScienceWorld, Search-QA, WebShop에서 3가지 모델 크기로 비교했으며, 132개 훈련 실행과 총 12,124.4시간의 H800 GPU를 사용해 8개 롤아웃 시드로 반복 평가했다. 최종 성능 외에 훈련 진행률, 안정성, 측정된 계산 비용을 조사했고, GRPO 대비 성능 향상이 제한적이며 모든 설정에서 지속적으로 뛰어난 방법이 없음을 발견했다. 전체 요약 5문장 읽기 → 035 15:11 ▲ 150 · 댓글 37 경량 추론 모델 LFM2.5-24B-A2B 출시, 온디바이스 에이전트 최적화 Liquid AI가 LFM2.5-24B-A2B를 공개했으며, 총 24B 파라미터 중 활성 파라미터는 2B만 사용하는 추론 특화 모델이다. AI · 머신러닝 · LFM2.5-24B-A2B: Built for fast on-device agents
Key Point 온디바이스에서 도구 호출과 추론을 빠르게 처리해야 하는 개발자에게, 클라우드 API 의존 없이 로컬 에이전트를 구축할 수 있는 선택지를 제시한다.
핵심 요약
Liquid AI가 LFM2.5-24B-A2B를 공개했으며, 총 24B 파라미터 중 활성 파라미터는 2B만 사용하는 추론 특화 모델이다. 총 파라미터가 50% 이상 많은 Qwen3.6-35B-A3B와 비교해 에이전트·도구 사용 벤치마크 8개 중 5개에서 경쟁력을 보였다. AutomationBench에서 27.69점으로 다음 경쟁 모델 8.72점의 3배 이상 점수를 기록했고, LiveClaw에서 48.09점을 달성했다. 전체 요약 13문장 읽기 → 036 03:11 당일 +364 Claude Code를 게임 스튜디오로 변신, 49개 AI 에이전트 시스템 Claude Code 세션을 49개의 전문화된 AI 에이전트로 구성된 게임 개발 스튜디오로 전환하는 오픈소스 템플릿을 공개했다. AI · 머신러닝 · Donchitos/Claude-Code-Game-Studios · Shell
Key Point AI 기반 게임 개발 도구인 Claude Code가 구조화된 팀 체계를 갖춰 솔로 개발자도 스튜디오 수준의 설계 검토·품질 관리·문서화를 자동으로 받을 수 있게 되었기 때문이다.
핵심 요약
Claude Code 세션을 49개의 전문화된 AI 에이전트로 구성된 게임 개발 스튜디오로 전환하는 오픈소스 템플릿을 공개했다. 감독·부서장·전문가 계층 구조로 조직되어 설계·프로그래밍·아트·오디오·내러티브·QA·프로덕션 분야를 담당하며, 각 에이전트는 정의된 책임과 에스컬레이션 경로를 가진다. 74개의 슬래시 명령 스킬로 게임 기획(`/brainstorm`), 설계 시스템(`/design-system`), 스토리 작성(`/create-stories`), 코드 리뷰(`/code-review`), QA(`/qa-plan`) 등 전체 개발 워크플로우를 지원한다. 전체 요약 9문장 읽기 → 037 21:11 ▲ 64 · 댓글 1 장기 작업 에이전트 훈련을 위한 반복적 환경 진화 방식 WorkRover 강화학습을 통해 장기 수행 에이전트를 훈련하기 위해서는 상호작용 환경을 확장하는 것이 중요하지만, 기존 구성 파이프라인은 작업 요소들을 정렬한 채 반복 개선을 지원하는 데 제한이 있다. AI · 머신러닝 · WorkRover: Scaling Long-Horizon Cowork Agent Training Via Recursive Environment Evolution
Key Point 장기 작업을 수행하는 AI 에이전트의 훈련 효율을 대폭 개선하는 새로운 프레임워크로, 복잡한 작업 환경을 자동으로 정제하고 검증하는 방식이 기존 대비 크게 나은 성능을 달성했다.
핵심 요약
강화학습을 통해 장기 수행 에이전트를 훈련하기 위해서는 상호작용 환경을 확장하는 것이 중요하지만, 기존 구성 파이프라인은 작업 요소들을 정렬한 채 반복 개선을 지원하는 데 제한이 있다. WorkRover는 하니스 기반 합성으로 구성 에이전트가 의미론적으로 정렬된 작업 맥락, 실행 가능한 작업, 증거 기반 검증자를 함께 구축하고 고정 워크플로우 대신 작업공간 상태와 실행 피드백에 맞춰 조치하는 프레임워크다. 환경 진화를 지원하기 위해 의존성 폐쇄 재실행과 검증된 후보 중 가장 작은 수정안을 선택하는 Factorial Compatibility Replay(FCR)를 도입했다. 전체 요약 5문장 읽기 → 038 15:11 ▲ 199 · 댓글 1 비디오 이해와 상호작용 통합한 VideoJev 모델 Visual agent가 비디오에서 빠르게 의사결정하도록 System One 패러다임에 기반해 VideoJev를 제안했다. AI · 머신러닝 · VideoJev: System One Model for Video Understanding and Interaction
Key Point 에이전트가 비디오를 이해하고 상호작용하는 모든 작업을 하나의 통합 모델로 처리하면서 기존 MLLM 대비 속도는 최대 100배 이상 빨라지는 방식을 제시한다.
핵심 요약
Visual agent가 비디오에서 빠르게 의사결정하도록 System One 패러다임에 기반해 VideoJev를 제안했다. 기존 멀티모달 LLM의 자동회귀 디코딩을 대신해, 시간 구간과 텍스트 옵션을 비디오 증거에 대해 점수 매기는 공유 헤드로 교체했다. 이를 통해 시간 그라운딩과 다지선다형 비디오 질문 답변을 통합하면서 MLLM의 의미론적 유연성과 효율적 의사결정을 결합한다. 전체 요약 7문장 읽기 → 039 15:11 ▲ 27 · 댓글 1 멀티턴 에이전트 학습의 진행도 신호, DeltaTTG 제안 강화학습에서 검증 가능한 보상(RLVR)으로 멀티턴 에이전트를 학습할 때 최종 보상만으로는 각 단계의 품질을 판단하기 어려운 문제를 다룬 논문입니다. AI · 머신러닝 · DeltaTTG: Training Multi-Turn Agents with a Token-to-Go Progress Meter
Key Point 기존 멀티턴 에이전트 강화학습에서 각 단계의 가치를 판단하는 방식의 비용 문제를 해결하는 새로운 접근으로, 실제 성능 향상을 실증한 방법입니다.
핵심 요약
강화학습에서 검증 가능한 보상(RLVR)으로 멀티턴 에이전트를 학습할 때 최종 보상만으로는 각 단계의 품질을 판단하기 어려운 문제를 다룬 논문입니다. 기존 방식은 상태 매칭의 신뢰성 확보나 외부 평가자·인간 주석·작업별 휴리스틱이 필요해 비용이 많이 들기 때문입니다. DeltaTTG는 다양한 정책의 궤적 기록으로부터 저비용 감독 신호를 얻어 재사용 가능한 진행도 신호를 학습합니다. 전체 요약 8문장 읽기 → 040 06:11 ▲ 146 · 댓글 39 로봇 물리 제어 위해 특화된 제미니 4 아르곤 공개 구글이 로봇공학 전문 대규모 언어 모델 제미니 4 아르곤을 발표했다. AI · 머신러닝 · Gemini 4 Argon for Robotics
Key Point 3D 물리 환경에서 로봇 제어·시뮬레이션·코드 생성을 통합적으로 처리하는 AI 모델의 등장으로, 로봇공학 개발의 전체 워크플로우가 단순화될 수 있는 전환점이 될 수 있다.
핵심 요약
구글이 로봇공학 전문 대규모 언어 모델 제미니 4 아르곤을 발표했다. 아르곤은 ERQA 벤치마크에서 순수 추론으로 87% 점수를 달성해 다른 모든 경쟁 모델을 능가한다. 보스턴 다이나믹스 스팟 로봇 제어, 로봇팔 조작 작업, 3D 환경 내 물체 배열 등 로봇공학 전주기에 적용 가능하다. 전체 요약 12문장 읽기 → 041 09:11 ▲ 12 · 댓글 3 코딩 에이전트 평가 기준이 현실 업무와 안 맞는 문제 JetBrains IDE의 실제 소프트웨어 엔지니어 4,782개 세션을 수집해 분석한 결과, 3개 이상의 사용자 메시지를 포함한 장기 세션(전체의 33%)은 이슈 기반 벤치마크 과제와 크게 다른 특징을 보인다. AI · 머신러닝 · Coding-Agent Benchmarks Should Match Their Users' Task Flows
Key Point 코딩 에이전트 벤치마크가 현실의 엔지니어 업무 흐름과 불일치하는 문제를 실데이터로 입증하고, 평가 기준을 개선하는 방법을 제시한다.
핵심 요약
JetBrains IDE의 실제 소프트웨어 엔지니어 4,782개 세션을 수집해 분석한 결과, 3개 이상의 사용자 메시지를 포함한 장기 세션(전체의 33%)은 이슈 기반 벤치마크 과제와 크게 다른 특징을 보인다. 실제 작업은 단일한 작업 유형보다는 코드 질문, 계획, 검토, 리팩토링, 실행 등 다양한 작업이 혼합되어 있으며, 사용자들이 작업 유형 간에 자주 전환한다. 세 개의 공개 상호작용 코퍼스에서 추출한 장기 세션들이 서로 다른 Task Flow(세션 길이, 작업 유형, 유형 간 전환 패턴의 분포)를 보이므로, 단일한 상호작용 분포로는 현실성을 보장할 수 없다. 전체 요약 8문장 읽기 → 042 12:11 ▲ 143 · 댓글 30 LLM으로 선택지 기반 의사결정 모델 만들기 기존 언어 모델이 JSON 같은 구조화된 출력을 내려면 토큰 하나씩마다 생성 패스를 거쳐야 하므로 (예: 11개 토큰이면 11회 패스) 비효율적이다. AI · 머신러닝 · Build your own decision model
Key Point 선택지 기반 의사결정 모델은 LLM의 효율성을 대폭 높이면서도 보정 없이는 신뢰도 점수가 실제 성능과 맞지 않는 근본 문제를 직면하게 되는데, 온도 스케일링으로 이를 해결하는 실제 구현 방법을 보여준다.
핵심 요약
기존 언어 모델이 JSON 같은 구조화된 출력을 내려면 토큰 하나씩마다 생성 패스를 거쳐야 하므로 (예: 11개 토큰이면 11회 패스) 비효율적이다. Decision model 방식은 A, B, C, D, E처럼 고정된 선택지만으로 출력을 제한해 단 한 번의 패스로 최고 확률 토큰을 선택한다. Qwen3-1.7B 모델을 이용해 선택지 토큰만 마스킹하는 방식으로 구현하면, CommonsenseQA 데이터셋에서 1.7B 모델 기준 정확도 59.38%를 얻는다. 전체 요약 8문장 읽기 → 043 09:11 ▲ 10 · 댓글 3 생물 진화 원리로 LLM 멀티에이전트 시스템 테스트 최적화 LLM 기반 멀티에이전트 시스템(MAS)은 복합 작업에 특화된 에이전트들을 조율하지만, 효과적인 워크플로우를 사전에 설계하기 어렵다. AI · 머신러닝 · Inherit-MAS: Test-Time Evolution of Multi-Agent Systems through Workflow and Execution Inheritance
Key Point 복합 작업을 처리하는 멀티에이전트 LLM 시스템의 워크플로우 최적화와 실행 효율성 문제를 동시에 해결한 새로운 접근법으로, 토큰 사용량을 대폭 줄이면서 성능을 높인다.
핵심 요약
LLM 기반 멀티에이전트 시스템(MAS)은 복합 작업에 특화된 에이전트들을 조율하지만, 효과적인 워크플로우를 사전에 설계하기 어렵다. Inherit-MAS는 워크플로우와 실행 단계에서 '상속'을 명시적으로 구현해 테스트 시점의 진화를 효율화했다. 메타 모델이 워커 에이전트 워크플로우를 합성하고(역할·통신·권한 선언), 별도의 판사 모델이 실행 결과를 평가하고 결함을 진단한다. 전체 요약 8문장 읽기 → 044 21:11 당일 +120 AI 에이전트 토큰 압축 도구 Headroom 공개 Headroom은 AI 에이전트가 읽는 도구 출력, 로그, RAG 청크, 파일, 대화 기록을 LLM에 도달하기 전에 압축한다. AI · 머신러닝 · headroomlabs-ai/headroom · Python
Key Point AI 에이전트 사용 비용의 대부분을 차지하는 토큰을 크기에 따라 20~95% 줄일 수 있으며 클로드, 깃허브 코파일럿 등 주요 에이전트에 대해 기존 코드 수정 없이 즉시 적용할 수 있다.
핵심 요약
Headroom은 AI 에이전트가 읽는 도구 출력, 로그, RAG 청크, 파일, 대화 기록을 LLM에 도달하기 전에 압축한다. 코딩 에이전트는 토큰 20% 절감, JSON은 60~95% 절감하면서 같은 답을 얻는다. Python 라이브러리, HTTP 프록시, MCP 서버의 세 가지 형태로 제공되며 압축은 사용자 머신에서 실행되어 프롬프트나 파일 내용이 외부로 전송되지 않는다. 전체 요약 13문장 읽기 → 045 00:11 ▲ 20 · 댓글 2 Flow 정책 미세조정을 위한 스칼라 수반 매칭 기법 Flow 정책은 다양한 행동 분포를 포착하며, 데모 데이터를 넘어 성능을 높이기 위해 오프-폴리시 강화학습으로 미세조정하는 방식이 주목받고 있다. AI · 머신러닝 · Q-Learning with Scalar Adjoint Matching
Key Point Flow 정책의 강화학습 미세조정 비용을 획기적으로 줄이면서도 실제 로봇 제어까지 검증한 실용적 알고리즘이 제안되었다.
핵심 요약
Flow 정책은 다양한 행동 분포를 포착하며, 데모 데이터를 넘어 성능을 높이기 위해 오프-폴리시 강화학습으로 미세조정하는 방식이 주목받고 있다. Flow 정책을 학습된 가치 함수로 미세조정하는 것은 정책이 많은 Flow 스텝을 거쳐 행동을 생성하므로 비자명하다. 기존 수반 매칭은 최종 행동에서 각 Flow 스텝으로 가치 정보를 역전파하는 원칙적 방법이지만, 매 스텝마다 벡터-야코비안 곱을 요구해 계산 비용이 Flow 스텝 수와 정책 크기에 따라 증가한다. 전체 요약 9문장 읽기 → 046 21:11 당일 +360 Windows에서 AI 에이전트 제어하는 MCP 서버 오픈소스 Windows-MCP는 LLM 기반 AI 에이전트가 Windows OS와 상호작용하도록 하는 경량 오픈소스 MCP 서버다. AI · 머신러닝 · CursorTouch/Windows-MCP · Python
Key Point AI 에이전트가 Windows 데스크톱을 네이티브하게 조종할 수 있는 오픈소스 표준이 등장했으며, 개발자들은 이를 자동화나 AI 통합 프로젝트에 즉시 활용할 수 있다.
핵심 요약
Windows-MCP는 LLM 기반 AI 에이전트가 Windows OS와 상호작용하도록 하는 경량 오픈소스 MCP 서버다. 파일 탐색, 애플리케이션 제어, UI 상호작용, QA 테스트 등의 작업을 자동화할 수 있으며, 컴퓨터 비전이나 특정 모델 학습 없이 모든 LLM과 호환된다. Python 3.13+ 환경에서 실행되며, Claude Desktop, Cursor, Perplexity, Gemini CLI 등 다양한 MCP 클라이언트에 연동 가능하고, PyPI를 통해 `uvx windows-mcp`로 설치할 수 있다. 전체 요약 9문장 읽기 → 047 18:30 ▲ 19 · 댓글 2 RAG 에이전트 평가 예산을 어떻게 배분할까 생성형 AI 모델이 정보를 찾아 답변하는 RAG 에이전트의 평가 비용을 효율적으로 배분하는 문제를 다룬 논문이다. AI · 머신러닝 · Agentic RAG Evaluation: Budget Allocation Across Questions, Trajectories, and Reads
Key Point RAG 시스템 평가에 투입할 제한된 예산을 질문, 탐색 경로, 반복 읽기 중 어디에 쓸지 결정하는 실증적 기준을 제시하므로, 대규모 언어모델 평가를 설계하는 연구자들이 의사결정할 때 직접 참고할 수 있다.
핵심 요약
생성형 AI 모델이 정보를 찾아 답변하는 RAG 에이전트의 평가 비용을 효율적으로 배분하는 문제를 다룬 논문이다. HotpotQA와 MuSiQue 데이터셋에서 회수 피드백 비교를 통해 3.4천만 토큰 예산에서 질문 커버리지를 넓히는 것이 다섯 번 반복 읽기보다 표준 오차를 33% 낮추고, 세 가지 탐색 경로보다 12.6% 낮춘다는 것을 측정했다. 저장된 예측 모델이 최적 배분을 4.0%(중첩 경로) 및 3.5%(질문만 사용) 범위 내에서 예측할 수 있음을 보였다. 전체 요약 6문장 읽기 → 048 18:30 ▲ 53 · 댓글 3 시각·언어·행동을 통합한 로봇 모델 UniWAM, 다중 작업에서 최고 성능 달성 비전-언어-행동 모델과 월드-액션 모델의 장점을 결합한 통합 아키텍처 UniWAM을 제안했다. AI · 머신러닝 · UniWAM: Unified World-Action Model
Key Point 로봇 학습에서 시각 이해와 행동 예측을 한 모델로 통합하는 접근법이 어떻게 작동하는지, 그리고 인간 데이터와 로봇 데이터를 함께 사용했을 때의 스케일링 효과를 보여주는 연구로, 구체화된 AI 시스템의 확장성을 이해하는 데 도움이 된다.
핵심 요약
비전-언어-행동 모델과 월드-액션 모델의 장점을 결합한 통합 아키텍처 UniWAM을 제안했다. 물리 추론기, 월드 생성기, 액션 예측기를 하나로 통합해 의미론적 이해, 시각 생성, 행동 예측을 동시에 학습한다. 저수준 행동을 자연언어로 표현하고, VQA 데이터·인간 이고센트릭 영상·로봇 시연으로 사전학습한다. 전체 요약 8문장 읽기 → 049 18:33 ▲ 21 · 댓글 2 단일 모델로 검색과 장문맥 처리 통합하는 UNREAL 말뭉치 검색(RAG)과 장문맥 추론은 증거 선택을 서로 다른 규모로 처리하는데, 이를 통일할 수 있는지 묻는 논문이다. AI · 머신러닝 · UNREAL: Unifying Retrieval and Long-Context with a Single Model
Key Point 대규모 언어모델의 검색과 장문맥 처리라는 두 가지 핵심 문제를 하나의 메커니즘으로 해결하는 새로운 접근으로, 생성 효율성과 정확도를 동시에 개선하는 경로를 제시한다.
핵심 요약
말뭉치 검색(RAG)과 장문맥 추론은 증거 선택을 서로 다른 규모로 처리하는데, 이를 통일할 수 있는지 묻는 논문이다. UNREAL은 LLM의 내부 표현에서 청크를 인코딩하고 검색 쿼리를 직접 도출하는 모델 내재 증거 선택 프레임워크다. 500K개 미만의 학습 가능 파라미터를 추가하며 기본 LLM은 수정하지 않는다. 전체 요약 9문장 읽기 → 050 18:33 ▲ 22 · 댓글 2 오디오-비주얼 추론 벤치마크와 학습법 제시한 OmniReasoning 논문 최근 음성·시각·언어를 통합으로 이해하는 옴니모달 모델들이 발전했으나, 기존 벤치마크와 학습 방식은 각 모달리티를 독립적으로 다루며 오디오-비주얼 결합 추론 능력을 제대로 평가하지 못하는 문제를 지적했다. AI · 머신러닝 · OmniReasoning: Pushing the Limits of Audio-Visual Joint Reasoning
Key Point 오디오와 비주얼 정보를 함께 활용해야 하는 멀티모달 추론이 현실 문제 해결에 중요해지는 만큼, 이를 측정하는 기준과 학습 방식이 필요한 시점에 제시된 실질적인 해결책이다.
핵심 요약
최근 음성·시각·언어를 통합으로 이해하는 옴니모달 모델들이 발전했으나, 기존 벤치마크와 학습 방식은 각 모달리티를 독립적으로 다루며 오디오-비주얼 결합 추론 능력을 제대로 평가하지 못하는 문제를 지적했다. 이를 해결하기 위해 벤치마크, 데이터 생성 엔진, 학습 방법을 함께 제시했다. OmniReasoningBench는 오디오와 비주얼 증거가 모두 필수적인 1,150개 객관식·개방형 문제로 구성되며, 비디오 추론과 비디오 외 추론 두 가지 과제를 포함한다. 전체 요약 7문장 읽기 → 051 18:33 ▲ 14 · 댓글 1 확산 언어 모델의 취약점: 피드백 제어로 편향 주입 공격 마스크드 확산 언어 모델(dLLM)은 토큰을 여러 번 재예측하면서 반복적으로 디노이징하므로, 각 토큰이 확정되기 전에 생성 확률이 여러 단계에서 노출된다. AI · 머신러닝 · Noise Out, Bias In: Targeted Bias Injection in Diffusion Language Models via Closed-Loop Activation Steering
Key Point 마스크드 확산 언어 모델이 기존 자동회귀 모델과 달리 여러 단계에서 답변을 노출하는 특성을 악용한 새로운 공격 벡터가 발견되었으며, 피드백 제어로 편향 주입 효과를 크게 증폭할 수 있다는 점이 주목할 만하다.
핵심 요약
마스크드 확산 언어 모델(dLLM)은 토큰을 여러 번 재예측하면서 반복적으로 디노이징하므로, 각 토큰이 확정되기 전에 생성 확률이 여러 단계에서 노출된다. 연구진은 내부 활성화에 접근 가능한 공격자가 이러한 디노이징 궤적을 악용해 모델을 특정 인구통계학적 답변으로 유도하는 '표적 편향 주입' 공격을 개발했다. 공격은 비례-적분(PI) 제어기를 사용해 디노이징 과정 중 목표 답변 확률을 추적하고, 조향 벡터의 강도를 실시간으로 조정한다. 전체 요약 7문장 읽기 → 052 18:33 당일 +199 DeepSeek의 GPU GEMM 커널 라이브러리 오픈소스 공개 DeepGEMM은 NVIDIA GPU에 최적화된 통합 텐서 코어 커널 라이브러리로, 대언어모델(LLM)의 핵심 연산인 GEMM(FP8, FP4, BF16), Mega MoE, MQA 스코링 등을 단일 CUDA 코드베이스에 통합했다. AI · 머신러닝 · deepseek-ai/DeepGEMM · Cuda
Key Point LLM 추론·학습 성능을 좌우하는 GEMM 커널을 DeepSeek이 직접 최적화한 오픈소스 공개로, 고속 LLM 인프라 구축 시 활용할 수 있는 기반 도구가 확보된다.
핵심 요약
DeepGEMM은 NVIDIA GPU에 최적화된 통합 텐서 코어 커널 라이브러리로, 대언어모델(LLM)의 핵심 연산인 GEMM(FP8, FP4, BF16), Mega MoE, MQA 스코링 등을 단일 CUDA 코드베이스에 통합했다. CUTLASS와 CuTe의 개념을 참고하되 무거운 템플릿 의존성을 피하고, 런타임 JIT 컴파일(DeepJIT)로 설치 시 CUDA 컴파일을 요구하지 않는다. 각 행렬 크기에 따라 전문가 튜닝 라이브러리 수준 이상의 성능을 제공하며, H800에서 최대 1550 TFLOPS를 달성한다. 전체 요약 11문장 읽기 → 053 18:35 ▲ 19 · 댓글 2 다중 매체 검색 결과를 선택적으로 압축하는 CANOPY 멀티모달 RAG는 텍스트, 표, 이미지, 비디오 등 다양한 매체를 검색하는데, 각 항목에서 얼마나 많은 맥락을 유지할지 결정하기 어려운 문제가 있다. AI · 머신러닝 · CANOPY: Adaptive-Granularity Evidence Compression for Multimodal RAG
Key Point 멀티모달 검색에서 압축 과정의 세분화 수준을 동적으로 조절함으로써 토큰 사용을 줄이면서도 답변 정확도를 지킬 수 있다는 점이 실무 적용에 중요하다.
핵심 요약
멀티모달 RAG는 텍스트, 표, 이미지, 비디오 등 다양한 매체를 검색하는데, 각 항목에서 얼마나 많은 맥락을 유지할지 결정하기 어려운 문제가 있다. 기존 압축 방식은 매체별로 다르게 동작하며, 이질적 항목 간에 적응형 세분화로 영역을 선택하는 공통 방식이 부족했다. CANOPY는 검색 결과를 계층 구조로 표현하고, 질문에 대해 학습된 인코더로 각 영역의 점수를 매긴 뒤, 부모 상대 정제(parent-relative refinement)로 다양한 세분화 수준의 여러 영역을 선택한다. 전체 요약 7문장 읽기 → 054 18:35 ▲ 11 · 댓글 2 에이전트 간 통신 75% 압축, 캐시 공유 방식 제안 다중 에이전트 시스템에서 에이전트 간 KV 캐시를 직접 전송하는 방식이 텍스트 통신보다 정확도와 지연시간이 우수하지만, 전체 캐시 크기가 각 에이전트 처리 컨텍스트와 에이전트 수에 따라 선형으로 증가해 GPU 메모리와 컨텍스트 윈도우를 초과하는 문제가 발생한다. AI · 머신러닝 · Receiver-Conditioned Latent Communication gives 94% CacheBack
Key Point KV 캐시 직접 전송으로 다중 에이전트 시스템의 성능을 높이되, 메모리 증폭 문제를 receiver conditioning으로 대폭 해결할 수 있는 실용적 방법을 제시한다.
핵심 요약
다중 에이전트 시스템에서 에이전트 간 KV 캐시를 직접 전송하는 방식이 텍스트 통신보다 정확도와 지연시간이 우수하지만, 전체 캐시 크기가 각 에이전트 처리 컨텍스트와 에이전트 수에 따라 선형으로 증가해 GPU 메모리와 컨텍스트 윈도우를 초과하는 문제가 발생한다. Receiver-Conditioned Latent Communication이라는 아이디어는 수신 에이전트가 자신의 정보 필요사항을 기술해 송신 에이전트에게 전달하면, 송신 에이전트가 이를 바탕으로 KV 캐시를 필터링·압축해서 보내는 방식이다. CacheBack은 송신 에이전트의 어텐션 가중치를 기반으로 receiver conditioning을 구현한 훈련 없는 방식이다. 전체 요약 5문장 읽기 → 055 18:35 ▲ 243 · 댓글 123 실제 측정한 12개 Zigbee 온습도센서 정확도 비교 AliExpress에서 주로 구매되는 Aqara·Sonoff·Tuya·Thirdreality·Zemismart·Moes 등의 Zigbee 온습도센서 12개를 실제 환경에서 비교 테스트했다. 하드웨어 · 시스템 · Best-selling Zigbee temperature sensors tested and compared
Key Point 스마트홈에서 가장 저렴한 Zigbee 온습도센서를 선택할 때 정확도·배터리 수명·보고 간격 조정 가능성이 매우 다르므로 실제 측정 데이터에 기반한 선택이 필요하다.
핵심 요약
AliExpress에서 주로 구매되는 Aqara·Sonoff·Tuya·Thirdreality·Zemismart·Moes 등의 Zigbee 온습도센서 12개를 실제 환경에서 비교 테스트했다. 캘리브레이션된 기준 센서(Xiaomi Miaomiaoce MHO-C401)와 나란히 놓고 약 10일간 측정했으며, 기준 센서는 정육점의 법정 검증 온도계로 영점을 재조정했다. 온도 정확도는 Paulie(Sonoff SNZB-02P)와 Carmela(Sonoff SNZB-02B)가 평균 0.2°C 편차로 가장 우수했고, Livia·Adriana·Furio는 0.5~0.8°C 오차를 보였다. 전체 요약 12문장 읽기 → 056 06:11 ▲ 23 · 댓글 2 평균이 같은 정책도 극단적 손실은 다르다…꼬리 위험 추정 방법 제시 평균 수익이 비슷한 강화학습 정책도 드문 실패(꼬리 위험)에서는 크게 달라지는데, 조건부가치손실(CVaR)을 정확히 추정하려면 많은 롤아웃이 필요하다. AI · 머신러닝 · Tail-Influence Sampling for CVaR Policy Evaluation
Key Point 강화학습 정책 평가에서 드물지만 치명적인 실패를 정확히 예측하는 것이 중요하며, 이 연구는 제한된 평가 예산으로 꼬리 위험을 효율적으로 추정하는 방법론을 제공한다.
핵심 요약
평균 수익이 비슷한 강화학습 정책도 드문 실패(꼬리 위험)에서는 크게 달라지는데, 조건부가치손실(CVaR)을 정확히 추정하려면 많은 롤아웃이 필요하다. 연구팀은 확률적 워크플로우의 각 조건부를 별도로 쿼리할 수 있을 때, 고정된 평가 예산을 꼬리 위험 추정에 최적 배분하는 방법을 제시했다. 각 쿼리 가능한 조건부 법칙에 대해 '꼬리 영향(tail influence)'을 정의해 그 불확실성이 벨만 재사용 전체에서 CVaR에 미치는 영향을 측정한다. 전체 요약 8문장 읽기 → 057 03:11 ▲ 19 · 댓글 2 루브릭 기반 강화학습의 보상 문제 해결하는 MetaRubric 루브릭 기반 강화학습은 개별 응답 요구사항에 부분 점수를 할당해 개방형 과제를 최적화하지만, 루브릭 판정자가 필수 정보나 행동이 없어도 높은 점수를 주는 '공허한 신용(Vacuous Credit)' 문제가 발생한다. AI · 머신러닝 · MetaRubric: Learning to Reward for Rubric-Based Reinforcement Learning
Key Point AI 모델의 보상 신호 설계 방식에 근본적인 문제점을 지적하고 의료·과학 분야 QA 성능을 20% 이상 끌어올린 접근법으로, 강화학습 기반 모델 개발에 실질적인 개선 방법을 제시한다.
핵심 요약
루브릭 기반 강화학습은 개별 응답 요구사항에 부분 점수를 할당해 개방형 과제를 최적화하지만, 루브릭 판정자가 필수 정보나 행동이 없어도 높은 점수를 주는 '공허한 신용(Vacuous Credit)' 문제가 발생한다. 이 문제는 필수 정보가 제거된 후에도 지속되며 응답의 GRPO 우위 부호를 역전시킬 수 있다. MetaRubric은 증거 인식 정책 최적화와 응답 기반 루브릭 적응을 교대로 수행하는 방식으로 이를 해결한다. 전체 요약 8문장 읽기 → 058 21:11 당일 +211 DeepSeek와 GLM을 개인 하드웨어에서 돌리는 경량 추론 엔진 공개 Salvatore Sanfilippo가 만든 DwarfStar는 DeepSeek V4/V4.1 Flash, GLM 5.2/5.3, Qwen3.8 Flash 등 주요 오픈웨이트 모델을 개인 하드웨어에서 실행하는 네이티브 추론 엔진으로, Metal·CUDA·ROCm을 지원한다. AI · 머신러닝 · antirez/ds4 · C
Key Point 개인 맥이나 워크스테이션에서 DeepSeek·GLM 같은 최신 고성능 모델을 실제로 돌릴 수 있는 구체적인 방법과 제약조건(메모리, SSD 스트리밍 필요 여부)이 명확해진다.
핵심 요약
Salvatore Sanfilippo가 만든 DwarfStar는 DeepSeek V4/V4.1 Flash, GLM 5.2/5.3, Qwen3.8 Flash 등 주요 오픈웨이트 모델을 개인 하드웨어에서 실행하는 네이티브 추론 엔진으로, Metal·CUDA·ROCm을 지원한다. 일반적인 GGUF 러너가 아니라 특정 모델 몇 개에 최적화된 자체 포함 C 코드이며, 프로젝트가 생산한 GGUF 파일만 사용한다. Metal은 애플 실리콘 맥(96GB 이상, 또는 SSD 스트리밍으로 더 작은 기계에서도 가능)을 주요 대상으로, CUDA는 DGX Spark와 Ada/L40S 카드를 포함한 다중 GPU 시스템을 지원하며, ROCm은 Strix Halo 같은 시스템을 대상으로 한다. 전체 요약 12문장 읽기 → 059 03:11 ▲ 25 · 댓글 2 이미지·텍스트 동시 생성하는 연속형 확산 모델 공개 Multimodal Flow는 텍스트와 이미지를 모두 연속적으로 생성하는 통합 생성 모델로, 기존 모델처럼 이미지를 양자화하거나 텍스트·이미지 생성 과정을 달리할 필요가 없다. AI · 머신러닝 · Multimodal Flow: Unified Flow Modeling of Language and Vision in Embedding Spaces
Key Point 텍스트와 이미지를 진정으로 통합되는 한 가지 방식으로 모두 생성할 수 있다면, 멀티모달 모델의 아키텍처가 단순해지고 더 나은 성능을 낼 수 있다는 점을 실증한다.
핵심 요약
Multimodal Flow는 텍스트와 이미지를 모두 연속적으로 생성하는 통합 생성 모델로, 기존 모델처럼 이미지를 양자화하거나 텍스트·이미지 생성 과정을 달리할 필요가 없다. 텍스트 블록과 이미지를 순서가 있는 연속적 하이퍼청크로 구성하며, Flow Matching을 통해 이들 위의 단일 벡터장을 학습한다. 크로스 모달 상호작용을 위해 공동 어텐션을 사용하고, 각 모달리티별 피드포워드 네트워크로 처리한다. 전체 요약 7문장 읽기 → 060 21:11 ▲ 165 · 댓글 2 실시간 스트리밍 비디오에서 인식·기억·응답을 통합하는 OneStreamer 스트리밍 비디오 LLM은 미래 작업의 중요성이 결정되기 전에 증거를 기억하고, 충분한 증거가 모였을 때 응답해야 한다. AI · 머신러닝 · OneStreamer: Unifying Perception, Memory, and Proactive Response in Streaming Video Interaction
Key Point 스트리밍 비디오 이해 작업에서 실시간 처리와 장기 기억 사이의 균형을 새롭게 푸는 방식을 제시하며, 8개 벤치마크에서 우수한 성능을 입증한 대규모 데이터셋과 모델을 공개합니다.
핵심 요약
스트리밍 비디오 LLM은 미래 작업의 중요성이 결정되기 전에 증거를 기억하고, 충분한 증거가 모였을 때 응답해야 한다. OneStreamer는 쿼리-독립적 증거 기록과 작업 응답을 공동으로 학습하되, 공유된 능동형 생성 과정을 통해 이룬다. Proactive Hierarchical Caption Memory(PHCM)는 시간-정박된 세부 사항 캡션과 완료된 이벤트의 요약을 생성하며, 훈련 중 관찰된 비디오 시작 부분의 해석을 감독한다. 전체 요약 10문장 읽기 → 061 18:11 ▲ 57 · 댓글 2 일상 영상에서 도구 사용 이해하는 AI 벤치마크 공개 일상 및 전문적 작업에서 도구 사용은 필수이지만, 현 영상 모델들은 도구 사용의 affordance·기하학적 관계·절차·인과관계를 이해하는 데 제한적이다. AI · 머신러닝 · EgoTools: Towards Tool-Centric Reasoning in Real-World Egocentric Videos
Key Point 현 멀티모달 모델이 실제 작업 영상에서 도구 사용의 세부 기하학·절차·인과관계를 이해하는 데 약점을 드러냈으므로, 이를 진단하고 개선할 수 있는 벤치마크가 필요하다.
핵심 요약
일상 및 전문적 작업에서 도구 사용은 필수이지만, 현 영상 모델들은 도구 사용의 affordance·기하학적 관계·절차·인과관계를 이해하는 데 제한적이다. 이를 해결하기 위해 EgoTools 스위트를 공개했으며, 100시간의 도구 중심 1인칭 영상 데이터셋(음성 동기화·캡션·내레이션·3D 정보 포함)과 진단 벤치마크로 구성된다. 벤치마크는 1,000개의 QA로 이루어져 있으며 지각·기하학·절차·인과 추론의 4가지 트랙을 포함한다. 전체 요약 6문장 읽기 → 062 06:11 ▲ 20 · 댓글 2 다단계 작업에서 언어 모델이 실수를 예방하고 회복하는 법 다중 턴 에이전트 훈련에서 초기에 발생한 하나의 잘못된 행동이 이후 상태를 왜곡해 오류가 누적되는 문제를 발견했다. AI · 머신러닝 · PivotOPD: Learning to Recover from Pivotal Mistakes in Multi-Turn Agents
Key Point 초기 실수를 예방하면서 동시에 회복하는 훈련 방식으로, 다중 턴 작업 에이전트의 오류 누적 문제를 직접 해결하는 실용적 접근이다.
핵심 요약
다중 턴 에이전트 훈련에서 초기에 발생한 하나의 잘못된 행동이 이후 상태를 왜곡해 오류가 누적되는 문제를 발견했다. Qwen3 3개 모델(8B~235B) 실험에서 실패한 시도의 50% 이상이 '중추적 실수'(작업 완료를 더 멀게 하는 행동)를 포함하고 있으며, 이는 대부분 초기에 발생한다. 놀랍게도 이러한 중추적 실수 후 몇 턴의 지도만으로도 작업 성공을 복구할 수 있다. 전체 요약 7문장 읽기 → 063 21:11 당일 +280 Y Combinator CEO의 AI 에이전트 프로덕션 툴킷 공개 Y Combinator의 Garry Tan이 gstack을 오픈소스로 공개했다. Claude Code를 위한 23개 슬래시 커맨드 도구 모음으로, CEO·설계자·엔지니어링 매니저·QA 등 역할을 수행하는 AI 에이전트 팀을 구성한다. AI · 머신러닝 · garrytan/gstack · TypeScript
Key Point 한 명의 기술 창업자가 전통적 팀 규모만큼 빠르게 일 처리할 수 있는 AI 에이전트 시스템의 구체적인 구현 방법과 수치 검증이 공개됐다.
핵심 요약
Y Combinator의 Garry Tan이 gstack을 오픈소스로 공개했다. Claude Code를 위한 23개 슬래시 커맨드 도구 모음으로, CEO·설계자·엔지니어링 매니저·QA 등 역할을 수행하는 AI 에이전트 팀을 구성한다. Tan은 2026년 개인 생산성이 2013년 대비 논리적 코드 변경 기준 약 810배에 달했다고 밝혔다. 같은 사람이 같은 방식이 아닌 다른 도구를 사용한 결과다. gstack의 핵심 흐름은 사고 → 계획 → 구축 → 검토 → 테스트 → 배포 → 회고의 스프린트 구조다. /office-hours로 제품 재검토, /plan-ceo-review로 전략 도전, /plan-eng-review로 아키텍처 확정, /design-review로 AI 슬롭 감지, /review로 버그 찾기, /qa로 브라우저 테스트, /ship으로 배포 자동화를 수행한다. 전체 요약 10문장 읽기 → 064 15:11 ▲ 121 · 댓글 3 LLM 에이전트의 자기 개선 능력 강화하는 AREX-2 발표 LLM 에이전트가 테스트 단계에서 해를 반복적으로 개선하는 자기 개선 능력을 갖추도록 하는 AREX-2를 제시한다. AI · 머신러닝 · AREX-2: Advancing Self-Improving Agents through Long-Horizon Reflective Tasks
Key Point 기존 LLM 에이전트는 일회성 답변을 생성하는 데 그쳤다면, 반사적 사고를 통해 반복적으로 해결책을 개선할 수 있는 에이전트 설계 방식이 제시되어 자율 문제 해결 능력의 한계를 넘는 가능성을 보여준다.
핵심 요약
LLM 에이전트가 테스트 단계에서 해를 반복적으로 개선하는 자기 개선 능력을 갖추도록 하는 AREX-2를 제시한다. 이 능력은 현재 해보다 나은 해를 만드는 반사적 사고(reflection)와 여러 라운드에서 효과를 유지하는 장기 실행(long-horizon execution) 두 가지를 결합한다. 두 능력이 모두 도메인 무관하다고 가정하여, 검증 가능한 피드백을 주는 기계학습과 알고리즘 프로그래밍 작업에서 데이터를 합성해 학습시킨다. 전체 요약 6문장 읽기 → 065 12:11 ▲ 72 · 댓글 1 장시간 영상의 객체 추적, 생애 기반 메모리로 풀다 수시간 또는 수일 길이의 영상에서 질문에 답하려면 같은 객체가 관여한 사건들을 시간 범위를 넘어 연결해야 한다. AI · 머신러닝 · Beyond the Timeline: Augmenting Long-Video Memory with Grounded Entity Biographies
Key Point 장시간 영상에서 같은 객체가 여러 사건에 걸쳐 나타날 때 시각적 정체성을 추적하는 문제를 푸는 새로운 접근법이 공개되었으며, 이는 비디오 이해 AI의 실용성을 크게 높인다.
핵심 요약
수시간 또는 수일 길이의 영상에서 질문에 답하려면 같은 객체가 관여한 사건들을 시간 범위를 넘어 연결해야 한다. 기존 시간 기반 설명이나 텍스트 기반 개체는 물리적 정체성을 구분하지 못해, 같은 객체의 관찰이 사건들 사이에 연결되지 않는 문제가 있다. 연구팀은 Grounded Entity Biographies(GEB)라는 긴 영상 메모리 프레임워크를 제안했다. 전체 요약 8문장 읽기 → 066 09:11 ▲ 108 · 댓글 62 Claude Opus 5.5의 성능 변화를 추적하는 벤치마크 공개 Claude Opus 5.5 출시 직후부터 모델 성능이 몰래 하락하는지 검증하는 'livenerf' 벤치마크를 공개했다. AI · 머신러닝 · Livenerf: Has Opus 5.5 been nerfed yet?
Key Point Claude 모델의 출시 후 성능 저하 의혹이 반복적으로 제기되는 상황에서, 데이터 기반 검증 도구가 공개돼 사용자와 개발자가 실제 변화를 직접 확인할 수 있게 되었다.
핵심 요약
Claude Opus 5.5 출시 직후부터 모델 성능이 몰래 하락하는지 검증하는 'livenerf' 벤치마크를 공개했다. GPQA Diamond, MMLU-Pro, 대회 수학 문제 2,336개를 선별해 때때로 정답률이 50~70% 범위에 떨어지는 78개 문항을 최종 패널로 구성했다. 매일 90개 샘플을 실행하되, 처음 10일간을 기준선으로 설정하고 이후 두 개 10일 구간에서 통계적으로 유의미한 변화를 감지한다. 전체 요약 11문장 읽기 → 067 03:11 ▲ 345 · 댓글 248 macOS Golden Gate, 버그 투성이인 상태로 출시됐다 Apple이 macOS 27(Golden Gate)을 출시했으며, 18년 전 Snow Leopard처럼 버그 수정과 안정성 개선에 중점을 두겠다고 약속했다. 하드웨어 · 시스템 · macOS Golden Gate Is a Buggy Mess
Key Point 안정성 개선을 약속한 macOS가 오히려 심각한 버그(시스템 한정 등)를 안고 출시되면서, 연간 릴리스 사이클의 한계를 드러내고 있다.
핵심 요약
Apple이 macOS 27(Golden Gate)을 출시했으며, 18년 전 Snow Leopard처럼 버그 수정과 안정성 개선에 중점을 두겠다고 약속했다. 하지만 정렬 문제가 곳곳에서 발견된다: QuickTime 녹화 버튼, 윈도우 타일링 아이콘, System Settings 텍스트 등이 제대로 정렬되지 않았다. 메뉴바 아키텍처를 변경하면서 여러 서드파티 앱이 충돌하고, 프로필 메뉴가 로드되는 데 1초 이상 걸리며, 파일 메뉴가 자동으로 하이라이트되는 버그가 있다. 전체 요약 8문장 읽기 → 068 21:11 당일 +477 벡터DB 없이 추론으로 문서를 읽는 RAG, PageIndex PageIndex는 벡터 인덱스 대신 계층 구조의 트리 인덱스를 만들고, LLM의 추론으로 그 트리를 탐색하는 벡터리스 RAG 엔진이다. AI · 머신러닝 · VectifyAI/PageIndex · Python
Key Point 벡터DB에 의존하지 않고 LLM의 추론으로 문서를 검색하는 새로운 RAG 방식이, 복잡한 전문 문서에서 기존 벡터 검색보다 훨씬 높은 정확도(98.7%)와 낮은 비용(2~16배 절감)을 달성했기 때문이다.
핵심 요약
PageIndex는 벡터 인덱스 대신 계층 구조의 트리 인덱스를 만들고, LLM의 추론으로 그 트리를 탐색하는 벡터리스 RAG 엔진이다. 벡터 RAG는 의미적 유사성으로 검색하지만, 유사성이 반드시 관련성을 의미하지 않는다. PageIndex는 문맥 이해, 도메인 전문성, 다단계 추론이 필요한 금융보고서나 법률 문서에서 더 정확한 관련 정보를 찾는다. 인덱싱은 문서마다 트리 구조를 생성하고, 검색은 LLM이 그 트리를 추론하며 탐색하는 두 단계로 진행된다. 전체 요약 12문장 읽기 → 069 21:11 ▲ 109 · 댓글 23 극한 압축 언어모델을 마이크로컨트롤러 클러스터에서 구동 7개의 ESP32S3 마이크로컨트롤러를 클러스터로 연결해 0.5B 규모 1.58비트 BitNet 언어모델을 분산 실행하는 프로젝트다. 하드웨어 · 시스템 · ESP32S3 cluster running 1.58-bit (BitNet) Language model
Key Point 마이크로컨트롤러 클러스터에서 극저단계 양자화 모델을 실행하는 구체적인 분산 시스템 설계와 구현 사례를 보여줌으로써, 임베디드 환경에서 LLM 배포의 가능성을 확장한다.
핵심 요약
7개의 ESP32S3 마이크로컨트롤러를 클러스터로 연결해 0.5B 규모 1.58비트 BitNet 언어모델을 분산 실행하는 프로젝트다. 마스터 노드에서 BPE 토크나이저와 임베딩을 처리하고, 6개의 컴퓨트 노드에서 24개의 트랜스포머 블록을 4개씩 나눠 실행한다. SPI 데이지-체인 방식으로 노드 간 고속 통신하며, 마스터-노드 1-노드 2...노드 6-마스터 순환 파이프라인 구조로 동작한다. 전체 요약 7문장 읽기 → 070 18:11 ▲ 12 · 댓글 1 프로그램 검증으로 강화한 시각-언어 모델 자가학습 시각-언어 모델의 자가학습은 라벨 없는 이미지에서 생성한 질문으로 학습하는데, 기존 방식은 다수결 투표나 모델 심판으로 답을 결정하면서 24~18% 오류율을 낳고 있다. AI · 머신러닝 · Program-Verified Self-Evolution for Vision-Language Models
Key Point 라벨 없는 데이터로 자가학습하는 모델의 답 검증 정확도를 다수결 투표 76%에서 94%로 끌어올린 방법론이므로, 대규모 비지도 학습 시대에 레이블 수집 비용과 오류 문제를 해결하는 접근법으로 주목할 만하다.
핵심 요약
시각-언어 모델의 자가학습은 라벨 없는 이미지에서 생성한 질문으로 학습하는데, 기존 방식은 다수결 투표나 모델 심판으로 답을 결정하면서 24~18% 오류율을 낳고 있다. 이를 해결하기 위해 VQS(Verifiable QA Generation for Self-Evolving Models)는 답변 검증 방식을 바꿔서, 이미지를 장면그래프·차트·다이어그램 같은 구조화된 기록으로 파싱한 뒤 고정된 프로그램이 질문과 답을 생성한다. 모델은 프로그램이 읽은 개별 사실을 주장 단위로 확인하는 시각 검증자 역할을 하며, 이러한 주장 수준의 검증이 파서의 학습 목표를 선택하므로 파서도 라벨 없이 개선된다. 전체 요약 7문장 읽기 → 071 18:11 ▲ 10 · 댓글 2 확산 모델의 생성 과정으로 이미지 품질 평가하기 Reference-based 이미지 품질 평가(IQA) 지표는 인간이 인식하는 이미지 쌍 간의 지각적 거리를 반영하려 한다. AI · 머신러닝 · FoMo: Forking Moment in Generative Trajectory as a Perceptual Distance
Key Point diffusion 모델의 생성 과정이 인간 시각 인식과 일치한다는 발견으로, 비용 많이 드는 인간 주석 없이도 이미지 품질 평가 모델을 학습할 수 있는 새로운 방식을 제시한다.
핵심 요약
Reference-based 이미지 품질 평가(IQA) 지표는 인간이 인식하는 이미지 쌍 간의 지각적 거리를 반영하려 한다. 기존 방식은 인간이 주석을 단 Mean Opinion Score(MOS) 데이터에 의존하는데, 대규모 수집이 비용이 크고 인간 판단의 불일치로 인해 노이즈가 많다. 2AFC(2-alternative forced choice) 쌍비교 라벨은 신뢰도가 높지만 상대적 비교만 포착한다. 전체 요약 9문장 읽기 → 072 15:11 ▲ 18 · 댓글 2 멀티뷰 학습으로 공간 추론 강화한 SpatialSpeak 공개 비전-언어 모델(VLM)이 다중 관점 공간 추론을 위해 기하학적 사전 정보를 활용하지만, 기존 답 위주의 학습은 중간의 기하학적 추정과 정량적 공간 답 도출 과정을 직접 감독하지 않는다. AI · 머신러닝 · SpatialSpeak: QA-Native Reconstruction with Local and Global Context for Spatial Chain-of-Thought Reasoning
Key Point 비전-언어 모델의 공간 추론 능력을 크게 향상하는 새로운 학습 방식이 제시되었으며, 멀티뷰 재구성과 사고의 흐름 학습을 결합한 접근법이 기하학적 이해와 답 도출 과정 모두를 강화한다.
핵심 요약
비전-언어 모델(VLM)이 다중 관점 공간 추론을 위해 기하학적 사전 정보를 활용하지만, 기존 답 위주의 학습은 중간의 기하학적 추정과 정량적 공간 답 도출 과정을 직접 감독하지 않는다. 연구팀은 VLM이 멀티뷰 재구성을 통해 국소 기하학과 전역 장면 맥락을 함께 학습할 때 공간 사고의 흐름(CoT) 감독이 더 효과적이라고 가정했다. SpatialSpeak은 두 단계 프레임워크로, 1단계(QA-Native Reconstruction Pretraining, QA-RP)에서 표시된 점 기반 3D 쿼리로 세밀한 국소 기하학을 학습하고 객체 중심 쿼리로 전역 장면 맥락을 학습한다. 전체 요약 8문장 읽기 → 073 21:11 당일 +136 마이크로소프트 SkillOpt, 모델 가중치 고정한 채 LLM 에이전트 스킬 자동 개선 마이크로소프트가 SkillOpt를 오픈소스로 공개했다. 이는 LLM 모델의 가중치를 건드리지 않고 자연어로 작성된 에이전트 스킬 문서를 신경망처럼 학습시키는 텍스트 공간 최적화 도구다. AI · 머신러닝 · microsoft/SkillOpt · Python
Key Point LLM 모델 자체를 수정하지 않고도 자연언어 스킬을 신경망처럼 반복 학습시켜 에이전트 성능을 대폭 개선할 수 있다는 점이 기존 방식과 근본적으로 다르며, 52개 평가 환경 전수에서 최고 성능을 입증했다.
핵심 요약
마이크로소프트가 SkillOpt를 오픈소스로 공개했다. 이는 LLM 모델의 가중치를 건드리지 않고 자연어로 작성된 에이전트 스킬 문서를 신경망처럼 학습시키는 텍스트 공간 최적화 도구다. 기존 에이전트 스킬은 수작업으로 만들거나 강력한 LLM으로 한 번에 생성하거나 느슨한 자가개선에만 의존했다. SkillOpt는 스킬 문서를 얼린 에이전트의 학습 가능한 상태로 취급하고 신경망 최적화처럼 학습시킨다. 동작 방식은 스코어된 롤아웃(실행 결과)을 텍스트 에디트(추가/삭제/변경)로 변환하는 별도의 옵티마이저 모델을 사용한다. 후보 에디트는 검증용 점수를 엄격히 향상시킬 때만 수용되며, 텍스트 학습률 예산과 에포크별 업데이트로 안정성을 보장한다. 전체 요약 9문장 읽기 → 074 03:11 ▲ 152 · 댓글 46 소프트웨어의 '그냥 안 되는' 일상화 저자는 문제의 원인을 추적할 수 없는 오류가 정상화되는 현상을 우려하고 있다. AI · 머신러닝 · The Normalization of Inexplicable Failures
Key Point AI 기반 기능이 배포되면서 '원인을 알 수 없는 장애'가 정상적인 것으로 받아들여지는 추세를 다루는데, 이는 개발 생산성과 품질 사이의 근본적인 긴장을 보여줍니다.
핵심 요약
저자는 문제의 원인을 추적할 수 없는 오류가 정상화되는 현상을 우려하고 있다. Jev 같은 AI 모델들은 빠르고 저렴하지만, 사용자는 반환값이 정말 작동하는지 검증할 평가 프레임워크(evals)를 구축해야 한다. 대부분의 개발자는 기술적 평가를 미루고 'AI 기반' 표시만 하고 배포한 뒤, 장애 발생 시 '음, AI는 실수한다'고 넘어간다. 전체 요약 9문장 읽기 → 075 00:11 ▲ 109 · 댓글 30 LLM의 토큰 확률 읽어 단일 함수로 선택지 점수 매기기 LLM API의 로그프로브(logprobs) 기능을 활용해 한 개 토큰만 생성하도록 강제한 후 각 선택지별 확률을 추출하는 기법을 소개했다. AI · 머신러닝 · A single function Jev-like wrapper for LLMs, including vision models
Key Point LLM의 로그프로브를 활용해 단 한 줄의 함수로 복잡한 다중 선택 평가를 빠르게 구현할 수 있으며, 비전 모델도 지원해 실시간 이미지 분석 애플리케이션의 선택지 점수 매김에 즉시 적용 가능하다.
핵심 요약
LLM API의 로그프로브(logprobs) 기능을 활용해 한 개 토큰만 생성하도록 강제한 후 각 선택지별 확률을 추출하는 기법을 소개했다. 상태와 질문을 프롬프트로 보내고 max_completion_tokens를 1로 설정한 후 top_logprobs로 대안 토큰들의 확률을 받으면, 여러 질문이 같은 상태 접두사를 공유할 때 KV 캐시를 활용할 수 있다. 이 방식은 텍스트뿐 아니라 비전 모델과도 작동하며, 이미지를 base64로 인코딩해 전송할 수 있도록 Jev 요청 형식에 attachments 필드를 추가했다. 전체 요약 7문장 읽기 → 076 22:29 ▲ 16 · 댓글 2 LLM 코딩 벤치마크, 실제 실력 평가 아닌 암기 성공 가능성 SWE-bench 등 저장소 수준 코딩 벤치마크는 학습 데이터에 반복 사용된 인기 오픈소스 저장소 기반이라 데이터 유출 문제를 안고 있다. AI · 머신러닝 · Schrödinger's Code Repository: Have LLMs Learned SWE-bench or Memorized It?
Key Point LLM 코딩 평가 벤치마크가 실제 실력이 아닌 암기된 패턴 재인식을 측정하고 있을 가능성을 실증적으로 보여, SWE-bench 성능 신뢰도 문제를 제기한다.
핵심 요약
SWE-bench 등 저장소 수준 코딩 벤치마크는 학습 데이터에 반복 사용된 인기 오픈소스 저장소 기반이라 데이터 유출 문제를 안고 있다. 강한 성능이 실제 저장소 추론 능력이 아니라 표준화된 저장소 단서 암기를 반영할 가능성이 있다. SchrodingerRepo 평가 프레임워크를 제안하며, 정적 저장소 표현 대신 평가 시점에 동적으로 인스턴스화된 저장소를 사용한다. 전체 요약 7문장 읽기 → 077 03:10 ▲ 269 · 댓글 132 Cloudflare, 계정 없이 로컬 앱을 즉시 공개하는 Quick Tunnels 출시 Cloudflare가 Quick Tunnels 서비스를 무료로 공개했다. 별도 계정 생성 없이 한 줄의 명령어로 로컬 개발 환경을 인터넷에 노출할 수 있다. 인프라 · 데브옵스 · Cloudflare Quick Tunnels
Key Point 로컬 개발 중인 앱을 공유하거나 테스트하려면 배포, 도메인, 인증서 등 복잡한 과정을 거쳤는데, 이제 한 명령어로 즉시 공개할 수 있어 프로토타입 피드백과 협업 속도가 크게 단축된다.
핵심 요약
Cloudflare가 Quick Tunnels 서비스를 무료로 공개했다. 별도 계정 생성 없이 한 줄의 명령어로 로컬 개발 환경을 인터넷에 노출할 수 있다. cloudflared CLI를 설치한 후 'cloudflared tunnel --url http://localhost:8000' 명령어 하나로 즉시 trycloudflare.com 도메인의 미리보기 링크를 생성한다. DNS 설정이나 인증서 관리, 포트 개방 없이 자동으로 HTTPS와 DDoS 보호, 라우팅을 Cloudflare 글로벌 네트워크에서 처리한다. 전체 요약 4문장 읽기 → 078 03:10 ▲ 130 · 댓글 80 LLM에 '뇌를 끄고' 의존하면 결국 직업을 잃는다 LLM이 나은 코드나 결과물을 자동으로 검증 없이 신뢰하는 '뇌를 끈' 업무 방식이 2025년 이후 급증하고 있다. AI · 머신러닝 · There's no point at which turning your brain off will work
Key Point LLM 능력이 개선될수록 역설적으로 오토메이션 없이 무분별하게 의존하는 개발자의 직업안정성이 위협받는 상황을 지적하며, 언제까지 유효한 업무 전략인지 생각해볼 필요가 있다.
핵심 요약
LLM이 나은 코드나 결과물을 자동으로 검증 없이 신뢰하는 '뇌를 끈' 업무 방식이 2025년 이후 급증하고 있다. LLM이 충분히 개선되어 품질 높은 소프트웨어를 생산하게 되면, 기업은 인간의 '고기 프록시'(meat proxy)가 아닌 LLM만 반복 실행하고 직원을 해고할 수 있다. 고부가가치 작업은 LLM이 단번에 성공할 확률이 낮으므로 여전히 아키텍처 검토·QA·의사결정 등 인간의 감독이 필수다. 전체 요약 5문장 읽기 → 079 21:11 당일 +660 코드베이스를 지식 그래프로 변환하는 Graphify 코드, 문서, PDF, 설정 파일 등을 쿼리 가능한 지식 그래프로 변환하는 도구로 Claude Code, Cursor 등 AI 코딩 어시스턴트에서 /graphify 명령으로 사용할 수 있다. AI · 머신러닝 · Graphify-Labs/graphify · Python
Key Point 벡터 검색 없이 실제 그래프 구조로 코드베이스를 매핑하고 추론 과정을 추적할 수 있다는 점이 기존 의미 검색 방식과 다르며, 개발자들이 AI 어시스턴트에서 직접 코드 전체 구조를 이해하는 방식을 바꿀 수 있다.
핵심 요약
코드, 문서, PDF, 설정 파일 등을 쿼리 가능한 지식 그래프로 변환하는 도구로 Claude Code, Cursor 등 AI 코딩 어시스턴트에서 /graphify 명령으로 사용할 수 있다. tree-sitter 기반 AST 파싱으로 코드는 로컬에서 결정론적으로 처리되며 LLM을 사용하지 않고 기계에서 벗어나지 않는다. 각 연결은 명시적 추출(EXTRACTED) 또는 추론(INFERRED)으로 태그되어 원본에서 직접 읽은 것과 도출된 것을 구분할 수 있다. 전체 요약 6문장 읽기 → 080 16:56 ▲ 114 · 댓글 8 DeepSeek, KV 캐시 압축으로 추론 속도 420 토큰/초 달성 DeepSeek-v4.1 Flash는 552B 매개변수 멀티모달 모델로, 에이전트 워크플로우에서 증가하는 컨텍스트와 도구 호출로 인한 프리필 계산 부담을 해결하기 위해 설계됐다. AI · 머신러닝 · DeepSeek-v4.1 Flash: Pushing the Limits of KV Cache Compression
Key Point 에이전트 워크플로우에서 일반적인 병목인 장문맥 프리필 계산과 KV 캐시 저장 비용을 획기적으로 줄인 새로운 모델 아키텍처 설계가 장기 맥락 처리와 배포 비용 절감에 어떻게 영향을 미치는지 보여준다.
핵심 요약
DeepSeek-v4.1 Flash는 552B 매개변수 멀티모달 모델로, 에이전트 워크플로우에서 증가하는 컨텍스트와 도구 호출로 인한 프리필 계산 부담을 해결하기 위해 설계됐다. KV 캐시 압축을 위해 채널·시퀀스·레이어 세 차원에서 최적화를 진행했으며, 같은 시퀀스 길이에서 런타임 KV 캐시는 v4-Flash의 1/4, 영구 저장소는 1/8 수준으로 줄었다. Causal Encoder-Decoder(CED) 아키텍처를 도입해 프리필 단계에서 8B, 디코딩 단계에서 16B 매개변수만 활성화되도록 설계했으며, 이는 입력 중심의 에이전트 시나리오에 특히 효율적이다. 전체 요약 12문장 읽기 → 081 08:27 ▲ 199 · 댓글 58 4,400년 전 이집트 판사 무덤 발굴, 색감 살아있는 벽화 발견 사카라에서 제5왕조 말 시대의 마스타바 무덤이 발굴되었으며, 이는 고위 판사 윤민과 그의 아버지 이티의 무덤이다. 기타 · 4,400-Year-Old Tomb of Egyptian Judge Found at Saqqara with Colors on Walls
Key Point 고대 이집트 행정 체계와 왕실의 작동 방식을 직접 보여주는 4,400년 전 무덤 기록이며, 천 년 이상 후에 발굴된 고고학 유산이 현대 기술로 어떻게 새로운 정보를 드러낼 수 있는지 보여준다.
핵심 요약
사카라에서 제5왕조 말 시대의 마스타바 무덤이 발굴되었으며, 이는 고위 판사 윤민과 그의 아버지 이티의 무덤이다. 무덤에는 농업 장면과 제물 행렬을 그린 부조가 있으며, 원래의 색감이 4,400년이 지난 지금도 남아있다. 윤민은 판사이자 법원 책임자였으며 청원과 불만을 검토하는 서기들의 장으로서 고대 이집트 행정부의 구조를 보여준다. 전체 요약 6문장 읽기 → 082 00:10 ▲ 102 · 댓글 23 PyTorch로 직접 구현한 최신 LLM 아키텍처 학습 저장소 최신 오픈소스 LLM들의 PyTorch 구현을 처음부터 손으로 직접 작성한 저장소로, 각 모델은 원논문과 기술 보고서를 참고해 구성했다. AI · 머신러닝 · OpenArch – PyTorch implementations of modern LLM architectures
Key Point LLM 아키텍처의 세부 설계 차이를 명확히 읽고 비교하고 싶은 개발자라면, 프로덕션 코드의 복잡성 없이 각 선택지가 어떻게 구현되는지 바로 확인할 수 있다.
핵심 요약
최신 오픈소스 LLM들의 PyTorch 구현을 처음부터 손으로 직접 작성한 저장소로, 각 모델은 원논문과 기술 보고서를 참고해 구성했다. GPT-2, Llama 2/3/4, Qwen, Mistral, DeepSeek R1 등 11개 텍스트 모델과 PaliGemma, Qwen3 등 멀티모달 모델을 구현 중이며, 추가로 72개 아키텍처 전체 구현을 목표로 한다. 주의 메커니즘(MHA, GQA, MQA, MLA), 정규화(RMSNorm, QK-Norm), 위치 인코딩(RoPE, NoPE), MoE 라우팅 등 현대 LLM들이 사용하는 구조적 선택지를 명시적으로 표현해 비교하기 쉽게 했다. 전체 요약 5문장 읽기 → 084 11:10 당일 +306 스크린 미러링 도구 Escrcpy, 다중 기기 제어와 AI 자동화 지원 Electron과 Vue.js 기반 GUI 애플리케이션으로 Android 기기를 PC에서 화면 표시 및 제어할 수 있는 scrcpy 래퍼다. 오픈소스 · 도구 · viarotel-org/escrcpy · JavaScript
Key Point Android 기기를 원격으로 제어하는 개발자·QA 엔지니어, 모바일 앱 테스터들이 PC에서 여러 기기를 한 곳에서 관리하고 자동화할 수 있는 통합 플랫폼이 생겼다.
핵심 요약
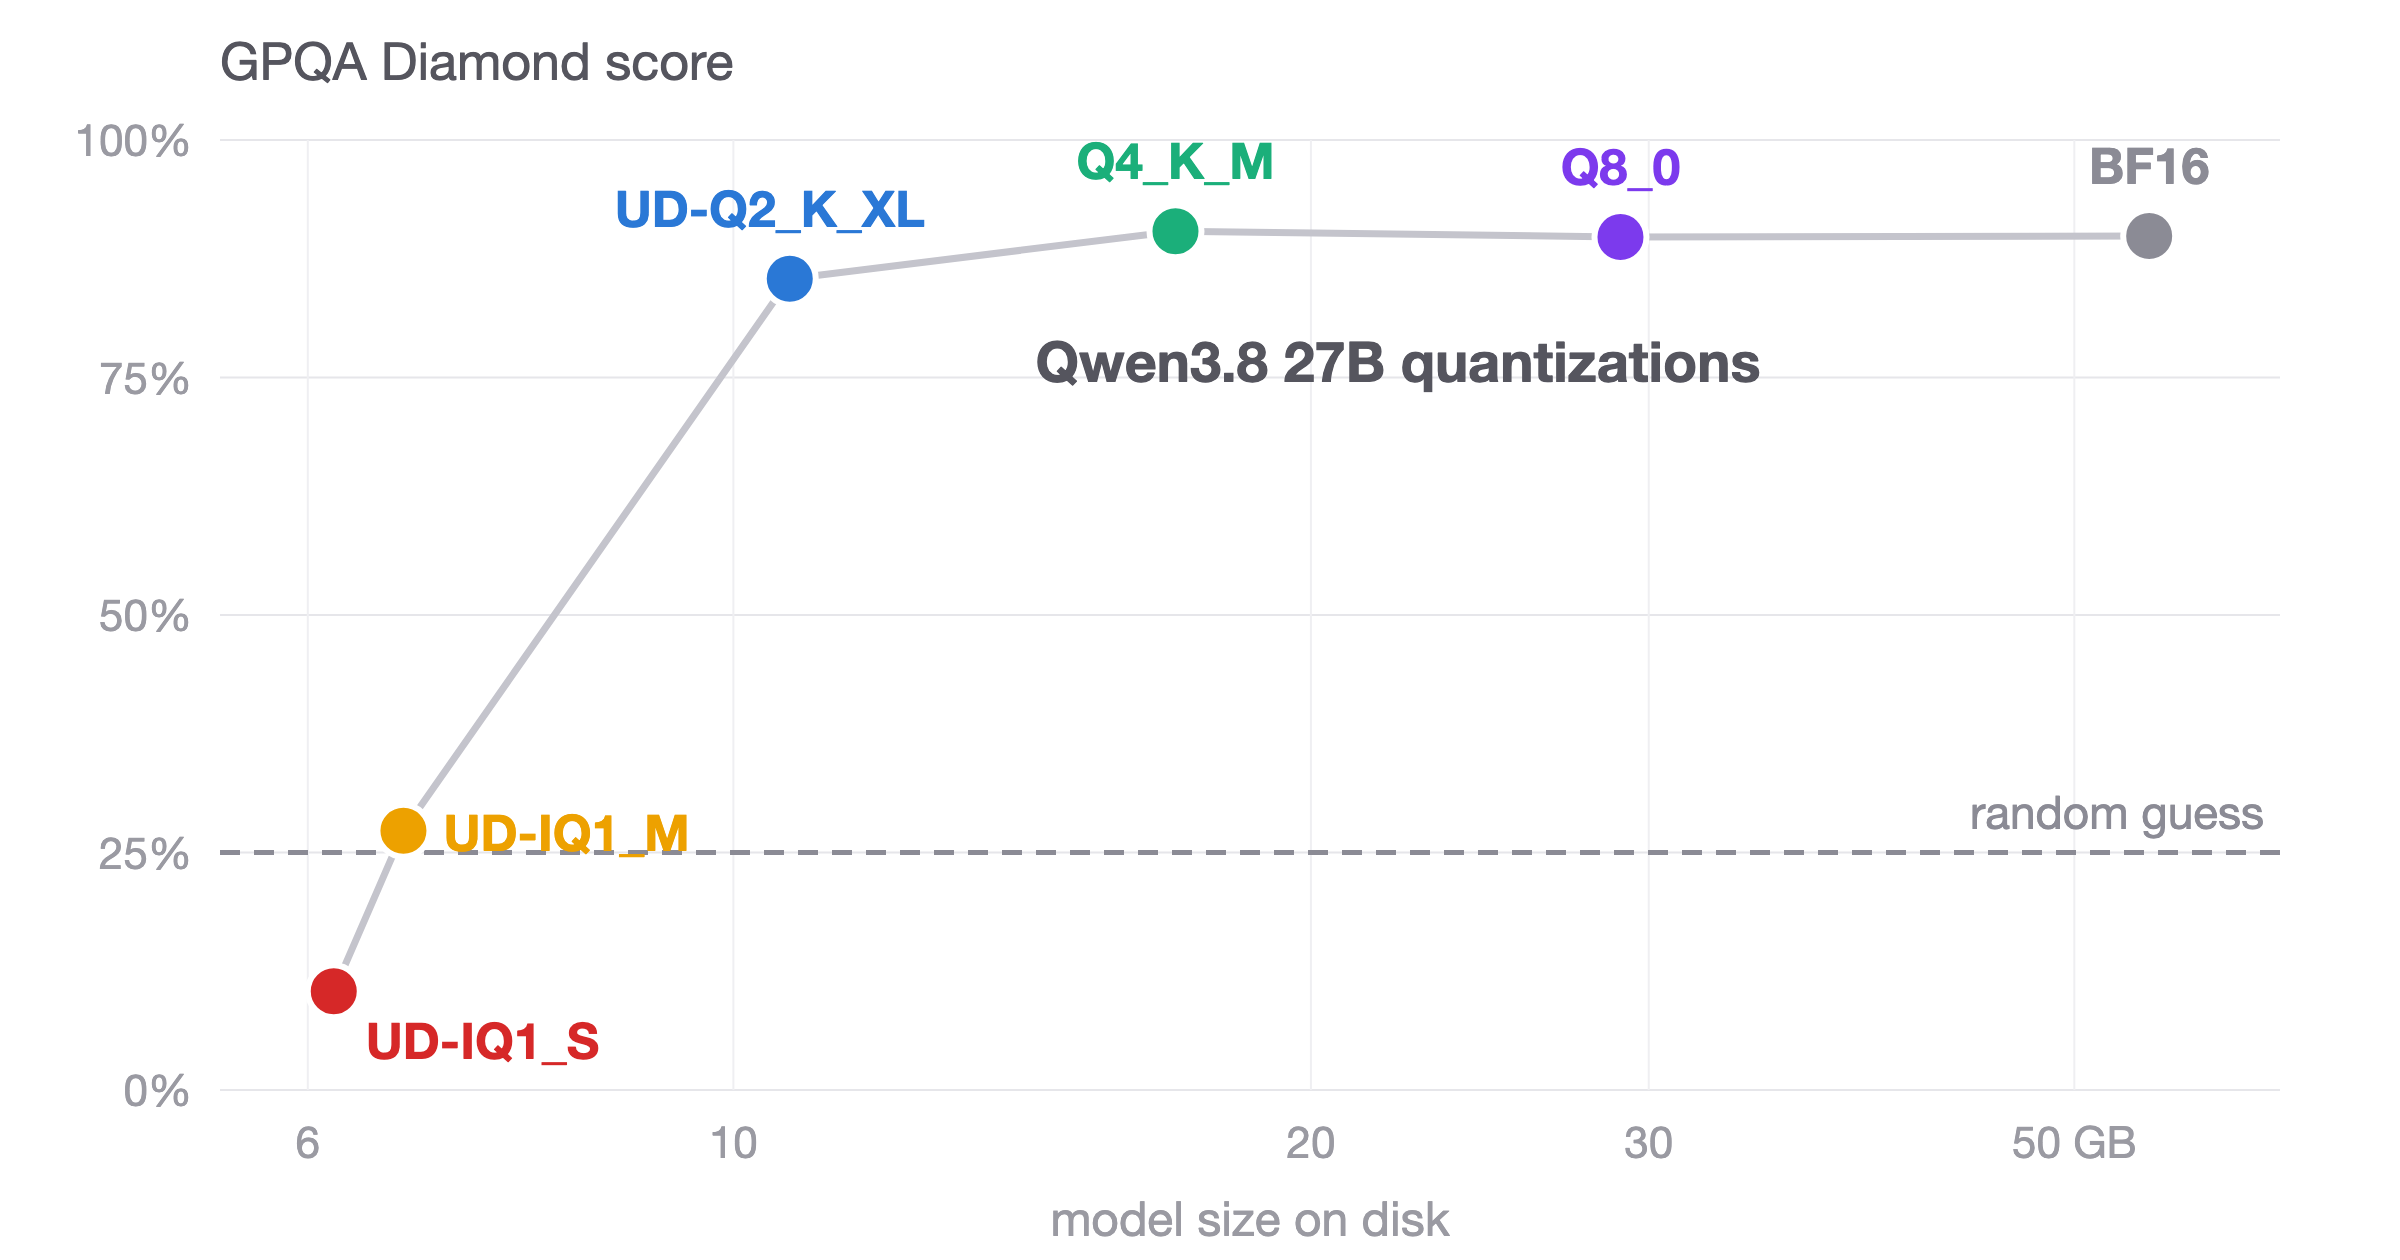
Electron과 Vue.js 기반 GUI 애플리케이션으로 Android 기기를 PC에서 화면 표시 및 제어할 수 있는 scrcpy 래퍼다. 터치, 조이스틱, 스와이프 등 키보드 매핑 설정, 여러 기기 동시 제어, 배치 스크린샷·APK 설치를 한 창에서 지원한다. 무선 ADB 연결, LAN 자동 발견, Gnirehtet 역 테더링으로 네트워크 기기 연결이 가능하다. 전체 요약 5문장 읽기 → 085 08:12 ▲ 218 · 댓글 107 Qwen 3.8 27B, 4비트 양자화까지는 성능 유지 원본 모델 55GB에 비해 4비트 Q4_K_M(17GB)은 Terminal-Bench 2.1 등 주요 벤치마크에서 동일한 성능을 유지한다. AI · 머신러닝 · Benchmarking Qwen3.8 27B quantizations: 4-bit holds up, 1-bit collapses
Key Point 로컬에서 대형 언어 모델을 실행할 때 양자화 정도별로 실제 성능이 어떻게 달라지는지 벤치마크로 확인한 첫 실측 데이터라, 제한된 GPU 메모리 환경에서 모델 선택을 할 때 직접적인 참고 기준이 된다.
핵심 요약
원본 모델 55GB에 비해 4비트 Q4_K_M(17GB)은 Terminal-Bench 2.1 등 주요 벤치마크에서 동일한 성능을 유지한다. RTX 4090(24GB) 같은 소비자 GPU에서도 약 64k 토큰 컨텍스트를 남기며 실행 가능하다. 2비트 양자화는 조금 낮은 성능을 보이지만 10.7GB로 감소하고 실용적 수준을 유지한다. 전체 요약 6문장 읽기 →