매일 쌓이는 개발자의 시야
2026년 10월 26일 (월). 세상의 기술 소식, 한국어로 한눈에.
AI 요약 안내 AI가 한국어로 정리한 내용입니다. 정확한 정보는 각 카드의 원문을 확인해 주세요.
요약 원칙 ↗ 01 읽을 소식Hacker News 7건 ↓ 02 써볼 도구GitHub Trending 4건 ↓ 03 읽을 논문Hugging Face Papers 9건 ↓ 04 새 버전GitHub Releases 0건 ↓ AI · 머신러닝 분야 · 20건 필터 해제 ×
오늘의 주요포인트 상위 6건
01 AI · 머신러닝 21:12 게시
원제 OpenShell – A safe, private runtime for fleets of autonomous AI agents
503 포인트 댓글 218
Key Point AI 에이전트에게 능력을 주면서도 데이터·자격증·네트워크 접근을 제한하는 커널 수준의 격리 방식이 자율 에이전트 배포의 보안 문제를 어떻게 풀고 있는지 보여준다.
핵심 요약
엔비디아가 자율 AI 에이전트 플릿을 위한 안전한 런타임 'OpenShell'의 0.1.0 안정화 버전을 출시했으며, 새로운 격리 기법과 확장 API를 포함하고 있다. OpenShell은 AI 에이전트가 파일 읽기, 패키지 설치, API 호출, 자격증 사용이 필요할 때 정책 선언을 통해 무제한 접근을 제한하면서 이를 가능하게 한다. 커널 수준에서 각 에이전트를 격리된 샌드박스에서 실행하고, 모든 파일 접근, 시스템 콜, 네트워크 연결을 런타임에 정책으로 제어한다. 전체 요약 12문장 읽기 → 02 AI · 머신러닝 06:11 게시
원제 A 10-year-old CNN outperforms frontier LLMs for skin cancer diagnosis
295 포인트 댓글 147
Key Point 이 글은 대규모 언어모델의 의료 진단 능력이 특화된 구형 모델에 미치지 못한다는 구체적인 임상 증거를 보여주며, LLM이 모든 분야에서 기존 방식을 대체할 수 없음을 시사한다.
핵심 요약
2015년 구글이 발표한 Inception v3 CNN을 피부과 이미지로 20분 정도 미세조정한 모델이 GPT-6 Astra와 Claude Fable 5.1 두 최신 LLM을 피부암 진단에서 압도했다. 임상 사진과 피부경 이미지를 포함한 조직검사로 확진된 200개 병변 테스트에서 CNN은 125개(62%)를 올바르게 진단했지만 두 LLM은 각각 84개와 85개(42%)만 정확했다. 테스트 병변은 MILK10k 공개 데이터셋에서 무작위 선정했으며, 진단 불가능 범주 100개(흑색종 30, 기저세포암 25, 편평세포암 25, 광선각화증 20)와 안전 범주 100개(양성모반 50, 지루각화증 50)로 구성됐다. 전체 요약 12문장 읽기 → 03 AI · 머신러닝 12:11 게시
원제 OpenAI and Anthropic cut their LLM prices by up to 80% within a few months. Why?
184 포인트 댓글 209
Key Point OpenAI와 Anthropic이 매출의 대부분을 차지하는 LLM 가격을 6개월간 최대 80%까지 연쇄 인하한 배경에는 DeepSeek 같은 오픈 웨이트 모델의 확산과 인프라 제공자의 경쟁 심화가 있으며, 이는 LLM이 상품화되고 있음을 보여준다.
핵심 요약
지난 6개월간 OpenAI와 Anthropic은 주요 LLM 모델들의 가격을 급격히 인하했다. GPT-5.6 Luna는 7월에 80% 인하, GPT-6 Sol은 9월에 입출력 가격을 50% 반으로 깎았고, Claude Opus 5.5도 전체 사용 비용 기준 40~60% 감소했다. LLM 에이전트 운영 시 캐시 읽기 비용이 전체 토큰 소비의 96~99%를 차지한다. Fable 5.1은 캐시 읽기 비용을 75% 인하하면서 이는 전체 사용 비용 70~75% 감소로 이어졌다. DeepSeek Flash V4는 4월 2026년 출시 이후 매우 저렴한 가격(입력 $0.14, 캐시 읽기 $0.0028)으로 급속도로 확산되었고, OpenRouter에서 29개의 서로 다른 인프라 제공자가 이를 지원하고 있다. 전체 요약 10문장 읽기 → 04 AI · 머신러닝 15:11 게시
원제 The State of Context Engineering
139 포인트 댓글 38
Key Point 에이전트 모델의 장시간 자동 실행이 일반화되면서 컨텍스트 관리 기법 자체가 새로운 버그를 만드는 악순환이 반복되고 있으며, 개발자는 더 이상 프롬프트만 개선해서는 문제를 해결할 수 없게 되었다.
핵심 요약
컨텍스트 엔지니어링은 AI에 올바른 정보를 제시하고 명확한 지시를 전달하는 기술로, 모델의 성능 향상과 무관하게 항상 어려울 것이다. 2024년 말 RAG 폐기 논쟁 당시 모델 제조사들은 컨텍스트 윈도우를 128,000 토큰에서 100만 토큰으로 확대했으나, 더 많은 정보를 담을 수 있게 되면서 더 많은 오류도 함께 들어왔다. 컨텍스트 중독(잘못된 정보 고착), 컨텍스트 분산(장문 컨텍스트에서 모델이 기본 지식 무시), 컨텍스트 혼동(무관한 정보가 모델 판단에 영향), 컨텍스트 충돌(도구 간 갈등) 등 4가지 주요 오류 모드가 발생한다. 전체 요약 11문장 읽기 → 05 AI · 머신러닝 18:11 게시
원제 PaperPilot – Zero-Cloud, Pure-Rust PDF Engine with WASM and MCP
126 포인트 댓글 29
Key Point AI 에이전트에 PDF 처리 기능을 안전하게 통합할 수 있는 방법이 생겼고, 클라우드 전송 없이 로컬에서만 동작해 데이터 프라이버시를 보장한다.
핵심 요약
Rust로 작성된 PDF 및 문서 도구 PaperPilot이 오픈소스로 공개되었다. 클라우드 없이 순수 로컬에서 동작하며 파일이 머신을 떠나지 않는다. Claude Desktop, Cursor 등 MCP 클라이언트에 플러그인으로 제공되어 AI 에이전트가 PDF 병합, 분할, OCR, 압축을 수행할 수 있다. CLI, 브라우저(WASM), Tauri 기반 데스크톱 앱, localhost REST API 등 5가지 인터페이스를 제공한다. 전체 요약 10문장 읽기 → 06 AI · 머신러닝 03:11 게시
원제 Nikon photography contest winner loses title after scientists spot signs of AI
107 포인트 댓글 39
Key Point 과학 논문의 신뢰성과 증거 기반을 중시하는 학계와 대회 운영진들이 AI 생성 이미지 검증 방법을 고민하게 되는 계기이며, 미디어·사진·과학 분야 전반에서 AI 검증 기준 마련의 필요성을 드러내는 사건입니다.
핵심 요약
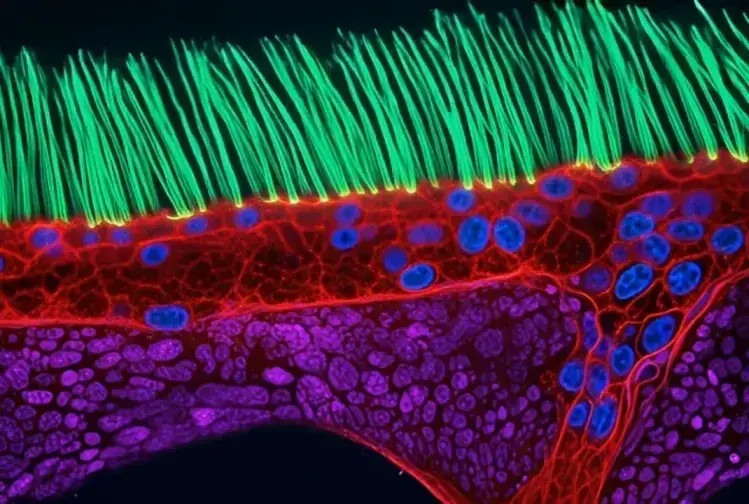
니콘의 16회 'Small World in Motion' 미시 촬영 대회에서 우승한 중국 칭화대 닝쉬 박사의 영상이 AI로 생성되었다는 의혹을 받았다. 영상은 원발성 섬모운동이상증을 가진 어린이의 기도에서 움직이는 미세한 섬모를 촬영한 것으로 제시되었으나, 세포 구조와 크기에 비정상이 있고 섬모가 갑자기 나타났다 사라지는 등 생물학적으로 불가능한 특징이 지적되었다. UT 사우스웨스턴 의료센터 박사과정생 이안 도노번은 원본 이미지에 AI 생성을 나타내는 특정 워터마크가 있다고 밝혔다. 전체 요약 9문장 읽기 → 전체 색인1건 · 분야별
AI · 머신러닝1건 001 18:11 ▲ 102 · 댓글 37 셀프-어텐션 없이 언어모델 성능 낼 수 있을까 논문은 시퀀스 모델링에서 셀프-어텐션이 반드시 필요한지 근본적으로 재검토한다. AI · 머신러닝 · Attention Is Not What You Need (2025)
Key Point 트랜스포머 아키텍처의 핵심인 어텐션 메커니즘 자체를 대체하는 기하학적 모델을 제시하며, 같은 성능을 유지하면서 더 해석 가능한 설계가 가능함을 시사한다.
핵심 요약
논문은 시퀀스 모델링에서 셀프-어텐션이 반드시 필요한지 근본적으로 재검토한다. 기존 멀티헤드 어텐션을 숨은 벡터들을 고차원 공간으로 끌어올리는 텐서 lifting 메커니즘으로 해석하되, 이는 수학적으로 불명확하고 여러 층을 거치면서 명시적 불변량으로 기술하기 어렵다고 주장한다. 대안으로 그래스만 다양체 기반 구조를 제안하며, 인과 그래스만 층은 토큰 상태를 선형 축약한 뒤 플뤼커 좌표로 인코딩된 저차수 부분공간의 제어된 변형을 통해 정보를 전파한다. 전체 요약 6문장 읽기 → 오늘의 주요당일 스타 상위 4건
01 AI · 머신러닝 21:11 게시
HKUDS/DeepTutor
원제 HKUDS/DeepTutor
스타 50,670 당일 +1,930 Python
Key Point 개인화된 AI 학습이 주목받는 시대에 오픈소스 기반의 완전한 튜터링 플랫폼이 공개되어, 교육용 AI 애플리케이션을 직접 구축하려는 개발자와 교육 기관에 실제 활용 가능한 기반을 제공한다.
핵심 요약
홍콩 대학 연구팀이 오픈소스 AI 기반 개인 맞춤형 튜터링 플랫폼 DeepTutor를 개발했다. Python 기반이며 deeptutor.info에서 공식 문서를 제공한다. 에이전트 네이티브 아키텍처로 설계되었으며 도구와 능력 플러그인 모델을 지원한다. 전체 요약 11문장 읽기 → 02 AI · 머신러닝 21:11 게시
google-gemini/gemini-cli
원제 google-gemini/gemini-cli
스타 108,396 당일 +658 TypeScript
Key Point 터미널 기반 AI 에이전트 표준이 형성되고 있는 가운데, Google이 공식 오픈소스 도구로 대응하며 MCP 서버 지원으로 확장성을 열어두고 있다.
핵심 요약
Google이 오픈소스 AI 에이전트 Gemini CLI를 공개했으며, TypeScript로 작성되어 GitHub에서 관리되고 있다. 터미널에서 직접 Gemini 모델에 접근할 수 있으며, 코드 이해·생성, 대형 코드베이스 편집, PDF나 이미지에서 앱 생성 등이 가능하다. 자동화 작업, PR 쿼리, 복잡한 리베이스 처리, MCP 서버 연결로 Imagen·Veo·Lyria 같은 미디어 생성 기능 통합이 지원된다. 전체 요약 9문장 읽기 → 03 AI · 머신러닝 21:11 게시
AstrBotDevs/AstrBot
원제 AstrBotDevs/AstrBot
스타 44,014 당일 +376 Python
Key Point 메신저 기반 AI 에이전트를 자체 운영하거나 통합하려는 개발자와 조직이 구축할 수 있는 완성도 높은 오픈소스 선택지가 생겼다.
핵심 요약
AstrBot은 QQ, 위챗, 텔레그램, 슬랙 등 주요 메신저 플랫폼과 연동되는 오픈소스 AI 에이전트 챗봇 플랫폼이다. OpenAI, Anthropic, Google Gemini, DeepSeek 등 다양한 LLM 서비스와 Dify, 코제 같은 LLMOps 플랫폼을 지원한다. 멀티모달 처리, 에이전트, MCP, 스킬, 나레지 베이스, 페르소나 설정, 자동 컨텍스트 압축 등의 기능을 제공한다. 전체 요약 10문장 읽기 → 04 AI · 머신러닝 21:11 게시
aws/agent-toolkit-for-aws
원제 aws/agent-toolkit-for-aws
스타 3,283 당일 +245 Python
Key Point AWS가 공식 지원하는 AI 에이전트 도구 키트를 공개했으며, Claude Code 등 개발자가 이미 사용 중인 AI 코딩 어시스턴트와 통합되어 에이전트 기반 AWS 개발을 대규모로 가능하게 한다.
핵심 요약
AWS가 AI 코딩 에이전트를 위한 Agent Toolkit for AWS를 공개했으며, Claude Code, Codex, Cursor, Devin, Kiro, fx 등 주요 AI 개발 도구들과 호환된다. 이 도구 키트는 AWS MCP 서버와 에이전트 스킬, 플러그인으로 구성되며, 개발자가 AI 에이전트를 사용해 AWS에서 애플리케이션을 구축·배포·관리하도록 지원한다. aws-core(서비스 선택, CDK/CloudFormation, 서버리스, 컨테이너, 스토리지, 옵저버빌리티, 청구, SDK 사용, 배포), aws-agents(Amazon Bedrock 기반 AI 에이전트 구축), aws-data-analytics(S3 Tables, AWS Glue, Athena를 활용한 데이터 레이크 및 분석 작업), aws-agents-for-devsecops(사건 조사, 코드 리뷰, 취약점 스캔, 침투 테스트), aws-startup-advisor(스타트업 전용 아키텍처 및 마이그레이션 지원) 등 5가지 플러그인을 제공한다. 전체 요약 9문장 읽기 → 읽을 논문
Hugging Face Papers09 커뮤니티가 고른 오늘의 AI 논문
오늘의 주요추천 상위 3건
01 AI · 머신러닝 21:12 게시
원제 Reading, Writing, Sharing, and Interacting with the World through Video
추천 298 댓글 2 Shengqiong Wu, Meng Luo, Bobo Li 외
Key Point 비디오 이해와 생성의 현주소를 통합적으로 정리한 메타 서베이로, 향후 연구의 방향성이 '보이는 것'에서 '일어나는 일'의 타당성으로 전환되고 있음을 보여준다.
핵심 요약
비디오 기초 모델은 시각 시퀀스의 이해와 생성에 급속히 발전해온 반면, 비디오 세계 모델은 그 속 세계의 동역학을 포착하려 한다. 이 논문은 세계 모델링을 통합 렌즈로 삼아 두 분야를 함께 조망한다. 관찰된 비디오를 잠재된 시간적 세계의 부분적·손실적·시간순 투영으로 보고, 네 가지 보완적 작업으로 문헌을 정리한다: reading은 비디오에서 세계 성질을 추론하고, writing은 지정되거나 학습된 세계 조건에서 비디오를 생성하며, sharing은 공통 모델링 메커니즘을 통해 이해와 생성을 통합하고, interacting은 행동과 진화하는 관찰 아래서 세계 상태를 예측하고 업데이트한다. 전체 요약 5문장 읽기 → 02 AI · 머신러닝 12:11 게시
원제 UserArena: Benchmarking Interactive User Simulation for Long-Horizon Shopping Agents
추천 60 댓글 2 Jujia Zhao, Jiakai Tang, Jing Yu 외
Key Point 추천 에이전트 개발을 위한 대규모 실제 데이터 벤치마크와 평가 방법론이 제시되어, 이커머스 AI 시스템의 개발과 검증 방식에 새로운 표준을 제시할 수 있다.
핵심 요약
Hugging Face 연구팀이 추천 에이전트 개발을 위한 새로운 벤치마크인 UserArena를 공개했다. 11,010명의 사용자로부터 수집한 64,729개의 세션 궤적(session trajectory)을 포함하며, 566,102개의 상품과 13가지 액션 타입을 다룬다. 이 벤치마크는 추천 에이전트가 장기간의 사용자 상호작용에서 쇼핑 목표를 달성하는 과정을 평가한다. 전체 요약 8문장 읽기 → 03 AI · 머신러닝 15:11 게시
원제 HiSTEVE 1.0: Harnessing Human-Interface VLA Agents for Open-World Games
추천 55 댓글 4 Zecong Tang, Zian Guan, Yuncheng Guo 외
Key Point 실제 마인크래프트 환경에서 인간 수준의 자율 행동을 보이는 에이전트가 처음 실현되었으며, 이는 게임 AI뿐 아니라 로봇 제어, 업무 자동화 등 복잡한 실제 환경에서의 에이전트 설계 방식을 재정의할 수 있다.
핵심 요약
마인크래프트 같은 개방형 게임에서 인간처럼 행동하는 자율 에이전트를 만들기 위해 장기적 계획과 네이티브 인터페이스 조작을 모두 필요로 한다. HiSTEVE는 계층적 VLA 에이전트로, 상위 수준의 조율 계층과 하위 수준의 제어 계층으로 구성되어 있다. 조율 계층은 구조화된 메모리로 진행상황을 추적하고 VLM 플래너로 수행 가능한 부작업을 선택하며, 정책 기반 작업 완료 감지기로 부작업 완료 여부를 판단한다. 전체 요약 7문장 읽기 → 전체 색인6건 · 분야별
AI · 머신러닝6건 001 21:12 ▲ 28 · 댓글 2 비디오 언어 모델로 e스포츠 실시간 연출과 해설 자동화 e스포츠 실시간 방송은 초 단위로 어느 카메라를 송출할지 결정하고 해설하는 연출자와 해설자가 필요하며, 미래를 알 수 없는 상황에서 진행된다. AI · 머신러닝 · DirCast: Live Esports Directing and Commentary with a Single Streaming Video-Language Model
Key Point 실시간 영상 생성 능력을 갖춘 대규모 언어 모델이 단순 해석을 넘어 실시간 의사결정(카메라 선택)이 필요한 프로덕션 수준의 작업을 수행할 수 있다는 점을 실증한 첫 사례입니다.
핵심 요약
e스포츠 실시간 방송은 초 단위로 어느 카메라를 송출할지 결정하고 해설하는 연출자와 해설자가 필요하며, 미래를 알 수 없는 상황에서 진행된다. 기존 스트리밍 비디오 언어 모델은 인간 연출자가 이미 제작한 방송을 보고 해설만 했으나, 이 논문은 모든 선수 카메라의 원본 영상을 받아 직접 연출과 해설을 동시에 수행하는 라이브 방송 제작을 다룬다. DirCast는 매초 모든 카메라를 저해상도로 스캔하고, 홀드-또는-스위치 연출자로 컷 여부와 위치를 결정한 뒤, 선택된 카메라를 고해상도로 읽고 해설을 생성한다. 전체 요약 7문장 읽기 → 002 21:12 ▲ 23 · 댓글 2 신경망 가중치를 이산 결정 경로로 표현하는 TWIG 제안 신경망의 모든 가중치를 트리 구조의 작은 이산 결정(부호, 2의 거듭제곱 시프트, 게이트, 테이블 인덱스)의 경로 끝으로 표현하는 TWIG(Tree-structured Weights with Inherited Gates)를 제안했다. AI · 머신러닝 · Every Weight Is a Path of Shared Discrete Decisions
Key Point 신경망 가중치 압축 방식을 통합하는 새로운 표현이 기존 양자화 방법보다 회로 비용을 크게 줄일 수 있음을 보여주기 때문이다.
핵심 요약
신경망의 모든 가중치를 트리 구조의 작은 이산 결정(부호, 2의 거듭제곱 시프트, 게이트, 테이블 인덱스)의 경로 끝으로 표현하는 TWIG(Tree-structured Weights with Inherited Gates)를 제안했다. 같은 영역에 속한 가중치들은 경로의 상위 부분을 공유하며, 각 결정은 트리 아래의 모든 가중치에 상속되어 한 번만 저장하고 적용된다. 임의의 학습된 신경망을 TWIG로 표현할 수 있으며, 2의 거듭제곱 결정을 사용할 때 가중치 계층이 거의 모두 선(wire)과 가산기로 이루어진 회로가 되어 고정 가중치 칩에 적합하다. 전체 요약 7문장 읽기 → 003 18:11 ▲ 34 · 댓글 2 세계 모델과 멀티모달 에이전트 분리 평가 프레임워크 공개 World Model(WM)이 시뮬레이션된 경험으로 Multimodal Agent(MA)를 지원하고, 에이전트 궤적이 WM 개선에 기여하는 상호작용을 평가하기 위해 액션 선택과 상태 진화에 대한 별도의 증거가 필요하다. AI · 머신러닝 · Dual Exam: Controlled Evaluation of Multimodal Agents and World Models
Key Point 멀티모달 에이전트와 세계 모델의 상호작용을 처음 체계적으로 분리 평가하는 프레임워크로, 현재 AI 시스템들이 실제 협력에서 왜 실패하는지 진단할 수 있는 벤치마크를 제공한다.
핵심 요약
World Model(WM)이 시뮬레이션된 경험으로 Multimodal Agent(MA)를 지원하고, 에이전트 궤적이 WM 개선에 기여하는 상호작용을 평가하기 위해 액션 선택과 상태 진화에 대한 별도의 증거가 필요하다. Dual Exam은 고정된 환경 응답 메커니즘 하에서 에이전트를, 고정된 액션 개입 하에서 WM을 테스트하며, 물리·디지털·사회·과학 도메인을 다룬다. 에이전트 트랙은 10개 구성으로 1,088개 항목을 15개 보고 카테고리로 평가하고, WM 트랙은 8개 시나리오에서 400개 케이스를 포함한다. 전체 요약 8문장 읽기 → 004 15:11 ▲ 54 · 댓글 2 RynnUnify: 로봇 제어까지 아우르는 통합 embodied AI 모델 RynnUnify는 영상-언어 추론을 통해 embodied 이해와 장기 시각 계획을 결합한 160억 파라미터 통합 모델이다. AI · 머신러닝 · RynnUnify: Towards Unified Embodied Brain
Key Point 물리 세계 이해부터 실제 로봇 제어까지 하나의 모델으로 통합하려는 시도로, embodied AI 연구의 새로운 기준을 제시한다.
핵심 요약
RynnUnify는 영상-언어 추론을 통해 embodied 이해와 장기 시각 계획을 결합한 160억 파라미터 통합 모델이다. 공간 추론, 물리 예측, 그라운딩 능력으로 물리 세계에 대한 이해와 변화 예측을 연결한다. 강화학습으로 에이전트 확장 버전을 개발했으며, 관찰되지 않은 상태와 상호작용 결과 추론을 위해 영상 예측을 선택적으로 활용한다. 전체 요약 8문장 읽기 → 005 15:11 ▲ 46 · 댓글 2 프롬프트 진화 알고리즘 비교하는 오픈소스 프레임워크 RSIHub AI 에이전트의 프롬프트, 스킬, 도구, 오케스트레이션을 실행 피드백으로 개선하는 Agent-evolution methods 연구가 늘고 있으나, 각 논문이 비슷한 실험 환경을 반복해서 구축해야 하는 문제가 있다. AI · 머신러닝 · RSIHub: A Composable Framework for Agent-Evolution Methods
Key Point Agent-evolution 연구자들이 각자 실험 환경을 처음부터 짜는 낭비를 없애고 방법 간 공정한 비교를 할 수 있는 표준 프레임워크가 등장했기 때문이다.
핵심 요약
AI 에이전트의 프롬프트, 스킬, 도구, 오케스트레이션을 실행 피드백으로 개선하는 Agent-evolution methods 연구가 늘고 있으나, 각 논문이 비슷한 실험 환경을 반복해서 구축해야 하는 문제가 있다. 이를 해결하기 위해 RSIHub라는 오픈소스 프레임워크를 개발했으며, 재사용 가능한 연산자와 변경 가능한 리소스를 조합한 레시피를 작성하면 실행·평가·복구·계보 추적을 자동으로 처리한다. AHE, Hyperagents, A-Evolve, GEPA 등 4가지 기존 방법을 RSIHub 핵심 코드 수정 없이 구현했으며, 각 방법의 특정 로직은 레시피와 연산자에만 담긴다. 전체 요약 6문장 읽기 → 006 15:11 ▲ 37 · 댓글 2 음성·영상 추론 AI의 환각 현상, 증거 우선순위 재조정으로 해결 멀티모달 추론이 가능한 최신 대형언어모델(OLLM)이 음성과 영상을 함께 처리할 때 교차모달 환각이 발생하는 문제가 있다. AI · 머신러닝 · Omni-Woodpecker: Hallucination Correction via Evidence-Prior Rebalancing for Omni LLMs
Key Point 음성과 영상을 동시에 처리하는 멀티모달 AI 모델의 성능 문제를 추론 단계에서 해결하는 새로운 방법이 다양한 모델에서 검증되었기 때문이다.
핵심 요약
멀티모달 추론이 가능한 최신 대형언어모델(OLLM)이 음성과 영상을 함께 처리할 때 교차모달 환각이 발생하는 문제가 있다. 기존 방법들은 출력 단계에서만 처리하며 융합 표현 내의 근거 증거와 학습된 사전지식의 얽힘을 간과했다. Omni-Woodpecker(OWP)라는 훈련 불필요 프레임워크는 교차모달 충돌을 식별한 후 숨겨진 상태에서 증거와 경쟁하는 사전지식을 분리한다. 전체 요약 7문장 읽기 → ● 이번 피드는 여기까지입니다.
작은 발견을 다음 커밋으로 이어가세요. 모든 발행본