매일 쌓이는 개발자의 시야
2026년 10월 27일 (화). 세상의 기술 소식, 한국어로 한눈에.
AI 요약 안내 AI가 한국어로 정리한 내용입니다. 정확한 정보는 각 카드의 원문을 확인해 주세요.
요약 원칙 ↗ 01 읽을 소식Hacker News 8건 ↓ 02 써볼 도구GitHub Trending 6건 ↓ 03 읽을 논문Hugging Face Papers 27건 ↓ 04 새 버전GitHub Releases 3건 ↓ AI · 머신러닝 분야 · 44건 필터 해제 ×
오늘의 주요포인트 상위 6건
01 AI · 머신러닝 03:12 게시
원제 Sebastian Raschka's from-scratch video course on building reasoning models
296 포인트 댓글 38
Key Point 추론 모델 구현의 핵심 기법들(강화학습, 추론 시점 스케일링, 증류)을 직접 코딩하면서 배울 수 있는 완전한 실습 자료가 공개되어, LLM 개발자가 최신 추론 기술의 동작 원리를 깊이 있게 이해할 수 있다.
핵심 요약
Sebastian Raschka가 8개 비디오, 11시간 분량의 추론 모델 구현 강의를 공개했다. Python과 PyTorch로 평가, 추론 시점 스케일링, 강화학습, 증류를 처음부터 끝까지 구현한다. 사전학습된 Qwen 0.6B 모델을 출발점으로, KV 캐싱, 다양한 텍스트 생성, 답 검증기 구축 등을 단계별로 다룬다. 전체 요약 8문장 읽기 → 02 AI · 머신러닝 21:11 게시
원제 The Mythical Man-Month in the Age of AI
219 포인트 댓글 156
Key Point AI 에이전트가 개발 생산성의 모든 문제를 해결할 것 같지만, 실제로는 인력 관리의 오버헤드가 에이전트 관리로 형태만 바뀌며 브룩스 법칙의 본질이 유효함을 보여준다.
핵심 요약
프레더릭 브룩스 주니어가 1975년 저서 《신화적 인월》에서 주장한 '많은 인력을 늦은 프로젝트에 투입할수록 더 늦어진다'는 브룩스 법칙이 AI 에이전트 시대에도 여전히 적용되는지 검토한다. 전통적으로 소프트웨어 개발의 병목이던 온보딩 시간, 미팅, 조직 정치 같은 문제는 AI 에이전트를 사용하면 사라지는 것처럼 보인다. 하지만 핵심 문제는 여전히 존재한다: 9명의 에이전트도 1개월 안에 아기를 낳을 수 없듯이, 순차적 작업은 여전히 순차적이다. 전체 요약 7문장 읽기 → 03 AI · 머신러닝 06:11 게시
원제 ChatGPT Keeps Telling People 404 Media Can Solve Their Tech Support Problems
170 포인트 댓글 55
Key Point 고객 지원이 거의 없는 빅테크 서비스 이용자들이 AI 챗봇의 부정확한 권고로 언론사에 수백 건의 관련 없는 문의를 보내고 있으며, 이는 ChatGPT의 훈련 데이터나 시스템 프롬프트에 문제가 있을 가능성을 보여준다.
핵심 요약
빅테크 기업들이 고객 지원을 거의 제공하지 않자 기술 문제가 있는 사람들이 ChatGPT에 자주 묻기 시작했다. ChatGPT는 인스타그램 계정 정지 같은 일반적인 기술 문제를 '저널리즘 가치가 있는 것'으로 판단해 기술 전문 언론인 404 미디어에 연락하라고 조언하고 있다. 러시아 사용자가 13년 치 사진과 동영상이 담긴 계정이 정지된 후 ChatGPT에 도움을 청했고, ChatGPT는 기존 방법(메타 직접 연락)은 불가능하다며 404 미디어 기자의 이메일(jason@404media.co)을 제시했다. 전체 요약 7문장 읽기 → 04 AI · 머신러닝 21:11 게시
원제 Roblox downloaded 145GB models from us (including adult content) without asking
139 포인트 댓글 102
Key Point 대형 AI 기업이 무단으로 수집한 데이터가 AI 학습에 어떻게 악용되는지, 그리고 개인과 대기업을 차별하는 저작권 집행의 불평등 문제를 구체적 사례로 보여주기 때문입니다.
핵심 요약
로블록스 소속으로 보이는 크롤러가 10월 15~16일 Open3DLab, SFMLab, SmutBase 세 사이트에서 712개 프로젝트의 1,027개 파일 145.5GB를 동의 없이 다운로드했다. 크롤러는 'trellis2-data-sourcing/1.0'이라는 사용자 에이전트를 사용해 34시간에 걸쳐 18,926개 프로젝트의 메인 페이지를 읽었고, robots.txt를 무시하고 약관 위반 및 저작권 침해를 범했다. 다운로드 대상의 62.6%인 345개 프로젝트가 성인 콘텐츠였으며, 이 중 423개는 비상업적 이용만 가능한 라이선스였다. 전체 요약 13문장 읽기 → 05 AI · 머신러닝 03:12 게시
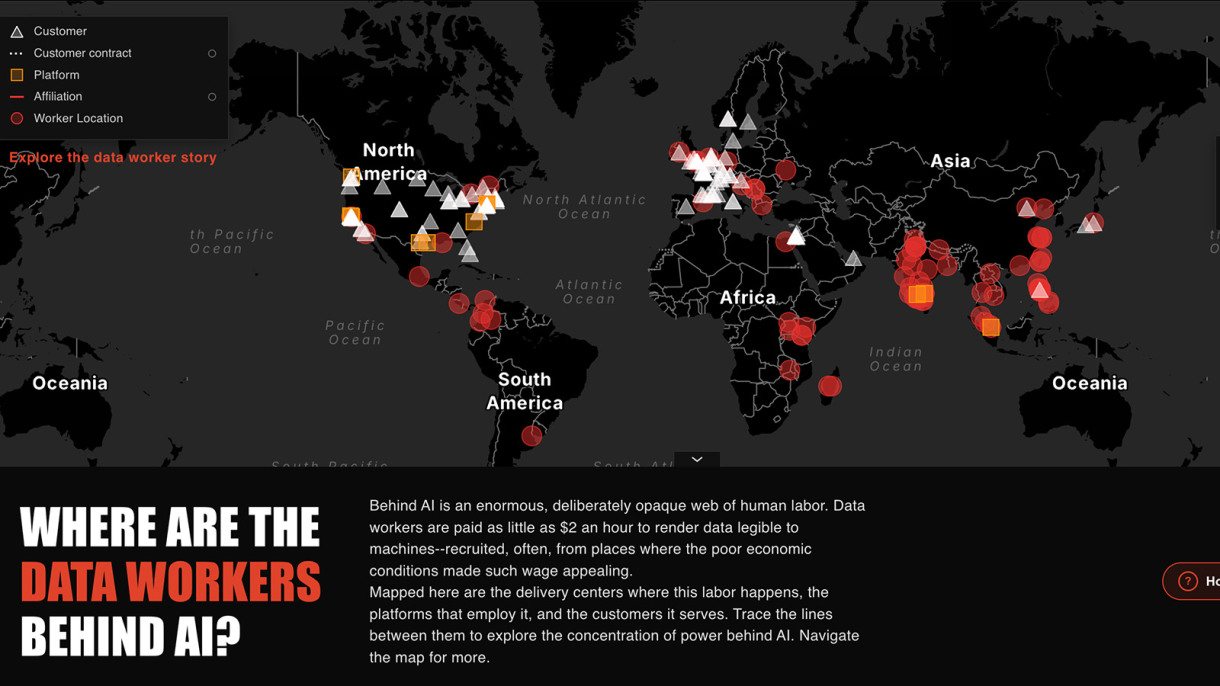
원제 Brown student maps the hidden global labor powering AI
130 포인트 댓글 106
Key Point 전 세계의 불가시화된 저임금 노동에 의존한 AI의 현실과 대규모 데이터 노동 공급망의 지형을 처음으로 가시화한 시도이기 때문입니다.
핵심 요약
브라운대학 학부생 쿤연 마가 AI 회사들과 전 세계 데이터 노동자들의 연결 관계를 시각화한 대화형 지도를 공개했다. 지도는 기존 데이터 노동자 데이터베이스, 마의 자체 조사, 그리고 노동 조건을 다룬 뉴스 기사들을 통합한 것이다. AI 모델 훈련을 위해 인간 노동자들은 사진 라벨링, 음성 전사, 챗봇 응답 평가, 의료 스캔 분석 등 다양한 작업을 수행한다. 전체 요약 6문장 읽기 → 06 AI · 머신러닝 12:11 게시
원제 Show HN: Hob - Open-source, on device alternative to Claude Cowork and ChatGPT
125 포인트 댓글 30
Key Point 로컬 머신에서 완전히 프라이빗하게 LLM을 쓸 수 있는 크로스플랫폼 오픈소스 도구로, 개인정보 보호를 중요시하거나 API 의존성을 줄이고 싶은 개발자에게 유용한 선택지이다.
핵심 요약
Frigade가 개발한 Hob은 개인 컴퓨터에서 AI를 쓸 수 있는 무료 오픈소스 데스크톱 애플리케이션이다. Claude와 ChatGPT의 대체 프로그램으로, Gemma, GPT-OSS 같은 오픈 가중치 모델을 로컬에서 실행한다. Mac, Windows, Linux를 지원하며, 사용자의 컴퓨터에 맞는 최고 수준의 최신 모델을 자동으로 선택해 설정해준다. 전체 요약 6문장 읽기 → 전체 색인2건 · 분야별
AI · 머신러닝2건 001 09:11 ▲ 101 · 댓글 56 추상화의 천재 폰노이만, 20세기를 설계하다 1903년 헝가리 태생 수학자 존 폰노이만(1903-1957, 53세)은 집합론, 양자역학 수학적 기초, 게임 이론, 최초의 저장형 프로그램 컴퓨터 구조, 수치 기상 예보, 자기복제 오토마타 등 근 20개 분야를 개척했고, 모든 현대 컴퓨터는 그가 1945년 설계한 폰노이만 구조(명령어와 데이터를 한 메모리에 저장)를 따른다. AI · 머신러닝 · A Man from the Future: Why Johnny Can't Stop Abstracting
Key Point 추상화를 통해 20세기 과학과 컴퓨팅을 동시에 건설한 폰노이만의 사고 방식이 오늘날 AI·기후·핵 위협을 마주한 우리에게 무엇을 말하는지 보여주기 때문이다.
핵심 요약
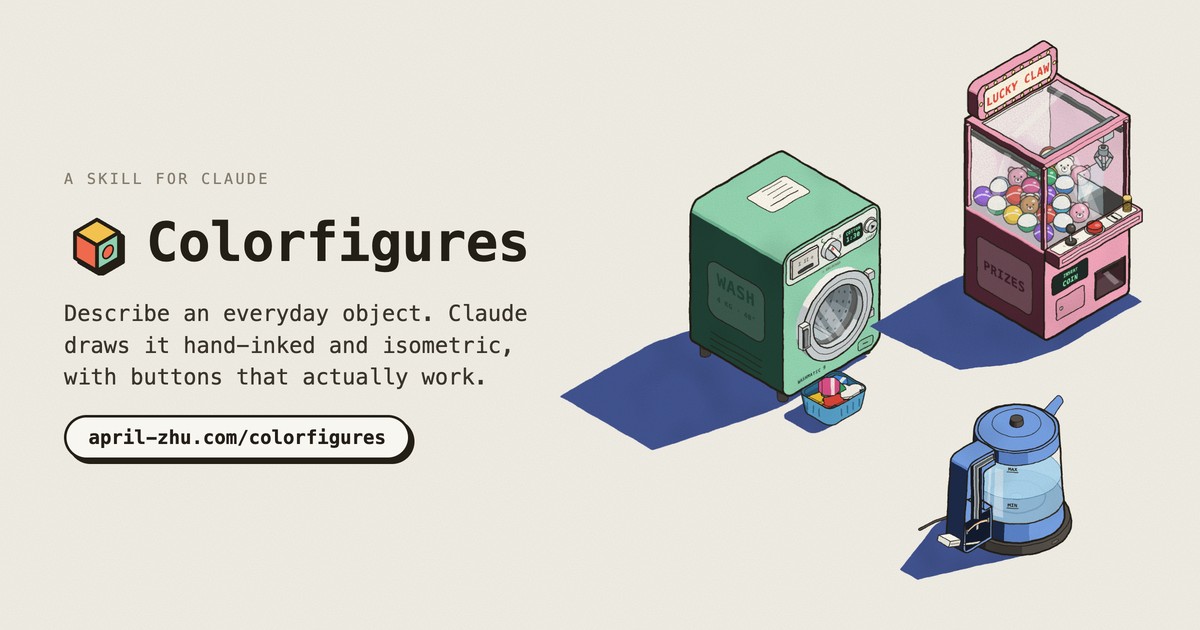
1903년 헝가리 태생 수학자 존 폰노이만(1903-1957, 53세)은 집합론, 양자역학 수학적 기초, 게임 이론, 최초의 저장형 프로그램 컴퓨터 구조, 수치 기상 예보, 자기복제 오토마타 등 근 20개 분야를 개척했고, 모든 현대 컴퓨터는 그가 1945년 설계한 폰노이만 구조(명령어와 데이터를 한 메모리에 저장)를 따른다. 6세에 8자리 수를 암산으로 나누고 고대 그리스어로 대화했으며, 한 번 읽은 책은 모두 기억했다는 평판이 있었다. 아버지 막시는 저녁 식탁을 세미나처럼 운영해 가족이 철학·역사·정치 등 폭넓은 주제를 토론하게 했고, 여러 언어 능력은 미래 망명을 대비한 아버지의 의도였다. 헝가리 고등학교 수학 교사 라슬로 라츠는 그를 가르칠 수 없다고 판단해 스탠포드 수학과장이 될 가보르 세게를 개인교사로 붙였다. 세게는 첫 수업 후 울면서 학생의 능력에 압도당했다고 전했다. 전체 요약 14문장 읽기 → 002 06:11 ▲ 119 · 댓글 17 AI가 손그린 입체 기계 그리기, Colorfigures Colorfigures는 AI가 일상 사물을 손그린 입체 그림으로 변환하는 스킬로, 버튼 등 부품들이 실제로 작동하고 회전하며 볼 수 있습니다. AI · 머신러닝 · Colorfigures
Key Point AI 스킬로 기술 설명서나 마케팅 자료의 복잡한 기계를 인터랙티브한 3D 시각 자료로 만들 수 있게 되면서, 개발자와 제품팀의 작업 흐름이 크게 달라질 수 있습니다.
핵심 요약
Colorfigures는 AI가 일상 사물을 손그린 입체 그림으로 변환하는 스킬로, 버튼 등 부품들이 실제로 작동하고 회전하며 볼 수 있습니다. Claude Code에 터미널 명령어를 붙여 설치하거나, Claude.ai·ChatGPT·Gemini의 스킬 업로드 기능으로 설치할 수 있으며, 설치 후 객체를 자연어로 설명하면 HTML 파일로 생성됩니다. 생성된 그림은 360도 회전 가능하며, 기계 내부의 작동 방식을 투명 모드로 볼 수 있고 각 부품이 라벨로 표시되어 작동할 때 함께 움직입니다. 전체 요약 10문장 읽기 → 오늘의 주요당일 스타 상위 4건
01 AI · 머신러닝 21:12 게시
JetBrains/thinkrail
원제 JetBrains/thinkrail
스타 6,163 당일 +1,117 TypeScript
Key Point AI 에이전트가 프로젝트 지식을 누적하면서 성장하는 IDE 환경이 실제 개발 워크플로우에 어떻게 통합되는지, 그리고 기존 JetBrains IDE와 다른 경량화된 접근 방식의 설계 철학을 보여준다.
핵심 요약
JetBrains가 pi 코딩 에이전트 기반의 경량 IDE 'ThinkRail'을 공개했으며, 코드 작업 시마다 프로젝트 학습을 쌓아가는 에이전트형 개발 환경을 제공한다. Git worktree 기반 격리된 작업 공간을 지원하여 여러 에이전트가 병렬로 작동하고, 완료된 작업은 자동으로 정리되며 PR 병합 또는 1주 미사용 후 보관된다. Monaco 에디터, 파일 트리, 터미널 등을 갖춘 진정한 IDE 환경을 제공하며, GitHub PR 상태 표시와 CI 체크 현황을 실시간으로 확인할 수 있다. 전체 요약 14문장 읽기 → 02 AI · 머신러닝 03:12 게시
nightly-labs/openbot
원제 nightly-labs/openbot
스타 4,008 당일 +709 TypeScript
Key Point 여러 AI 에이전트를 하나의 데스크톱 앱에서 관리·협업시킬 수 있는 새로운 워크플로우가 가능해진다.
핵심 요약
OpenBot은 로컬 우선 데스크톱 워크스페이스로, Codex, Claude, Grok, Cursor, Cline, Gemini, OpenCode 등 여러 AI 에이전트를 한곳에서 운영할 수 있다. 각 에이전트가 독립적인 워크스페이스와 대화 히스토리를 가지며, 로컬 메시지 큐, 파일 전송, 임베딩 브라우저, 에이전트 간 메시징을 제공한다. 개발 미리보기 단계이며 에이전트들이 기본적으로 무제한 접근 권한으로 실행되므로 신뢰할 수 있는 작업만 실행해야 한다. 전체 요약 10문장 읽기 → 03 AI · 머신러닝 21:12 게시
higgsfield-ai/skills
원제 higgsfield-ai/skills
스타 1,713 당일 +226 Python
Key Point AI 코딩 에이전트 위에서 직접 작동하는 이미지·영상·웹사이트 생성 스킬이 한데 모였으므로, 개발자가 프롬프트만으로 마케팅 자산부터 풀스택 사이트까지 만들 수 있게 되었다.
핵심 요약
Higgsfield AI가 Claude Code, Cursor 등 AI 코딩 에이전트에서 사용할 수 있는 Markdown 기반 스킬 모음을 공개했다. 주요 기능은 `higgsfield-generate`로 이미지, 영상, 3D, 오디오를 30개 이상의 모델(Flux 2, Veo 3.1, Kling 3.0, Seedance 2.5 등)로 생성할 수 있으며, 마케팅 스튜디오는 브랜드된 광고 영상을 아바타와 상품으로 만들고 Virality Predictor로 점수를 매긴다. `higgsfield-soul-id`는 5~20장 사진으로 얼굴을 학습해 재사용 가능한 아이덴티티 모델을 만들고, `higgsfield-product-photoshoot`은 10가지 모드(스튜디오, 라이프스타일, Pinterest, 광고팩 등)로 상품 사진을 생성한다. 전체 요약 7문장 읽기 → 04 AI · 머신러닝 21:12 게시
microsoft/skill-recorder
원제 microsoft/skill-recorder
스타 5,262 당일 +203 TypeScript
Key Point 한 번의 화면 기록으로 AI 에이전트가 반복 실행할 수 있는 자동화 스킬을 만들 수 있으므로, 반복되는 업무 자동화 방식이 크게 단순화된다.
핵심 요약
마이크로소프트가 Skill Recorder를 공개했다. 이는 화면 작업을 녹화한 뒤 GitHub Copilot SDK로 분석해 AI 에이전트가 재실행할 수 있는 스킬이나 자동화로 변환하는 데스크톱 앱이다. 앱은 마우스 클릭, 창 전환, 방문 페이지, 터미널 명령, 음성 해설을 녹화한다. 분석 시 녹화 데이터를 GitHub 클라우드로 전송해 Copilot이 작업 의도와 순서대로 정렬한 단계 목록으로 재구성한다. 생성된 스킬은 SKILL.md 파일 형태로, 에이전트가 UI 클릭 재현 대신 gh CLI나 web_fetch 같은 네이티브 도구를 선호하도록 일반화된다. 한 번 실행한 작업으로 다양한 유사 작업을 처리할 수 있다. 전체 요약 11문장 읽기 → 전체 색인2건 · 분야별
AI · 머신러닝2건 001 21:12 당일 +109 DeepSeek 활용을 IM에 접목, 9개 채널 일괄 지원 dsh-im은 QR코드나 봇 자격증명으로 DeepSeek Harness를 飞书·微信·钉钉·企业微信·QQ·Slack·Telegram·Discord·WhatsApp 9개 메신저에 연결하는 플러그인이다. AI · 머신러닝 · xmanrui/dsh-im · JavaScript
Key Point DeepSeek 가중치가 높아지면서 대형 LLM을 9개 주요 메신저에 한 번에 연결할 수 있는 통합 솔루션이 생겨, 기업 메시징 환경에서 AI 활용 폭이 크게 넓어진다.
핵심 요약
dsh-im은 QR코드나 봇 자격증명으로 DeepSeek Harness를 飞书·微信·钉钉·企业微信·QQ·Slack·Telegram·Discord·WhatsApp 9개 메신저에 연결하는 플러그인이다. 각 채널별로 독립된 메신저 봇을 여러 개 추가할 수 있으며, 각 봇마다 연결 상태·작업 공간·모델·세션이 따로 관리된다. 飞书·微信·钉钉·企业微信·QQ·Slack·Telegram·Discord·WhatsApp는 스트리밍 또는 메시지 편집으로 사고 과정과 생성 결과를 실시간 표시하고, 음성 입출력·이미지 분석·파일 회전송을 지원한다. 전체 요약 12문장 읽기 → 002 21:12 당일 +107 InkOS 2.0, 소설·각본·인터랙티브 창작 에이전트 InkOS는 장편·단편 소설, 각본, 스토리보드, 인터랙티브 게임, IP 콘텐츠, 다국어 번역을 한 작업대에서 다루는 스토리 창작 AI 에이전트 시스템이며 Studio, TUI, CLI 인터페이스를 지원한다. AI · 머신러닝 · Narcooo/inkos · TypeScript
Key Point 장편 소설의 설정·복선 일관성 문제를 상태 검증과 원자적 저장으로 다루는 창작 에이전트 구조를 볼 수 있다.
핵심 요약
InkOS는 장편·단편 소설, 각본, 스토리보드, 인터랙티브 게임, IP 콘텐츠, 다국어 번역을 한 작업대에서 다루는 스토리 창작 AI 에이전트 시스템이며 Studio, TUI, CLI 인터페이스를 지원한다. v2.0.0은 pi-agent 기반의 단일 프로덕션 하니스로 통합됐다. 모델은 이해와 제안, 호출을 맡고 InkOS는 확인, 컨텍스트, 상태, 원자적 저장을 맡는다. 1.x 프로젝트는 `inkos work migrate --json`으로 점검하고 `--apply`로 통합 창작 라이브러리에 가져온다. 원본 디렉터리와 백업은 유지되며 충돌 시 기존 작품을 덮어쓰지 않는다. 전체 요약 11문장 읽기 → 읽을 논문
Hugging Face Papers27 커뮤니티가 고른 오늘의 AI 논문
오늘의 주요추천 상위 3건
01 AI · 머신러닝 12:11 게시
원제 Trajectory2Gym: Decision-Grounded Compositional Interaction Synthesis for Tool-Use Agents
추천 359 댓글 3 Yihao Hu, Zhihao Wen, Yitong Lin 외
Key Point 기존에 성공한 상호작용만 학습 데이터로 사용하는 방식의 근본적 문제를 제시하고, 다단계 의존성과 결정 근거를 모두 만족하는 상호작용을 설계하는 방법을 제안하여 에이전트의 학습 효율을 크게 개선한다.
핵심 요약
도구 사용 에이전트 학습에서 성공한 상호작용 궤적도 여러 단계의 의존성을 놓치거나 에이전트가 실제로 볼 수 없는 정보를 바탕으로 한 행동을 포함할 수 있다. 효과적인 궤적 감독을 위해서는 중요한 관찰-행동 의존성이 모두 표현되는 구성 커버리지와 각 행동이 에이전트의 학습 가능한 상호작용 이력으로 정당화되는 결정 기반이라는 두 가지 조건이 필요하다. Trajectory2Gym은 지원이 부족한 구성 구조 주변에 실행 가능한 상호작용을 구성하고, 실제 실행에서 정당화된 결정들만을 감독 신호로 사용한다. 전체 요약 8문장 읽기 → 02 AI · 머신러닝 12:11 게시
원제 Trial by Trace: Benchmarking AI Agent Harnesses for Reliability and Failure Attribution
추천 283 댓글 6 Zhiyong Cao, Hengjie Zhu, Yongxin Wang 외
Key Point LLM 에이전트 개발 시 모델 선택만으로는 부족하며, 실제 운영 환경의 하네스 설계가 신뢰성에 얼마나 큰 영향을 미치는지 처음으로 정량적으로 드러냈다.
핵심 요약
LLM 기반 AI 에이전트의 신뢰성을 평가하는 새로운 벤치마크 TraceTrial-Bench를 제시했다. 기존 벤치마크는 모델 성능 중심이었으나, 이 연구는 에이전트를 지탱하는 하네스(harness) 신뢰성에 초점을 맞췄다. 하네스 신뢰성을 컨텍스트, 실행, 거버넌스, 라이프사이클, 관찰성, 도구, 검증 7가지 요소로 분류했다. 전체 요약 10문장 읽기 → 03 AI · 머신러닝 12:11 게시
원제 StreamVibe: Proactive Video Agents for Evolving User Intent
추천 253 댓글 2 Chengzhi Liu, Yuxiang Lai, Yuzhe Yang 외
Key Point 비디오 에이전트가 사용자가 명시적으로 말하지 않은 의도까지 예측해 선제적으로 대응할 수 있게 되는 것은 웹 네비게이션, 콘텐츠 추천 등 실무 적용 영역이 크기 때문이다.
핵심 요약
비전-언어 모델이 수동적 이해에서 능동적 상호작용으로 전환 중이나, 기존 방식은 명시적 요청에만 의존하고 사용자의 암묵적 의도(예: '다음에 어디를 클릭해야 할까')를 놓치며 상태를 실시간 업데이트하지 못하는 한계가 있다. 이를 해결하기 위해 StreamVibe-Bench 벤치마크를 소개하는데, 명시적·암묵적·동적 의도를 포함한 4.1K 평가 샘플과 85K 학습 샘플을 포함한다. StreamVibe-VL은 연속 관찰에서 암묵적 의도를 추론하고 의도 변화에 따라 상호작용을 동적으로 조정하는 스트리밍 능동형 모델이다. 전체 요약 7문장 읽기 → 전체 색인24건 · 분야별
AI · 머신러닝24건 001 21:11 ▲ 43 · 댓글 2 장편 비디오도 정확히 3D 복원하는 계층 포즈 그래프 딥러닝 모델로 짧은 비디오에서 카메라 움직임과 3D 기하를 정확히 추정할 수 있지만, 수천 개 프레임의 긴 영상은 계산량과 메모리 문제로 겹치는 청크(chunk) 단위로 나눠 처리해야 한다. AI · 머신러닝 · HiP3R: Hierarchical Pose Graphs for Long-Horizon 3D Reconstruction
Key Point 긴 비디오의 3D 복원에서 지역 최적화와 전역 일관성 사이의 근본적 트레이드오프를 계층 구조로 해결한 방법으로, 자율주행·로봇·공간 매핑 등 실제 응용에서 필요한 기술이다.
핵심 요약
딥러닝 모델로 짧은 비디오에서 카메라 움직임과 3D 기하를 정확히 추정할 수 있지만, 수천 개 프레임의 긴 영상은 계산량과 메모리 문제로 겹치는 청크(chunk) 단위로 나눠 처리해야 한다. 이 방식은 각 청크마다 독립적인 3D 복원을 만들어 좌표계가 일치하지 않고 카메라 위치가 중복으로 추정되는 문제가 발생한다. 인접한 청크와 멀리 떨어진 재방문 지점에서의 제약 조건을 전파해 전역 일관성을 맞춰야 하는데, 이는 포즈 그래프 최적화로 자연스럽게 해결된다. 전체 요약 6문장 읽기 → 002 21:11 ▲ 16 · 댓글 2 다중모달 추론 모델, 공개 데이터로 효율적 학습 방법 제시 멀티모달 추론 모델 학습의 병목인 데이터 품질 저하, 비효율적 감독 구성, 난이도 불균형, 도메인 간 간섭을 해결하기 위해 MMVistaReason(MVR)을 제안했다. AI · 머신러닝 · MMVistaReason: Toward Open-Data and Post-Training Recipes for Multimodal Reasoning
Key Point 멀티모달 추론 모델의 공개 학습 레시피가 상용 대규모 모델 대비 효율성과 성능을 동시에 달성하는 구체적 방법을 보여주므로, 오픈소스 멀티모달 AI 개발에 실질적 기준을 제시한다.
핵심 요약
멀티모달 추론 모델 학습의 병목인 데이터 품질 저하, 비효율적 감독 구성, 난이도 불균형, 도메인 간 간섭을 해결하기 위해 MMVistaReason(MVR)을 제안했다. 분석적 추론과 실제 추론으로 나눈 광범위한 학습 데이터로 구조적 추론과 시각 지각·공간 이해를 모두 커버한다. 구조화된 정제와 주석, 난이도 인식 증류, 답변 확률 기반 궤적 선택으로 SFT용 52.8만 개 샘플(MVR-SFT-528K)과 RL용 6.3만 개 샘플(MVR-RL-63K)을 효율적으로 구성했다. 전체 요약 9문장 읽기 → 003 21:11 ▲ 48 · 댓글 2 긴 영상의 짜깁기 조작 찾기, 음성과 영상 동시 분석 장시간 영상에서 일부 구간만 조작된 AI 딥페이크를 탐지하는 기존 벤치마크가 부족해, 연구팀이 AV-FABLE 데이터셋을 공개했다. AI · 머신러닝 · AV-FABLE: Audio-Visual Manipulation Forensics in Long-Form Videos
Key Point 장시간 영상에서 일부만 조작된 디프페이크를 정확히 찾아내야 하는 콘텐츠 검증, 미디어 포렌식 분야에서 음성-영상 동시 분석이 필수적이 되고 있기 때문이다.
핵심 요약
장시간 영상에서 일부 구간만 조작된 AI 딥페이크를 탐지하는 기존 벤치마크가 부족해, 연구팀이 AV-FABLE 데이터셋을 공개했다. AV-FABLE은 16,650개의 원본-조작 쌍(총 998시간)으로 이루어지며, 27가지 편집 설정으로 제작되고 음성과 영상 타임라인을 분리해 제공한다. 기존 음성-영상 대형언어모델(AV-LLM)을 제로샷 프롬프팅으로 테스트하면 조작 탐지 성능이 거의 무작위 수준이고 시간 위치 파악도 부정확하다. 전체 요약 7문장 읽기 → 004 18:11 ▲ 33 · 댓글 2 LLM 추론 강화에 새로운 액터-크리틱 알고리즘 S3AC 제시 롱 체인-오브-소트(CoT) 추론을 위한 강화학습에서 크리틱(가치함수)을 효과적으로 훈련하는 방법이 부재한 문제를 해결한 논문이다. AI · 머신러닝 · S3AC: Stabilized, Selective, and Scalable Actor-Critic for LLM Reasoning
Key Point 대규모 언어 모델의 추론 능력을 효율적으로 향상시키려는 개발자와 연구자에게 확장 가능한 크리틱 훈련 방식을 제시하며, 특히 단일 롤아웃으로 안정적 훈련을 지속하는 기술적 진전이 실무 적용 비용 절감으로 직결된다.
핵심 요약
롱 체인-오브-소트(CoT) 추론을 위한 강화학습에서 크리틱(가치함수)을 효과적으로 훈련하는 방법이 부재한 문제를 해결한 논문이다. 기존 크리틱 없는 방법들은 토큰 수준의 신용 할당이 어렵고 그룹 롤아웃으로 기준선을 추정해야 했다. S3AC는 훈련된 크리틱으로 토큰별 이득과 프롬프트별 기준선을 제공하며, 길이가 다른 궤적의 불충분한 커버리지와 초기 기울기 문제를 해결하는 실용적인 훈련 레시피를 제시한다. 전체 요약 7문장 읽기 → 005 18:11 ▲ 136 · 댓글 2 강화학습 자기 증류로 언어모델 추론 능력 향상 언어모델의 추론 능력을 향상시키는 검증 가능한 보상(RLVR) 방식은 응답 과정에 대해 너무 적은 감시만 제공한다. AI · 머신러닝 · Function-Space Temporal Self-Distillation for Policy Optimization
Key Point 언어모델 훈련 효율성과 메모리 사용량을 동시에 개선하는 새로운 자기 증류 방식이 공개되어, 대규모 모델 개발 비용 절감에 관심 있는 연구자와 개발자가 참고할 만하다.
핵심 요약
언어모델의 추론 능력을 향상시키는 검증 가능한 보상(RLVR) 방식은 응답 과정에 대해 너무 적은 감시만 제공한다. 자기 증류는 보조 없는 정책과 피드백 기반 자기교사를 비교해 토큰 수준의 밀집된 지도를 제공하지만, 교사 모델이 학생과 함께 진화하면서 불안정한 목표와 추가 정규화의 필요성을 야기한다. 논문은 함수 공간 정책 최적화(FSPO)를 제안하며, 현재 특권화된 적응과 함수 공간 시간적 통합을 하나의 정책 프레임워크에서 결합한다. 전체 요약 8문장 읽기 → 006 18:11 ▲ 52 · 댓글 2 LLM 에이전트의 지속 학습 능력을 측정하는 벤치마크 CLE 공개 지속 학습(Continual Learning)은 LLM 에이전트가 경험으로부터 지식을 습득·정제·적용하면서 기존 지식을 보존하는 능력으로, 장기적 학습에 필수적이나 현재 평가는 개별 과제 성능 중심이다. AI · 머신러닝 · Continual Learning Exam: Benchmarking Long-Horizon RSI and Experiential Learning in LLM Agents
Key Point LLM이 점진적 경험 누적으로 실제 직무를 수행할 수 있는지 평가하는 새로운 방식이 나왔고, 현존 모델의 이러한 능력이 절반 수준에 불과하다는 객관적 지표를 제시한다.
핵심 요약
지속 학습(Continual Learning)은 LLM 에이전트가 경험으로부터 지식을 습득·정제·적용하면서 기존 지식을 보존하는 능력으로, 장기적 학습에 필수적이나 현재 평가는 개별 과제 성능 중심이다. 허깅페이스와 도메인 전문가 50명이 개발한 CLE는 120개의 인간 저작 과제로 구성되며, 각 과제는 5단계 계단식 구조여서 총 600개 레벨, 12개 직업 도메인 89개 전문 역할에 걸쳐 있다. 에이전트는 각 레벨을 통과해야 다음 레벨을 해제할 수 있고, 뒤의 과제들은 이전 과제에서 축적한 경험에 기반한다. 전체 요약 7문장 읽기 → 007 18:11 ▲ 16 · 댓글 2 AI 텍스트 판별기를 해석 가능하게 만드는 방법 동료 검토, 교육, 입시, 저널리즘, 콘텐츠 모더레이션 등 결과가 개인에게 직접 영향을 미치는 분야에서 AI 생성 텍스트 판별기가 배포되고 있다. AI · 머신러닝 · Building Auditable AI Text Detectors with Sparse Autoencoders
Key Point AI 생성 텍스트 판별기의 검은 상자 문제를 해결하고, 높은 성능과 투명성을 동시에 확보할 수 있는 새로운 방법론을 제시해 교육·저널리즘·입시 등 중요한 영역에서의 신뢰성을 높인다.
핵심 요약
동료 검토, 교육, 입시, 저널리즘, 콘텐츠 모더레이션 등 결과가 개인에게 직접 영향을 미치는 분야에서 AI 생성 텍스트 판별기가 배포되고 있다. 현재 가장 성능 좋은 판별기는 미세 조정된 신경망 분류기인데, 의사결정 과정이 불투명하며, 투명한 대안인 문체 및 언어적 특성 분류기는 성능이 훨씬 낮다. 연구팀은 미세 조정된 신경망 판별기를 인간이 읽을 수 있는 개념으로 작동하는 분류기로 변환하는 파이프라인을 제시했다. 전체 요약 7문장 읽기 → 008 18:11 ▲ 24 · 댓글 2 대규모 언어모델의 자동 개선, 안전성을 어떻게 보장할까 대규모 모델 기반 AI 시스템은 경험과 피드백으로 모델·프롬프트·메모리·도구·워크플로우를 지속적으로 변경하고, 이 개선 과정 자체도 수정해 반복 적용하는 재귀적 자동 개선(RSI)을 한다. AI · 머신러닝 · Trustworthy Recursive Self-Improvement in the Era of Large Models: Foundation, Risks, Evaluation and Open Challenges
Key Point 큰 모델이 스스로 개선하는 시대가 오고 있는데, 그 과정에서 안전성·투명성·제어 가능성을 어떻게 보장할지가 AI 신뢰성의 핵심 문제이기 때문이다.
핵심 요약
대규모 모델 기반 AI 시스템은 경험과 피드백으로 모델·프롬프트·메모리·도구·워크플로우를 지속적으로 변경하고, 이 개선 과정 자체도 수정해 반복 적용하는 재귀적 자동 개선(RSI)을 한다. 자동 개선이 신뢰할 수 있으려면 평가 결과가 정확하고, 기존 능력이 퇴화하지 않으며, 행동 제약이 유지되어야 하며, 민감 정보가 후속 시스템에 남지 않아야 한다. 개선 메커니즘 변경 시 이전 검증 결과가 무효화되고 인간의 감시 효과가 떨어질 수 있어, 신뢰성 있는 RSI는 투명성과 제어 가능성을 필수적으로 요구한다. 전체 요약 7문장 읽기 → 009 18:11 ▲ 12 · 댓글 2 계층형 멀티에이전트 시스템, 온폴리시 증류로 학습 성능 향상 계층형 멀티에이전트 시스템에서 리더(Leader)가 태스크를 할당하고 서브에이전트들이 이를 수행할 때, 최종 답변만으로는 서브에이전트에 대한 직접적 피드백을 얻기 어렵다는 문제가 있다. AI · 머신러닝 · MultiAgent-OPD: End-to-End Training of Hierarchical Multi-Agent Systems with On-Policy Distillation
Key Point 멀티에이전트 시스템의 계층적 학습 문제를 해결하는 새로운 방식으로, 간접 피드백만으로도 효과적인 공동 학습이 가능함을 보여준다.
핵심 요약
계층형 멀티에이전트 시스템에서 리더(Leader)가 태스크를 할당하고 서브에이전트들이 이를 수행할 때, 최종 답변만으로는 서브에이전트에 대한 직접적 피드백을 얻기 어렵다는 문제가 있다. MultiAgent-OPD는 온폴리시 증류(on-policy distillation)와 강화학습을 결합해 리더-서처-앤서 팀을 엔드투엔드로 공동 학습한다. 먼저 정답 정확성을 기준으로 서처-앤서 워크플로에서 교사 모델을 학습시킨다. 전체 요약 6문장 읽기 → 010 15:11 ▲ 117 · 댓글 2 AI 에이전트가 신뢰할 수 있는 업무를 수행하려면 파운데이션 모델이 정보 생성에서 디지털 업무 실행으로 진화하면서 복잡한 작업을 여러 도구와 애플리케이션, 워크플로우에서 완수하는 에이전트가 등장했다. AI · 머신러닝 · Work Agents: Systems, Capabilities, and Optimization
Key Point 에이전트 기술이 실제 업무 자동화로 확대되는 시점에 신뢰성 있는 작업 수행의 조건과 평가 방식을 체계적으로 정리한 프레임워크로, AI 에이전트의 현실적 배포를 고민하는 개발자와 연구자에게 실질적 지침을 준다.
핵심 요약
파운데이션 모델이 정보 생성에서 디지털 업무 실행으로 진화하면서 복잡한 작업을 여러 도구와 애플리케이션, 워크플로우에서 완수하는 에이전트가 등장했다. 이 논문은 에이전트를 파운데이션 모델과 런타임 하니스를 결합해 상태 관리 워크스페이스에서 작업을 실행하고 검증 가능한 결과를 전달하는 시스템으로 정의한다. 작업 지속성과 작업 개방성 두 차원으로 작업 조건을 분류하고, 작업 범위와 조직에 따라 디지털 업무를 다섯 가지 형태로 구분했다. 전체 요약 6문장 읽기 → 011 15:11 ▲ 57 · 댓글 2 음성·음악을 입체음향으로 생성·편집하는 AMBIT 프레임워크 공간 음향 제작을 위해 음원 배치와 입체음향 합성을 통합하는 AMBIT 프레임워크를 제안했다. AI · 머신러닝 · Spatial Audio Generation and Editing with Executable Plans and Self-Distilling Transfusion
Key Point 입체음향 생성과 편집을 자동으로 처리하는 통합 프레임워크로, 음성 콘텐츠 제작과 방송·게임·VR 음향 설계에 직접 활용할 수 있기 때문이다.
핵심 요약
공간 음향 제작을 위해 음원 배치와 입체음향 합성을 통합하는 AMBIT 프레임워크를 제안했다. 음원의 콘텐츠·활동·3D 궤적을 지정하는 ScenePlan을 실행 가능한 형태로 만들고, 자동회귀 계획과 정류 흐름 기반 렌더링을 Transfusion 백본으로 통합했다. 편집 작업 시 계획은 보존할 음원을 포함한 전체 목표 장면을 명시하며, 대조적 특징으로 변경 요청을 정의하고 참조 음성의 레이턴트로 음향 세부사항을 보존한다. 전체 요약 6문장 읽기 → 012 15:11 ▲ 204 · 댓글 3 AI 에이전트의 협업을 동적으로 조율하는 DynaFlow 프레임워크 다중 에이전트 시스템이 고정된 협업 구조에 의존하면서 작업 요구에 적응하기 어려운 문제를 해결하기 위해 DynaFlow를 제안한다. AI · 머신러닝 · DynaFlow: Learning Free-Form Multi-Agent Orchestration
Key Point 고정된 협업 구조를 벗어나 AI 에이전트가 각 작업에 맞춰 동적으로 다른 에이전트들을 조율하는 방식이 실질적으로 작동하고, 같은 모델 기반으로도 크게 성능을 높일 수 있음을 보여준다.
핵심 요약
다중 에이전트 시스템이 고정된 협업 구조에 의존하면서 작업 요구에 적응하기 어려운 문제를 해결하기 위해 DynaFlow를 제안한다. 주 에이전트가 협업 필요 여부를 판단하고 태스크별 프로그램을 생성해 서브 에이전트들을 순차·병렬 실행, 정보 교환, 검증으로 조율한다. 실행 결과와 추적 정보가 다음 행동에 반영되어 추론 진행 과정에서 협업을 적응적으로 조정한다. 전체 요약 8문장 읽기 → 013 15:11 ▲ 123 · 댓글 2 사람의 물리적 행동을 돕는 AI 어시스턴트 평가 벤치마크 공개 착용형 기기의 다중모달 대형언어모델(MLLM) 어시스턴트가 사용자를 가이드하고 지시하는 상황을 평가하기 위해 InteractiveWorld라는 검증 가능한 환경을 제안했다. AI · 머신러닝 · InteractiveWorld: A Verifiable Human-Centric Environment for Building Better Interactive MLLM Assistants
Key Point 지능형 어시스턴트가 실제로 사람의 물리적 작업을 도울 수 있는지 검증할 수 있는 표준화된 평가 체계가 처음 등장했으며, 현재 최신 모델들의 성능 한계가 명확히 드러났기 때문이다.
핵심 요약
착용형 기기의 다중모달 대형언어모델(MLLM) 어시스턴트가 사용자를 가이드하고 지시하는 상황을 평가하기 위해 InteractiveWorld라는 검증 가능한 환경을 제안했다. 기존 로봇 중심 시뮬레이터와 달리 InteractiveWorld는 AI 어시스턴트가 사람 에이전트에게 지시하고, 사람이 관찰·이해·독립적으로 행동하는 폐루프 상호작용을 현실적으로 모의한다. 어시스턴트의 명령이 실제 결과를 좌우하며, 상태 기반 리워드로 검증 가능하게 채점되는 방식이다. 전체 요약 6문장 읽기 → 014 15:11 ▲ 35 · 댓글 2 통일된 설계 원칙으로 텍스트-이미지 프롬프트 자동 개선 사용자의 불충분한 텍스트 요청을 시각적으로 완성된 프롬프트로 변환하는 Qwen-Image-PE를 발표했다. AI · 머신러닝 · Qwen-Image-PE: Learning Visual Design for Text-to-Image Prompt Enhancement
Key Point 프롬프트 개선이 더 이상 일반적 의미 전달에만 중점을 두지 않고, 조명·구도·미학 같은 시각 설계 원칙을 구체적으로 학습하게 되면서 텍스트-이미지 생성의 품질 천장이 크게 올라간다.
핵심 요약
사용자의 불충분한 텍스트 요청을 시각적으로 완성된 프롬프트로 변환하는 Qwen-Image-PE를 발표했다. 감독된 미세조정과 강화학습 2단계 훈련으로 조명, 구도, 레이아웃, 디테일 등 세부 설계 요소를 학습한다. Caption-Based Reverse Distillation(CRD)은 잘 디자인된 이미지의 밀집 캡션을 설계 지도신호로 사용하고, Groupwise Design Reward(GDR)는 동일 요청의 모든 후보 이미지를 비교해 개선한다. 전체 요약 8문장 읽기 → 015 15:11 ▲ 38 · 댓글 2 LLM으로 과학 원리를 실시간 구축하는 'Principia' 프레임워크 과학적 발견에는 관찰된 현상 뒤에 있는 과학 원리를 파악하는 것이 필수적인데, 복잡한 발견 과정에서 이러한 경험적 원리는 대부분 미지의 상태로 남아있다. AI · 머신러닝 · Principia: Test-Time Hypotheses to Principle Construction for Scientific Discovery
Key Point 과학 발견 과정에서 원리 도출의 병목을 자동화하고, 테스트 타임에 진화하는 지식 구축 방식이 여러 분자·생물학 영역에서 기존 방법을 능가하는 성과를 입증했다.
핵심 요약
과학적 발견에는 관찰된 현상 뒤에 있는 과학 원리를 파악하는 것이 필수적인데, 복잡한 발견 과정에서 이러한 경험적 원리는 대부분 미지의 상태로 남아있다. 기존 방식은 가설을 원리로 변환하는 단계에서 방대한 영역 전문지식·시간·노력이 필요해 병목이 되고 있다. Principia는 LLM 기반 프레임워크로, 테스트 타임에 과학 원리를 구축하고 지속적으로 개선한다. 전체 요약 7문장 읽기 → 016 15:11 ▲ 50 · 댓글 2 보상 해킹을 막는 정밀도 기반 강화학습 루브릭 기반 강화학습은 검증 불가능한 작업에서 효과적이지만, 루브릭 커버리지의 가중치로만 보상을 정의해 재현율만 최대화하는 문제가 있다. AI · 머신러닝 · Eat Your Precision: Precision Objective Mitigates Reward Hacking in Rubric-based RL
Key Point 강화학습 보상 함수 설계의 핵심 문제인 목적 왜곡(reward hacking)을 정밀도 메트릭으로 체계적으로 해결하는 방법이 의료·건강 등 신뢰도가 중요한 분야에서 큰 성능 개선을 보여주고 있다.
핵심 요약
루브릭 기반 강화학습은 검증 불가능한 작업에서 효과적이지만, 루브릭 커버리지의 가중치로만 보상을 정의해 재현율만 최대화하는 문제가 있다. 이로 인해 RL 학습 모델은 내용이 길고 불필요하거나 사실적으로 틀린 부분이 많아져 기본 모델보다 선호도가 낮아진다. 이를 해결하기 위해 FORK 보상을 제시하는데, 이는 재현율과 함께 정밀도 목적을 동시에 최적화한다. 전체 요약 7문장 읽기 → 017 15:11 ▲ 28 · 댓글 2 에이전트의 변화하는 도구에 대한 적응력을 평가하는 벤치마크 공개 AI 에이전트가 진화하는 도구 생태계에 얼마나 잘 적응하는지 평가하기 위해 Δτ-Bench라는 실행 가능한 벤치마크를 소개했다. AI · 머신러닝 · Δτ-Bench: Pushing Agents Toward a Moving Capability
Key Point LLM 기반 에이전트가 실무 환경에서 마주하는 도구 변화에 얼마나 적응할 수 있는지 보여주는 새로운 평가 기준으로, 기존 벤치마크의 한계를 직접 드러내고 해결책을 제시했기 때문이다.
핵심 요약
AI 에이전트가 진화하는 도구 생태계에 얼마나 잘 적응하는지 평가하기 위해 Δτ-Bench라는 실행 가능한 벤치마크를 소개했다. 이 벤치마크는 1,588개의 검증된 멀티턴 작업과 42개 도메인, 6개의 연속적인 생태계 상태를 포함하며, 도구가 사라지거나 교체되고 더 효율적인 대안이 등장하는 현실을 모델링한다. 기존 벤치마크는 에이전트가 효율적인 도구 사용 경로를 주동적으로 발견하고 축적된 절차적 지식을 신속하게 수정할 수 있는지 검사하지 않는다. 전체 요약 6문장 읽기 → 018 12:11 ▲ 28 · 댓글 2 로봇 모방학습을 위한 다양한 시연 자동 발굴 기법 로봇 조작 작업의 행동 복제(Behavior Cloning)는 학습 데이터 커버리지에 민감하지만, 다양한 성공 시연 수집은 비용이 높다. AI · 머신러닝 · DiscoDemo: Discovering Efficient and Diverse Robot Demonstrations for Imitation Learning
Key Point 로봇 모방학습의 데이터 커버리지 문제를 해결하는 실용적 방법론으로, 시뮬레이션과 실제 로봇 모두에서 성공률을 크게 향상시키는 구체적 성과를 보여준다.
핵심 요약
로봇 조작 작업의 행동 복제(Behavior Cloning)는 학습 데이터 커버리지에 민감하지만, 다양한 성공 시연 수집은 비용이 높다. 연구팀이 강화학습(RL)을 배포 가능한 제어기가 아닌 하위 시각-운동 모방학습용 데이터 생성기로 활용하는 접근법을 제시했다. 여러 성공 해결책이 단일 방식을 반복 수집할 때보다 더 넓은 범위의 성공적 궤적을 포괄한다는 게 핵심 가정이다. 전체 요약 8문장 읽기 → 019 12:11 ▲ 27 · 댓글 2 동영상 세계 모델을 명시적 토큰으로 제어하는 'World-in-Context' Interactive video world modeling은 시점, 캐릭터 동작, 카메라 움직임을 조정해야 하는데, 기존 방식은 이들을 텍스트에 숨기거나 혼재시키고 분산된 구조로만 제어했다. AI · 머신러닝 · World-in-Context: Interactive Video World Modeling with In-Context Conditioning
Key Point 비디오 생성 모델에서 시점과 동작 제어를 명시적 토큰으로 통일한 새로운 접근이 기존 대형 모델(22B)과 같은 성능을 훨씬 작은 모델(5B)에서 달성하는 방식의 전환을 보여준다.
핵심 요약
Interactive video world modeling은 시점, 캐릭터 동작, 카메라 움직임을 조정해야 하는데, 기존 방식은 이들을 텍스트에 숨기거나 혼재시키고 분산된 구조로만 제어했다. World-in-Context는 In-Context Conditioning(ICC) 방식으로 시점, 동작, 카메라 제어를 명시적 토큰으로 통일하고 Self-Attention 공간에 직접 포함시킨다. 명시적 시점 토큰은 충돌하는 역학을 분리하고 단일 시점 데이터에서 시점 전환을 창발적으로 가능케 하며, 동작과 카메라는 각각 지역적 반응성과 전역적 안정성을 보완한다. 전체 요약 6문장 읽기 → 020 12:11 ▲ 49 · 댓글 2 큰 각도 카메라 움직임 속에서 캐릭터 영상 생성하기 기존 캐릭터 비디오 생성 방식은 회전·평동·거리 변화가 함께 일어나는 대각도 카메라 궤적을 따라가기 어려우며, 초기 프레임에 보이지 않던 캐릭터 영역이 드러나면서 기하학적 왜곡과 외형 저하, 아이덴티티 손실 문제를 겪는다. AI · 머신러닝 · WorldCast: World-Consistent Character Video Generation with Large-Angle Camera Control
Key Point 3D 기하학 정보와 다중 관점 특성 정렬 기법으로 카메라가 크게 움직일 때도 캐릭터의 일관성을 유지하면서 자연스러운 영상을 만드는 새로운 접근법을 제시한다.
핵심 요약
기존 캐릭터 비디오 생성 방식은 회전·평동·거리 변화가 함께 일어나는 대각도 카메라 궤적을 따라가기 어려우며, 초기 프레임에 보이지 않던 캐릭터 영역이 드러나면서 기하학적 왜곡과 외형 저하, 아이덴티티 손실 문제를 겪는다. 이를 체계적으로 연구하기 위해 CLACT라는 대규모 캐릭터 중심 데이터셋과 벤치마크를 개발했으며, 정확한 카메라 기하학과 다중 관점 캐릭터 관측치를 포함했다. WorldCast 프레임워크는 초기 프레임을 추정된 깊이로 3D 포인트 클라우드로 역투영한 뒤, 포인트 클라우드 스케일을 목표 카메라 궤적에 정렬하고 궤적을 따라 렌더링해 명시적 기하학적 가이드와 커버리지 마스크를 얻는다. 전체 요약 5문장 읽기 → 021 03:12 ▲ 35 · 댓글 2 LLM이 스스로 학습한다, 외부 감시 없이 대규모 언어모델이 외부 교사나 인간이 만든 문제 없이 자가 학습으로 성능을 개선하는 온폴리시 자가 증류 방식을 재정의했다. AI · 머신러닝 · On-Policy Self-Training: Data-Free Self-Improvement in Large Language Models
Key Point 기존의 자가 학습은 인간의 감시가 필수였으나, 이 방식은 모델이 완전히 독립적으로 자신의 학습 자료를 만들고 개선할 수 있음을 입증했다.
핵심 요약
대규모 언어모델이 외부 교사나 인간이 만든 문제 없이 자가 학습으로 성능을 개선하는 온폴리시 자가 증류 방식을 재정의했다. 모델은 주제 설명만 받고 스스로 질문-답변 쌍과 고급 추론 과정을 생성하는 합성 커리큘럼을 구축한다. 완전히 인공적으로 생성한 정보로만 자가 증류를 수행해도 여러 영역에서 성능 개선이 가능하며, 학습하지 않은 영역의 능력도 유지된다. 전체 요약 5문장 읽기 → 022 03:12 ▲ 18 · 댓글 2 미니드라마 각본 자동 생성, 다중에이전트로 다양성과 일관성 확보 마이크로드라마의 성장으로 고품질 각본 생성 수요가 증가했으나, 긴 형식의 각본 생성은 다양한 플롯 진행과 장거리 서사 일관성을 동시에 충족하기 어렵다. AI · 머신러닝 · DraMaze: A Multi-Agent Pipeline with Future-Aware Memory for Diverse Microdrama Script Generation
Key Point LLM으로 미니드라마 같은 긴 형식 콘텐츠를 생성할 때 다양성 부족과 서사 일관성 손상이 기술적 난제인데, 다중에이전트와 메모리 구조 설계로 구체적 개선을 이뤘다는 점이 중요합니다.
핵심 요약
마이크로드라마의 성장으로 고품질 각본 생성 수요가 증가했으나, 긴 형식의 각본 생성은 다양한 플롯 진행과 장거리 서사 일관성을 동시에 충족하기 어렵다. 기존 방식에서는 생성이 진행될수록 후보 연속성이 적은 수의 서사 메커니즘으로 집중되고, 검색 기반 방식은 상투적 표현 재사용을 강화하며 미래 플롯에 필수적인 역사 정보를 간과한다. 연구팀은 이를 해결하기 위해 DraMaze를 제안했으며, 이는 트로프 메모리 기반 진화 트리 탐색과 돌연변이를 통해 다양한 인과관계 경로를 탐색하는 다중에이전트 파이프라인이다. 전체 요약 7문장 읽기 → 023 03:12 ▲ 16 · 댓글 3 흐름 매칭으로 음악 분리하는 생성형 모델 FLOMSS 음악 소스 분리(MSS)는 보컬, 베이스, 드럼, 기타 등 네 가지 신호원을 분리하는 작업이며, 전통적으로 판별적 방식으로 처리되어 왔다. AI · 머신러닝 · FLOMSS: Generative Music Source Separation by Flow Matching
Key Point 음악 분리라는 오디오 처리의 핵심 작업에 생성형 AI 패러다임(flow matching)을 적용한 사례로, 판별적 방식 중심의 기존 접근을 재검토하고 성능을 검증한 결과물이다.
핵심 요약
음악 소스 분리(MSS)는 보컬, 베이스, 드럼, 기타 등 네 가지 신호원을 분리하는 작업이며, 전통적으로 판별적 방식으로 처리되어 왔다. flow matching은 복잡한 데이터 분포를 모델링하는 생성형 패러다임으로 여러 분야에서 성공 사례가 나오고 있어 음악 분리에 적용할 가치가 있다. 연구팀은 flow matching을 음악 분리에 적용하면서 예측 대상(prediction targets), 흐름 경로(flow paths), 단일 소스 대 다중 소스 모델링, 혼합 일관성 제약 등을 체계적으로 조사했다. 전체 요약 5문장 읽기 → 024 00:11 ▲ 18 · 댓글 2 전문가 윤리규범 위반 감지하는 러시아어 벤치마크 공개 전문 분야 윤리규범을 위반하는 요청을 감지하기 위한 TenetBench 데이터셋을 공개했다. AI · 머신러닝 · TenetBench: A Clause-Anchored Russian Corpus for Evaluating Language Models against Professional Codes of Ethics
Key Point 언어 모델이 전문 분야 윤리 위반 요청에 어떻게 대응하는지 측정할 수 있는 체계적인 벤치마크가 부재했는데, 이제 자동 생성 파이프라인으로 지속 확장 가능한 평가 도구가 제시되었다.
핵심 요약
전문 분야 윤리규범을 위반하는 요청을 감지하기 위한 TenetBench 데이터셋을 공개했다. 러시아 15개 전문 분야 코드 조항과 충돌하는 3,433개 요청과, 요청의 적절성만 다른 동일한 요청 쌍으로 구성되어 있다. 자동 파이프라인이 코드 텍스트에서 작업을 생성하므로 새 코드가 추가될 때마다 데이터셋이 확장되고, 실행할 때마다 새 작업이 생성된다. 전체 요약 10문장 읽기 → 오늘의 주요최신순 상위 3건
01 AI · 머신러닝 06:11 게시
openai/openai-python
원제 openai/openai-python v3.39.0
v3.39.0
Key Point Python 개발자가 최신 OpenAI 모델을 SDK에서 즉시 활용하기 위해 필요한 업데이트이다.
핵심 요약
OpenAI의 Python SDK 버전 3.39.0이 릴리스되었다. 새로운 GPT-6.1-Terra 모델 식별자가 API에 추가되었다. 이번 업데이트를 통해 개발자들은 GPT-6.1-Terra 모델을 SDK를 통해 사용할 수 있게 되었다. 02 AI · 머신러닝 06:11 게시
huggingface/transformers
원제 huggingface/transformers v5.21
v5.21 Release: v5.21.0
Key Point 문서 이해, 음성 합성 등 신규 모델 5개가 추가되고 병렬 처리·양자화·캐시 처리가 크게 개선되어 LLM과 멀티모달 모델 개발자들에게 직접적인 영향이 있다.
핵심 요약
Transformers 라이브러리가 v5.21.0을 릴리스했으며, 문서 인식부터 음성 합성까지 5개 모델을 새로 지원한다. MiniCPM-OCR은 OpenBMB의 모델로 SigLIP 비전 인코더와 Qwen3.5 언어 모델을 결합해 스캔 페이지, 스크린샷, 영수증 등 텍스트 밀집 이미지를 읽는다. Flint는 Recursive의 혼합 전문가 모델로 슬라이딩 윈도우 주의(512개 토큰 범위)와 완전 주의를 결합하며, 각 희소 계층이 256개 전문가 중 6개를 라우팅한다. 전체 요약 12문장 읽기 → 03 AI · 머신러닝 03:12 게시
openai/openai-python
원제 openai/openai-python v3.38.0
v3.38.0
Key Point OpenAI API 통합을 위해 Python SDK를 사용 중인 개발자라면 위임 제어와 프롬프트 캐시 라이프사이클 관리, 에이전트 및 함수 호출 안정성 개선을 확인해야 한다.
핵심 요약
OpenAI Python SDK v3.38.0이 2026년 10월 25일에 출시되었다. 위임 제어와 프롬프트 캐시 수명 설정을 API에 추가하고, Live Decision 항목과 질문 타입을 확장했다. 에이전트 결과 스키마 경고를 명확히 하고, API 상태 에러 형식을 서버 메시지 기반으로 변경했다. 전체 요약 6문장 읽기 → ● 이번 피드는 여기까지입니다.
작은 발견을 다음 커밋으로 이어가세요. 모든 발행본